Анти-оптимизация: как мы ускорили запрос в 4 раза, сделав его неоптимальным
Цель этой статьи - показать, что оптимизация запросов "по учебнику" не всегда работает, и иногда приходится использовать подходы, которые идут вразрез всем правилам, описанным на курсах и в книгах для 1С:Экспертов по технологическим вопросам.
Более 2-х лет я занимаюсь вопросами повышения производительности 1С за счет оптимизации программного кода. Одна из частых задач (особенно при борьбе с ожиданиями на блокировках) - это повышение режима совместимости конфигурации 1С.
Описание проблемы
Один из клиентов обратился к нам для перевода конфигурации из режима совместимости с 8.1 в режим "без совместимости" (версия платформы 8.2.19.102).
Код конфигурации был адаптирован под 8.2, режим совместимости благополучно изменен.
Примечание: версия СУБД в процессе повышения режима совместимости не изменялась.
НО, после повышения режима совместимости пользователи начали жаловаться на медленный поиск номенклатуры в рабочем месте менеджера.
Поиск выполнялся следующим образом: пользователь в специальном окне вводил строку поиска и нажимал Enter. На 8.1 поиск выполнялся около 5 секунд. При переходе на 8.2 стал выполняться 20 секунд (в 4 раза дольше). Нужно было ускорить поиск хотя бы до старых значений в 5 секунд.
Анализ и решение
При поиске номенклатуры выполнялся вот такой запрос:
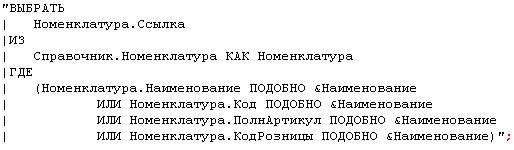
С помощью SQL Server Profiler были получены тексты запросов и планы выполнения для платформы 8.1 и для платформы 8.2.
Текст запроса в терминах SQL (платформа 8.1):
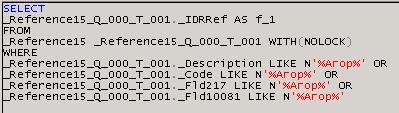
План запроса (платформа 8.1):
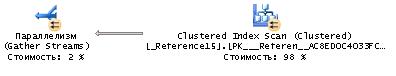
Таким образом, при выполнении запроса на 8.1 происходил полный скан таблицы справочника. Любой человек, который когда-нибудь занимался оптимизацией запросов скажет вам - "скан - это плохо", и будет прав. Но дальше увидим, что на самом деле это не всегда так :)
Текст запроса в терминах SQL (платформа 8.2):

План запроса (платформа 8.2):
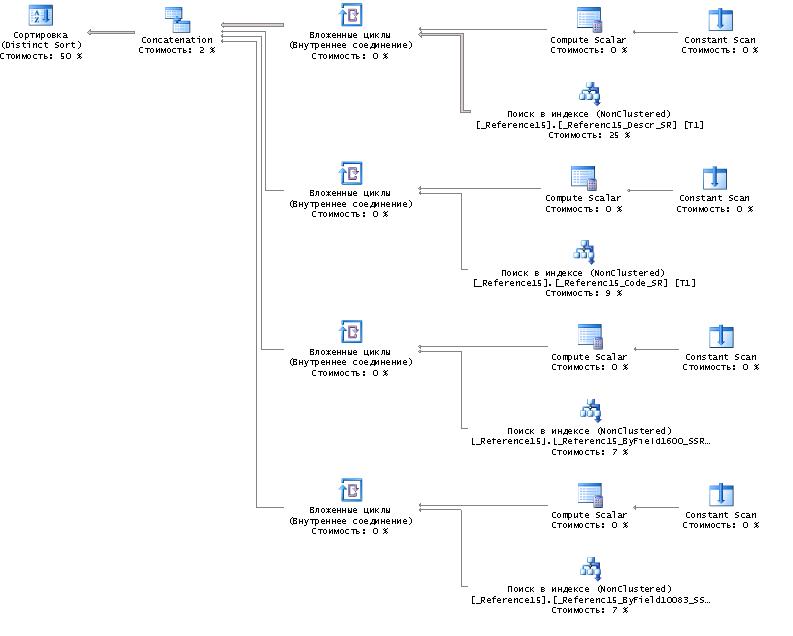
Несмотря на то, что сканов в этом плане запроса не было, запрос выполнялся в 4 раза дольше (20 сек.), чем этот же самый запрос на платформе 8.1 (5 сек.).
Любые попытки оптимизации этого запроса по стандартным методикам не привели к нужному результату - он продолжал стабильно выполняться в 3-4 раза дольше, чем до повышения режима совместимости.
Тогда было принято решение намеренно "ухудшить" запрос, чтобы повлиять на выбор плана запроса оптимизатором СУБД, и получить скан таблицы справочника (как было в 8.1).
Для этого в текст запроса были добавлены выражения над полями условий, запрос стал выглядеть так:
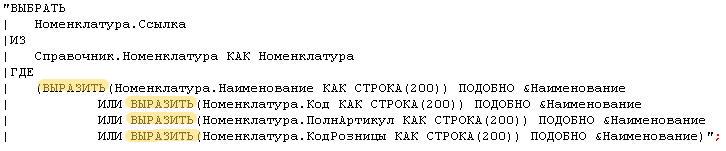
План запроса стал следующим:
То есть, мы получили такой же план запроса, который был при режиме совместимости с 8.1 - полный скан таблицы справочника.
При этом запрос ускорился в 4 раза: с 20 сек. до 5 сек.
Таким образом, конкретно в этом случае, скан таблицы оказался быстрее поиска по индексу.
В этой статье постарался показать, что оптимизация "по учебнику", работает не всегда.
Если вам понравилась статья, поставьте "+" :)
Вступайте в нашу телеграмм-группу Инфостарт
1с эксперт оптимизация ускорение запрос тормозит ускорить поиск номенклатуры производительность
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Инструментарий разработчика Роли и права Запросы СКД Разработчик Руководитель проекта 1С:Предприятие 8 Платные (руб)
Инструменты для разработчиков 1С 8.3 и 8.5: Infostart Toolkit. Автоматизация и ускорение разработки на управляемых формах. Легкость работы с 1С.
16500 руб.
02.09.2020 287701 1620 423
Кадровый учет Интеграция Запросы Журналы и реестры данных 1С:Предприятие 8 1C:Бухгалтерия 1С:Зарплата и Управление Персоналом 2.5 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х 1С:Зарплата и Управление Персоналом 3.x 1С:Управление нашей фирмой 3.0 1C:ERP Россия Управленческий учет Платные (руб)
Готовое решение для автоматизации проверки сотрудников, кандидатов и контрагентов по государственным реестрам и официальным источникам прямо из интерфейса 1С. Сократите время на ручные проверки, минимизируйте риски и храните результаты в единой информационной системе.
18300 руб.
17.06.2026 1039 2 0
Инструментарий разработчика Запросы Разработчик 1С 8.3 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Абонемент ($m)
Структура запроса. Обработка визуально показывает, из какого количества подзапросов состоит запрос.
2 стартмани
06.07.2026 5139 65 XSlava 20
Запросы Разработчик 1С 8.3 Россия Бесплатно (free)
Визуальный «Конструктор запроса» 1С, встроенный прямо в VS Code, — аналог конструктора из Конфигуратора и EDT, но без запуска платформы. Расширение читает конфигурацию, выгруженную в файлы, позволяет собрать запрос мышью и генерирует корректный текст на языке запросов 1С (SDBL). Открывает уже существующий текст запроса из кода для правки и — что особенно ценно — сохраняет комментарии при цикле «открыть - править - сохранить». Подходит тем, кто пишет код 1С в VS Code, держит под рукой множество проектов и не хочет ради одного запроса запускать тяжёлый Конфигуратор или EDT.
26.06.2026 10846 Alex_YAM 7
Нейросети Инструментарий разработчика Запросы Разработчик 1С:Предприятие 8 Абонемент ($m)
Консоль запросов 1.0: добавлен ИИ-помощник (запрос в DeepSeek), который помогает быстрее получать каркас Запроса 1С Сформулируйте простое описание; нажмите кнопку – получите результат прямо в консоли. Где дальше его можно дорабатывать и тестировать. 28.5.2026 Добавил "Консоль запросов 2.0" (запрос в DeepSeek + Claude) 4.10.2026 Обновил "Консоль запросов 2.0"
3 стартмани
20.05.2026 9816 46 German4739 72
WEB-интеграция Запросы Разработчик 1С 8.3 Абонемент ($m)
Post1C - это внешняя обработка, которая превращает 1С в полноценный инструмент для тестирования REST API. Всё управление сосредоточено в одном окне: настройка запроса, выполнение, просмотр ответа и генерация кода - без переключения между формами. Аналог Postman, но работающий в привычной среде 1С.
1 стартмани
02.04.2026 5051 107 priem_nv 28
Запросы Механизмы типовых конфигураций Разработчик 1С:Предприятие 8 1С:Управление торговлей 11 Россия Бесплатно (free)
Предлагается обзор работы с объектной моделью запроса по схемам запросов типовым функционалом УТ 11.5.
09.10.2025 13563 aximo 18
Инструментарий разработчика Запросы Разработчик 1С:Предприятие 8 1С:Зарплата и кадры государственного учреждения 3 1С:Зарплата и Управление Персоналом 3.x Абонемент ($m)
QueryConsole1C — расширение, включающее консоль запросов с поддержкой исполняемых представлений — аналогов виртуальных таблиц, основанных на методах программного интерфейса ЗУП. Оно позволяет выполнять запросы с учётом встроенной бизнес-логики, отлаживать алгоритмы получения данных и автоматически генерировать код на встроенном языке 1С.
1 стартмани
16.05.2025 13866 168 zup_dev 32
- переписывали через ОБЪЕДИНИТЬ ВСЕ
- в параметр наименование передавали строку с фиксированным началом (например, вместо "%строкапоиска%" использовали "строкапоиска%".
Вот с этого и нужно было начинать. При Like и подстановочных символах не может использоваться именно поиск по индексу. Был полный перебор индексов, причем 4 разных. Во втором был просто перебор таблицы один раз.
Для таких случаев придумали Полнотекстовый поиск.
Хехе... Знаем проходили... Поищите ошибки при полнотекстовом поиске в интернете.
Да, этот механизм предназначен именно для этого, но оно же не работает как надо.
Для реально больших баз, были ошибка с дампами (отключаешь полнотекстовый поиск - все ок, выполняешь поиск дамп и вылет из программы) и место заканчивалось в папке с файлами индекса, а его же на другой диск не перенесешь в отличие от файлов того же сиквела...
Поэтому полнотекстовый поиск как бы есть, но для больших данных нужны свои велосипеды.
В вашем случае можно было бы попробовать:
"ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
|  Номенклатура.Наименование ПОДОБНО &Наименование
|
|ОБЪЕДИНИТЬ ВСЕ
|
|ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
|  Номенклатура.Код ПОДОБНО &Наименование
|
|ОБЪЕДИНИТЬ ВСЕ
|
|ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
|  Номенклатура.ПолнАртикул ПОДОБНО &Наименование
|
|ОБЪЕДИНИТЬ ВСЕ
|
|ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
| Номенклатура.КодРозницы ПОДОБНО &Наименование;" ПоказатьНе понятно правда на сколько это будет быстрее в вашем случае, но официальная рекомендация такая.
Понятно что LIKE в индексе будет заниматься тем же самым перебором, что и без индекса. У него (у LIKE) другого варианта и нет.
Быстрее конечно перебрать все элементы 1 раз, сравнивая их на 4 различных условия.
А может кто-то все же добавил индекс на один из реквизитов при повышении совместимости? Например, до измениний были индексы только на реквизитах "Код", "Артикул", "КодРозницы". А после добавили индекс на "Наименование".
В данном случае если вместо ПОДОБНО было строгое равенство, тогда было бы оптимальнее: было бы 4 поиска по индексам и объединение.
Добавил регистр сведений с измерениями:
- Подстрока (индекс)
- Номенклатура
и регламентное задание, которое бы перезаполняло этот регистр:
А именно: разбивало бы исходную строку на подстроки:
Пример:
Туфли женские (наименование)
3-х буквенные:
туф
уфл
фли
жен
енс
нск
кие
4-х буквенные:
туфл
уфли
женс
енск
нски
ские
5-ти буквенные
и т.д.
Каждой такой подстроке соответствует номенклатура "Туфли женские". А дальше разбиваем исходную строку поиска на слова и делаем запрос к регистру, который работает без ПОДОБНО, через равно.
Да получается много данных сохраняем и огромный регистр, который строится долго, но поиск работает очень быстро.
Вот такой вариант по поиску был предложен.
В принципе, можно добавить еще измерение размер блока и сначала фильтровать по нему, чтобы избегать фильтров по строке и максимально сократить размер выборки, так же нужны оптимизации при изменении данных номенклатуры, чтобы данные регистра перестраивались без пересчета всей номенклатуры, а только измененной (допустим использовать план обмена) для регистрации измененной номенклатуры и регламентное, которое изменения этого плана обмена перебирает и строит только для указанной номенклатуры).
Все это имеет смысл только для баз где ОЧЕНЬ много номенклатуры. И люди пользуются такими извращениями потому, что деваться в общем-то некуда...
Бред, а не решение. Автор этого решения, видимо, даже не подумал о том, что 99% этих буквосочетаний не будут нужны никогда. Потому что в 99.99% случаев пользователи ищут по началу слова, а не по середине, если нужны "туфли", то никто не будет писать "уфл".
Затем автор этого бредового решения не подумал о том, что даже если номенклатуры в справочнике миллион, то даже группировка по двум первым буквам уже даёт выборку всего в пару тысяч элементов, что вполне уже подъёмно даже для 1С.
Соответственно, если уж хочется решать это всё через регистр, то можно весь миллион номенклатуры разбить по словам, у каждого слова взять две-три первые буквы, а дальше уже составлять индекс - "туф" как начало любого из слов в номенклатуре присутствует в этих двух тысячах номенклатур. А во время поиска, когда пользователь набрал "туфли ж", выбирается вся номенклатура, у которой индекс = "туф" (равно, не подобно), дальше уже из этих пары тысяч строк по Имя Подобно "%туфли ж%" за несколько мс выбирается всё нужное.
Нет террабайтов бесполезных индексов, нет часов ожидания перестроения бесполезных индексов, нет ожидания пользователей.
Я передал саму мысль. Понятное дело, что в чистом виде без оптимизаций никак.
Тогда обычный индекс легко и быстро поможет находить слова любой нужной длины.
В общем то, полнотекстовый поиск именно так и устроен. Можно еще про суффиксные массивы и деревья почитать. В , кстати, применяется. Избыточность небольшая - для каждой записи справочника создается в среднем L записей, где - L - средняя длина заполненной части строки. Например, для миллиона записей будет 10 миллионов записей суффикса. В случае (15) таких записей будет гораздо больше - L x L / 2.
По моему, 5 секунд слишком много, нужно либо полнотекстовый поиск настроить, а если не получится, сделать свой, самодельный. То есть, нужно сосредоточить борьбу не на отрезке 5 - 20 секунд, а 0.1 - 5.
Не понял, чем эти суффиксы помогут для поиска. В вашем примере "абра" попала в суффиксы, потому что она два раза в слове встречается. Возьмём "туфли женские". Начинаю писать "туф", ни один из суффиксов ("уфли женские", "фли женские" и т.п.) мне не поможет в поиске. И опять приходим к десяткам миллионов ненужных данных. При этом если у нас была таблица, где есть:
"ту" (или "туф") - "туфли женские"
"ту" (или "туф") - "туфли мужские"
"бо" (или "бот") - "ботинки женские"
"бо" (или "бот") - "ботинки мужские"
, то поиск занимал бы миллисекунды. Я реализовывал такой поиск городов. Задача была - реализовать внешнюю обработку на базе на замке, соответственно, реестр хранился в виде текста, извлекался оттуда в соответствие, где ключ - две первые буквы названия, значение - массив всех данных о городах, которые начинаются на эти две буквы. В файле было 250 тысяч строк, первичное кэширование (из файла JSON в соответствие) занимало 4 сек, поиск занимал миллисекунды, пользователь вводил от двух букв и больше и ему показывалась выпадающая подсказка, пользователь вообще не ощущал, что что-то в фоне происходит. А в фоне отбирались первые две буквы, получался соответствующий массив из пары сотен-пары тысяч строк и по нему искалось Подобно "ТоЧтоВвёлПользователь%". А уж если использовать не внешние объекты, которые надо конвертировать, а БД, то там и без кэширования можно обойтись.
В результате размер индекса или равен размеру справочника, или в 2-3 раза больше (если индексировать начало каждого слова в наименовании). Искать можно только по началу слов, но, повторюсь, в моей практике я ни разу не встречал, чтобы кому-то пришло в голову искать "туфли" как "уфли". Более того, надо, наверное, всерьёз поработать над бизнес-процессами и НСИ, если такая нужда у кого-то возникает. Даже, как тут где-то указывалось, если у меня "Искитимцемент цемент мешок 10 кг", то не знаю, зачем бы я искал "мент" или "шок".
Поэтому, повторюсь, так и не понял, зачем нужно резать слова на суффиксы.
Про ПП в 1С пишут, что были глюки и ошибки. Сам я когда-то включал ППИ в базе 1С, но ни разу не дождался, чтобы он построился до конца. Было это довольно давно, но осадочек остался.
Пример:
- пеностирол
- пенополистирол
- полистирол
Как найти их все?
Давайте определимся - мы говорим о пользователе, который ищет конкретную номенклатуру или об абстрактной ситуации, в которой кому-то, например, для отчёта, понадобилась номенклатура со всякими вхождениями?
В дин.списках 1С есть поле поиска, которое также может помочь в поиске вхождений. Как и форма поиска. Для описанной вами ситуации вполне подойдёт. Если же мы говорим о ситуации из статьи, когда, например, оператору, нужно подобрать определённую позицию номенклатуры в документ, "пенос" даст первый, "пеноп" даст второй, "поли" третий из ваших элементов. Плюс на "пено" выпадут оба первых, можно будет выбрать вручную.
Если ограничивать только узкими рамками для конкретного сценария, то можно сказать, что нечеткий поиск вообще не нужен. "Мы вот сразу знаем наименование всех номенклатур".
Сценарии могут быть разные, для разных сценариев могут быть разные подходы.
Для вашего сценария вообще ничего изобретать не нужно. Подходит интересующийся клиент - "А что у вас из стирола есть?" Менеджер вбивает в типовой поиск "стирол" и получает все вхождения. Время ожидания зависит от базы, пусть даже 20 секунд - это не критично для этого сценария, никто не умрёт. За минуту собрал несколько позиций, показал цену, рассказал о товаре.
Другой сценарий - сидит оператор, например, на складе, и целый день вбивает в документы номенклатуру. Ему нужны "пенос", "поли", "пеноп". Позицию он хотя бы примерно знает. А может и совсем знает, если вбивает по бумажке, например, или по памяти из частых позиций. Время поиска для него критично, 20 секунд на каждую номенклатуру - это не только невыгодно, но и психически сложно, будет бунт.
Изобретать механизмы для первого сценария - ну, наверное, можно, если прям большущая нужда. Но мешать его со вторым, делать общий механизм - это раздутые трудозатраты на разработку и негарантируемый результат (по вашему сценарию придётся делать десятки, если не сотни миллионов индексов, очень не уверен, что вообще будет существовать приемлемое по затратам решение, которое даст меньше секунды на поиск). Для второго сценария описанный мною механизм как один из вариантов по трудозатратам выйдет в несколько часов. И эти смешные затраты решат проблему по одному из сценариев здесь и сейчас.
Поэтому никакого "ограничения" сценариев нет, есть разумное разделение сценариев по нуждам, реализации и затратам. Если есть какая-то панацея - предлагайте. Конечно, одно решение на все случаи жизни лучше, чем несколько. Если нет, тогда два разных эффективных решения или хотя бы одно эффективное на один сценарий - это лучше, чем полный бардак в ожидании панацеи.
это называется подогнать вопрос под ответ.
Вариантов "приставок" может быть неограниченное количество. Помнить все довольно трудно. Причем это только для одного корня. А этих ситуаций может быть неограниченное количество. Вот корень слова запомнить проще, чем все возможные "приставки"
Мы же рассматриваем универсальное решение. Вообще такое решение давно придумано: ППД, но в данном случае его отбросили и изобретают свой велосипед.
Предположи, товар в базе может называться английскими буквами или начинаться с кавычки, слова, которое обычно не произносимо или сокращения.
Можно конечно настроить rls, но что если оператор один, а привязки rls к клиенту нет?
К складу эту роль ограничения rls играют остатки, и то, если они есть.
Нет, это называется придумать какую-то задачу, которая не решается данным решением, и с радостью заявить, что решение не решает вообще ничего.
Я вам описал сценарий, с которым я работал и который успешно решил, этот сценарий сильно похож на тот, который описан в статье. Есть замеры и трудозатраты.
По вашему сценарию, очевидно, нужно другое решение. Вы при этом никакого другого решения не предлагаете, при этом заявляете, что решение совершенно другого сценария плохое, потому что оно не решает ваш сценарий. Ну ок, пойду удалю код у клиента, скажу, что был неправ, на форуме сказали, что решение неправильное.
Т.е. вы сами придумали себе свой сценарий и под него все подводите. Обсуждение же было про универсальный поиск.
Никто не говорил, что ваше решение не имеет права на жизнь. Вы просто влезли в обсуждение универсального решения со своим узкоспециализированным и выдаете его как единственно верное.
учитывая, что было обсуждение предложенного выше варианта решения, то это можно принять за просто попытку оскорбления.
Удачи вам. Дальше продолжать общения с вами не вижу смысла.
Повторюсь, сценарий в статье описывал похожий на мой сценарий. Поэтому я привёл решение своего сценария.
По суффиксам я не понял тогда и не понимаю сейчас, чем они могут помочь. У нас есть справочник с миллионом строк, по которому поиск осуществляется очень долго. Нам предлагается создать ещё один справочник, больше первого в 10-50 раз, запустить работы по его наполнению и поддержке - резать слова, собирать их по буквенно по 2-3-4-5 и так до скольки?, пересобирать куски при каждом изменении каждой номенклатуры и при создании новой, перестраивать индексы базы по этому монстру каждый раз, а с блокировками что? Это в фоне будет выполняеться? Т.е. новая номенклатура найдётся только завтра, после перелопачивания? Или сегодня подождём полчасика, пока всё перестроится? Ночных операторов нанимать, чтобы днём не дай бог никто номенклатуру не поменял)) А колво букв какое - 10? А если пользователь наберёт 11 букв, то мы ему вывалим критикал эррор и выключим 1С, чтобы не повадно было) Или все буквы сколько есть? Представляю, что за индекс будет там, где номенклатура "Шарикоподшипники самзанные КЛМКПСФНС103443КУППРЕТЫФ Искитимглавшарикоподшипник"))
Т.е. было предложено решение, которое вроде бы как что-то должно решать, но я пока вижу проблемы и не вижу замеров этого "универсального" решения. Поэтому я и предложил сделать из абстрактного "а давайте искать абракадабру по бре!", который лично я не встречал никогда, более жизненный вариант сценария, с которым работал неоднократно - искать по началу слов.
Постараюсь не сильно реветь от этой потери)) Потому что так хочется на техническом форуме читать обидки, а не технические решения, а тут на тебе, обломали меня))
Относительно "туфель". Суффикс здесь не лингвистическое понятие. Я же привел пример: "абракадабра" - слово и "абракадара" - его первый "суффикс". То есть "туфли женские" - слово и "туфли женские" - один из его суффиксов.
Если вы хотите сэкономить и не хранить "уфли женские" как малоиспользуемое сочетание, то "уф" В ЭТОМ МЕСТЕ тоже зря будет храниться.
А тут вы сможете найти очень быстро и точно за одно обращение к индексу целые "ботинки женские", а боты, ботильоны и другая ботва будет пропущена.
Вообще минимизировать число разделяющих признаков можно, если задано множество наименований. Но тут мы не говорим про словарь и его возможные ограничения, тут ведь и артикулы и коды есть, то есть строками считаем произвольный набор символов, где и "уфли" могут какой-то смысл иметь. Не расслышал первую букву, например, в названии улицы или фамилии. Акунин или Окунин - как тут найти? - Пиши "кунин", полнотекстовый поиск его сразу найдет.
То есть предложенная схема хранит одновременно и единички и двойки и тройки и четверки и так далее и все только храня суффиксы, которых гораздо меньше, чем подстрок.
Насчет скриншота итогового плана запроса есть сомнения. До этого было сканирование 4 разных не кластерных индекса, а в итоге идет сканирование по кластерному индексу, который еще и Primary Key похоже... Что-то тут не так. Он обрезанный?
Нет, конечно это не оптимизация. Даже для частного случая. Это ещё выстрелит вам в ногу. Вы заставили свалиться запрос в один скан и параллелизм, почему сам поиск работает долго по каждому индексу - не разобрались. При такой оптимизации можно уже и индексы отключать. О записи то вы почему-то не стали беспокоиться.
Так можно поступить только "пока не разберемся'.
Давайте детали:
Версия СУБД. Совместимость базы. Maxdop=0? Или сколько? Почему при наличии maxdop разница в 4 раза? Очень странно. Нужны цифры...
Сколько записей в таблице, сколько записей в выборке по каждому индексу.
Прогрет ли кэш? Покажите чтения и время для каждого случая по всем (пяти) индексам отдельно.
План запроса свежий или из кэша? закэширован для какого параметра?
ПС: 5 сек - это тоже не результат. Что делает этот запрос? Если это список, то где ПЕРВЫЕ?
Версия СУБД: Microsoft SQL Server 2008 R2 10.50.6000.34
maxdop = 8
compatibility level = 100
Проверялась работа с разными значениями maxdop, в том числе и с выключенным (=1), результат значительно не изменялся.
План запроса свежий или из кэша? закэширован для какого параметра?
Кэш прогревался. Тестирование выполнялось с предварительной очисткой кэша и его прогревом.
запрос выполняет поиск номенклатуры по части строки, поиск выполняется по разным реквизитам (это не динамический список)
Покажите чтения и время для каждого случая по всем (пяти) индексам отдельно.
Эту информацию, к сожалению, сейчас нет возможности предоставить - доступа к базе уже нет.
Очень жаль, что уже нет доступа к данным и больших подробностей. Можно было хотя бы отдельно таблицу выдрать/сохранить.
Я такие вещи тестирую прямо в SSMS. Можно рекомпиляцию делать (для избежания снифинга), хоть как-то контролировать кэши, можно чтения видеть, замеры и т.п. Из 1С проводить тесты - так себе...
Очень важный момент: как бы повел себя оптимизатор на 2012-2017 версиях. Теперь мы этого не узнаем. ((
Во всех подобных случаях не стоит рассматривать примеры запросов как что-то универсальное (а-ля вот такая таблица с таким-то количеством строк). Подобные странности проявляются на определенных данных, с определенным статистическим распределением значений.
PS: прошу прощения за лишнюю резкость в предыдущем посте.
Все нормально, к критике отношусь положительно - в ней рождается истина)
Ну его нафиг такую оптимизацию.
Напишите, пожалуйста, где можно прочитать про этот инструмент и как с ним работать в связке с 1С
Решение задачи методом подселения козла.
Подозреваю юзеры жаловались и на 5 сек поиск номенклатуры, им сделали 20 сек, а потом вернули 5 сек и наступило счастье )
На самом деле не хватает информации по задаче.
Самое главное - сколько секунд ищется такой конструкцией
"ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
|  Номенклатура.Наименование ПОДОБНО &Наименование


 сколько секунд ищется такой конструкцией
"ВЫБРАТЬ
|  Номенклатура.Ссылка
|ИЗ
|  Справочник.Номенклатура КАК Номенклатура
|ГДЕ
| Номенклатура.Наименование = &Наименование Показатьи по какому полю чаще всего пользователи ищут
и если они в большинстве случаев правильно вводят начало слова а я думаю 100% они не ищут по середине - то можно искать по равенству, а не по подобию - это будет 0.5 сек к примеру вместо 5 сек
У нас примерно так же сделан поиск и простых альтернатив этому я не вижу.
запрос с ПОДОБНО только по одному полю выполнялся после повышения совместимости около 5 секунд
запрос на равенство - меньше 0,5 секунды.
и если они в большинстве случаев правильно вводят начало слова а я думаю 100% они не ищут по середине - то можно искать по равенству, а не по подобию - это будет 0.5 сек к примеру вместо 5 сек
то что на равенство будет работать в десятки раз быстрее - сомнений нет)
По поводу "100% не ищут по середине" - тоже так думали, но вариант с поиском по строке с фиксированным началом не устроил пользователей - искали и по середине тоже, хотя работал он быстрее.
Во-первых, такая строка 99% будет уникальной, а значит и индекс будет селективным.
Во-вторых, это будет один индекс, а не 3 (5,10 и т.д.), в плане будет поиск по 1-му индексу, а не по 3-м и последующая конкатенация результатов.
Очевидное решение, лежит на поверхности, неужели никто не догадался???
Наименование = Стол дубовый
Код = 00012345;
Артикул = 12345;
ПолноеНаименование = Стол дубовый лаковый производство Россия
КлючАналитикиПоиска = 00012345 Стол дубовый лаковый производство Россия
Еще можно административно принять в компании шаблон заполнения всех этих полей, написать обработчики на эти поля, шаблон поиска для подстановки в запрос формировать также, как сам ключ. Уже масса вариантов. А пока на "оптимизацию" ну никак не тянет, уж извините
Да еще и длины строки может не хватить поместить все выбранные реквизиты.
Это конечно требует проверки на практике, но повторюсь - решение то очевидное.
И как поможет тут статистика? Статистика это не еще одна разновидность индекса.
Начиная с версии MS SQL 2005:
"String summary statistics: частота распределения подстрок при анализе символьных полей. Помогает оптимизатору лучше оценивать селективность условий с оператором LIKE."
"Объект статистики содержит сводную строковую статистику, позволяющую уточнить оценку количества элементов для предикатов запроса, использующих оператор LIKE, например WHERE ProductName LIKE '%Bike'. Сводная строковая статистика хранится отдельно от гистограммы и создается в первом ключевом столбце объекта статистики, если он имеет тип char, varchar, nchar, nvarchar, varchar(max), nvarchar(max), text или ntext."
Ссылки на пруфы могу прикрепить, но думаю и сами найдете легко и просто
Вот это ни о чем не говорит? Эта статистика нужна оптимизатору плана запросов для выбора таблиц/индекса в котором делать поиск. Т.к. поиск по определению тут невозможен, то будет выбор: или перебор таблицы или индекса. Никакого дополнительного увеличения быстродействия статистика не даст.
Вы меня раззадорили. Я не поленился и провел эксперимент.
У меня есть в тестовой базе документ ЭлектронныйЗаказ. Всего 2 млн строк в таблице документа.
Вот такой запрос:
ВЫБРАТЬ
	ЭлектронныйЗаказ.Ссылка КАК Ссылка
ИЗ
	Документ.ЭлектронныйЗаказ КАК ЭлектронныйЗаказ
ГДЕ
	ЭлектронныйЗаказ.Комментарий ПОДОБНО "%1%"
В поле "Комментарий" пишут адрес доставки, так что цифра "1" там встречается очень и очень часто.
1. Вариант 1. Поле Комментарий не индексируется.
Запрос после прогревания кэша стаблильно отрабатывает за 20 с небольшим секунд. Возвращает 178 тыс. строк.
План запроса точь в точь как у автора (за небольшим исключением, у меня в базе есть еще разделение данных по общему реквизиту "Организация", так что у меня не scan, а seek индекса (но в данном контексте это не существенно).
seek кластерного индекса (то есть, по сути - самой таблицы) 99% - параллелизм 1%
Оптимизатор запроса подсказывает, цитирую:
/*
Отсутствуют сведения об индексе из v8_66BC_e7.sqlplan
Обработчик запросов считает, что реализация следующего индекса может сократить стоимость запроса на 90.1642%.
*/

/*
USE [KRR]
GO
CREATE NONCLUSTERED INDEX [<Name of Missing Index, sysname,>]
ON [dbo].[Документ.ЭлектронныйЗаказ] ([Организация],[Комментарий])
INCLUDE ([Ссылка])
GO
*/
Показать2. Вариант 2. Я включил для поля "Комментарий" - "Индексировать с доп. упорядочиванием".
Тот же самый запрос. Прогрел кэш. Вернулись те же 178 тыс. строк. Отработало за 1.9 секунды.
План запроса:
Поиск в индексе (не-кластерный) 100% - Вложенные циклы (внутреннее соединение) 0%
Compute scalar 0% -----------------------------
Оптимизатор никаких индексов до-создать не советует.
20+ секунд ---> 1.9 секунды.
Так что данная логика вполне жизнеспособна.
Не верите - возьмите и повторите, как говорится....
Надеюсь, звучит убедительно.
Планы прикладываю.
2.sqlplan
Да можно конечно, только результат будет такой же как у автора - план разобьет эти ИЛИ на несколько seek-ов и потом будет объединять...
Будет ли параллельно выполнять - это уж как у вас в БД настроен параллелизм.
Я поэтому и предложил - "составной" строковый реквизит, грамотно заполненный, с отдельным индексом. Думаю, из исходных 5 секунд можно сделать 0.5
А теперь то же самое с нормальным реквизитом. И не %1%, а более осмысленное типа %стул%. Чтобы приблизить к оригиналу.
И по поводу кеша. Вот один пользовать делает %стол%, второй %белый стол% и т.д. Какая вероятность попадания в кеш при таком поиске?
Так что он нормальный. %1% вполне осмысленное в моем случае, так как в этом поле хранится что-то вроде:
"12345 На деревню дедушке"
"Москва, улица Мира, д. 134, 345671"
"Позвонить после обработки по телефону +79991234567"
и т.д.
Так что мой эксперимент очень близок к оригиналу. Шаблон %1% как видите - не особо избирательный. И тем не менее, на порядок ускорилось.
Для алгоритма какая разница, какой шаблон %стол% или %белый стол%? Я думаю, никакой абсолютно.
Ради интереса, сделал вот такие шаблоны:
"%аптека%" 98 тыс строк вернулось
"%ООО%" 59 тыс срок
"%стол%" 69 строк
"%стул%" 0 строк (ну не торгуем мы стульями, уж извините xD)
"%аптека фарм%" 3 строки
Везде результаты 1.9-2.1 секунды.
Я на этом эксперимент закончу, можете повторить при желании и отписаться о результатах
Предложу другое объяснение. Индекс - это файл, содержащий индексируемое поле. Он существенно меньше исходной таблицы. Часто помещается в оперативную память и остается в ней. По этому полный скан этого файла в поиске подстроки будет быстрее как раз настолько, насколько получилось у вас, чем сканирование основной таблицы. То есть не за счет каких-то хитрых структур данных или статистики (???). А за счет меньшего размера файла. А когда в теории говорится, что индекс ускоряет поиск по шаблону 1%, речь идет о более существенном ускорении, чем до 2-х секунд.
Это можно проверить. Будет интересно проверить тут же зависимость времени от длины подстроки в шаблоне %подстрока%. Зависимость должна быть. Чем длиннее строка, тем быстрее поиск.
Добрый день, Сергей. Да, в теории не должен. В плане не полный скан, а именно поиск в индексе, то есть seek. Мне кажется, просто этот оператор для like работает несколько иначе, чем просто перебор строк и разбор каждой на предмет соответствия условию. А вот как именно он это делает - это я уже не знаю.
(117)
все же написано в документации
а про шаблоны - многие компании такое используют
Лично видел! В Москве есть весьма такая неплохая сеть магазинов автозапчастей: АвтоРусь (не сочтите за рекламу).
Там сотрудник для поиска конкретной запчасти по наименованию в поле поиска вбивает не просто абы как, а по шаблону, что-то типа: "патруб*Д10*Bosh*и т.д."
Каждый раз, кстати, как захожу к ним - всегда подглядываю, как у них 1С меняется - очень нравится, как все внедрено, формы красивые-удобные, кнопки там, прям пожать руку хочется разрабам
Как раз таки подобная строка очень хорошо укладывается в поиск по индексу.. А вот кабы было "*патруб*Д10*Bosh*и т.д." - было бы интереснее.
Хотя конкретно для номенклатуры поиск правильнее организовать по свойствам, значения фильтров которых выбирать на форме. Ну или брать из строки "патруб*Д10*Bosh*и т.д.", разбив ее по звездочкам, например.
У нас есть похожее решение, хранит статичные связанные аналитики в отдельной таблице (тоже РС), куда потом в запросах приклеиваются динамически меняющиеся доп. данные. Перезаполнение этих аналитик нормально так нагружает весь сервер, хорошо, что нам хватает 1 раз в сутки их перезаполнять (по бизнес-логике)
Нет у этой задачи однозначно хороших решений, придется чем-то жертвовать
А в общем алгоритм с оптимизациями примерно такой:
1) Создаем план обмена, который регистрирует изменения в номенклатуре.
2) Обработка регламентным заданием только той номенклатуры, которая была изменена.
3) После обработки убираем регистрацию с обработанной номенклатуры.
4) Регламентное, которое отрабатывает раз в минуту прекрасно будет справляться и не нагружать сервер.
В регистр пишем только начала слов начиная с 3-букв
"Туфли женские" трансформируются в регистре в:
туф
туфл
туфли
жен
женс
женск
женски
женские
Предположим, в строке поиска введено: "туф жен"
Разбиваем строку на слова по пробелам и загоняем результат в массив.
Ну а дальше запрос к регистру, без использования оператора ПОДОБНО.
Состав регистра с измерениями:
1. Подстрока (Индексирование включено);
2. Номенклатура;
Поиск должно работать быстро, места занимать не так уж и много будет, кстати, и все очень даже актуально (в минуту будет не много измененной номенклатуры... наверное...).
В очередной раз скажу:
1) Это алгоритм, который может потребовать дополнительных оптимизаций.
2) Велосипед придумал не я и я его не пробовал как оно работает в боевых условиях.
3) Да, я открыл для себя ПДД/ElasticSearch и т.п. и это осознаю :)
"seq scan on Справочник.Номенклатура t1  (cost=0.00..2206.72 rows=235 width=29) (actual time=2.254..82.594 rows=98 loops=1)
  filter: ((not ПометкаУдаления) and ЭтоГруппа and (ОбластьДанныхОсновныеДанные = '0'::numeric) and ((Наименование ~~ '%абыр%'::mvarchar) or (Артикул ~~ '%абыр%'::mvarchar)))
  rows removed by filter: 26896
planning time: 0.154 ms
execution time: 82.610 ms
",rowsaffected=98
справочник порядка 25 тыс товаров
1) Зачем клиенту понадобилось повышать уровень совместимости (что это дало пользователям/бизнесу) ?
2) Какие проблемы были решены этим переводом ?
Обувь туфли женские
Или запчасти шарикоподшипник
Поскольку и так понятно, но в общем списке неудобно.
Справочник с ценами поставщиков в подборе по прайсу это хорошо.
С покупателями сложнее, но все это не относится к теме.
Пробовали выполнять прямо из ssms?
Это в общем-то и есть адекватная точка зрения на этот вопрос. Не стоит переоценивать методические рекомендации, но и отказываться от них тоже не стоит. Рекомендации будут работать в 80% случаев, поэтому они и стали рекомендациями.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 1087368
Создание 02.07.19 15:30
Обновление 02.07.19 15:30
Просмотры 19945
Загрузки 0
Рейтинг
63
Комментарии 121
Код открыт Да
Рубрики Запросы
Кому Разработчик
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация Универсальные
Операционная система Не имеет значения
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)