"Распределение в запросе" или "избавляемся от перебора"
Разработка - Математика и алгоритмы
В свое время, года 3 назад, возникла необходимость оптимизации конфигурации и устранения ее узких мест в одной компании. Одним из таких узких мест оказался, казалось бы, безобидный, механизм распределения товаров в реализации по сериям. Суть в том, что строк распределялось достаточно много и было это очень медленно. Не миллионы за раз, конечно, но на это самое распределение для одного документа могло уходить до минуты. От этого становилось всем очень грустно, т.к. параллельно бухгалтера препроводили документы, другие операторы тоже формировали документы отгрузки и когда отгружали «большого» клиента – жизнь на некоторое время замирала. К слову сказать, размер базы 1С за 2-3 года на тот момент составлял ~500 Гб, заказов от одного клиента за день могло прийти десяток-другой, а в некоторых из них строк могло быть более 1000, в общем «Реализация товаров и услуг» на 1000 строк - это не было ничем сверхъестественным. Реиндексация, обновление статистики, шринк и другие необходимые процедуры проводились регулярно, но сейчас речь не об этом. Вернемся к нашему объекту оптимизации. На тот момент механизм распределения был до банального прост:
- Запросом получали остатки по сериям (Номенклатура – Серия – Количество)
- Другим запросом получали таблицу товаров к отгрузке (Номенклатура – Заказ покупателя – Количество).
- Проходил обыкновенный перебор для каждой номенклатуры по принципу «Пока КоличествоКРаспределению > 0 Цикл …….. ».
Т.к. я всегда придерживался позиции, что сам факт перебора на больших объемах данных – это уже само по себе узкое место, то возможность «улучшения» алгоритма перебора я даже рассматривать не планировал. Нужна была альтернатива. Также на тот момент я уже давно набил руку в оптимизации сложных запросов и укрепился в выводе, что нет ни одной задачи, которую нельзя было бы решить исключительно запросом и точно знал, что качественный запрос (пакет запросов) в 99% случаев окажется самым эффективным решением, чем какая-либо пост-обработка результатов запроса. Вопрос оставался только в нахождении этого решения).
Выходил я на перекур с достаточно тривиальным условием задачи (распределить количество по измерениям одной таблицы на количество по измерениям из другой) и 2-мя тезисами:
- Мы имеем 2 таблицы, которые и так собираются запросом
- SQL не знает никакого «Распределить». SQL знает только «больше», «меньше», «равно» (утрированно). Надо дать ему некий параметр для сравнения. Числовой параметр, по которому будет понятно какое количество еще можно распределить в условную строку.
И в этот самый момент, когда я мысленно проговаривал второй тезис, слово «еще» и натолкнуло меня на решение. Далее, рисуя палочкой на снегу, я не успел докурить, как уже побежал пробовать свою гипотезу в консоли запросов.
Рассмотрим ниже простой пример:
У нас есть складские ячейки с количеством вмещаемого в них товара с одной стороны (A, B, C, D) и сам товар (X, Y, Z), который необходимо «как-то» разложить по этим ячейкам, но так, чтоб в ячейку не положили больше товара, чем может быть в ней места.
A – 10 мест
B – 1 место
C – 5 мест
D – 8 мест
X – 13 шт
Y – 1 шт
Z – 4 шт
Результатом должна стать таблица распределения:
A-X-10
B-X-1
C-X-2
C-Y-1
C-Z-2
D-Z-2
Для этого нам надо определить порядок распределения, сделать это оказалось до банального просто:
ВЫБРАТЬ
    Ячейки.Ячейка КАК Ячейка,
    Ячейки.Количество,
    ЕСТЬNULL(СУММА(Ячейки1.Количество), 0) + 1 КАК ПорядокРаспределенияС,
    ЕСТЬNULL(СУММА(Ячейки1.Количество), 0) + Ячейки.Количество КАК ПорядокРаспределенияПо
ИЗ
    Ячейки КАК Ячейки
        ЛЕВОЕ СОЕДИНЕНИЕ Ячейки КАК Ячейки1
        ПО Ячейки.Ячейка > Ячейки1.Ячейка

СГРУППИРОВАТЬ ПО
    Ячейки.Ячейка,
    Ячейки.Количество
Кстати, здесь же можно учесть и порядок распределения, если, например, в какие-то ячейки товар надо класть в первую очередь. Решается изменением условия в соединении.
Тоже самое и с товарами:
ВЫБРАТЬ
    Товары.Товар КАК Товар,
    Товары.Количество,
    ЕСТЬNULL(СУММА(Товары1.Количество), 0) + 1 КАК ПорядокРаспределенияС,
    ЕСТЬNULL(СУММА(Товары1.Количество), 0) + Товары.Количество КАК ПорядокРаспределенияПо
ПОМЕСТИТЬ ТоварыПоПорядку
ИЗ
    Товары КАК Товары
        ЛЕВОЕ СОЕДИНЕНИЕ Товары КАК Товары1
        ПО Товары.Товар > Товары1.Товар

СГРУППИРОВАТЬ ПО
    Товары.Товар,
    Товары.Количество
Для простоты понимания разложу все эти позиции поштучно в таблице и наложу одну на другую в порядке распределения:
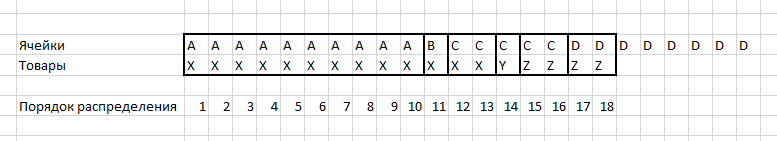
Нам просто нужно написать граничные условия. А теперь осталось просто соединить эти таблицы и получим наш результат:
ВЫБРАТЬ
    ЯчейкиПоПорядку.Ячейка КАК Ячейка,
    ТоварыПоПорядку.Товар КАК Товар,
    ВЫБОР
        КОГДА ТоварыПоПорядку.ПорядокРаспределенияПо < ЯчейкиПоПорядку.ПорядокРаспределенияПо
            ТОГДА ТоварыПоПорядку.ПорядокРаспределенияПо
        ИНАЧЕ ЯчейкиПоПорядку.ПорядокРаспределенияПо
    КОНЕЦ - ВЫБОР
        КОГДА ТоварыПоПорядку.ПорядокРаспределенияС > ЯчейкиПоПорядку.ПорядокРаспределенияС
            ТОГДА ТоварыПоПорядку.ПорядокРаспределенияС
        ИНАЧЕ ЯчейкиПоПорядку.ПорядокРаспределенияС
    КОНЕЦ + 1 КАК Количество
ИЗ
    ЯчейкиПоПорядку КАК ЯчейкиПоПорядку
        ВНУТРЕННЕЕ СОЕДИНЕНИЕ ТоварыПоПорядку КАК ТоварыПоПорядку
        ПО (ЯчейкиПоПорядку.ПорядокРаспределенияС <= ТоварыПоПорядку.ПорядокРаспределенияПо
                И ЯчейкиПоПорядку.ПорядокРаспределенияПо >= ТоварыПоПорядку.ПорядокРаспределенияС)
Сразу оговорюсь, что в запросе умышленно добавлено большее количество полей, чем надо. Можно было бы обойтись и одной границей распределения (нарастающим итогом) и не делать «+1», но как мне показалось – в таком виде это более наглядно для понимания. Оптимизацию запросов мы в этой теме не рассматриваем, поэтому и индексы здесь тоже не описаны. Ну а более сложные алгоритмы распределения (по нескольким измерениям, например) решаются только изменением условий соединения и проверки границ.
Вот и все. В итоге вместо минут ожидания на тех же объемах данных этот запрос выполнялся считанные милисекунды.
Прошу простить за обилие лирики в этой статье. Хотелось дать не математическое решение узкой задачи, а поделиться концептуальным подходом к решению подобных задач, именно ходом своих мыслей. Ну а также сделайте скидку на то, что это первая в моей жизни статья :)
Вступайте в нашу телеграмм-группу Инфостарт
запросы распределение перебор оптимизация серии
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Универсальные функции 1С 8.3 1С:Документооборот Россия Платные (руб)
ДО+ — расширение конфигурации, в котором собран постоянно пополняемый набор из 33 востребованных доработок для 1С:Документооборот КОРП 3.0: согласование задач прямо из мессенджеров MAX и Telegram, отзыв согласования и исполнения, гибкие повторные круги, эскалация с точностью до минут, контроль исполнительской дисциплины, выгрузка вложений в ZIP и склейка PDF, реестр документов в Excel, проверка дублей контрагентов и регистрационных номеров. Каждая возможность активируется отдельным флажком в режиме предприятия — включается только то, что нужно конкретной организации. Список функций расширяется с каждым релизом — текущая версия 2.1.0. Режим AddOn: типовая конфигурация не модифицируется, обновления ДО ставятся штатно, дополнительные лицензии и внешние компоненты не требуются. Внедрение силами администратора — около часа.
30000 руб.
09.07.2026 1440 1 0
Универсальные функции Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Благодаря этим пяти строчкам можно больше не заморачиваться с загрузкой из внешних файлов. Пользуюсь везде, всегда и постоянно.
21.05.2024 68876 dimanich70 87
БСП (Библиотека стандартных подсистем) Сканер штрих-кода Универсальные функции Этикетки, ценники Разработчик Аналитик 1C:Бухгалтерия Бесплатно (free)
Разберем на примерах использование компоненты из БСП для генерации штрихкода и матричных кодов.
15.09.2023 55304 YA_418728146 17
WEB-интеграция Универсальные функции Механизмы платформы 1С Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
При работе с интеграциями рано или поздно придется столкнуться с получением JSON файлов. И, конечно же, жизнь заставит проверять файлы перед тем, как записывать данные в БД.
28.08.2023 32134 YA_418728146 8
Пакетная печать Печатные формы Адаптация типовых решений Универсальные функции 1С:Предприятие 8 1С:ERP Управление предприятием 2 1С:Управление торговлей 11 1С:Комплексная автоматизация 2.х Россия Абонемент ($m)
Расширение для программ 1С:Управление торговлей, 1С:Комплексная автоматизация, 1С:ERP, которое позволяет распечатывать печатные формы для непроведенных документов. Можно настроить, каким пользователям, какие конкретные формы документов разрешено печатать без проведения документа.
2 стартмани
22.08.2023 10322 121 progmaster 23
Инструментарий разработчика Универсальные функции 1С:Предприятие 8 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:Зарплата и Управление Персоналом 3.x 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 2 1С:Розница 3.0 1С:Документооборот Абонемент ($m)
Копирует в буфер значения из списков, из ячеек отчетов, таблиц, настроек списков, других отборов и вставляет в выбранную настройку отбора. Работает с Объект не найден. Работает как в одной так и между разными базами 1С. Использует комбинации [Alt+C] Копировать список, [Alt+V] Вставить список. Также для копирования данных используется стандартная [Ctrl+C] (например из открытого xls, mxl, doc и т.п. файла скопировать список наименований)
1 стартмани
13.10.2022 28750 259 sapervodichka 118
Универсальные функции Механизмы типовых конфигураций БСП (Библиотека стандартных подсистем) Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
В данном материале рассмотрим типовой алгоритм подсистемы контроля учета БСП в конфигурациях на примерах.
18.07.2022 11564 quazare 8
СКД Универсальные функции Разработчик Стажер 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Столкнулся с тем, что мне приходится писать гору отчетов. Во многих приходится использовать повторяющиеся приемы. Решил написать шпаргалку, которая, надеюсь пригодится не только мне. В этой статье: Объединение ячеек в отчете только на определенном уровне иерархии, Постобработка итогов в табличном документе, Скрытие колонок в зависимости от количества месяцев в периоде.
28.05.2022 15282 milkers 11
Вот ссылки:
Популяризировать эти запросы любыми способами можно и нужно, чем больше людей о них узнает, тем лучше.
Поэтому и поставил плюс.
Хорошо понимаю автора: решить эту задачу самому гораздо интереснее, чем найти готовое ранее известное решение.
Но в публикации новизну решения нужно уже оценивать более трезво и ознакомится с тем, что сделано до тебя, будет нелишним.
Теперь по сути:
В данном случае слишком упрощенно и неправильно противопоставлять запросную и внезапросную технику.
Рассуждения "сделаю запросом - так всегда будет быстрее" просто-напросто ошибочные и даже вредные.
Думаю, большой эффект в этом конкретном случае был не потому, что запросом лучше, а потому, что код ("перебор") был очень плохой.
Например, из-за того, что какие-то поля типа коэффициента единиц измерения мелкими запросами в цикле из базы дергались. Или индекса в таблице значений не было.
Эта задача из-за своей природы запросом решается сложнее.
И может выигрывать либо в специфических случаях небольшого количества строк, либо при применении сложных методов ускорения расчета нарастающего итога.
Из-за того, что используются тэта-соединения (целых три штуки!).
В результате время работы запроса может очень сильно (квадратично) увеличиться с ростом числа "ячеек" и "товаров".
В общем, я против крайностей и "универсальных решений", за более взвешенное и обдуманное решение в каждом конкретном случае.
Это ссылки сравниваем?
выбрать "А" как Товар, 111 как Количество
поместить Товары
объединить
выбрать "Б" ....
и т.д.

Была аналогичная задача при закрытии месяца в УПП.
В типовом алгоритме был фрагмент кода, который строил большую таблицу перехода номенклатуры из одного состояния другое. А реализовано это было через "цикл в цикле" по таблице в 20 тыс. строк, что в итоге давало 400 млн итераций, и в свою очередь общее время проведения документа составляло 3-4 часа по каждому из разделов учета (БУ, НУ, УПР).
Здесь даже была статья по этой проблеме и ее решению.
Попробовал решение из статьи - эффект был, но не скажу, что проблема ушла. выигрыш был порядка 10%.
Несколько дней ходил и крутил проблему в голове. Идея, как и у автора текущей статьи, осенила неожиданно.
В итоге переложил типовой цикл на запрос и время его выполнения составило что-то около 3-5 секунд, а общее время проведения документа - несколько минут.
Например, для нумерации данных во временной таблице. Так как в 1С нет подобия ROW_NUMBER, то для нумерации можно соединять таблицу саму с собой с сравнением по Таблица1.Ссылка > Таблица2.Ссылка.
И все хорошо работало.
а то вы только что открытие для меня сделали))
Не обольщайтесь внешним видом.
Выигрыш может быть за счет переноса нагрузки на сервер
Или за счет использования поиска по индексу вместо перебора.
Например, в объектной модели программирования Таблицу значений индексировать командой ДобавитьИндекс и использовать НайтиСтроки(Отбор) вместо Для Каждого Строка ИЗ ТаблицаЗначений.
Статья не плюсовая, а скорее минусовая.
"Хозяйке на заметку": запрос вида "выбрать датавремя(2016,1,1,1,1,30) < 3.14" тоже ошибки не вызовет, однако его целесообразность и практический смысл лично для меня сомнительны)
SQL Server Engine
умеет сравнивать bynary(16) c числами
но
1с8 в запросе к субд заменяет конструкцию типа ссылка > число
на истина ()
и
ссылка < число - на ложь .
прошу еще раз прощения за замечание не по делу.
умеет ли SQL Server Engine сравнивать значения типа UNIQUEIDENTIFIER - точно не знаю. но думаю что умеет.
если будет интересно - потом напишу статью, как используя этот метод, одним запросом на лету собрать движения по партиям в базе 1С Розница > 50 Гб, где партионного учета нет как такового, а задача была сделать такой отчет, не меняя типовую конфигурацию) отчет отрабатывал секунд 10-20 за месяц (10 розничных магазинов, торговля продуктами - в общем движений много).конечно, это уже была модификация данного метода, более оптимизированная, но я бы посмотрел, как бы вы это делали через таблицы значений))
про количество строк - например 1000 пустых ячеек при ячеистом хранении - не редкость. У меня на практике был склад с 50000 ячейками и 15к наименований на них.
обход двух таблиц одним циклом делается достаточно просто. просто вместо "Для каждого" используется "Пока Истина" и две переменных-счетчика.
Вот ссылки:
Популяризировать эти запросы любыми способами можно и нужно, чем больше людей о них узнает, тем лучше.
Поэтому и поставил плюс.
Хорошо понимаю автора: решить эту задачу самому гораздо интереснее, чем найти готовое ранее известное решение.
Но в публикации новизну решения нужно уже оценивать более трезво и ознакомится с тем, что сделано до тебя, будет нелишним.
Теперь по сути:
В данном случае слишком упрощенно и неправильно противопоставлять запросную и внезапросную технику.
Рассуждения "сделаю запросом - так всегда будет быстрее" просто-напросто ошибочные и даже вредные.
Думаю, большой эффект в этом конкретном случае был не потому, что запросом лучше, а потому, что код ("перебор") был очень плохой.
Например, из-за того, что какие-то поля типа коэффициента единиц измерения мелкими запросами в цикле из базы дергались. Или индекса в таблице значений не было.
Эта задача из-за своей природы запросом решается сложнее.
И может выигрывать либо в специфических случаях небольшого количества строк, либо при применении сложных методов ускорения расчета нарастающего итога.
Из-за того, что используются тэта-соединения (целых три штуки!).
В результате время работы запроса может очень сильно (квадратично) увеличиться с ростом числа "ячеек" и "товаров".
В общем, я против крайностей и "универсальных решений", за более взвешенное и обдуманное решение в каждом конкретном случае.
Но по поводу конкретного случая готов поспорить: во-первых в изначальном условии я четко оговорил, что у нас уже есть 2 таблицы, которые мы получаем 2-мя другими запросами. Очевидно, что эти таблицы уже содержат отфильтрованный набор данных.
Это во-первых.
Во-вторых при продумывании своих решений я руководствуюсь именно пониманием как работает движок SQL. В данном конкретном примере, когда мы будем собирать нарастающий итог даже по всей таблице с 1 млн записей, при соединении этой таблицы самой с собой будет не 1000000*1000000 строк (полный перебор SQL), а те же 1 млн строк. SQL при выполнении соединения по ключевому полю руководствуется именно этим индексом, а так как агрегатные функции (в данном случае сумма) очень качественно обрабатываются движком SQL, то учитывая индекс по которому будет организован поиск и использование реквизитов правой части соединения только для расчета агрегатной суммы - SQL умеет хранить нарастающий итог по уже обработанным записям и будет всего 1 проход по этой таблицы - это можно будет при желание увидеть в плане запроса.
Простым языком:
запрос вида
"ВЫБРАТЬ
Ячейки.Ячейка КАК Ячейка,
Ячейки.Количество,
ЕСТЬNULL(СУММА(Ячейки1.Количество), 0) + 1 КАК ПорядокРаспределенияС,
ЕСТЬNULL(СУММА(Ячейки1.Количество), 0) + Ячейки.Количество КАК ПорядокРаспределенияПо
ИЗ
Ячейки КАК Ячейки
ЛЕВОЕ СОЕДИНЕНИЕ Ячейки КАК Ячейки1
ПО Ячейки.Ячейка > Ячейки1.Ячейка
СГРУППИРОВАТЬ ПО
Ячейки.Ячейка,
Ячейки.Количество"
будет стоить не намного дороже, чем даже такой:
"ВЫБРАТЬ
Ячейки.Ячейка КАК Ячейка,
Ячейки.Количество
ИЗ
Ячейки КАК Ячейки
СГРУППИРОВАТЬ ПО
Ячейки.Ячейка,
Ячейки.Количество"
потому что основные затраты ложаться в этом случае на левую часть соединения, на получение данных первый раз. хотя казалось бы.
Опять же, я делаю акцент, что такая незначительная нагрузка при вроде бы большом соединении достигается именно при соединении по сравнению ссылок.
Далее: почему еще запрос быстрее перебора? - да потому что перебор, например, в 1с, и, хотя бы тот же перебор, в SQL - это кардинально отличающиеся по затратам процедуры. нельзя забывать, что 1с - это классический интерпретатор, даже в случае выполнения кода на стороне сервера. И как бы это банально не звучало - каждая новая строка кода - это достаточно сложная операция для сервера (опять же все познается сравнении).
ну а касательно этой задачи - я готов с кем угодно посмотрить, что распределение в запросе для БОЛЬШИХ объемов данных - всегда оптимальней делать запросом. я делаю акцент именно на больших объемах данных, когда речь идет о распределении тысяч строк НА тысячи строк. в остальных же случаях - это место навряд ли потребовало оптимизации и там бы преспокойно жил бы Цикл))
Я не агитирую переписывать все циклы на запросы - я агитирую не делать больших циклов в узких местах ;-)
Это достаточно просто доказать. Просто посмотрев время выполнения запроса в зависимости от числа строк в исходной таблице.
При расчете нарастающего итога:
N Число строк Затрачено миллисекунд
1 1 000 302
2 2 000 998
3 3 000 2 263
4 4 000 3 840
5 5 000 5 971
6 6 000 8 443
7 7 000 12 817
8 8 000 14 846
9 9 000 18 851
10 10 000 23 346
По вашей логике зависимость должна быть линейной и расчет нарастающего итога для десяти тысяч строк должен занять в десять раз больше времени, чем для тысячи, то есть примерно три секунды, а на самом деле расчет занимает двадцать две секунды. То есть зависимость нелинейная, близка к квадратичной, что видно, если построить график.
Но главное, что практические прогоны предлагаемого запроса не показывают его преимуществ по времени выполнения перед работой с таблицами значений ни на каких значениях числа строк! Ни на маленьких, ни на больших. И чем больше число строк, тем хуже и хуже!
Что прямо противоречит озвученным вами выводам.
Вот таблица:
N Метод Число строк Затрачено миллисекунд
1 Скрипт 100 8
2 Запрос 100 48
3 Скрипт 200 8
4 Запрос 200 56
5 Скрипт 1000 37
6 Запрос 1000 716
7 Скрипт 2000 75
8 Запрос 2000 2457
9 Скрипт 10000 379
10 Запрос 10000 52873
11 Скрипт 20000 774
12 Запрос 20000 227231
Посмотрите на результат при двадцати тысячах строк: 0,7 секунд для кода против 227(!!!) секунд для запроса.
Для распределения по таблицам значений использовалась взятая из "Минимализмов" ( функция (задача 7).
Если захотите перепроверить, вот обработка, которой я пользовался:
ВЫБРАТЬ
"A" КАК Ячейка,
10 КАК Количество
ПОМЕСТИТЬ Ячейки
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"B",
1
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"C",
5
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"D",
8
;
//////////////////////////////////////////////////////////// ПоказатьАвтору плюс!
Вы ведь знаете, как на самом деле перераспеделяется нагрузка между сервером 1С и сервером SQL(если не файловая)? Я обеими руками поддерживаю Вашу идею, если быть до конца правдивым.
ВЫБРАТЬ
"A" КАК Ячейка,
3.8 КАК Количество
ПОМЕСТИТЬ Ячейки
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"B",
1.2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"C",
5
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"D",
8
;
//////////////////////////////////////////////////////////// ПоказатьВЫБРАТЬ
"A" КАК Ячейка,
3.8 КАК Количество
ПОМЕСТИТЬ Ячейки
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"B",
1.2
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"C",
5
ОБЪЕДИНИТЬ ВСЕ
ВЫБРАТЬ
"D",
8
;
//////////////////////////////////////////////////////////// ПоказатьСотых для большинства случаев должно хватить. В 1С обычно всё до сотых округляется (кроме курса валюты).
Дано:
Ячейка Количество
A 3,8
B 1,2
C 5
D 8
Товар Количество
x 4,5
у 1,5
z 4
Результат:
A x 3,8
B x 0,7
B z 0,5
C z 3,5
C у 1,5
Я проверил обработку из (31), разница к сожалению большая и она не в пользу запроса. Я по ЗУПу еще помню, этот нарастающий итог не такой уж хороший, под конец года НДФЛ считался дольше чем в начале года (правда как ща не знаю).
Я собственно за то, что СУБД нам отдает данные, а логика выполняется на сервере приложений. Когда логика выполняется на СУБД, этот код со временем превращается в неподдерживаемый хаос.
ВЫБРАТЬ
Ячейки.Ячейка,
СУММА(Слева.Количество) - МИНИМУМ(Ячейки.Количество) КАК КоличествоОт,
СУММА(Слева.Количество) КАК КоличествоДо
ПОМЕСТИТЬ ЛинейкаЯчеек
ИЗ
Ячейки КАК Ячейки
ВНУТРЕННЕЕ СОЕДИНЕНИЕ Ячейки КАК Слева
ПО (Слева.Ячейка <= Ячейки.Ячейка)
СГРУППИРОВАТЬ ПО
Ячейки.Ячейка
;
//////////////////////////////////////////////////////////// ПоказатьИдея запроса вовсе не в целых числах, а в том, чтобы построить друг против друга линейку товаров и ячеек и найти пересечение отрезков на этих линейках.
Вот в этом обсуждении есть картинка: .
Как я был расстроен и опечален, когда немного более подробно изучил T-SQL... Мы здесь с вами изворачиваемся, чтобы посчитать нарастающий итог, таблицы сами с собой соединяем и т.д. А у sql-щиков есть уже "по умолчанию" ранжирование в запросах, расчет нарастающего итога и прочие плюшки - все буквально одной-двумя строками кода... Мечтательно представил, как бы парочку своих мегазапросов переписал на куда как более компактно.... Эх ))))
Есть фура объемом 50 000т. Ее нужно загрузить так , чтобы Суммарная стоимость товара, перевозимого фурой, должна быть максимальной.
Результат должен быть такой:
код партии вес Стоимость
101 10 000 700 000
302 4 000 240 000
601 24 000 2 160 000
602 11 000 990 000
Пробую методом из статьи:
ВЫБРАТЬ
"A" КАК Фура,
50000 КАК Объем
ПОМЕСТИТЬ Фуры
;
//////////////////////////////////////////////////////////// ПоказатьРезультат получается такой:
Партия Вес Стоимость
601 24 000 2 160 000
602 11 000 990 000
501 15 000 880 000
Подскажите, как изменить условия, чтобы получалась максимальная загрузка по стоимости.
Ваш код не очевиден. И тем ценен. Можно сказать, что вначале своей статьи вы описали инсайт (То есть, как на самом деле люди делают открытия - получают новое знание).
А спасибо, потому что Вы решили просто сложную задачу и поделились с нами.
Меня запутало слово порядок в вашем запросе!
Недавно решал похожую задачу:
Вот здесь корректный пример запроса для распределения по ФИФО.
У вас не порядок, а метод ФИФО.
Правила для распределения я не нашел.
У меня задача такая.
Есть таблица 1 колонки ячейка, номенклатура, характеристика, назначение, упаковка, количество
Есть таблица 2 колонки ячейка, номенклатура, упаковка, количество.
И нужно распределить итоги таблицы 2, по данным таблицы 1 с нужным порядком. В частности ФИФО, но с оговоркой.
ФИФО по характеристике, но приоритет над назначением.
Как приоритет делать?
ВЫБРАТЬ
ПересчетТоваровТовары.НомерСтроки КАК НомерСтроки,
ПересчетТоваровТовары.Ячейка КАК Ячейка,
ПересчетТоваровТовары.Номенклатура КАК Номенклатура,
ПересчетТоваровТовары.Упаковка КАК Упаковка,
ПересчетТоваровТовары.Характеристика КАК Характеристика,
ПересчетТоваровТовары.Назначение КАК Назначение,
ПересчетТоваровТовары.КоличествоУпаковок КАК КоличествоУпаковок
ПОМЕСТИТЬ втТовары
ИЗ
Документ.ПересчетТоваров.Товары КАК ПересчетТоваровТовары
ГДЕ
ПересчетТоваровТовары.Ссылка = &Документ
;
//////////////////////////////////////////////////////////// ПоказатьБерем в УТ документ пересчет товара (втТовары). В ТСД попадают обрезанные данные (втТоварыТСД). Для эмуляции действий пользователя уменьшил количество на 1.
Просто распределение я получил.
Ключевой момент был, что в приведенной ссылке используется внутреннее соединение, а оно в нашем случае ничего не вернет. Поэтому пришлось переписать как у вас на левое! Плюс у вас идет прибавление к результату до 1, чего делать не нужно. В итоговом запросе просто надо изменить сравнение с больше равно на больше!
И стоит вопрос как свой порядок настроить, чтобы сначала заполнялись характеристики, которые пришли раньше. Если заполнено назначение, то в первую очередь покрывалось оно и тоже по дате заказа.
Могу привести пример таблички, как есть и как хочется видеть порядок.
Далее возникла проблема когда ТСД возвращает количество больше чем в документе. Оно просто пропадало. Для этого придумал финт через ВТ посчитал максимум таких позиций добавил в первую таблицу этот итог. И затем в конце сравнивал чтобы значение после и итог были равны, тогда в последнюю строку все добавляло.
Проблему с порядком так и не решил.
Пока придумал костыль. Сортировать таблицу 1 до попадания в запрос, тогда получится нужный порядок!
Вот что вышло:
ВЫБРАТЬ
ПересчетТоваровТовары.НомерСтроки КАК НомерСтроки,
ПересчетТоваровТовары.Ячейка КАК Ячейка,
ПересчетТоваровТовары.Номенклатура КАК Номенклатура,
ПересчетТоваровТовары.Упаковка КАК Упаковка,
ПересчетТоваровТовары.Характеристика КАК Характеристика,
ПересчетТоваровТовары.Назначение КАК Назначение,
ПересчетТоваровТовары.КоличествоУпаковок КАК КоличествоУпаковок
ПОМЕСТИТЬ втТовары
ИЗ
Документ.ПересчетТоваров.Товары КАК ПересчетТоваровТовары
ГДЕ
ПересчетТоваровТовары.Ссылка = &Документ
;
//////////////////////////////////////////////////////////// ПоказатьПоменял - на +, чтобы эмулировать избыток товара.
Спасибо за статью!
Столкнулся с похожей задачей, но у меня условия отличались наличием 2-х измерений. В тот момент не смог понять, как это правильно сделать.
Сейчас сел, чтобы разобраться,
Сделал для наглядности обработку, на основании запроса из статьи.
Условие задачи, в моей версии немного по другому звучит.
Есть таблица с номенклатурой с колонками "Номенклатура" и "Количество" - номенклатура, которую нужно распределить.
Есть таблица со складами с колонками "Склад" и "Количество" - склад и количество, по которым можно распределить номенклатуру.
Сделал 3 разных решения под 3 разных случая (рассчитываю, что решения правильно работают, если найдутся неточности - прошу сообщить).
1. По одному измерению в каждой таблице.
2. В первую таблицу добавилось измерение "Характеристика"
3. В первую и вторую таблицу добавилось измерение "Характеристика"
Под 3 разных случая в форме обработки есть страница под каждый случай.
Значения в таблицах сохраняются, для удобства работы.
Обработку прикладываю.
Проверял в пустой базе на платформе 1С:Предприятие 8.3 (8.3.18.1520). Управляемое приложение.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 568299
Создание 16.12.16 09:03
Обновление 16.12.16 09:03
Просмотры 55294
Загрузки 0
Рейтинг
244
Комментарии 52
Код открыт Не указано
Рубрики Математика и алгоритмы Универсальные функции
Кому Разработчик
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)

