Наш путь в Git – история одного внедрения CI/CD
Разработка - DevOps и автоматизация разработки
Меня зовут Алексей Жучков. Я – один из самураев 1С команды банка Тинькофф. Хочу рассказать о том, какой путь мы прошли вместе с командой – с чего начинали и к чему пришли.
Возможно, вы со мной не согласитесь, но у всех специалистов 1С есть общий враг, с которым приходится ежедневно бороться. Я назову этого врага страстями, которые заставляют наших пользователей страдать и тратить часы в ожидании, пока сформируется отчет или проведется документ.
В начале того пути, о котором идет речь, у нас было:
-
2000 отдельных баз 1С на «Бухгалтерии предприятия».
-
Код, который был доработан, находился сразу в основной конфигурации. Кто-нибудь из вас обновлял 2000 баз «Бухгалтерии предприятия»? Можете себе представить, каково это.
-
Мы использовали хранилище, и я не просто так назвал это попоболью. С хранилищем, как вы знаете, много проблем, поскольку оно подразумевает одну ветку разработки и необходимость захвата объектов.
-
Я написал на слайде про родовой призыв, потому что у меня фамилия Жучков, и мы вынуждены были бороться с багами. Делать это тоже нужно было максимально эффективно.
В самом начале пути нам пришлось определиться с тем оружием, которым мы будем сражаться.
Я сейчас не буду проводить детальное сравнение между EDT и конфигуратором, могу лишь сказать, что мы остановили свой выбор на конфигураторе.
Не только из-за его привычной теплой ламповости, но и из-за наличия большого количества прекрасных расширений. Например, Снегопат. Или Турбоконф.
Первый бой
Мы жили с одним хранилищем. Но так дальше жить было нельзя.
-
Мы взяли Jenkins, прикрутили к нему задание, и gitsync-ом начали выгружать весь исходный код из хранилища в Git. В результате мы получили Git, который выгружается из хранилища. И сделали там три ветки: ветку master, которая смотрит на прод; ветку test, ориентированную на тестовый контур; и ветку develop разработчиков, куда изначально выливается все из хранилища. Git-сервер у нас тогда был на Atlassian. И мы настроили себе триггер, чтобы после merge-request’ов из одной ветки на другую автоматически запускались задания, накатывающие конфигурацию ветки на необходимый контур. Это позволило нам разделить разработку на три части.
-
Чтобы не испытывать проблем с обновлениями основной конфигурации, мы вынесли весь код в расширения. Сразу стало намного легче и быстрее деплоить именно те изменения, которые нам нужны. Потому что обновление расширений занимает значительно меньше времени, чем обновление всей измененной конфигурации.
-
Но этого было недостаточно. 2000 баз – это серьезный вызов. Здесь тоже нужно было что-то сделать. Нам повезло, ведь мы не первые столкнулись с такой проблемой – в самой фирме «1С» давным-давно успешно победили ее при помощи разделителей. Мы включили разделение данных для своих баз и смогли из 2000 баз сделать 14. Нам понравилось такое количество, оно было удобно в использовании – использование 14 баз значительно снизило и нагрузку на дисковую подсистему, и нагрузку на сервер 1С.
-
Мы решили дальше развивать наш начинающийся успех на пути к Git, который был нашей целью.
После первой итерации мы столкнулись с тем, что у нас возникли вопросы. Как быть? Что делать? Куда идти дальше? Что смотреть?
И мы встретили прекрасного человека, которого многие из вас знают. Это Алексей Лустин, который вертит планеты на своем пальце. Он многое знает, и он рассказал нам о разных технологиях и стеках. Мы долго и упорно разбирали всю эту информацию. По секрету скажу, до сих пор не разобрали еще. Уже почти год прошел. Но выводы для себя сделали.
Второй бой
Ко второму сражению мы подошли уже более вооруженными и защищенными.
-
Один из основных принципов, которого мы придерживались при разработке – это Feature Driven Development. Нам важно и нужно было, чтобы каждая конкретная фича могла быть доставлена на контур в любой момент времени вне зависимости от того, находится она ниже по ветке, выше, сбоку, рядом. Git все это позволял сделать, но у нас его пока еще не было в полном виде.
-
Мы познакомились с большим количеством прекрасных модулей OneScript. Мы разные модули, все это вложили в голову нашего прекрасного Никиты Иванченко и собрали комплект скриптов на OneScript. С их помощью мы могли выгружать конфигурацию в текстовые файлы и помещать ее в Git. Также мы научили наши скрипты обратному процессу – выгружать конкретную ветку из Git и заливать ее в конфигурацию, конфигуратор.
-
Чтобы унифицировать и формализовать процесс, мы познакомились с технологией SubModules Git. Прекрасная технология, которая позволяет подключать репозитории со всеми нашими скриптами непосредственно как подмодуль текущего репозитория Git.
-
И о хуках, конечно. Многим из вас знакомы хуки Git. Некоторые используют precommit1c или precommit4onec. Мы смогли пойти немного дальше – мы узнали о том, что, кроме pre-commit хука, есть еще хук post-checkout.
Все это привело к тому, что на текущий момент мы смогли полностью отказаться от хранилища.
Сейчас с каждой новой фичей разработчики работают в своих отдельных ветках. Чтобы забрать необходимую ветку из Git в базу, разработчику достаточно в любом комфортном ему Git-клиенте или командной строке просто выполнить команду checkout. При этом post-checkout запускает ряд скриптов, которые завершают сеансы, собирают конфигурацию и заливают ее в нужную целевую базу. В результате разработчик получает у себя в базе разработки конфигурацию из Git.
Обратный процесс работает на pre-commit – после того, как разработчик завершает работу над конфигурацией в конфигураторе, он просто делает commit и pre-commit скрипт выгружает эту конфигурацию в файлы и коммитит ее в Git со всеми изменениями.
Мы связали весь процесс и подключили в него Jira, Sonar и систему тестирования.
Один против 1С не воин
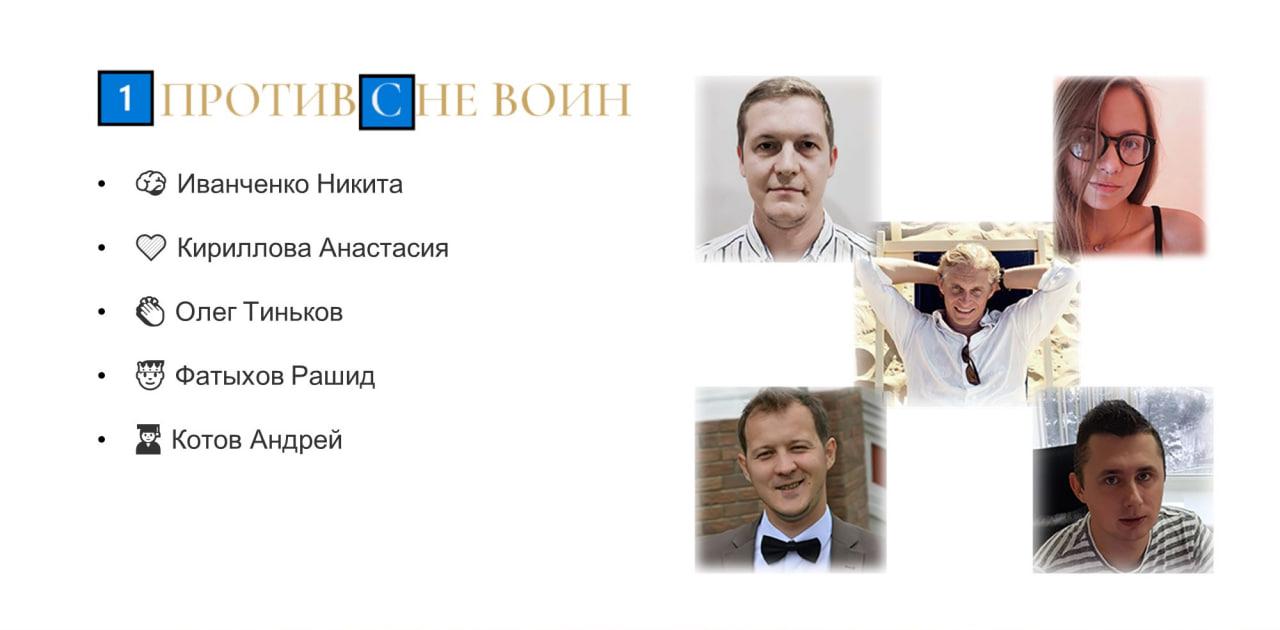
Хочу рассказать о том, кто мы, и как все это происходило. На слайде – наша команда, потому что в одиночку со всем этим справиться просто было бы нереально.
-
Иванченко Никита – наш ведущий разработчик, он готов сейчас вместе со мной ответить на ваши вопросы.
-
Кириллова Анастасия отвечает за наше тестирование.
-
Фатыхов Рашид – прекрасный профессиональный разработчик и тестировщик.
-
И Котов Андрей – наш самый юный разработчик.
-
Я добавил сюда и Олега, потому что в процессе развития этой истории я действительно прошел большой путь. От человека, который был готов разрезать свою карту Tinkoff и выкинуть ее, до человека, гордого тем, что он работает именно в Tinkoff.
Мы не остановимся на этом пути и будем идти дальше. У нас есть очень много интересных вызовов.
-
Мы любим ClickHouse – нам нравится загружать в него данные и работать с ними быстро и качественно. Мы хотим научиться прозрачно переносить данные из 1С в ClickHouse и обращаться к ним из 1С таким образом, чтобы они хранились только в ClickHouse.
-
Также у нас есть планы по автоматизированному тестированию. Мы уже придумали, как сделать так, чтобы написание тестовых сценариев не требовало привлечения разработчика – чтобы их делали сами пользователи.
-
Ну, и про чудеса пространств 1С – это история про то, как мы уже сейчас научились выгружать отдельные справочники из 1С в Git и вести их там.
Вопросы
Вы рассказали, что, когда делаете checkout в Git-клиенте, исходный код скриптами загружается в конфигуратор. А что происходит при коммите?
Сейчас, когда нам нужно сделать для себя ветку под разработку конкретной фичи, мы делаем checkout. И скрипт post-checkout загружает текстовые файлы конфигурации в информационную базу разработчика – сведения о настройках этой базы хранятся в отдельном файле, который находится в .gitignore.
Причем скрипт post-checkout’а заканчивается тем, что в репозиторий вносится небольшое изменение – мы специально кладем в него временный файлик, чтобы Git видел, что там есть какие-то изменения.
И когда разработчик готов сделать коммит, он делает его средствами Git на этих изменениях – pre-commit-скрипт удаляет этот временный файлик, выгружает конфигурацию из базы 1С в текстовые файлы, и делает из нее коммит.
Когда это происходит? В конце? Например, разработчик много раз обновлялся, протестировал это у себя и решает сделать коммит. Когда он переходит в Git-клиент, у него уже будет все готово?
Если у него в 1С есть сохраненная конфигурация, которую он хочет выгрузить в Git, то у него все готово. Он просто делает коммит, конфигурация выгружается в текстовые файлы и отправляется в Git.
Когда ребята помещают коммиты, у вас бывают конфликты при мержах? Как вы потом сливаете ветки и эти конфликты разруливаете?
Единственная проблема – это мерж форм. Мы пока не придумали, как делать мерж форм в XML эффективно и качественно. Поэтому мы пока договорились, что разработчики над одними и теми же формами не работают.
А слияние текстов – если не получается реализовать это автоматически посредством самого гита, то есть прекрасные мерж-инструменты, которые позволяют это сделать уже на клиенте.
У нас получился очень негативный опыт работы с подмодулями. Причем нас предупреждали, мы не послушались и потом получили серьезные проблемы. У вас нет проблем с подмодулями?
Были определенные сложности с кодировками и с относительными путями. Но сейчас я могу сказать, что процесс работает эффективно, и у нас нет никаких проблем с подмодулями.
А как вы распространяете хуки, чтобы их положить в репозиторий?
Пока мы эти хуки кладем в репозиторий руками. Но вообще хочется сделать, чтобы при инициализации подмодуля хуки прилетали автоматически. Мы этого пока не сделали, сейчас над этим работаем.
Пока хуки прописываем руками – там два файлика скопировать.
Вы говорите, что загружаете изменения в конфигурацию при post-checkout. А в pre-commit вы выгружаете изменения обратно. Вы выгружаете всю конфигурацию?
Да, мы работаем в расширениях, они не такие большие.
А как вы боретесь с мусорными файлами? Или разработчик должен вручную проверить каждый файл на соответствие изменениям?
Так как мы работаем с расширением, мы не работаем с большими конфигурациями, потому что это больно и неохота. А расширение загружается и выгружается в течение минуты, каким бы большим оно ни было.
Так как там есть набор скриптов, все мусорные файлики подчищаются. Всегда полная выгрузка, загрузка, но это не проблема, потому что она достаточно быстрая.
У нас были идеи, как реализовать загрузку большой конфигурации побыстрее. Когда у тебя в Git лежит большая конфигурация, можно посчитать diff между коммитами – какие файлы нужно загрузить. Мы пытались это дело автоматизировать – генерили небольшой текстовый файл, который содержит в себе список того, что было изменено от коммита A до коммита B. И пытались подсовывать этот файл как дополнительный параметр.
Когда загружаешь конфигурацию, там можно передать xml-файлик, который указывает, какие файлы нужно загрузить. Но эта штука себя не оправдала, потому что даже если загружать очень мало, конфигурация все равно загружается долго.
И там еще были подводные камни, связанные с самими проблемами в платформе. Допустим, если ты указываешь загрузить только XML-ку по обработке, эта загрузка падает. Нельзя какую-то часть загрузить – нужно всю обработку целиком загружать.
Мы пытались эти подводные камни обойти, обошли, но в итоге все равно загружается долго.
Вы сказали, что выгружаете в Git справочники – это некий аналог MDM или для чего это делается?
У нас есть два вида справочников, которые нам нравится быстро обменивать между собой в нескольких базах.
Один вид справочников связан именно с бизнес-логикой, которая помогает конфигурации при определенных автоматических работах обрабатывать входящие документы из миллиарда других систем. Он очень простой в плане своей структуры, там не так много реквизитов и нет тяжелой ссылочной связанности. Поскольку нам нужно доставить эти данные в очень большое количество баз, мы написали отдельное небольшое расширение, которое нацеливается на определенный универсальный набор справочников и на папку. И при каких-то изменениях постоянно эти данные туда-сюда либо загружает, либо выгружает. Эта папочка очень хорошо ложится текстом в Git, что позволяет выгружать эти изменения в разные ветки и разные контуры. В одной ветке поработали, в GitLab сделали мерж-реквест, данные упали в другую ветку и база сразу себе все это забрала.
И второй вид справочников – это часть служебной конфигурации, которая помогает обрабатывать вот этот весь зоопарк на проде и на тесте. Условно, это набор алгоритмов, который нужен для того, чтобы обработать этот большой объем. На тесте разработчики обкатали, записали справочник, он автоматом упал в Git. И через мерж-реквест эти файлы перетекают в справочники других баз.
Я так понимаю, у вас достаточно серьезные требования к людям, которые работают. Вы сразу нанимаете со знанием Git? Или у вас какое-то обучение есть? И как у вас люди вообще соглашаются изучать Git?
Изначально вся эта каша была заварена, в том числе, для того, чтобы облегчить вход в Git для тех, кто с ним никогда не работал.
Мы изо всех сил старались максимально убрать необходимость знания Git, понимания команд, принципов его структуры, чтобы максимально автоматизировать процесс.
Сейчас получается, что мы можем нанять разработчика без знания Git, дать ему знания о том, как у нас выглядят ветки, и как работать с ними в Git-клиенте.
Это принудительное обучение? Он без этого не сможет работать?
Большинство основных вещей, которые нужны будут для текучки, можно освоить по роликам на YouTube за полтора-два часа. А потом ты возьмешь Git Pro и будешь ее два года читать, а через два года все равно не будешь всего знать.
Я в начале говорил, что мы боремся со страстями, и сейчас для нас релизный цикл – это просто удовольствие.
Раньше у нас эти базы обновлялись неделями, а сейчас у нас сборка запускается, и в параллель одновременно обновляются все базы – очередью, какую мы сами зададим (зависит от того, как мы сейчас хотим).
Вечером запускаем мерж-реквест, который стартует в Jenkins, все собирается, а мы спокойно идем спать. А утром встаем, и смотрим, что у нас все хорошо, все базы обновлены.
Раньше мы были на Jenkins с выгрузкой в Bitbucket. Потом перешли на GitLab, но остались на раннерах Jenkins. Сейчас у нас GitLab стреляет на Jenkins через curl с определенными параметрами на каждом репозитории, и запускает с ними джобы в Jenkins – там есть специальные JSON-файлы, которые знают, что, куда и в какой последовательности загружать.
Как готовятся тестовые данные? Вы берете базу с продуктива или какую-то изначально подготовленную? Как и кем тестируются эти данные? Вы разработали расширение, выгрузили его в XML, и кто потом тестирует все эти изменения? И какую систему учета задач вы используете?
Мы используем Jira.
Тестовые данные частично продовые, частично сгенерированные.
Продовые данные – это, скорее, какие-то частные случаи, которые вдруг случились на проде и что-то сломали. И мы их себе как эталон перенесли, чтобы это учитывать и 1С нам каким-нибудь обновлением это не сломало.
Плюс мы сейчас разрабатываем отдельный фреймворк на Python, который позволяет тестовые данные генерить автоматически. Он, во-первых, генерирует данные для тестирования в 1С, в потом запускает 1С и дергает ее там за определенные рычаги, используя Vanessa, и все тестирует. И прям в онлайн режиме, пока это тестируется, результаты уже падают в Allure.
Что входит в вашу инфраструктуру? И как вы накатываете обновления? Файлом поставки?
У нас типовые конфигурации «Бухгалтерия предприятия» и «Зарплата и управление персоналом». Есть одна самописная нетленка, которая помогает всем этим рулить, и свой менеджер 1cfresh.
Мы не делаем поставку – сразу из файлов собираем конфигурацию и накатываем в базу. Конфигурации поставщика мы обновляем cf-никами, а наши изменения в расширениях собираем из исходников.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции Infostart Event.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

