Как правильно настроить MS SQL сервер для работы с 1С
База данных - HighLoad оптимизация



1. Настройка сервера
Во-первых нам нужен только сервер, остальные службы, которые к нему относятся и возможно кто-то ими пользуется, нам только тормозят работу. Останавливаем и отключаем такие службы, как FullText Search (у 1С собственный механизм полнотекстового поиска), Integration Services и иже с ними.
Оставляем только:
SQL Server (sqlservr.exe)
SQL Server Agent (SQLAGENT.exe)
SQL Writer (sqlwriter.exe)
Далее в свойствах сервера, через Server Management Studio устанавливаем:
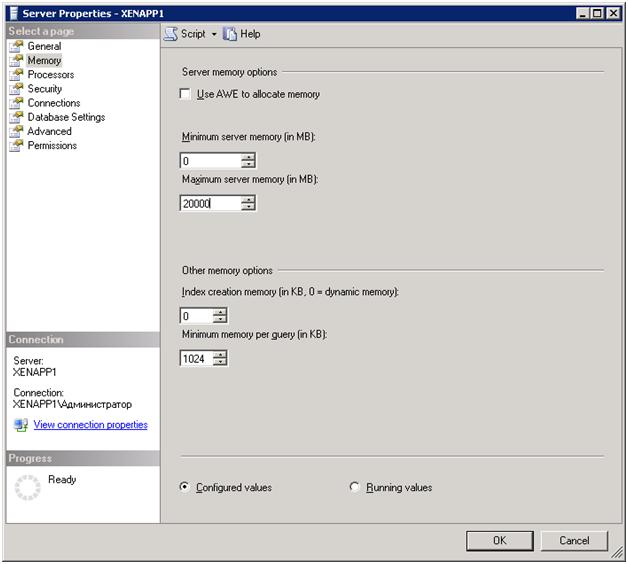
Максимально отведенное серверу количество памяти из расчета:
[Общее количество оперативной памяти сервера] – [4ГБ под систему(2ГБ если Win2003)] – [1,5 ГБ * количество процессов rphost (если SQL и 1С на одном сервере вращаются.)] Например если у нас на сервере всего 36 ГБ оперативной памяти, стоит Windows 2008 и запущено 8 процессов rphost то рассчет идет так: 36 - 4 - 1.5*8 = 20 ГБ ставим ограничение для SQL.
Это необходимо для того, чтобы sql сервер рассчитывал на этот объем и чистил память заблаговременно, т.к. если поставить неограниченный объем, и сервер попробует получить память, которой нет, он начинает крепко задумываться над своим поведением и крайне медленно отвечать на запросы.
Далее:

Максимальное количество потоков (Maximum worker threads) ставим 2048, по умолчанию стоит 0 и с таким значением сервер не создает больше 255 потоков, а этого ему не хватает (установлено опытным путем, что при большом количестве одновременных транзакций сервер реально начинает быстрее работать). Также выставляем галку повышенного приоритета сервера (Boost priority).
Собственно с глобальными настройками все. Теперь переходим к настройкам рабочей базы данных (или нескольких баз, если такое имеет место быть).
2. Настройка рабочей базы данных
Заходим в свойства нужной нам базы данных:
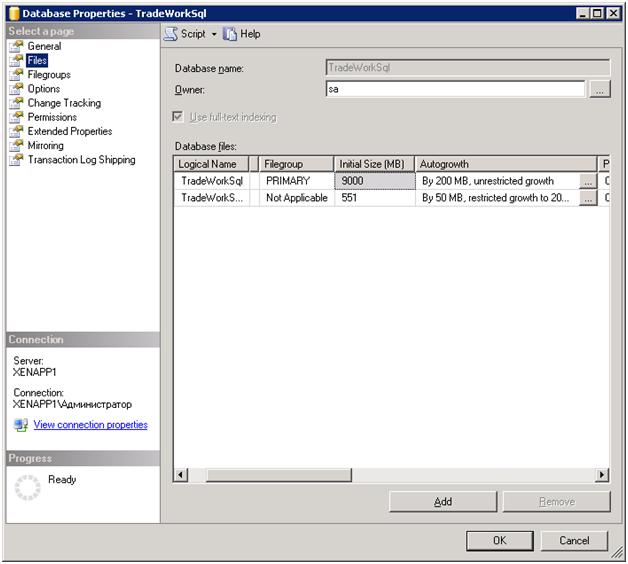
Если база еще не развернута из .dt файла, и вы знаете примерный ее размер, то первичному файлу размер инициализации лучше сразу указать >= размера базы, но это дело вкуса, он все равно вырастет при развертке. А вот Автоувеличение размера надо обязательно указать примерно по 200 МБ на базу и по 50 МБ на лог, т.к. значения по умолчанию – рост по 1МБ и по 10% очень сильно тормозят работу сервера, когда ему при каждой 3й транзакции надо файл увеличивать. Также, если не используетет RAID массив, то хранение файла базы и файла лога лучше указать на разных физических дисках. Ну и ограничить лог 2-4 ГБ, чтоб сильно не пух.
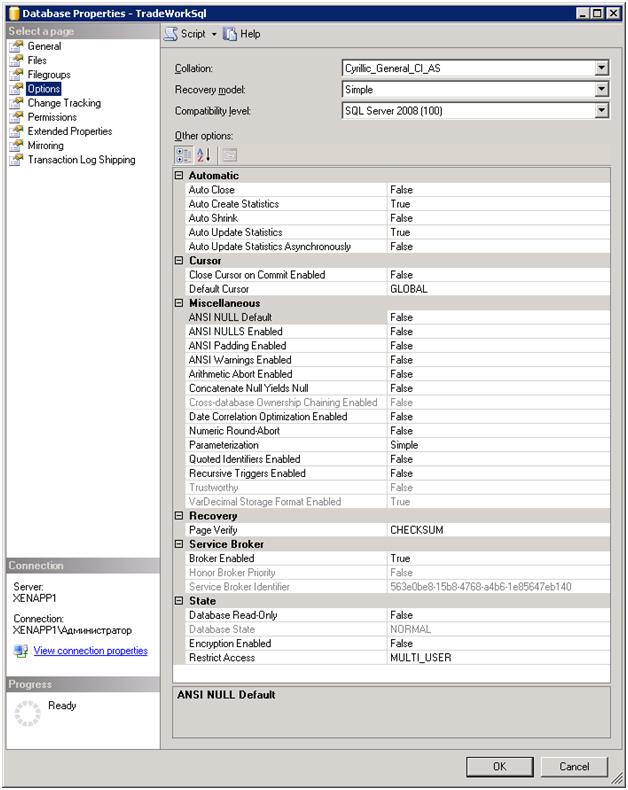
Остальные настройки как на скришоте:
С настройками базы все. Осталось настроить регламентные задания.
3. Настройка регламентных заданий
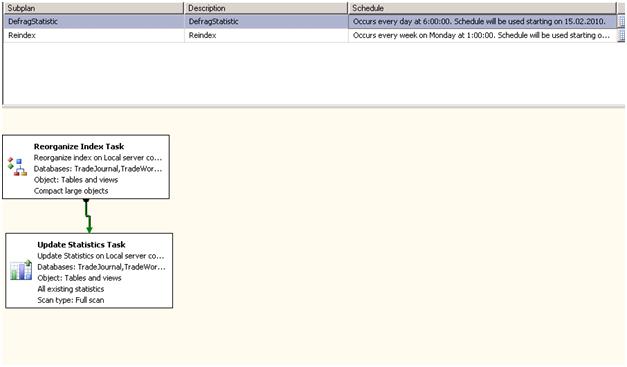
Сначала создаем Maintenance Plan в разделе Management:
Дефрагментацию индексов и сбор статистики нужно производить ежедневно, т.к. если фрагментированость индексов > 25%, это резко снижает производительность сервера. Дефрагментация и обновление статистики делается быстро и не требует отключения пользователей. Насколько ваши индексы фрагментированы можно посмотреть очень хорошей и многофункциональной обработкой Гилева Вячаслава, с названием Lock1C.epf, и которую он убрал со своего сайта из-за наезда 1С-ников за нарушение какого-то пункта лицензионного с., но хорошему админу гугл всегда в помощь J . Также желательно делать полную переиндексацию, с блокировкой БД, хотя бы раз в неделю, естественно после полной переиндексации сразу же делается дефрагментация индексов и обновление статистики.
Настройка бэкапа средствами SQL.
Ту все просто, добавляем 2 новых задания Agent'у:
Full BackUp, с периодичностью 1 раз в сутки и 2мя шагами T-SQL скриптов:
1. BACKUP DATABASE [<ИмяБД>] TO DISK = N'<ПутьКПапке>\Backup\<ИмяБД>.bak' WITH NOFORMAT, INIT, NAME = N'<ИмяБД>-Full Database Backup', SKIP, NOREWIND, NOUNLOAD, STATS = 10
GO
2. USE [<ИмяБД>]
GO
DBCC SHRINKFILE (N'<ИмяБД>_log' , 0)
GO
И второе задание с периодичностью 1 раз в 1-2 часа Differencial BackUp и с одним T-SQL скриптом:
BACKUP DATABASE [<ИмяБД>] TO DISK = N'<ПутьКПапке>\Backup\<ИмяБД>Diff.bak' WITH DIFFERENTIAL , NOFORMAT, INIT, NAME = N'<ИмяБД>-Differential Database Backup', SKIP, NOREWIND, NOUNLOAD, STATS = 10
GO
Такой бэкап делается, даже при активной работе пользователей, 4-6 минут и практически не сказывается на быстродействии сервера.
Да, и добавим очистку процедурного после переиндексации (раз в неделю), в задание, кторое у же появилось в агенте после сохранения Maintenance Plan добавляем еще один шаг:
DBCC FREEPROCCACHE
GO
Не забыв поменять в настройках первого шага после завершения не выходить, а перейти к следующему. Спс gilv за подсказку.
Вот, собственно, и все. По поводу бэкапа средствами 1С: //infostart.ru/public/65849/ - Full BackUp и выгрузку 1С можно делать одновременно.
Database Compression Tool
Инструмент для свертки и сжатия баз данных 1С
Доступна демо-версия с прогнозом результата
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
HighLoad оптимизация Разработчик 1С 8.3 1С:ERP Управление предприятием 2 Бесплатно (free)
Использование оператора «В» для полей или данных составного типа (например, Регистратор) может приводить к неочевидным проблемам.
10.11.2025 15884 ivanov660 48
HighLoad оптимизация Разработчик 1С:Предприятие 8 1C:ERP Бесплатно (free)
Приведем примеры использования различных в динамических списках и посмотрим, почему это плохо.
18.02.2025 16491 ivanov660 39
HighLoad оптимизация Системный администратор Разработчик 1C:ERP Бесплатно (free)
Не всегда индексирование с дополнительным упорядочиванием полезно.
04.02.2025 15134 ivanov660 21
HighLoad оптимизация Разработчик Россия Бесплатно (free)
А вы знали, что сервер 1С при соединении с базой на сервере PostgreSQL самостоятельно устанавливает некоторые параметры? Это важно знать при настройке сервера и отладке долгих запросов. Предлагаю разобраться.
27.08.2024 10402 soulner 10
HighLoad оптимизация Технологический журнал Системный администратор Разработчик Бесплатно (free)
Обсудим поиск и разбор причин длительных серверных вызовов CALL, SCALL.
24.06.2024 19125 ivanov660 13
HighLoad оптимизация Разработчик 1С:Предприятие 8 Бесплатно (free)
Метод очень медленно работает, когда параметр приемник содержит намного меньше свойств, чем источник.
06.06.2024 24976 Evg-Lylyk 73
HighLoad оптимизация Механизмы платформы 1С Системный администратор Разработчик Стажер 1С:Предприятие 8 Бесплатно (free)
Сравним «Регистры сведений» с «Сервисами интеграции» и узнаем, кто быстрее!
28.03.2024 14632 dsdred 27
HighLoad оптимизация Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Анализ простого плана запроса. Оптимизация нагрузки на ЦП сервера СУБД используя типовые индексы.
13.03.2024 14615 spyke 29
Преамбула: (из анекдота) "Ты не выделывайся. Пальцем покажи!"
Фабула: Если нет возможности/сил/желания идти вашим 10тилетним путём, то какой приговор вы нам, простым смертным, даёте? Иными словами, если мы не участники Формулы-1 и не стоит вопрос о тюнинговании базы данных на молекулярном уровне, можете дать усредненный рецепт по открыживанию настроек с минимальным пояснением "почему так выставили зажигание"?
Послесловие: можно не делать бакап журнала и при этом знать, почему это не делаем!
некоторые регламенты нужно делать не зависимо от того "как кому то хочется работать"
вы что бэкапы к примеру не будете делать из-за того что 24х7 ? ну-ну
если у вас за ночь не успевает дефрагментация - значит вам надо перепроектировать структуру хранения данных, обрезать периодически базу, увеличивать скорость записи дисков и другие элементарные действия, а не ныть
(16) Если у вас rphost'ы максимум по 500 МБ отъедают памяти в процессе работы, то столько им и оставляйте. Сдесь взято по максимуму и у нас они действительно по столько иной раз занимают (правда не видал, когда все одновременно, но чем чорт не шутит...)
необходимо также настраивать размер и log базы tempdb
Размер этой базы должен составлять от 25% до 40% самой большой базы данных
Лучший вариант размещения базы данных tempdb – на отдельном диске или дисковом массиве RAID0 (эта база данных не нуждается в восстановлении).
Приращение лога для temdb - обязательно не в процентах.
Просто эта цифра 25-40% это как общая рекомендация.
Точное значение надо подбирать индивидуально для каждого сервера.
Если есть какая нибудь методика то с удовольствием с ней познакомился бы.
Тут как всегда компромис чем больше размер тем лучше. Но дисковое пространство сервера как правило очень дорогой ресурс и его надо как-то ограничивать.
Как выставлять приращение log для tempdb точно не знаю но желательно чтобы sql
делал это редко.
Ставя явно 4096 Вы резервируете для sql сервера пул рабочих процессов.
Если общее количество подключений к серверу меньше этого числа то каждому подключению выделяется свой рабочий поток иначе для коннекта назначается поток из пула.
Т.е если к примеру у Вас общее число подключений к серверу меньше 2000 то 4096
ставить неправильно так как каждый рабочий поток резервирует память ( об этом косвенно говорит и тот факт что для изменения параметра нужна перестартовать sql сервер).
Как действует значение 0 точно не скажу это надо отдельно разбираться взависимости от
(select @@version) версии sql (2000,2005,2008)
Я исхожу из своих знаний на основе sql200,sql2005 Как резервируется память
под это дело в sql2008 я точно не знаю ( думаю что также)
Также надо учитывать и возможности сервера.Предположим что конкретный сервер не может одновременно обслуживать более 3000 потоков. В таком случае ставить 4096 тоже бессмысленно.
Про значение 0
В sql2000 это равно 255 рабочим потокам
В sql2005 ( и наверное sql2008 ) 0 означает что sql сервер сам по внутреним алгоритмам динамически меняет количество рабочих процессов. Для каких то нагрузок это может и хорошо для каких-то не очень хорошо.
При любых других (не 0 ) значениях я считаю что память под рабочие процессы выделяется статически при старте sql сервера.
и как правило не рекомендуют ставить значение больше 5.
Фишка в том что при большом распаралеливании sql начинает слишком много времени тратить на само планирование и разбиение запроса вместо его выполнения
и общая производительность падает вместо ожидаемого роста.
Ничего подобного.
Опция Maximum Degree of Parallelism - работает с устройствами, а не параллелит обработку данных по нитям процессов.
И поэтому рекомендуют как раз исходить из количества рабочих процессоров и так выставлять Maximum Degree of Parallelism, чтобы некоторое их количество оставалось не занятыми для других дел, если SQL вдруг решит распараллелить какую-то задачу и нагрузить процессоры.
Вот поэтому и падала производительность - все процессора занримались для некоей "параллельной" обработки.
(27)
0 - это максимальный параллелизм. В тестовых "забегах" максимальное использование ресурсов процессоров для получения блоков данных параллельно эффект дает, а в реальной работе - нет. И все благодаря использованию 1С-сервера.
Почему - смотрите выше.
А вообще - для настройки и администрирования SQL администратору нужно читать по каждому параметру отдельно, что, зачем и почему. Или ставить все по умолчанию.
Файл базы у нас падал, и мы его никак не смогли восстановить. Пришлось поднимать базу из бэкапа, перед этим скопировав базу с логом на тестовый сервер... Для аттача этой базы никакие шаманские действия не помогли. Скачал утилиту от MS, которая, типа, битые базы поднимает, она за неделю 50% файла обработала, при том на каждой второй операции сообщала об ошибке... Остановил процесс за ненадобностью.
Сервер 1С находится вместе с сиквелом?
почему минимум = 0?
наверно слишком пафосно "правильная настройка", скорее "настройка для случая Х"
еще многе зависит от операционки, разрядности и т.п.
вцелом труд в правильном направлении сделан, хотя некоторые выводы необоснованы
Да, сейчас 1С и SQL вместе находятся. До недавнего времени на разных машинах висели, но настройки оптимальные были такими-же...При переносе SQL на сервер, где 1С вращается, производительность чуть-чуть возросла, хотя сервера были по мегабитному каналу связаны.
Насчет разрядности вы правы, на 32х все равно больше 4 ГБ оперативы не увидит операционка, и тут уже смысла нет память ограничивать, или 3-3,5 ГБ ограничение ставить, т.к. ее итак нет.
- в этом вы не правы. Серверная x32 ОС видит больше 4 Гб памяти, для того чтобы SQL-сервер мог адресоваться к памяти выше 4 Гб необходимо включить AWE (см. скриншот 1)
Ну увеличивает. А как это сказывается (в цифрах и фактах пожалуйста).
Да, сейчас 1С и SQL вместе находятся. До недавнего времени на разных машинах висели, но настройки оптимальные были такими-же...На счет настройки памяти не соглашуюсь. На отдельно стоящем сиквеле и совмещенном настройки памяти разные.
Опять таки, зачем на отдельно стоящем скуле вообще приоритет повышать.
При переносе SQL на сервер, где 1С вращается, производительность чуть-чуть возросла, хотя сервера были по мегабитному каналу связаны.
Сколько сетевух на сервере? Может быть пора посмотреть 10гигабитку.
К тому же не всегда есть возможность и целесообразность совмещать.
А то Вас тут почитают и таких дров наломают.
Но это так, непринципиальная критика. Просто не хотелось бы рядом с дельными советами видеть "отсебятину". Т.е. лучше меньше советов, но максимально дающих эффект.
а по делу- по комментируйте(дело было в понедельник 15 февраля), что и как вы по Вашей схеме будете восстанавливать:
ЗАГОЛОВОК: Microsoft SQL Server Management Studio
------------------------------
Не удается вывести требуемое диалоговое окно.
------------------------------
ДОПОЛНИТЕЛЬНЫЕ СВЕДЕНИЯ:
Не удается вывести требуемое диалоговое окно. (SqlMgmt)
------------------------------
SQL Server обнаружил логическую ошибку ввода-вывода, связанную с согласованностью: неверный идентификатор страницы (ожидаемый 1:712; фактический 0:0). Она произошла при прочитать страницы (1:712) в базе данных с идентификатором 4 по смещению 0x00000000590000 файла "C:\Program Files\Microsoft SQL Server\MSSQL.1\MSSQL\DATA\MSDBData.mdf". Дополнительные сведения см. в журнале ошибок SQL Server и журнале системных событий. Это серьезная ошибка, которая угрожает целостности базы данных и должна быть немедленно исправлена. Выполните полную проверку базы данных на согласованность (DBCC CHECKDB). Эта ошибка может быть вызвана многими причинами; дополнительные сведения см. в электронной документации по SQL Server. (Microsoft SQL Server, ошибка: 824)
Чтобы получить справку, щелкните:
------------------------------
КНОПКИ:
ОК
А восстановление заняло 5 минут. Всего лишь упал Log у Master.
Какой переезд на другой сервер, какой ребут, я же писал магазин, работающий 24 часа
А вообще по жизни, был хороший ресурс, но теперь для поднятия рейтинга постят ВСЕ. Хорошо если читает грамотной, он разберется ,что к чему, а новичек, прочтет сделает по данной схеме получит геморой в лучшем случае или увольнение после очередного падения сервера
Читайте и думайте.
Ресурс стараемся поднимать, статья впервую очередь была написана как хорошая тема для обсуждения, для того, чтобы народ делился опытом. Если можете какие-то тезисы опровергнуть, то говорите. Если можете написать лучше - пожалуйста. Здесь я ни одной подобной статьи не встречал, вот и решил написать.
ты хотя бы понимаешь, что удаляешь скомпилированные запросы этим ?
надо просто понимать рекомендации, а не только тупо их выполнять
если объем данных изменяется не сильно, то очистка процедурного кэша скорее зло, так как скулю придется компилировать запрос заново
именно поэтому у админов есть термины типа "прогретый кэш", потому что все необходимые данные подняты в кэш и скомпилированы запросы
т.е. при первом запуске когда кэши "холодные" запросы исполняются дольше
резюмирую: процедурный кэш надо чистить не ради чистки, а если вы видите что система очень сильно загруженно и очитска кэша ускоряет общую производительность (т.е. когда заново скомплированный запрос работает с новыми условиями типа статистики, объемов строк, индексами и т.п.)
перестройка индексов - это удаление индекса и создание его заново.
После этой процедуры дефрагментировать дополнительно нечего, уже все упорядочено в момент создания.
Молодец! и даже
Критерий оптимальности указал!!!:
1. MS SQL для круглосуточной работы
2. более, чем 200 пользователей одновременно
Все ясно и понятно если MS SQL для круглосуточной работы И более, чем 200 пользователей одновременно ----> пользуйся этой статьей.
вот куда правильней называется "регламентные операции", а не как правильно делать регламентные операции :)
то что я считал нужным расказать публично, я выкладываю на свой сайт gilev.ru
все что считаю конкурентным преимущество, я "продаю" на курсах или ввиде консалтинговых услуг
но если кто сомневается, что скуль просядет на 1000 юзерах, попробуйте сами...
Надеюсь, не путаете меня с однофамильцем
Вроде неплохие базовые настройки, плохо конечно, что без описания почему-куда, тут gilv верно отметил.
Я обычно взвожу этот флаг.
Кстати, встречалась информация, что связка WinServer2008+MSSQL2008R2+1C8.1 (да и 8.2) дают значительно большие тормоза, чем более ранние версии скуля и винды. Даже тесты делались, дважды тестировали на одном железе, но с разным софтом:
1
Win2003 (32bit) + SQL 2005
Первый тестовый запуск 3:30
Второй тестовый запуск 2:30
2
Win2003 (32bit) + SQL 2005 + оптимизации
Первый тестовый запуск 3:30
Второй тестовый запуск 2:30
3
Win2008R2 + SQL 2008 + 1C x64
Первый тестовый запуск 5:30
Второй тестовый запуск 4:30
4
Win2008R2 + SQL 2008 + 1C x86
Первый тестовый запуск 5:30
Второй тестовый запуск 4:30
5
Win2008R2 + SQL 2005 + 1C x64
Первый тестовый запуск 5:20
Второй тестовый запуск 4:15
6
Win2008R2 + SQL 2005 + 1C x86
Первый тестовый запуск 5:20
Второй тестовый запуск 4:15
7
Win2003 (32bit) + SQL 2005
Первый тестовый запуск 3:15
Второй тестовый запуск 2:20
(78) (80) Здесь же на инфостарте встречал публикацию (правда найти сейчас не могу, может быть так-же в комментариях было где-то), в которой говорилось о том, что Win 2008x64 + SQL 2008x64 дают большую производительность, чем 2003. Насколько я знаю в 2008 винде очень сильно переписана процедура работы с файловой системой, ускоряющая работу с файлами если не на порядок, то в разы точно. И результаты таких тестов являются частным случаем для конкретного оборудования. Если на сервере 2 ГБ памяти, то и дибилу понятно что поставив туда 2008-е вин и скуль, вы снизите производительность в разы, по сравнению с 2003-ми.
Вобщем желательно самому на своем оборудовании протестировать и решить с чем работать комфортнее. Да и поддержка M$, обновления и т.п. для 2008-х покачественнее, ИМХО.
Батенька, Вы бы хоть ИМХО добавляли, чтобы безапелляционно делать такие утверждения. Не нужен дефраг на современных винтах с размером больше терабайта? ну-ну... :)
Вот интересная статья про NTFS:
В самом начале утверждалось, что NTFS не подвержена фрагментации файлов. Это оказалось не совсем так, и утверждение сменили - NTFS препятствует фрагментации. Оказалось, что и это не совсем так. То есть она, конечно, препятствует, но толк от этого близок к нулю... Сейчас уже понятно, что NTFS - система, которая как никакая другая предрасположена к фрагментации, что бы не утверждалось официально. Единственное что - логически она не очень от этого страдает. Все внутренние структуры построены таким образом, что фрагментация не мешает быстро находить фрагменты данных. Но от физического последствия фрагментации - лишних движений головок - она, конечно, не спасает. И поэтому - вперед и с песней...
--------------------------------------------------------------------------------
NTFS - очень экономная система. Размер кластеров в ней разумно минимален - обычно это 4 кб (на стандартных сейчас дисках в десяток-другой гигабайт). Как известно, система сильнее всего фрагментирует файлы когда свободное место кончается, когда приходится использовать мелкие дырки, оставшиеся от других файлов. Тут возникает первое свойство NTFS, которое прямо способствует серьезной фрагментации.
Диск NTFS поделен на две зоны. В начала диска идет MFT зона - зона, куда растет MFT, Master File Table. Зона занимает минимум 12% диска, и запись данных в эту зону невозможна. Это сделано для того, чтобы не фрагментировался хотя бы MFT. Но когда весь остальной диск заполняется - зона сокращается ровно в два раза icon_smile.gif. И так далее. Таким образом мы имеем не один заход окончания диска, а несколько. В результате если NTFS работает при диске, заполненном на около 90% - фрагментация растет как бешенная.
• Попутное следствие - диск, заполненный более чем на 88%, дефрагментировать почти невозможно - даже API дефрагментации не может перемещать данные в MFT зону. Может оказаться так, что у нас не будет свободного места для маневра.
Далее. NTFS работает себе и работает, и всё таки фрагментируется. Этому способствует странный алгоритм нахождения свободного места - второе серьезное упущение. Если файл пишется большими кусками - всё нормально. Но если файл медленно растет - алгоритм такой: берется какой-то определенный объем диска и заполняется файлом до упора. Причем по очень интересному алгоритму: сначала заполняются большие дырки, потом маленькие. Т.е. типичное распределение фрагментов файла по размеру на фрагментированной NTFS выглядит так (размеры фрагментов):
16 - 16 - 16 - 16 - 16 - [скачек назад] - 15 - 15 - 15 - [назад] - 14 - 14 - 14 .... 1 - 1 - 1 -1 - 1...
Так процесс идет до самых мелких дырок в 1 кластер, несмотря на то, что на диске наверняка есть и гораздо более большие куски свободного места.
Может быть я забыл написать что-то еще... Смысл в том, что никак нельзя сказать, что NTFS препятствует фрагментации файлов. Наоборот, она с радостью их фрагментирует. Фрагментация NTFS через пол года работы доведет до искреннего удивления любого человека, знакомого с работой файловой системой. Поэтому приходится запускать дефрагментатор. Но на этом все наши проблемы не заканчиваются, а, увы, только начинаются...
--------------------------------------------------------------------------------
В NT существует стандартное API дефрагментации. Обладающее интересным ограничением для перемещения блоков файлов: за один раз можно перемещать не менее 16 кластеров (!), причем начинаться эти кластеры должны с позиции, кратной 16 кластерам в файле. В общем, операция осуществляется исключительно по 16 кластеров. Следствия:
• В дырку свободного места менее 16 кластеров нельзя ничего переместить (кроме сжатых файлов, но это тонкости).
• Файл, будучи перемещенный в друге место, оставляет после себя (на новом месте) "временно занятое место", дополняющее его по размеру до кратности 16 кластерам.
• При попытке как-то неправильно ("не кратно 16") переместить файл результат часто непредсказуем. Что-то округляется, что-то просто не перемещается.. Тем не менее, всё место действия щедро рассыпается "временно занятым местом". Наверное о нас заботятся, чтобы мы отстали от этого места - чтобы алгоритм дефрагментации не клинило. icon_smile.gif
• "Временно занятое место" освобождается через некоторое время, обычно где-то пол минуты. Гы.
Тем не менее, логично было бы использовать это API. Его и используют. Поэтому процесс стандартной дефрагментации, с поправками на ограниченность API, идет следующими фазами, не обязательно в этом порядке:
• Вынимание файлов из MFT зоны. Не специально - просто обратно туда их положить не представляется возможным. Безобидная фаза, и даже в чем то полезная.
• Дефрагментация файлов. Безусловно полезный процесс, несколько правда осложняемый ограничениями кратности перемещений - файлы часто приходится перекладывать сильнее, чем это было бы логично сделать по уму.
• Дефрагментация MFT, виртуалки (pagefile.sys) и каталогов. Возможна через API только в Windows2000, иначе - при перезагрузке, отдельным процессом, как в Diskeeper-е.
• Складывание файлов ближе к началу - так называемая дефрагментация свободного места. Вот это - воистину страшный процесс...
Допустим, мы хотим положить файлы подряд в начало диска. Кладем один файл. Он оставляет хвост занятости дополнения до кратности 16. Кладем следующий - после хвоста, естественно. Через некоторое время, по освобождению хвоста, имеем дырку <16 кластеров размером. Которую потом невозможно заполнить через API дефрагментации! В результате, до оптимизации картина свободного места выглядела так: много дырок примерно одинакового размера. После оптимизации - одна дыра в конце диска, и много маленьких ><16 кластеров дырок в заполненном файлами участке. Какие места в первую очередь заполняются? Правильно, находящиеся ближе к началу диска мелкие дырки ><16 кластеров... Любой файл, плавно созданный на прооптимизированном диске, будет состоять из дикого числа фрагментов. Да, диск потом можно оптимизировать снова. А потом еще раз.. и еще.. и так - желательно каждую неделю. Бред? Реальность.>
Таким образом, имеется два примерно равнозначных варианта. Первый - часто оптимизировать диск таким дефрагментатором, смиряясь при этом с дикой фрагментацией заново созданных файлов. Второй вариант - вообще ничего не трогать, и смириться с равномерной, но гораздо более слабой фрагментацией всех файлов на диске.
Пока есть один дефрагментатор, который игнорирует API дефрагментации и работает как-то более напрямую - Norton Speeddisk 5.0 для NT. Когда его пытаются сравнить со всеми остальными - Diskeeper, O&O defrag, т.д. - не упоминают этого главного, самого принципиального, отличия. Просто потому, что эта проблема тщательно скрывается, по крайней мере уж точно не афишируется на каждом шагу. Speeddisk - единственная на сегодняшний день программа, которая может оптимизировать диск полностью, не создавая маленьких незаполненных фрагментов свободного места. Стоит добавить также, что стандартное API не может дефрагментировать тома NTFS с кластером более 4 Кбайт - а SpeedDisk, по прежнему, может.
К сожалению, в Windows 2000 засунули дефрагментатор, который работает через API, и соответственно плодит дырки <16 кластеров. Так что как только появится (если уже не появился) - так сразу надо качать Speeddisk для W2k. Как некоторый вывод из всего этого - все остальные дефрагментаторы при одноразовом применении просто >вредны. Если вы запускали его хоть раз - нужно запускать его потом хотя бы раз в месяц, чтобы избавится от фрагментации новоприбывающих файлов. В этом основная суть сложности дефрагментации NTFS теми средствами, которые сложились исторически.
Общий вывод: если начнете делать дефрагментацию, то ее необходимо будет делать постоянно, иначе начнутся тормоза.
ИМХО вывод: Нахрена она нужна если на быстродействии базы это никак не скажется, т.к. база лежит (у грамотных админов) на отдельном от системы и TEMP'а диске одним(двумя) файлами. Это как иконка в автомобиле - если с ней вы чувствуете себя спокойнее, то весить надо обязательно, т.к. уверенность в себе водителя за рулем помогает безаварийному вождению.
ага, посмотрю как головки будут хрустеть, когда идет полнотекстовый поиск на базёнке размером под сто гектар (волею судеб распухшей вперемешку с другим хламом на разделе)...
1) если база стоит с ОС
2) если база не одна, а SQL обслуживает еще много чего.
Когда есть отдельный РЭЙД только под базу, есть возможность этот рейд "защищать" от вопросов начальства ("а че это у вас пустой рэйд токо с одной базой!?") - замечательно.
Но именно это нужно указать в примечаниях к "дефрагментация не нужна!"
Дефрагментация - это накладные расходы использовыания файловых систем виндовс, в линуксах и прочих никсах создатели ФС заранее постарались свести к минимуму как саму фрагментацию, так и её последствия.
Т.е. опять же, кто сидит на 1С и Линуксе (Posgre) - тоже могут об дефрагментации не думать.
Я ему про Фому, он мне про Ерёму! Когда на разделе стоит несколько баз и они начинают пухнуть исторически, они по-любасу жирнеть будут паззлами! Если диск не дефражить, то они так и будут кусками по винту расплёснуты. Имейте мужество вести конструктивный диалог и не надо "ты"кать и переходить на панибратчину.
В конце концов, я же женщина... пусть и СИСЯСдминка. )))
Лана, проехали... разрешаю выпить со мной бокальчик на брудер... ))
Между прочим, я у себя дома чисто субъективно ощущаю разницу скорости работы нулевого райда (пусть и миллион раз отдефрагментированного), если на нем запущена операционка обычно.
И есть разница и весьма существенная, если с этого же райда, но в режиме vhd (кусок 50 гектар).
Прирост по скорости ощутим, еще раз спасибо за статью! Также очень много полезного почерпнул из развернувшейся в комментариях дискуссии. :)
ПС: название библиотеки придумал сам, в винде такой нету)
В филиале сервер MSSQL .. постоянно какие то косяки. То памяти не хватает, то просто вырубается 1С ка.
Проблемы с MS sql лишь говорят либо о недостаточности ресурсов , либо кривости настройки.
В Postgresql - основная проблема , это блокировка постраничная , и некоторые проблемы при работе с виртуальными таблицами
в запросах
Это несколько спорно. При таких настройках в журнале приложения появилась такая строка: "Автоматическое увеличение размера файла "tmp_back_NC" в базе данных "tmp_back_NC" заняло 66457 миллисекунд. Возможно, следует командой ALTER DATABASE задать меньшее значение FILEGROWTH для данного файла.
1. Запустить Microsoft SQL Server Managment Studio. Ссылка на неё есть под кнопкой "Пуск" в операционной системе.
2. Если требуется, то пройти авторизацию.
3. В левой части окна должно быть окно Object Explorer. Если его нет, то открыть его через меню: View - Object Explorer (или нажатием клавиши F8).
4. Находим в дереве окна Object Explorer ветку Management -> Maintenance Plan. Щелкаем на ветке Maintenance Plan правой кнопкой мыши и из появившегося контекстного меню выбираем New Maintenance Plan.
Для русифицированной версии:
"Object Explorer" = "Обозреватель объектов";
"View" = "Вид";
"Management" = "Управление";
"Maintenance Plan" = "Планы обслуживания";
"New Maintenance Plan" = "Создать план обслуживания".
Этого достаточно...
SQL сервер: WIN2008 SP2(х86)+MSSQL2008R2 8Гб ОЗУ, проц Intel Xeon X3450 2.66GHz (8 ядер).
1C сервер: WIN2003SE SP2(х86) 4Гб ОЗУ, проц Intel Quad Q6600 2.4GHz
База ~ 30 Гб
Пользователей не больше 50
По тесту Гилева (что с клиентской машины, что с сервера 1С) показывает 17 попугаев (это чуть выше, чем "удовлетворительно"). Хотя по диспетчеру ресурсов обе машины (особенно SQL сервер) не загружены даже на 25%. Подскажите в каком направлении копать? Очень нужно.
Интересно, какая конфа 1с использовалась? Возможно просмотрел...
Смущает вот что:
1. "...дефрагментация и обновление статистики делается быстро и не требует отключения пользователей..."
2. "...полная переиндексация раз в неделю" - как работают пользователи во время операций?
Могу предположить, что круглосуточно 200 пользователей не работают...
Откуда собственно вопросы:
8.1 самописная, 200 пользователей, SQL бэкап базы ~400Гб
работаем в режиме 24*6
Преиндексация ~ 6 часов
Статистика ~ 12-14 часов
Работать во время регламента очень-очень проблематично....
Автору +
Применил половину настроек описанных в статье - существенно ускорило работу. Спасибо автору. Но хотелось бы еще решить один вопрос:
Логи базы раздулись до 500Гб. Если я сделаю настройки баз в соотв. с вашей статьей, что произойдет? не повредятся ли логи? уменьшится их размер? чем я рискую собственно?
Вобще канечно хотелось бы логи сжать максимально. ато 4 базы, по 500Гб как то через чур помоему =)
USE [<ИмяБД>]
GO
DBCC SHRINKFILE (N'<ИмяБД>_log' , 0)
GO
выдало ошибку:
09/12/2012 07:06:26,Full_backup_Doc_abm,Ошибка,2,FILE_SERVER,Full_backup_Doc_abm,second_step,,Выполняется от имени пользователя: NT AUTHORITY\LOCAL SERVICE.Не удалось найти файл "Doc_abm_log" для базы данных "Doc_abm" в sys.database_files. Файл не существует или был удален. [SQLSTATE 42000] (Ошибка 8985). Шаг завершился с ошибкой.,00:00:00,16,8985,,,,0
У меня еще один вопрос, раньше базы бэкапились средствами SQL вот по такому скрипту, в один шаг:
USE Doc_test;
GO
BACKUP DATABASE Doc_test
TO DISK = 'E:\first_step\SQLDoc.Bak'
WITH FORMAT,
INIT,
MEDIANAME = 'E_SQLDOC',
NAME = 'Full Backup of DOC2008R2';
GO
Чем ваш вариант отличается от этого? Сразу в глаза бросаются такие вещи как SKIP, NOREWIND, NOUNLOAD, STATS = 10. Незнаю что это.
SKIP
Отключает проверку сроков действия и имен резервных наборов данных, которая обычно проводится инструкцией BACKUP для предотвращения перезаписи.
STATS [ =percentage ]
Отображает сообщение каждый раз, когда завершается очередной percentage задания; используется для отслеживания хода выполнения. Если параметр percentage не задан, то SQL Server выдает сообщение после каждых выполненных 10 процентов.
Параметр STATS сообщает о готовности в процентах по отношению к порогу сообщения о следующем интервале. Показатель готовности в процентах имеет неточное значение; например при значении STATS=10, если процент готовности равен 40, то параметр может отображать 43 процента. Это не является проблемой для больших резервных наборов данных, поскольку показатель готовности в процентах перемещается очень медленно между обращениями ввода-вывода.
NOREWIND
Указывает, что SQL Server сохранит ленту открытой после операции резервного копирования. С помощью этого параметра можно улучшить производительность при выполнении нескольких операций резервного копирования на ленту.
NOUNLOAD
Указывает, что после завершения операции BACKUP лента остается в ленточном накопителе.
Источник:
По идее эти параметры не обязательные, просто MS SQL их добавляет автоматом, когда из окна бэкапа (правой кнопкой мыши на базе данных в дереве / Backup...) получаешь SQL-скрипт команды.
Пож-ста проясните вопросы:
1. В свойствах сервера SQL, вкладка Память (Использовать AWE для выделения памяти)
Как понимаю в моем случае на WinServer 2003 галочку лучше поставить для использования памяти больше 2 Гб?
2. В свойствах сервера SQL, вкладка Дополнительно (Максимальная степень параллелизма)
Кое где в инете советуют установить значение "1", как это отображается на производительности сервера? Стоит ли это делать?
3. В свойствах базы данных, вкладка Параметры (Компонент Service Broker включен)
В вашей статье указан параметр "True", для каких целей, за что он отвечает?
WinServer 2003 R2 EE (32 Bit)
SQL Server 2008 R2 (10.50.1600.1)
1) Да, для использования памяти более 3,5 ГБ на 32х системах нужно включать использование AWE.
2) Максимальная степень параллелизма = 1 ускоряет работу SQL сервера с маленькими базами данных. Т.е. при ограничении в 1 процессор на исполнение одного плана запроса эффективно для маленьких запросов, сервер не тратит времени на анализ необходимости подключения дополнительных ядер для выполнения того или иного плана запроса. Но для больших баз данных и оборота с документами в тысячи строк табличной части все же лучше ограничение в одно ядро на запрос не ставить.
3) Компонент SQL Server Service Broker обеспечивает собственную поддержку приложений обмена сообщениями и приложений с очередями сообщений в компоненте Компонент SQL Server Database Engine. Т.е. простыми словами он поддерживает механизм транзакций для распределенных баз данных MS SQL. Для работы с 1С он не нужен, и в статье параметр остался включен, т.к. это значение по умолчанию.
Это было справедливо для SQL2000. С SQL 2005 при значении "0" сервер сам выбирает при старте число рабочих потоков, и для 32разрядных SQL это число начинается от 256 и выше.
А цифра "2048" взята с "потолка" - MS рекомендует для х32 выставлять в Maximum worker threads не более 1024. А лучше - оставить 0 по умолчанию.
(24) _Z1,
Причем тут рабочие процессы и выделяемая под них память? Здесь настраивается количество рабочих процессов, а сколько они съедят памяти - сие не известно заранее.
На SQL 2005 больше, вроде, и не давало ставить, а сейчас на SQL2012 - хоть до 2 ГБ выставляй.
Однако выставление значений данного параметра в МБ чем выше, тем более чревато перерасходом памяти "впустую".
Сверял настройки базы. Не совсем понятно, для чего broker enabled функция нужна ? Можете подсказать?
1.Перестроение индекса. Вы пишете что производится раз в неделю. Если чаще - это зло? У нас настроено - каждую ночь.
2.Реорганизация индекса. Вы пишете, что не стоит ее делать если делаем Перестроение индекса, но сейчас не могу найти где, но когда настраивала обслуживание - то читала что наилучшая схема такая: Reorganize Index Task - Rebuild Index Task - Shrink Database Task - Update Statistics Task . А Вы считаете, что если Rebuild Index Task, то ни Reorganize Index Task ни Update Statistics Task делать нет необходимости.
3. И по поводу Очистки процедурного кеша. Ну ведь кеш для того и создается и используется - чтобы быстрее работали запросы, чтобы их заново не создавать. Гилевым здесь было сказано: "если объем данных изменяется не сильно, то очистка процедурного кэша скорее зло, так как скулю придется компилировать запрос заново ".Как определить Сильно изменяется объем данных или нет , какие здесь критерии? Количество пользователей (120 - много или мало)? Количество создаваемых документов (300 шт - много или мало)? Количество строк в документах?.
Большое спасибо.
1. и 2. Перестроение индекса (Rebuild) - это создание индекса заново. Реорганизация индекса (Reorganize) - это дефрагментация существующего индекса. По сути это взаимозаменяющие операции, при этом вторая (дефрагментация) менее затратная по ресурсам сервера, чем первая (полное перестроение). Но все же дефрагментация может проводится не всегда настолько же "правильно", как полное перестроение, что приводит к деградации индекса со временем, особенно при изменении данных "задним числом", по этому полное перестроение все же проводить рекомендуется. Если в базе по ночам ни кто не работает, то нет ничего страшного в том, что перестроение проводится каждую ночь. В нашей же ситуации база работала 24х7 и постоянная полная переиндексация сильно тормозила систему.
3. Очистка кэша конечно операция спорная, но все же опытным путем заметили увеличение производительности послее очиски, когда было произведено полное перестроение индексов. Замечу, что в нашей базе данные менялись очень часто, по 200-700 документов в день с табличными частями в 100 - 10 000 строк. При том постоянно изменялись данные "задним числом". Каждый день кэш чистить однозначно не стоит. Но, ИМХО, хотя бы раз в месяц, особенно после перепроведения или пересчета итогов запросы в кэше устаревают и лучше бы SQL перекомпилировал их заново.
при реорганизации (reindex) индеска обновляется статистика
при дефрагментации (defrag ) индекса статистика не обновляется
(153) Если делать каждую ночь reindex - база будет лучше работать - однозначно.
как бы поводом не делать если индексы не будут успевать перестраиваться за ночь.
второе против этого если у Вас диски SSD - как бы их ресурс на перезапись я не знаю.
(153) Shrink Database Task - категорически делать нельзя вообще ( не то что каждую ночь ).
запуская его Вы сводите на нет
выполненый до этого reindex.
т.е. ночью Вам если у Вас все продит часа за 2-3 делайте reindex (или всей базы или частично)
при этом выполниться автоматически Update Statistics Task
что такое Rebuild Index Task - не знаю.
по 3 по поводу очистки процедурного кеша ( кеша запросов ) по моему очищать не обязательно,
но хуже тоже не будет, после обновления статистики ms sql сам разбереться что запросы
в кеше запросов уже не актуальны.
т.е. если Вы перестаиваете reindex индексы частично( не для всех таблиц) то Вам не нужно очищать кеш запросов
если делаете reindex для всей базы то лучше очистить кеш запросов
Подскажите еще проверка целостности - когда стоит ее делать, есть ли приоритет в последовательности.
ТабличныйДокумент.Вывод = ИспользованиеВывода.РазрешитьВозможно мои телепатические способности дали сбой и не угадал с правильной постановкой вопроса (что за функция? как именно открывает? что значит "при локальной работе"? и "при работе через sql"?
Могу точно сказать, что возможности работы 1С с PDF от настроек SQL сервера не зависят никак. SQL-сервер используется только как хранилище данных, вместо файла 1CD, а весь код выполняется на сервере 1С, и от используемого хранилища его выполнение никак не зависит.
На что влияет данный параметр и какое значение лучше поставить?
У меня по умолчанию стоит False, у вас True.
"Service Broker (cервис-брокер) — это служба в составе MS SQL Server, работающая как мессидж-брокер, т.е. служба, которая позволяет отправлять и получать сообщения."
Какие сообщения тут могут быть и нужна ли данная служба вообще?
А можете меня поправить если я не прав.
Как понял я для каждого плана обслуживания (Дефрагментация индексов и сбор статистики) создается создается отдельный пакет SSIS (SQL Server Integration Services — подсистема SQL Server, которая раньше называлась DTS).
Но в начале статьи есть такая фраза "Во-первых нам нужен только сервер, остальные службы, которые к нему относятся и возможно кто-то ими пользуется, нам только тормозят работу. Останавливаем и отключаем такие службы, как FullText Search (у 1С собственный механизм полнотекстового поиска), Integration Services и иже с ними."
Вопрос в следующем отключив данную службу (Integration Services) не повлияет ли это на планы обслуживания?
За планы обслуживания отвечает MS SQL Server Agent. Хотя не могу сказать точно за SQL Server 2012, могли перенести функционал между службами. Вообще лучше вариант запуска поставить "Вручную" и SQL Server запустит нужную службу при необходимости.
Статья писалась почти 5 лет назад, нужно бы, конечно, ее обновить с учетом последнего опыта и замечаний из комментариев. Постараюсь это сделать.
Меня интересует ещё один параметр, который не описан в вашей статье.
max degree of parallelism (DOP).
Данный параметр указывает на то сколько максимально процессоров может быть задействовано на выполнение одного запроса.
По умолчанию стоит значение 0. Это означает, что все процессоры могут быть загружены одним запросом.
Многие источники утверждают, что нужно ставить знание в 1, то есть один запрос- один процессор.
Мне кажется, что использовать ни один из этих параметров не стоит. А выбрать среднее значение исходя из количества процессоров на сервере.
У меня 8-ядер и я думаю установить значение в 4. Но есть сомнения...
Может подскажете какие проверки можно выполнить, чтобы более точно оптимальное количество.
Идеально было наличие уже готовых тестов, чтобы можно было проверить, а не выдумывать запросы самому.
За статью огромная благодарность!
ИМХО: мне лично, как новичку в работе с MS SQL Server, очень помогла! А все комментарии, побудили еще глубже заняться этим вопросом. Спасибо всем, кто принимает участие в обсуждении.
А за это, Вам будут благодарны еще многие пользователи!
Спасибо!
Прокомментируйте, плиз.
Сенькс.
1. SA пользователь для работы - это нонсенс... я-бы рекомендовал вообще для каждой базы заводить отдельного пользователя с правами только на эту базу, это очень удобно для быстрого убития сессии, в тестовой базе, завесявшей например памят запросом к темпДБ
2. про память - мои рекомендации такие
отдаем скулю 50% физической памяти, потом при пиковых нагрузках смотрим сколько свободной памяти имеет сервер и добавляем скулю столько что-бы свободной физической памяти при пике загруки было 10% от физической.
3. про регламенты - обновление статистики стоит делать чаще чем индексы...
4. про бекапы - стоит настроить два разных джоба (и в разные папки) "ежедневный" и "помесячный"
1. Так как эта инструкция предполагалась как "для чайников", то настройка отдельных пользователей SQL, прав для них и т.п. уже выходит за рамки статьи, да и по большому счету это дело вкуса, в подавляющем большинстве организаций 1С ходит в SQL под SA (я не утверждаю что это правильно и нужно так делать).
2. С точки зрения владельца бизнеса/оборудования 10% свободной памяти при пиковых нагрузках это 10% зря выброшенных денег за сервер в миллион долларов. Небольшая аналогия: вы купили 4х местный автомобиль, но программист вам говорит "вы должны использовать максимум 3 места из 4х!" Что вы ему ответите? А зачем SQL серверу память резать и свободную оставлять?
3. По поводу обновления статистики: - Тут не советуют делать слишком частое обновление статистики, т.к. это вызывает перекомпиляцию=замедление запросов. По идее статистика сама копится и автоматически дополняется/изменяется, и принудительное обновление лучше делать как раз после перестроения индексов или какого-то другого сильного изменения данных, участвующих в статистике.
4. Чем отличается ежедневный полный бэкап, сделанный 31.01 и ежемесячный бэкап? Только папкой назначения? Данные в них одни и те же. Вообще грамотный администратор будет ежемесячные/еженедельные бэкапы сохранять на другом сервере/в другой стране/на жестком диске в сейфе... но это опять же, как и п.1, относится к тонкостям администрирования, во многом зависит от вкуса и опыта администратора и выходит за рамки статьи.
с точки зрения "бешеного" бизнеса вообще не зачем тратить деньги на зеркальный райд. стоит в 2 раза больше а объём тот же.
а вот с точки зрения нормального бизнеса обязательно требуется резервирование и масштабирование как софта так и железа, то есть железо всегда должно покупаться с неким запасом "на будущее"
И вам доброго. А что за железо на сервере стоит? 1С и SQL на одной машине? Что там еще крутится? Что системный монитор ресурсов Windows показывает по нагрузке на память / процессор / диск(и) ?
Так же средние значения по логическому диску с базами и памяти
Что-то у вас очереди длинные на диск, нужно смотреть что именно нагружает. Или разносить систему+1с и sql по разным физическим дискам. Если на SQL очереди не приблизятся к оптимальным показателям, разносить данные и temdb по разным дискам.
Обычно даются такие рекомендации по оптимальным показателям системного монитора:
Контроль основных показателей производительности серверов СУБД и Приложения 1С:
Processor - %Processor time: лимит 70%
System - Processor Queue Length: лимит 2 * кол-во ядер
Physical Disk - Avg. Disk Queue Length: лимит 2 * кол-во дисков, работающих параллельно (для рейд-массивов)
Network adapter - Bytes total / sec: лимит 65% от пропускной способности
Memory - Available Mbytes: больше 0
Добрый день.
Для максимального увеличения производительности лучше на SSD положить temp.db и лог транзакций SQL (*имя базы*.log). Также туда стоит перенести систему и, соответственно, сервер приложений 1С со своими временными файлами. Для экономии места нужно будет периодически архивировать на медленный диск и чистить журналы сервера 1С (*.lgf и *.lgp). Если возможности перенести систему нет, то хотя бы перенести файл подкачки и сервер 1С,
во первых темпдб бывает довольно большой (лично встречал 80гигов), и скорее всего он не влезет, а как он не влезет - будет беда :)
во вторых свободная оперативка для скуля куда важнее чем быстный темпдб
в третих давай посчитаем чего дешевле - 100 гигов серверной оперативы или ssd ???
Это я одна такая ущербная, что у мя темпдб меньше полутора гектар? Может вы где-то и видели 80гиговый файл на экзотической базёнке, но данная публикашка о настройках скулы под базы 1с.
И потом, если вы так переживаете за живучесть темпдб, тогда уж предлагайте под него серверную ССД(для надёжности), а она весьма недёшева.
ЗЫ: А
Ставил на тест SQL. работало быстрее конечно, чем файловый вариант..НО система немного с косяками и скуль вылетал. Вот сейчас и думаю переставлять ОС и надо сразу определиться по SSD, где будет задействуется..
К Железу SQL Server 2014 не намного более требователен, чем предыдущие версии (особенно 2005/2008). Единственно, что он занимает больше места на жестком диске. Но на железе с минимальными требованиями (объем оперативной памяти 512 Мб и т.п.) с базами 1С будет работать практически невозможно, разве что с маленькой базой в однопользовательском режиме. А вообще, благодаря оптимизации алгоритмов работы, на одинаковом железе с одной и той же базой 2014 должен работать быстрее 2008 или 2005 sql сервера.
Попробуйте запустить процесс SQL Server с параметром -f. Так он запускается с минимальной рабочей конфигурацией.
Подробнее по настройкам параметров памяти вручную:
В SQL 5 баз. Нужно дать одному челу полный доступ к 2 базам, а к 3 только просмотр. (Это вроде решается)
+
Надо дать полный доступ к Управление/Планы обслуживания.
Я так понимаю что Планы обслуживания открыты только для роли sysadmin, но если я эту роль дам у него будет полный доступ ко всему.
Есть какие ни будь решения?
Попробуйте дать роль serveradmin. Либо создать свою.
Мне кажется параметр автообновления статистики лучше ставить в TRUE, чтобы SQL автоматически актуализировал статистику после операций с БД.
Как то всё не было необходимости в SQL, обходились файловыми, Но с переходом на 8.3, как то всё не весело работает. Пока вот приходиться буквари читать да комментарии.
В статье ИТС про настроку Boost SQL Server priority сказано:
Если сервер 1С:Предприятия установлен вместе с Microsoft SQL Server, то данную настройку производить не нужно.
А почему бы и спать спокойно, если из этих 200 челов в некоей очень грустной и печальной конторе(ВПК/бюджет и т.п.)каждый в лучшем случае делает полтора документа в день. Или вы считаете, что перед восстановлением сидеть и вычислять, кто из 200 пользователей на какую минуту в этот день провел документ, а кто не успел это более продуктивно?
Последние предложение вообще не понятно. Кого вычислять надо и зачем? Если лог транзакций бекапится раз в пять минут, вы потеряете 5 минут работы, а не сутки.
Лукавить только не надо, говоря про 5 мин. Если сервак упал, то 5 мин в лучшем случае, чтобы пяточку взорвать и понять, в каком измерении находишься. :)
Добрый день.
Во-первых юзеров до 500 в хорошие дни.
Во-вторых внамательно читаем статью, цитата:
BACKUP DATABASE [<ИмяБД>] TO DISK = N'<ПутьКПапке>\Backup\<ИмяБД>Diff.bak' WITH DIFFERENTIAL , NOFORMAT, INIT, NAME = N'<ИмяБД>-Differential Database Backup', SKIP, NOREWIND, NOUNLOAD, STATS = 10
Это как раз накопительный разностный бэкап, периодичность в 1 или в 2 часа в зависимости от уровня ночных кошмаров... лучше конечно 1 час ставить.
Если честно, проверяли опытным путем. Сперва было настроено по рекомендации 1С и кэш чистился тоже каждый день. Но по утрам наблюдались "тормоза" в базе. После отключения очисти кэша - тормоза прекратились. Возможно не имеет смысл обновлять статистику каждый день. Особенно если база не очень большая и вы не перепроводите за день документов на миллионы строк. Статистика должна обновляться SQL-сервером автоматически. И универсальным решенем тут будет делать и то, и то не чаще раза в неделю.
Есть сервер, стоит SQL Server 2008 R2.
И за день приходится по несколько раз перезапускать Агент Сервера 1С преприятия, т.к. SQL выжирает 80-90% ЦП.
Может быть есть какие-то настройки о которых я не подумал?
ЦП - Rizen 7
Баз 7 штук общим объемом на 51ГБ.
Значит в одной из баз используются неоптимизированные запросы. Например, разыменовывание реквизита типа "ЛюбаяСсылка" через точку. Нужно анализировать, какие запросы вызывают такую нагрузку. Либо их слишком много. Либо часто вызываются неоправданно дорогие запросы. Количество потоков с количеством пользователей как коррелируют? Если потоки растут нужно опять же искать откуда, например стартует какое-то фоновое задание с тяжелым запросом, запрос не успевает выполнится и стартует новое задание с тем же запросом, в результате SQL-сервер постоянно грузится все сильнее и сильнее. Но это один из огромного количества вариантов.
Но еще раз повторюсь, настройками сервера такие проблемы не решаются. Тут нужно анализировать и исправлять ошибки в архитектуре решения.
особенно умиляют перлы типа
Статья писалась 10 лет назад, когда на ИТС никаких рекомендачий не было и писалась скорее для "собрать фидбэк по настройке, вымученной на собственном опыте". Конечно она многим помогла в свое время, но сейчас лучше пользоваться рекомендациями с ИТС. Т.к. вымученного опыта у авторов с ИТС явно больше, чем у меня. Тем более я уже 1С не занимаюсь и актуализировать статью не собираюсь.
ясно спасибо.
Я мучаюсь и сейчас с rphost, грузящим процессор на виртуалке сервера 2016.
При старте базы загрузка проца до 60% и это при одном клиенте и почти пустой базе.
Рейтинг: 1161
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 65955
Создание 17.02.10 19:33
Обновление 19.03.10 00:00
Просмотры 660284
Загрузки 0
Рейтинг
861
Комментарии 255
Код открыт Не указано
Рубрики HighLoad оптимизация
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация Универсальные
Операционная система Windows
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)


