Подведем итоги. Нарастающие.
Разработка - Математика и алгоритмы
Бесплатные
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Узнавайте о новых бесплатных решениях в нашей телеграм-группе Инфостарт БЕСПЛАТНО
| Наименование | Скачано | Бесплатно |
|---|---|---|
|
-
.dt 26,43Kb
431
|
431 | Скачать бесплатно |
Вы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Шепоту посвящается.
Возможно читателю покажется интересным приложение в конце статьи :
Что такое нарастающие итоги ? И зачем они нужны ?
Три подхода или кто прав ?
1. Eugeneer предлагает следующий алгоритм решения задачи получения просроченных долгов контрагентов . Организовать цикл обхода выборки контрагентов ,в каждой итерации которого выполнять "мелкий" запрос к базе и с помощью кодинга получить необходимые данные отчета. Eugeneer имеет весомый аргумент - отчет //infostart.ru/public/60670/ ,практическое тестирование которого показало неплохие результаты при размере базы УТ - 13 Гб и количестве контрагентов - более 4 тыс.
2. Ish_2 в дискуссиях с Anig99 и Eugeneer настаивал на том , что лучший вариант с точки зрения быстродействия - это сделать один запрос к базе и за один проход выборки кодингом получить все необходимые для отчета данные . Ish_2 считает весомым аргументом собственные рассуждения и умозрительные построения.
3. Anig99 предлагает уместить алгоритм получения всех данных в один пакет запросов. Anig99 имеет весомый аргумент- отчет //infostart.ru/public/58966/ , который показал хорошее быстродействие при объеме базы 120(!) Гб
В настоящий момент , автор статьи считает , что прав в споре - Anig99. Опуская аргументацию почему Eugeneer и Ish_2 неправы (пожалуй , потянет на отдельную статью о вредности "семерочного" похода при работе с таблицами БД),скажу лишь , что выбранный Anig99 подход , не предполагающий кодинга вовсе - самый простой и технологичный , при котором мы "отвязываемся" от "слабости" клиента и передаем всю обработку данных на сервер баз данных. Итак, правильный подход к решению задачи выбран. Осталась мелочь - написать эффективный запрос , обеспечивающий наилучшее быстродействие. Мелочь эту мы и рассмотрим в статье.
Рассматриваемый ниже вариант построения текста пакета запросов для решения поставленной задачи представляется автору самым оптимальным для как небольших, так и очень больших объемов данных (свыше 120-150 ГБ). В демонстрационных целях , для объяснения сути подхода к решению задача несколько упрощена . Несколько упрощен , соответственно , и предлагаемый к рассмотрению текст пакета запросов . Теперь можно приступить к делу.
Постановка задачи.
Даны две таблицы:
Таблица «Долги»
|
Контрагент |
Долг |
ДатаОтсрочки |
|
Компания |
200 |
01.11.09 |
Таблица «Обороты»
|
Контрагент |
Период |
Рег-р |
Сумма |
|
Компания |
10.09.09 |
Накл. 1 |
40 |
|
Компания |
20.09.09 |
Накл. 2 |
60 |
|
Компания |
31.10.09 |
Накл. 3 |
80 |
|
Компания |
25.11.09 |
Накл. 4 |
100 |
Требуется получить таблицу «Просроченные долги»
|
Контрагент |
Период |
Рег-р |
Сумма |
Долг |
Просроченный долг |
|
Компания |
20.09.09 |
Накл. 2 |
60 |
20 |
20 |
|
Компания |
31.10.09 |
Накл. 3 |
80 |
80 |
80 |
|
Компания |
25.11.09 |
Накл. 4 |
100 |
100 |
0 |
В выходную таблицу вошли документы на общую сумму равную долгу контрагента (=200).
Алгоритм получения выходной таблицы сводится к нахождению в таблице «Обороты» строки с регистратором «Накл 2»,.
Действительно , сумма долга 200 будет складываться как
Строка «Накл 4» - 100
Строка «Накл 3» - 80
Строка «Накл 2» - 20 , где 20 – это часть значения «Суммы» текущей строки
таблицы «Обороты».
Итак , мы ищем строку в таблице «Обороты», которая является последней в последовательности строк таблицы «Обороты» , «набирающих» в обратном порядке следования строк необходимую сумму долга.
 Отступление для "семерочников".
Не спешите восклицать: " Делов -то ! Пройтись по таблице "Обороты" циклом, да и дело с концом !" Представьте себе , что во встроенном языке 1с нет оператора цикла . Возможно, тогда представленный алгоритм не покажется совсем уж нелепым.
Описание алгоритма решения .
I. Получим суммарные обороты с нарастающими итогами по месяцам из таблицы «Обороты». . Долг контрагента(=200) лежит в интервале 180-280, значит искомый период - сентябрь . Остаток долга для последующего поиска составит 200 – 180 = 20.
В вехней строке таблицы показаны нарастающие итоги оборотов.
| 0 | 100 | 180 280 |
|
Ноябрь |
Октябрь |
Сентябрь |
|
100 |
80 |
100 |
II. Получим последовательность документов с нарастающими итогами в сентябре. Остаток долга 20 лежит в интервале 0-60 , значит искомая строка таблицы «Обороты» найдена.
| 0 60 | 100 |
|
Накл. 1 от 20.09.09 |
Накл. 1 от 10.09.09 |
|
60 |
40 |
III. Скопируем все строки из таблицы «Обороты» с периодом большим или равным 20.09.09 в новую таблицу. Добавим новые колонки «Долг» и «Просроченный долг». Заполним добавленные колонки очевидным образом ,учитывая , что «Долг» для строки с «Накл. 2» составляет 20, и значение «Даты Отсрочки» - 01.11.09 .
|
Контрагент |
Период |
Рег-р |
Сумма |
Долг |
Просроченный долг |
|
Компания |
20.09.09 |
Накл. 2 |
60 |
20 |
20 |
|
Компания |
31.10.09 |
Накл. 3 |
80 |
80 |
80 |
|
Компания |
25.11.09 |
Накл. 4 |
100 |
100 |
0 |
Отступление для "семерочников".
Обратите внимание на то, что с точки зрения здравого ("семерочного") смысла мы сделали немыслимое : вместо очевидного перебора строк в таблице "Обороты" просуммировали по месяцам всю таблицу. Поехали в Москву через Владивосток ? - Смотри приложение в конце статьи.
В демонстрационном примере мы рассматривали лишь два вида интервала для поиска Месяц-документ. В реальных же задачах, когда очень большая таблица "Обороты" имеет строки с высокой плотностью по времени (розничные продажи по дисконтным картам , как у пользователя Anig99) количество видов интервалов для поиска должно быть увеличено, например Год - квартал - месяц - декада - день - документ.
Текст пакета запросов
Рассмотрим текст пакета запросов из отчета "ПросроченныйДолг", содержащегося в демонстрационной конфигурации "ПросроченныйДолг.dt". Таблицы "Долги"и "Обороты" реализованы как справочники . Сделано допущение, что поле "Период" в справочнике "Обороты" содержит только уникальные значения.
1. Найдем обороты по месяцам
ВЫБРАТЬ
Обороты.Контрагент,
НАЧАЛОПЕРИОДА(Обороты.Период, МЕСЯЦ) КАК НачПериода,
КОНЕЦПЕРИОДА(Обороты.Период, МЕСЯЦ) КАК КонПериода,
СУММА(Обороты.Сумма) КАК Сумма
ПОМЕСТИТЬ ОборотыПоМесяцам
ИЗ
Справочник.Обороты КАК Обороты
СГРУППИРОВАТЬ ПО
Обороты.Контрагент,
НАЧАЛОПЕРИОДА(Обороты.Период, МЕСЯЦ),
КОНЕЦПЕРИОДА(Обороты.Период, МЕСЯЦ)
;
Временная таблица "ОборотыПоМесяцам"
|
Контрагент |
НачПериода |
КонПериода |
Сумма |
|
Компания |
01.09.09 |
30.09.09 |
100 |
|
Компания |
01.10.09 |
31.10.09 |
80 |
|
Компания |
01.11.09 |
30.11.09 |
100 |
2. Получим нарастающие итоги для "ОборотыПоМесяцам".
ВЫБРАТЬ
ОборотыПоМесяцам.Контрагент,
ОборотыПоМесяцам.НачПериода,
ОборотыПоМесяцам.КонПериода,
ОборотыПоМесяцам.Сумма,
СУММА(ОборотыПоМесяцамКопия.Сумма) КАК СуммаПосле,
СУММА(ОборотыПоМесяцамКопия.Сумма) - ОборотыПоМесяцам.Сумма КАК СуммаДо
ПОМЕСТИТЬ ОборотыПоМесяцамНарастающие
ИЗ
ОборотыПоМесяцам КАК ОборотыПоМесяцам
ВНУТРЕННЕЕ СОЕДИНЕНИЕ ОборотыПоМесяцам КАК ОборотыПоМесяцамКопия
ПО ОборотыПоМесяцам.Контрагент = ОборотыПоМесяцамКопия.Контрагент
И ОборотыПоМесяцам.НачПериода <= ОборотыПоМесяцамКопия.НачПериода
СГРУППИРОВАТЬ ПО
ОборотыПоМесяцам.НачПериода,
ОборотыПоМесяцам.КонПериода,
ОборотыПоМесяцам.Контрагент,
ОборотыПоМесяцам.Сумма
;
Временная таблица "ОборотыПоМесяцамнНарастающие"
|
Контрагент |
НачПериода |
КонПериода |
Сумма |
СуммаДо | СуммаПосле |
|
Компания |
01.09.09 |
30.09.09 |
100 |
180 | 280 |
|
Компания |
01.10.09 |
31.10.09 |
80 |
100 | 180 |
|
Компания |
01.11.09 |
30.11.09 |
100 |
0 | 100 |
3. Найдем строку, интервал которой от "СуммаДо " до "СуммаПосле" содержит в себе значение долга (=200) , используя внутренне соединение таблиц "Долги" и "ОборотыПоМесяцамНарастающие".
ВЫБРАТЬ
Долги.Контрагент,
Долги.Долг,
Долги.ДатаОтсрочки,
ОборотыПоМесНарастающие.НачПериода,
ОборотыПоМесНарастающие.КонПериода,
Долги.Долг - ОборотыПоМесНарастающие.СуммаДо КАК ОстатокДолга
ПОМЕСТИТЬ ДолгиПоВыбраннымМесяцам
ИЗ
Справочник.Долги КАК Долги
ВНУТРЕННЕЕ СОЕДИНЕНИЕ ОборотыПоМесяцамНарастающие КАК ОборотыПоМесНарастающие
ПО Долги.Контрагент = ОборотыПоМесНарастающие.Контрагент
И Долги.Долг > ОборотыПоМесНарастающие.СуммаДо
И Долги.Долг <= ОборотыПоМесНарастающие.СуммаПосле
;
Временная таблица "ДолгиПовыбраннымМесяцам" Контрагент НачПериода КонПериода Долг Компания 01.09.09 30.09.09 200
ДатаОтсрочки
ОстатокДолга
01.11.09
20
4. Выберем из таблицы "Обороты" документы только за указанный период
ВЫБРАТЬ
Обороты.Контрагент,
Обороты.Документ,
Обороты.Период,
ДолгиПоВыбМесяцам.Долг,
ДолгиПоВыбМесяцам.ОстатокДолга,
Обороты.Сумма,
ДолгиПоВыбМесяцам.ДатаОтсрочки
ПОМЕСТИТЬ ДвиженияПоВыбраннымМесяцам
ИЗ
Справочник.Обороты КАК Обороты
ВНУТРЕННЕЕ СОЕДИНЕНИЕ ДолгиПоВыбраннымМесяцам КАК ДолгиПоВыбМесяцам
ПО Обороты.Контрагент = ДолгиПоВыбМесяцам.Контрагент
И Обороты.Период >= ДолгиПоВыбМесяцам.НачПериода
И Обороты.Период <= ДолгиПоВыбМесяцам.КонПериода
;
Временная таблица "ДвиженияПоВыбраннымМесяцам"
|
Контрагент |
Период |
Рег-р |
Сумма |
Долг |
ОстатокДолга |
ДатаОтсрочки |
|
Компания |
10.09.09 |
Накл 1 |
40 |
200 |
20 |
01.11.09 |
|
Компания |
20.10.09 |
Накл. 2 |
60 |
200 |
20 |
01.11.09 |
5. Получим нарастающие итоги по документам
ВЫБРАТЬ
ДвиженияПоВыбМесяцам.Контрагент,
ДвиженияПоВыбМесяцам.Документ,
ДвиженияПоВыбМесяцам.Период,
ДвиженияПоВыбМесяцам.Сумма,
СУММА(ДвиженияПоВыбМесяцамКопия.Сумма) КАК СуммаПосле,
СУММА(ДвиженияПоВыбМесяцамКопия.Сумма) - ДвиженияПоВыбМесяцам.Сумма КАК СуммаДо,
ДвиженияПоВыбМесяцам.ОстатокДолга,
ДвиженияПоВыбМесяцам.ДатаОтсрочки
ПОМЕСТИТЬ ДвиженияПредварительные
ИЗ
ДвиженияПоВыбраннымМесяцам КАК ДвиженияПоВыбМесяцам
ВНУТРЕННЕЕ СОЕДИНЕНИЕ ДвиженияПоВыбраннымМесяцам КАК ДвиженияПоВыбМесяцамКопия
ПО ДвиженияПоВыбМесяцам.Контрагент = ДвиженияПоВыбМесяцамКопия.Контрагент
И ДвиженияПоВыбМесяцам.Период <= ДвиженияПоВыбМесяцамКопия.Период
СГРУППИРОВАТЬ ПО
ДвиженияПоВыбМесяцам.Контрагент,
ДвиженияПоВыбМесяцам.Документ,
ДвиженияПоВыбМесяцам.Период,
ДвиженияПоВыбМесяцам.Сумма,
ДвиженияПоВыбМесяцам.ОстатокДолга,
ДвиженияПоВыбМесяцам.ДатаОтсрочки
;
Временная таблица "ДвиженияПредварительные "
|
Контрагент |
Период |
.... |
ОстатокДолга |
СуммаДо |
СуммаПосле |
|
Компания |
10.09.09 |
.... |
20 |
60 |
100 |
|
Компания |
20.10.09 |
.... |
20 |
0 |
60 |
6. По "ОстаткуДолга" =20 определим единственную строку и выведем ее в таблицу "ДвиженияОкончательные"
ВЫБРАТЬ
ДвиженияПредв.Контрагент,
ДвиженияПредв.Документ,
ДвиженияПредв.Период,
ДвиженияПредв.ОстатокДолга - ДвиженияПредв.СуммаДо КАК СуммаДолга,
ДвиженияПредв.Сумма,
ДвиженияПредв.ДатаОтсрочки
ПОМЕСТИТЬ ДвиженияОкончательные
ИЗ
ДвиженияПредварительные КАК ДвиженияПредв
ГДЕ
ДвиженияПредв.ОстатокДолга > ДвиженияПредв.СуммаДо
И ДвиженияПредв.ОстатокДолга <= ДвиженияПредв.СуммаПосле
;
Временная таблица "ДвиженияОкончательные"
|
Контрагент |
Период |
.... |
ОстатокДолга |
СуммаДо |
СуммаПосле |
|
Компания |
20.10.09 |
.... |
20 |
0 |
60 |
7. Используя таблицу "ДвиженияОкончательные" и внутреннее соединение с исходной таблицей "Обороты" получим выходную таблицу запроса.
ВЫБРАТЬ
Обороты.Контрагент,
Обороты.Период,
Обороты.Документ,
Обороты.Сумма,
ВЫБОР
КОГДА Обороты.Документ = ДвиженияОконч.Документ
ТОГДА ДвиженияОконч.СуммаДолга
ИНАЧЕ Обороты.Сумма
КОНЕЦ КАК СуммаДолга,
///
ВЫБОР
КОГДА Обороты.Период < ДвиженияОконч.ДатаОтсрочки
ТОГДА ВЫБОР
КОГДА Обороты.Документ = ДвиженияОконч.Документ
ТОГДА ДвиженияОконч.СуммаДолга
ИНАЧЕ Обороты.Сумма
КОНЕЦ
ИНАЧЕ 0
КОНЕЦ КАК СуммаПросроченногоДолга
ИЗ
Справочник.Обороты КАК Обороты
ВНУТРЕННЕЕ СОЕДИНЕНИЕ ДвиженияОкончательные КАК ДвиженияОконч
ПО Обороты.Контрагент = ДвиженияОконч.Контрагент
И Обороты.Период >= ДвиженияОконч.Период
Выходная таблица "ПросроченныеДолги"
|
Контрагент |
Период |
Рег-р |
Сумма |
Долг |
Просроченный долг |
|
Компания |
20.09.09 |
Накл. 2 |
60 |
20 |
20 |
|
Компания |
31.10.09 |
Накл. 3 |
80 |
80 |
80 |
|
Компания |
25.11.09 |
Накл. 4 |
100 |
100 |
0 |
В прикрепленном к статье файле "ПросроченныйДолг.dt"(26Кб) находится небольшая демонстрационная конфигурация,содержащая :
- справочники "Контрагенты","Долги","Обороты".
- отчет "ПросроченныйДолг".
После запуска конфигурации см. Рисунок ниже :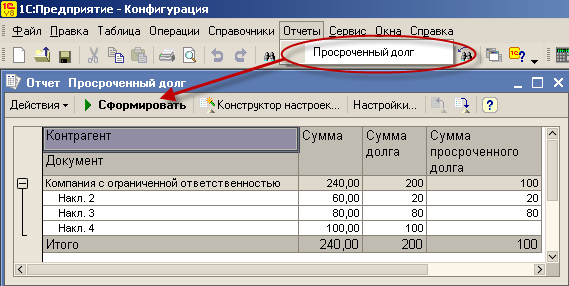
Приложение .
Что такое нарастающие итоги ? И зачем они нужны ?
Дана таблица с именем «Таблица» наших месячных оборотов :
|
Месяц |
Оборот |
|
Сентябрь |
100 |
|
Октябрь |
80 |
|
Ноябрь |
100 |
Вопрос : В каком месяце мы достигли суммарного оборота 200 ,начиная с сентября ?
Решение.
Представим , что у нас в языке 1с нет оператора цикла и «в лоб» перебрать строки таблицы мы не можем. Но у нас есть язык запросов.
Вначале сделаем «ненужный» вспомогательный запрос , проясняющий суть соединения по неравенству . Таблица "Таблица" соединяется "сама с собой".
Выбрать Т1.Месяц , Т1.Оборот, Т2.месяц,Т2.Оборот
ИЗ Таблица как Т1
ВнутреннееСоединение Таблица как Т2
по Т1.Месяц >=Т2.Месяц
|
Т1Месяц |
Т1Оборот |
Т2Месяц |
Т2Оборот |
|
Сентябрь |
100 |
Сентябрь |
100 |
|
Октябрь |
80 |
Сентябрь |
100 |
|
Октябрь |
80 |
Октябрь |
80 |
|
Ноябрь |
100 |
Сентябрь |
100 |
|
Ноябрь |
100 |
Октябрь |
80 |
|
Ноябрь |
100 |
Ноябрь |
100 |
Уберем из полей выборки лишние поля и сгруппируем по Т1Месяц с суммой поля Т2Оборот
Выбрать Т1.Месяц , Т1.Оборот, Сумма(Т2.Оборот) как СуммаПосле // так вот назвал
ИЗ Таблица как Т1
ВнутреннееСоединение Таблица как Т2
по Т1.Месяц >=Т2.Месяц
Сгруппировать ПО Т1.Месяц , Т1.Оборот
|
Т1Месяц |
Т1Оборот |
СуммаПосле |
|
Сентябрь |
100 |
100 |
|
Октябрь |
80 |
180 |
|
Ноябрь |
100 |
280 |
Но этого мало , в каждой строке нужно иметь интервал СуммаДо и СуммаПосле.
Поэтому перепишем запрос :
Выбрать Т1.Месяц , Т1.Оборот, Сумма(Т2.Оборот) как СуммаПосле ,
Сумма(Т2.Оборот) – Т1.Оборот как СуммаДо
ИЗ Таблица как Т1
ВнутреннееСоединение Таблица как Т2
по Т1.Месяц >=Т2.Месяц
Сгруппировать ПО Т1.Месяц , Т1.Оборот
|
Т1Месяц |
Т1Оборот |
СуммаДо |
СуммаПосле |
|
Сентябрь |
100 |
0 |
100 |
|
Октябрь |
80 |
100 |
180 |
|
Ноябрь |
100 |
180 |
280 |
Теперь нужно определить в какой строке выполняется двойное неравенство
СуммаДо <= 200 <= CуммаПосле. Или , другими словами, в каком месяце мы достигли оборота со значением 200.
Для этого поместим результат первого запроса во временную таблицу Итоги и приведем весь пакетный запрос решения :
Выбрать Т1.Месяц , Т1.Оборот, Сумма(Т2.Оборот) как СуммаПосле ,
Сумма(Т2.Оборот) – Т1.Оборот как СуммаДо
ПОМЕСТИТЬ Итоги
ИЗ Таблица как Т1
ВнутреннееСоединение Таблица как Т2
по Т1.Месяц >=Т2.Месяц
Сгруппировать ПО Т1.Месяц , Т1.Оборот
;
Выбрать Итоги.Т1Месяц,Итоги.Т1Оборот,Итоги.СуммаДо , Итоги.СуммаПосле
ИЗ Итоги как Итоги
ГДЕ 200 >Итоги.СуммаДо и 200 <=Итогм.СуммаПосле
Выходная таблица решения :
|
Т1Месяц |
Т1Оборот |
СуммаДо |
СуммаПосле |
|
Ноябрь |
100 |
180 |
280 |
Вывод : нарастающие итоги (значения колонок СуммаДо и СуммаПосле, задающих определенный интервал) нужны в контексте темы статьи для поиска некоторого определенного значения (Оборот = 200).
Примечание : Представим, что исходная таблица "Таблица" имеет миллионы записей . Тогда какого размера достигнет таблица в результате соединения "сама с собой" ( первый запрос в приложении) ?
Поэтому нарастающие итоги применять нужно для таблиц ограниченного
размера. В этом весь смысл приведенного в статье алгоритма :
нарастающие итоги применяются сначала для поиска в небольшой таблице месячных итогов , затем "вырезается" интервал в таблице "Обороты" и в этом небольшом месячном интервале снова используются нарастающие итоги для поиска нужного значения оборотов.
Вступайте в нашу телеграмм-группу Инфостарт
См. также
Инструментарий разработчика Роли и права Запросы СКД Разработчик Руководитель проекта 1С:Предприятие 8 Платные (руб)
Инструменты для разработчиков 1С 8.3 и 8.5: Infostart Toolkit. Автоматизация и ускорение разработки на управляемых формах. Легкость работы с 1С.
16500 руб.
02.09.2020 285512 1606 423
WEB-интеграция Запросы Разработчик 1С 8.3 Абонемент ($m)
Post1C - это внешняя обработка, которая превращает 1С в полноценный инструмент для тестирования REST API. Всё управление сосредоточено в одном окне: настройка запроса, выполнение, просмотр ответа и генерация кода - без переключения между формами. Аналог Postman, но работающий в привычной среде 1С.
1 стартмани
02.04.2026 4633 105 priem_nv 27
Инструментарий разработчика Запросы Разработчик 1С:Предприятие 8 1С:Зарплата и кадры государственного учреждения 3 1С:Зарплата и Управление Персоналом 3.x Абонемент ($m)
QueryConsole1C — расширение, включающее консоль запросов с поддержкой исполняемых представлений — аналогов виртуальных таблиц, основанных на методах программного интерфейса ЗУП. Оно позволяет выполнять запросы с учётом встроенной бизнес-логики, отлаживать алгоритмы получения данных и автоматически генерировать код на встроенном языке 1С.
1 стартмани
16.05.2025 13646 168 zup_dev 32
Запросы Разработчик Бесплатно (free)
Увидел cheatsheet по SQL и захотелось нарисовать подобное, но про запросы.
18.10.2024 28927 sergey279 18
Запросы Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Столкнулся с интересной ситуацией, которую хотел бы разобрать, ввиду её неочевидности. Речь пойдёт про использование функции запроса АВТОНОМЕРЗАПИСИ() и проблемы, которые могут возникнуть.
11.10.2024 24492 XilDen 40
Инструментарий разработчика Запросы Разработчик Стажер 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Пишем на человеческом языке, что нам надо, и получаем текст запроса на языке 1С. Используются большие языковые модели (LLM GPT) от OpenAI или Яндекс на выбор.
15.01.2024 20796 444 mkalimulin 34
Очень немногие из тех, кто занимается поддержкой MS SQL, работают с хранилищем запросов. А ведь хранилище запросов – это очень удобный, мощный и, главное, бесплатный инструмент, позволяющий быстро найти и локализовать проблему производительности и потребления ресурсов запросами. В статье расскажем о том, как использовать хранилище запросов в MS SQL и какие плюсы и минусы у него есть.
11.10.2023 29448 skovpin_sa 15
HighLoad оптимизация Запросы Мониторинг Разработчик Бесплатно (free)
Расскажем, как найти часто повторяющиеся запросы.
05.10.2023 13073 ivanov660 3
1. Никаких вложенных запросов.
Представленный пакет предствляет собой совокупность последовательно получаемых простых временных таблиц.
2. Никаких выражений в условиях соединения .
Применение операторов и выражеий в условиях соединения повышает время исполнения запроса.
3. Никаких сложных выражений в полях выборки .
В частности, оператор ВЫБОР применен лишь для двух полей в последнем запросе пакета .
вынудившего автора написать эту статью.
Подход Anig99 к решению этой задачи , заключающийся в том , что весь алгоритм должен умещаться в один пакет запросов и не содержать кодинга , представляется автору глубоко верным.
Такое же глубокое ,но уже несогласие, автор выражает по поводу алгоритма решения и техники исполнения в вышеназванной теме Anig99 . См (1).
Ну ничего .. Сейчас попробуем.
Пост (2) во второй части означает отвержение твоего алгоритма решения - раз ! осуждение техники исполнения в твоей разработке с посылом к (1) - два ! Забирай плюс назад !
ножом - удобно резать ...
топором - удобно колоть ...
молотком - удобно забивать ...
ключевое слово "удобно" ... хотя конечно можно-с и молотком - резать или колоть ...
... 1С поставило во главу угла запросы ... понятно SQL он и есть SQL ...
... но лично я запросами получаю максимально приближенные таблицы - только то, что Запрос делает быстро ...
а вот ТАКИЕ вещи просто делаю в "результатах" ... как и много другое ... потому, что:
... 1. я не такой спец в запросах ...
... 2. и есть вещи для которых данный язык (запросов) просто не приспособлен - елементарно "сцепить" тестовые строки ...
... вотТАКОЕестьМНЕНИЕ ...
Цель этой статьи как раз и показать на конкретном примере ,
что вырежешь ножом - не вырубишь топором.
Привычные топорные "семерочные" алгоритмы в "восьмерке" будут плохо работать или не работать вовсе на базах 100 -200 Гб.
И правильнее писать такие отчеты ,которые будут работать на любых базах, маленьких или больших, без приписок вроде : "Ой , не для всех баз."
Конкретный пример : Anig99 занялся оптимизацией отчета и перешел к варианту "один запрос" не от хорошей жизни, а потому что вывод первоначально сделанного "обычного" отчета занимал более 30 мин.
Симпатично , вроде.
А выборка в базе 200Гб может быть настолько большой , что сделает невозможной дальнейшую обработку и выгрузку данных с сервера на клиента. Это раз.
Для больших объемов данных такая переброска данных с сервера на клиента тоже затратна. Это два.
Поэтому нужно стремиться как можно плотнее использовать запросы
и всю обработку выносить на сервер Бд.
Клиент же должен получать готовые выходные данные , небольшие по объему.
Из этой идеологии и вытекает другое построение алгоритмов , так нелюбимое в среде 1сников.
Совсем не гуд.
Скулевский оптимизатор может не все понять правильно :)
Укажи ему явно индексируемые поля для исключения неоднозначности.
В демонстрационном варианте , думаю, возможно и опустить. Но если дашь ссылку где сказано , что всегда лучше индексировать явно таблицу перед соединением в след.статьях буду ставить.
Откуда взялись долги и соответственно просроченные долги для накл.2 и 3 ?
Что такое дата отсрочки? и почему она = 01.11?
или ты что-то в описании пропустил, или условия неточны?
Постановка задачи приведена для конкретного элементарного примера .
Таблицы заполнены значениями на вкус автора,
чтобы читатель мог визуально убедиться в правильности хода вычислений.
И проверить "на глаз" правильность запросов.
Весь продемонстрированный ход алгоритма с показом промежуточных результатов как раз показывает как из двух первых таблиц получается выходная таблица .
ДатаОтсрочки - это дата , которой все суммы документов с более ранней датой считаются просроченным долгом. Обычно в начальных условиях указывается количество дней отсрочки платежа. Я пошел на упрощение и задал в начальных условиях ДатуОтсрочки.
Показывать реальный запрос в статье вряд ли нужно.
Текст запроса и так для статьи слишком велик . Мне не удалось его упростить и сжать сильнее.
Вопрос - нафига нам нужны лишние выборки и ограничения по месяцам/периодам ?
Ведь в условии об этом нигде не сказано, нужно получить выходную таблицу, в которой нет никаких месяцев :)
Если так, предлагаю в описании это каким-то образом обозначить.
Иначе сторонний/новый наблюдатель/тестер, не читавший всю дискуссию, в роли которого я сейчас пытаюсь выступить :) , может не понять данной схемы :)
Выбор периода "месяц"- это на вкус разработчика.
У меня вначале демонстрационного запроса находятся суммарные итоги по месяцам (как из один из возможных вариантов).
А у Саши Anig99 вначале запроса находятся суммарные итоги - по дням, потом по месяцам, потом по годам.
Я мог сделать также , но для демонстрации принципа алгоритма показалось достаточным обойтись "МЕСЯЦАМИ".
гарантирую, что запросы по частям + ТЗ сделает всЁ гОООраздо быстрее ... проверял ! и делаю именно тАк ...
... что-то не тАк в датскомИСХ_2королевстве ... что-то не договариваем-с... да-сссс...
... нет ужжж ... каждыму инструмент своЁ предназначение - ...
... а если говорить про модное СКД - дык это и есть Запрос+ТаблицаЗначение ...
... вот ...
Месячные итоги хранятся отдельно в базе . И обращение будет не ко всей базе , а к месячным итогам. Наоборот - все полетит.
Гарантировать не спеши . Ох , не спеши.
Я ведь нигде не утверждал : запрос +ТЗ медленней .
Я говорил о том , что один пакет запросов - оптимальнее для разных режимов работы , разных размеров баз, для разных по силе "клиентов" и т.д.
Вот чем хорошо перекладывать всю обработку на сервер.
При запросе ты ведь не знаешь за какой период по конретному клиенту нужно делать запрос (может у него есть неоплаченные накладные составляющие текущий долг аж 5 лет назад). Тебе придется или делать один сумашедший запрос по всем клиентам за весь период и твоя любая "клиентская машина" захлебнется. Или же делать несколько запросов по частям выбирая весь период. Что снижает быстродействие.
Время исполнения конкретного алгоритма зависит слишком от многого.
Вот мы встретились с тобой . То , да сё...
Пошли , конечно, прежде всего тестировать и сравнивать быстрдействие твоего метода и моего . И допустим , запрос+ТЗ сработал быстрее.
Может быть такое ? Может.
И ты крикнешь : Ага !!!! С тебя бутылка !
Я вспомню о делах , приму озабоченный вид и по -еврейски (прости, Аркадий) улизну.
И буду прав.Потому что запрос "всё в одном" быстрее не ВСЕГДА. , а в среднем.
На некоторых данных он чуть проиграет, на некоторых данных сильно выиграет, т.е. всреднем оптимальнее.
Но при 200Гб ,уверен, Запрос +Тз в данной задаче захлебнется .
вложенный запрос ...
запрос+ТЗ ...
... чтобы понять быстродействие - нужно понять "физику" этих процессов ...
тогда и писать меньше надо будет ...
ВОТ мне и хочется чтобы ТЫ прояснил данную "физику" - дЫк чем оТличается вложенный_запрос от пакетного_запроса ...
... тогда можно будет и поговорить более предметно и детально ... без МЕТАфизики ...
... вотТАКОЕпредложение ...
... вот ... а вот если тЫ этого не знаешь ... ? ... ! тогда твоя статья ЭТО профанация .. гадание на кофеёной гуще ... "залезе не залезе.... или пролезе ... неее ... нЕпролезе ..."
... вОООООттакаявОООООтпрОООООвОООООкация ...
...
ИТС, где читал про оптимизацию запросов, с собой нет, поэтому погуглил
Вот отсюда
Сообщение номер 539689
Максим Радченко, 1С
539689
Сами по себе вложенные запросы не страшны. Страшны соединения с вложенными подзапросами. Их использование очень затрудняет выбор оптимального плана для СУБД. Поэтому высока вероятность ошибки оптимизатора и, соответственно, катастрофического замедления запроса.
Разница в производительности может быть огромной. Например, при выборе правильного плана запрос может работать 1.5 сек, а при выборе неправильного - 18 часов (это реальный случай).
Поэтому следует всегда избегать соединений с вложенными подзапросами. Вместо этого надо использовать временную таблицу.
При использовании временной таблицы запрос будет всегда работать стабильно быстро. Ключевое слово тут - стабильно. Запрос, содержащий соединения с вложенными подзапросами, тоже может иногда работать быстро. Но гарантировать этого нельзя.
......
Обратите внимание, что существует экзотический случай, когда вложенный подзапрос ни с кем не соединяется. То есть написано
ВЫБРАТЬ ИЗ (ВЫБРАТЬ ИЗ ( ВЫБРАТЬ ИЗ ...)))
и все. В этом случае использовать временные таблицы необязательно. Но можно и использовать. Никакого замедления при этом не произойдет.
Резюмируя можно сказать, что всегда нужно стремиться (с помощью временных таблиц в том числе), делать запрос как можно проще. Избегать вложенных подзапросов, а особенно соединений с ними.
Ну о том, что один правильный запрос в SQL версии много быстрее цикла с множеством запросов или проход по таблице значений с условиями, спорить не будем?
1. что значит правильный ?
2. что значит быстрее ?
...
вопрос заключается : если знаешь принцип построения запросов - язык прежде всего декларативный а внутри правила выборки и соединения (оптимизация на основании внутренних алгоритмов) - то тогда можно и сделать правила и ответить на вопрос: когда и где и как и в каком запросе как соединять и как выбирать ...
... а то что вложеные запросы надо переводить во временные таблицы - и так все знают - везде об этом пишут НО на уровне общих рекомендаций ...
могу порекомендовать следующую ссылку и далее ссылки по всему тексту: ...
... а то, что написано ТУТ - напоминает тексты об УправленческомУчёте - и красиво и похоже на правду и хочется верить - но начинаешь повторять и не получается ...
... вот ...
(30)Всё не так. Язык запросов SQL (стандарт пока только один -92г.)- описание синтаксиса, он сам по себе - и внутри у него ничего не сидит.
Разные производители придумывают разные оптимизаторы , например оптимизатор SQL-сервер. Описание внутренней структуры оптимизатора никто не публикует и не документирует(документация отсутствует и у оптимизатора запросов 1с в файловом варианте). И для нас он - черный ящик. Мы , строго говоря , лишь догадываемся , что там внутри и не можем
"ответить на вопрос: когда и где и как и в каком запросе как соединять и как выбирать ... "
Представляешь в какое положение попадает разработчик ?
Написав сложный запрос с вложенными запросами - он НЕ ЗНАЕТ как запрос будет выполняться в каждом конретном случае у каждого конкретного оптимизатора разных фирм !!!
Хочется себя обезапасить. и не применять вложенные запросы , которые допускают двоякость и троякость толкования.
Технология временных таблиц (разбиение на мелкие запросы и заданный порядок исполнения) дает возможность написания однозначно понимаемого любым оптимизатором алгоритма действий.
Второе соображение , отлаживать запрос с временными таблицами гораздо легче (последовательное выполнение временных таблиц). А как ты будет контролировать и смотреть выполнение каждого вложенного запроса ?
Третье соображение : продемонстрировать для публики (см. тему) запрос с временными таблицами и показом промежуточных результатов удобнее . Легче разбираться в нем и другому программисту.
Декларативность языка запросов ИЗНАЧАЛЬНО предполагает неопределеность в вопросе КАК ? В КАКОМ ПОРЯДКЕ ? и не дает на этот вопрос никакого ответа.
Т.е. я напишу сейчас запрос тебе простенький( с вложенным) и ни ты и никто не скажет определенно как он будет выполняться.
УФФ !
ваши и статья и комментарии разговор о повседневном, без желания обсуждать, без утверждений, без "глубины" и без "ширины" рассматриваемого вопроса ... лужа ...
... как всегда уход от желания обсуждать в сторону использования нескольких демагогических прАвил - для бега по кругу ... нет желания Зделать проблему "прозрачной", наоборот, утопить её в не связанных цифрах, чтобы оставить лазейки для бегства - типа это упрощение - вот ваша цель ...
... у вас есть хороший оппонент - ... I_G_O_R ... - вот его публикациям и комментариям я верю ... есть чему по-учиться ... и есть желание залезть в интернет ...
... вотТАКАЯкритика ...
Один и тот же запрос может выполняться по - разной схеме(последовательности действий) в зависимости от размера используемых таблиц . Ты представляешь какая это засада ?
И рассказ о том , что все было хорошо и работатло , а потом вдруг БАЦ и какой то мелкий запросик вместо выполнения в доли секунды - выполняется !! сутки!!! - это не байки . Это проделки оптимизатора запроса.
Это демонстрационный вариант. Оптимального алгоритма. Для возможного изучения . И не более того.
(22) В тексте темы указано на это упрощение (уникальный период).
По моменту времени нельзя сортировать и соединять временные таблицы.
Это недостаток 1с платформы. Момент времени может использоваться только в при выборке из регистров для соединения или сортировки .
Это недостаток 1с платформы.
откуда такие данные?
вот только сделал в кострукторе:
ВЫБРАТЬ
ВзаиморасчетыСРаботникамиОрганизаций.Физлицо,
ВзаиморасчетыСРаботникамиОрганизаций.Регистратор,
ВзаиморасчетыСРаботникамиОрганизаций.СуммаВзаиморасчетов КАК Сумма,
ВзаиморасчетыСРаботникамиОрганизаций.МоментВремени
ПОМЕСТИТЬ ВТДолги
ИЗ
РегистрНакопления.ВзаиморасчетыСРаботникамиОрганизаций КАК ВзаиморасчетыСРаботникамиОрганизаций
;
//////////////////////////////////////////////////////////// ПоказатьСделано допущение, что поле "Период" в справочнике "Обороты" содержит только уникальные значения.
Если это так , как ты пишешь и ты проверил исполнение ,то виноват !
И не получилось еще вот что , после выгрузки в таблицу значений - сортировать по Моменту времени нельзя (неправильно получается)- это уже совсем недавно.
Для реальной конфигурации конечно запрос должен быть переделан.
Справочник "Обороты" - экзотика, тоже ведь серьезное допущение ,а ты его не упомянул .
Отвечаю прямо об отличии :
Вложенный запрос - это часть другого запроса.
Пакетный запрос   - это совокупность последовательно выполнямых
                            запросов.
Если ты имеешь ввиду отличия между выполнением одной и той же задачи разными способами
1. Запросом, имеющим вложенные запросы
2. Пакетным запросом ( последовательное выполнение нескольких простых запросов).
И задаешь вопрос , так сказать, какова "физика" этих отличий ?
То я спрашиваю , нафига я писал (30) ?
Если ты понимаешь под "физикой" отличий что-то другое - дай определение
этой "физики".
то несомненно нужная и полезная статья ,
приоткрывающая дверь к кухне интерпертации запросов 1с в SQL.
Но эта информация полезна для очень ограниченного круга специалистов, разрабатывающих какие -то специализированные решения на платформе 1с . Статья эта лишь на другом уровне и подробностями раскрывает ,то что есть уже у Радченко.
При использовании временной таблицы запрос будет всегда работать стабильно быстро. Ключевое слово тут - стабильно. Запрос, содержащий соединения с вложенными подзапросами, тоже может иногда работать быстро. Но гарантировать этого нельзя.
Для огромного подавляющего большинства 1с-ников этого вполне достаточно.
Мало того , почти наверняка, можно сказать :
1с-ник ! Если у тебя проблемы и ты полез смотреть как 1с запрос интерпретируется в SQL-запрос - ЗНАЙ : ты не знаешь как правильно составлять запросы.вопрос1:
... дык при каких условиях и пАчему Пакетный запрос выполняется быстрее ...?
вопрос2:
... дык как же Зделать Нарастающий Итог в запросе ...?
самый простой тип нарастающего итога это нумерация строк запроса ... прошу тебя не влезая в дебри конфигурации:
1. покажи нАм
и
2. рАсскажи нАм
и
3. укАжи нам
... способы создания нарастающих итогов в запросах ...
... лично мне интересно .... сделай это дополнением к статье ... я до сих пор не умею делать нарастающие итоги ... хотя бы нумерацию освоить ... а вот понятных изложений пока не нашЁл ... только по простому - чтобы даже мне было понятно ...
думаю это будет интерсно и важно и познавательно для многих ...
... вОООт ...
Ключевые слова здесь "правильно понятый". Чтобы избежать вероятности "неправильной понятости" и применяют пакетный запрос.
Сегодня подготовлю демо-вариант с нарастающими итогами с наглядным примером.
Пакет запросов скорее всего будет выполнятся быстрее, чем объединение вложенных запросов. Причиной тому - сложность для оптимизатора SQL работы с объединением вложенных запросов. Гораздо меньше неоптимальных инструкций SQL возникает при разборе простых запросов и дальнейшей передаче по цепочке временных таблиц.
З.Ы. Честное слово... Такое ощущение, что специально упускаешь из внимания некоторые моменты, которые были уже сказаны
но твоЁ изложение слишком "продвинуто" и а изложение Исх_2 - запутано ...
может ВЫ и понимаете - а я нет ...
самое простое = как соединить две таблицы чтобы можно посчитать нарастающий итог ... хотя бы нумерация строк запроса ... а то сразу " ... Метод последовательного приближения. ..." ...
... хочется как-то более простых и наглядных примеров: типа: как составить запрос: 1. выбрать номенклатуру из папки разрезе характеристик,
+
2. найти остатки в разрезе выбранныйСклад-номенклатура-характеристика,
+
3. найти зарезервировано в разрезе выбранныйСклад-номенклатура-характеристика,
+
4. вывести свободный остаток в разрезе выбранныйСклад-номенклатура-характеристика
и даже бог с ним с разбиением по периодам ...
... если бы меня кто этому научил - последовательно и обЪясняя по шагово - спАсибо бы сказал ...
... вот ...
работа по вам плачет :D
... кстати вам не обидно, что из 24 часов только 8 тратите на работу ...
... вот ...
Так вот
Пальцем в небо. Тяжело дается диалектический подход . Получше будет так:
Научный подход подразумевает :
Без теории нет практики. Без практики нет теории.
... твоЁ желание придраться больше чем "Правда" и выше чем "Истина" ...
... основой науки есть повторяемый опыт как Эксперимент и Опыт как опыт ...
... поэтому его сначало "наблюдают" потом "описывают", потом "повторяют" ...
... именно поэтому без Теории нет Науки ... нет Практики ... нет Опыта ...
... хотя некоторых Теория никогда не станет Опытом пока они не получат опыт ...
... вотТАКАЯтеория ...
Я предпочитаю находить ответы экспериментальным путем.
Но своих убеждений стараюсь не то что не навязывать, а отговаривать от них. Вообщем, главное, без фанатизма. 8-)
без ТЕОРИИ нет эксперимента ... !!! ... однозначно !!! ...
... есть холерики - им проще 40 раз сбегать и один раз подумать ...
... есть меланхолики - им проще 40 раз подумать и один раз сбегать ...
НО ! но сначало ТЕОРИЯ а потом Эксперимент ...
... вот ...
Назвался автором - будь им : "навязывай" свой взгляд ,ты этим взглядом и отличаешься от других
Над чем тут мозг ломать - есть.
Речь ведь идет не только о решении конкретной задачи , но и об ощем подходе к использованию нарастающих итогов в запросе.
Если бы ты хоть чуть-чуть расшифровал слова здесь или в статье
"запрос с коррелированными подзапросами" - появилось бы еще одно решение - возможно самое оптимальное.
А 8.2 и агрегатами пугать простую публику не стоит.
1. Рейтинг - это не аргумент. Рейтинг - это повод поинтересоваться - а что там ?
2. Запрос в цикле - это зло. Широко известное еще до изобретения "семерки".
Применяется исключительно редко (например тогда , когда результат общего запроса может быть оч.оч. большим по размеру.)
Серверу не все равно обрабатывать кучу мелких запросов или один большой.
Разумеется , быстрее будет выполнен один общий правильно составленный запрос. Хотя бы потому что, обращение к базе данных будет всего одно (а это время !). Поэтому всегда нужно стремиться к одному запросу, а не к циклу запросов.
Убедиться в этом можно практическим путем. Перепиши свой отчет - сделай один запрос к базе для всех контргаентов . Получи выходную таблицу за один проход выборки. Сравни время.
Один запрос , набранный в конструкторе , технологичней в использовании.
Применяя "Запрос + кодинг" для больших баз ты жестко привязан к "силе клиента" , к сети и т.д, т.к. часть кодинга выполняется на "клиенте". Передавая обработку на сервер ты отвязываешься от этих проблем.
Для базы 120 Гб применение твоего запороса в цикле неприемлемо в принципе.
Так вот кратенько...
И в полях выборки используется номенклатура.
Какое отношение они имеют к задаче получения просроченных долгов контрагентов ? Чем они нам помогут ?
В таком случае , возможно , лучше опубликовать статью где раскрыть замысел полностью.
А вот , неравенство в условии соединения запроса (68) имеет прямое к текущей теме .
Рассмотрим чаить этого запроса
ВЫБРАТЬ
    Продажи.Родитель КАК Родитель,
    Продажи.Номенклатура КАК Номенклатура,
    Продажи.Количество КАК Количество
ИЗ
    Продажи КАК Продажи
        ВНУТРЕННЕЕ СОЕДИНЕНИЕ Продажи КАК ПродажиНумерация
        ПО Продажи.Родитель = ПродажиНумерация.Родитель
И Продажи.Количество <= ПродажиНумерация.Количество ПоказатьПредставим , что в таблице всего одна группа содержащая 10 000 товаров.
(для крупных торговых сетей ничего фантастического, кстати).
Тогда в результате соединения получим таблицу с количеством записей
(10 000+1)/2*10 000 = 50 005 000 (сумма членов арифметической прогрессии). Т.е. размер первоначальной таблицы увеличился более в чем 5 000 раз. Последующая группировка с условием не отменяет необходимости такого соединения , а лишь при получении выходной выборки фильтрует промежуточную таблицу.
Ты не видишь здесь никакой проблемы ?
Так вот текущая статья и статья Anig99 посвящены как раз тому , чтобы избежать таких больших промежуточных таблиц в процессе исполнения запроса.
Приведенный пример не выдумка . С подобной ситуацией столкнулся Anig99 при работе с базой 120Гб.
Поэтому приводя тексты таких запросов лучше предупреждать пользователя :
"Этот запрос пригоден для небольшого количества данных (малые базы до 30Гб). Не вздумайте применять такие подходы для больших баз (более 120 Гб)."
... гипноз нулей ...
... кто больше ... 100 ГБ ... 120 ГБ ... 150 ГБ ... 200 ГБ ... 80 000 строк ...
... сумма членов арифметической прогрессии ...
... прямь как в рекламе : не поворяйте этого - это сделано в фотошопе ...
... ВОТ ...
Магия, не магия, но из малого произрастает большое.... Современные компьтеры расхолаживают программистов позволяя не задумаваться об оптимизации кода и экономии памяти. В результате получаем расчет себестоимости и корректировку стоимости списания по 6 часов... Перешли для получения нового функционала и получения аналитики - но плата за это - длительность не очень сложных расчетов. Вот проблема на самом деле.
Требовалась жесточайшая экономность кода.
Эти Кб занимали , обменивали , одалживали до след. проекта и т.д.
Началась антиалкогольная компания и Кб обменивали на бутылки.
(74) 120 гигов, пустое хранилище, база за 4 года, по 10 тыс документов реализации в месяц. Так понятнее? Куча виртуальных таблиц - это реализация алгоритма. Если его понять, остальное - тут же становится ясно. Я и не надеялся, что кто-то без разъяснений алгоритма разберется (хотя нашелся как минимум 1 человек, который разобрался без моих дополнительных объяснений).
З.Ы. Сейчас я не буду впадать в полемику. Хочу отдохнуть на выходных
... выбран слишком простой демагогический приЁм, чтобы увести разговор от конкретного примера в сторону красоты "филосовской" сложности ...
... уверен, я не провоцирую, Eugeneer вас "отметелит" сложной философской простотой - "бритвы Оккаямы" ...
... вОООт ...
п.с. «Бритва (лезвие) О́ккама» — методологический принцип, получивший название по имени английского монаха-францисканца, философа-номиналиста Уильяма Оккама (Ockham, Ockam, Occam; ок. 1285—1349). В упрощенном виде он гласит: «Не следует множить сущее без необходимости»
...
... порвЁт тебя Eugeneer как тузик грелку ...
... и хорошо ... может чего-нибудь и надумаешь ...
... вот ... без злорадства но с надеждой ...
С тобой всё по другому. Я никак не могу понять, что тебе надо. То ты просишь раскрыть механику оптимизатора запросов SQL - а это теория, т.к. для каждой базы всё будет по-разному. То ты заявляешь, что тебе нужна конкретика - покажите запрос. То ты пишешь пост в стиле "дао программирования". И всех обвиняешь в увиливании...Никто с темы слезть не пытается. Просто люди по-разному воспринимают проблему: кто-то конкретно запрос на дебиторку, кто-то запрос с нарастающими итогами, кто-то преимущества разных вариантов сочетания запросов и кода, а кто-то вообще не видит проблемы. Одно твое желание я знаю точно - расшевелить болото.
... но ткнул понятием 1 курса ... ещЁ один демАгоический приЁм ...
... прям как у М.Жванецкого "... что может сказать хромой об исскустве Герберта Фон Караяна, если ему сразу сказать что ОН хромой ..." ...
... значИтельность не может быть больше знАчимости ...
... вот ...
1. уважаю ваше мнение ...
2. мне хочется знать то чего не знаю, в чём сомневаюсь, то что хочу знать ещё лучше ...
3. методы получения знаний могут быть разные ...
но когда на конкретный вопрос о 2*3 тебе начинают говорить об "ИНТЕГРАЛЬНЫХ МЕТОДОВ ДЕТЕРМИНИРОВАННОГО ФАКТОРНОГО АНАЛИЗА" поневоле начинаешь задумываться ... так ли нужна сложность интеграла в получении утроенного сложения ... такая вот дЕмагогия ...
... вот ...
... почти в тему но не совсем : ...
...вот ...
...
Но если мы только получили временную таблицу - индекс у нее отсутствует.
Оптимизатор запроса или мы явно должны ее индексировать ?
Я не нахожу большой разницы . Артур считает , что надежнее всё-таки явно её проиндексировать.
Под пунктом 2 приведено первоначальное мнение автора этой статьи.
Полностью совпадающее с Вашим. Вообще говоря, количество операций (трудоемкость) при этом варианте значительно меньше.
И если в кого-то автор тыкает пальцем и покатывается со смеху , то прежде всего в себя.
Первый вариант (запросы в цикле) был рассмотрен выше в коментариях.
Надеюсь Вы согласны, что запрос в цикле - это зло.
Второй вариант (одним запросом получить выборку для всех контрагентов и из нее получить выходную таблицу) имеет одно ограничение.
Мы не знаем периода этого запроса ( какова самая рання дата неоплаченного документа ), т.е. вынуждены выгружать на клиента все обороты всех контргаентов за весь период. До определенного размера базы этот ограничение не имеет смысла. Но ведь где -то этот предел существует ! И время передачи только одной выходной таблицы запроса может стать неприемлемо большим.
Для конфигурации в крупной розничной сети , торгующей по дисконтным картам 3-4 года, это ограничение может быть актуальным. Грузить на клиента огромную выборку проблематично.
Говорить о слабости клиента стоит !
При использовании подхода "все в одном запросе" на клиента поступает очень небольшая таблица для визуального отображения и не более того.
Это и есть важнейшее преимущество третьего подхода - его универсальность. Технологичность же подхода определяет отсутствие кодинга : запрос составляется в конструкторе.
Поэтому такой подход и был назван оптимальным : на малых базах(до 30 Гб)много не проиграет , на больших выиграет.
Сейчас вы аргументируя это тем, что "мы не знаем периода запроса".
НО! При подходе "скрестить две таблицы" мы его тоже не знаем!
Дальнейшее рассуждение "При использовании подхода "все в одном запросе" на клиента поступает очень небольшая таблица для визуального отображения и не более того" - значит что? Что по нарастающему итогу делается фильтрация! Т.е. как у вас в статье в приложении. Однако, кроме как там, о фильтре по н.итогу более нигде не сказано - а это всего лишь одно из применений. Может конечно в исходной постановке речь шла именно об том - тут в этих статьях и ссылках друг на друга черт ногу сломит, может я что-то и пропустил - только этого не видно.
Так вот, если задача стоит лишь в определении одного показателя - ее можно решить и другими методами - например, искать остатки двоичным поиском, сужая период.
Ну и наконец, никто не запрещает таки цикл на сервере делать (эта возможность не является стандартом и зависит от реализации, но и MSSQL, и Postgre ее предоставляют). А коли 8ка этого не умеет - проблемы 8ки :). 7.7 с 1С++ это позволяет.
Сейчас вы аргументируя это тем, что "мы не знаем периода запроса".
НО! При подходе "скрестить две таблицы" мы его тоже не знаем!
Предельно конкретно.
У вас 100 контргаентов . Общее количество документов всех контргаентов за весь период 2-4 тыс. Вы выгрузили одним запросом все эти документы в выборку. И за один проход в цикле выборки получили выходную таблицу . Вы выиграете у метода "Все в одном запросе" ? Отвечаю : Да ! Много выиграете ? Отвечаю : несущественно (для пользователя).
И мы с Вами говорим : Ура! "семерочные" подходы рулят !
У Вас 100 000 контрагентов 30 000 000 документов за весь период.
Если Вы скажете что этого мало - я Вам скажу 1 000 000 и 300 000 000.
Не торопитесь выгружать эти обороты в одну таблицу(выборку) и пройтись по ней циклом. Вы жестоко проиграете на одной переброске такой таблицы с сервера на клиента. Вы должны также сказать, что и клиентская машина должна быть очень не простой .
Т.е. появляется масса "НО". Чтобы от этих "НО" отвязаться не проще ли отказаться от перегонки таблиц "сервер-клиент" вовсе , а всю обработку передать на "сервер" , а на клиентскую машину выдавать только результат запроса (оч.маленькую таблицу для отображения в отчете) ?
Это лишь один аргумент.
Второй аргумент . Да , Количество операций в методе "все в одном запросе" больше. Но и выделенный сервер базы данных гораздо мощнее клиентской машины. Операции группирования и суммирования выполняются многократно быстрее чем при при "ручном кодинге цикла" на клиентской машине.
Так вот. Мы не знаем периода запроса для каждого контрагента , но мы его ищем . Сначала суммируем по месяцам - получаем оч.небольшую таблицу - в ней ("срещиваем сама с сбоой") находим нар.итоги . По сумме долга определяем период для каждого контргаента. Согласно этому периоду вырезаем только нужные документы для каждого контргаента , их "скрещиваем" и находим тот самый первый неоплаченный документ.
Это и есть подход , который кажется "ужасно затратным". Но он эффективен т.к. сервер базы данных совершает те операции , для которых он и предназначен.
С одним я согласен . Полная аргументация в статье в пользу выбранного подхода опущена напрасно.
Из Ярославля в Москву быстрее доехать через Владивосток, потому что мы поедем на Сервере Баз Данных .
На дохлом велосипеде (клиентской машине) до Москвы добираться дольше.
"Вы выгрузили одним запросом все эти документы в выборку. И за один проход в цикле выборки получили выходную таблицу ...И мы с Вами говорим : Ура! "семерочные" подходы рулят !"
- Маленькое замечание. В "1С 7.7" цикл выполняется не по выборке, а непосредственно по таблице базы данных. В DBF-ной версии - всегда так. В SQL-ной версии - не всегда. Т.е. термин "семерочные подходы" имеет разный смысл в разных версиях "1С 7.7".
И, кстати, "в ДБФ цикл выполняется по таблице" тоже неверно - это разве что в простейшем случае, типа ВыбратьЭлементы()/получитьЭлемент(). Для н/итогов (да и просто итогов :) ) всяко некая промежуточная выборка должна быть построена.
На самом деле речь идет о применении оператора "цикл" или о шаблоне мышления программистов СУБД гораздо более старом чем "семерка" .
Суть этого шаблона в том , что с таблицами нужно работать , перебирая записи явно в цикле (т.е. сканируя таблицу). Я же считаю , что это очень дурной тон тогда , когда можно обойтись агрегатными командами или запросами.
Например, в FoxPro решая такую задачу , можно обойтись без циклов и запросов , а только используя агрегатную командe Replace .
Отступление. Привычным и понятным для 1с-ника , например при расчете зарплаты, является подход , реализованный в тип.конф-иях :
позиционируемся на первую запись таблицы - Сотрудник и для него начинаем применять те или иные расчеты , позиционируемя на след . Сотрудника и так далее. На мой взгляд , боле правильным и выгодным подходом для СУБД является следующий : Берем таблицу "Сотрудники" и последовательно к ней применяем Первый расчет (для всей таблицы) , потом Второй расчет и т.д.
Другими словами алгоритм представляет собой последовательность получения временных таблиц. Правда для 1с-ника построение такой БД будет выглядеть диковато, но для специалиста по базам данных - нормально.
В СУБД , проще говоря, нужно стремиться оперировать не записями, а таблицами.
Проблема в том, что работа со временными таблицами появилась если не ошибаюсь начиная с 8.1. Соответственно "берем ... и применяем первый расчет, второй" и т.д. было недоступно в типовом механизме.
Далее, в SQL (по крайней мере MS) нет возможности указать возвращаемый набор результатов. Т.е. нельзя выполнить в одном пакете формирование нескольких врем. таблиц (или табличных переменных), и что-то с них получить: вернется не последний select пакета, а все результаты (в т.ч. промежуточных insert'ов и update'ов). А механизм 1Ски отдаст только первую выборку из набора. Вот и приходится делать несколько пакетов. Но это ладно.
В SQL почему-то отсутствует ряд возможностей, которые вроде-бы хорошо востребованы. Те же н/итоги ("кумулятивное суммирование"); работа с иерархией (оператор with, введенный в стандарт только то ли в SQL2003, толи 2005 и поддерживаемый далеко не всеми); генерируюшие функции (например, нужно получить последовательность дней с ... по... - приходится извращаться. В постри хоть есть generate_series, но это уже вне стандарта).
1. Запрос.Выполнить() - вернет результат последнего запроса в пакете.
2. Запрос.ВыполнитьПакет() - вернет массив содержащий результаты всех запросов , входящих в пакет.
В чем тут дело сказать трудно. Ведь и сами временные таблицы - тоже совершенно очевидная вещь - появились только через 4(!) года в 8.1, а до этого в 8.0 писались километровые вложенные запросы.
"Я же считаю , что это очень дурной тон тогда , когда можно обойтись агрегатными командами или запросами."
Именно об этом я и сказал в той юмористической теме. Т.е цель - писать красивые "запросы" (алгоритмы)... ;-) И "суть этого шаблона в том ", что за красотой не видна сама задача и пути её решения. Повторю, что "проблемы", обозначенной в Вашей статье, вообще не существует при наличии подходящих инструментов. Очень жаль, что "1С 8.х" таких инструментов не предоставляет... :-(
P.S. Не ставлю минус на данную публикацию, т.к. минус надо ставить не на Вашу публикации, а на "1С 8.х".
Теперь по поводу объемов.
Во-первых, не могу представить реальной ситуации, где действительно нужно обработать такую выборку. Конечный потребитель (человек) просто не воспримет "миллион контрагентов". Т.е. наверняка "масштаб" выборки можно будет укрупнить, что-то свернув. А если надо не по всем, а по одному/нескольким - то же самое, у вас 300 млн доков на 1 млн контрагентов - всего 300 доков на контрагента, не так уж и много.
Во вторых, при таких объемах для подобных задач рулят уже другие системы (а-ля OLAP) и другие подходы (промежуточные хранилища данных, заранее свернутая аналитика и итоги по периодам), которые выходят за рамки 1С.
Ну и в третьих, такие объемы, да на 1С - это опять же исключение. Штучные экземпляры. В массе для обычной фирмы-пользователя 1С база 20 гиг - это уже "ого-го". А там где больша - часто практикуется "закрытие периода".
Честно говоря, не очень понял.
В приложении написано , что нарастающие итоги для каждой записи (СуммаДо,СуммаПосле) строятся для того, чтобы определить запись для которой СуммаДо < ИскомыйПараметр <= СуммаПосле. Судя по всему Вы под этим понимаете фильтрацию по нарастающим итогам.
НО. При 2 варианте в начале статьи (ish_2) никакой фильтрации нет вовсе.
Делается запрос по всем движениям всех контргаентов и используется выборка Запрос.Выполнить().Выбрать(). И затем сканируя двухуроневую (контргаент,движения) выборку в цикле будем накапливать итог (сумма всех пред.движений) для каждого контргаента и сранивать этот итог с текущим долгом каждого контрагента.
Но интересен эксперимент , который всё расставит по местам : с какого размера таблицы вариант 3(Anig99) превзойдет вариант 2 (Ish_2) по быстродействию ?
1. Пока установлен только факт Вариант 1( Eugeneer) значительно проигрывает по быстродействию Варианту 3(Anig99) на базе 120Гб.
Информация о этом факте представлена Anig99.
2. По информации того же Anig99, времена выполнения Варианта2(ish_2) и Варианта 3(Anig99) на этой же базе 120Гб относятся как 5:1
Очень хорошо , что ты пишешь тест сравнивающий разные подходы !
Текущей статье не хватает замеров производительности , о которой писал еще Игорь в (21) . Без такого фактического сравнения можно еще долго спорить о "красивости" и "некрасивости" алгоритмов.
С Вами , Владимир , я опять не согласен. И ничего такого в минусе от Вас на текущую тему не вижу.
Вот пример...
Для бомжа жить под теплоцентралью и бутылки собирать - оптимальный вариант... Тепло, относительно сухо, почти каждый вечер можно собрать на бутылку и закусь... Зашибись. Самый оптимальный вариант - для бомжа...
А вот попробуйте таким образом собрать на Ламборджини??? Мало того, что бутылки собирать будете пол жизни, так вам ещё нужно найти кто бомжику без паспорта Ламборджини продаст... так ещё и ездить как-то надо научится, на бензин опять-таки.
С другой стороны, нафуа бомжу Ламборджини??? Ведь большинство бомжуют не из-за отсутствия способностей, а из-за нежелания работать и/или удовлетворения текущим положением вещей.
А положение вещей, конечно, может быть разным... Может климатические условия очень хорошие - бананы там всякие, кокосы... или бомжик совсем маленький и Ламборджини ему игрушечной хватает....
Тут сразу столько оптимумов появляется... Ух...
Таким образом, если в процессе работы Вас устраивает время получения данных с нарастающими итогами, то пользуйтесь текущим методом. Но это ВАШ оптимум.
А мы здесь обсуждаем как БЫСТРО заработать на Ламборджини, а не как легко прожить.
Ламборджини - это скорее к САПу.
Встречный вопрос - у Вас очевидно, она уже есть?
А про оптимальность я вполне аргументировал: цикл - линейная трудоемкость, пересечение таблиц - в пределе квадратичная. Говоря Вашими словами - мы покупаем Ломбарджини за ее обычную цену, но предварительно еще оплатив детали, труд сборшиков, механиков и продавца.
--наши исходные данные
create table #t(i int,s int)
insert into #t values (1,100)
insert into #t values (2,200)
insert into #t values (4,400)
insert into #t values (3,300)
insert into #t values (5,500)
select * from #t
-- наш результат
create table #tt(i int primary key,s int,ss int)
insert into #tt(i,s) select i,s from #t
/* А вот тут прикол - обработка таблицы будет вестись в порядке ее
первичного ключа. Вот такой неявный цикл.
Это не специфицировано в стандарте, это особенность реализации от MS.*/
declare @d int
set @d=0
update #tt set @d=@d+s, ss=@d
--окончательный результат
select * from #tt
первичного ключа. Вот такой неявный цикл.
Это не специфицировано в стандарте, это особенность реализации от MS.*/
declare @d int
set @d=0
update #tt set @d=@d+s, ss=@d
--окончательный результат
select * from #tt
(113) Виноват , не понял в чем прикол ? Если мы создали tt с первичным ключом , то ,разумеется, модификация таблицы tt по команде
update #tt set @d=@d+s, ss=@d
будет вестись в порядке ее первичного ключа. Тут есть что-то прикольное ?
(122) Серьезно??? В 8.1 нельзя менять врем. таблицы??? А как они тогда вообще делаются - только через select into? А индексы на поля ставятся?
(Может, это просто разработчики вообще ничего кроме select не реализовали - а неизменение врем. таблиц - только следствие)
Я, признаться, думал что 8.1 позволяет делать все что можно с SQL.
(122) (123) Наверно нам надо четко указывать что имеем ввиду - 77 или 8. В 77 1С++ позволяет послать запрос в любом виде, но получает только 1-й набор пакета (таковы ограничения механизма семерки). Покольку я не работаю с 8кой, то не знаю ее возможностей и ограничений.
В любом случае, если в 8ке столько ограничений - толку от пакета никакого (точнее, пакет ничем не лучше последовательного выполнения неск. запросов).
Но речь шла не только о том, что нельзя получить результаты пакета кроме первого, а о том что вообще нельзя управлять выдачей результата. Т.е. если у меня в пакете есть "промежуточные" select,update,insert - то в результат попадет это все, хотя мне нужен только самый последний select. А нахрена лишние данные гонять? А уж тем более - зачем мне результат допустим insert'а?.
(Может, это просто разработчики вообще ничего кроме select не реализовали - а неизменение врем. таблиц - только следствие)
Ага . Именно так.
К тому же сама возможность работы в 8.1 с временными таблицами ( в 8.0 этого не было) подавалось фирмой 1с - как большое достижение.
Запрос получающий данные не совсем оптимальный для данной задачи, но взял его готовый из своего отчета по просроченной дебиторке - получает данные секунд 15. Цикл разнесения отрабатывает очень быстро - порядка 3 секунд. Получаем набор записей регистра сведений порядка 130 тыс строк - пишется долго - около 20 секунд (наверное сервер все таки не очень быстрый у клиента).
P.S.: Данные по оплаченности документов реализации также потом используются для отчета по оплаченной реализации с детализацией до номенклатуры.
Варианты эти могут быть сложные или простые , плохие или хорошие..
Но с точки зрения Заказчика ,как мне недавно объяснили, единственным правильным подходом
является следующий : организовать учет по расчетным документам, т.е использовать 3 субконто на счете 62 в БП2.0. Все проблемы тогда решаются сами собой.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 61295
Создание 25.11.09 09:32
Обновление 07.12.09 00:00
Просмотры 58573
Загрузки 431
Рейтинг
118
Комментарии 125
Код открыт Не указано
Рубрики Математика и алгоритмы Запросы
Кому Разработчик
Тип файла Конфигурация (md, cf)
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)

