ФИФО для любопытных
Разработка - Математика и алгоритмы

Бесплатные
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Узнавайте о новых бесплатных решениях в нашей телеграм-группе Инфостарт БЕСПЛАТНО
| Наименование | Скачано | Бесплатно |
|---|---|---|
|
СписаниеПоМетодуФИФО.dt
.dt 35,91Kb
1061
|
1061 | Скачать бесплатно |
Вы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Зачем это нужно ?
Существуют различные способы увеличения быстродействия процедуры перепроведения документов по регистру партий. Насколько известно автору , все они предполагают хранение вспомогательной дополнительной ("ускоряющей при проведении") информации. Представленный же алгоритм является решением "в лоб" , т.е. не требующим создания дополнительных структур хранения информации. Преимущества и недостатки такого подхода требуют отдельного исследования.
Постановка задачи .
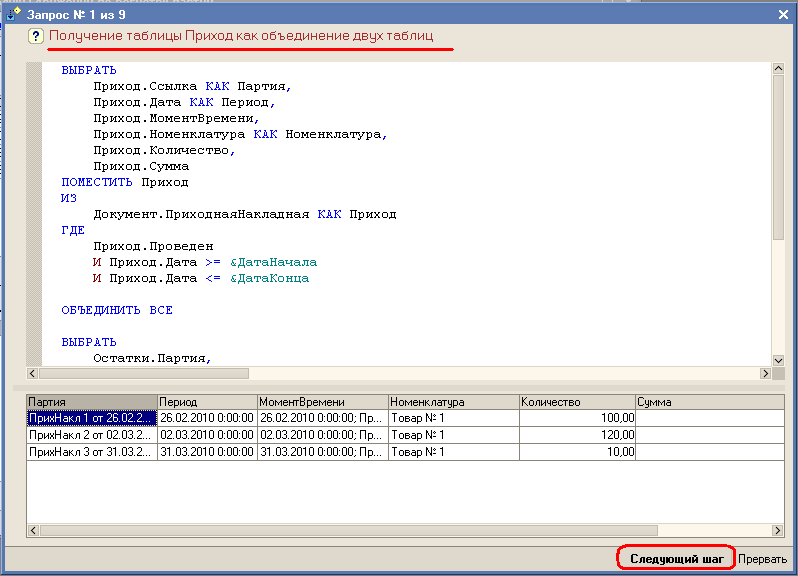
Рассмотрим постановку задачи списания по методу ФИФО в рамках простейшей конфигурации, содержащей справочник Номенклатура, документы РасходнаяНакладная и ПриходнаяНакладная, а также регистр накопления Партии. Период проведения расходных документов определен как [ДатаНачала,ДатаКонца].Получены две временные таблицы Приход и Расход (описание алгоритма будет сопровождаться демонстрационным примером).
Приход
|
Номенклатура |
Партия | МоментВремени | Период | Количество | Сумма |
| Товар № 1 | ПрихНакл №1 | ..... | 26.02.2010 | 100 | 1000 |
| Товар № 1 | ПрихНакл №2 | ..... | 01.03.2010 | 120 |
1200 |
Таблица Приход может быть получена как объединение двух таблиц :таблица остатков партий на ДатаНачала и таблица движений документов ПриходнаяНакладная, полученная за период [ДатаНачала,ДатаКонца].
Расход
|
Номенклатура |
Регистратор | МоментВремени | Период | Количество | Сумма |
| Товар № 1 | РасхНакл №1 | ..... | 11.03.2010 | 80 | 800 |
| Товар № 1 | РасхНакл №2 | ..... | 14.03.2010 |
40 |
400 |
| Товар № 1 | РасхНакл №3 | ..... | 26.03.2010 | 100 |
1000 |
Таблица Расход может быть получена при обращении к таблице Документы.РасходнаяНакладная за период [ДатаНачала,ДатаКонца].
Требуется получить таблицу движений по регистру партий :
|
Номенклатура |
Партия | Период | Регистратор | Количество | Сумма |
Алгоритм решения.
Рассмотрим упрощенный алгоритм получения движений регистра только по количеству. В демонстрационной конфигурации СписаниеПоМетодуФИФО.dt приведено более полное и подробное решение.
Этап I.
Получим таблицы НарРасход и НарПриход , содержащие нарастающие итоги для каждой строки в колонках КоличествоДо и КоличествоПосле.
НарПриход
|
Номенклатура |
Партия | ... | Период | КоличествоДо | КоличествоПосле |
| Товар № 1 | ПрихНакл №1 | 26.02.2010 | 0 | 100 | |
| Товар № 1 | ПрихНакл №2 | 01.03.2010 | 100 |
220 |
НарРасход
|
Номенклатура |
Регистратор | ... | Период | КоличествоДо | КоличествоПосле |
| Товар № 1 | РасхНакл №1 | 11.03.2010 | 0 | 80 | |
| Товар № 1 | РасхНакл №2 | 14.03.2010 |
80 |
120 |
|
| Товар № 1 | РасхНакл №3 | 26.03.2010 | 120 |
220 |
Запросы для получения таблиц НарРасход и НарПриход аналогичны.Приведем текст запроса для получения таблицы НарРасход
ВЫБРАТЬ
Расход.Период,
Расход.МоментВремени,
Расход.Регистратор,
Расход.Номенклатура,
Расход.Количество,
Расход.Сумма,
СУММА(Расход1.Количество) - Расход.Количество КАК КоличествоДо,
СУММА(Расход1.Количество) КАК КоличествоПосле
ПОМЕСТИТЬ НарРасход
ИЗ Расход КАК Расход
ВНУТРЕННЕЕ СОЕДИНЕНИЕ Расход КАК Расход1
ПО Расход.Номенклатура = Расход1.Номенклатура
И Расход.МоментВремени >= Расход1.МоментВремени
СГРУППИРОВАТЬ ПО
Расход.Период,
Расход.МоментВремени,
Расход.Регистратор,
Расход.Номенклатура,
Расход.Количество,
Расход.Сумма
Этап II.
Одного внутреннего соединения таблиц НарРасход и НарПриход достаточно для получения выходной таблицы движений. Здесь мы описываем лишь суть алгоритма , поэтому в нижеприведенном тексте запроса ресурс Сумма не учитывается.
ВЫБРАТЬ
НарРасход.Период,
НарРасход.Регистратор,
НарПриход.Партия,
НарРасход.Номенклатура,
// Следующее поле "Количество" можно определить как
// Мин(НарПриход.КоличествоПосле, НарРасход.КоличествоПосле)
// - Макс(НарПриход.КоличествоДо, НарРасход.КоличествоДо)
ВЫБОР
КОГДА НарПриход.КоличествоПосле < НарРасход.КоличествоПосле
ТОГДА НарПриход.КоличествоПосле
ИНАЧЕ НарРасход.КоличествоПосле
КОНЕЦ - ВЫБОР
КОГДА НарПриход.КоличествоДо > НарРасход.КоличествоДо
ТОГДА НарПриход.КоличествоДо
ИНАЧЕ НарРасход.КоличествоДо
КОНЕЦ КАК Количество
ИЗ
НарРасход КАК НарРасход
Внутреннее СОЕДИНЕНИЕ НарПриход КАК НарПриход
ПО НарРасход.Номенклатура = НарПриход.Номенклатура
И НарРасход.КоличествоПосле > НарПриход.КоличествоДо
И НарРасход.КоличествоДо < НарПриход.КоличествоПосле
И НарРасход.МоментВремени > НарПриход.МоментВремени
Таблица Движений
|
Номенклатура |
Регистратор | Партия | Период | Количество | Сумма |
| Товар № 1 | РасхНакл №1 | ПрихНакл №1 | 11.03.2010 | 80 | -нет |
| Товар № 1 | РасхНакл №2 | ПрихНакл №1 | 14.03.2010 |
20 |
-нет |
| Товар № 1 | РасхНакл №2 | ПрихНакл №2 | 14.03.2010 | 20 |
-нет |
| Товар № 1 | РасхНакл №3 | ПрихНакл №2 | 26.03.2010 | 100 | -нет |
Этап III .
Полученную таблицу движений можно или "подокументно" записать в регистр партий или предварительно сравнить с существующими движениями в регистре и записать только "изменения".
Замечания.
Приведенный в Этапе I запрос нагляден , но чрезвычайно затратен .В практических разработках при вычислении нарастающих итогов возможно применение подхода , описанного в статье "Подведем Итоги.Нарастающие" //infostart.ru/public/61295/. Применение же подхода Шепота - невозможно , потому что он ничего на эти темы не писал.
В демонстрационной конфигурации прикрепленной к теме алгоритм рассматривается по шагам более полно и подробно : полученные движения содержат ресурс Сумма, реализован учет погрешности округления ресурса Сумма, учитывается возможность отрицательных остатков при проведении.
В тексте темы использована разукрашка Aleks-is http://www.infostart.ru/public/19856/
Вступайте в нашу телеграмм-группу Инфостарт
См. также
Математика и алгоритмы Разработчик 1С 8.3 Абонемент ($m)
Данная внешняя обработка для платформы 1С:Предприятие реализует усовершенствованный алгоритм Левенштейна для вычисления схожести строк с учетом различных лингвистических особенностей русского языка. В отличие от классической реализации, этот алгоритм учитывает фонетические, визуальные и контекстные особенности набора текста.
1 стартмани
07.11.2025 7068 18 InFlach 17
Математика и алгоритмы Запросы Разработчик 1С:Предприятие 8 Бесплатно (free)
Рассмотрим быстрый алгоритм поиска дублей с использованием hash функции по набору полей шапки и табличных частей.
08.07.2024 9225 ivanov660 9
Математика и алгоритмы Разработчик 1С:Предприятие 8 1C:Бухгалтерия Россия Абонемент ($m)
На написание данной работы меня вдохновила работа @glassman «Переход на ClickHouse для анализа метрик». Автор анализирует большой объем данных, много миллионов строк, и убедительно доказывает, что ClickHouse справляется лучше PostgreSQL. Я же покажу как можно сократить объем данных в 49.9 раз при этом: 1. Сохранить значения локальных экстремумов 2. Отклонения от реальных значений имеют наперед заданную допустимую погрешность.
1 стартмани
30.01.2024 17039 stopa85 12
Математика и алгоритмы Бесплатно (free)
Разработка алгоритма, построенного на модели симплекс-метода, для нахождения оптимального раскроя.
19.10.2023 25310 user1959478 57
Математика и алгоритмы Разное 1С:Предприятие 8 1C:Бухгалтерия Россия Абонемент ($m)
Расширение (+ обработка) представляют собою математический тренажер. Ваш ребенок сможет проверить свои знание на математические вычисление до 100.
2 стартмани
29.09.2023 15772 maksa2005 8
Математика и алгоритмы Инструментарий разработчика Разработчик 1С:Предприятие 8 Россия Абонемент ($m)
Что ж... лучше поздно, чем никогда. Подсистема 1С для работы с регулярными выражениями: разбор выражения, проверка на соответствие шаблону, поиск вхождений в тексте.
1 стартмани
09.06.2023 25656 13 SpaceOfMyHead 20
Математика и алгоритмы Разработчик 1С:Предприятие 8 Бесплатно (free)
Три задачи - три идеи - три решения. Мало кода, много смысла. Мини-статья.
03.04.2023 17766 RustIG 10
Механизмы платформы 1С Математика и алгоритмы Разработчик 1С:Предприятие 8 Россия Бесплатно (free)
В статье анализируются средства платформы для решения системы линейных уравнений в 1С. Приводятся доводы в пользу некорректной работы встроенных алгоритмов, а значит потенциально некорректного расчета себестоимости в типовых конфигурациях.
23.11.2022 16660 gzharkoj 17
...
если меня что-то и интересует то только с точки зрения экономической эффективности ... а это как прАвило простота решения, пусть даже и более длинного ...
такой же принцип и в массовом производстве ... так технологичесие процессы расположены вне логики ручного труда ...
...
... вот ...
А жизнь без последовательностей радостна и безоблачна, и никакого отношения к партионному учету не имеет.
Партионный учет - объективная потребность (а значит, реальность).
Последовательность - химера, рожденная в воспаленных мозгах разработчиков. Последовательности ирреальны, ибо не встречаются в жизни.
К сожалению, в отличие от других нервно-паралитических болезней, эта (использование последовательностей) оказалась заразной. А поскольку из всех лекарств в арсенале восьмерки остались одни запросы...
Но :
"Потребность = реальность",
"последовательность = химера"
- э..э .. перехвалили тебя .
В "восьмерке" не остались , а добавились запросы как признание столбовой дороги развития СУБД . Представленный алгоритм как раз и говорит :
авторитетному мужчине пора завязывать с 77.
язык запросов существует для получения копий таблиц + фильтрация из БД ...
пытаться программировать, манипулировать данными на уровни запросов - утопия ... и СКД это наглядно демонстрирует ... Запрос+ТЗ = универсально, практично, феерично ...
запрос + тз = неограниченные возможности в манипулировании данными ... быстрота в объединении этих возможностей а не в их пересечениях ... вот ...
... понятно, как задача для ума может это и интересно ... но не более ...
... вот ...
В настоящий момент я считаю такую процедуру самым быстрым и эффекивным способом получения всех движений по регистру партий (читай- перепроведения документов по регистру партий).
Нужна ,конечно, тестовая конфигурация для подтверждения этого мнения. Пока она не представлена.
Шепот , ты упорно не хочешь изучать СКД.
Можно сказать , что в узком смысле СКД = запрос+тз+обработка тз.
Уж за что 1с не должно быть стыдно , так это за СКД.
"пытаться программировать, манипулировать данными на уровни запросов - утопия ... и СКД."
Я не согласен с тобой. Работая в клиент-серверном варианте мы, наоборот, просто обязаны пытаться "программировать, манипулировать данными" при помощи запросов. Для тебя же запросы - средство простой выборки данных, после которой "тыканье кнопок" ,т.е. любимый кодинг.
Скажи, Шепот , тебя убедит что текущий алгоритм не баловство "для ума " если в рамках рассматриваемой конфигурации ты получишь по сравнению с обычным перепроведением ускорение в сотни раз ?
Естественно, запросный подход не идеален (а уж тем более запросный 2го уровня, когда запрос "транслируется" в родной язык БД), в частности, с учетом нарастающих итогов... Поэтому нужно соизмерять важность скорости получения результата и сложность достижения этой скорости. Поэтому поводу - пусть 1с самый простой и самый долгий - "перепровести всё нах" или какой-то, видимо, относительно простой, но ОЧЕНЬ долгий алгоритм примененный в документе "корректировка стоимости партий" (у меня он идет 7 часов! а результирующих движений 3000-7000 тыс на регистр, т.е. большую часть времени происходят именно расчеты). Второй путь - код и много мелких запросов - сейчас я его использую и проверка Fifo хоть и занимает несколько часов, но всё же меньше, чем проведение по партиям. 3ий неизвестный по поведению относительно производительности - расчет в одном сложном и оптимизированном запросе.
Нужно только пробовать на твоей конфигурации , чтобы убедиться что эффективнее.
Меня смущает составное поле в условиях соединения - МоментВремени.
Индекировать врем.таблицу по нему нельзя. Означает ли это , что оптимизатор запроса будет сканировать не индекс , а основную таблицу - что приведет к замедлению ?
НарРасход.МоментВремени > НарПриход.МоментВремени
придется написать
НарРасход.Период> НарПриход.Период ИЛИ
НарРасход.Период = НарПриход.Период И
НарРасход.Регистратор > НарПриход.Партия
Насколько мне известно, оптимизатор запроса если в условии соединения есть "ИЛИ"
вынужден сканировать не индекс , а основную таблицу. Что тоже не есть хорошо, т.к.
таблицы НарПриход и НарРасход могут быть очень большого размера.
"НарРасход.Период>НарПриход.Период" - лишнее условие.
Потому что из "НарРасход.МоментВремени > НарПриход.МоментВремени " совершенно очевидно следует "НарРасход.Период>=НарПриход.Период".
И оптимизатор запроса всё равно будет проверять условие по Моменту времени.
В чем выигрыш ?
Мне непонятен смысл : зачем добавлять еще одно выражение , т.е.
"НарРасход.Период > НарПриход.Период "
если оптимизатор запроса всё равно будет проверять неиндексируемое поле МоментВремени в
"НарРасход.МоментВремени > НарПриход.МоментВремени"
В чем выигрыш ?
сравнение
НарРасход.МоментВремени > НарПриход.МоментВремени
в Вашем запросе НЕ ТРЕБУЕТСЯ!!!
Эта логическая ошибка поясняется схемой в файле (рис.2). Кстати, схема, поясняет и сущность метода. На словах дело в том, что проверка нужна, чтобы избежать списаний "по-красному". Но если Вы вырезаете их такой проверкой, то почему не уменьшаете на сумму вырезанных списаний накопленный расход?
Выход в том, чтобы списывать по-красному (тогда проверка не нужна!), либо делать третий накопленный расход (запрос будет другим)

Строка в условии соединения
"НарРасход.МоментВремени > НарПриход.МоментВремени "
совершенно необходима.
Если это условие убрать , то более ранний расход «спокойно» спишется с более позднего прихода.
Как мы тогда в выходной таблице отловим эту ошибочную ситуацию ?
Компромиссом следует считать следующий подход :
Строка
"НарРасход.МоментВремени > НарПриход.МоментВремени " из условий соединения убирается.
А в поля выборки добавляется строка
«Выбор Когда НарРасход.МоментВремени > НарПриход.МоментВремени
Тогда Истина
Иначе Ложь
Конец как ПризнакСвоевременности»
Тогда появляется возможность «отловить» в входной таблице эту ошибочную ситуацию.
Поэтому предложение просто убрать строку
"НарРасход.МоментВремени > НарПриход.МоментВремени "
из условий соединения нельзя назвать верным.
А в файле СписаниеПоМетодуФИФО.dt применено ЛЕВОЕ СОЕДИНЕНИЕ.
С обработкой значений NULL.
А вот левое соединение и обработка NULL - это неправильно, так как если расход не сделан, то следующие "своевременные" расходы должны соединяться с приходами, пропущенными в паре с несвоевременными расходами.
.. хм... в сотни раз .... это конечно ты перебрал хотя упорствовать не буду ... но я точно знаю что труды ВалерычА ( ) гораздо продуктивнее ... он уже добился быстродействия в 100 раз а возможно и более ...
также хочется напомнить и про труд Владимира ( ) хотя и в рамках отдельной конфигурации ...
... добиваться же быстродействия в рамках запроса ...? для меня очень и очень не понятно - для меня это создание исскуственных трудностей на пути поиска простых и эффективных решений ...
... соглашусь и с возможной, своей полной или частичной - НЕграмотностью ...
... вот ...
... вот ...
Но убедительно - с аргументами.
Представь себе , что я внимательно читаю и проверяю ,что ты мне написал.
Ссылки на Валерыча и Владимира не убеждают .
Они рассматривали совсем другие темы.
в 1С запрос это только "чтение" ... запись не возможна ... любые операции с данными гораздо проще делать в таблицах, массивах ....
... я сам закрываю 26 счет, для подсчёта нулевой рентабельности, нууу это типа точкаБЕЗубыточности ... 3 разными способами ... прекрасно знаю что 1С механизмы очень долгие и добиться увеличения быстродействия на порядок, заменив их на свои, это почти без проблем ....
ссылки на ВалерычА и Владимира считаю основными ... так как эти товарищи прекрасно демонстрирует силу самостоятельного программирования ... не умаляя 1С как сверхУниверсальную систему ...
... ВОТ ...
... по сути, мы пропагандируем одно и то же решение - оптимально, 1С часто это делает неЭффективно из-за своей гиперУниверсальности, любыми доступными методами собрать данные в таблицу и записать её ... здесь мы едины ... просто я считаю что запрос для оперирования данными не эффективен а ты считаешь наоборот ... вот ...
За что ? А вот за это :
1. "... добиваться же быстродействия в рамках запроса ...? для меня очень и очень не понятно"
2. "просто я считаю что запрос для оперирования данными не эффективен.."
Запрос бывает эффективен или неэффективен не вообще , а для конкретной задачи.
Если тестирование показывает , что запрос работает быстрее ,чем кодинг - то запрос эффективен. Настоящая тема как раз о том , что , по мнению автора, запрос эффективнее для задачи перепроведения документов , чем кодинг. Разумеется , только для текущей простейшей конфигурации.
Для других конфигураций нужно проводить конкретное тестирование и приведенный в статье алгоритм лишь отправная точка для создания эффективного решения.
Оценка трудоемкости запросов 1, 2 и 3 приводит к формуле
O(n * n / 2) + O(m * m / 2) + O(n * m / 2),
где n - число приходов, m - число расходов. Оценка обосновывается
методом "вложенных циклов", который используется при оптимизации запросов.
Действительно, для каждого прихода в запросе 1, например, требуется просуммировать
в среднем n / 2 записей (при использовании индекса по моменту времени). То есть,
трудоемкость пропорциональна квадрату числа приходов (расходов для запроса 2).
Ускорение по методу изменит оценку на следующую
O(n * ln(n)) + O(m * ln(m)) + O(n * m / 2),
что, конечно, гораздо лучше, но при наличии процедурных подходов с трудоемкостью
O(n + m),
не требующих дополнительной памяти
(а в Вашем случае хранится и обновляется примерно log(n) уровней итогов),
преимуществ метода "одного запроса" не усматривается.
Вас мог смутить реальный выигрыш по быстродействию метода
в задаче просроченной задолжности.
Но там не было внешнего цикла! Там был переход от пропорции O(n) к пропорции O(ln(n)),
что существенно. В задаче ФИФО есть внешний цикл - задачу накопления нужно решить для каждой накладной.
И это все меняет.
Не знаю, можно ли надеяться, что 1С в своей обертке SQL даст нам возможность быстрого нахождения тэта-соединений таблиц
(такие вопросы ставились) или функцию нарастающих итогов. Сейчас 1С стыкуется с разными СУБД, возможно, будут какие-то находки.
Взять, к примеру, агрегаты в 8.2.
Но пока встроенных нарастающих итогов в запросах нет и компромиссом будут процедурные решения. :cry:
Кстати, похожий вопрос обсуждался здесь:
К сожалению ,оценку трудоёмкости вычислений я забыл. Поэтому о верности приведенных формул мне судить трудно.
Но и без формул понятно , что количество вычислений в текущем алгоритме больше , чем при "процедурном подходе".
Разумеется , приведенный в теме алгоритм с эффективным вычислением нар.итогов многократно выиграет у простого перепроведения расходных документов ,если в каждом расходном документе предусмотрен запрос к остаткам регистра партий.
Но Ваш пост , как я понял, о другом . Из него вытекает :
Для исходных таблиц значений Приход и Расход можно привести такой кодинг с циклами ("процедурный подход") , реализующий метод ФИФО , который многократно
превзойдет текущий алгоритм с любым самым эффективным вычислением нарастающих итогов . При этом размер таблиц Приход и Расход может быть как угодно большим .
Так ?
Для каждой значения Номенклатуры из таблицы НарРасход мы строим движения по регистру партий.
Поэтому если N-расход по M-номенклатуре получился "красным" , то зачем нам последующие "своевременные" расходы N+1,N+2 и т.д. по M-номенклатуре ?
Совершенно очевидно , что они не имеют смысла .
Для М+1-номенклатуры , конечно, будет выстроена своя последовательность движений расходов. Как и для M+2,M+3 и т.д.
Вот почему утверждение в приведенной цитате - неверно.
Тем более если в таблице НарРасход для М-номенклатуры имеются записи со значением поля КоличествоДо больше любого КоличествоПосле в таблице НарПриход эта запись при ВНУТРЕННЕМ СОЕДИНЕНИИ просто "пропадёт" в выходной таблице "без следов".
При ЛЕВОМ СОЕДИНЕНИИ мы достигаем того, что в выходной таблице гарантировано будут присутсвовать все регистраторы-расходы. И по полям признакам мы сможеи определить какое движение регистратор - неверное (или "красное").
т.к. в рамках рассматриваемой простейшей конфигурации "запросный" метод значительно уступит по быстродействию "процедурному подходу" (т.е. "вручную" просканировать две исходные таблицы Приход и Расход для получения движений),
то единственной , достойной внимания особенностью представленного алгоритма является перенос в трехзвенной системе( клиент-сервер приложений- сервер БД) всех вычислений на сервер БД.
1) Если у тебя есть возможность не пользоваться курсором - не пользуйся им.
2) Если у тебя НЕТ возможности не пользоваться курсором - ВСЕ РАВНО НЕ ПОЛЬЗУЙСЯ.
-------------
Запрос всегда быстрее курсора, единственное исключение: неправильный (неоптимальный) запрос.
В общем случае это ,конечно, неверно. Но уж больно симпатично.
Ну, опять же на нормальной БД нарастющие итоги на врем-таблицу можно накрутить и без курсора.
update vt_total
set @СуммаНачало = case when vt_total.НоваяСтрока = 0 then @СуммаКонец else vt_total.СуммаНачало
,@СуммаКонец = @СуммаНачало + vt_total.Оборот
,vt_total.СуммаНачало = @СуммаНачало
,vt_total.СуммаКонец = @СуммаКонец Логотип темы - «Мы пишем запросы!».
Позволю себе высказаться не в тему.
Для простого и эффективного решения аналогичных задач не требуются:
1) Наличие в языке запросов Update.
2) Временные таблицы.
3) Процедурные методы на сервере.
4) Курсоры.
5) Всякие «левые» и «правые» соединения.
Да и сами запросы не требуются. ;-)
Печально, что движение по «столбовой дороги развития СУБД»(с) ведет в тупик. А «круглые колеса, на каких во всем мире принято ездить»(с) ускоряют это движение… :-(
Впрочем , однажды Вы в своей теме привели текст кода а-ля Clipper Summer '87, обозначающий Ваш подход к решению такого рода задач и заставивший меня смахнуть слезу :
do while !eof()
.........
enddo
Т.е. сканирование таблицы и ручной кодинг.
Возврашаясь в 1987г , Вы отрицаете ту самую двадцатилетнюю "столбовую" дорогу :
-Утверждение стандарта SQL от 1992г.
-Развитие трехзвенной системы клиент-сервер приложений-сервер БД.
Оно конечно, Вам это никто не запретит. Но думаю , Вы найдете мало сторонников.
Если вдруг на каком -то этапе на "столбовой" дороге откажутся от языка запросов - я первый сниму перед Вами шляпу.
Игорь.
Я не отрицаю язык запросов в развитии СУБД. Я утверждаю, что для наших задач надо иметь ДВА способа (ЯМД) обработки данных. И в задачах типа «Нарастающие итоги» просматривать таблицы построчно в обычном цикле на стороне клиента. Это быстрее работает, не загружает сервер лишней работой, проще писать ««ручной кодинг»». Есть алгоритмы, где эффективней использовать язык запросов.
А в целом, наличие двух ЯМД позволяет проектировать схему БД не под средства манипулирования данными, а под предметную область. И отпадает необходимость в «трехзвенной» архитектуре, как средства преобразования одного ЯМД в другой.
Соображения общего плана (58) меня мало в чем убеждают.
Разберемся конкретно .
Мы разбираем задачу вычисления нарастающих итогов в клиент-серверной архитектуре.
Цитататы :
"Для простого и эффетнаективного решения аналогичных задач не требуются:
1..5 . Да и сами запросы не требуются.."
"И в задачах типа «Нарастающие итоги» просматривать таблицы построчно в обычном цикле на стороне клиента. Это быстрее работает, не загружает сервер лишней работой, проще писать ««ручной кодинг»»."
Из этих цитат вытекает , что в клиент-серверной архитектуре для вычисления нарастающих итогов:
1. БОЛЕЕ эффективно загрузить таблицу с сервера на клиента и далее на клиенте ручным кодингом просканировать таблицу в цикле (do while...skip...enddo).
2. МЕНЕЕ эффективно оставить таблицу на сервере и одной командой Update получить таблицу нарастающих итогов см (54)
Так ? Или я что-то напутал ?
Игорь.
1) Для обработки таблицы навигационным способом не требуется загружать таблицу с сервера на клиент. Выполняется чтение по одной записи. Вычисление и накопление нарастающего итога на клиенте для каждой строки в переменной оперативной памяти. Выводится в отчет строка вместе с вычисленным итогом. Т.е. выполняется чтений столько раз, сколько строк в таблице (обозначим - N).
2) На сервере же формируется рабочая таблица (в простейшем случае N чтений и N записей). Далее читаем каждую строку рабочей таблицы (N чтений), вычисляем нарастающий итог и записываем его в каждую строку (N обновлений). Далее передаём все строки рабочей таблицы клиенту (N чтений). Итого 5*N чтений/записей.
По сети, в обоих способах, предаётся одинаковое количество строк.
Вариант:
1. Мы получили запросом ТаблицуДвижений.
2. Делаем Полное Соединение с движениями из регистра партий.
3. Оставляем в таблице , полученной в п.2, только расхождения , т.е. получаем ТаблицуРасхождений.
4. Затем с помощью запроса
"Выбрать Различные Регистратор ИЗ ТаблицаРасхождений" получаем таблицу -столбец
с документами , которые нужно перепровести.
5. Сканируя таблицу, полученную в п.4, для каждого документа- регистратора выбираем нужные движения из ТаблицыДвижений и записываем их в регистр.
Если в языке запросов 1с появится Update , Declare , Create Table (для временных таблиц), то представленный алгоритм , на мой взгляд, для больших таблиц выиграет у любого другого.
Это предсположение основывается на том , что
вся тяжесть вычислений в алгоритме ложится на вычисление нарастающих итогов.
С помощью команды Update нарастающие итоги считаются очень быстро.
Вы ждете возможностей языка, которые позволят втиснуть ваши огромные вычисления в рамки приличий по быстродействию? А решение лежит в другой стороне. Смоьтреть надо в сторону изменения структуры регистров, которая позволит анализировать только то, что реально нужно...
Попросив уже сидевшего за компьютером человека посмотреть ИС , увидел комментарий и побежал за паспортом. Жара , скучно, на море ни ногой - делать нечего.
Как обычно , хмыкну там где восторгается Шепот.
Выгрузки - загрузки в txt, потом в свой формат и т.д, чтобы потом "ЗА ОДНУ СЕКУНДУ" !
- это для кого текст ? Для специалистов ? Если - да , то для каких ?
В статье предлагается общий алгоритм списания по методу ФИФО.
Который может быть реализован как на платформе 1с , так и на другой платформе средствами только TSQL. В последнем случае эффективность реализации алгоритма многократно выше.
( с помощью Update нарастающие итоги считаются быстрее)
Выгрузка и загрузка (конвертация) у меня происходят в 3 часа ночи... зато при открытии пользователем мгновенно загружается в динам.массив и идет работа с OLAP (по вчерашний день)....
Метод FIFO на 1С делал применительно к расчету дебиторки / кредиторки, когда считал взаиморасчеты и самое главное кол-во дней просрочки... быстродействия хватило... А вот с партиями - увы нет - 1С это не потянет!!! - точнее база будет проводится столько ко же, как при обычном проведении, ну не 6 часов, а всего 2 часа :-) Потом на SQL делал хранимую процедуру метода FIFO - тоже тормоза... ну не может SQL сделать update даже миллиона записей!!!! (поле себестоимость) - не может и все!! select может, а update нет....
В общем то, статья хорошая, все нормально. Метод FIFO, LIFO,... известные. Есть даже метод "списания максимальной себестоимости" (который придумал мой знакомый)... Но мне все же нравится метод FIFO!
Кстати, когда я практически его реализовывал - и при гашение долгов и при гашении партий - выяснилось, что "в чистую" этот метод на практике не применим, и "за один проход" не получается. А причина была в том, до метода FIFO приходится делать первый проход при котором идет гашение с учетом явных ссылок (начиная от сторно, возврат ошибочно перечисленных сумм, возврата товара и других движений....). Вот, что хотелось бы добавить к статье.
(78) :-)
- Мужчина в желтых трусах ! Я же вам сказала : отойдите от компьютера.
А трусы у меня , Миша, между прочим адидасовские - яркие ,оранжевые.
Адидас, правда, цыганский и кореша говорят , что похож я в них не на голландца ,а на бандеровца. Но они мне нравятся и я их ношу...
- Пустите . Я же в прошлый раз Вам паспорт показывал.
- Мужчина мне нужно внести ваши данные . Вы это понимаете ?
Крыть было нечем и я решился .. перегнувшись через стойку доверительно сообщил:
- Девушка , а трусы на мне не желтые , а померанчевые ! Бачишь ?
Пока она с трудом подбирала ответ я понял , что не попал. Мда... Здесь вам не инфостарт , "штучки-дрючки" не проходят и не дожидаясь ответа ,я поперся за паспортом.
Выбор
Когда ВычислитьВыражение("Сумма(СуммаДок)", , , "Первая", "Текущая") < Долг
тогда СуммаДок
Когда ВычислитьВыражение("Сумма(СуммаДок)", , , "Первая", "Текущая") - Долг < СуммаДок
тогда СуммаДок - (ВычислитьВыражение("Сумма(СуммаДок)", , , "Первая", "Текущая") - Долг)
Иначе 0
конец
Всё почти хорошо. Однако при использовании дополнительной группировки по степени просроченности долга (долг не просрочен, долг просрочен не более на 5 дней, долг просрочен на срок 5-30 дней и т.д.) вычисляемое поле вычисляется в пределах отдельной группировке по степени просроченности долга, а не в пределах клиента. Подозреваю, что надо "побаловаться" с параметрами ВычислитьВыражение(), но пока не додумал. Может у кого-то получилось понять суть этих параметров. Прошу поделиться идеями, ибо у меня уже мозг закипает.
Получить таблицу минимальных дозакупок на каждый день месяца для того чтобы вывести в ноль все ежедневные отрицательные остатки задним числом. Пример
Дата Остаток ! Дозакупка НовыйОстаток
01 -3 3 0
02 4 0 7
03 -1 0 6
04 -4 0 2
05 -7 5 0
06 2 0 7
Вот нужно получить колонку Дозакупка.
Естественно хотелось бы решить ее запросом.
Конечно , можно решать и твою задачу как некий упрощенный частный случай.
Но для общего случая ( интересен , на мой взгляд именно он) правильно формулировать следующим образом :
Проверить и найти все отрицательные остатки за период возникшие после момента проведения любого расходного документа. Реализовать одним запросом.
Другими словами , на входе имеем таблицы :
НачОстаткиНаНачалоПериода
ВсеПриходыЗаПериод,
ВсеРасходыЗаПериод.
На выходе должны получить таблицу РасходныеДокументыСОтрицательнымиОстатками.
Далее нужен анализ :
или сдвинуть расходный документ во времени в течение дня.
или оформить доп. приход.
Остатки на конец периода должны остаться неизменными.
Таким должен быть , на мой взгляд , подход к решения такой задачи.
Загружает.
Задает вопрос о конвертации.
И после подтверждения сразу в дамп.
Разучилась, видимо, превращать базы на 8.1 в 8.2.
Пришлось искать 8.2 для конвертации и хорошо, что нашел, сконвертировал.
Но оказалось что все еще проще. В окне настройки инф.базы надо поменять с 8.3 на 8.2)
Или пятница, или уже очевидные вещи вылетают из головы)
Применил методику, ключевой момент был, что там нет номенклатуры. Это поле можно было убрать у меня, а я его заменил на другой реквизит, который у всех одинаковый. А момент времени в конце заменил на условие, что оплата не может быть раньше расхода на начало дня.
Было бы не плохо в заголовке указать про нарастающий итог. Сначала гуглил по нему, а потом пришла мысль что это ФИФО по оплате.
И только тогда на эту тему наткнулся через ссылку, которую указали тоже как ФИФО=))
Но там пример запроса вообще кривой был...
Мною решаемая задача поставлена таким образом, что строки для которых "не хватило остатков партий" должны присутствовать в результате выборки. А строка на которой частично хватило остатка партии должна разбиваться на 2: на количество которое хватило и на количество превышения. Если подскажите как доработать запрос под такие условия, буду благодарен.
Спасибо большое за статью и метод! Бывают ситуации когда надо в середине готового большого запроса добавить распределение по ФИФО и тогда это прям ну Очень выручает.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 68225
Создание 02.04.10 09:04
Обновление 27.07.11 16:16
Просмотры 63271
Загрузки 1061
Рейтинг
118
Комментарии 105
Код открыт Не указано
Рубрики Математика и алгоритмы
Кому Разработчик
Тип файла Архив с данными
Платформа 1С:Предприятие 8
Конфигурация 1C:Бухгалтерия
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Бухгалтерский учет
Доступ к файлу Бесплатно (free)