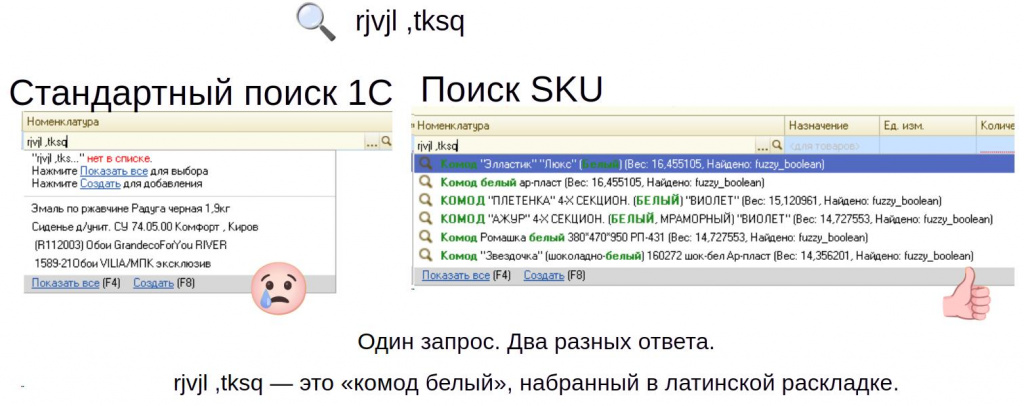
Внешний Fuzzy-поиск для 1С: транслит, синонимы и любые реквизиты
Задачи пользователя - Поиск данных

Что такое sku-search простыми словами
Это внешний сервис полнотекстового поиска для ваших данных.
Вы загружаете в него товары, марки, документы — что угодно. Каждая запись — это JSON с любым набором полей. Сервис строит поисковый индекс и за миллисекунды находит нужное по:
-
наименованию;
-
артикулу, штрихкоду, коду, GUID;
-
бренду, поставщику, ТН ВЭД, цвету, размеру, ГОСТу, материалу;
-
любым другим реквизитам, которые вы решите передать.
Без лицензий, без ограничений по времени, без GPU, без Java, без Docker.
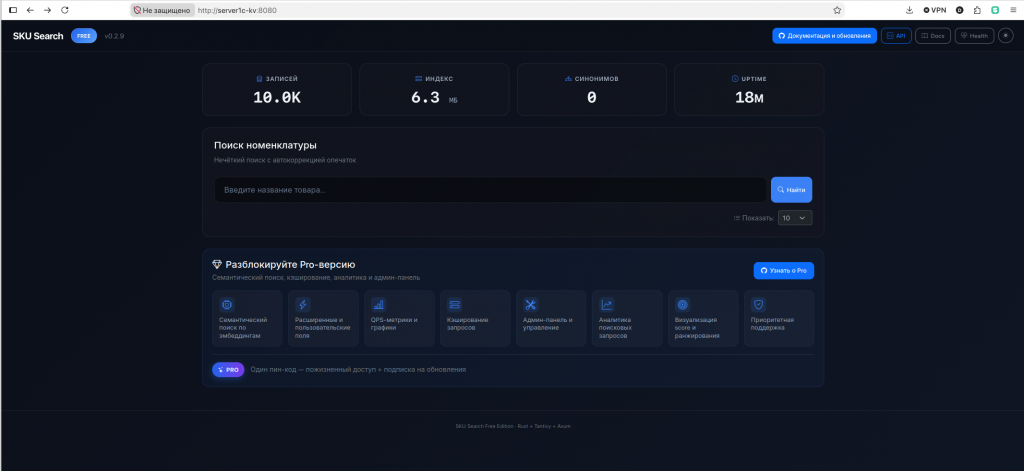
Главная магия: просто введи наименование
Для большинства задач не нужно ничего настраивать. Передайте name — и сервис сам разберется.
Он поймет:
-
опечатки: «блот м16 цынк», «болт М16 оцинкованный»;
-
разные формы слов: «болты», «болтом», «болтов», «болт»;
-
сокращения: «цинк», «оцинкованный» (если добавите синоним);
-
неправильную раскладку: «ljvbr d lthtdyt» , «домик в деревне».
Вы отправляете из 1С:
{
"items": [
{ "name": "болт м16 цинк" }]}
Получаете:
{
"request_id": "550e8400-e29b-41d4-a716-446655440000",
"search_time_ms": 4,
"results": [
{
"query": { "name": "болт м16 цинк" },
"matches": [
{
"original": {
"name_out": "Болт М16х60 оцинк. ГОСТ 7798-70",
"id_out": "DEMO-00002",
"art": "ART-000002",
"score": 0.91,
"matched_by": "fuzzy_text",
"matched_tokens": ["болт", "м16", "цинк"]}}]}]}
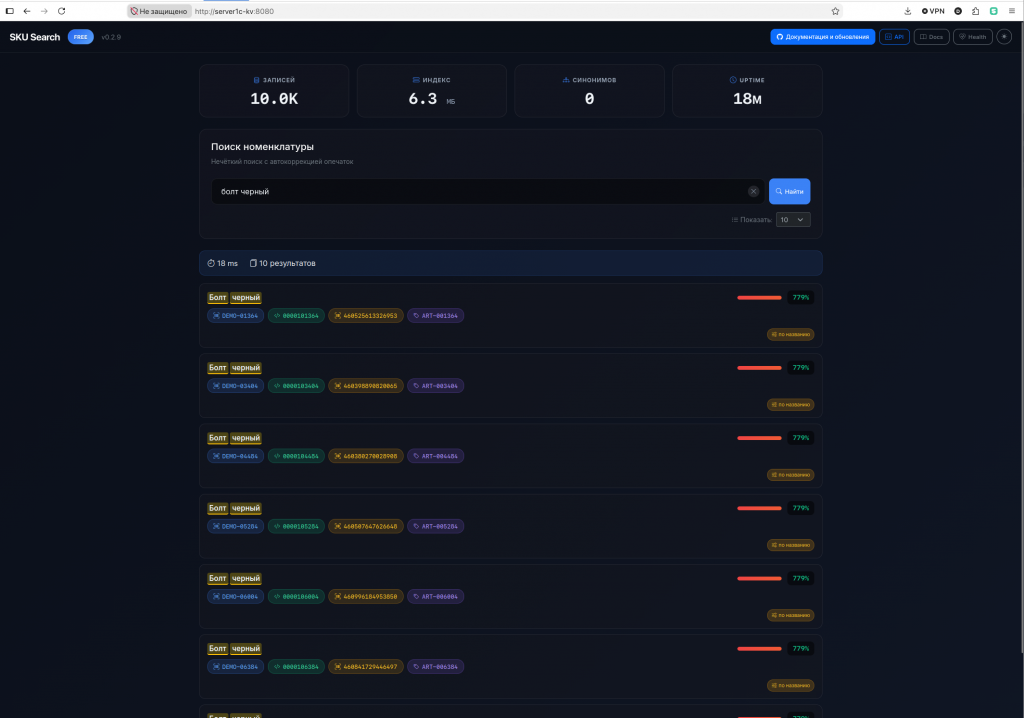
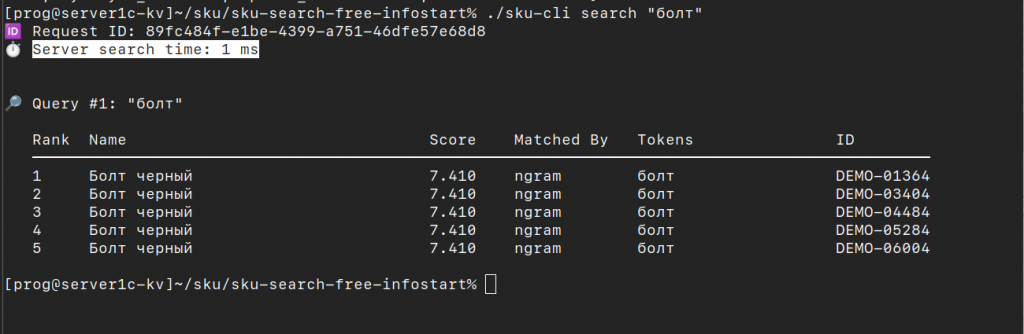
Почему нашлось:
-
«болт» — точное совпадение;
-
«м16» — по префиксу: edge n-граммы (тот же механизм, что находит «Перфоратор» по «перф»);
-
«цинк» — fuzzy-поиск (поиск с опечатками): в наименовании токен «оцинк», разница в один символ (расстояние Левенштейна — сколько символов нужно поменять, чтобы одно слово стало другим).
Можно сделать совпадение и точнее: добавьте синоним «цинк» = «оцинкованный» — и сервис будет искать оба варианта.
С кириллическими названиями fuzzy-поиск работает устойчиво к типичным опечаткам: вставкам, пропускам, перестановкам и замене соседней буквы.
При fuzzy_max_distance = 2 сервис найдет, например
| Что ищем | Что найдем |
| краскаа | краска |
| крска | краска |
| красак | краска |
| телефоон | телефон |
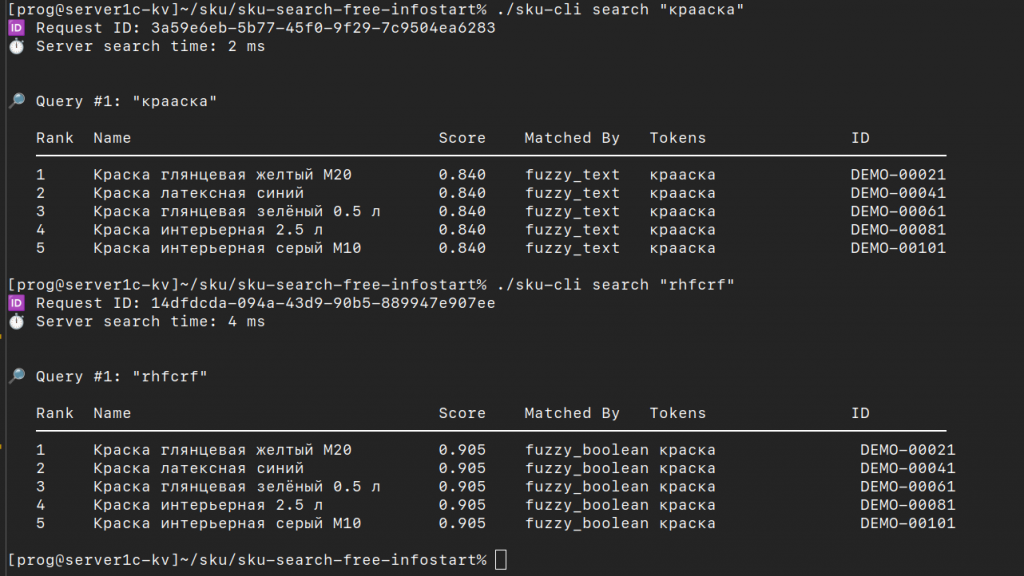
Для русских названий рекомендуется именно значение 2, потому что один кириллический символ кодируется двумя байтами, и поисковый движок работает с расстоянием на уровне байтов — без дополнительной доработки многие кириллические опечатки не покрывались бы даже при fuzzy_max_distance = 1.
А главное — сервис прозрачный: вы видите score (степень совпадения с запросом: 1.0 — идеал, 0 — не похоже) и matched_by (по чему именно нашлось). Никакого черного ящика. Если результат неверный — оператор нажимает «не то» в 1С, и сервис записывает reject. Так собираются сигналы для обучения — об этом ниже.
Транслитерация и неправильная раскладка
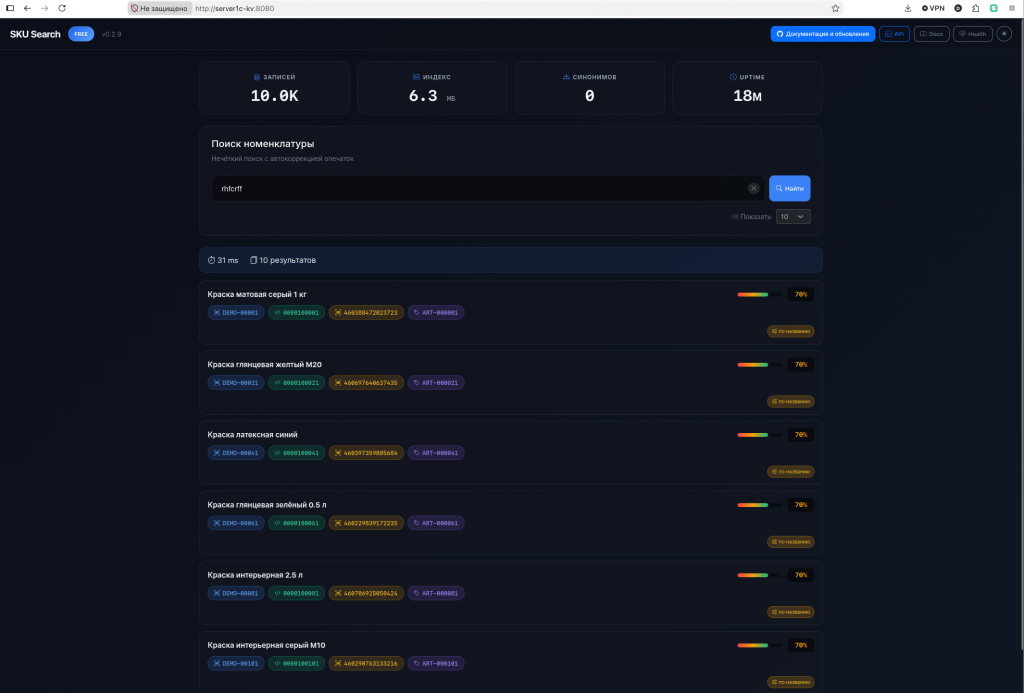
Оператор ошибся раскладкой и ввел запрос латиницей, или написал название транслитом — сервис все равно поймет.
Примеры, которые находят товар «Домик в деревне»:
-
ljvbr d lthtdyt — кириллица, ошибочно набранная на латинской раскладке;
-
domik v derevne — обычная латинская транслитерация.
{
"items": [
{ "name": "ljvbr d lthtdyt" }]}
Сервис размножает каждый токен на несколько вариантов: исходный, исправленную раскладку и транслитерированный, после чего ищет по всем вариантам одновременно. Работает в обе стороны (RU/EN и EN/RU).
Когда это полезно:
-
операторы работают на разных языках;
-
в базе есть товары с латинскими названиями, а запросы приходят кириллицей;
-
пользователи мобильного приложения часто промахиваются по раскладке.
Включить или выключить механизм можно в config.toml:
[search]
transliteration_enabled = true
transliteration_threshold = 0.35
Порог отвечает за «уверенность» сервиса: чем ниже значение, тем охотнее он считать слово транслитом. При лишних ложных срабатываниях увеличьте порог до 0.45–0.50.
А если в наименовании зашит артикул? Находит мгновенно
Вот реальный сценарий. Оператор получает заказ и вводит:
ART-000002 болт м16
1С отправляет это в name. Сервис видит, что в запросе есть ART-000002, и ищет по полю art. Находит точное совпадение — мгновенно, до fuzzy-поиска.
{
"results": [
{
"query": { "name": "ART-000002 болт м16" },
"matches": [
{
"original": {
"name_out": "Болт М16х60 оцинк. ГОСТ 7798-70",
"id_out": "DEMO-00002",
"art": "ART-000002",
"score": 1.0,
"matched_by": "exact_art"}}]}]}
То же самое с barcode, code, id, type, ref.
Более того, exact-поиск по этим полям работает даже если name пустой. Передали
{"art": "ART-000002"}
получили товар.
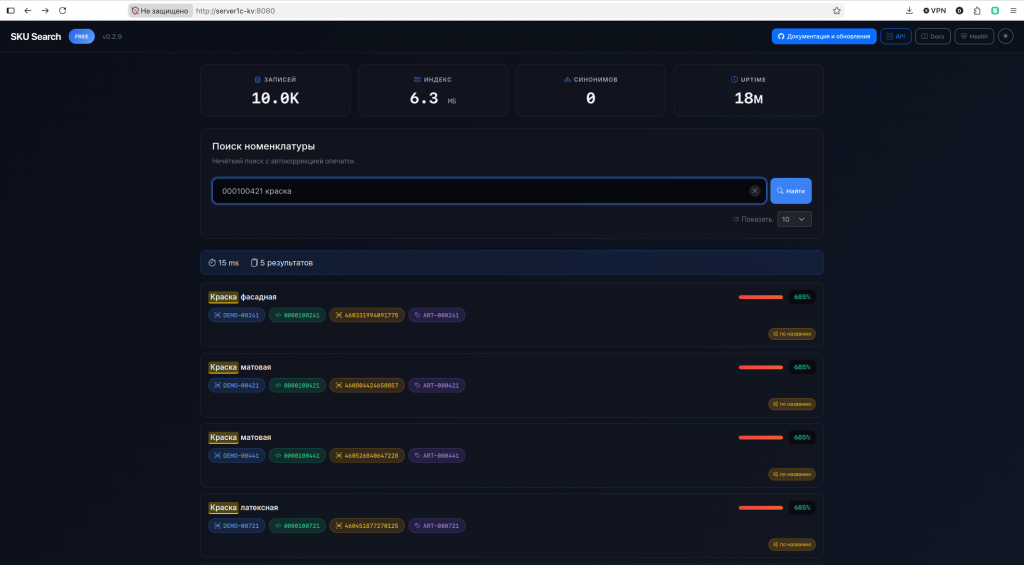
Это и есть та самая автоматизация: ввел артикул в наименовании — получил товар. Не нужно парсить строку в 1С, не нужно отдельное поле для артикула в запросе.
Поля ref и type: прямые ссылки на объекты 1С и фильтр по типу
Помимо id, сервис поддерживает два поля, которые делают интеграцию с 1С удобнее.
ref — прямая ссылка на объект 1С
В ref можно положить сериализованную ссылку 1С, полученную через ЗначениеВСтрокуВнутр()/ПолучитьНавигационнуюСсылку(). Сервис сохранит ее как есть и вернет в ответе. На стороне 1С вы сразу получаете живую ссылку обратно через ЗначениеИзСтрокиВнутр() — без привязки к GUID и без дополнительного поиска по базе.
Пример загрузки:
{
"items": [
{
"id": "SHOE-001",
"name": "Кроссовки спортивные",
"ref": "e1cib/data/Справочник.Номенклатура?ref=a1b2c3d4e5f6..."}]}
Поиск по ref:
{
"items": [
{ "ref": "e1cib/data/Справочник.Номенклатура?ref=a1b2c3d4e5f6..." }]}
Ответ вернет товар с точным совпадением по полю ref.
type — фильтр по типу объекта
Поле type позволяет ограничить поиск одним классом объектов. Например, можно проиндексировать и номенклатуру, и контрагентов, и документы, а затем искать только внутри одного типа.
Пример загрузки:
{
"items": [
{
"id": "C-001",
"name": "ООО Ромашка",
"type": "Справочник.Контрагенты"
},
{
"id": "N-001",
"name": "Болт М16",
"type": "Справочник.Номенклатура"}]}
Поиск с фильтром по типу:
{
"items": [
{ "name": "болт", "type": "Справочник.Номенклатура" }]}
Сервис найдет «Болт М16», но не вернет контрагента «ООО Ромашка». Также type можно передавать вместе сart, barcode, code или ref — exact-поиск отработает по всем указанным полям одновременно.
Любые реквизиты
Здесь я хочу подчеркнуть отдельно: sku-search умеет хранить и искать по неограниченному количеству реквизитов любых типов.
Бренд, поставщик, ТН ВЭД, цвет, размер, материал, ГОСТ, страна, гарантия, серийный номер, внутренний код склада — что угодно. Вы передаете это в одном JSON, и сервис индексирует.
Пример загрузки:
{
"items": [
{
"id": "SHOE-001",
"name": "Кроссовки спортивные",
"brand": "Nike",
"color": "красный",
"size": "42"
},
{
"id": "FRIDGE-001",
"name": "Холодильник Side-by-Side",
"brand": "Samsung",
"diagonal": "55",
"volume": "600"}]}
После этого можно искать с названием и фильтрами:
{
"items": [
{ "name": "телевизор", "brand": "Samsung", "diagonal": "55" }]}
Важно: реквизиты ищутся точно (регистронезависимо, со стеммингом слов). Искать можно и с названием (реквизиты работают как фильтры), и без него
{"name": "", "brand": "Samsung", "diagonal": "55"}
Опечатки в значениях реквизитов не прощаются. В конфиге из архива индексация реквизитов уже включена (enable_attrs_indexing = true), поэтому дополнительные поля можно просто передавать.
Все реквизиты внутри индекса хранятся как строки!
Разные товары могут иметь разные наборы полей. У обуви — цвет и размер. У холодильников — объем. У крепежа — материал и ГОСТ. Сервис не требует единой схемы. Он индексирует только то, что есть у конкретной записи.
Но есть честный недостаток: чем больше полей вы передаете в записи, тем по большим параметрам можно искать, — и тем больше индекс. Его размер растет примерно пропорционально числу полей в записях (и длине их значений).
Регистрозависимый поиск: то, чего в 1С нет
Это важный момент. В 1С сравнение строк по умолчанию регистронезависимое. Это значит, что ART-000002 и Art-000002 для 1С — одно и то же.
Звучит безобидно, пока вы не столкнетесь с:
-
акцизными марками;
-
марками Честного ЗНАКА;
-
серийными номерами;
-
артикулами поставщиков, где регистр различает модификации.
Я знаю реальный кейс: поиск марок Честного Знака в 1С превращался в кошмар именно из-за регистронезависимого поиска. Марка AL123456789 и al123456789 — для 1С одинаковы. Для ГИС МТ — нет. И когда нужно быстро найти конкретную марку среди тысяч, 1С выдает кучу ложных совпадений.
sku-search решает это через настройку case_sensitive_fields:
[search]
case_sensitive_fields = ["id", "art", "barcode", "code"]
case_sensitive_extra_fields = ["brand", "supplier", "serial"]
Теперь при поиске напрямую по этим полям AL123456789 и al123456789 — разные записи, и вы точно находите нужную марку.
Нюанс: регистрозависимость работает для прямого поиска по полю
({"art": "AL123456789"})
а поиск через общее поле name остается регистронезависимым — так операторы продолжают искать по наименованиям как раньше.
Живые кейсы из 1С
Кейс 1. Создание номенклатуры — ищем дубль
Оператор вводит «болт м16 цинк». Сервис находит «Болт М16х60 оцинк. ГОСТ 7798-70». Создание дубля предотвращено.
Кейс 2. Загрузка прайса поставщика — ищем по артикулу
В прайсе артикул ART-000002. В вашей базе — тот же товар. Сервис мгновенно возвращает matched_by: exact_art. Не нужно руками сверять.
Кейс 3. Подбор по штрихкоду
Сканер считал 4601234567890. Сервис сразу нашел товар. Без fuzzy, без ложных срабатываний.
Кейс 4. Поиск по характеристикам
Клиент: «Нужен телевизор Samsung, 55 дюймов». Оператор вводит name: телевизор, brand: Samsung, diagonal: 55. Получает список. При необходимости можно убрать name и искать только по реквизитам — точное совпадение.
Кейс 5. Сверка ТН ВЭД
Нужно найти все товары с кодом 7307 19 100 0. Передаете ТН ВЭД как реквизит — реквизиты ищутся точно, так что код найдется без лишних совпадений и без дополнительной настройки.
Кейс 6. Пакетная сверка накладной
В накладной 200 позиций. Отправляете их одним POST /find. Сервис обрабатывает пакетом и возвращает сопоставления. Не 200 отдельных запросов, не циклы в 1С.
Кейс 7. Марки Честного ЗНАКА и акцизы
Нужно проверить, есть ли марка AANL123456789 в базе. Сервис находит точно, с учетом регистра. В 1С такой поиск дал бы лишние результаты.
Как sku-search дополняет встроенный поиск 1С
Я не говорю, что 1С плохая. Но у нее есть ограничения, которые сложно обойти внутри конфигурации:
| Возможность | Встроенный поиск 1С | sku-search |
| Опечатки | не ловит | ловит |
| Падежи и формы слов | не ловит | ловит |
| Синонимы | нужно писать самому | встроено |
| Регистрозависимость | невозможно в запросах | настраивается |
| Поиск по 10+ реквизитам | сложно и медленно | из коробки |
| Пакетный поиск | цикл в 1С | один HTTP-запрос |
| Нагрузка на 1С | средняя | минимальная |
| Зависимости | нет | один бинарник |
А если сравнивать с Elasticsearch/другими поисковыми решениями — то sku-search не требует Java, отдельного сервера и администрирования. Один бинарник. Скопировал — запустил.
Как это работает под капотом (коротко)
Сервис поднимает http-сервер на указанном в конфигурации порту.
Вы загружаете в сервер необходимые вам данные. Сервис строит внутренний индекс. По вашему запросу производится поиск и отдается ответ.
Внутри — поисковый движок на Tantivy (аналог Lucene, но на Rust). Вместо перебора всех товаров циклом мы строим инвертированный индекс — «обратную» таблицу: по слову сразу список товаров, в которых оно есть. Отсюда — миллисекунды.
1С HTTP POST /find -> sku-search -> Нормализация -> Точные проверки > Fuzzy + ранжирование -> Ответ
Ключевые особенности:
-
Стемминг — приведение слов к основе: «болты», «болтом» = «болт».
-
Fuzzy distance — «блот» = «болт».
-
Edge n-граммы — поиск по началу слова: «перф» = «Перфоратор».
-
Синонимы — «цинк» = «оцинкованный».
-
Веса полей — артикул важнее цвета.
-
Индекс на диске — данные не теряются при перезапуске.
Настройка под ваши данные
Сервис конфигурируется через config.toml. Для старта достаточно значений из архива, но под свои данные можно подкрутить:
[index]
# Расстояние Левенштейна: 0 — точно, 1 — одна ошибка, 2 — две
fuzzy_max_distance = 1

[search]
# Порог «надежности» результатов: чем выше, тем строже
auto_match_threshold = 0.85

# Индексация дополнительных реквизитов (brand, supplier, tnved, ...) — включена по умолчанию
enable_attrs_indexing = true

# Регистрозависимые поля
case_sensitive_fields = ["id", "art", "barcode", "code"]
case_sensitive_extra_fields = ["brand", "supplier", "serial"]
Ключевые параметры:
-
fuzzy_max_distance (секция [index]) — сколько ошибок в слове допускается. Если операторы вводят названия в разных падежах («болтом», «болты») — ставьте 2.
-
auto_match_threshold — порог «надежности»: кандидаты со score, заметно ниже лучшего совпадения, отбрасываются. Начните с 0.85.
-
enable_attrs_indexing — индексировать ли дополнительные реквизиты. В поставляемом конфиге уже включено.
-
case_sensitive_fields / case_sensitive_extra_fields — какие поля искать с учетом регистра.
Все параметры конфигурации описаны в документации сервиса.
Синонимы и обратная связь: как сервис учится без нейросетей
Самое интересное — sku-search не просто ищет, он собирает сигналы для обучения на действиях операторов. Без ML, без GPU, без переобучения моделей.
Как это работает:
-
Оператор вводит запрос, сервис показывает результаты.
-
Если результат неверный — оператор нажимает в 1С кнопку «Не то».
-
1С отправляет в сервис POST /feedback с action: reject.
-
Сервис пишет запись в feedback.log — это и есть источник данных для обучения.
-
Администратор периодически (например, раз в неделю) смотрит лог: какие запросы часто отклоняют и с какими товарами.
-
На этой основе добавляются синонимы
Например: несколько операторов искали «болт м16 цинк», а им предлагали «Болт М16 черный». Смотрим feedback.log и добавляем синоним:
{
"items": [
{ "word": "цинк", "expansions": ["оцинкованный", "zn", "zinc"]}]}
Добавляем через API или CLI:
./sku-cli synonyms add --word "цинк" --expansions "оцинкованный,zn,zinc"
Эффект мгновенный. Перезапуск сервиса не нужен. Теперь «цинк» будет находить «оцинкованный».
То же самое работает с сокращениями и отраслевыми терминами:
-
«нерж» = «нержавеющий», «нержавейка», «a2», «aisi304»;
-
«оц» = «оцинкованный»;
-
«упак» = «упаковка» (или наоборот — в стоп-слова).
Пример CSV для импорта
Не обязательно писать интеграцию сразу. Можно загрузить данные из CSV через sku-cli:
id,name,code,barcode,art,supplier,brand,material,size
DEMO-00001,Краска матовая серый 1 кг,0000100001,4601234567890,ART-000001,ООО ТехноСнаб,Ceresit,,1 л
DEMO-00002,Болт М16х60 оцинк. ГОСТ 7798-70,0000100002,4601234567891,ART-000002,ООО МетизПлюс,Зубр,стальной,M16
DEMO-00003,Кроссовки спортивные красные,0000100003,4601234567892,ART-000003,ООО СпортОпт,Nike,,42
Импорт:
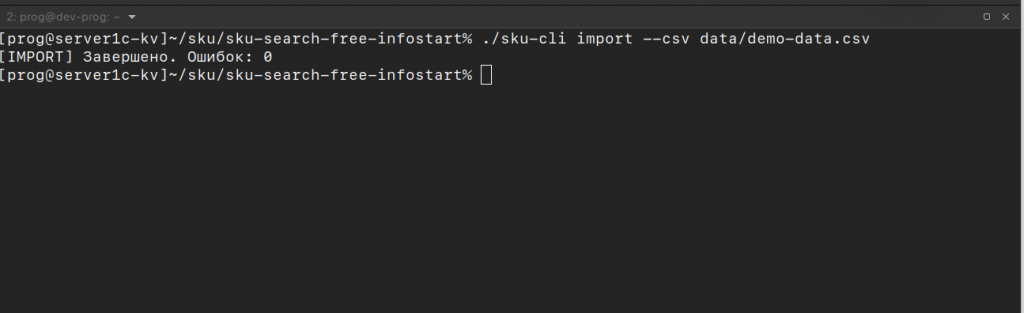
./sku-cli import --csv catalog.csv
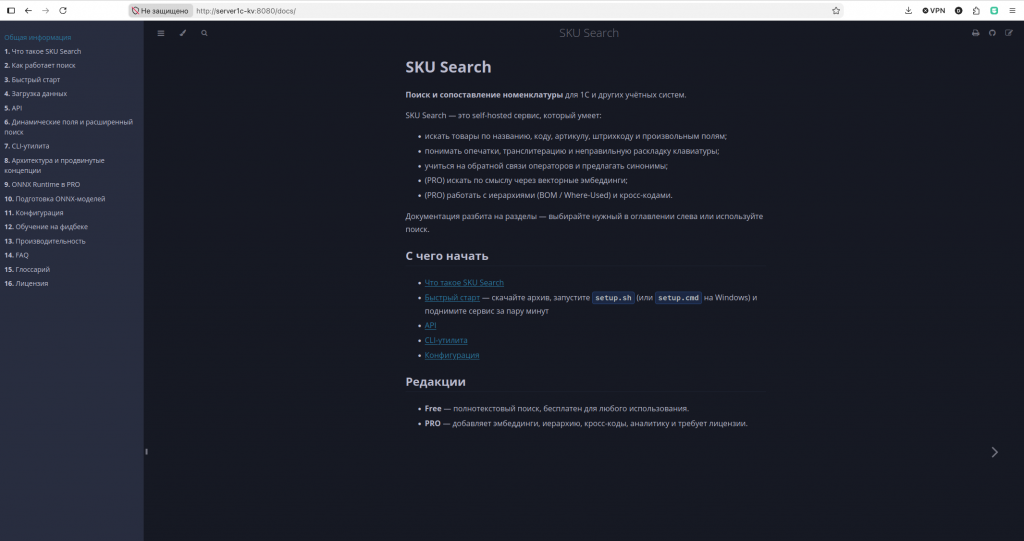
Сервис сам создаст индекс. После этого можно искать через API или веб-интерфейс.
В архиве содержится файл с демо-данными.
Импортируйте его проверьте поиск в web-интерфейсе/sli-cli без подключения к 1С.
Типичные ошибки и как их исправить
Ошибка 1. Передал name: "", а результата нет
Пустое name во Free работает для exact-поиска по id, code, art, barcode, type, ref и для поиска по реквизитам (точное совпадение). Для нечеткого поиска название обязательно.
Ошибка 2. Поле передано, но не участвует в поиске
Любые дополнительные поля индексируются автоматически — описывать их не нужно. Проверьте, что поле передается плоско (на одном уровне с name и id) и что в конфиге не выключен enable_attrs_indexing (в поставляемом конфиге он включен).
Ошибка 3. «болтом» не находит «болт»
По умолчанию fuzzy_max_distance = 1. Для форм слов установите 2.
Ошибка 4. Регистр артикула ломает поиск
Настройте case_sensitive_fields для art, code, barcode. Тогда ART-000002 и art-000002 будут разными записями.
Ошибка 5. Сервис предлагает неверные товары
Повысьте auto_match_threshold до 0.90–0.92. Или добавьте стоп-слова для отраслевого шума.
Быстрый старт за 5 минут
- Скачайте архив.
- Распакуйте. По желанию запустите скрипт setup для вашей платформы - укажите адрес и порт сервиса.
- Скопируйте config.toml.default в config.toml (если запускали скрипт - то не нужно!)
- Запустите: ./sku-service.
- Откройте http://localhost:8080.
- Импортируйте демо-данные: ./sku-cli import --csv demo-data.csv.
- Введите в поиск «болт м16» или «молоко».
Готово. Сервис работает.
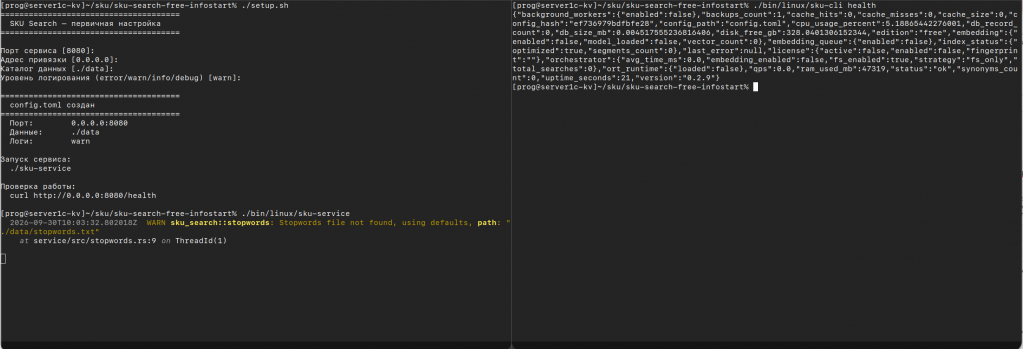
После запуска доступны:
-
/ — главная страница с поиском;
-
/docs — документация;
-
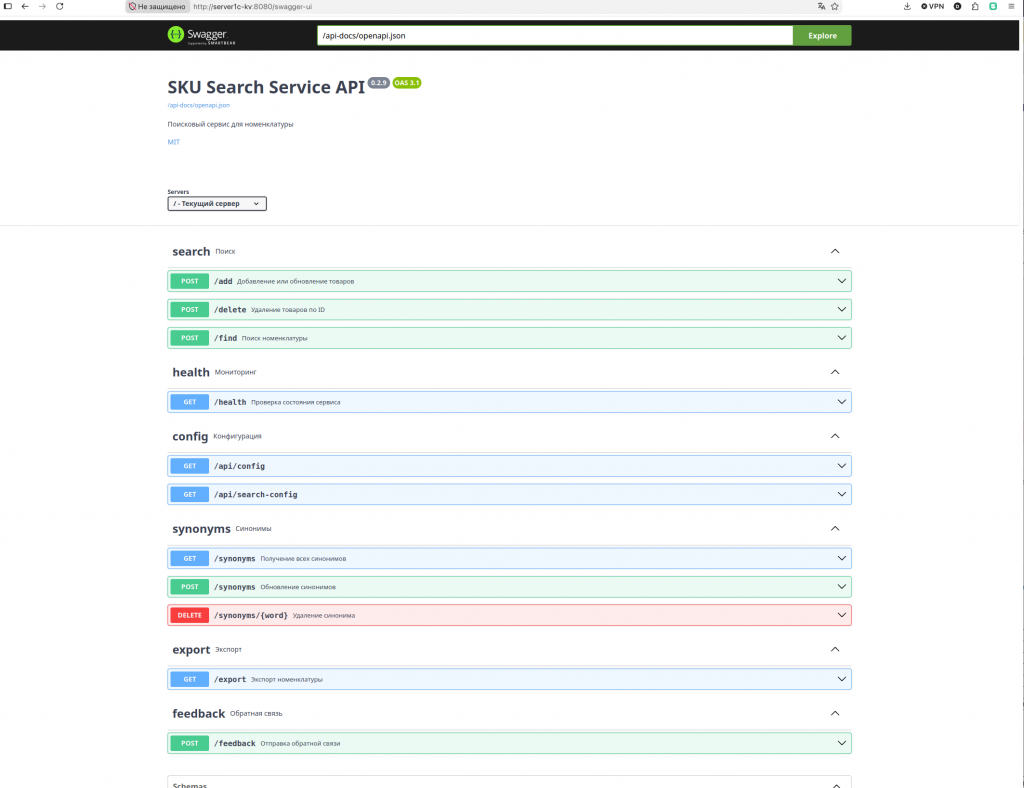
/swagger-ui — интерактивные запросы к API;
-
/health — метрики;
-
sku-cli — импорт CSV, поиск, синонимы, фидбек.
Развертывание: бинарник, Docker, служба
Вариант 1. Один бинарник
Самый простой путь. Скопировали файл, запустили. Подходит для тестов и небольших баз.
cp config.toml.default config.toml
./sku-service
Вариант 2. Docker
В архиве есть Dockerfile. Соберите образ и запустите контейнер:
docker build -t sku-search-free .
docker run -d -p 8080:8080 -v $(pwd)/data:/app/data sku-search-free
Вариант 3. Служба systemd
Для production удобно оформить сервис как systemd-unit:
# /etc/systemd/system/sku-search-free.service
[Unit]
Description=sku-search Free
After=network.target

[Service]
Type=simple
User=sku
WorkingDirectory=/opt/sku-search-free
ExecStart=/opt/sku-search-free/sku-service
Restart=always

[Install]
WantedBy=multi-user.target

systemctl enable sku-search-free
systemctl start sku-search-free
Как подключить к 1С
Вызов через HTTP-запрос. 10–15 минут интеграции.
&НаСервере
Функция НайтиПохожиеТовары(Название)

	Соединение = Новый HTTPСоединение("localhost", 8080);
	Запрос = Новый HTTPЗапрос("/find");
	Запрос.Заголовки.Вставить("Content-Type", "application/json");

	Элемент = Новый Соответствие;
	Элемент.Вставить("name", Название);
	Массив = Новый Массив;
	Массив.Добавить(Элемент);
	Корень = Новый Соответствие;
	Корень.Вставить("items", Массив);

	Запись = Новый ЗаписьJSON;
	Запись.УстановитьСтроку();
	ЗаписатьJSON(Запись, Корень);
	ТелоЗапроса = Запись.Закрыть();

	Запрос.УстановитьТелоИзСтроки(ТелоЗапроса);

	Ответ = Соединение.ОтправитьДляОбработки(Запрос);
	Возврат Ответ.ПолучитьТелоКакСтроку();

КонецФункции
Ответ — JSON, который можно разобрать и показать оператору.
Если не хотите писать интеграцию с нуля — в архиве идет готовое расширение 1С СКУПоиск.cfe.
Все параметры запросов описаны в документации к API сервиса.
Расширение для 1С
Подключается к УТ 11 / ERP / БП / КА.
Предоставляет основные методы АПИ. Умеет искать, добавлять товары в индекс.
Расширение тестировалось на платформе 8.3.27, конфигурация УТ11.
Для Вашей конфигурации может потребоваться доработка.
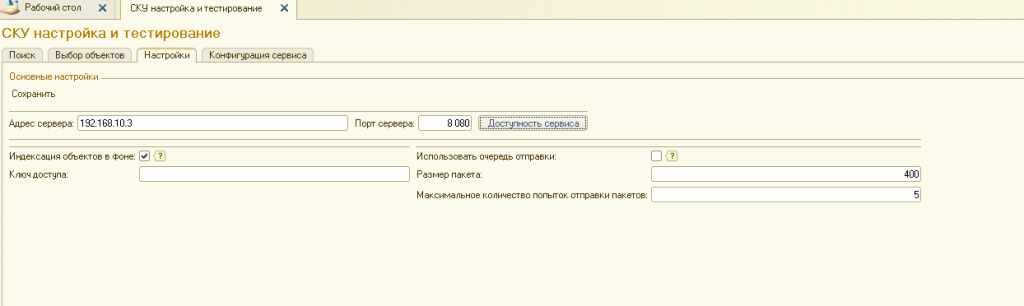
Настройка параметров сервиса
Выбор и настройка объектов для индексирования
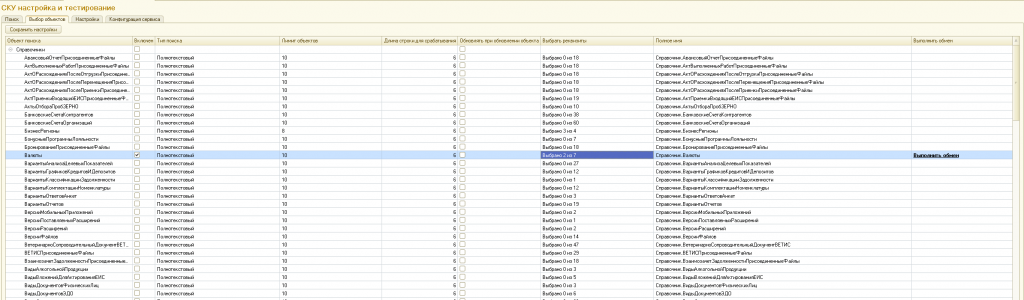
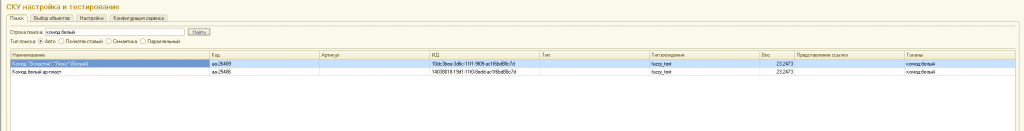
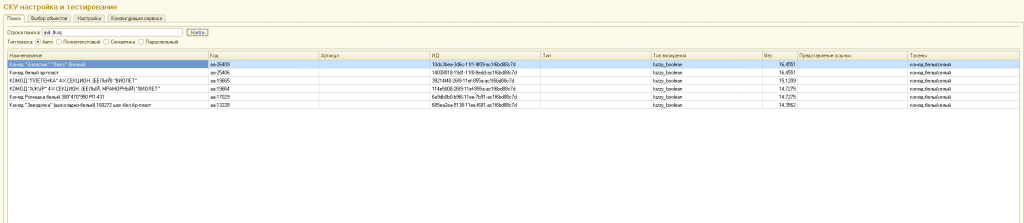
Поиск данных
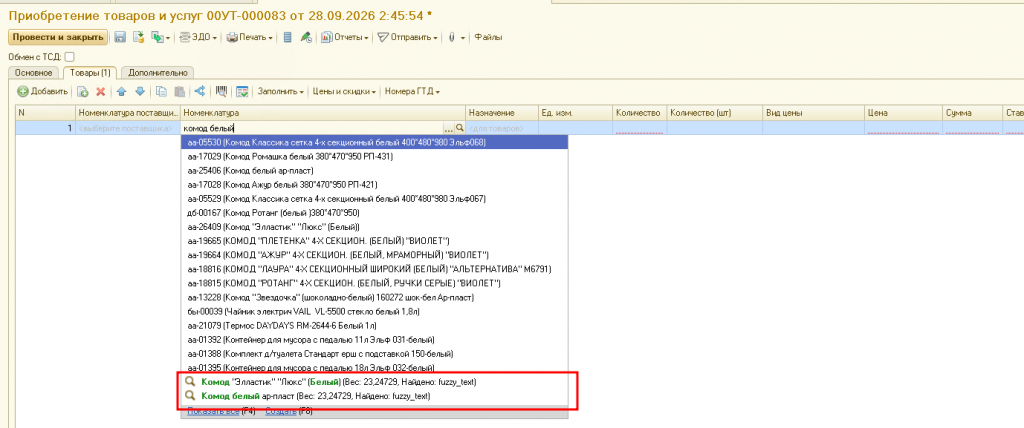
Подбор для документов
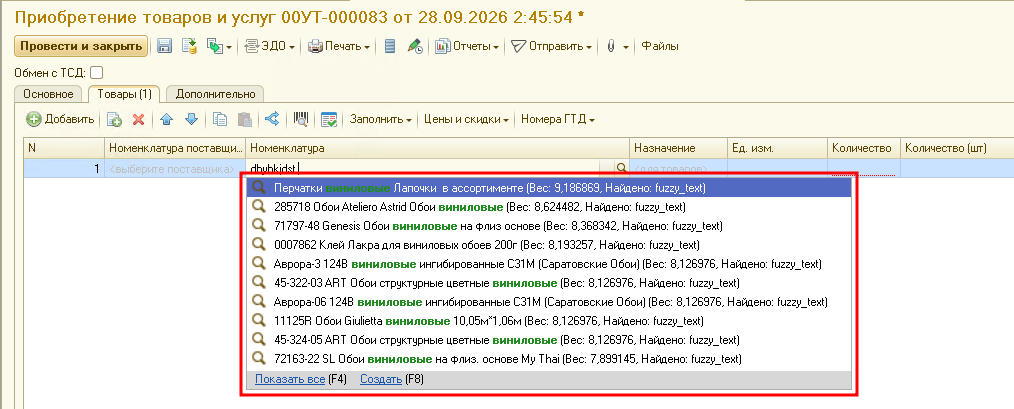
Бенчмарки
Загрузка данных
Результаты внутреннего бенчмарка (100 000 товаров с разным размером одной порции данных):
| batch | items/s | 100k за | Примечание |
|---|---|---|---|
| 500 | 866 | ~115 с | Базовый режим |
| 1 000 | 1 703 | ~58 с | |
| 2 000 | 3 380 | ~29 с | |
| 5 000 | 8 016 | ~12.5 с | |
| 10 000 | 14 121 | ~7.1 с | |
| 30 000 | 37 602 | ~2.7 с | При лимите тела 20 МБ — это максимальный работающий batch |
| 50 000 | 49 354 | ~2.0 с | Требует поднять max_request_body_size_mb и client_max_body_size до ~64 МБ |
| 100 000 | 52 476 | ~1.9 с | Один запрос на всю пачку; предел CPU/RAM и дисковой подсистемы сервера |
Ваши реальные цифры могут отличаться в зависимости от железа и состава данных.
Поиск
Реальные замеры на 50 000 сгенерированных позициях. Цифры — время полного HTTP-цикла, включая сериализацию JSON:
| Тип поиска | Среднее | p50 | p95 |
| Точный по ID | 0,76 мс | 0,74 мс | 0,88 мс |
| Точный по штрихкоду | 0,76 мс | 0,75 мс | 0,83 мс |
|
Точный по реквизиту brand |
0,99 мс | 0,95 мс | 1,19 мс |
|
Название + реквизит brand |
2,78 мс | 3,01 мс | 4,16 мс |
| N-gram по префиксу | 3,72 мс | 1,42 мс | 41,99 мс |
| Fuzzy по названию (2 слова) | 15,89 мс | 3,93 мс | 45,71 мс |
| Fuzzy по названию с опечаткой | 18,50 мс | 5,25 мс | 46,81 мс |
Размер индекса
Индекс на 50 000 товаров занимает около 5 МБ — при скромном наборе реквизитов; чем больше полей передаете, тем индекс крупнее пропорционально. Сервис влезает на любой сервер.
Ваши реальные цифры могут отличаться в зависимости от железа и состава данных.
Работа под нагрузкой
Стенд: 10000 записей, 2 потока, 10 соединений, время нагрузки 30 сек, инструмент wrk.
| Конфигурация | QPS | Средняя задержка | p50 | p99 |
| По-умолчанию | 242 | 41 мс | 40 мс | 83 мс |
| Доработанная | 664 | 15 мс | 14 мс | 30 мс |
При использовании конфигурации по-умолчанию, сервис выдает 242 запросов/с при средней задержке 41 мсек.
Если отключить в конфигурации "дорогие" настройки (transliteration, critical tokens, extended search, unified exact) и свернуть логирование, показатель поднимается до 664 запросов/с при средней задержке 15 мсек.
Почему QPS кажется низким: каждый запрос /find — это тяжелая процессорная операция (полнотекстовый поиск + fuzzy + стемминг + транслитерация + фильтрация + ...).
| Параметр | По умолчанию | Доработанный | Зачем |
|---|---|---|---|
max_candidates_for_fuzzy |
500 |
100 |
обрабатывается меньше кандидатов |
use_unified_search |
true |
false |
отключен булевый фильтр по точным полям |
transliteration_enabled |
true |
false |
нет транслитерации токенов |
enable_critical_token_filtering |
true |
false |
нет пост-фильтра критичных токенов |
min_token_match_ratio |
0.5 |
0.0 |
нет отсечения по покрытию токенов |
candidate_multiplier |
2 |
1 |
меньше кандидатов |
extended_search_enabled |
true |
false |
не ищем по дополнительным полям |
enable_deep_1c_parsing |
true |
false |
нет 1С-препроцессинга |
feedback.enabled |
true |
false |
не собираем статистику для предложений |
logging.level |
info |
warn |
меньше логов |
console_enabled |
true |
false |
нет красивого лога |
file_enabled |
true |
false |
нет записи логов на диск |
Мониторинг и логи
Сервис пишет логи в data/logs/. По умолчанию уровень info, но для отладки можно включить debug:
[logging]
level = "info"
file_enabled = true
file_directory = "./data/logs"
file_rotate_max_size_mb = 100
file_keep_last_n = 7
Что смотреть:
-
/health — общее состояние: db_record_count, index_status, ram_used_mb, edition.
-
data/logs/sku-search-*.json — запросы, ошибки, время ответа.
-
data/feedback.log — действия операторов для обучения синонимам.
Если поиск стал медленным — проверьте index_status.segments_count. Сегменты — части индекса, их накапливается при массовой загрузке; когда их много, поиск замедляется. Если сегментов мало, а поиск все равно медленный — смотрите на RAM и диск; перезапуск сервиса очистит кэши в памяти, но на сегменты не влияет.
FAQ
Ничего не находит
-
Данные загружены? Проверьте /health - db_record_count.
-
Ищете пустым name? Такой запрос работает только для exact-поиска (id, code, art, barcode, type, ref) и поиска по реквизитам.
-
Реквизиты индексируются? Проверьте enable_attrs_indexing в конфиге.
Не находит с опечатками
-
Увеличьте fuzzy_max_distance в config.toml. 0 — точно, 1 — одна ошибка, 2 — две. Для кириллических названий рекомендуется 2 — это покрывает типичные опечатки: «краскаа», «крска», «красак», «телефоон».
Находит не то
-
Подстройте auto_match_threshold. Повысьте — будет строже.
-
Добавьте стоп-слова и синонимы.
Как искать только по бренду/поставщику?
-
Передайте реквизит без name — сработает точное совпадение (регистронезависимо, со стеммингом).
Почему «болтом» не находит «болт»?
-
По умолчанию fuzzy_max_distance = 1. Для форм слов и кириллических опечаток установите 2.
Можно ли использовать без 1С?
-
Да. JSON in / JSON out. Подключается к любой системе.
Нужен ли интернет?
-
Нет. Работает полностью локально.
Как синхронизировать данные с 1С?
-
sku-search не заменяет справочник 1С. Он дублирует нужные данные в свой индекс. Обычно при создании/изменении номенклатуры в 1С отправляется POST /add. При удалении — POST /delete. Или раз в ночь перезагружается весь каталог через CSV.
Какие данные передавать в id?
-
Лучше всего GUID из 1С. Тогда по id_out можно однозначно найти товар в базе. Можно использовать код или артикул, если они уникальны.
-
Альтернатива — поле ref: положите туда ЗначениеВСтрокуВнутр()/ПолучитьНавигационнуюСсылку() — сериализованную ссылку на любой объект вашей 1С (номенклатура, документ, что угодно). Сервис вернет ее в ответе как есть, а на стороне 1С ЗначениеИзСтрокиВнутр() мгновенно восстановит живую ссылку из текущей базы — без привязки к GUID.
-
Значение id должено быть уникальным и постоянным. Если вы загрузите товар с тем же id, но другим набором полей, сервис полностью перезапишет старую запись новыми данными. Пустой или отсутствующий id вызовет ошибку при добавлении.
Можно ли ограничить доступ к API?
-
Да. В config.toml есть api_key и настройки rate limit. Если сервис доступен только из локальной сети, ключ можно не включать.
Что делать, если индекс разросся?
-
На 50 000 товаров индекс — около 5 МБ, на 100 000 — порядка десятков мегабайт.
-
Установите флаг в конфиге [admin] optimize_on_startup = true и перезапустите сервис.
-
Не индексируйте лишнее если в этом нет необходимости: enable_attrs_indexing = false - уменьшает индекс примерно на 18% (в зависимости от количества полей).
Приложение: глоссарий
Для тех, кто не в теме поисковых движков:
| Термин | Что это простыми словами |
| Токен | «Слово» — кусок текста, на который сервис разбирает строку |
| Стемминг | Приведение слов к основе: «болты», «болтом», «болт» |
| Fuzzy-поиск | Поиск с опечатками: «блот» найдет «болт» |
| Расстояние Левенштейна | Сколько символов нужно поменять, чтобы одно слово стало другим |
| Edge n-граммы | Поиск по началу слова: «перф» найдет «Перфоратор» |
| Инвертированный индекс | «Обратная» таблица: по слову сразу список товаров, где оно есть |
| Score | Степень совпадения с запросом: 1.0 — идеал, 0 — совсем не похоже |
| Порог (threshold) | Граница: например, «надежный результат, если score не ниже порога» |
| Сегмент | Часть индекса; после массовой загрузки их много — их можно объединить для ускорения поиска |
| BOM / Where-Used | Спецификация изделия (из чего состоит) и обратная (где используется) |
| Эмбеддинг | Математический «отпечаток» смысла текста; позволяет искать по смыслу |
Вместо заключения
Sku-search — это не просто «поиск дублей».
Это поисковый движок, который дополняет встроенный поиск 1С:
-
ищет по наименованию с опечатками и словоформами;
-
ищет по неограниченному числу реквизитов;
-
ищет с учетом регистра — критично для марок, акцизов, серийников;
-
ищет пакетно, не грузя 1С циклами;
-
работает из одного бинарника без Java, Docker и GPU.
Если у вас в 1С боль с поиском — попробуйте. Скачайте, загрузите свои товары, сделайте десяток запросов. Увидите, что искать в 1С может быть быстро, прозрачно и без нервов.
В архиве:
-
sku-service — сам сервис;
-
sku-cli — консольная утилита;
-
СКУПоиск.cfe — расширение для 1С;
-
demo-data.csv — демо-каталог;
-
config.toml.default — пример конфигурации;
-
Dockerfile — если нужен контейнер.
-
setup.sh/setup.cmd - скрипты начальной инициализации
Страница сервиса: github.com/kadrjob/sku-free.
Все приложенные к статье картинки реальные. Запуск выполнялся на ПК Xeon 4210 / 64 Gb RAM
Sku-search работает с любыми данными: крепеж, электрика, одежда, запчасти, алкоголь, маркированный товар — сервис подстраивается под вашу предметную область.
Если статья была полезна или у вас есть вопросы по настройке — буду рад обсудить в комментариях.
Делитесь своими кейсами поиска в 1С — прочитаю все с интересом.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.