Автоматические оповещения об ошибках журнала регистрации 1С в ElasticSearch через ElastAlert
База данных - Журнал регистрации
Настройка ElastAlert для журнала регистрации 1С в ElasticSearch сводится к одной задаче: перевести контроль ошибок 1С из нерегулярного ручного просмотра индексов в автоматическое оповещение по правилам частоты (frequency). Логи ЖР уже в кластере - дальше нужны предсказуемые письма в поддержку без дежурства у Kibana Discover. ElastAlert описывает пороги в файлах правил и сам шлёт e-mail, когда условие выполняется.
1. Зачем автоматизировать контроль ошибок журнала регистрации
Типичная отправная точка: ElasticSearch уже принимает события из журнала регистрации по основным информационным базам 1С:Предприятие 8.3, разовые правки по всплескам сделаны. Дальше кто-то из админов или разработчиков «когда успеет» смотрит агрегации и таблицы. Такой разбор статистики нерегулярен, завязан на человека и часто срабатывает поздно.
Фоновые задания, регламентные обмены и интеграции пишут «Уровень: Ошибка» в ЖР, а пользователи в интерфейсе ничего не видят и в саппорт не звонят. Проще один раз описать пороги в файлах правил, чем каждую неделю вручную смотреть одни и те же агрегации в Discover. Пороги и получатели лежат в конфигурации, а не в голове дежурного администратора.
Проверка идёт по расписанию процесса ElastAlert, хоть раз в минуту, а не по календарю дежурного. Правила можно сузить до комбинаций полей ЖР, которые при ручном просмотре легко пропустить: та же база, тот же «Комментарий», но только фоновый контекст по полю «ИмяПриложения». Обратная сторона - одинаковые письма по ошибке, которую вы пока не чините. Без realert, группировки и фильтров саппорт быстро перестанет читать алерты даже когда придёт что-то важное.
Схема цепочки такая (рис. ниже).

ЖР 1С, индекс ES, правило frequency, e-mail
Журнал регистрации остаётся источником истины на стороне 1С, ElasticSearch хранит копию для поиска, ElastAlert опрашивает индекс по правилам type и при срабатывании вызывает alert. Ручной мониторинг выпадает из цепочки как отдельный нерегулярный шаг.
Какие поля ЖР стоит уже иметь в индексе
Чтобы правила frequency и фильтры в файлах правил были осмысленными, в документе в ElasticSearch обычно индексируют хотя бы «Уровень», «ИнформационнаяБаза», «Комментарий», «ИмяПриложения», «Событие», «Дата», «ИмяПользователя», «Компьютер». «Уровень» отделяет ошибки от предупреждений и информации. «ИнформационнаяБаза» даёт query_key для порогов по каждой базе отдельно.
«Комментарий» несёт текст исключения и стек вызова из модуля 1С. По «ИмяПриложения» отличают пользовательский сеанс от фонового контекста. В выгрузках встречаются и «BackgroundJob», и «Фоновое задание», и имя регламентного задания - проверьте в Discover фактические значения для регламентных и фоновых заданий в вашем контуре. Я часто завожу отдельные правила или более жёсткие пороги для регламентных заданий, чтобы не смешивать их с единичными ошибками в UI.
2. ElastAlert: как устроены мониторинг и оповещения
ElastAlert написан на Python и в цикле опрашивает ElasticSearch по правилам из каталога rules_folder. В голове я держу две независимые части: правило мониторинга (поле type в YAML) и правило оповещения (блок alert). Мониторинг отвечает на вопрос «условие по событиям в индексе выполнилось?». Оповещение отвечает «куда и как сообщить».
Контекст: 2. ElastAlert: как устроены мониторинг и оповещения
Для логов журнала регистрации 1С чаще всего начинают с frequency: событие произошло X раз за Y времени. Так задают порог «больше ста ошибок в час по базе» или «одна и та же ошибка больше десяти раз в час». Остальные типы из документации ElastAlert подключают, когда frequency уже не описывает симптом.
spike - резкий скачок или провал числа событий относительно предыдущего окна; уместен, если фон стабилен, а вас интересует аномалия, а не абсолютный порог. flatline - слишком мало событий за период; для ЖР это скорее контроль «обмен перестал писать в лог», если вы ожидаете регулярные записи. blacklist / whitelist - срабатывание, когда значение поля попало или не попало в список; база для идеи «новой» ошибки через исключение известных шаблонов «Комментарий». any - любое событие по фильтру; агрессивно, но иногда нужно для редких критичных «Событие» с немедленным письмом. change - у поля два разных значения за интервал; реже для классических ошибок, чаще для диагностики смены контекста.
Готовые каналы оповещения в ElastAlert уже есть: Command, Email, Jira, Slack, Telegram, MS Teams, PagerDuty, HTTP POST и другие. Свой alerter можно дописать по документации проекта. В продакшене для письма в поддержку обычно хватает блока email в alert: from_addr, список получателей, alert_subject, smtp_host, smtp_port. Остальные каналы подключают, если у вас уже принят инсидент-инструмент; сюжет статьи - e-mail в саппорт как в рабочем контуре.
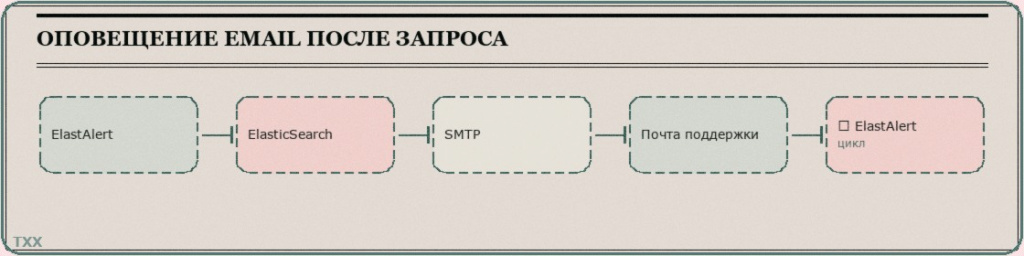
ElastAlert опрашивает ES и шлёт SMTP в саппорт
Тип правила не подменяет транспорт: одно и то же frequency может слать и в Slack, и на почту, если явно перечислить несколько способов в alert. Я на практике оставляю один канал на правило, чтобы проще разбирать ложные срабатывания.
Актуализация: ElastAlert 2, Kibana Alerting, Watcher
Оригинальный ElastAlert заточен под классический стек и старые версии клиента elasticsearch. В старых инструкциях встречаются pip install elastalert, python setup.py install и elasticsearch>=5.0.0. Для современного кластера 7.x/8.x я смотрю в сторону поддерживаемого форка ElastAlert 2 и клиента elasticsearch, совместимого с вашей версией сервера.
Тот же сценарий «frequency по индексу 1c-eventlog-* при превышении порога» можно реализовать встроенным Kibana Alerting или Elasticsearch Watcher: там другой формат правила, но логика та же - запрос по индексу, порог за окно времени, действие e-mail. Тема статьи остаётся на ElastAlert и YAML, потому что правила удобно хранить в Git рядом с конфигом и переносить между средами без привязки к UI Kibana.
3. Установка и базовая конфигурация
Дальше предполагаю, что индексы с ЖР уже есть; установку самого ElasticSearch и Logstash/Filebeat с нуля сюда не тащу. На той же машине, где уже крутится агент доставки логов (или на отдельном хосте без GUI), поднимите venv и установите пакеты из README выбранного форка.
Контекст: 3. Установка и базовая конфигурация
pip install elastalert
pip install "elasticsearch>=5.0.0"
Блок выше - легасу-путь из старых заметок: для новых кластеров берите ElastAlert 2 и клиент elasticsearch под вашу версию ES, а не слепое копирование pip install elastalert. Строки с python setup.py install и setuptools для новых развёртываний я не копирую вслепую: для ElastAlert 2 смотрите README форка. Отдельно установите Рутнон-пакет elasticsearch той маjор-версии, которую требует ваш форк - имя клиента в pip совпадает с elasticsearch, но номер версии должен стыковаться с сервером.
После установки правлю config.yaml в каталоге конфигурации.
rules_folder: /etc/elastalert/rules
run_every:
  minutes: 1
buffer_time:
  minutes: 15
es_host: es.example.local
es_port: 9200
es_username: elastalert_reader
es_password: "***"
writeback_index: elastalert_status
Параметры из основы конфигурации те же по смыслу: rules_folder - каталог файлов правил; es_host и es_port - точка входа в кластер; es_username и es_password - если включена безопасность. Для записи служебного состояния нужен writeback_index (по умолчанию elastalert_status). run_every задаёт, как часто процесс просыпается; для оперативности по ошибкам 1С я ставлю минуту, но нагрузку на ES проверяю на своём объёме индекса.
Служебные индексы создаю один раз командой elastalert-create-index. Имя нового индекса по умолчанию elastalert_status, копировать из существующего обычно не нужно. Без этого шага правила могут отрабатывать странно или не запоминать состояние.
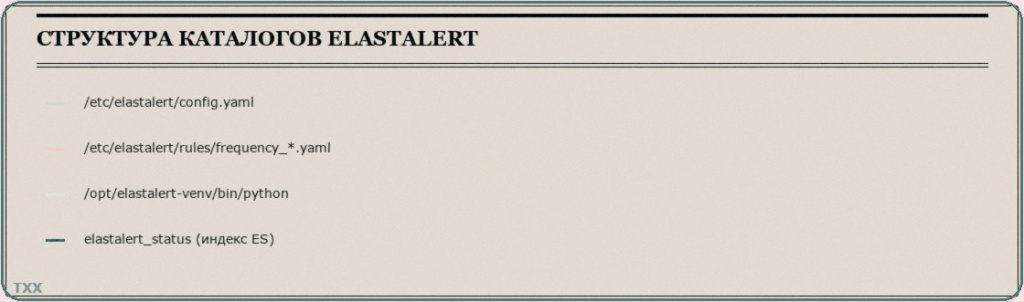
Каталоги config.yaml и УАМЛ-правил ElastAlert
Каталог config.yaml и каталог rules_folder держу раздельно, чтобы при деплое не смешивать секреты SMTP и сами пороги. После создания индекса положите в rules_folder хотя бы одно тестовое правило. Не смешивайте example_rules из поставки с боевыми именами: name в YAML должно быть уникальным.
4. Правило frequency для индекса 1c-eventlog: разбор боевого фрагмента
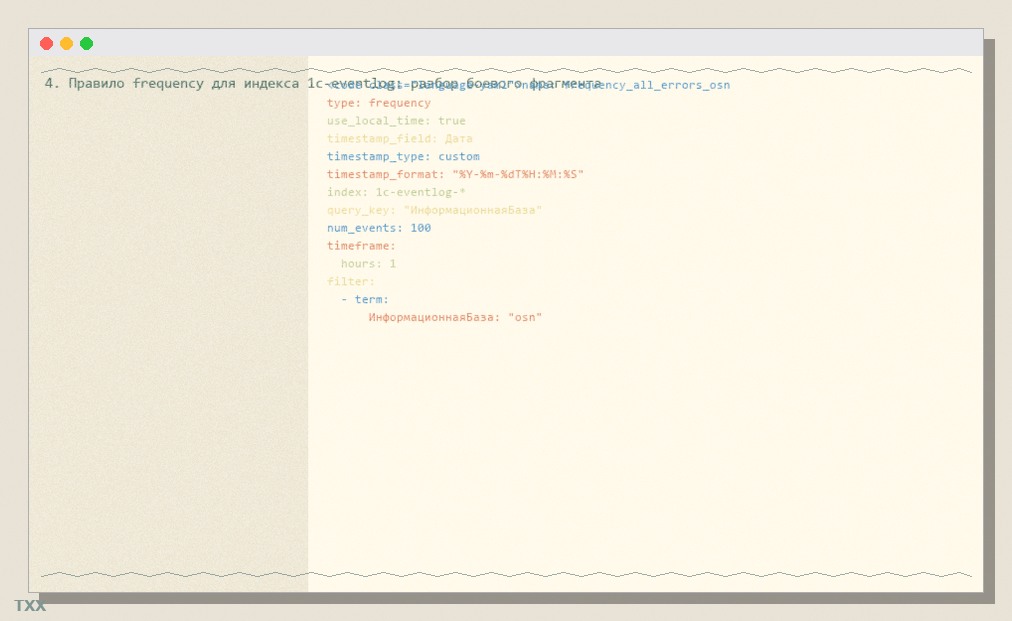
Базовый шаблон для «все ошибки по базе за час» я собираю вокруг индекса 1c-eventlog-*, поля времени «Дата» и фильтра по уровню. Подключение к ES задаётся в config.yaml, в файле правила es_host дублировать не нужно, если ваш форк это явно не требует.
Контекст: 4. Правило frequency для индекса 1c-eventlog: разбор боевого фрагмента
name: frequency_all_errors_osn
type: frequency

use_local_time: true
timestamp_field: Дата
timestamp_type: custom
timestamp_format: "%Y-%m-%dT%H:%M:%S"

index: 1c-eventlog-*
query_key: "ИнформационнаяБаза"
num_events: 100
timeframe:
  hours: 1

filter:
  - term:
      ИнформационнаяБаза: "osn"
  - term:
      Уровень: "Ошибка"

alert:
  - email
email:
  - support@example.com
from_addr: admin@example.com
smtp_host: mail.example.local
smtp_port: 25
alert_subject: "Превышение количества ошибок в {0}"
alert_subject_args:
  - ИнформационнаяБаза
alert_text_type: alert_text_only
alert_text: |
  За последний час в базе {0} зафиксировано не менее {1} ошибок ЖР.
  Проверьте Kibana Discover по индексу 1c-eventlog и полю Комментарий.
alert_text_args:
  - ИнформационнаяБаза
  - num_hits
В плейсхолдерах {0} и {1} в alert_subject и alert_text подставляются значения из alert_subject_args и alert_text_args: имя базы из query_key и число совпадений (num_hits). Сверьте список полей с документацией вашей версии ElastAlert - у форков порядок иногда отличается.
timestamp_field «Дата» должно совпадать с mapping в ElasticSearch: тип date и формат, который реально приходит из вашего конвейера загрузки ЖР. timestamp_type: custom и timestamp_format: "%Y-%m-%dT%H:%M:%S" задают разбор строки. Если у вас миллисекунды или суффикс Z в конце, формат правят под фактический документ.
use_local_time: true влияет на границы окон. При расхождении часового пояса сервера ElastAlert и поля «Дата» правило может «молчать» или срабатывать со сдвигом. Это первое, что я проверяю, когда в Discover события есть, а numhits в тесте нулевой.
query_key «ИнформационнаяБаза» заставляет ElastAlert считать порог отдельно для каждого значения поля. num_events и timeframe задают порог frequency: здесь сто событий за один час. В filter сочетаются term по базе и term по полю «Уровень». Если в индексе уровень нормализован иначе (например, «Error»), подставьте фактическое значение из pipeline.
Второе боевое правило: одна ошибка чаще десяти раз в час
Для повторяющегося «Комментарий» порог ниже. Группировку расширяю: одна и та же текстовая ошибка не должна размазываться по разным пользователям. Ниже тот же контур, что закрывает обещание из раздела про спам: realert, два поля в query_key, term по «Уровень» и сужение по «ИмяПриложения».
name: frequency_same_comment_osn
type: frequency

use_local_time: true
timestamp_field: Дата
timestamp_type: custom
timestamp_format: "%Y-%m-%dT%H:%M:%S"

index: 1c-eventlog-*
query_key:
  - "ИнформационнаяБаза"
  - "Комментарий"
num_events: 10
timeframe:
  hours: 1

filter:
  - term:
      ИнформационнаяБаза: "osn"
  - term:
      Уровень: "Ошибка"
  - term:
      ИмяПриложения: "BackgroundJob"

realert:
  hours: 2

alert:
  - email
email:
  - support@example.com
from_addr: admin@example.com
smtp_host: mail.example.local
smtp_port: 25
alert_subject: "Повтор ошибки ЖР, более 10 в час, база {0}"
alert_subject_args:
  - ИнформационнаяБаза
Два порога - «больше десяти совпадений по одному комментарию» и «больше ста ошибок всего» - закрывают мой типичный контур. Массовый сбой интеграции или регламентного задания виден по второму. Локальная проблема модуля - по первому.
Типичная ситуация после смены пароля интеграции: 1С при каждом обращении пишет ошибку в ЖР. Пользователи могут не заметить. Счётчик по «Комментарий» с HTTP или авторизацией за час переваливает за десять, письмо уходит в поддержку раньше эскалации от бизнеса.
Mapping «Дата» и тишина правила
Если «Дата» проиндексирована как text, а не date, или формат в timestamp_format не совпадает с тем, что кладёт shipper, ElastAlert не попадает в окно timeframe. Проверка руками: в Dev Tools Kibana или через API возьмите один документ ошибки. Сравните строку «Дата» с timestamp_format.
Частый промах - term по «ИнформационнаяБаза», когда в документе другое написание имени базы: регистр, лишний пробел. Ещё вариант - фильтр query_string «Уровень: Ошибка», когда уровень уже нормализован в отдельное поле. Тогда фильтр переписывают под ваш pipeline.
5. Тестирование, запуск и эксплуатация
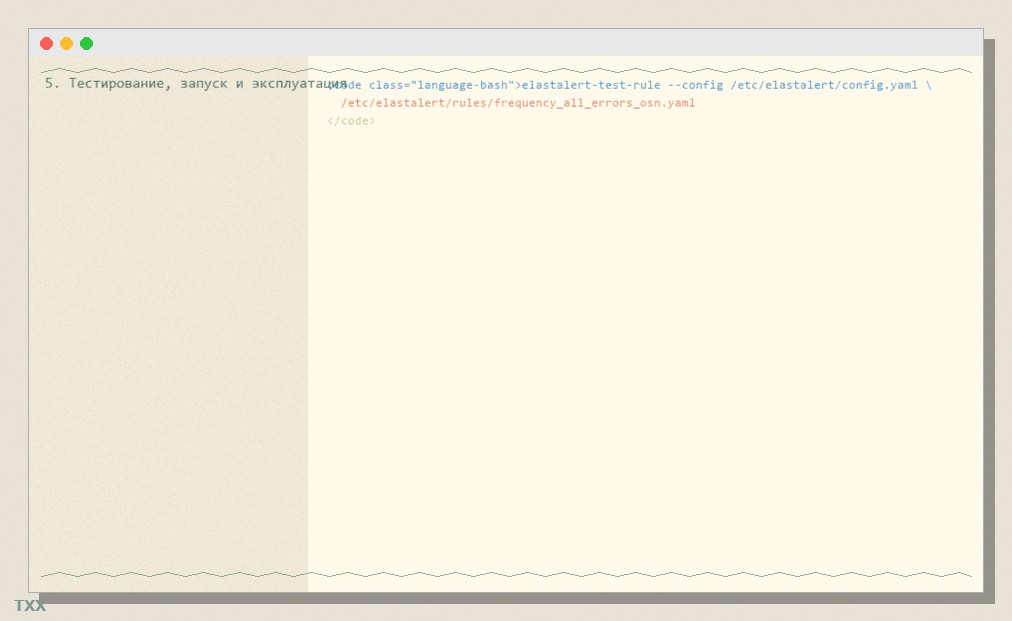
Перед фоновым запуском прогоняю правило на исторических данных:
Контекст: 5. Тестирование, запуск и эксплуатация
elastalert-test-rule --config /etc/elastalert/config.yaml \
  /etc/elastalert/rules/frequency_all_errors_osn.yaml
В выводе смотрю num_hits, num_matches и попадает ли тестовое окно в интервал, где ошибки точно были. При нуле matches при видимых ошибках в Discover возвращаюсь к «Дата», timezone и filter. Не к num_events.
Боевой процесс поднимаю так:
python -m elastalert.elastalert --verbose --config /etc/elastalert/config.yaml
Флаг --verbose на первых сутках помогает увидеть ошибки SMTP или отказ ES. Потом логирование можно ослабить, но writeback_index я не отключаю.
Как выглядит письмо и что из него читать
ElastAlert в теле письма обычно даёт имя правила, интервал окна, число совпадений и поля документов ЖР. Упрощённый фрагмент в духе реального оповещения. Поля зависят от шаблона alert_text и include_fields. Формат «Дата» согласован с timestamp_format в правиле (без Z в конце):
frequency_same_comment_osn
At least 10 events occurred between 2020-01-24 14:15 and 2020-01-24 15:15
index: 1c-eventlog
ИнформационнаяБаза: osn
ИмяПриложения: BackgroundJob
Дата: 2020-01-24T12:15:38
Комментарий:... Ошибка при вызове метода контекста... по причине:...
ИмяПользователя:...
Компьютер:...
Мне в первую очередь нужны «Комментарий» и «ИмяПриложения»: по ним видно, регламентное это задание или интерактив, и какой модуль 1С упал. «КраткоеОписание» и «Событие», если они есть в индексе, стоит добавить в include для сортировки шума.
Снижение спама без универсального фильтра
Универсальной кнопки нет, зато в конфигурации правил есть конкретные рычаги. realert с интервалом в часах не шлёт новое письмо по тому же query_key каждую минуту. query_key группирует повторы: одна база, один шаблон «Комментарий». В части версий ElastAlert для той же группировки есть aggregation_key - сверьте с README форка, если realert одного query_key мало.
Дополнительные терм-фильтры по «КраткоеОписание», «Событие» и «ИмяПриложения» отсекают шум. В одном файле правила оставляю только фоновый контекст, в другом исключаю известное «Событие» штатного обмена через must_not. blacklist по началу «Комментарий» для старых известных ошибок уменьшает поток, пока вы не завели отдельное правило «новой» ошибки. Второе боевое правило выше - готовый образец с realert и двумя полями query_key.
Отдельно ограничиваю получателей: одно правило - один ящик второй линии, а не вся компания. alert_subject с подстановкой полей базы помогает быстрее разобрать очередь писем поддержки.
6. Что дальше: новые ошибки и служба
Следующий шаг, который я обычно откладываю до стабилизации порогов, - правила на «новые» ошибки. type any или frequency с низким порогом плюс blacklist известных шаблонов «Комментарий» (или whitelist только критичных подстрок). Либо отдельный индекс эталонов хешей комментариев, который обновляется реже боевых алертов. Эталон устареет, если не чистить его после релиза конфигурации 1С - здесь нужна дисциплина.
Запуск python -m elastalert.elastalert в screen на сервере я считаю временным. Для продакшена фиксирую unit systemd с Restart=always и журналированием в journal, либо программу Supervisor с autorestart=true. Пример минимального systemd unit:
[Unit]
Description=ElastAlert for 1C eventlog
After=network.target

[Service]
Type=simple
User=elastalert
WorkingDirectory=/etc/elastalert
ExecStart=/opt/elastalert-venv/bin/python -m elastalert.elastalert --config /etc/elastalert/config.yaml
Restart=always
RestartSec=10

[Install]
WantedBy=multi-user.target
После enable/start проверяю, что процесс переживает reboot и что в elastalert_status появляются отметки последних прогонов. Логи SMTP при блокировке relay без пароля - отдельная история; from_addr должен быть разрешён на вашем mail.example.local. На продакшене часто нужны smtp_ssl или relay с аутентификацией - порт 25 без TLS в 2026 году редко проходит без доработки.
Если команда уходит на Kibana Alerting, те же пороги десять и сто в час оставляю контрольными цифрами при миграции. Неделю сравниваю срабатывания со старым ElastAlert. ElastAlert удобен там, где правила версионируются как файлы и где не хочется привязывать мониторинг ЖР к конкретной версии Kibana.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

