6 нагрузочных тестов за 16 недель: как мы автоматизировали цикл нагрузочного тестирования с помощью LLM
Нагрузочное тестирование сейчас является неотъемлемой частью многих продуктов и систем. Здесь я не буду говорить о нагрузочном тестировании при переходе с УПП на ERP или при перестройке целого зоопарка из пятнадцати систем, приобретенных заводами, в какую-то единую систему.
Речь пойдет о другом случае – когда перед вами стоит задача миграции программного обеспечения. Причем любого ПО: например, замены MS SQL на PostgreSQL, изменения платформы «1С», замены веб-серверов или миграции в облако, когда нужно проверить, как все работает у нового провайдера. Либо вы понимаете, что у вас значительно увеличивается количество пользователей. Даже при увеличении на 20% уже стоит провести тестирование.
Изначальная задача
Перед нами стояла задача выполнить импортозамещение шести высоконагруженных систем в кратчайшие сроки.
Эти шесть систем уже работали: использовалась MS SQL, 1С была установлена на Windows, а веб-серверы – на Internet Information Services. Все работало хорошо, но теперь требовалось все заменить: перейти на Linux и PostgreSQL, а затем протестировать результат. При этом у нас уже была собрана статистика работы систем.
Конечно, все оказалось не так просто.
Первой проблемой были сжатые сроки. У нас оставалось пять месяцев, за которые нужно было провести нагрузочное тестирование и устранить проблемы, чтобы после перехода на импортозамещенный контур система работала по крайней мере не хуже, чем раньше. Желательно лучше, но точно не хуже.
Проблемы функционирования к этому моменту мы уже решили: заменили COM-объекты, которых нет в Linux, устранили прописанные в коде клиентские пути и так далее. Оставалась проблема нагрузочного тестирования.
У нас были совершенно разные конфигурации, причем две из них – самописные. С одной была настоящая беда: в ней не было даже БСП, поэтому ее приходилось встраивать.
Практически у каждой базы была своя инфраструктура. Некоторые системы были очень высоконагруженными и отказоустойчивыми. Где-то использовалась асинхронная репликация, где-то – синхронная. В одних случаях предъявлялись более жесткие требования к резервированию, в других – более свободные, поэтому серверы можно было нагружать не так сильно.
Неоднородность собранных данных. Когда мы подошли к нагрузочному тестированию, выяснилось, что каждую базу администрировали свои специалисты, которые почти не общались друг с другом. Каждый по-своему собирал логи и данные: и технологический журнал, и статистику по базе.
Что было в наличии
Мы занимаемся нагрузочным тестированием уже несколько лет. У нас есть команда из нескольких человек и накоплен определенный инструментарий. Но это не значит, что у нас существует волшебный инструмент, который позволяет решать любые проблемы производительности и проводить нагрузочное тестирование. Важны прежде всего опыт применения тех или иных методик и умение работать с инструментами. Практически у каждой команды экспертов есть такой опыт, и все стараются его систематизировать.
У нас были скрипты и специальное программное обеспечение, в том числе решения, разработанные или адаптированные специально для парсинга технологического журнала. Наши эксперты умели ими пользоваться и понимали, какие данные получат на выходе.
Но к этим инструментам нужен хирург. Если просто передать их другому человеку, ничего хорошего не получится. Скальпелем должен пользоваться хирург, иначе получится не очень эффективный мясник.
У нас также была методика заполнения сценария. Мы понимали, как подготовить сценарий нагрузочного тестирования и провести его.
Инструменты НТ. Для воспроизведения нагрузки использовался наш любимый «1С:Тест-центр», который входит в состав «1С:Корпоративного инструментального пакета», а также JMeter. JMeter был нужен для создания нагрузки на HTTP-сервисы и вообще эмуляции работы интеграций.
На начало проекта у нас было два эксперта. Эксперт – специалист достаточно дорогой и штучный. Как говорил наш руководитель, у нас было «две штуки человек».
Параметры тестов
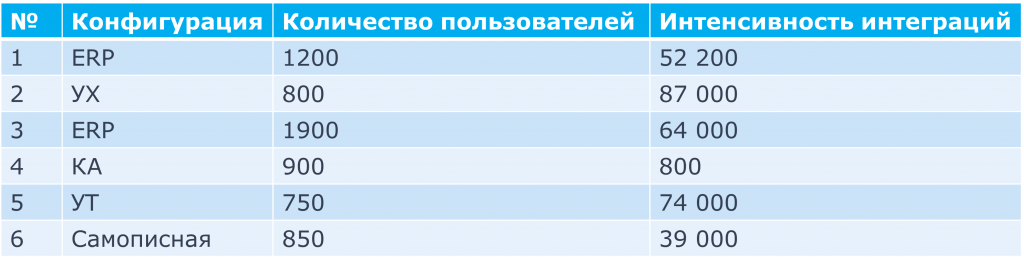
Хочу сделать одну ремарку. Наверное, только в мире 1С принято измерять нагрузку количеством пользователей.
Когда спрашиваешь Java-разработчиков: «А сколько у вас пользователей?», они отвечают: «При чем здесь пользователи? Есть транзакции, операции, запись данных, количество строк. Какая разница, что делает пользователь? Может быть, сотрудница получила документ и два часа его читает».
А у нас нагрузку измеряют в пользователях. При этом пользователи не всегда являются основным элементом нагрузки. Например, в одной из систем было 750 пользователей, но интенсивность интеграции оказалась очень высокой. Именно интеграция создавала значительную нагрузку. К счастью, это была интеграция с HTTP, поэтому для нее у нас был JMeter.
Проблема ресурсов и параллельности
Ресурсы в IT – это прежде всего люди: инженеры уровня junior, middle и senior, эксперты, архитекторы. Неважно, как называется их должность, – это люди.
Вторая проблема – параллельность работы. Когда вы входите в такой проект, вам предлагают привлечь еще несколько экспертов, чтобы они параллельно начали работать над одной базой и быстро завершили проект. Но девять женщин не родят ребенка за один месяц. Работу не всегда можно распараллелить.
Без готового сценария начинать разработку крайне проблематично. Писать тест, не доведя сценарий до конца, будет больно. В «экспертной молодости» я так делал, но больше не буду.
План решения
У нас уже был опыт применения LLM для внутренней автоматизации и создания инструментов для других целей. Поэтому мы начинали не с нуля. Пять месяцев – это не история о том, как мы спросили: «Что такое LLM?», прочитали статью в Википедии и приступили к работе.
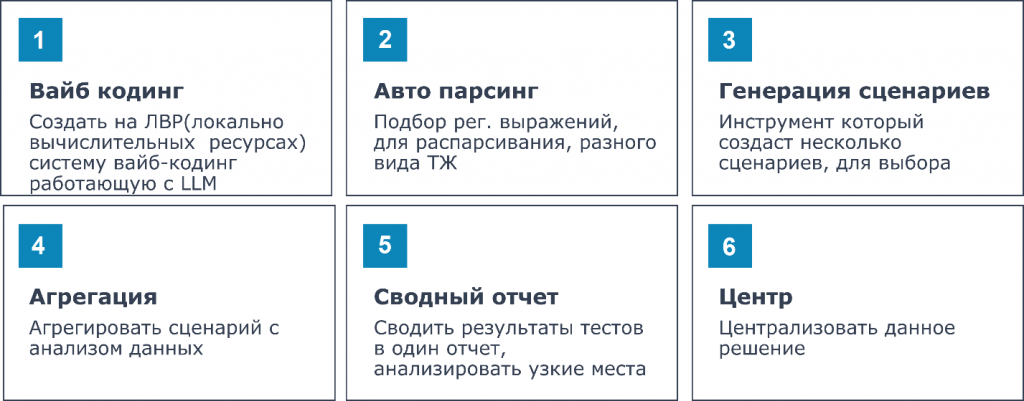
У нас уже было много инструментов, но срок все равно оставался небольшим. Требовалось адаптировать существующую систему и собрать все вместе: использовать вайб-кодинг на локальных вычислительных ресурсах, создать MCP-серверы, связать их с LLM и двигаться дальше.
Мы хотели автоматически распарсить технологический журнал и журнал регистрации, получить данные из базы, сгенерировать и агрегировать сценарий, сформировать сводный отчет по нагрузочному тестированию и централизовать решение.
Нам требовалось определить, как проводить нагрузочное тестирование, провести его и выявить проблемы.
Данные уже существуют. Нужно научиться их использовать
Одна из особенностей платформы 1С заключается в том, что она способна предоставлять огромное количество технической информации о своей работе.
В первую очередь речь идет о двух источниках.
Журнал регистрации содержит сведения о событиях информационной базы: действиях пользователей, изменениях объектов, выполнении отдельных операций и возникающих ошибках.
Технологический журнал позволяет заглянуть глубже – на уровень работы платформы, серверных вызовов, взаимодействия с СУБД, блокировок и других технических событий.
Эти источники дополняют друг друга. Журнал регистрации помогает исследовать активность информационной системы, а технологический журнал – ее техническое поведение.
Добавим к этому показатели производительности серверов, операционной системы и СУБД – и получим весьма богатую основу для анализа.
Но есть сложность: в активно работающей корпоративной системе объем такой информации может исчисляться десятками и сотнями миллионов событий.
А для построения достоверной статистической модели нужно не просто найти отдельные записи. Необходимо исследовать поведение системы во времени, определить закономерности и выделить характерные профили нагрузки.
И здесь на помощь приходят облачные технологии.
Yandex Cloud: от миллионов событий к структурированной статистике
Для работы с большими массивами технических данных в экосистеме Yandex Cloud есть несколько интересных инструментов.
Object Storage – основа для накопления информации
Yandex Object Storage – объектное хранилище с S3-совместимым API.
Оно позволяет хранить большие объемы файлов и программно управлять ими, не разворачивая собственную инфраструктуру хранения.
Для аналитических задач это удобно: можно работать с историческими данными, формировать архивы и сохранять информацию за длительные периоды.
А история здесь действительно важна.
Нагрузка в понедельник утром может заметно отличаться от пятничной. В конце месяца появляются одни операции, в период закрытия отчетности – другие.
Нагрузочный тест, построенный по статистике одного случайного часа, рискует не воспроизвести реальную картину.
Cloud Functions – автоматизация обработки
Yandex Cloud Functions позволяет выполнять программный код в управляемой serverless-среде.
Функции могут запускаться по событиям, например при появлении нового объекта в Object Storage. Платформа самостоятельно управляет вычислительной средой в пределах заданных параметров и ограничений.
Это открывает возможности для автоматизации обработки поступающей технической информации без постоянной эксплуатации отдельных серверов приложений.
С инженерной точки зрения интересен сам принцип: инфраструктура становится событийно-ориентированной, а задачи обработки данных выполняются по мере их поступления.
ClickHouse – аналитика там, где обычных отчетов уже недостаточно
Пожалуй, один из наиболее интересных компонентов – ClickHouse.
Это высокопроизводительная колоночная СУБД, рассчитанная на аналитическую обработку больших массивов данных.
Колоночное хранение, сжатие, параллельное выполнение запросов и эффективные механизмы агрегации позволяют исследовать большие объемы событий с помощью SQL.
Представим, что необходимо выяснить:
-
Какие виды операций выполняются чаще всего?
-
Как меняется интенсивность работы пользователей в течение суток?
-
В какие периоды возникает максимальная активность?
-
Как распределяется длительность технических операций?
-
Какие действия чаще совпадают с пиковыми нагрузками и блокировками?
Это уже не поиск отдельной ошибки в журнале. Это статистическое исследование поведения информационной системы.
Managed Service for ClickHouse в Yandex Cloud позволяет использовать такую аналитическую СУБД без самостоятельного сопровождения всей инфраструктуры кластера.
Самое интересное: построение модели реальной нагрузки
Рассмотрим пример. Предположим, в компании работает 300 пользователей 1С. Какой нагрузочный сценарий будет реалистичным?
Запустить 300 виртуальных пользователей, выполняющих одну и ту же операцию, – довольно сомнительная идея. В реальности у сотрудников разные роли, частота действий и характер операций.
Бухгалтер работает с документами и отчетностью. Менеджер оформляет заказы. Сотрудник склада выполняет операции с товарами. Фоновые задания обрабатывают данные без непосредственного участия пользователей.
Кроме того, существует фактор времени. Утром система может испытывать одну нагрузку, в обед – другую, а в период массового проведения документов – третью.
На основании статистики эксплуатации можно сформировать профиль нагрузки, включающий частоту выполнения различных операций, распределение активности по времени, уровень одновременной работы и характер пиковых периодов.
Особенно важно различать количество подключенных пользователей и количество действительно активных операций.
Для производительности системы это далеко не одно и то же.
Отдельная задача – определение наиболее значимых бизнес-операций. Не все действия одинаково важны и не все создают сопоставимую техническую нагрузку.
Полученная статистика становится основой для проектирования сценариев нагрузочного тестирования.
При этом сами журналы не являются готовой записью пользовательских сценариев. Их данные необходимо сопоставлять с бизнес-процессами, а состав операций и параметры нагрузки – проверять с участием специалистов предметной области.
DataLens – увидеть поведение системы до запуска теста
Цифры в таблицах полезны, но иногда один график способен рассказать значительно больше.
Yandex DataLens позволяет подключаться к ClickHouse и строить интерактивные аналитические панели.
На них можно отображать интенсивность операций, распределение активности по часам, структуру событий, динамику выполнения отдельных действий и другие статистические показатели.
Например, график может показать, что основная пользовательская активность приходится на утренние часы, а определенная категория операций резко увеличивается во второй половине дня.
Или выяснится, что максимальная нагрузка формируется не количеством пользователей, а сочетанием нескольких ресурсоемких процессов.
Такие наблюдения помогают формировать более осмысленные сценарии испытаний.
Вместо абстрактного вопроса «Выдержит ли система 500 пользователей?» появляется гораздо более полезный: «Выдержит ли система характерную для предприятия нагрузку при увеличении ее интенсивности в полтора раза?»
Это уже задача, которую можно поставить, измерить и проверить.
Yandex AI Studio: искусственный интеллект в работе с технической статистикой
Следующий интересный шаг – использование генеративного искусственного интеллекта.
Yandex AI Studio предоставляет инструменты для создания AI-агентов, способных работать не только с текстовыми запросами, но и с внешними источниками данных.
Для подключения инструментов может использоваться открытый протокол MCP (Model Context Protocol).
Его идея заключается в стандартизированном взаимодействии AI-агента с внешними системами, в том числе аналитическими базами данных и корпоративными сервисами.
Представим, что специалист готовит программу нагрузочного тестирования.
Вместо последовательного ручного построения множества отчетов он может поставить интеллектуальному агенту исследовательскую задачу:
«Определи периоды максимальной активности пользователей за последний месяц».
Или:
«Какие операции следует рассмотреть при формировании сценария пиковой нагрузки?»
Или даже:
«Сравни активность системы в обычные рабочие дни и в период закрытия месяца».
При наличии правильно организованного доступа к аналитическим данным агент может помогать формировать запросы, обобщать статистику, выявлять отклонения и подготавливать предварительные выводы.
Разумеется, здесь есть ограничения. Языковая модель может ошибаться в интерпретации данных, а статистическая взаимосвязь сама по себе еще не доказывает причинно-следственную связь.
Поэтому AI-агент – это инструмент ускорения аналитической работы, а не замена инженера по производительности.
Но перспективы такого подхода выглядят весьма интересно.
От статистики – к реальному нагрузочному испытанию
Важно разделять две самостоятельные задачи.
Первая – исследование реальной эксплуатации системы и построение статистически обоснованной модели нагрузки.
Вторая – непосредственное воспроизведение этой нагрузки на испытательном стенде.
Для второй задачи могут применяться специализированные средства, например «Тест-центр» из корпоративного инструментального пакета 1С.
Именно они обеспечивают выполнение пользовательских сценариев, управление виртуальными пользователями и проведение многопользовательских испытаний.
Yandex Cloud и AI Studio в рассматриваемом подходе выполняют другую роль: помогают подготовить качественные исходные данные, определить параметры испытаний и затем проанализировать полученные результаты.
И здесь открывается еще одна возможность.
Если до начала тестирования мы располагаем статистической картиной работы продуктивной системы, то после испытаний можем сравнить ее с фактическими результатами стенда.
Нас будут интересовать не только количество успешно выполненных операций, но и время отклика, его распределение, пропускная способность, загрузка ресурсов, блокировки и стабильность работы при различных уровнях нагрузки.
Особое внимание стоит уделять не только средним значениям, но и высоким процентилям времени выполнения – например, P95 и P99, характеризующим поведение наиболее медленных операций.
Такой подход позволяет оценивать производительность существенно глубже, чем по одному показателю среднего времени выполнения.
Что в итоге получает бизнес?
Нагрузочное тестирование необходимо не ради красивого отчета с графиками.
Оно должно отвечать на вполне конкретные вопросы.
Справится ли система с ростом количества пользователей? Как изменится производительность после обновления платформы или конфигурации? Достаточно ли ресурсов серверов? Какие операции требуют оптимизации? Где находится предел масштабируемости?
И главное – можно ли подтвердить ответы измерениями, а не предположениями?
Использование статистики реальной эксплуатации позволяет сделать нагрузочный тест более обоснованным, а облачные аналитические инструменты помогают работать с необходимым объемом информации.
Автопарсинг
У клиента в каждой базе был собран технологический журнал, но везде по-разному и с разными настройками. Нам требовалось проанализировать все эти журналы и сформировать более-менее удобный отчет, на основе которого можно создать сценарий тестирования. Журнал регистрации, к счастью, везде был одинаковым.
Для начала нужно было попросить LLM проанализировать технологический журнал: определить его настройки и поля, придумать регулярное выражение, обработать с его помощью журнал и вывести нужные данные. Затем таким же образом требовалось проанализировать журнал регистрации.
Для этого мы использовали Cloud Functions. Не забывайте, если можете использовать какую-либо автоматизированную обработку информации, вместо LLM обязательно используйте ее, это бережет Вам токены. Иначе стоимость токенов превысит целый департамент экспертов.
После этого мы могли понять:
-
какие операции выполнялись чаще всего;
-
сколько раз они повторялись;
-
какие пользователи их выполняли;
-
в какие группы входили эти пользователи.
Так мы получали сценарий: пользователи Иванов, Петров и Сидоров выполняют операции один, два, три и четыре в определенной последовательности и с определенной интенсивностью.
Полученные логи нужно было обработать и преобразовать в сценарий. Конечно, результат обязательно должен контролировать эксперт. Пока без мясных специалистов никуда: они управляют процессом, а LLM помогает убрать рутинную работу.
Вайб-кодинг
Мы настроили Docker и MCP-серверы. В качестве рабочей среды использовали Cursor, а работали тогда через Gemini. В результате получали сгенерированный код.
Это позволило подключить к работе middle-разработчиков. Понимая задание, которое дали эксперты, они могли на основании сценария получить заготовки обработок и структуру для «1С:Тест-центра».
Это еще не готовое решение – после генерации его нужно отлаживать. Но 80–90% работы уже сделано. Самое главное – подготовлен и собран сценарий, на основе которого мы генерируем обработки.
На этом этапе работу уже можно распараллелить: выделить на шесть баз шесть middle- или junior-разработчиков, которые с помощью этой технологии начнут разрабатывать тесты.
Для этого у нас были правила и примеры паттернов, которые можно использовать. Например, используй инструменты:
-
При написании кода обязательно проверяй существование используемых встроенных процедур, функций, методов, свойств по документации, используя docsearch.
-
Написанный код обязательно проверяй на наличие синтаксических ошибок, используя syntaxcheck.
-
Если используешь метаданные конфигурации, проверяй их существование и структуру, используя metadatasearch.
-
Если нужно обратиться к существующему коду конфигурации, используй codesearch.
Здесь мы не будем подробно говорить о промпт-инжиниринге. Скажу только, что для нагрузочного тестирования вайб-кодинг действительно требует минимальных усилий.
Само нагрузочное тестирование – сложный продукт и сложное решение. Но обработки, непосредственно выполняющие нагрузочный тест, в 80% случаев достаточно однообразны. У них есть очень четкая последовательность и стандартизация, которую можно описать и проверить: инициализировать данные, обработать их, выполнить с ними определенные действия и записать результаты.
Поэтому вайб-кодинг не создал для нас серьезных проблем и позволил автоматизировать большую часть работы.
Схема работы
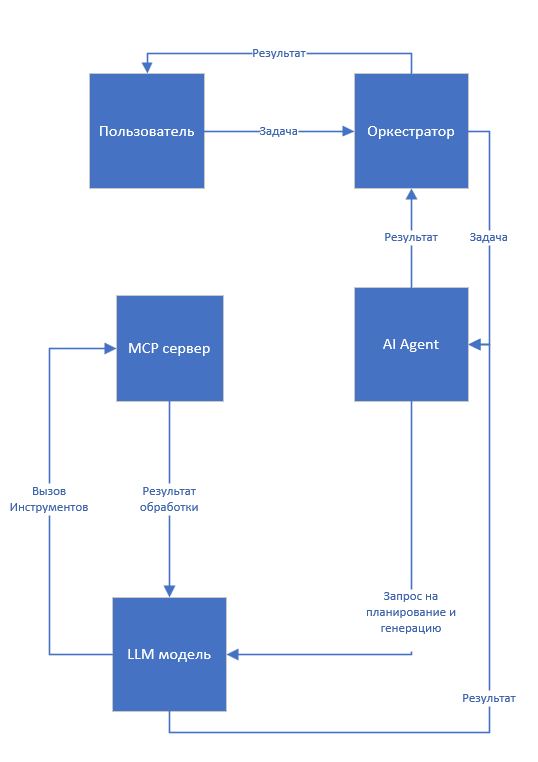
В начале схемы находится оркестратор. Если не считать пользователя, то именно он является сердцем всей структуры.
Оркестратор через AI-агента обращается к инструментам посредством MCP-серверов и выполняет определенные действия. Затем результат возвращается к LLM, обрабатывается, оркестратор запускает следующий цикл – и так продолжается, пока действие не будет завершено.
Рассмотрим пример. У нас есть технологический журнал объемом 100 ГБ. Это 100 ГБ текста, и ни одна LLM не сможет обработать его целиком.
Но мы можем передать ей структуру технологического журнала, пример данных, правила обработки и описание результата, который хотим получить на выходе. Затем попросить ее написать регулярное выражение для парсинга.
LLM создает регулярное выражение, с помощью которого можно распарсить технологический журнал и привести данные к нужному виду. Но сама модель никуда не пойдет, не нажмет кнопку и ничего не запустит. Для этого ей нужны MCP-серверы – ее «руки».
С их помощью запускается скрипт, который анализирует 100 ГБ логов. В результате мы получаем агрегацию, которую можно соединить с журналом регистрации и определить, какие действия выполнял каждый пользователь.
Так мы понимаем, что пользователи Иванов, Петров и Сидоров, относящиеся к определенной группе, являются инициаторами конкретных событий. Уже получается готовый сценарий. Мы также знаем, сколько раз происходило каждое событие и с какими интервалами. Точно так же можно получить сведения об интеграциях и других операциях.
Вам не нужно наполнять базу данных, как при классическом нагрузочном тестировании, и не нужно генерировать данные – они уже есть.
Единственное, что я всегда прошу делать при использовании LLM, – обезличивать данные. У меня есть такая возможность, потому что не требуется анализировать живые данные. Мы обезличиваем базу и уже на нее накатываем изменения.
Можно создать промежуточную базу, чтобы вы понимали, что значение X-17 на самом деле означает, например, Николаеву Петровну. Но если такой необходимости нет, базу достаточно обезличить. После этого обезличенные данные можно загружать куда угодно.
Сначала мы передавали технологический журнал, парсили его и получали агрегацию. Затем соединяли результат с журналом регистрации и получали сценарий действий. После этого анализировали данные и определяли, какие документы необходимо подставлять.
Так формировался сценарий. На его основе уже можно понять, какие обработки и для каких ролей требуется написать.
Где-то использовалось RLS, где-то его не было. Работу с RLS автоматизировать пока не получилось, ее пришлось выполнить вручную.
После этого мы создавали обработки для «1С:Тест-центра», и здесь нам помог вайб-кодинг.
Кроме того, LLM очень неплохо справилась с генерацией HTTP-запросов для JMeter. Она определила сценарий и данные, которые нужно передавать в HTTP-запросах к 1С. Это действительно очень помогло. С кодом в 1С ситуация была сложнее, а для JMeter мы получили практически готовые настройки.
Сами тесты запускали вручную, без LLM. Иногда с помощью тех же инструментов анализировали результаты – скорее для эксперимента. Времени у нас осталось достаточно много: сначала мы боялись, что не успеем, но справились раньше срока.
Схема, к которой сейчас идем
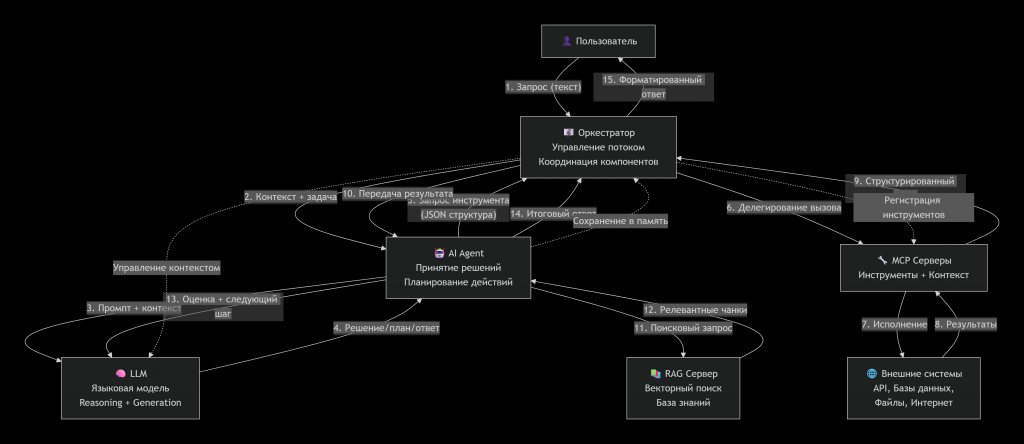
В итоговой схеме в центре находится оркестратор. Сейчас мы также используем RAG, чтобы уточнять некоторые моменты.
Когда мы узнали о RAG, то сначала не поняли, как применять его для наших целей. Позже выяснилось, что он позволяет очень хорошо решать некоторые задачи, опираясь на наш накопленный опыт.
Мы продолжаем расширять и дорабатывать инструментарий, чтобы автоматизировать процессы. Автоматизируется прежде всего рутина, одновременно накапливается база знаний.
Но хотя я говорил, что в центре схемы находится оркестратор, на самом деле в центре остается эксперт. Именно он должен завершить эту работу.
На первых этапах у нас часто формировался неправильный сценарий, потому что мы неверно соединяли технологический журнал и журнал регистрации. Ошибок было достаточно много, и их подробное перечисление заняло бы много времени.
Важно понимать, что в таком проекте придется дорабатывать большое количество инструментов. К счастью, многие из них можно найти в готовом виде. Уже существует множество решений, которые позволяют заполнять сценарии в документах Word или генерировать события в JMeter.
Пример как работает наша модель
Итак….
Да, для удобства обычный телеграм-бот, хотя под капотом очень сложная система.
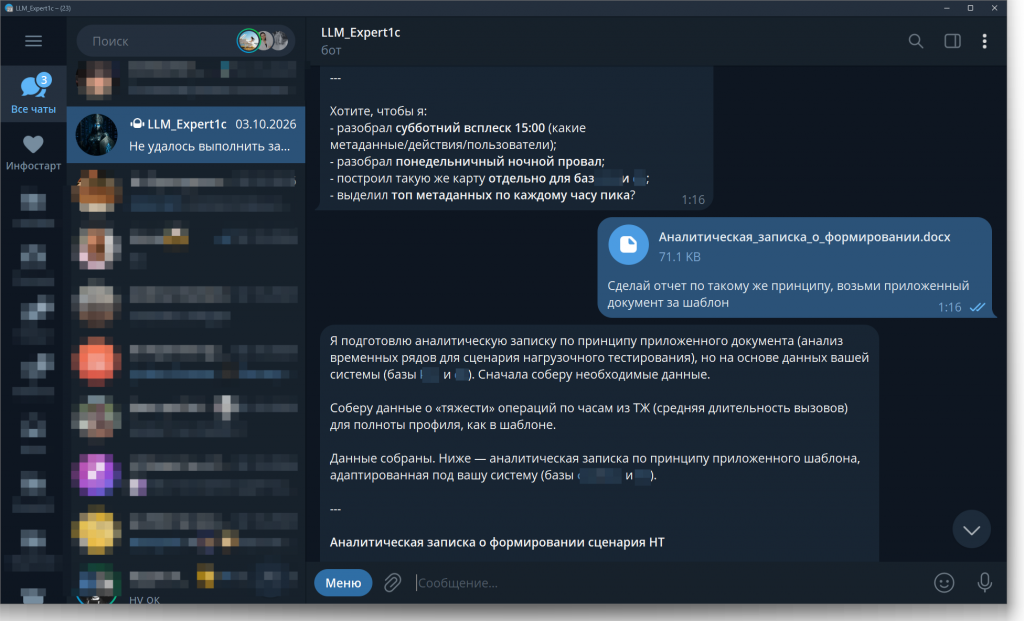
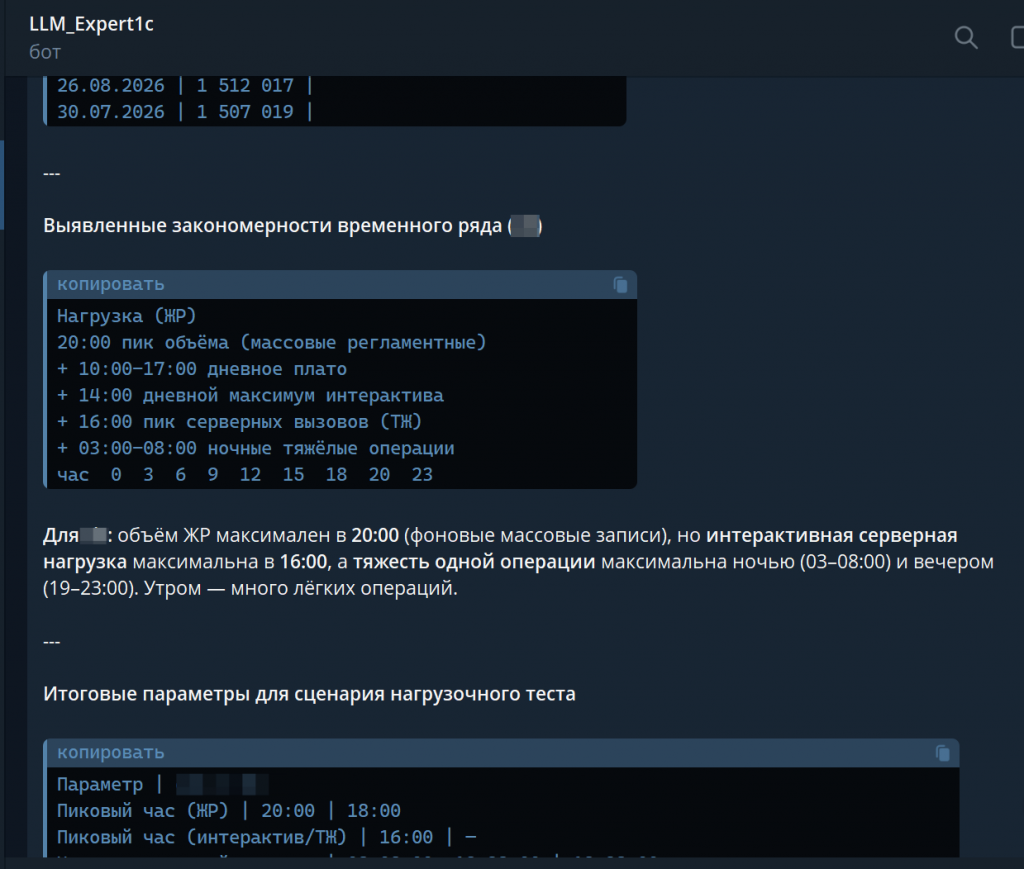
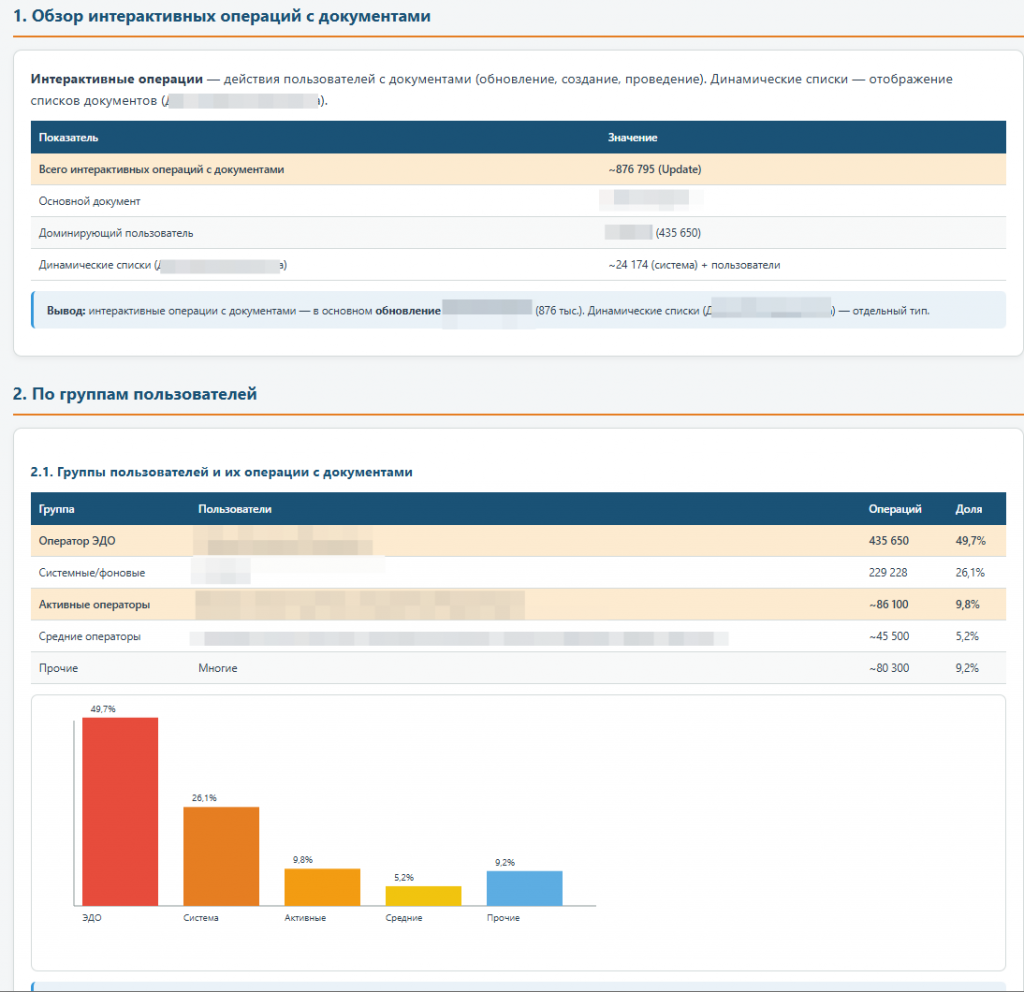
Конечно, так читать неудобно, поэтому можно попросить делать это в HTML и будет так:
Дальнейшее развитие
У нас сформировались планы развития на ближайший год.
Часть этих действий можно было выполнить и без LLM. Подобные решения уже существуют. Но использование LLM многое дало нам для развития.
Изначально решение с нейросетью вообще использовалось для другой задачи – нормализации базы. Однако именно оно дало сильный толчок работе над автоматизацией нагрузочного тестирования.
Следующий этап – формирование полноценного сценария и базы данных, полностью подготовленной к тесту. Это понадобится, например, при переходе с УПП на ERP.
Мы думаем, как преобразовывать данные для таких случаев, потому что здесь все не так просто. Обычного технологического журнала будет недостаточно: он относится к УПП, а что будет происходить в ERP, мы еще не знаем.
До начала тестирования нужно определить, как выявлять эти моменты и каким образом описание бизнес-процессов поможет создать сценарий. Потребуется анализировать исходные данные и преобразовывать их в данные будущей системы.
Еще одна задача – научить систему запускать тесты. Конечно, не самостоятельно, потому что LLM – это всего лишь чат, но она сможет делать это с помощью инструментов.
Мы также планируем автоматизировать разбор проблем.
Пока мы анализировали с помощью LLM планы запросов, но скорее в тестовом режиме. На тот момент система иногда придумывала некоторые детали, поэтому работать с ней было сложно.
Во время первого прохода она могла предложить простую оптимизацию: например, переписать запрос. Это помогало, но речь шла о действительно элементарной ошибке. Когда возникали более сложные проблемы, модель начинала придумывать отдельные моменты. К счастью, таких проблем было немного. Мы привлекли третьего эксперта и разобрали их втроем.
Размышляя о будущем
Скорее всего, требования к специалистам просто вырастут. Знание систем искусственного интеллекта пока не заменит людей – по крайней мере, это мое мнение. Но оно станет обязательным требованием.
Вспомните, как в двухтысячных годах в вакансиях отдельно писали: «знание ПК», «знание Excel», «знание Word». Позже стали добавлять: «Если не знаете – обучим». А затем об этом вообще перестали писать. Стало очевидно, что человек, который приходит на работу, умеет пользоваться компьютером.
С системами искусственного интеллекта нас ждет то же самое. Если к 2030 году вы скажете, что не знаете, как пользоваться вайб-кодингом или AI-напарником, вас, скорее всего, спросят: «Как так получилось?» Это инструмент, который в дальнейшем станет частью повседневной работы.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

