Почему перезапуск rphost по памяти в 1С приводит к обрыву фонового задания без ошибки в журнале
База данных - Администрирование СУБД
- Объект настройки: рабочий процесс rphost в составе кластера 1С:Предприятие 8.3, не отдельный сервер СУБД.
- Параметры кластера: SafeMemoryUsageBuffer, MemoryLimit, RestartProcessAtMemoryExcess, количество рабочих процессов на узле.
- Ограничения: учёт памяти ОС, лимит на процесс, поведение при превышении без аварийного дампа платформы.
- Зависимости: число ИБ на rphost, длительные фоновые задания, размер кэша метаданных и временных таблиц запроса.
- Контроль: журнал кластера, счётчики процесса, события перезапуска rphost, состояние регламентного задания в базе «УправлениеТорговлей_КопияОбмен» (пример имени).
Пользователь уверен, что ночной обмен с WMS обрывается из-за «сети или блокировок в SQL», потому что в журнале регистрации нет текста исключения, а на сервере приложений память «ещё не кончилась».
На практике менеджер кластера rmngr может завершить конкретный rphost по внутреннему лимиту памяти раньше, чем администратор увидит нехватку RAM на хосте. Сеанс фонового задания обрывается, платформа не всегда успевает записать привычное сообщение об ошибке в журнал регистрации той базы, где шло задание.
Параметры
Настройки задаются на уровне кластера и рабочего сервера в консоли администрирования серверов 1С или через утилиту rac/ras. Значения по умолчанию зависят от версии платформы; ниже приведены типовые имена полей, которые проверяют в первую очередь.
- SafeMemoryUsageBuffer: порог «мягкой» защиты, килобайты рабочей памяти процесса rphost. При стабильном превышении rmngr инициирует перезапуск этого процесса, сеансы переподключаются к другим rphost или поднимаются заново.
- MemoryLimit: жёсткий предел памяти рабочего процесса (если поле доступно в вашей консоли). Срабатывание ближе к аварийному завершению, чем у буфера.
- RestartProcessAtMemoryExcess: признак, разрешён ли автоматический перезапуск по превышению памяти (на части стендов включён по умолчанию).
- Количество рабочих процессов на узле: при малом числе rphost перезапуск одного экземпляра задевает больше информационных баз, смонтированных на этот процесс.
- Интервал перезапуска по числу вызовов (отдельный механизм): не путать с памятью; при совместной настройке ночной простой может совпасть с двумя причинами перезапуска.
Где смотреть текущие значения: свойства кластера, затем рабочий сервер, затем список рабочих процессов; для скриптов эксплуатации дублируют вывод rac cluster info и rac process list.
Пример ориентира для стенда с 32 ГБ RAM на узле приложений: один rphost и SafeMemoryUsageBuffer около 4 ГБ (в kilobytes в API rac, например 4194304) часто даёт ночной запас под регламент, но не спасает при двух тяжёлых базах на одном pid. Число приведено как иллюстрация порядка величины, не как норматив.
| Поле | Единица в консоли | Что фиксировать при инциденте |
|---|---|---|
| SafeMemoryUsageBuffer | КБ | Значение до изменения и время изменения |
| MemoryLimit | КБ или выкл. | Сработал ли жёсткий предел |
| pid rphost | число | Менялся ли pid в окно обрыва регламента |
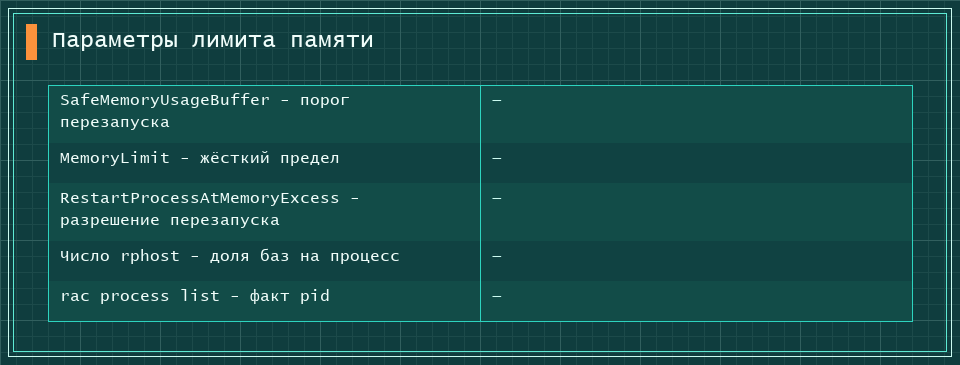
Параметры памяти rphost и где их смотреть
Ограничения
Лимит памяти rphost считает не «свободную память сервера», а память конкретного процесса в модели платформы. Диспетчер задач Windows или free на Linux показывают картину хоста целиком, поэтому визуальное «ещё 12 ГБ свободно» не отменяет перезапуск одного rphost.
- Перезапуск процесса не равен перезапуску службы агента кластера: ragent продолжает работать, меняется только pid rphost.
- Журнал регистрации 1С не является журналом кластера: событие перезапуска ищут в каталоге логов агента (путь задаётся при установке службы) и в технологическом журнале при включённых фильтрах по процессу.
- Фоновое задание, выполнявшееся в оборванном сеансе, может остаться в состоянии «выполняется» до таймаута планировщика или ручной отмены, если регламент не обрабатывает обрыв.
- Увеличение SafeMemoryUsageBuffer без добавления rphost отодвигает проблему и увеличивает длительность простоя при последующем перезапуске того же pid.
- На одном rphost несколько тяжёлых ИБ делят один и тот же потолок памяти: лимит задаётся на процесс, не на базу.
- Командная строка запуска rphost наследует лимиты кластера: локальные правки без rac не переживают пересоздание процесса менеджером.
Зависимости
Частота срабатывания лимита растёт, когда на одном рабочем процессе совмещают интерактивную нагрузку и длительные регламенты с большими выборками.
- Монтирование ИБ: чем больше информационных баз назначено на один rphost, тем выше базовое потребление памяти из-за кэшей и сеансов.
- Фоновые задания с отчётами и обменами через временные таблицы: пик памяти может приходиться на 02:00-04:00, когда интерактивных пользователей нет, но rphost уже на пределе буфера.
- Разрядность и версия платформы: профиль памяти 32-разрядного rphost принципиально уже; на таких узлах лимит срабатывает при меньших абсолютных числах.
- СУБД на том же хосте: конкуренция за RAM усиливает давление на ОС, но решение «разнести SQL» не отменяет перезапуск rphost по SafeMemoryUsageBuffer.
- Резервное копирование средствами 1С в сеансе сервера: кратковременные пики памяти могут совпасть с регламентом обмена.
- Веб-сервисы и HTTP-сервисы на том же rphost: внешние вызовы добавляют одновременные сеансы и ускоряют рост рабочего набора.
# Список кластеров (порт агента 1540 или 1545 уточните на стенде)
rac cluster list localhost:1545

# Свойства кластера: ищите safe-memory-usage-buffer, memory-limit
rac cluster info --cluster=<uuid> localhost:1545

# Процессы: pid, использование памяти в выводе rac
rac process list --cluster=<uuid> localhost:1545

# Пример изменения буфера (4194304 КБ = 4 ГБ, проверьте единицы)
rac cluster update --cluster=<uuid> --safe-memory-usage-buffer=4194304 localhost:1545

# Технологический журнал: фрагмент logcfg.xml (имена событий уточняйте по документации)
<log location="D:\1cv8\logs" history="24">
  <event>PROC</event>
  <property name="all"/>
</log>
Частные случаи
Ниже перечень ситуаций, когда перезапуск по памяти выглядит «без причины». У каждого пункта указано следствие для эксплуатации.
- На rphost смонтированы «ОбменОстатками» и «ОтчётностьЦентр», ночью параллельно стартуют два регламента с большими временными таблицами. Следствие: падает только одно задание, второе может успеть завершиться; в журнале регистрации пусто, в списке фоновых висит «выполняется».
- SafeMemoryUsageBuffer оставлен по умолчанию, а на сервере 64 ГБ RAM и один rphost на все базы филиалов. Следствие: перезапуски редки днём и регулярны ночью; администратор SQL не видит блокировок.
- После обновления платформы включён RestartProcessAtMemoryExcess, раньше процесс мог работать на большем рабочем наборе. Следствие: «новая» нестабильность обмена без изменений в конфигурации 1С.
- Интерактивный пик (утро понедельника) совпал с регламентом «ПересчётСебестоимости» на том же rphost. Следствие: обрываются интерактивные сеансы пользователей склада с сообщением о потере связи, фоновое задание отменяется платформой.
- Администратор поднял буфер до 8 ГБ, но MemoryLimit на уровне ОС или политики ниже. Следствие: процесс завершает ОС или служба мониторинга раньше, чем сработает «мягкий» перезапуск rmngr; в логах другая формулировка события.
- На узле два rphost, базы распределены неравномерно: «ТяжёлаяИБ_ERP» одна на первом процессе. Следствие: перезапуски цикличны только у pid первого rphost, второй не затрагивается; ошибочно подозревают «битую базу».
Контроль
Выполните проверку в порядке от кластера к регламенту в базе. Фиксируйте время UTC и локальное, если фоновые задания привязаны к часовому поясу сеанса.
- Сопоставьте время обрыва задания «ВыгрузкаНоменклатурыВСкладскуюСистему» с событием перезапуска rphost в логах кластера (не в журнале регистрации).
- Снимите rac process list до и после ночного окна: изменился pid у rphost, на котором смонтирована проблемная ИБ.
- На Windows проверьте счётчик Private Bytes и Working Set для rphost.exe в момент регламента; на Linux смотрите RSS процесса rphost в цикле каждые 60 секунд, например через pidstat.
- В консоли кластера откройте список сеансов и фоновых заданий проблемной базы: после перезапуска возможен «висящий» сеанс с пустым пользователем.
- Зафиксируйте текущие SafeMemoryUsageBuffer и число rphost; повторите замер после изменения только одного параметра.
- Убедитесь, что регламентное задание идемпотентно: повторный запуск после обрыва не создаёт дублей документов «ПеремещениеТоваров».
- Сравните нагрузку по базам: rac session list по проблемной ИБ в окно регламента покажет, оставались ли параллельные сеансы пользователей.
Если перезапуски участились после релиза отчёта с запросом на 200000 строк, сначала разнесите регламент на отдельный rphost или уменьшите параллелизм заданий, затем корректируйте буфер памяти.
После разнесения баз по двум rphost повторите ночной прогон регламента три дня подряд и сохраните график RSS: стабильный pid и отсутствие скачка к порогу подтверждают, что причина была в совмещении нагрузок, а не в «случайной сети».
План изменений зафиксируйте в регламенте эксплуатации: кто меняет SafeMemoryUsageBuffer, кто проверяет pid после ночи, какой порог RSS считается нормой для вашего узла. Без этой фиксации следующий администратор снова увеличит буфер «на глаз» и вернёт длинные простои при перезапуске.
При обращении в поддержку платформы приложите вывод rac cluster info, два снимка rac process list с разным pid и фрагмент лога ragent за пять минут до обрыва: этого достаточно, чтобы отделить перезапуск по памяти от обрыва соединения с PostgreSQL или MS SQL.
Команды для копирования
# Список кластеров на агенте
rac cluster list localhost:1545

# Свойства кластера
rac cluster info --cluster=XXXXXXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX localhost:1545

# Процессы кластера
rac process list --cluster=XXXXXXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX localhost:1545

# Сеансы информационной базы
rac session list --cluster=XXXXXXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX --infobase=<uuid> localhost:1545

# Информационные базы и привязка к рабочим процессам
rac infobase summary list --cluster=XXXXXXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX localhost:1545

# Linux: RSS rphost раз в минуту (пример pid 12345)
while sleep 60; do ps -o pid,rss,cmd -p 12345; done

# Linux: pidstat по процессу rphost
pidstat -r -p 12345 60

# Windows: счётчики процесса (PowerShell)
Get-Process rphost | Select-Object Id,WorkingSet64,PrivateMemorySize64
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

