Снять параллельный pg_dump -Fc, не останавливая пользователей
База данных - Администрирование СУБД
- Объект: кластер 1С:Предприятие 8.3, СУБД PostgreSQL 14+, база прикладная «erp_prod» (~420 ГБ в каталоге PGDATA).
- Цель: ежесуточная логическая копия в custom-формате (-Fc) с параллельными потоками (-j) без остановки rphost и без перевода базы в монопольный режим.
- Ответственный: администратор СУБД совместно с администратором кластера 1С.
Дано: резервное окно 90 минут; средняя длительность однопоточного pg_dump около 140 минут; допустимый рост WAL за окно не более 35 ГБ; каталог приёма копий /backup/1c/erp_prod/daily/ на отдельном томе; проверка восстановления выполняется на стенде restore-check, не на продуктиве.
1. Область применения
1.1. Настоящий порядок распространяется на логическое резервное копирование прикладной базы 1С, размещённой в PostgreSQL, когда однопоточный pg_dump не укладывается в регламентное окно и при этом запрещается останавливать рабочие процессы кластера для «тишины» в базе.
1.2. Параллельный pg_dump с ключом -j создаёт несколько потоков чтения; для формата -Fc допустимы значения j от 2 до 8 inclusive, если число vCPU на узле СУБД не меньше j+2 (резерв под autovacuum, checkpoint и фоновые сессии 1С).
1.3. Порядок не заменяет физическое резервирование (pg_basebackup, снимки СХД) и не покрывает выгрузку .dt через конфигуратор; он дополняет существующую схему хранения копий и не отменяет отдельный регламент проверки pg_restore на стенде.
1.4. Требование согласованности: все worker-процессы pg_dump должны участвовать в одном снимке данных (единый snapshot транзакции REPEATABLE READ). Иначе при восстановлении возможны расхождения остатков между регистром «ТоварыНаСкладах» и регистром «СебестоимостьТоваров» на границе момента снятия копии.
1.5. Запрещается повышать -j выше 8 без измерения p95 блокировок pg_stat_activity.wait_event_type = Lock в окне дампа; для типовых ERP-объёмов на SATA SSD рекомендуемое стартовое значение j=4.
1.6. Формат -Fc (custom) обязателен: plain-текстовый дамп не поддерживает параллельную запись в один файл и не допускает выборочный pg_restore по таблицам на restore-check.
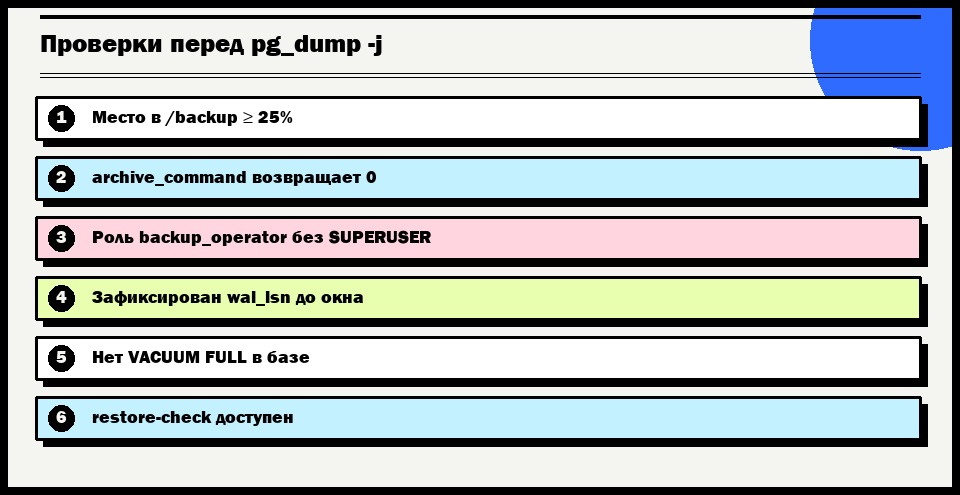
Контрольный перечень перед запуском параллельного pg_dump
2. Последовательность работ
2.1. За 15 минут до окна проверьте, что на узле СУБД свободно не менее 25% места в /backup и что в pg_stat_activity отсутствуют сессии с query, содержащим VACUUM FULL, по таблицам прикладной базы.
2.2. Зафиксируйте исходные параметры, влияющие на длительность дампа: max_parallel_workers_per_gather (по умолчанию 2), maintenance_work_mem (по умолчанию 64MB), max_wal_size (по умолчанию 1GB в PostgreSQL 14); изменения вносятся только по согласованию с владельцем регламента эксплуатации.
2.3. Запуск выполняется от учётной записи ОС postgres; подключение к базе erp_prod под ролью backup_operator с правом SELECT на все прикладные таблицы и без атрибута SUPERUSER.
2.4. Перед первым промышленным запуском создайте индексный файл backup_inventory.csv с полями: stamp_utc, jobs, bytes, sha256, wal_delta_bytes, exit_code, restore_list_ok.
2.5. Убедитесь, что archive_mode=on и archive_command возвращает 0 для тестового сегмента WAL; иначе рост журнала во время длительного pg_dump может заполнить том pg_wal раньше срабатывания checkpoint.
2.6. Базовая команда запуска (имя файла включает метку UTC и число потоков):
export PGDATABASE=erp_prod
export JOBS=4
export STAMP=$(date -u +%Y%m%dT%H%MZ)
export OUT=/backup/1c/erp_prod/daily/erp_prod_${STAMP}_j${JOBS}.dump
pg_dump -Fc -j "${JOBS}" -f "${OUT}" \
  --no-owner --no-privileges \
  --verbose 2>&1 | tee "/var/log/1c-backup/pg_dump_${STAMP}.log"
2.7. Для PostgreSQL 15+ при высокой параллельной записи документов «РеализацияТоваровУслуг» допускается добавление ключа синхронизации снимка между worker-процессами (см. release notes pg_dump для --snapshot); без единого snapshot pg_restore --list покажет разные метки в секциях TABLE DATA.
2.8. В окне дампа запрещается запускать реиндексацию типовых регистров через reg-task 1С и операции TRUNCATE в технических таблицах обмена; такие работы переносятся в соседнее окно обслуживания.
2.9. По завершении с кодом 0 выполните pg_restore --list на том же файле; убедитесь, что количество секций TABLE DATA совпадает с эталоном backup_inventory.baseline_sections (фиксируется после первого успешного цикла).
2.10. Файл передаётся в каталог immutability (WORM или версионирование объектного хранилища) только после sha256 и записи restore_list_ok=Y в backup_inventory.
2.11. Параллельный pg_dump не блокирует INSERT/UPDATE в 1С на уровне AccessShareLock, но увеличивает IO wait у rphost; при росте APDEX интерактива ниже согласованного порога окно следующей ночи сдвигается на 45 минут.
3. Проверки результата
3.1. Минимальный набор контролей в момент завершения pg_dump:
- размер файла .dump не меньше 70% от среднего за последние 7 успешных суток (отклонение трактуется как неполный дамп);
- в логе /var/log/1c-backup/ отсутствуют строки ERROR после «dumping contents of table» и повторяющиеся «canceling statement due to lock timeout»;
- счётчик pg_stat_database.xact_commit для datname=erp_prod после дампа продолжает расти (кластер 1С обслуживает интерактив).
3.2. Еженедельно на restore-check выполняется частичное восстановление: pg_restore -j 2 -d erp_prod_rc --section=pre-data --section=data для ограниченного набора таблиц (_AccOpt, _Reference2617, _AccumRg52891) и сверкой COUNT(*) с продуктивом на момент снимка; допустимая погрешность 0 строк.
3.3. Раз в месяц выполняется полное восстановление в изолированную базу erp_prod_full_rc на отдельном томе с последующим запуском 1С в режиме «Только администрирование» и проверкой открытия журнала документов «КорректировкаРеализации» за последний закрытый день.
3.4. Метрики для мониторинга (экспорт в Prometheus или Zabbix):
- backup_pg_dump_duration_seconds (пример порога: 5100);
- backup_pg_dump_wal_bytes_delta за окно (пример порога: 37580963840);
- backup_pg_dump_exit_code (0/1);
- backup_pg_dump_jobs (фактическое j).
3.5. Порог оповещения: duration > 85 минут при j=4 или wal_bytes_delta > 40 ГБ; повторный параллельный запуск в ту же ночь запрещается без разбора pg_locks и журнала регистрации 1С на предмет длительных блокировок.
3.6. Срок хранения daily-копий в /backup/1c/erp_prod/daily/: не менее 14 суток на диске и не менее 45 суток в объектном хранилище; старше удаляется только при наличии более свежей weekly-копии с restore_list_ok=Y.
3.7. Таблица соответствия длительности и j ведётся в backup_inventory; при трёх подряд успешных ночах с duration < 60 минут допускается эксперимент j+1 на следующей неделе с обязательным откатом при первом превышении порога WAL.
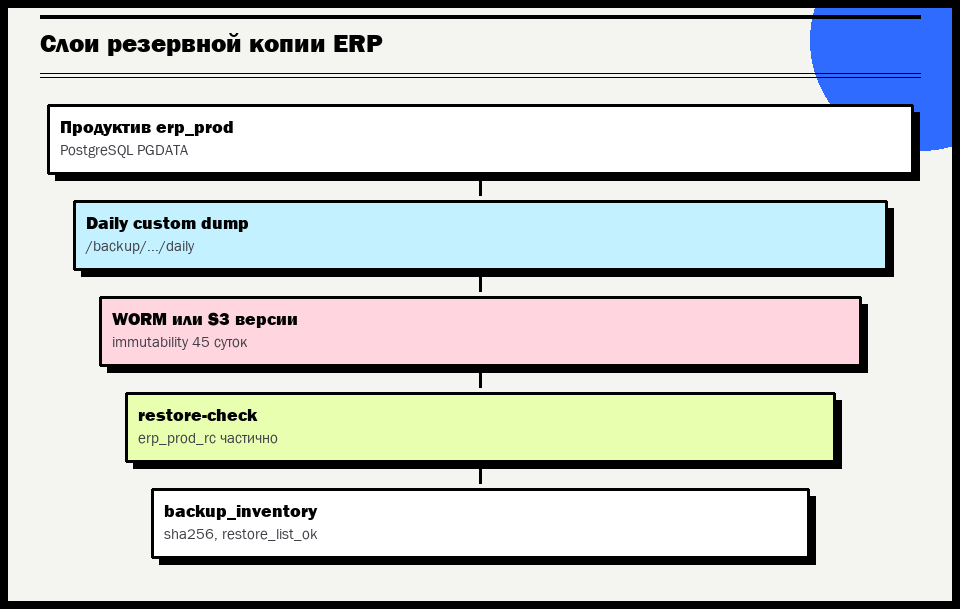
Уровни хранения логической копии и проверки
Что обычно уточняют
Количество потоков -j не равно ускорению в j раз: узкое место часто оказывается дисковая подсистема PGDATA и одновременная запись журнала WAL, а не CPU. На практике прирост от j=2 к j=4 укладывается примерно в 1,6-1,9 раза при NVMe; дальнейшее увеличение даёт contention на pg_catalog и рост длительности ожидания AccessShareLock на горячих таблицах документов.
Ключ --no-owner при pg_dump для 1С остаётся обязательным для переносимости на restore-check, но он не снимает требование роли с правами на чтение служебных таблиц платформы. Ошибка permission denied for table _InfoRg184726 в одном worker-потоке обрывает весь параллельный дамп с ненулевым кодом, хотя остальные потоки могли уже записать сотни гигабайт в файл .dump.
Параллельный дамп не освобождает от политики хранения и не отменяет dt-выгрузку перед крупным обновлением конфигурации.
4. Реагирование на отказ
4.1. При коде выхода pg_dump, отличном от 0, файл .dump с неполной записью подлежит немедленному перемещению в /backup/1c/erp_prod/quarantine/; восстановление из него запрещается, в backup_inventory проставляется restore_list_ok=N.
4.2. Если в логе зафиксирован deadlock между pg_dump worker и сессией 1С на таблице _DocumentJournal39412, выполните один повтор с j=2 и сдвигом окна на 30 минут; второй отказ эскалируется владельцу информационной базы и фиксируется в журнале инцидентов.
4.3. При переполнении каталога pg_wal во время дампа (симптом: число файлов WAL растёт выше ожидания от max_wal_size без успешного archive_command) приостановите pg_dump SIGINT, дождитесь checkpoint, проверьте место на томе pg_wal и работоспособность архивации, затем назначьте новое окно.
4.4. Если pg_restore --list на свежем файле показывает разные snapshot для секций TABLE DATA, копия помечается logically inconsistent; в ближайшем резервном окне запускается однопоточный pg_dump -Fc без -j под ionice -c3 -n7.
4.5. При ошибке «could not read block» в логе pg_dump инициируется проверка аппаратной целостности RAID и fsck только на стенде; повтор дампа на продуктиве без устранения причины запрещается.
4.6. После любого сбоя обновите backup_inventory полями failure_reason, wal_delta_gb, peak_connections_1c, max_wait_event; отчёт направляется ответственному за кластер 1С в течение одного рабочего дня без остановки пользователей на продуктиве.
4.7. Если сбой совпал с плановым обновлением платформы 1С, приоритет имеет восстановление штатного окна pg_dump после обновления; отложенный дамп не заменяется снимком VM без записи в backup_inventory о пропуске логической копии.
Команды для копирования
# Проверка snapshot в custom-дампе (фрагмент списка)
pg_restore --list /backup/1c/erp_prod/daily/erp_prod_EXAMPLE_j4.dump | head -n 40

# WAL до и после окна (разница в байтах)
psql -d erp_prod -Atc "SELECT pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0');"

# Активные блокировки во время дампа
psql -d erp_prod -c "SELECT pid, wait_event_type, wait_event, query FROM pg_stat_activity WHERE datname='erp_prod' AND wait_event IS NOT NULL;"

# Частичная проверка на restore-check
createdb erp_prod_rc
pg_restore -j 2 -d erp_prod_rc --section=pre-data --section=data \
  --table=public.\"_AccOpt\" /backup/1c/erp_prod/daily/LATEST.dump

# Контрольная сумма перед WORM
sha256sum /backup/1c/erp_prod/daily/LATEST.dump >> /backup/1c/erp_prod/backup_inventory.sha256

# Однопоточный fallback
pg_dump -Fc -f /backup/1c/erp_prod/daily/erp_prod_fallback.dump \
  --no-owner --no-privileges erp_prod
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

