Что проверить в выводе метрик кластера 1С для Prometheus до выпуска: promtool, CRLF и ловушки самопроверок
База данных - Администрирование СУБД
Если вы готовите НТТР-вывод метрик кластера 1С для Prometheus, вся памятка сводится к одному: экспортёр, text exposition format и проверка до выпуска через promtool, а не к отчёту «у меня всё зелёное». Regex по вашему же выводу совпадёт с тем, что отдаёт экспортёр, но парсер Prometheus при scrape может отбросить весь ответ - тогда в TSDB не будет ни одного sample. На пустом тестовом кластере Grafana покажет пустые панели, алерты сработают не там, где ждёте.
Prometheus и метрики кластера 1С - зачем отдельный вывод
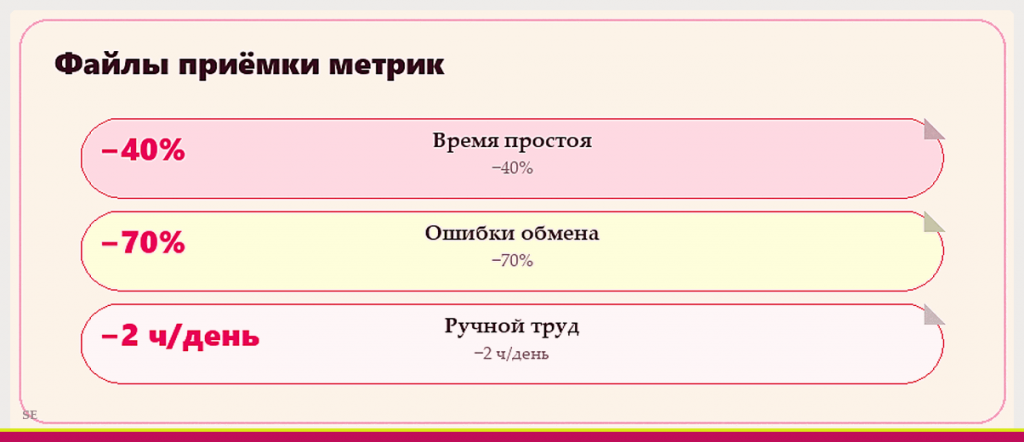
Журнал регистрации и технологический журнал отвечают на «что было», консоль кластера - на «сейчас», без долгой памяти. Prometheus хранит временные ряды: когда память rphost начала расти, как менялась очередь сеансов, с чем на одном экране сравнить диск СУБД. У многих команд 1С на общем дашборде инфраструктуры как раз не хватает этого слоя; внешний экспортёр, который опрашивает кластер через rac и RAS, кладёт метрики кластера 1С в тот же стек, что уже крутится у админов.
Scrape по расписанию пишет samples в TSDB, Grafana читает уже из базы, а не «напрямую с кластера». Парсер отверг документ на первом же target - и история обрывается с первого дня, график так и останется плоским. Перед выпуском я смотрю на вывод так же, как Prometheus при scrape: важно, попадут ли samples в TSDB, а не только то, что порт ответил.
Готовый мост «метрики кластера 1С в Prometheus и Grafana» на маркетплейсе - лишь один из вариантов; здесь речь про приёмку вывода, не про каталог решений. Даже без развёрнутого Prometheus те же ошибки формата и самообман зелёных проверок остаются.
На рисунке - как я раскладываю артефакты вокруг экспортёра: живой НТТР-вывод, файл для textfile collector, эталон в репозитории и promtool как «читатель по умолчанию» для приёмки. Эталон в git удобно смотреть в diff, а promtool читает байты: изR09;за этого CRLF в *.prom в CI проходит незаметно. На Linux CRLF чаще прилетает из Git или редактора, а не из генератора строк на Python или Go без AppendLine.
Text exposition format - критерий «настоящего» читателя
Вывод метрик для Prometheus - текст с семействами (# HELP, # TYPE), самрле-строками и метками. В спецификации exposition format между строками только LF; парсер требует это жёстко. После правки генератора на Windows проверьте diff и .gitattributes: autocrlf снова подставит \r\n в *.prom.

Контекст: Text exposition format - критерий «настоящего» читателя
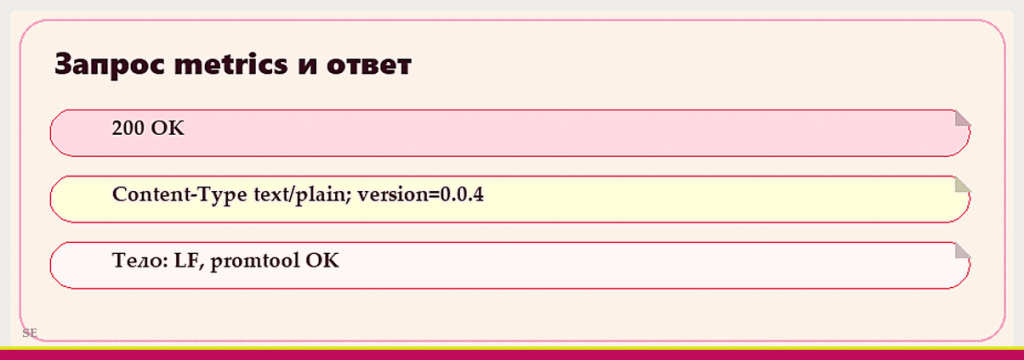
Перед релизом прогоняйте тот же байтовый поток через promtool check metrics, что увидит target. Полный тестовый scrape в CI с временным TSDB - по желанию; для приёмки вывода обычно хватает promtool. Открыть URL в браузере или посчитать строки regex - слабая замена парсеру: он падает на первой невалидной строке TYPE.
Семейство начинается с HELP и TYPE, дальше идут самрле-строки с метками в фигурных скобках. Имена меток должны быть стабильными между scrape, иначе в Grafana «прыгают» серии - но до этой семантики вы не дойдёте, если документ отбросят изR09;за LF.
promtool идёт в дистрибутиве Prometheus, отдельный агент для него не требуется. Я держу его в том же job CI, что и упаковку экспортёра: сначала promtool, потом публикация артефакта.
Перевод строки - когда всё зелёное, а target down
Симптом в Prometheus знакомый: health down, lastError invalid metric type "gauge\r". В TSDB не попадает ни один ряд; Grafana рисует пустоту, пока ктоR09;то не откроет вкладку target и текст ошибки.
Контекст: Перевод строки - когда всё зелёное, а target down
На Windows StringBuilder.AppendLine() ставит CRLF (Environment.NewLine). Строка # TYPE onec_sessions gauge для парсера превращается в объявление типа gauge\r - отсюда сообщение. Символ \r прилипает к последнему токену строки.
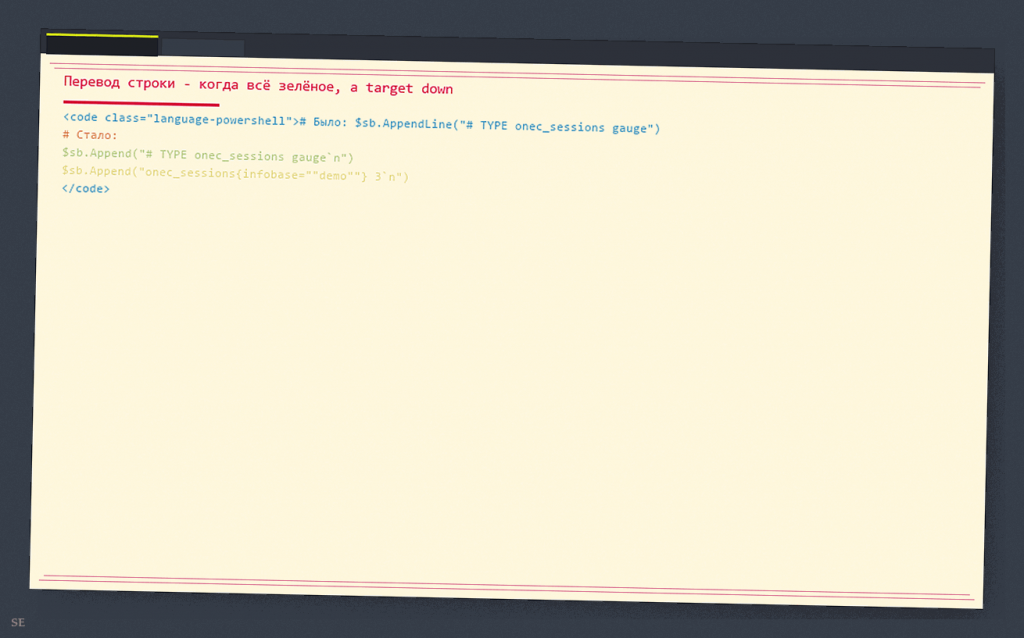
Правка - явный LF при склейке, без AppendLine:
# Было: $sb.AppendLine("# TYPE onec_sessions gauge")
# Стало:
$sb.Append("# TYPE onec_sessions gauge`n")
$sb.Append("onec_sessions{infobase=""demo""} 3`n")
После правки гоняю promtool check metrics по живому выводу (файл или pipe). Target поднимается в up, когда парсер перестаёт ругаться.
Отдельная ловушка - эталонный образец вывода в репозитории. Собран со старым CRLF - CI «проверяет» испорченный эталон и дублирует болезнь. Пересоберите образец из исправленного живого вывода, иначе promtool в пайплайне будет врать в другую сторону.
Для *.prom в репозитории задаю eol=lf в .gitattributes; тест на байт CR ловит регресс, который глазами в diff не виден. Настройки «принять CRLF в Prometheus» нет - меняют генератор, не парсер.
Шесть «зелёных» проверок - что они меряют и почему не ловят \r
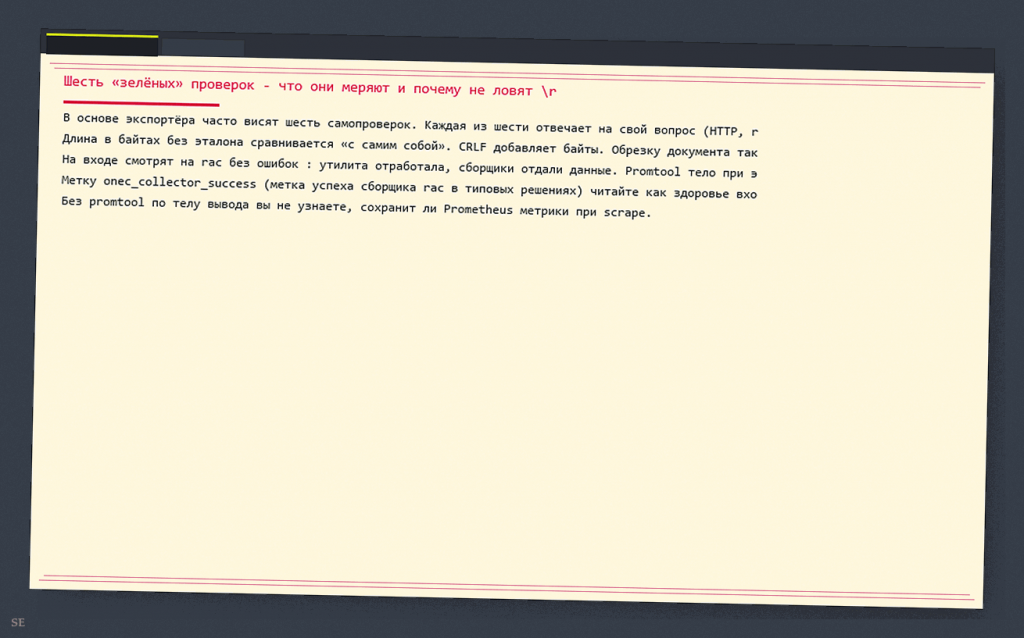
В основе экспортёра часто висят шесть самопроверок. Каждая из шести отвечает на свой вопрос (HTTP, rac, BOM) и не заменяет promtool. Две первые про транспорт: HTTP 200 значит лишь то, что слушатель отдал тело - на мусор с CRLF код ответа тот же. Content-Type - заголовок, который вы сами выставили; это намерение отдать exposition format 0.0.4, а не гарантия корректности байтов.
Контекст: Шесть «зелёных» проверок - что они меряют и почему не ловят \r
Длина в байтах без эталона сравнивается «с самим собой». CRLF добавляет байты. Обрезку документа так не поймаете. Счётчики семейств и рядов по regex режут тот же текст, что уходит наружу: для regex строка # TYPE … gauge может выглядеть целой и при LF, и при CRLF, поэтому числа совпадают на испорченном и исправленном тексте.
На входе смотрят на rac без ошибок: утилита отработала, сборщики отдали данные. Promtool тело при этом не проверяет. В техтfиле-режиме проверка UTF-8 без BOM - единственная работа с сырыми байтами в типичном наборе. Она ловит маркер в начале файла, но не перевод каретки в хвосте строк TYPE. Отдельной проверки на LF в этой шестёрке нет.
Метку onec_collector_success (метка успеха сборщика rac в типовых решениях) читайте как здоровье входа: rac и сборщики справились - это ещё не знак, что TSDB примет текст. Зелёная метка при красном target в Prometheus обычна, пока promtool не прогнали по выгрузке.
Без promtool по телу вывода вы не узнаете, сохранит ли Prometheus метрики при scrape.
Обязательная приёмка - promtool на живом потоке
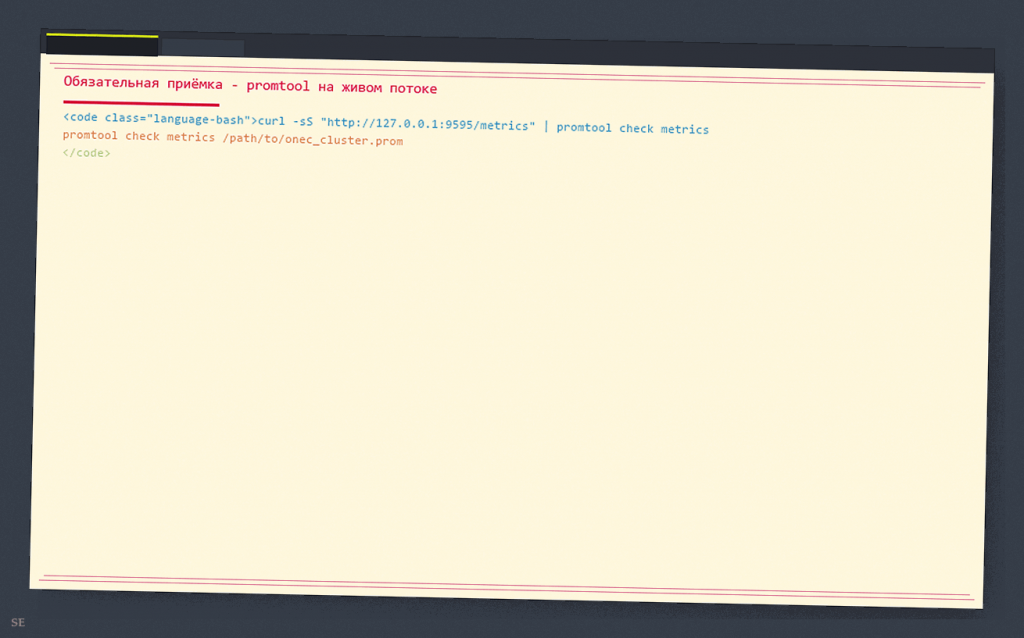
Перед тегом релиза я всегда делаю два прогона - pipe с curl и файл textfile, если схема с collector:
Контекст: Обязательная приёмка - promtool на живом потоке
curl -sS "http://127.0.0.1:9595/metrics" | promtool check metrics
promtool check metrics /path/to/onec_cluster.prom
Если метрики идут через node_exporter textfile collector, тот же promtool к файлу перед rotate или rename: парсер не знает, откуда файл взялся.
На Windows вывод удобнее сначала сохранить в файл и отдать promtool. На Linux чаще хватает pipe с curl без промежуточного диска. Оба варианта должны закончиться без ошибки promtool. Ненулевой код завершения - повод отложить выкладку, даже если внутренний отчёт экспортёра зелёный.
Ниже таблица типичных сообщений парсера: что видно в UI Prometheus или в stderr promtool и что чаще всего стоит за текстом. Формулировки зависят от версии promtool - сверьте на своих намеренно битых фикстурах. Выдуманных кейсов нет:
| Симптом в UI Prometheus / promtool | Типичная причина |
|---|---|
| invalid metric type "…" | Мусор в токене TYPE (часто \\r из CRLF), опечатка типа |
| duplicate label names | Две метки с одним именем в одном ряду |
| help text after metric | # HELP или # TYPE после самрле-строки семейства |
| expected float as value | Нечисловое значение sample, NaN/Inf не по правилам |
| label name … is not valid | Недопустимые символы в имени метки |
Для алертов и recording rules на пустом стенде пригодится absent() или группировка по меткам, когда метрика законно отсутствует. Это другой договор, чем ожидание постоянного ряда для лицензий с реальным labelset из rac.
RAS, rac и ragent - версии и «процесс жив, данных нет»
Утилиты администрирования должны совпадать с платформой кластера. По опыту эксплуатации держу так: rac может быть новее RAS. RAS новее ragent быть не может. Это не таблица совместимости из ИТС, а правило со стендов.
На машине с несколькими установками 1С в Program Files не берите ras.exe из каталога с максимальным номером версии. Привяжитесь к ragent, который обслуживает кластер: служба «1C:Enterprise 8.3 Server Agent», путь процесса. rac, ras и ragent - из одного каталога bin той установки, где работает ragent кластера, а не с «самой новой» платформы для разработки.
Симптом знакомый: процессы живы, HTTP 200, а часть метрик пустая или rac сыпет ошибками совместимости. Самопроверка «порт открыт» это не ловит. Версию бинарника ragent сверяю с путём к ras.exe в скрипте запуска RAS.
Автозапуск RAS на той же машине, что ragent, должен подхватывать ras.exe из каталога установки агента. Не подмешивайте бинарники из PATH. На сервере с одной службой 1С путаница редка; на машине администратора с несколькими bin - частая история.
Если rac новее RAS, иногда ещё терпимо. Обратная пара - RAS новее ragent - почти гарантированные сбои опроса. Правило запоминают один раз и сверяют при каждом обновлении платформы на кластере.
Метрики, которых нет на пустом стенде
Отдельная проблема - метрики, которые появляются только при наличии данных (лицензии, сеансы). Метрики лицензий выходят только когда лицензии выданы; на тестовом кластере без сеансов семейства нет. Дашборд ждёт ряды. Алерт «лицензий мало» молчит или срабатывает на отсутствие данных неправильно.
Идея «всегда печатать ноль» с пустыми метками ломает семантику: фиктивные ряды путают absent(), раздувают cardinality и дают ложные срабатывания. Надёжнее отдельный сбор через rac process list --licenses - те же параметры подключения к кластеру, что и для остальных вызовов rac; полная строка в rac help process list. На пустом стенде видна лицензия rphost платформы, без выдуманных нулевых рядов.
Если отдаёте метрики через textfile collector node_exporter, файл - UTF-8 без BOM. Временные файлы с полудописанным содержимым не оставляйте: node_exporter может прочитать мусор между rename и delete.
Для алертов по лицензиям на тестовом кластере я явно разделяю «метрика отсутствует, потому что стенд пуст» и «метрика есть, значение плохое». Первое закрывают absent() или панель «есть ли вообще семейство». Второе - порогами по реальным label из rac. Подмена отсутствия нулём с пустыми labels ломает оба сценария.
Дашборд, собранный на боевом кластере, на СИ-стенде без пользователей может выглядеть «сломанным». Панели пустые изR09;за того, что на стенде нет тех рядов, под которые писали PromQL на боевом кластере. Прогон сценария пустого кластера входит в приёмку наравне с promtool.
Чек-лист перед выпуском и line endings в CI
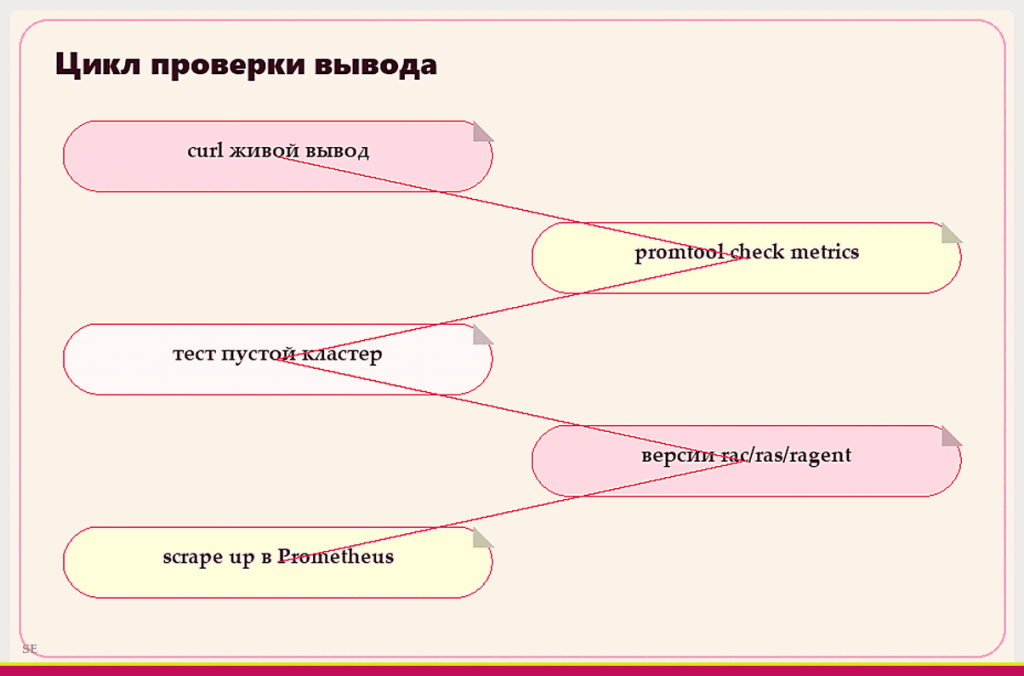
На рисунке - цикл приёмки: живой curl, promtool, опционально тестовый scrape, сценарий пустого кластера, сверка версий rac, ras, ragent.
promtool check metricsна НТТР-потоке (curl) и на файле textfile перед публикацией.- Генерация строк только с LF:
Appendи явный\nв PowerShell (символ LF, не «обратный слэш-н» в смысле C), не AppendLine на Windows. - Эталон в репозитории пересобран из вывода, который уже прошёл promtool.
- В CI:
.gitattributestext eol=lfдля*.promили тест, что в образце нет символа CR вне комментариев (если политика репозитория это допускает). - rac, ras, ragent с одного
binустановки ragent кластера, не с «самой новой» установки в Program Files. - Пустой стенд: лицензии через
process list --licenses; алерты сabsent(), где метрика может отсутствовать. - textfile: UTF-8 без BOM; не оставлять временные файлы между rename и delete.
- Разделяйте
onec_collector_success(вход rac/сборщиков) и результат promtool (выход, пригодный для парсера).
Пример assert на CRLF в эталоне (фрагмент теста):
$bytes = [System.IO.File]::ReadAllBytes("$PSScriptRoot/fixtures/onec_cluster.prom")
$body = $bytes[0..($bytes.Length-1)]
$cr = @($body | Where-Object { $_ -eq 0x0D }).Count
if ($cr -gt 0) { throw "CR byte 0x0D found: $cr times - need LF-only per exposition format" }
promtool check metrics "$PSScriptRoot/fixtures/onec_cluster.prom"
Без promtool и живого scrape обещание «HTTP 200 и Content-Type хватит для production» не держится. Самопроверки редко ловят то, что вы не заложили в тест; хвост \r в строке TYPE как раз из этой категории.
Что почитать дальше
Prometheus exposition formats (LF между строками) и справка promtool check metrics в документации Prometheus. Утилиты rac, ras, ragent - в комплекте платформы 1С:Предприятие 8.3, раздел администрирования кластера. Если поднимаете стек с нуля, хватит официальных гайдов Prometheus и Grafana по scrape_config; эта памятка про приёмку вывода, а не про установку с нуля.
После деплоя вкладка target в Prometheus (up, down, lastError) покажет расхождение быстрее, чем внутренний отчёт экспортёра; promtool на том же URL закрывает приёмку. На CI и на стенде без сеансов стоит отдельно прогнать promtool - условные метрики лицензий там всплывают чаще всего.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

