Как понять, что случилось, когда пользователи бушуют?
База данных - Администрирование СУБД
От жалобы пользователя до технической гипотезы
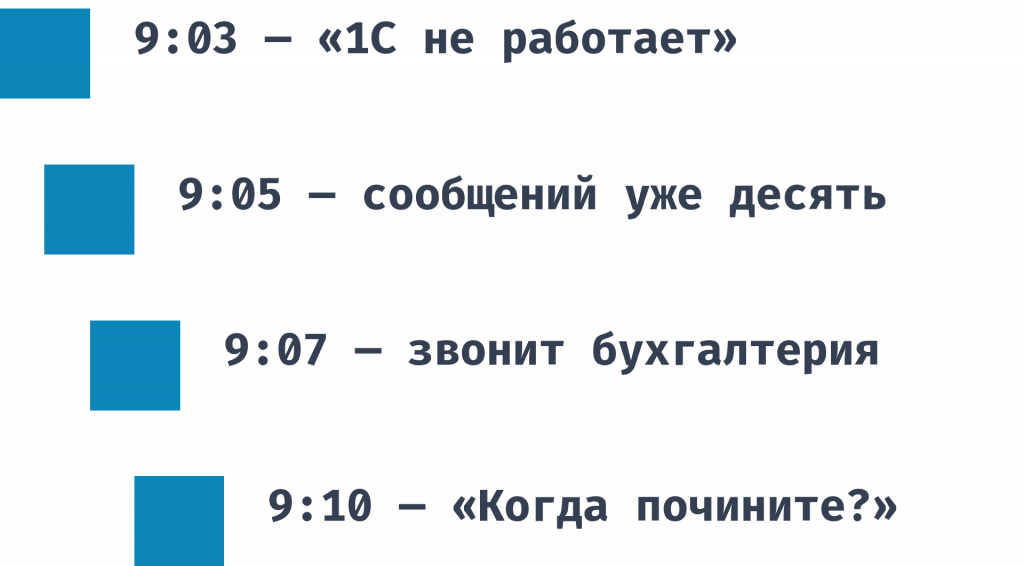
Представьте обычное утро понедельника. В 9:00 вам в чат уже пишут, что 1С не работает или тормозит. Через пару минут сообщений уже десять. Еще через несколько минут звонит бухгалтер, а потом к нему присоединяется руководитель и говорит: «Надо работать, давайте что-то сделаем».
Проблема даже не в том, что что-то сломалось, а в том, что пользователи уже знают, кто виноват, бизнес уже ждет ответ, а вы еще не понимаете, что именно случилось. Это сервер, кластер, база, интеграция какая-то отвалилась или кто-то просто запустил что-то очень тяжелое в неудачное время?
Когда пользователь начинает нервничать, времени на теорию остается мало. Мы будем рассматривать кейс, когда нам почему-то надо очень быстро реагировать. Возможно, у вас ситуации другие и можно полдня подождать – ничего не случится. Но в нашем случае нужно быстро ответить на три вопроса: что происходит, где это происходит и какую гипотезу проверяем первой.
Эта статья именно об этом. Не о мониторинге как о красивом наборе графиков или метрик, а о том, как сократить путь от жалобы пользователя до технического решения.
Я занимаюсь внедрением и сопровождением веб-приложений и решений на платформе 1С и всей инфраструктуры, которая их окружает. И практически в каждом втором проекте, которого я касаюсь, вижу одну и ту же историю: пользователи уже научились жаловаться, бизнес уже немного на нервах, а команда сопровождения только пытается понять, где искать причину.
Очень часто проблема не в слабой команде и не в том, что люди не стараются. Проблема в том, что система плохо наблюдаема.
Я обычно формулирую это так: если первый мониторинг у вас – это звонок бухгалтера, то, скорее всего, мониторинга у вас нет.
Можно собрать красивый дашборд, настроить сотни метрик, хранить гигабайты логов, но если в первые минуты инцидента это не помогает быстро сузить круг причин, с практической точки зрения это все еще неработающий мониторинг.
Поэтому поговорим не про идеальную картинку мониторинга, а про практический контур – путь, алгоритм, который помогает, когда уже началось.
Главная мысль очень простая: хороший мониторинг – это не когда у вас много данных и метрик. Хороший мониторинг – это когда он сокращает время расследования.
Четыре уровня системы
Обычно мониторинг или наблюдаемость системы описывают через три столпа: метрики, логи и трассировки. Это полезная и очень важная модель.
Но я хочу предложить другой ракурс – ракурс инцидента. Не только какие данные мы собираем, но и на каком слое системы может находиться причина.
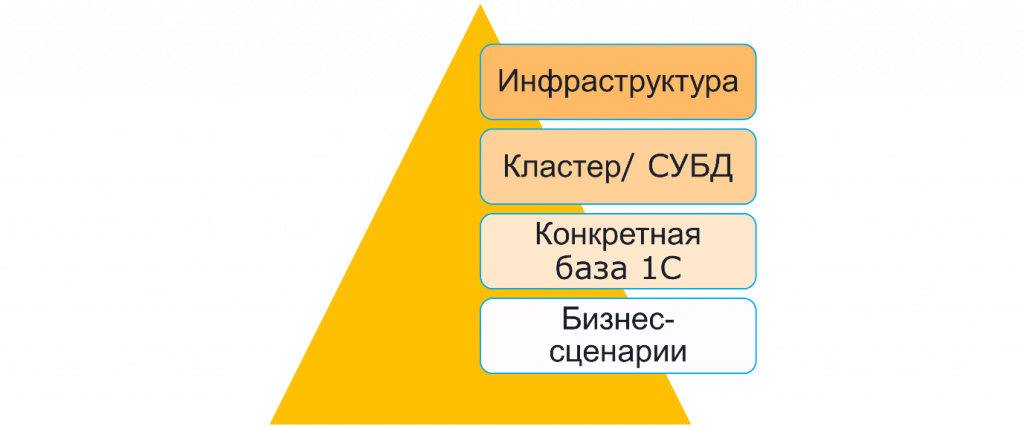
Я предлагаю посмотреть на систему по четырем уровням.
Первый уровень – инфраструктура: серверы, сеть, параметры операционной системы, диски и все остальное.
Второй уровень – сама платформа 1С и СУБД. Возможно, какие-то стоящие рядом приложения, которые общаются с платформой. Здесь мы смотрим на кластер, рабочие процессы, сеансы, блокировки и все, что вы хорошо знаете.
Третий уровень – приложение, решения 1С и интеграции. Обмены, API, какие-то очереди, веб-интерфейсы.
Четвертый уровень – непосредственно пользовательские бизнес-сценарии. Что именно перестало работать для бизнеса?
Дальше пройдемся по этим четырем уровням: что смотреть, куда двигаться во время инцидента и какие инструменты могут помочь, даже если мониторинга у вас почти еще нет.
Алгоритм первых минут инцидента
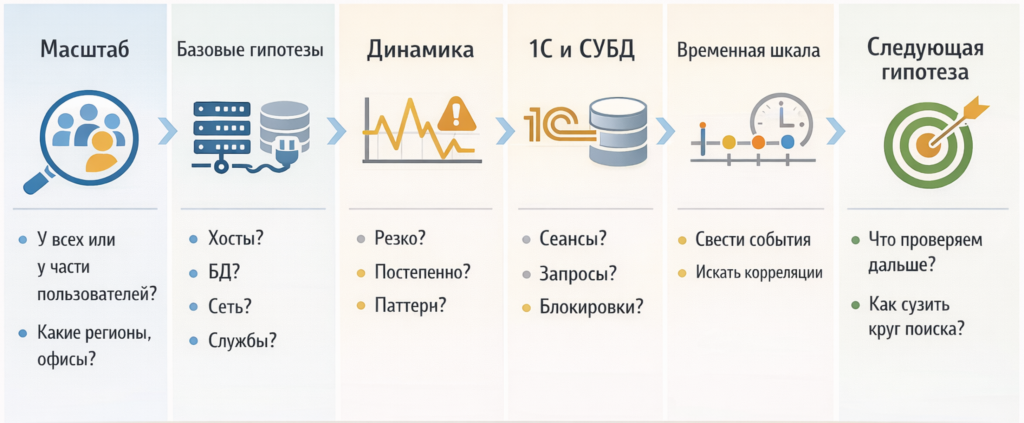
Когда пользователи нервничают, я предлагаю очень простой порядок действий. Он не волшебный, но помогает не метаться лишний раз.
Первое – понять масштаб. Проблема у всех или не у всех пользователей? Это масштабный сбой или проблема в каком-то конкретном сценарии? Не работает все или сломалось что-то частично?
Второе – снять базовые гипотезы. Живы ли серверы? Доступна ли база? Отвечает ли сеть? Что в целом происходит с базовым техническим контуром?
Иногда это звучит банально, но именно такие банальные проверки очень часто экономят первые минуты и часы, когда все сильно горит.
Третье – посмотреть на динамику. Когда стало плохо? Это был резкий спад, плавная деградация или какой-то повторяющийся паттерн? Во времени система часто проявляет себя ярче и заметнее, чем в моментальном срезе.
Четвертое – подняться на уровень 1С и СУБД и после предыдущих проверок посмотреть, что происходит с сеансами, блокировками, возможно, какими-то длительными операциями.
Пятое – свести события на одну временную шкалу. Это сложно сделать нормальным человеческим способом, если у вас нет системы, которая помогает это сделать. Метрики, логи, события платформы, интеграции – все эти события могут влиять на ваши процессы. Если что-то упустить, расследование может затянуться.
Шестое и самое главное – понять, какой следующий шаг мы должны получить в результате анализа. Какую гипотезу проверяем прямо сейчас?
Хороший мониторинг, конечно, не заменяет логику и базовое мышление, но очень сильно экономит время.
Здесь должен прозвучать важный тезис: я не продвигаю идею «давайте мониторить все». Для многих команд, особенно тех, которые не сильно в это погружены, это тупиковое направление.
Ценность мониторинга начинается там, где сигнал помогает ответить на вопрос: что делать дальше?
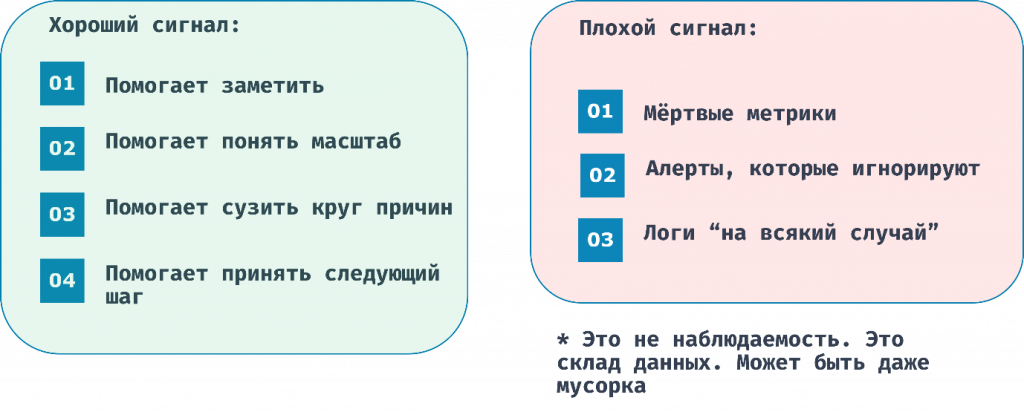
Хороший сигнал помогает раньше заметить проблему, понять масштаб, быстрее сузить круг причин и, что особенно важно, говорить с бизнесом фактами, а не ощущениями и домыслами.
Плохой сигнал – это шум.
Очень часто встречается ситуация, когда у нас сотни метрик, на которые никто не смотрит. Десятки алертов, на которые уже никто не реагирует, потому что сколько можно – мы смотрим на это месяцами. Тысяча сообщений в чате от мониторинговой системы, которую мы не читаем. Дашборды есть. А ответа на вопрос «Что случилось? Почему пользователь жалуется?» – нет.
Логи собираются, но про запас. К сожалению или к счастью, большая часть логов, которые мы собираем, остается просто данными, пока мы не столкнемся с реальной проблемой.
Если система сигналит слишком часто и бессмысленно, команда так или иначе начинает отключать звук оповещений, потом перестает заглядывать в чат, а потом начинает думать: «Что-то шумит, пошумит и пройдет».
И какой бы хороший сигнал у нас ни был, если вокруг огромное количество шума, он в нем затеряется.
Здесь важно изменить подход к мониторингу. Мы не должны думать: «Что бы нам еще такое интересное померить?» Нужно отвечать на другой вопрос: «Какой вопрос мы сможем закрыть, если получим новый сигнал от системы?»
Уровень 1. Инфраструктура
Поговорим про инфраструктуру – первый уровень. Главный вопрос здесь: уперлись ли мы в наш базовый технический контур?
Когда пользователи говорят: «1С тормозит», первое, что нужно сделать, – быстро снять самые базовые гипотезы. Сервер перегружен или нет? Проблема в сети или нет? Диск деградирует или нет? Сервис на нашем сервере вообще жив?
Если этот слой не закрыт, дальнейшее расследование, скорее всего, будет во многом вслепую.
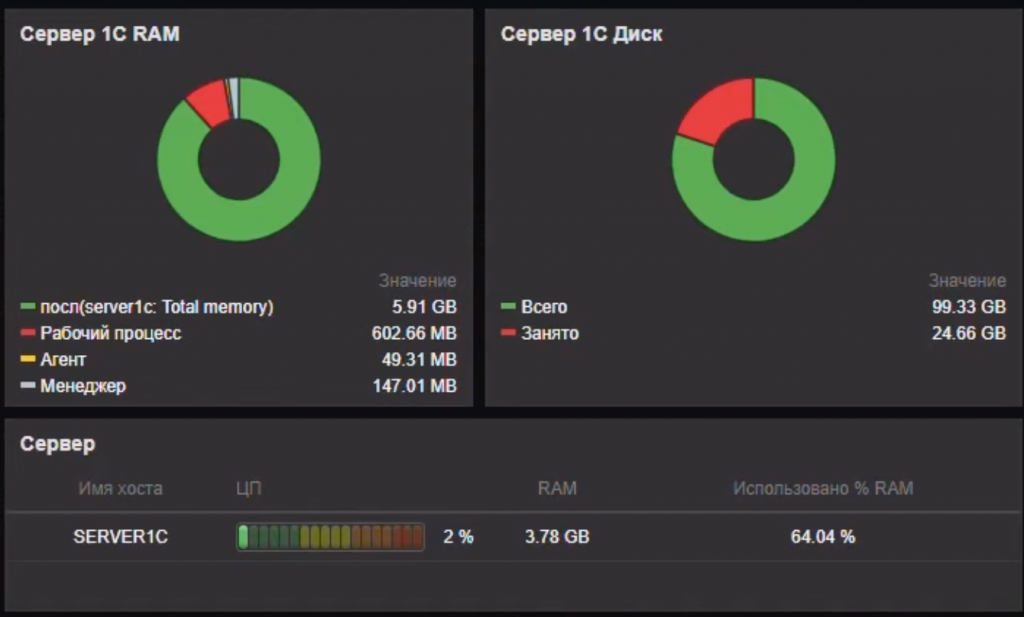
На этом уровне хорошо работает Zabbix. На изображении можно увидеть один из базовых вариантов его использования. Его задача простая: показать, жив ли базовый контур.
От него многого не требуется. Настраивается все достаточно просто: буквально установить и скачать несколько шаблонов – и все работает.
Это не весь мониторинг. Это фундамент.
Здесь очень важно понимать границу: если сервер мертв, база недоступна, на диске нет места и так далее, то какие бы красивые дальнейшие аналитики у нас ни были, они уже не сильно помогут, потому что именно здесь может находиться корень проблемы. Сначала нужно увидеть, что базовый контур жив.
Когда мы начинаем говорить про инструменты, всегда возникает вопрос: какой инструмент лучше, какой проще, какой дешевле и так далее. Но на практике это почти всегда неправильный вопрос. Правильный вопрос другой: какую задачу мы решаем?
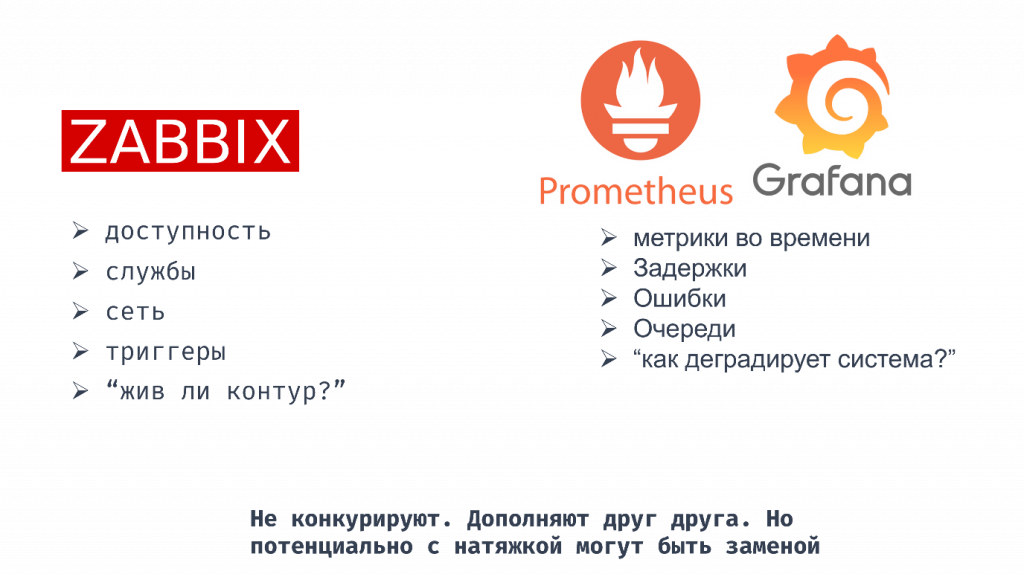
Если нам нужен классический эксплуатационный контур – хосты, доступность, понятные проверки и триггеры без излишних наворотов, – Zabbix будет естественным выбором. Он бесплатный. Нужно просто разобраться, как его установить и настроить, и это не занимает много времени.
Если нам нужны какие-то кастомные метрики во времени, количество ошибок, длительность операций, состояние очередей и техническая динамика системы, можно обратить внимание, например, на Prometheus.
Но это не догма. Таких инструментов много. Нужно просто понимать их назначение и с каким из них вам будет проще стартовать.
Например, мы посмотрели Zabbix – базовый контур вроде бы в порядке. Но если дополнительно использовать Prometheus с Grafana, можно увидеть, что время конкретной операции постепенно растет. Получается, базовый контур жив, а система начинает потихоньку деградировать.
Для пользователей все проблемы в системе, скорее всего, выглядят одинаково. У нас может произойти критическая ошибка и что-то перестанет работать, а может внезапно в десять раз вырасти время выполнения ключевой операции. Для пользователя это одинаково плохо. Для него система уже ломается.
Уровень 2. Кластер 1С и СУБД
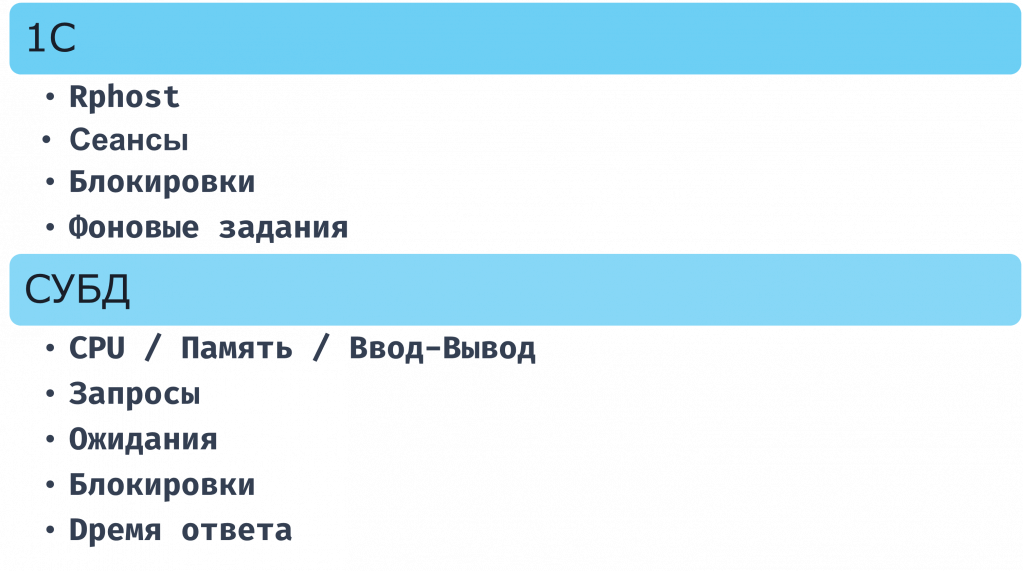
Очень часто железо оказывается в порядке, потому что инфраструктура – достаточно устойчивая штука. Тогда начинается следующий уровень – платформа 1С и СУБД.
Именно здесь, как правило, и сидит настоящая боль пользователя.
Со стороны 1С я бы в первую очередь смотрел состояние кластера, активные сеансы, лицензии, что происходит с rphost, которые любят отваливаться, длительные операции, блокировки и регламентные задания.
Со стороны СУБД очень важно определить, сколько ресурсов она потребила и сколько еще может потребить, сколько осталось. Очень часто при высоконагруженных операциях или когда мы не вовремя выполняем какие-то регламентные операции в самой СУБД, возникает рост потребления ресурсов. Здесь нужно проверять как минимум рост времени ответа на запросы и блокировки. Остальное для начального уровня можно опустить.
Когда пользователь говорит: «У меня упала или тормозит 1С», проблема может быть в базе или, наоборот, в платформе. Но выглядит это практически всегда как проблема прикладного кода.
И часто это действительно так. Прикладной код создает нам большинство проблем: длительные транзакции, блокировки – и ломает жизнь всем остальным.
На этом уровне особенно важна не только точка «сейчас» – то, что мы можем увидеть, например, посмотрев, что происходит в технологическом журнале или журнале регистрации.
Нам важна динамика. С какого момента стало плохо?
Возможно, плохо становилось в течение месяца, а сейчас мы просто оказались в критической ситуации.
И самое важное – посмотреть, что еще происходило и с чем это совпало по времени.
Если вы этого не видите, пользователи, скорее всего, будут первыми, кто расскажет вам о сбое.
Кейс №1. Тормозит каждые 15 минут
Сейчас особенно важно заботиться о конкурентоспособности наших услуг, поэтому разберем типовой сценарий.
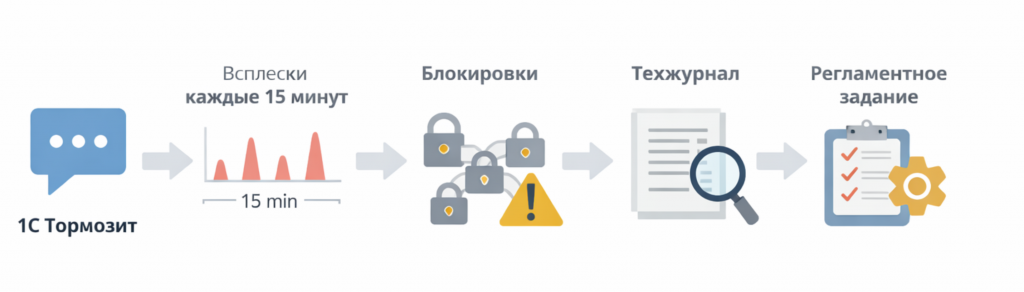
Пользователи жалуются: 1С периодически сильно тормозит. Не постоянно. Несколько минут все плохо, потом отпускает, потом снова плохо.
Первая гипотеза, естественно, – железо. Смотрим на общую нагрузку, а там никакой аварии нет, ничего критичного не происходит. Первый уровень ответа не дает.
Переходим на уровень 1С и СУБД, смотрим поведение во времени и видим ключевую вещь: примерно каждые 15 минут резко растет время выполнения операции.
Если это повторяющийся паттерн, значит, можно искать событие, которое совпадает с ним по времени. Его гораздо проще найти.
Дальше смотрим в дашборд и видим всплески ожидания блокировок. Возникает вопрос: откуда они взялись?
После этого идем в логи и находим виновника – наше любимое регламентное задание, которое каждые 15 минут обменивается с Битриксом и перепроводит документ.
В результате возникают длинные транзакции и блокировки.
Пользователь видит это очень просто: «1С тормозит».
Здесь важно не только то, что мы нашли причину. Важно, как мы к ней пришли.
Инфраструктура не подтверждает проблему, общей перегрузки не видно. Есть периодичность, растет время операций. Есть всплески блокировок. Очень важно увидеть именно эти всплески. Есть совпадающие по времени события в журнале.
То есть мы не просто нашли что-то подозрительное. Мы нашли механизм деградации.
Дальше определили менее загруженные часы и перенесли туда регламентное задание. И что особенно удобно: имея мониторинг, можно определить, когда у нас действительно менее загруженные часы. Когда мониторинга нет, это сделать гораздо сложнее.
Это пример уже более зрелого подхода, когда вы находите не просто «тормоза» и не просто реагируете на жалобы пользователей, а видите конкретный механизм, который производит деградацию. Это еще один аргумент в пользу того, что на мониторинге нужно концентрировать усилия.
Уровень 3. Приложение и интеграции
Но и этого недостаточно, потому что в реальной системе рядом с 1С обязательно есть что-то еще. Это может быть обмен, сайт, веб-интерфейс, очереди или другие сервисы.
Здесь возникает третья ловушка: инфраструктура может быть жива, 1С может быть жива, а пользовательский сценарий уже сломан.
Это и есть третий уровень – приложения и интеграции.
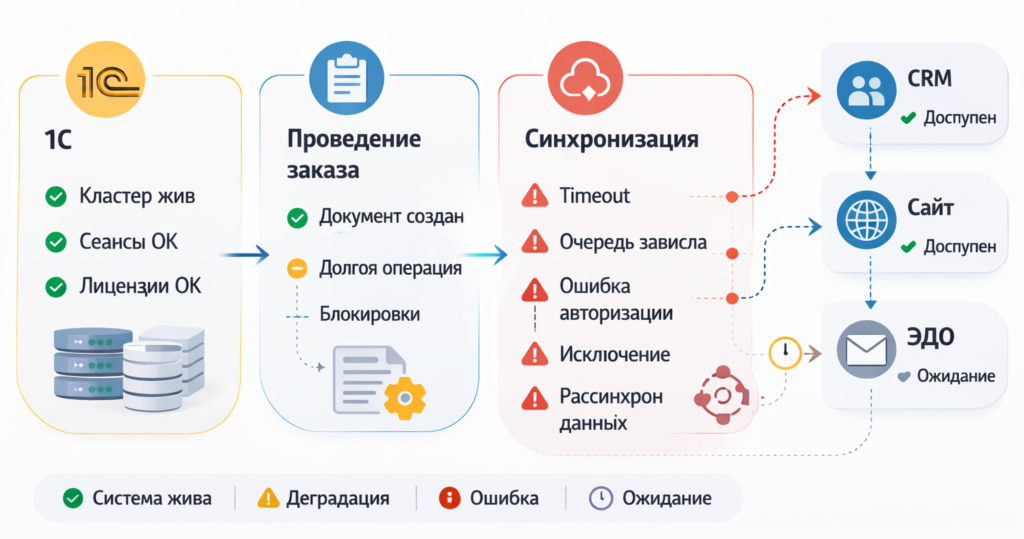
Пользователь видит одно: «Не работает». Но внутри это может быть тайм-аут соединения, зависшая очередь, повторные запросы во внешнюю систему или просто упавший внешний интеграционный сервис.
Ответ в духе «CPU в норме, память в порядке, в кластере все хорошо» здесь уже не подходит. Потому что вопрос теперь не в том, жив ли сервер. Вопрос в другом: на каком шаге ломается сценарий?
Здесь полезно все, что помогает это увидеть.
В последнее время я стал использовать на проектах Sentry. Он может быть очень полезен, потому что крайне легко встраивается в приложения, которые не относятся к 1С.
В 1С он тоже встраивается. Мы можем передавать туда ошибки журнала регистрации и наш Apdex.
Обычно Sentry особенно полезен вокруг 1С.
Если система уже распределенная, не стоит забывать и про трассировки. Для большинства систем это, наверное, вершина развития мониторинга – когда появляется возможность добавить трассировки.
Когда бизнес-сценарий проходит насквозь через несколько сервисов, момент, в котором он упадет, очень сложно отследить. К тому же некоторыми системами мы можем вообще не владеть.
Если у нас есть единая система сбора ошибок, которая позволяет настроить трассируемость, можно для каждого бизнес-сценария выделить уникальный идентификатор транзакции. Он проходит насквозь через весь сценарий. Тогда мы можем увидеть не просто то, что сценарий сломан, а на каком именно этапе он сломался и с какими данными.
Кейс №2. «Иногда падает»
Еще один очень неприятный сценарий – когда пользователи говорят, что 1С иногда падает. Само слово «иногда» – одно из самых неудобных в эксплуатации. Проблема есть, но воспроизвести ее по запросу нельзя. Она происходит нерегулярно и из-за этого очень долго может выглядеть просто как случайность.
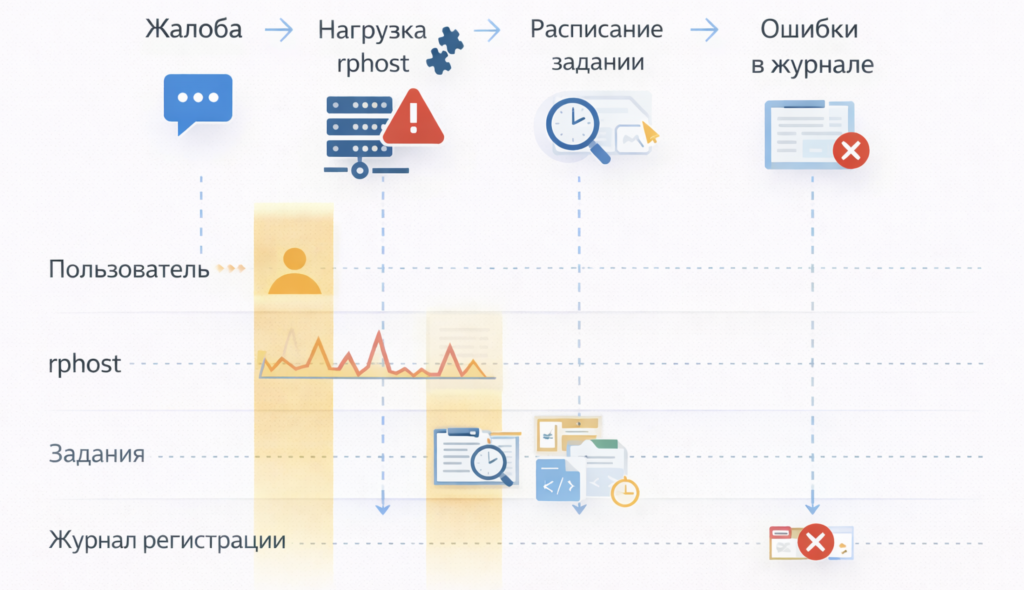
В одном из таких случаев у нескольких пользователей периодически непредсказуемо отваливался сеанс без очевидной причины.
Когда смотришь на это со стороны пользователя, в момент сбоя ничего особенного не видно – просто прекращается работа 1С.
Используя мониторинг, логирование и анализ технологических журналов, которые тоже выгружались в общую систему, мы смогли увидеть, что у нас периодически отваливаются rphost.
Дальше сопоставили это время с прикладными ошибками бизнес-сценариев и увидели, что ошибка повторяется.
Отвал rphost происходит не просто так. Это не просто перезапуск. Он происходит во время определенного обмена, где совпали тяжелая обработка, нестабильные внешние взаимодействия и плохо обработанное исключение.
Что сделали дальше? Разбили обработку на маленькие шаги, сделали стандартные действия и обложили все логами.
В итоге из внезапной нестабильной ошибки мы получили управляемую ситуацию, когда проблемы периодически происходят, но по ним уже видна полная картина.
Ошибка стала видимой, локальной и диагностируемой.
Из этого следует очень важный практический вывод. В инциденте часто побеждает не тот, кто сказал: «Я знаю, что там упало». Выигрывает не опыт сам по себе, а тот, кто умеет свести несколько источников на одну временную шкалу.
Если у вас есть только жалобы пользователей, зачастую у вас есть только эмоции. Если есть только системные метрики – у вас только симптомы. А причина очень часто находится на пересечении платформы, логов, времени сбоя и прикладного контекста.
Уровень 4. Бизнес-сценарии
Здесь начинается, на мой взгляд, самый зрелый уровень.
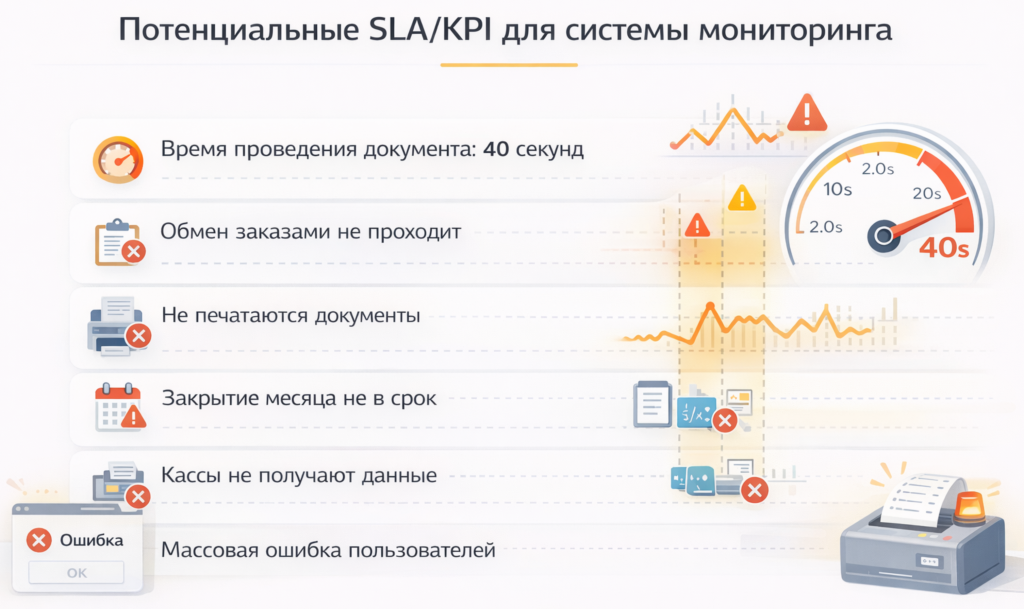
Настоящее качество мониторинга определяется не только тем, что вы умеете смотреть нагрузку. Это база, это нужно, но это только начало.
Настоящая ценность начинается там, где вы видите, что именно перестало работать для пользователя и для бизнеса.
Не просто CPU зашкаливает. Не просто занята память. Не просто сыплются какие-то ошибки. Мы должны иметь возможность разбить эти ошибки и сгруппировать данные в метрики.
Проведение документов занимает не две секунды, а 40.
Не проходит обмен заказами – а не просто появилась ошибка доступа к внешнему URL.
Не печатаются документы.
Закрытие месяца выходит за ранее оговоренное окно.
Или, что особенно важно, пользователи массово получают однотипные ошибки.
Бизнесу обычно неинтересно, сколько у нас процессов rphost и какая задержка на диске. Бизнесу важно, можем ли мы работать и когда начнем работать после ошибки.
Здесь появляется важное правило. Если у нас есть критические процессы, а они обязательно есть, должно быть три-пять измеримых бизнес-сценариев, по которым мы заранее понимаем: это норма или уже деградация.
Включить Apdex в БСП, добавить его в нужные системы достаточно просто. Добавить туда логи – и эти данные уже будут собираться.
Логи должны участвовать в расследовании
Отдельный важный блок – логи.
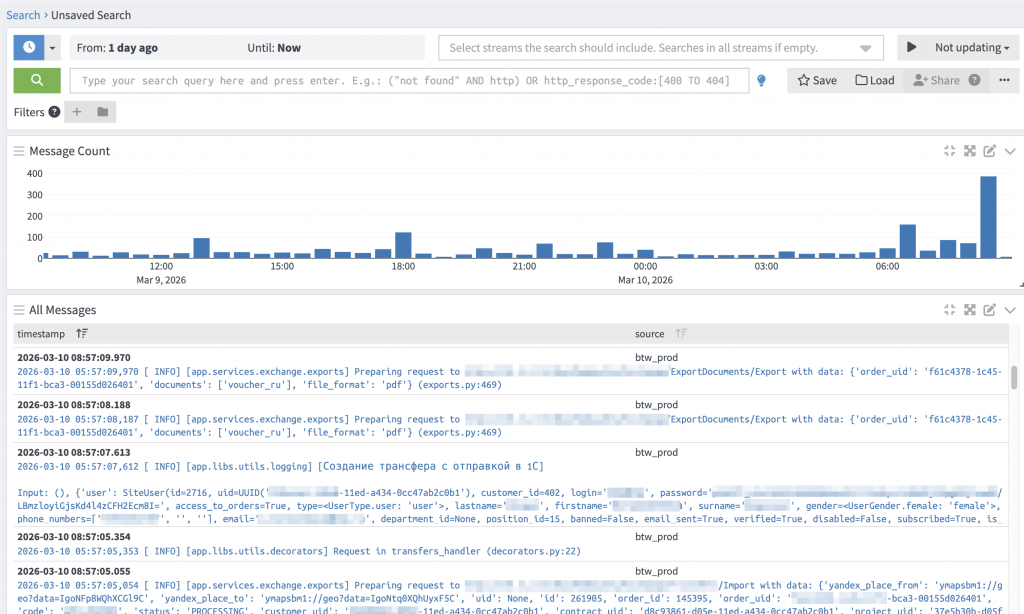
Логи есть почти у всех. Но если система достаточно большая, развитая и распределенная, очень часто они существуют в формате «где-то лежат».
И в момент инцидента начинается знакомый квест: где журнал этой базы? Где журнал интеграции – в регистре сведений, в файле или в журнале регистрации? Сохранился ли нужный период? Это тест, прод или что-то еще?
Иногда нужный лог ищут дольше, чем саму проблему.
Поэтому централизованные логи в современной системе – это не роскошь. Тем, кто еще их не использует, рекомендую попробовать. Это практичный инструмент расследования.
Они нужны, чтобы быстро находить взаимосвязанные ошибки в разных системах, делать выборки по времени, пользователю и операции. В Sentry это можно удобно настроить, в Graylog тоже можно настроить среду, в которой возникли ошибки: тест, прод или стейдж. Их удобно разделять между собой.
Когда мы говорим про инструменты сбора и накопления логов, часто возникают такие названия, как ClickHouse, Elasticsearch, Graylog и другие.
Но сам инструмент на самом деле не так важен. Важнее, на каком уровне работы с ним вы находитесь.
Система центрального хранения логов – это не только хранилище. Там обязательно должен быть удобный поиск, чтобы вы долго не ковырялись, когда нужно что-то найти. Должна быть система визуализации и система алертов, чтобы можно было, например, настроить рассылку на ошибку уровня приложения.
Если взять голый ClickHouse или Elasticsearch, этого не будет. Зато будет большая гибкость, и все необходимое придется настраивать самостоятельно.
Мысль не в том, что нужен какой-то конкретный инструмент. Мысль в том, что у нас должно быть одно место – вы можете хоть сами написать такое приложение, – где события из разных систем можно быстро найти, сопоставить и связать по времени.
Что делать, если мониторинга почти нет
Еще один важный вопрос – что делать, если мониторинга почти нет.
Мой ответ простой: не стоит сразу строить какой-то космический корабль, универсальную платформу мониторинга.
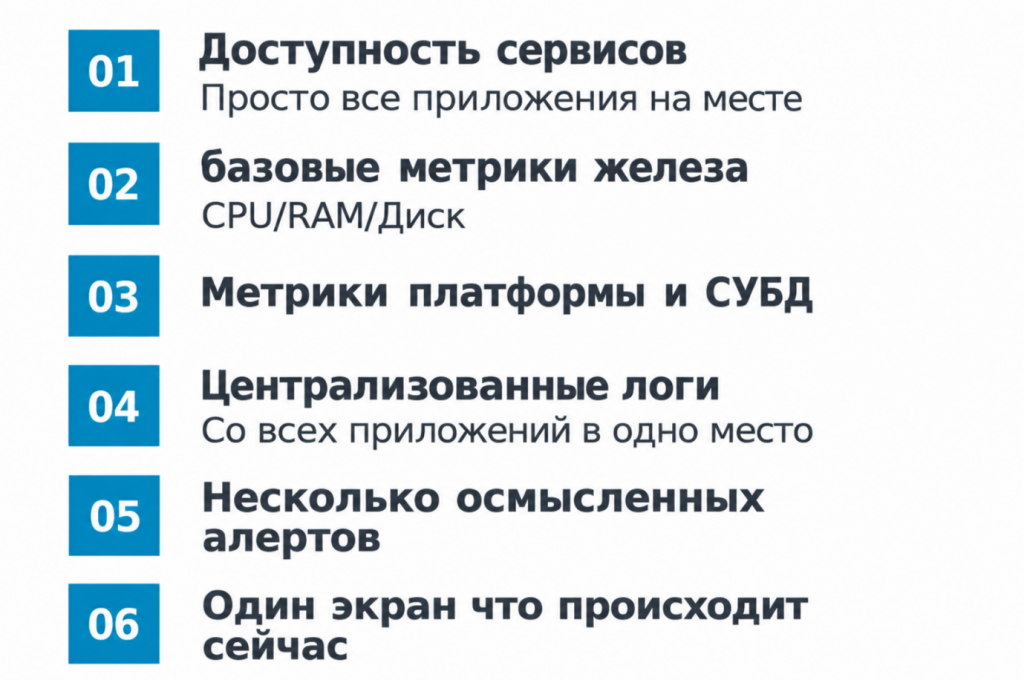
Постройте минимальный контур. Я бы начинал с доступности критичных сервисов: нужно знать, живы ли серверы.
Базовые метрики железа. Нужно знать, что у нас с CPU, памятью и дисками.
Нужно знать, что происходит с 1С и СУБД. Для этого можно использовать шаблон для Zabbix. Потратили условный час на настройку – уже знаете, что происходит с блокировками и сеансами.
Дальше – централизованные логи. Подойдет любое решение, которое позволяет их собрать и искать.
Следующий пункт – несколько осмысленных алертов. Не 200 и даже не 100, а только те, по которым действительно понятно, что делать. Например: сервис недоступен, база не отвечает, резко выросло время критической операции или массово пошли ошибки обмена.
Sentry позволяет достаточно быстро с этим работать: однотипные ошибки группируются в события, и их очень удобно отсматривать.
Еще один важный элемент – один экран с ответом на вопрос: что происходит сейчас? Если этого экрана нет, достаточно тяжело ходить по всем системам и собирать данные из каждой отдельно. Лучше использовать, например, Grafana или тот же Zabbix и вывести туда основную информацию.
Базовый стек из уже озвученных инструментов может выглядеть так: Zabbix – инфраструктура и доступность; Prometheus – если нужны расширенные аналитики; централизованный логовый контур; Sentry – чтобы собирать ошибки; Apdex – чтобы замерять проседание процессов по времени выполнения.
Это не идеальная система. Но она очень быстро настраивается, достаточно проста в эксплуатации и практически не требует глубокого погружения. При этом это уже контур, с которым можно работать практически в любом инциденте.
В реальности лучше иметь неидеальный, кривой, косой, но рабочий контур, чем год искать нужное решение или использовать дорогие системы, для внедрения которых потребуется еще и дополнительное согласование.
5 ошибок, которые ломают мониторинг
Кратко обсудим ошибки, которые часто допускают.
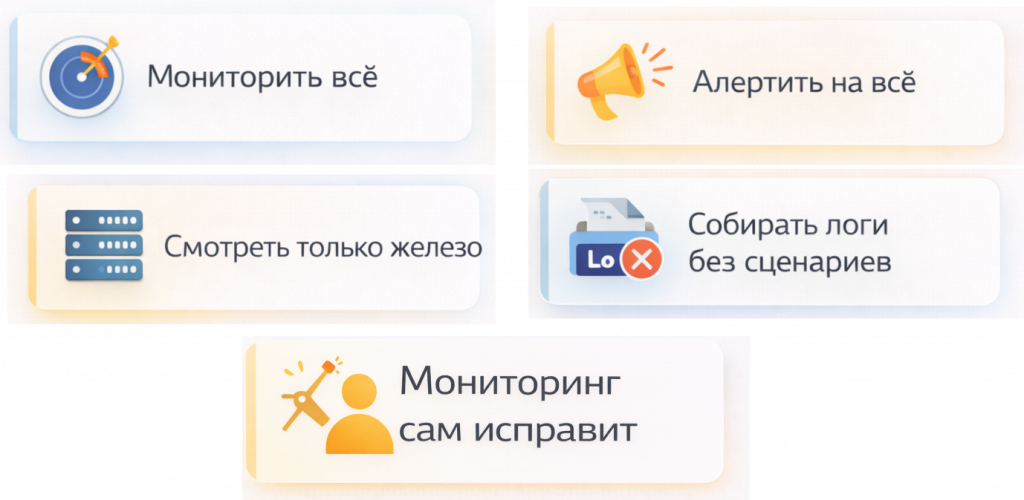
Первая – мониторить вообще все, когда нет понятных сценариев использования данных.
Вторая – делать алерты на все подряд.
Третья – мониторить только железо. Это хорошо, но этого мало. Обычно этим занимаются администраторы, а им прикладной контекст, как правило, уже не так важен.
Четвертая – собирать логи без сценариев использования. Если вы не понимаете, как ими пользоваться, как в них искать и не проработали эту схему, то, скорее всего, от них будет мало пользы.
Пятая – думать, что мониторинг исправит все сам. К сожалению, нет. Более того, внедряя мониторинг, вы, скорее всего, увидите гораздо больше, чем хотелось бы увидеть, потому что окажется, что проблемы уже есть, просто раньше вы о них не знали.
Мониторинг помогает и с коммуникацией во время инцидентов, потому что у вас появляются хорошие ответы на вопросы: каков масштаб, что затронуто, какая текущая гипотеза и что команда должна сделать прямо сейчас.
В результате
Вернемся к нашему понедельнику.
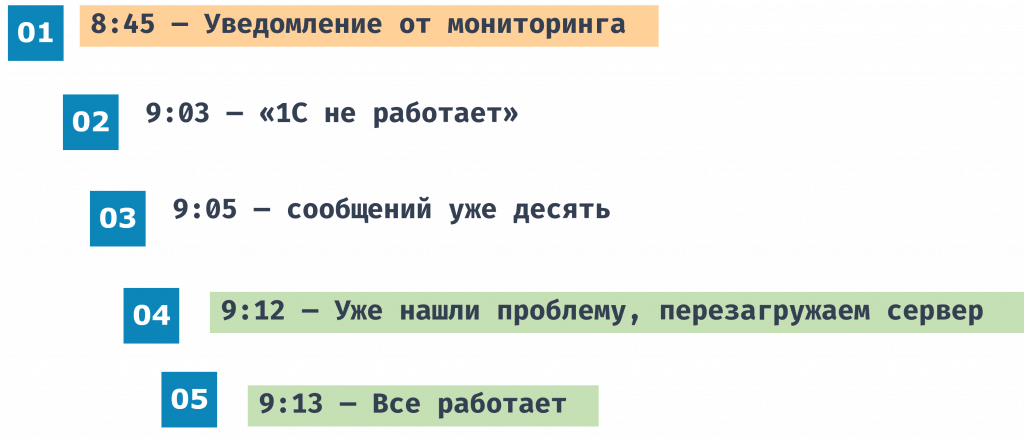
Теперь в 8:45 нам прилетает уведомление от мониторинга о том, что постоянно падает rphost.
Через пару минут в чат приходит сообщение: «1С не работает». Потом таких сообщений уже десять. Но к этому моменту мы уже увидели, что проблема началась, например, после запуска пересчета индекса полнотекстового поиска. Мы его остановили, перезапустили службу – через минуту все работает. И после этого уже можем позволить себе в спокойном режиме углублять расследование.
Финальная мысль очень простая: мониторинг – это способ сократить путь от жалобы пользователя до технической гипотезы.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

