1С Батл: PostgreSQL 9,10 vs MS SQL 2016
База данных - Администрирование СУБД
Предыстория
MS SQL – наш давний друг. И около 15 предыдущих лет мы жили с полной уверенностью, что для 1С нет лучшего выбора, чем MS SQL. Oracle - сильно дорого, IBM никто в живую не видел, а про Postgres на тот момент совсем ничего не было слышно.
Примерно пять лет назад в мире 1С начал появляться Postgres, за что большое спасибо команде Postgres Pro: Олегу Бартунову и Федору Сигаеву, которые продвинули эту СУБД. Как раз в это время у руководства нашей компании появилась задача резко вырасти в масштабах ИТ-инфраструктуры 1С. При этом была поставлена задача максимально сэкономить бюджет. Мой хороший друг, а по совместительству эксперт по техвопросам 1С сказал: «Антоха, кто не рискует, тот потом на Инфостарте не выступает!». И мы рискнули. И я выступаю на Инфостарте.
Первый опыт работы с PostgreSQL на Windows
С чего мы начали? В 2014 году рискнули перевести 5 баз 1С общим объемом порядка 100 гигабайт на Postgres. Не сразу стали перепрыгивать бездну нашего незнания между Windows и Linux, а мир 1С, мне кажется, до сих пор на 80% это мир Windows. Поэтому сначала решили перепрыгнуть пропасть незнания между двумя базами данных: MS SQL и PostgreSQL.
Мы запустили Postgres на Windows. Сначала сильно удивились, что оно заработало. В целом все завелось, заработало, даже база открылась. Правда, потом начались бессонные ночи и дни без обеденного перерыва в попытках настроить Postgres так, чтобы он работал хорошо.
На момент 2014 года информации никакой нет. Есть английская документация, а в мире 1С английский язык не в почете: вы даже код пишете на русском. Поэтому читать тяжело, понимать еще тяжелее. И по сравнению с дружественным интерфейсным MS SQL, где вся настройка – это 5 галочек и 2 цифры, настройки в Postgres – это сотни параметров, слишком непонятно, как и на что отреагирует система, отреагирует ли вообще. Менять приходилось по одному параметру, потому что иначе вообще не поймешь, на что была реакция. А очень часто смена одного параметра не давала никакой реакции. Вот так мы и жили примерно полгода до момента обнаружения той самой ошибки, которая сейчас уже исправлена. О ней рассказывал Олег Бартунов.
Это была фантастика. Я на прошлой конференции по Postgres в Москве рассказывал об этом отдельно. Мы долго не верили своим глазам, будучи уверенными, что это мы неопытные и неправильно настроили систему. Потому что не может так база данных себя вести.
Там происходило очень чудесная вещь: у Postgres есть много файлов статистики. Один из них на весь сервер, и он переименовывается несколько десятков, может быть, сотен, может быть, тысяч раз в секунду. Так построена система: она создает рядом новый файл статистики, переименовывая его в действующий. А наша любимая Windows не дает так работать с файлами в своей файловой системе. Если файл кто-то читает, переименовать его нельзя. Postgres по-честному пишет, что у него нет доступа к статистике, поэтому он будет использовать старые файлы. Ладно, используй. Но нет, происходило 15-ти секундное торможение всего сервера, просто на 15 секунд останавливались все транзакции.
Мы долго не верили своим глазам, мы боялись рассказать это разработчикам. Что они бы подумали? Что какие-то дураки взялись за систему, и теперь непонятно, что от нас хотят. В итоге мы боролись-боролись, но не побороли. И все-таки написали письмо в Postgres Pro. Там тоже долго удивлялись, не верили, что такое может быть. Потом подтвердили, что, действительно, есть косяк. Пообещали исправить.
Отказ от Windows
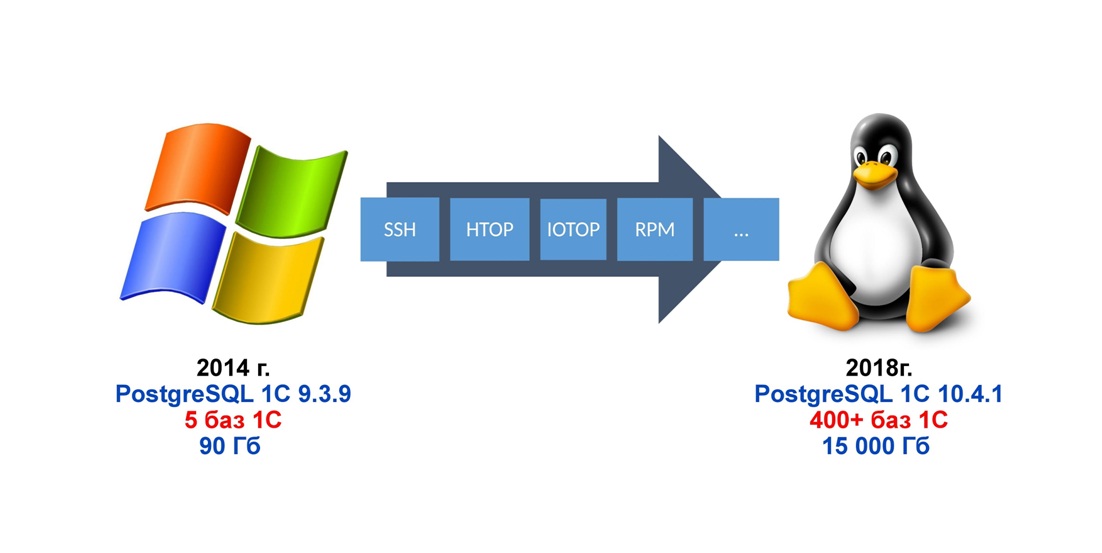
Но у нас время поджимало. И мы решили прыгать через пропасть незнания в Linux. Это вообще кошмар. То есть система Linux – хорошая, но кошмар для админов, которые всю жизнь жили на Windows. Ни красивых окошек, ни мышек, ни кликов, даже диспетчера задач нет. Есть какие-то черные окна с белыми буковками. Когда разберешься, буковки станут цветными. Но это все, что ожидает админа в Linux. Какие службы работают, как что куда поставить – ничего не понятно. Там уже бессонные ночи начались не только у 1С-ников, но и у админов. Но примерно на 20-ой инсталляции CentOS все, вроде, стало хорошо.
Запустили Postgres, и он тоже заработал. А мы к тому времени уже были крутые чуваки в настройке Postgres, и мы его сразу настроили: и статистику внесли в оперативную память, и все параметры включили как надо.
На текущий момент мы пришли к такой ситуации: у нас 400 с лишним баз, 15 терабайт данных, все это крутится на Postgres на Linux, все сервера Postgres имеют реплики, кто-то имеет каскадные реплики, кто-то имеет несколько реплик на один мастер. То есть это не просто какая-то одноранговая система баз данных. Мы там снимаем бэкапы (backup) с реплик, мы можем восстановить бэкап с рабочей базы в тестовую или базу разработчиков одной строчкой, сохраняя транзакционную целостность данных, при этом не создавая файла бэкапа.
Самое удивительное – все есть в документации! Ты на грабли наступил уже 15 раз, все попробовал, думаешь, что «открыл Америку». Заходишь в документацию, а там прямым текстом написано все то, что ты открывал до этого три дня. Понимать эту документацию ты начинаешь только тогда, когда несколько раз уже окунулся в саму практику.
Так мы счастливо живём до сих пор.
Тестирование
В какой-то момент задумались, а может, нам страсть к Postgres на Linux застила глаза, и нам только кажется, что все хорошо работает. Решили попробовать подтвердить, что работает как минимум не хуже чем с MS SQL, а может быть, если и хуже-то, то совсем чуть-чуть.
На самом деле, когда приступали к нагрузочному тестированию, вся моя команда, скрестив пальчики думала, ладно, пусть Postgres проиграет, но проиграет не сильно. Все-таки он еще новенький, может быть, нами еще не до конца изученный, но очень активно развивается, и как рассказывал Олег Бартунов, будет очень много крутых фишек в версиях 10 в 11.
На момент организации нашего батла была версия 9. И мы решили, что площадкой для батла будет Windows 2012 R2. Почему Windows? Это для того чтобы соревнование было совсем честным, не учитывая операционные системы, просто проверка двух баз данных.
Итак, в красном углу ринга – заслуженный чемпион, обладатель всех поясов производительности 1С, имеющий любые регалии в мире 1С – Microsoft SQL server версия 2016, последняя поддерживаемая на данный момент.
В синем углу ринга – наш новичок, претендент, PostgreSQL. Он выступает сразу двумя бойцами, каждый бьется по очереди. Это Postgres 9.6 и Postgres 10. Обе версии на данный момент поддерживаются 1С.
Платформа взята последняя релизная на момент тестирования. Все сервера баз данных располагаются на одном и том же железе, это прямо одна и та же коробочка. Все настроено оптимально: и дисковые подсистемы, и процессор, и сервера баз данных (оптимально, согласно требованиям фирмы 1С и нашему опыту). Плюс к этому все настроено на многопользовательскую нагрузку, в том числе параллелизм отключен: и на MS SQL, и на Postgres стоят единички.
Первый раунд
В первом раунде тяжелая операция – загрузка DT 40 с лишним гигабайт, итоговая база почти 2 терабайта. Сразу оговорюсь, если заглянуть в интернет, там будет много информации о том, что в DT не выгружается база, потому что она более 100 гигабайт, и ничего не работает. Все работает, надо только правильно настраивать сервер 1С, надо понимать, куда сервер 1С выгружает DT. Подтверждаю на своем опыте: база до 5 терабайт (больше не приходилось выгружать) из DT загружается и в DT выгружается. Все остальное – это неумение настраивать сервера 1С.
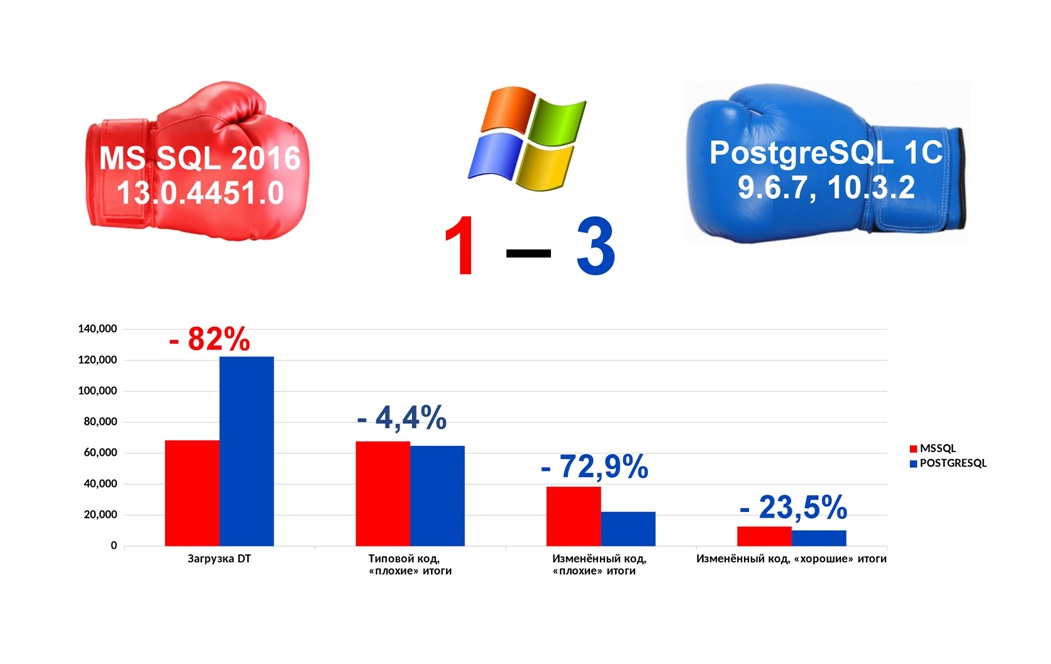
Первые результаты. С явным преимуществом побеждает MS SQL. Он в 2 раза быстрее загрузил данные в DT. Оба загружали очень долго, Postgres – почти двое суток, а MS SQL – почти сутки.
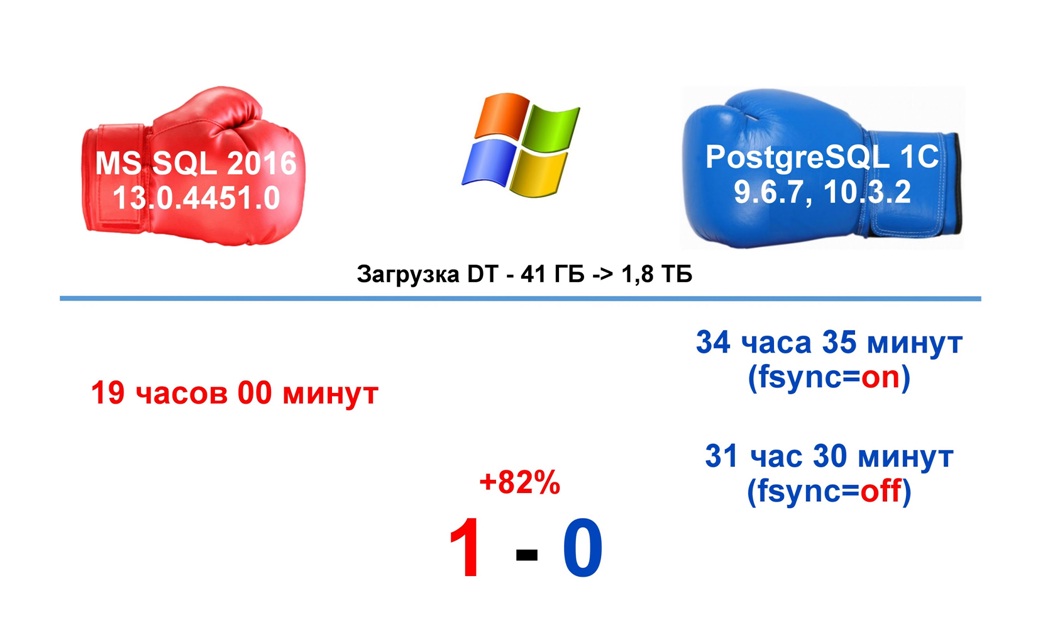
В то время как раз был шум про мельдоний (скандал в СМИ), и мы тоже решили обратиться к допингу. Решили использовать топ вредных советов из интернета на запрос «1С + Postgres тормозит». Первый совет – отключить fsync. Отключили. Получили другой результат – на 10% быстрее, чем с включенным, но риски несоизмеримы. Потому что такое отключение приведет к потере всего сервера баз данных. Вы не сможете ничего восстановить при аварийном завершении. Никогда так не делайте! Это самый вредный совет, который только может быть. Если вдруг вам действительно помогло отключение fsync, и все заработало в 10 раз быстрее, Это значит что у вас сервер неправильно настроен, начиная с самого низкого уровня – с железа, с дисками.
Fsync отключать нельзя никогда!
Но что такое есть в Postgres, что он загружает данные в DT в 2 раза дольше? Наши исследования показали, что это «create index». Он создает индексы намного медленнее MS. В начале 2018 года разработчики обещали, что в версии 12 эта ситуация улучшится. Ждем с нетерпением, думаю, тогда даже в этом раунде мы будем близки к MS SQL.
Второй раунд
Тут уже практически пользовательская нагрузка. Операция, на которой проводится тестирование, – восстановление последовательности партионного
учета управленческих партий. Это последняя УПП на момент тестирования, код типовой. Также типовой клиент, у которого итоги рассчитаны на полгода назад. Я не знаю, почему у клиентов такая амнезия по поводу этой регламентной операции, но никто не хочет следить за итогами. Почему, никто объяснить тоже не может. Поэтому берем типовой код, типового клиента, в самих партиях за месяц 150 тысяч документов, а строк в документах около 2 миллионов.
Все это делаем в 10 потоков. Это уже чуть-чуть не типовой этап, сделана определенная обработка, но внутри все запросы типовые.
В результате у нас получилось, что Postgres всего на 4% лучше. Делалось все очень долго – порядка 18 часов. И бухгалтеры будут вынуждены весь день не работать, чтобы дождаться результатов.
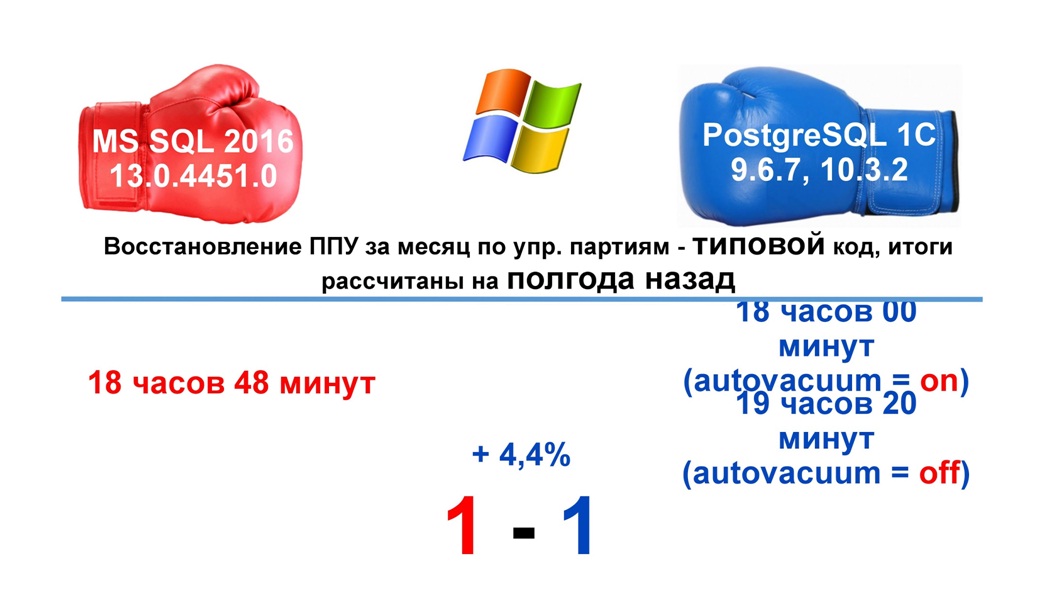
Поскольку результат получился не очень большой, плюс 4%, решили вместо
мельдония использовать что-нибудь похлеще. Второй в рейтинге вредных советов интернета на запрос «1С + Postgres тормозит» оказалась рекомендация отключить autovacuum. Отключили.
Результат получился еще хуже – примерно на 5%. То есть если бы мы изначально настроили систему с помощью этого вредного совета, мы бы вообще раунд полностью проиграли, было бы минус 0,6%.
На этом хочу остановиться чуть подробнее. Что за зверь такой autovacuum, зачем он нужен. И почему разработчики Postgres на каждой конференции твердят: «Не отключайте autovacuum!», но народ упорно его отключает. Попытаюсь объяснить, как говорят, на пальцах.
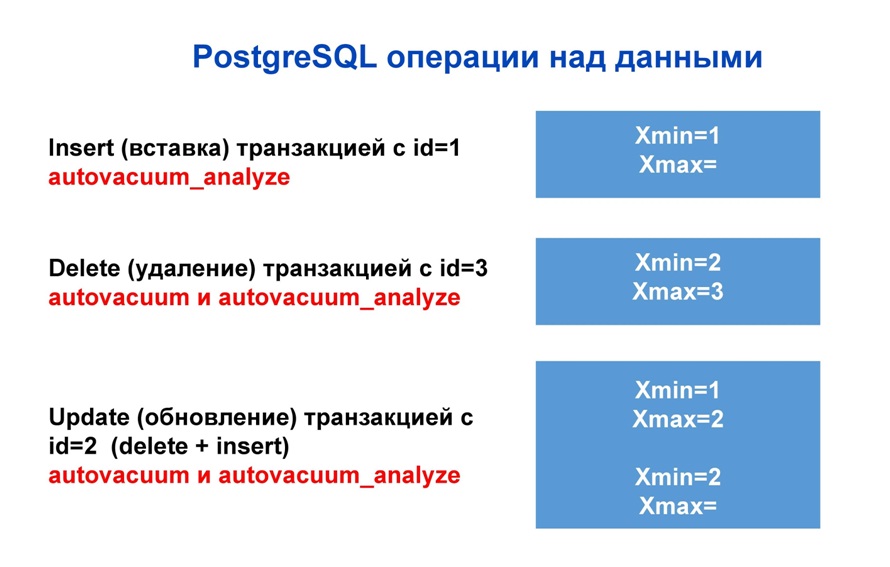
Чтобы понять, для чего нужен autovacuum, нужно понять, как Postgres работает с данными. Операция insert – записали строчку. Помимо строчки, пишется еще два служебных параметры x min и x max. В x min записывается номер транзакции, которая выполнила этот insert. Операция delete на самом деле ничего не удаляет, она просто в служебное поле строки x max записывает номер транзакции, которая ее удалила. Потом идет самая прикольная операция update. На самом деле нет такой операции, это просто delete + insert.
А в мире 1С, к сожалению, просто обожают работать задним числом: для пользователей не вопрос перевести месяц или год. То есть апдейтов миллионы. У нас не столько растут данные с помощью insert, сколько с помощью update, мы постоянно что-то обновляем. Из-за этого база имеет эффект распухания. Ладно, пусть раздувается, скажем админам, что это их проблемы, пусть увеличивают диски. Они увеличат. Но если было бы все так просто, никто не заморачивался бы. Проблема в том, что данные хранятся не где-то в сферическом вакууме, они хранятся в страницах. И когда у вас в страницах хранится куча мертвых данных, а в Postgres есть такое страшное понятие, как мертвые строчки, и когда вы делаете запрос базе данных, движок вынужден поднять все страницы с данными, отфильтровать данные, в которых x max пустой, и только с ними потом работать. Вы каждый раз заставляете Postgres ставить олимпийские рекорды по поднятию данных с дисков, чтобы выдать вам выборку.
Что делает autovacuum? Autovacuum – это своеобразный пылесос, он циклически и периодически идёт к каждой таблице вашей базы данных и делает выборку всех данных, где x max не пустой и чистит их физически. Теперь туда insert возможен, у вас на страницах будет больше живых данных, чем мертвых. Эффект – вам проще поднимать страницы. Это первое.
Второе. Помимо чистого autovacuum, есть еще такой фоновый процесс autovacuum analyze. Это аналог фонового обновления статистики в MS SQL. Без него планировщик никогда не узнает, что вы в таблицу добавили данные. Было в таблице 100 записей, добавили вы миллион записей, но планировщик свято уверен, что там их 100. И при любом запросе не парится и не ищет никакие индексы. Он просит TableScan, ему его дают, а там миллион записей. И вы сидите и ждете несколько минут.
Поэтому никогда не выключайте autovacuum. Надо его правильно настраивать, но ни в коем случае не отключать. Он имеет кучу настроек, и если у вас autovacuum настроен достаточно агрессивно, то есть он срабатывает на очень маленьком проценте изменения данных в таблицах, то вам не нужны даже ночные и недельные регламенты над базой данных, которые имеются у MS SQL. Ничего не надо делать, просто ничего. Кое-что делают только админы, если точно знают, что в этой таблице недавно удалили огромный массив данных, и ее нужно, грубо говоря, сжать. Тогда делается autovacuum full – это реструктуризация таблицы в понятиях 1С. Рядом создается табличка, куда и копируются данные.
В других случаях вам никакие регламенты, ни ночные, ни недельные, не нужны. Autovacuum все сделает за вас. Только настраивайте его правильно.
Третий раунд
Та же самая операция, но бойцам меняем тренера. Приглашаем эксперта по техвопросам, он месяц чешет затылок, два часа кодит, меняет пару запросов. Особо большой эффект дал запрос, где поменяли получение остатков на момент документа. Клиент остается типовой с амнезией по поводу пересчета итогов. Запускаем!
В этом раунде Postgres выигрывает с явным преимуществом.
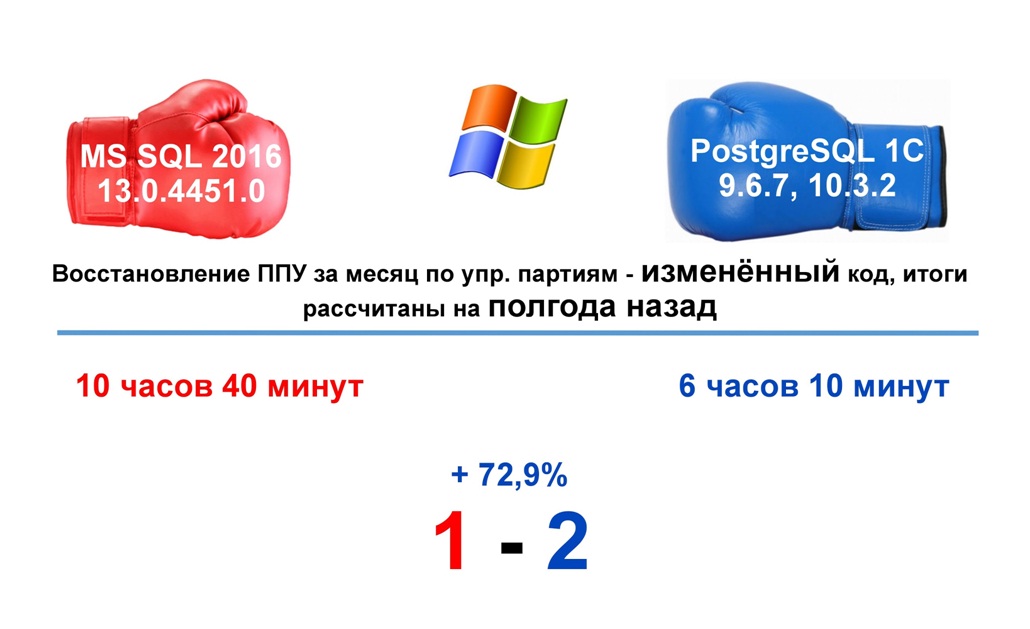
Гораздо благодарнее отнесся к более правильному коду, код правильный в той части, что поднимает гораздо меньше данных, намного меньше данных. Postgres выиграл почти в 2 раза, а по сравнению с изначальным временем выполнения процедура целиком стала выполняться в 3 раза быстрее. И это после вмешательства компетентного специалиста 1С, который понимает, что делать. Я даже думаю, что, обновив весь сервер за космические деньги, вы вряд ли добьетесь большего ускорения, если будут неправильные запросы.
Ничего бы этого не произошло, и этого бы доклада не было, и Postgres бы у меня не было, если бы в свое время Фёдор Сигаев – ведущий разработчик команды Postgres Pro, а также один из всего лишь двух коммитеров во всей России не создали патч OnlineAnalyze для 1С.
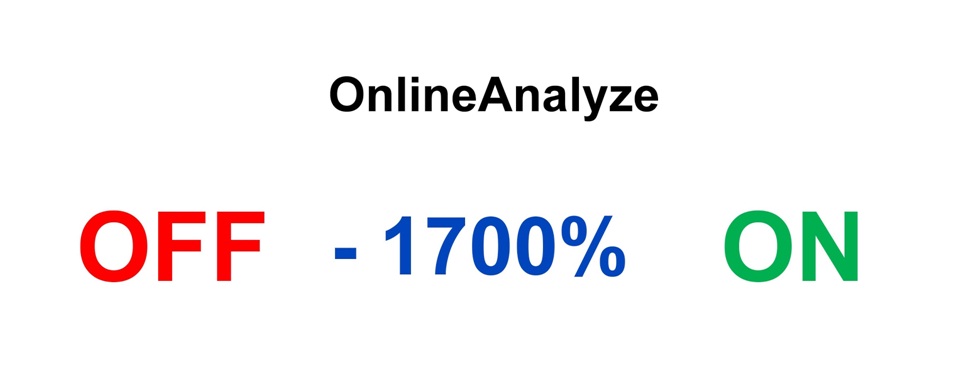
Что это такое? Во всем нормальном мире база данных считает, что временные таблицы – это чуть ли не ошибка проектировщика базы данных, и уж точно ошибка программиста, который просто не умеет писать правильные запросы. И считает, ну ладно, раз уж так случилось, простим, создадим этим неучам временную таблицу. Она в любом случае будет очень маленькой – на сотню, может, тысячу записей, но ни в коем случае не на миллионы и не на миллиарды, как это в 1С сделано. 1С вся построена на временных таблицах: на любой запрос мы создадим временные таблицы. И тут возник вопрос о быстродействии Postgres в связи с этим. Postgres крайне прохладно относится к временным таблицам, он их вообще «за людей не считает». Это просто какой-то артефакт, который создался. А мы же когда пишем кода в 1С, мы даже индексируем временные таблицы (прямо индексы по ним создаем). А Postgres на все плевать, потому что планировщик просто не в курсе, что это за временная таблица, сколько там записей, что в ней есть индекс. Он ничего не знает. Он всегда пользуется TableScan и все.
И был разработан патч OnlineAnalyze, который заставляет наш autovacuum analyze, грубо говоря, проверять и временную таблицу. Причем, заставляет ее проверять мгновенно во время создания и еще каждые новые тысячи записей. Он их проверяет, анализирует, и таким образом у нас планировщик запросов четко знает, сколько записей в этой таблице, что за индексы по ней, и строит запрос правильно.
Ради интереса отключили OnlineAnalyze. Получили результат тестирования в 17 раз хуже. Мы прождали несколько дней, она у нас все-таки посчитала, результаты упали в 17 раз.
К сожалению, в своей практике сталкиваюсь очень часто и даже на очень крупных предприятиях, на которых есть Postgres и которые уже поискали ответы в интернете на запрос «1С + Postgres тормозит», что люди следуют этим 2 вредным рекомендациям. А тем временем в самом конце конфигурационного файла есть строчка OnlineAnalyze.enable = off. Но если поправим настройку на on, все взлетает.
Я вас призываю, если у вас уже стоит Postgres, посмотрите свои конфигурационные файлы. И включите патч, включите! Это очень крутая вещь.
И еще один момент. В последней сборке Postgres, опубликованной на сайте 1С, к сожалению, этого патча нет. Его просто нет в строчке предкомпилированных библиотек, он в настройках есть и даже внизу включен, но его нет в строчках предкомпилируемых библиотек. Надо добавить. Внимательно отнеситесь: патч должен быть, патч должен быть включен. И будет резкий рост производительности.
Финальный раунд
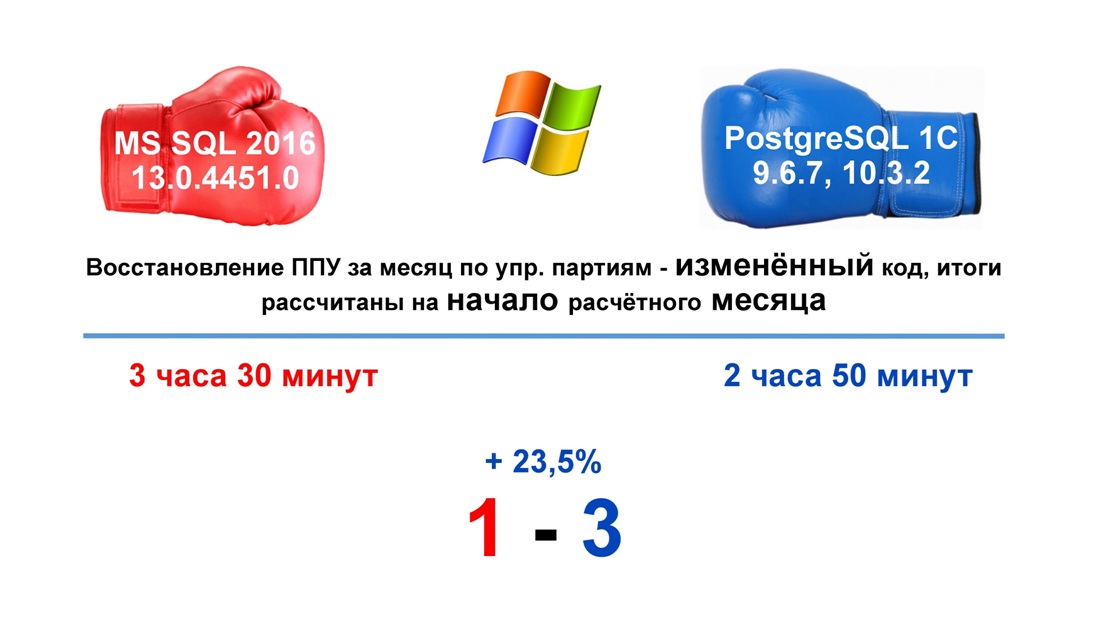
На этот раз меняем нашего типового клиента на идеального, который не страдает амнезией, и пересчитываем итоги на начало расчетного месяца. Запускаем ту же самую операцию. Получаем еще раз двухкратное ускорение той же самой операции, а по сравнению с первыми результатами, когда операция длилась почти 18 часов, ускорение в 6 с лишним раз.
И тут Postgres опять выиграл. Он опять более благодарно отнесся к порядку в данных, чем MS. Выиграл не так круто, как на старых итогах, но все-таки на четверть быстрее – это очень серьезный результат.
Итоги батла
Итак, Postgres выиграл со счетом 3:1. Но хочу обратить внимание, что на пользовательских нагрузках, а именно многопоточное проведение документов, участвующих в восстановление последовательности партионного учета, Postgres выиграл вообще со счетом 3:0. Вот такие противоречивые результаты.
Postgres на Linux и Postgres на Windows: что лучше
Сами удивились, сами себя похвалили, какие мы молодцы, что 5 лет назад сделали крутой выбор. Но встречаем очень часто вопрос: стоит ли переходить на Postgres.10 на Windows.
Тот самый злополучный баг Postgres, когда система замирала на 15 секунд из-за недоступности файла статистика исправлен в версии Postgres 10.4.1. Говорю об этом отдельно, потому что эта версия на данный момент 1С не поддерживается. Она есть только на сайте Postgres Pro, мы ее поставили и запустили ради этой конференции. Что получили? При 10 потоках все почти одинаково, что на Postgres версии 9, что на Postgres версии 10. При 20 потоках Postgres.10 в 3 раза быстрее. Я бы даже сказал иначе: Postgres.9 на Windows в 3 раза медленнее, потому что возникает та самая блокировка, замирание на 15 секунд. Причем, оно рандомное, то есть вы не угадаете, это будут замирания один раз в минуту или у вас будет секунда работы, 15 секунд замирание и так тысячу раз.
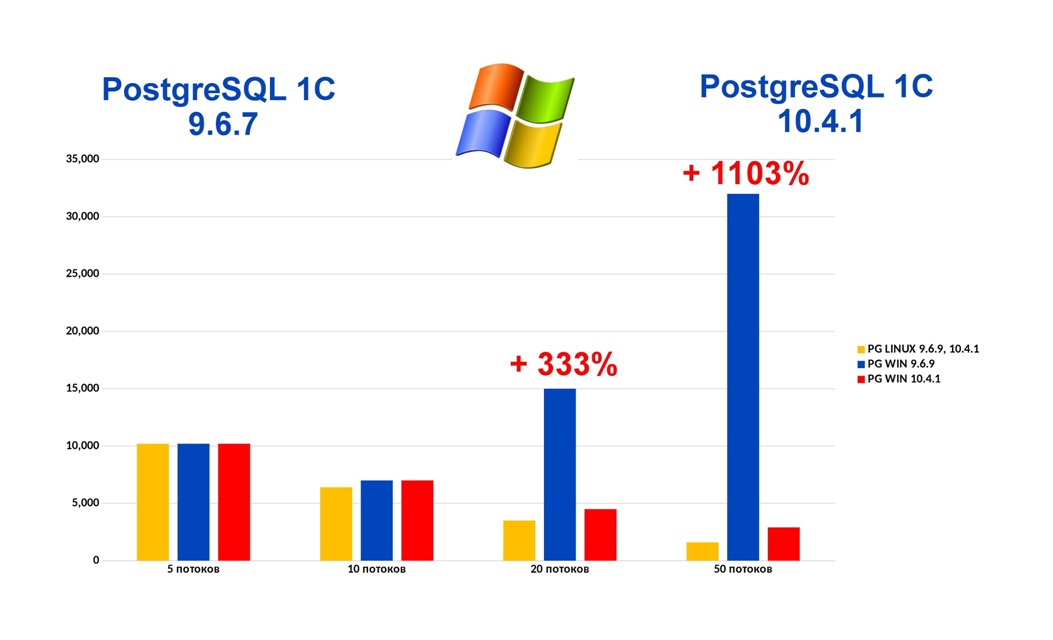
При 50 потоках Postgres.9 медленнее в 11 раз. При 100 потоках мы не дождались завершения операции. Данные я не привожу. Нам надоело: мы неделю ждали.
Второй самый популярный вопрос, стоит ли переходить на Linux? Да, стоит переходить! По нашим данным, а они у нас достаточно релевантные – 15 терабайт и 400 баз, Postgres работает почти в 2 раза быстрее.
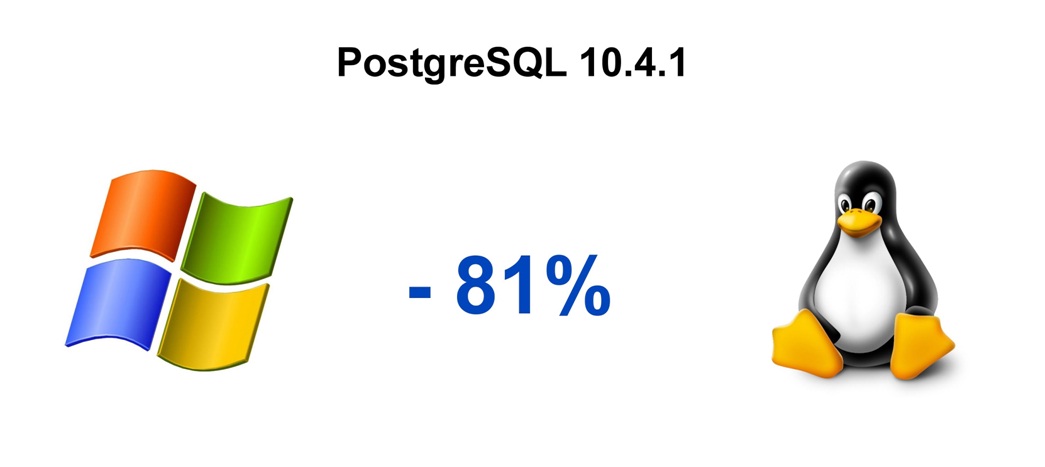
Почему? Не потому что Postgres такой плохой на Windows, а потому что файловая система Windows не способна обрабатывать такое большое количество файлов. Тут вся фишка в том, как Postgres и MS хранят файлы. Если MS хранит по умолчанию всю вашу базу данных в двух файлах (это файл данных mdf и файл журнала транзакций lgf), то Postgres хранит каждую таблицу в отдельном файле и каждый индекс в отдельном файле.
Типовая база бухгалтерии содержит 6 тысяч таблиц и 20 тысяч индексов. Значит, одна база будет в Postgres представлена 26 тысячами файлов. На наших серверах мы примерно делаем по 60 баз на один instant Postgres, это в районе 2 миллионов файлов. С таким количеством файлов Linux управляется, как мы видим, почти в 2 раза быстрее, чем Windows.
Поэтому если вы уже всерьез на Postgres, а всерьез – это наличие хотя бы 20 сессий, начинайте подумывать о переходе на Linux. Причем, не обязательно железный, можете на этой же винде, если сильно страшно, то поднимите hyper-v, поднимите виртуалку, на эту виртуалку ставьте Linux, ставьте Postgres, и получите отличный эффект. Проверено!
Два важных момента
Хочу обратить еще внимание на два небольших досадных недоразумения, которые пока есть еще в Postgres. Первое недоразумение – это такой параметр по настройке default_statistics_target. Это своеобразный множитель количества страниц, который берет Postgres для расчета статистики. Он этот множитель умножает на 300 и берет такое количество страниц. Множитель может иметь значение от 1 до 10 тысяч, по умолчанию 100. Все хорошо работает при сотке. Но как только мы ставим 10 тысяч, Postgres, действительно, берет много страниц, считает статистику, но потом запросы к базе начинают резко тормозить. К разработчикам мы еще с этим не обращались, вот-вот обратимся, думаю, победим и разберемся.
Второй момент – это репликация. Просто обращу ваше внимание. Разработчики говорят: репликации – это не бэкап. Это действительно так. Кроме того, репликация может отставать на часы и дни. Потому что она однопоточная. Все, что мастер-сервер удалил, создал, обновил в сотне своих потоков, все это придется догонять в один поток. Поэтому реплика это хорошо, мы, например, с нее бэкапы льем, но перед тем, как слить бэкап с реплики, мы проверяем какое отставание. Если отставание не больше секунды, то делаем бэкап с нее, а если больше – то с мастера.
В завершение хочу сказать, что, привлекая компетентных специалистов, вы можете зарабатывать золотые медали любых тестов 1С. Даже на таком новичке в мире 1С, как Postgres, выбирая правильную инфраструктуру.
Данная статья написана по итогам доклада, прочитанного на конференции INFOSTART EVENT 2018 EDUCATION.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
HighLoad оптимизация Администрирование СУБД Разработчик 1С:Предприятие 8 1С:ERP Управление предприятием 2 Бухгалтерский учет Бесплатно (free)
После миграции с MS SQL на PostgreSQL закрытие месяца в 1С:ERP стало идти 8 часов вместо 12 минут. Рассказываем, как мы нашли причину в оценке Hash Join, которую планировщик завышал в миллионы раз, и как исправили её так, что проблемный запрос теперь выполняется за 18 секунд вместо часа.
19.10.2026 1019 Tantor 0
Администрирование СУБД Сервера Системный администратор Разработчик 1С:Предприятие 8 Россия Бесплатно (free)
Примеры скриптов для работы с автономным сервером (ibsrv).
09.10.2026 1162 hexhoc 6
Администрирование СУБД HighLoad оптимизация Разработчик 1С:Предприятие 8 1С:ERP Управление предприятием 2 Россия Бесплатно (free)
Большинство материалов о компрессии в PostgreSQL отвечают на вопрос «во сколько раз удалось уменьшить базу». Мы предлагаем посмотреть на проблему с другой стороны — какой ценой достигается эта экономия? В статье разбираем архитектурные компромиссы различных подходов к компрессии страниц, объясняем, почему при разработке CSM в Tantor Postgres отказались от погони за максимальным коэффициентом сжатия, и показываем результаты нагрузочных испытаний на реальных базах 1С.
01.10.2026 1514 Tantor 6
DevOps и автоматизация разработки Администрирование СУБД Групповая разработка (Git, хранилище) Разработчик 1С 8.3 Абонемент ($m)
В корпоративных инсталляциях «1С:Предприятие 8.3» под управлением PostgreSQL всё чаще проявляются архитектурные пределы масштабирования: рост числа пользователей, обязательная маркировка, плотный поток API-интеграций и высокая стоимость простоя. Вводная часть цикла разбирает ключевые факторы современной эксплуатационной нагрузки и формирует инженерную методологию эволюционной модернизации без остановки продуктивного контура. Материал основан на практическом кейсе «Торговый контур» и показывает, как определить целевые метрики (p95, MTTR, APDEX), выстроить наблюдаемость, стабилизировать работу кластера и подготовить инфраструктуру к дальнейшему масштабированию. Публикация задаёт фундамент для последующих частей, посвящённых телеметрии, оптимизации PostgreSQL, CI/CD и архитектурному росту.
1 стартмани
10.09.2026 1572 Ninel_S 0
HighLoad оптимизация Администрирование СУБД Разработчик 1С:Предприятие 8 1С:ERP Управление предприятием 2 Бесплатно (free)
В рамках 18 релиза СУБД Tantor Postgres мы рассказывали об оптимизациях, которые помогают планировщику сделать более точный выбор между Nested Loop и Hash Join. В следующем релизе у нас планируются оптимизации, которые позволят ускорить выполнение как Nested Loop, так и Hash Join. Сегодня мы расскажем об одном из таких методов - фильтре Блума.
31.08.2026 6174 Tantor 3
Администрирование СУБД Системный администратор Разработчик 1С 8.3 Бесплатно (free)
Мы подготовили для сообщества Infostart.ru практическое занятие, в котором каждый желающий сможет: научиться собирать реальные данные о процессах кластера 1С; выявлять «перестарков» — процессы старше периода и без соединений; выполнять безопасный перезапуск (с dry-run и подтверждением); настраивать автоматическую проверку через systemd на Linux; отправлять уведомления (Telegram, почта) при обнаружении проблем; работать с логами, ротацией, профилями кластеров и конфигурацией; развернуть полноценный учебный проект AdminClusterMonitor у себя в тестовой среде.
30.08.2026 1774 Ninel_S 2
Администрирование СУБД Системный администратор 1С:Предприятие 8 Бесплатно (free)
На infostart.ru вышел разбор Ивана Недомолкова «Сервер 1С падает: настройка сбора дампов (logcfg.xml), лимиты памяти и передача дампа в поддержку» - это хорошая инструкция, как ловить и разбирать падение rphost постфактум: logcfg.xml, procdump, анализ дампа. Но там нет ответа на вопрос «а почему кластер вообще прибил процесс сам, ещё до всякого краша». Мы дополняем разбор тремя сводными таблицами лимитов памяти и автомасштабирования кластера - и заодно фиксируем, чем в этой части лицензия ПРОФ урезана относительно КОРП.
12.08.2026 2531 Ninel_S 5
Администрирование СУБД Системный администратор Разработчик Бесплатно (free)
5,5 тысячи пользователей в единой базе 1С, розница в режиме 24/7 и SLA 99,98% – в таких условиях любая авария быстро превращается в очереди на кассах, потерю денег и давление со стороны бизнеса. Показываем, как выстроить процесс аварийно-восстановительных работ: от первых алертов и базового скрининга системы до подключения команды, проверки гипотез и дебрифа после инцидента. Разбираем, как метрики, дашборды, техжурнал, Zabbix, Prometheus, Grafana, Telegram-боты и скрипты помогают не гадать, а быстро находить причину проблемы. На реальных авариях объясняем, почему «быстро» не должно означать «рискованно», как работа над ошибками снижает панику и почему каждая авария может сделать систему надежнее.
11.08.2026 3455 jul.dolganova 9
А какой был режим совместимости платформы в УПП? Есть опыт, в котором изменение режима совместимости УПП с 8.2 до 8.3.7+ положительно влияло на производительность платформы с postgres (так как разработчики что-то там оптимизировали).
Снятие режима в целом положительно влияет в разных моментах, по крайней мере точно не становится хуже, но в этом тесте специально брали Типовую УПП.
Не говоря уже о том что 1С то тут как раз по большей части достались порицания, а не хвальба...
Дуэлль - пока не о чем)))
Пусть сначала объяснит позицию и там посмотрим.
Ну и обвинения в подтасовках и манипуляциях слишком серьёзны!!! чтобы оправдывать их тем, что не было уделено внимание конкретным настройкам БД. Хотя при этом и в выступлении и в тексте стаьии написано что сервера настроены оптимально.
А внимание на настройки PG было обращено по причине, опять же озвученной и в выступлении и в статье, на просторах сети слишком много вредных советов, резульиаты исполнения которых я и озвучил.
Вячеслав, сначала объяснитесь, а потом уже я подумаю отвечать на Ваши вопросы или нет.
"видео конференции скоро будут - выложим до конца февраля для участников"
т.е. как вы выбираете какую операцию тестировать так не манипуляция, а как я хочу другую выбрать операцию - так сразу манипуляция
ну-ну
У автора получилось ускориться, он поделился своей success story, что в этом плохого и кого он ввел в заблуждение?
но вот другим он говорит что postgres рвет скуль налево и направо, хоть и косвенно но намекает очень жирно
вцелом - это упрощение
у 1С тоже все работает вцелом, но есть нюансы :)
как вы поняли что если ускорилась операция 1 то и все остальное залетало?
оптимизированный код под конкретные условия чаще всего будет выигрывать у "типового" кода который не учитывает например особенности аппаратных ресурсов
если я знаю что диски значительный запас имеют, а процессорных ядер не хватает то я одним способом сбалансирую код
а если наоборот, диски дохлые, то постараюсь как можно меньше их трогать
Сначала кажется что Вам просто не нравится как подан материал, но потом складывается впечатление что Вы считаете что PostgreSQL не лучше MS SQL.
А как же тогда "Мы сами используем PostgreSQL" на странице ?
подача материала мне не нравится тем, что доверчивые люди решат что PostgreSQL решит все их проблемы с производительностью - т.е. заменил "плохой" скуль на "хороший" PG и сразу счастье наступило
потратит время, нервы и разочаруется, скажет "какашка ваш слоник", а мне бы не хотелось терять будущих коллег по PostgreSQL
потому что типовые конфигурации, особенно старые, а еще больше доработки фирм франчайзи не заточены под PostgreSQL, и не достаточно поставить субд и галочки понажимать, надо еще пилить код, причем не пять минут
да и использовать надо тот инструмент, который не идеологически нужно впарить, а который лучше подходит для каждой конкретной ситуации, учитывая квалификацию, отведенное время, деньги, возможности и т.д.
мы за правду, а не за тренды и маркетинг
понятно объяснил?
Проблема в том, что коллеги написали, что делают именно сравнение PG <-> MS SQL.Это следует из названия статьи. Был выбран один пример прикладной задачи, ОДИН ! Для обывателя в статье однозначный вывод - PG рвёт MS SQL как тузик тряпку.
Я понимаю, хочется хайпануть на этой теме, но это в корне не верно. И самое главное, что это несёт больше вреда, чем пользы для PG.
Спасибо за интересный доклад !
Прошу уточнить, в тестировании участвовала база 1С в управляемом режиме блокировок, обе СУБД использовали режим изоляции Read Commited ?
По режиму изоляции, тоже да, MS SQL Read Commited, ну а Postgres по умолчанию в таком режиме работает
Если у вас ситуация, в которой основная бизнес-система не работает, то конечно можно принять такое рискованное решение, хуже то не будет, максимум будет так же. Но когда вы с рабочей системы прыгаете на незнакомую среду, без наличия специалистов. Меня бы, наверное, просто уволили, а у вас получился довольно интересный доклад.
Но вообще, если кто-то продает продукт, у которого есть некая рекламируемая опция (работа с 1С), то было бы неплохо, чтобы продукт уже из коробки работал на уровне конкурентов и не приходилось устраивать танцы с бубном.
Видимо там есть немного фанатизма OpenSource. У меня довольно большой опыт общения с программистами пользователями опенсурса и Linux и среди них довольно большое число самых настоящих фанатиков, которые Microsoft называют M$ и корпорацией зла и отказываются от хороших решений только на основании своей субьективной личной неприязни
Отсутствие исходников, зависимость от одной фирмы (а до недавнего времени ещё и прибитость гвоздями к одной ОС, хотя здесь ситуация у MSSQL вот только что начала меняться) - это "субъективная личная неприязнь"? Или всё-таки объективная проблема?
PostgreSQL реально хорош в том числе тем, что его развивают разные команды и фирмы, в том числе упоминавшаяся здесь Postgres Pro. Это как раз благодаря тому, что вы называете "фанатизмом OpenSource".
Вы же не будете плавать с аквалангом в ванной?..ну т.е. можно конечно понырять и решить кучу сопутствующих проблем (примеры которых приводились в статье), но акваланг создан для морей и океанов.. и если использовать его по назначению - этих проблем просто не будет. Опять же в статье ребята понимали, что они будут делать полноценный переход.. и с аквалангом плавать и в океане.. а ванна была нужна только для проверки "можно ли дышать с его помощью".
Но надо быть честным до конца и описать не только технические аспекты, но в том числе денежные и ресурсные.
Где оценка сколько понадобилось временных и денежных ресурсов по настройке Postgres, эту часть кто-то считал?
Для MS SQL - этот показатель равен почти 0 руб.
И хотелось бы видеть стоимость лицензий и подписки коммерческой версии Postgres против лицензий и подписки MS SQL Standard.
Вот тогда и будет понятно насколько Postgres дешевле MS SQL.
И хотелось бы видеть стоимость лицензий и подписки коммерческой версии Postgres против лицензий и подписки MS SQL Standard. - на сайте 1С есть прайс, там всё открыто, в целом расчёт такой - на 500 пользователей PG Enterprise + 3 года поддержки в 2 раза дешевле MS SQL Std
В целом на 500 пользователь PostgresEnt + 3 года поддержки в 2 раза дешевле MS SQL Std.
Там конечно надо смотреть что выгоднее взять, лиц. на ядра или на пользователей.
В целом на 500 пользователь PostgresEnt + 3 года поддержки в 2 раза дешевле MS SQL Std.
А сколько стоит грамотный админ со знанием PG и на сколько сложно его найти? Хотели сэкономить и поставили PG. Столкнулись с проблемами при эксплуатации. Решение этих проблем с учётом трудозатрат, простоя и затраченных нервов стояли дороже лицензии на MS. И основная проблема была в том что установить PG может много кто. А вот разобраться и решить проблемы мало кто и просят за это много денег. Так ещё найти такого человека надо.
Все-таки нужна таблица сравнения между MS SQL Server и PostgresEnt, а то у меня не складывается где PostgresEnt дешевле.
т.к. по ядрам MS проигрывает, а на пользователей примерно одинаково.
Взял прайс 1С:
Клиентский доступ на 100 р.м.к MS SQL Server 2016 Full-use для 1С:Предприятие 8. Электронная поставка руб. 1175741
Сколько стоит подписка на год, но вряд ли космическую сумму.
vs
Лицензия СУБД Postgres Pro Enterprise для 1C на 100 пользователей руб. 850000
Сертификат поддержки на 1 год СУБД Postgres Pro Enterprise для 1C на 100 пользователей руб. 200600 * 3 года = 601800
На 100 пользователях, разница в дистрибах не такая большая как на 500, но она есть и существенна.
Либо ставим ваниль и вообще бесплатно работаем, 100 пользователей не та нагрузка ради которой нужна проддержка вендора и Ент версия, опять же если это не ГосКонтора)
Пока у меня не складывается картинка перехода, особенно для тех компаний у которых есть договор премьер поддержки с MS
Лицензии sql у нас были куплены, еще когда Postgres не жил дружил с 1С и стоимость подписки в год на сервер SQL (не ядро) совсем смешная.
Или Postgres еще понижает цены и делает нормальную работу из коробку, без всяких танцев с бубном.
Или участь Postgres это новые компании, у которых еще нет инфраструктуры или госкомпании.
Это наверно только на настройку Postgres, а сколько времени надо, чтобы переписать запросы 1С под Postgres?
Выглядит очень заманчиво, как я понял Вы работаете во франчайзи. Так вот, готовы Вы ли за 60000 рублей перевести высоконагруженную базу ~ 1TB (~ 500 тыс событий в день прилетает извне) с mssql на Postgres, сохранив те же показатели работы, чтобы были на mssql?
А если показатели будут ниже, то за свой счет будете доводить до ума?
Это наверно только на настройку Postgres, а сколько времени надо, чтобы переписать запросы 1С под Postgres? - не переписывали специально под Postgres!
Переписывали логику запросов, которые работаеют на обоих БД
60 000 - конечно только установка настройка
Если у Вас интерес реальный, пишите в личку по переводу базы, тут светить подходы и цены не буду. Но они в несколько раз меньше покупки MS SQL точно)
После вашего доклада решили переходить на Postgres, могли бы вы описать как у вас организованна работа с Postgres в части репликации, бэкапов, хранение логов транзакций.
Подскажите в каких ситуациях нужно покупать PG Enterprise?
(27)
Реплики - по 2 на каждый мастер, одна "близко" в том же ЦОДе, одна в другом ЦОДе
Логи - храним на отдельном сервере 2 недели - такие требования бизнеса
Бэкапы - мы делаем pg_dump каждый день, так как у нас частый кейс восстановление отдельной базы на тестовый сервер. И деоаем basebackup раз в неделю
Всего около 80 наших пользователей и без счёта клиентов, которые работают через сайты.
В реальности, админы нужны не круче чем на такой же профиль нагрузки админы ms sql.
Но новые знания получить придётся и пропасть незнания и страха перепрыгнуть...
При том что ваша статья противоречит этому.... Про бессонные ночи, про ЦентОс с двадцатого раза, про недружелюбный терминал....
Мега админ и не нужен. Обычного бы найти да ещё по цене виндового.
Но сейчас попроще, и по умолчанию pg преднастроен и документация на русском и статьи какие никакие с опытом есть.
Итого: Сейчас можно сказать уже работает из коробки. А админы которые понимают, а не жмут далее-далее, с линуксом разбираться должны (сугубо моё IMHO). Ну за исключением если он не MVP заточенный на MS.
либо в начале разговора надо заявить что linux не является полноценной заменой windows-среды по некоторым задачам
потому что мне например нужно запускать конфигуратор на сервере 1С, так как сервер находится в облаке и "издалека" сеть делает загрузку dt неприемлемой по времени для баз размерами в террабайты
(95)
в нашей команде половина программистов сидит только под виндой, я их насильно не пересажу
могу на почасовке привлечь вас настроить сервер для коллективной работы в гуи под линукс если хотите
ну и что, у меня бизнес-процесс вызывается из 1С, мне отказаться от решения и писать все с нуля?
у меня и так программист для решения написал веб-сервис на java и через него залез в таблицу
А что тут удивительного. Связка 1С+Линукс стала нормально работать сравнительно недавно, поэтому подавляющая часть ИТ бизнеса действительно не умеет это готовить. Это просто факт, не ставящий целью кого-то принизить.
А по существу вопроса, если для малого бизнеса действительно проще сидеть на WIN, то для среднего и тем более крупного вырастить команду Линукс-специалистов под определенные задачи наверно выгоднее, чем бесконечно платить за лицензии Майкрософт.
Я не понял что вы предлагаете сделать?
* Подключиться из 1С напрямую к pg и сделать транкейт? Тогда не понятно причём тут 1С.
* Сделать очистку регистра сведений записью путого набора?
* Ещё какой-то вариант?
Под рукой pg+1c, могу только дома попробовать
Вы заинтриговали, действительно интересно что не так
отвечаю на ваши вопросы:
потому задача звучит как делать эту операцию средствами сервера 1С, у меня есть на PG база данных, выполняющая роль отдельного буфера при очереди к некоему потоку, в некоторых случаях очередь имеет большой массив данных и при этом может в какой то момент моментально обесценится и надо за минимальное время ее почистить
очищается не 1Ся таблица, но это и не важно потому что вы пишите про костыль в частном случае, а не общее решение
тоже самое на PG под виндой вызвать черед ODBC проблем у моего программиста не возникло
Сам использую Debian или Ubuntu + PGSQL
Уже достаточно давно, начинал с PG 9.1
По сути ничего сверхъестественного в этом нет, ни в linux ни в Pgsql.
Просто надо изучить, и понять как работает.
СУБД тут сравнили, результат я бы сказал, нет никакой разницы.
Скажу про Linux vs Windows что касается именно серверов.
Когда научитесь Linux поймете что он гораздо круче, проше, удобнее, и производительнее.
Для UserSpace Windows неоспоримый лидер.
Уважаемый таки это всегда бывает, когда устанавливаются СУБД по дефолту и 1С сервер по дефолту. А с настройкой такого не бывает, справедливо как для МС так и Слона.
1.
2.
3.
4.
5.
По поводу самого батла сказать нечего. Параметры железа не даны. Параметры windows не даны. Параметры настройки sql не даны. Что специалист накодил за 2 часа после месяца обдумывания, неизвестно. Все тесты проводятся на базах гигантского объёма, которые имеются у единиц.
Про OnlineAnalyze я вообще не понял. У вас он был включён и поэтому такие результаты были до этого, или вы его только в третьем раунде включили и получили увеличение производительности в 17 раз?
В основном эта статья не соответствует своему названию. Батла тут минимум, больше рассказа про то как работает PostgreSQL с несколькими элементарными советами как его правильно готовить.
привели бы структуру расходов такой организации за год , выделив те % которые занимает стоимость владения сервером БД, и главное те % , которые приходятся на экономию на PgSQL относительно MS SQL с учетом переучивания персонала на Linux + PgSQL
Очень интересно сравнить эти % экономии с % расходов на коммунальные платежи :)
и как правильно выше замечено - на стадии планирования экономия на PgSQL признается не достаточной чтобы начинать реорганизацию или рисковать внедряя новый проект на PgSQL
______
С одной стороны понятно , что статья сделана грамотно: продемонстрировано владение предметом, убежденность в своей правоте, предъявлены конкретные результаты, конкурентные преимущества внедренцев и указана выгода бизнеса .
И даже один из авторов комментариев явно заинтересовался …
но с другой - вот вспомнилось :
Золотой теленок (С):
(О.Бендер) ... Он развернул перед смущенным шофером удивительные дали и тут же раскрасил их в голубой и розовый цвета. – А в Арбатове вам терять нечего, кроме запасных цепей, – убеждал он. — По дороге голодать не будете. Это я беру на себя. Бензин ваш – идеи наши! ….
____
т.е. битва за "бензин" ".. Бензин ваш - идеи наши! " :-)
но что делать - капитализм....
последние несколько месяцев что-то массировано началась реклама PgSQL - "и это "жж" неспроста" :-)
хотя Infosoft давно демонстрирует умение работать с PgSQL
SHOW online_analyze.enable;Если вернет on, то значит включен. Если не включен, то проверь файл postgresql.conf на наличие следующих строк
shared_preload_libraries = 'online_analyze, plantuner'

online_analyze.enable = 'on'
online_analyze.table_type = 'temporary'
online_analyze.verbose = 'off'

plantuner.fix_empty_table = 'on'
- чего нехватает добавь и перезагрузи сервер.
После включения online_analyze еще желательно выполнить пересчет статистики по всей базе VACUUM ANALYZE. Иначе 1С-ка какое-то время бедет вести себя "задумчиво".
параллельные подзапросы хороши только тогда, когда есть критерий, по которому можно разобрать "работу" на потоки, а если у вас еще и в таблице меньше 100 000 строк то вряд ли вы увидите на глаз ускорение, а вот со сменой на 10.4 и выше надо по мнению фирмы 1С и платформу надо ставить последнюю, а она пока не поражает своей стабильностью
Сразу появляется желание назвать публикацию "ШОК КОНТЕНТ !!!!!!! СЛОНИК НОГЕБАЕТ СКУЛЯ !!! СМОТРЕТЬ ДО КОНЦА !!"
Автор конечно не пишет что после этих эээ "опытов в вакууме", если в Оку и Мерс засунуть по 4 человека, Ока все равно поедет быстрее, что в целом спасает ситуацию. Но польза сего исследования вызывает сомнения.
Лично для меня, эта статья не станет катализатором к смене СУБД, хотя проблемы с производительностью мы испытываем немалые.
Вообще, на свободных СУБД весь Интернет живет. MySQL на 2-м месте рейтинга "мерседесов" после Oracle, а MS только на третьем. Ну а за ними с некоторым отрывом Postgre. Но при этом в 1С Oracle работает так себе, ибо 10 лет подряд 1С-ники пилили свое решение для работы с MS SQL, и уже после этого подоткнули к нему все, что только можно (например, IBM DB2, который в отдельных сценариях работы заставит курить в углу даже Oracle, а не только MS SQL).
Но если говорить о задачах бизнеса вообще, то у него основная задача - создавать стоимость. ИТ для бизнеса - это инструмент снижения затрат и повышения производительности труда (чтобы не вручную по картотеке искать партии и не вычеркивать оттуда по строчке). И не важно, какую СБУД для этого использовать, важна стоимость владения и, в меньшей степени, способность СУБД обеспечивать бизнес-процессы организации, связанные с сохранением и извлечением данных. В 1С извлечение и сохранение данных избыточно: объекты сохраняются целиком, а не только их изменения (а объект может содержать в себе туеву хучу таблиц); остатки извлекаются каждый раз при работе с исторически-зависимыми данными - нет промежуточного пула исторических данных, т.е. они не кешируются, ... Это как для соблюдения атомарности делается, так и для минимальных издержек ума программиста для обеспечения консистенции внутри транзакций. В итоге и тормоза, которые связаны не сколько с проблемами СУБД, сколько с проблемами архитектуры 1С как таковой, так и архитектуры типовых решений.
Если Жигули 6 модели вытянут на тросе Газельку по сельской дороге, это не значит что они круче Ламборджини.
Если бы в тестах по APDEX Postgres побил бы Скуль я бы сильно удивился для начала, а потом стоя апплодировал.
А эти тесты - отдел ИТ сделал под себя.
Порассуждайте хотя бы с точки зрения бизнеса - есть штат сотрудников, он работает в рабочее время (не всегда) - каламбур.
И от быстродействия операций происходящих в рабочее время зависит быстродействие фирмы.
Их с переменным успехом меряет APDEX.
А ваши залития невероятных баз и пересчеты итогов в принципе не критичны пока они в выходные успевают проходить.
Так вот на APDEX микрософт на микрософте просто разорвет Постгри, как бы хорошо я к Постгри не относился
На линуксе Постгри еще побьется при всех правильных настройках.
Еще более мифические советы - никогда не делайте то, никогда не делайте се.
Я бы дал совет - никогда не говорить никогда, а делайте того, что знаете зачем делаете.
В штатную базу например не заливается обычно миллион записей в случайный момент времени, она идет в ровном режиме.
Поэтому спокойно в ней можно делать обновление статистики регламентно, а автообновление убрать.
PS: кстати, ошибся - лидирует что-то другое )))
Тест TPC-H измеряет производительность при характерных нагрузках на хранилище данных. При проведении теста TPC-H используется технология обновляемой обработки в памяти columnstore в SQL Server, позволяющая достичь высочайшей производительности при обработке запросов.
Те же маркетинговые уловки
В версии Энтерпрайз и оттуда они постепенно уходят в Стандарт.
А постгри для высоконагруженных ситем надо основательно напильником обработать.
online_analyze.threshold = 50
online_analyze.scale_factor = 0.1
online_analyze.enable = on
online_analyze.verbose = off
online_analyze.min_interval = 10000
online_analyze.table_type = 'temporary'
plantuner.fix_empty_table = false
и для чего online_analyze.verbose и нужно ли его включать?
На posgres sql нет возможности переноса временных таблиц на другой диск. К примеру на какой нибудь другой хранитель.
Postgres может хранить лишь статистику TempDB хранить в другом месте.
При правильных настройках на базах выше 50Gb MSSQL выигрывает, если tempdb выведен на отдельный SDD Optane или Samsung 970 Pro. Если на RAM диск то себестоимость ERP считает раза 3 быстрее (при условии хороших камней CPU)
temp_tablespaces = 'ram'
Кто что думает?
удалил
Результаты теста крайне странные, настройки PG бы в студию.
очень странно что Выполнение процедуры «Закрытие месяца за декабрь 2018 г. у PG быстрее чем у MS, и при этом проведение ПТУ и РТУ медленнее....
И тут же все скриптовые данные дали одинаковый результат
Я не то чтобы в защиту PG (работаю и с MS Тоже много), но результаты очень странные.
я не увидел сначала, на хабре уже написал рекомендации
Почему-то конкретные модели процессоров предусмотрительно не указаны...
И мне кажется, что имеет смысл сравнивать стоимость железа + ПО. Все же MSSQL дорогой продукт, и за эти деньги вполне можно купить более производительный сервер и разнести данные по разным дискам.
Согласен, но тогда бы был тест финансовой эффективности СУБД, а не скорости работы с 1С
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 962876
Создание 18.12.18 06:50
Обновление 18.12.18 06:50
Просмотры 79097
Загрузки 0
Рейтинг
173
Комментарии 156
Код открыт Да
Рубрики Администрирование СУБД
Кому
Системный администратор
,
Разработчик
Тип файла Нет файла
Платформа Не имеет значения
Конфигурация Универсальные
Операционная система PostgreSQL
Страна Не имеет значения
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)