Использование машинного обучения для решения инцидентов. Практическое применение

25.02.20

Разработка - Тестирование QA

Продолжаю (и заканчиваю) тему с автоматическим решением инцидентов. Перейдем от теории к практике.

В данной статье я продолжу (ну и закончу) тему использования машинного обучения для автоматического (без участия сотрудника техподдержки) решения инцидентов.

Первая часть тут:


Весь код для получения модели, которая будет предлагать наиболее подходящий классификатор:


%%time

def predict(vectorizer, classifier, data):

    data_features = vectorizer.transform(data['Description'])

    predictions = classifier.predict(data_features)

    target = data['ShortDescription']

    evaluate_prediction(predictions, target)


def plot_confusion_matrix(cm, title='Confusion matrix', cmap=plt.cm.Blues):

    plt.imshow(cm, interpolation='nearest', cmap=cmap)

    plt.title(title)

    plt.colorbar()

    tick_marks = np.arange(len(my_tags))

    target_names = my_tags

    plt.xticks(tick_marks, target_names, rotation=90)

    plt.yticks(tick_marks, target_names)

    plt.ylabel('True label')

    plt.xlabel('Predicted label')

    fig = plt.gcf()

    fig.set_size_inches(18.5, 10.5)

    fig.savefig('test2png.png', dpi=100)


def evaluate_prediction(predictions, target, title="Confusion matrix"):

    print('accuracy %s' % accuracy_score(target, predictions))

    print('recall %s' % recall_score(target,predictions, average='micro'))

    cm = confusion_matrix(target, predictions)   

    cm_normalized = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]

    plot_confusion_matrix(cm_normalized, title + ' Normalized')


from sklearn import linear_model

from sklearn.externals import joblib

#Разбиваем наш df на две части, тренировочную и тестовую.

train_data, test_data = train_test_split(df_result_filter, test_size=0.1, random_state=42)

len(test_data)

len(train_data)


#Разделяем все инциденты на слова

test_tokenized = test_data.apply(lambda r: w2v_tokenize_text(r['Description']), axis=1).values

train_tokenized = train_data.apply(lambda r: w2v_tokenize_text(r['Description']), axis=1).values


#Преобразуем все наши слова в векторы

X_train_word_average = word_averaging_list(wv,train_tokenized)

X_test_word_average = word_averaging_list(wv,test_tokenized)


#Для обучения мы будем использовать логистическую регрессию. Вы можете попробовать использовать другие типы регрессий и сравнить результат.

logreg = linear_model.LogisticRegression(n_jobs=1, C=1e5)


#Обучим нашу модель на тестовых данных. Данная процедура самая длительная, в зависимости от размера модели может занимать несколько часов. В моем случае ушло более 6 часов.

logreg_w2v = logreg.fit(X_train_word_average, train_data['ShortDescription'])


#Сохраним полученный результат, он нам потребуется в дальнейшем

joblib.dump(logreg_w2v, 'Data/logreg_w2v.sav')


#Выполним предсказание для нашей тестовой выборки

predicted_w2v = logreg_w2v.predict(X_test_word_average)


#Посмотрим на результат

evaluate_prediction(predicted_w2v, test_data.ShortDescription)


Доля правильных ответов

accuracy 0.7425814736403706


Полнота

recall 0.7425814736403706


Можно считать полученные результаты весьма неплохими.

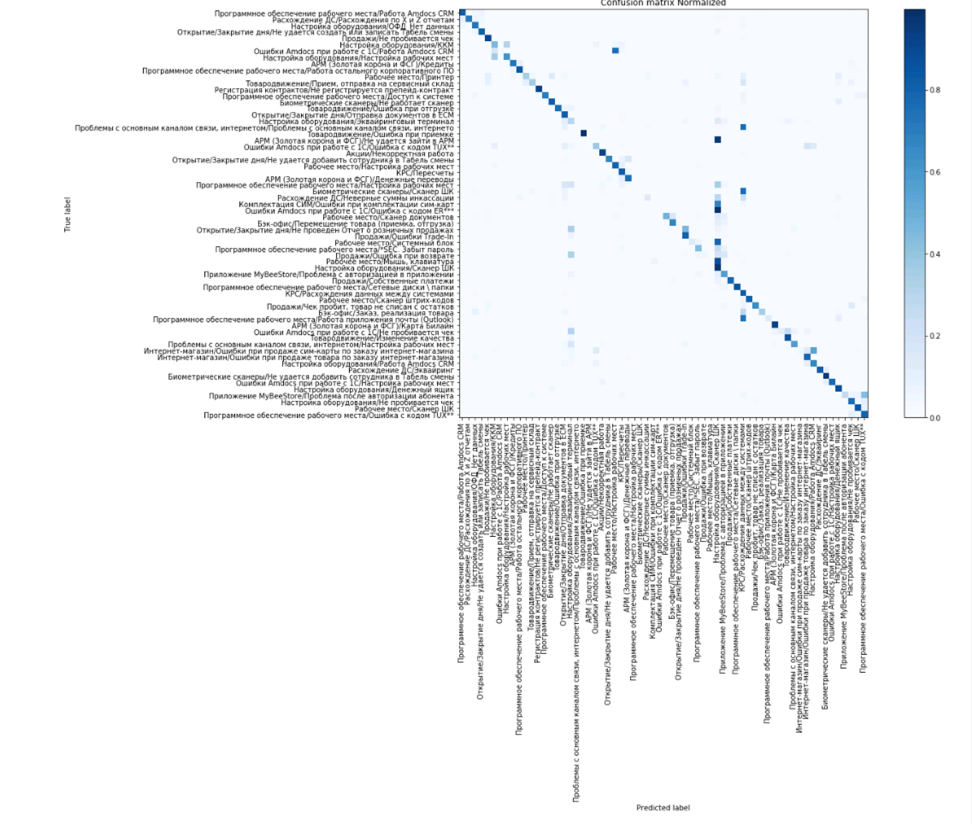
А вот как выглядит так называемая матрица ошибок. Видим, что есть проблемы с классификатором «Проблемы с MyBeeStore/Проблемы с авторизацией», в остальном предсказания в основном укладываются в диагональ, то есть предсказанное и действительное значения классификаторов совпали.


Ну что ж, с обучением мы закончили, теперь давайте превратим наши исследования в полноценный продукт.

Для того, чтобы использовать описанный ранее функционал нам нужен веб-сервис с двумя процедурами, первая по тексту инцидента будет возвращать список похожих инцидентов, а вторая – наиболее подходящий с точки зрения модели классификатор.

Я не буду копировать сюда весь код, вот ссылка на github, если кто-то соберется запустить подобный функционал все равно код придется немного переделать.


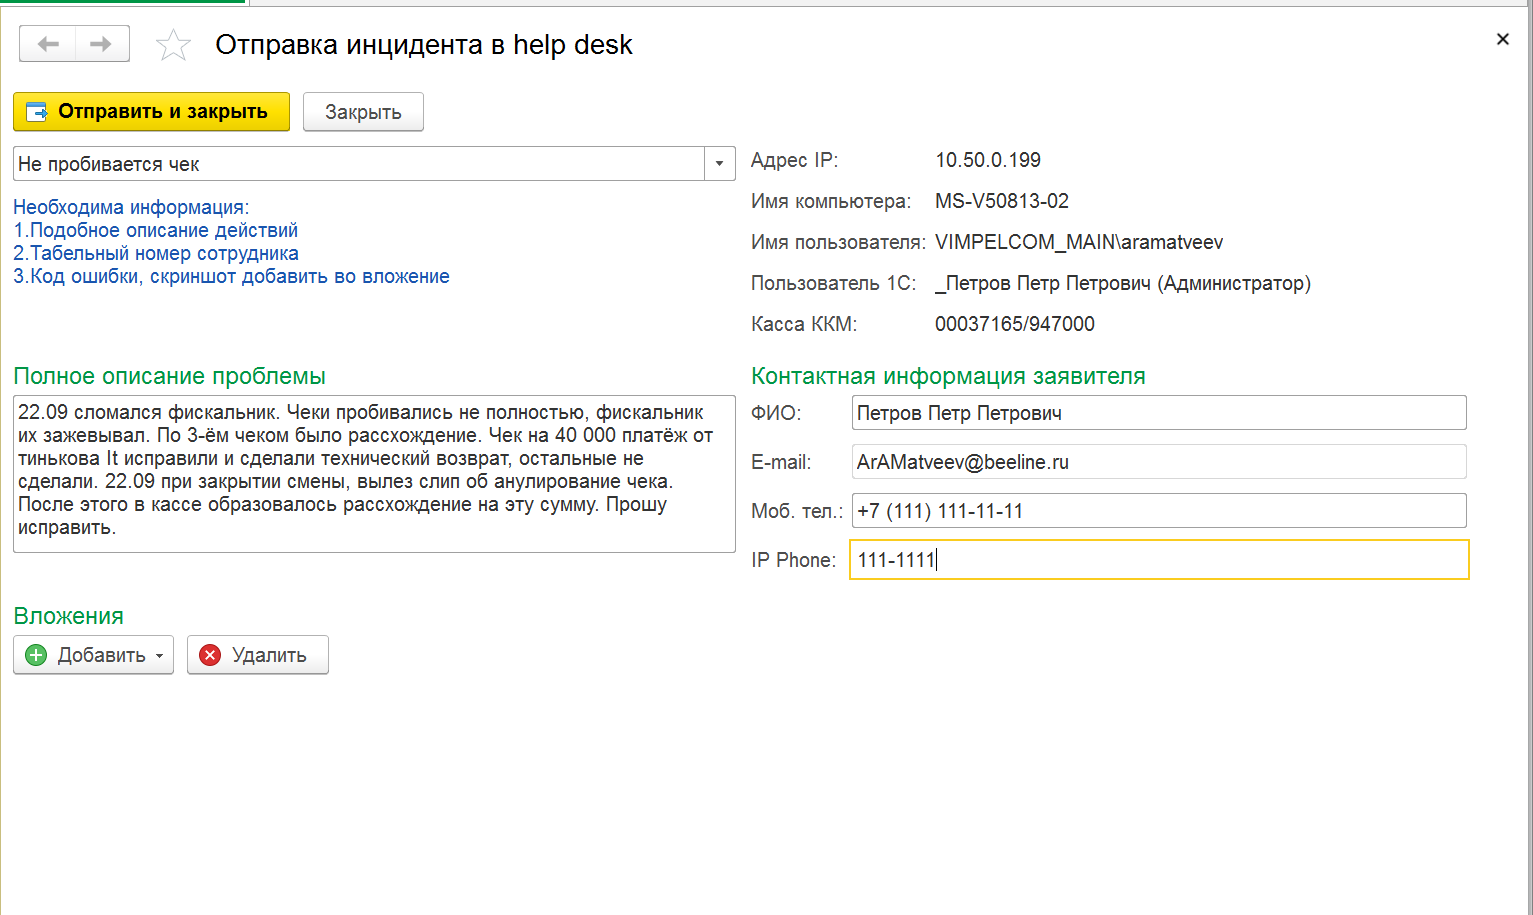
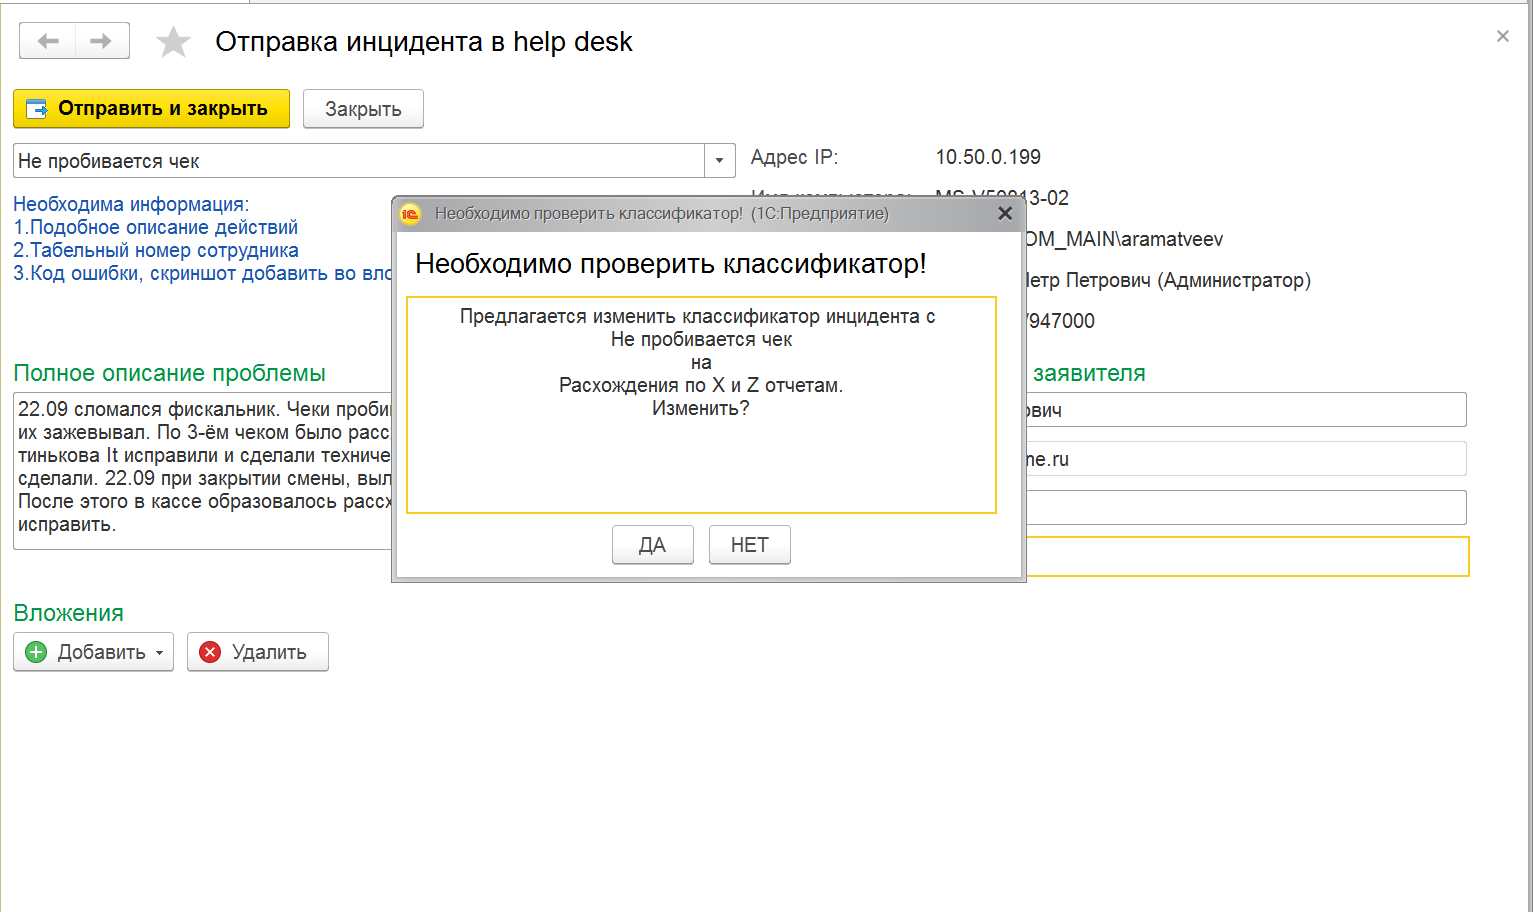
При заведении инцидента пользователь выбирает наиболее подходящий по его мнению классификатор и вводит текст инцидента. Затем при записи нового инцидента происходит вызов двух функций, поиск похожих инцидентов и поиск подходящего классификатора.

  1. Поиск готового решения.

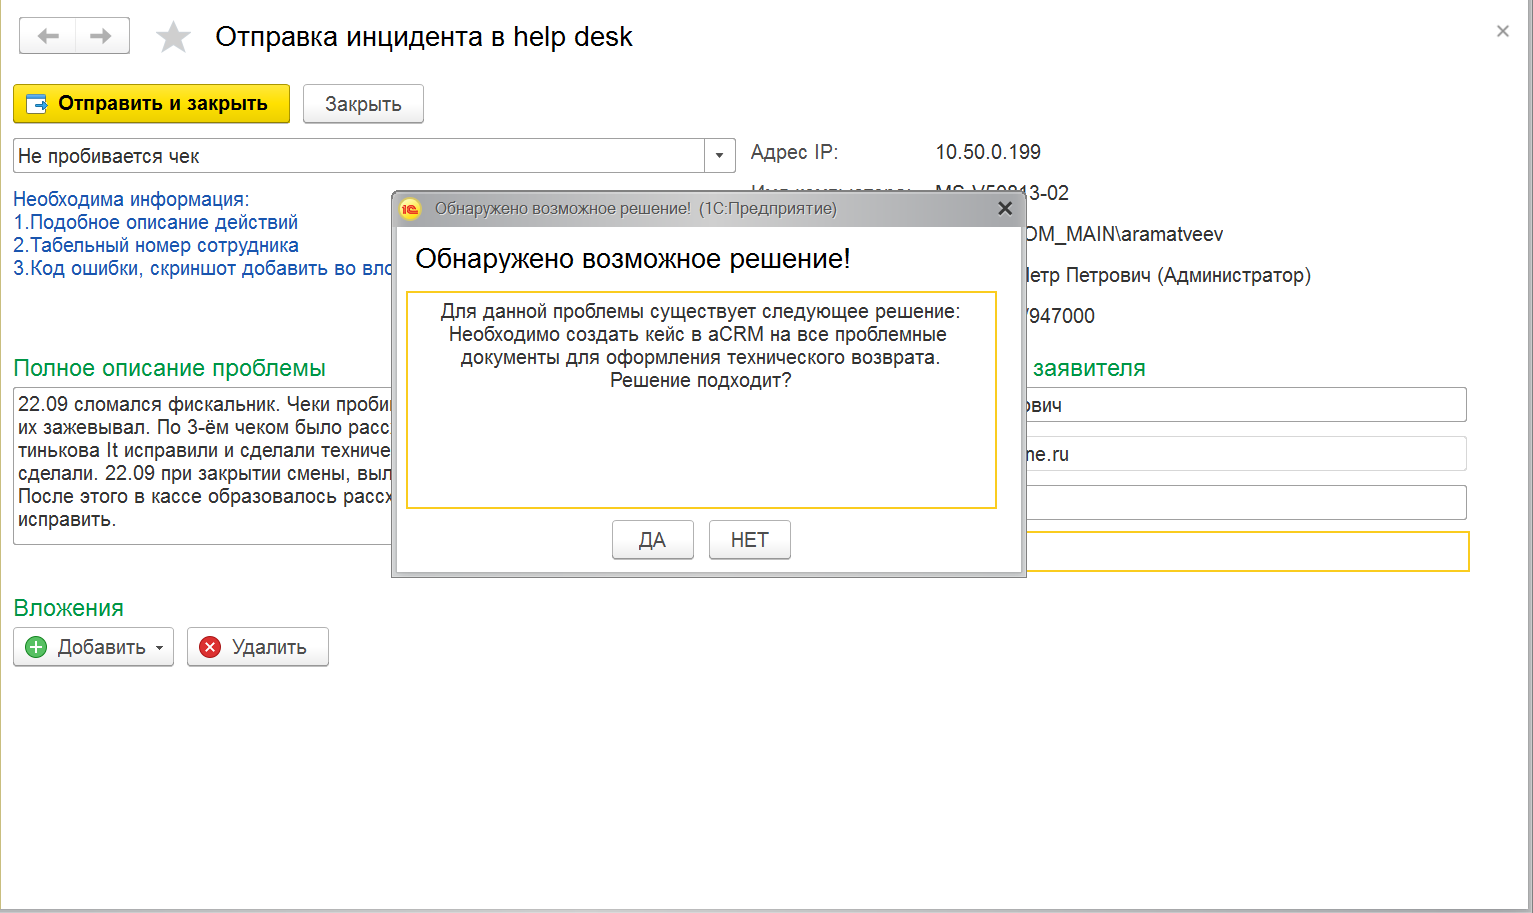
Изначально был проведен опрос сотрудников техподдержки, были выделены инциденты, которые сотрудник может решить самостоятельно. Затем по примерному тексту инцидента были выделены все похожие с помощью перекрестного сравнения выбран инцидент, максимально похожий на остальные по выбранной тематике. Затем мы создали базу данных, в которой в одной из таблиц был указан номер инцидента и описанное для него «саморешение», то есть решение, которое может проделать сотрудник самостоятельно. В случае, если на текст инцидента существует похожий инцидент с описанным решением – оно предлагается пользователю и задается вопрос «Решение помогло?» При положительном инциденте мы отмечаем для статистики эту информацию, инцидент не создаем, в противном случае информацию сохраняем и заводим инцидент.


  1. Подбор классификатора.

Аналогично предыдущему пункту информация о том, подошел ли предложенный классификатор сохраняется в отдельной базе. Сначала мы анализировали полученные данные, но примерно через 2 месяца поняли, что система работает без нашего участия, так что теперь я где то раз в месяц заглядываю туда чтобы посмотреть статистику предсказаний ну или получить сводную информацию для очередной презентации J
Вступайте в нашу телеграмм-группу Инфостарт

Машинное обучение Python HelpDesk

Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».

  • 0% комиссии — оплата напрямую исполнителю;
  • Исполнители любого масштаба — от отдельных специалистов до команд под проект;
  • Прямой обмен контактами между заказчиком и исполнителем;
  • Безопасная сделка — при необходимости;
  • Рейтинги, кейсы и прозрачная система откликов.

См. также

SALE! %

Банковские операции Обмен с интернет-банком Мастера заполнения Нейросети Разработчик Бухгалтер Пользователь 1С:Предприятие 8 1C:ERP 1С:Бухгалтерия 3.0 1С:ERP Управление предприятием 2 1С:Управление холдингом 1С:ERP. Управление холдингом 1С:Комплексная автоматизация 2.х 1С:Управление нашей фирмой 3.0 1С:Управление торговлей 11 1С:Розница 3.0 Платные (руб)

Корректируйте банковские документы быстро и легко! Создайте правило обработки — и оно автоматически применится при загрузке выписки (отбор по любому реквизиту или регулярному выражению). Решение заполняет расшифровку платежа, комиссию эквайринга, подбирает ведомости на выплату зарплаты, помечает дубли из банка на удаление и многое другое. Доплачивать за алгоритмы не нужно — они включены в решение. Обработка работает при загрузке из файлов клиент-банка и через DirectBank. Новое — искусственный интеллект: модель приводит нестандартные назначения платежа к виду, понятному алгоритмам, а ИИ-ассистент прямо в 1С консультирует по решению и разбирает код правил и алгоритмов. Поддерживаются локальные и облачные OpenAI-совместимые модели — данные могут не покидать ваш контур.

17500 руб.

20.12.2024    19370    98    32    

83

Нейросети Системный администратор Разработчик Аналитик Бухгалтер Пользователь Руководитель проекта 1С 8.3 1С:Документооборот 1С:Бухгалтерия 3.0 1С:Зарплата и Управление Персоналом 3.x Россия Платные (руб)

Задавайте вопросы базе 1С обычными словами: получайте данные, находите ошибки и связанные документы, проверяйте права, работайте с вложениями и контролируемо вносите изменения. Всё это работает в самой программе, а Codex и Claude подключаются по желанию.

15989 руб.

30.07.2026    12458    26    4    

26

Инструментарий разработчика Нейросети Платные (руб)

Первые попытки разработки на 1С с использованием больших языковых моделей (LLM) могут разочаровать. LLMки сильно галлюцинируют, потому что не знают устройства конфигураций 1С, не знают нюансов синтаксиса. Но если дать им подсказки с помощью MCP, то результат получается кардинально лучше. Далее в публикации: MCP для поиска по метаданным 1С, справке синтакс-помощника и проверки синтаксиса.

15250 руб.

25.08.2025    70768    140    41    

149

Распознавание документов и образов Нейросети 1С:Предприятие 8 1С 8.3 1С 8.5 1C:Бухгалтерия 1С:Зарплата и Управление Персоналом 3.x Беларусь Россия Казахстан Армения Платные (руб)

ИИ-сканер документов с REST API для интеграции с 1С и корпоративными системами. Извлекайте данные из счетов, паспортов, дипломов, патентов и трудовых книжек за секунды. Точность человека - скорость машины. Приложение поддерживает восемь типов документов, четырех провайдеров ИИ (имеется возможность использования локальных ИИ), локальный REST API и экспорт в JSON. Важно! модель должна поддерживать функцию Vision (распознавание файлов и картинок). Запускайте используя локальные ИИ, без подписок и ограничений

6100 руб.

24.08.2026    476    2    0    

1

DevOps и автоматизация разработки Тестирование QA Групповая разработка (Git, хранилище) Разработчик 1С:Предприятие 8 Бесплатно (free)

Четыре года в интеграторе я работал с git и EDT. Git после хранилища полюбил сразу: видно, кто и что менял. С EDT сложнее: тормозит, ошибки при обновлении ERP, автономный сервер внутри него работает только с файловой базой. На новой работе команда захотела перейти на git, я развернул EDT, и оно на второй день разрушило проект при загрузке расширения. Тогда я решил дать команде git с привычным Конфигуратором и инструмент, который за минуту доносит коммит до базы через ibcmd, вместо получасовой загрузки из файлов. На новой работе разрешили ИИ, и я написал это приложение с его помощью: от чтения документации и первого ТЗ до идей в электричке. Впервые за годы снова почувствовал себя творцом, а не закрывателем задач. По дороге приросли выгрузка, объединение и проверка конфигурации по коммитам, YAxUnit и режим MCP-сервера. В статье: схемы, скриншоты, грабли и честный список ограничений. Ссылки пока нет: хочу понять, нужно ли это кому-то, кроме меня.

03.09.2026    10850    KatanaDragon511    28    

40

Инструменты администратора БД Инструментарий разработчика Тестирование QA Системный администратор Разработчик Стажер 1С:Предприятие 8 Бесплатно (free)

В экосистеме 1С давно живут сотни инструментов: от Конфигуратора и Хранилища до систем тестирования, мониторинга, интеграции и CI/CD. Я собрал их в Ландшафт технологий, а теперь добавляю данные о реальном использовании. Рассказываю, как устроена карта, что показал первый опрос и почему в новой волне особенно нужны администраторы, аналитики и тестировщики.

01.09.2026    2287    mrXoxot    6    

25

Нейросети Разработчик 1С:Предприятие 8 Россия Бесплатно (free)

Как связать 1С и Cursor через MCP так, чтобы AI-агент сам получал актуальную конфигурацию из информационной базы, находил нужный BSL-код, вносил изменения, загружал конфигурацию обратно и запускал 1С:Предприятие. В статье — настройка 1C: Platform Tools, 1C: Platform Tools MCP, OneScript, vanessa-runner и env.json, а также важные нюансы при работе с несколькими проектами, IPC-портами, большими конфигурациями и длительными операциями загрузки. Покажу полный практический цикл на тестовой базе без ручной выгрузки и загрузки XML через Конфигуратор.

28.08.2026    18362    rinat1c    18    

30

DevOps и автоматизация разработки Мониторинг Тестирование QA Разработчик 1С:Предприятие 8 Бесплатно (free)

Платформа 1С давно вышла за рамки учетных систем. Сегодня это полноценная среда для создания сложных, высоконагруженных и распределенных приложений. А значит, и стек технологий современного разработчика кардинально изменился. Систематизируем весь инструментарий, который превращает 1С-программиста в инженера: от EDT и Git до автотестов на YAxUnit, контейнеризации приложений в Docker, мониторинга в Prometheus и организации шины данных на Kafka. Разберемся, зачем каждый инструмент нужен, как он вписывается в жизненный цикл разработки и с чего начать его внедрение.

25.08.2026    21650    mrXoxot    53    

84
Комментарии
Подписаться на ответы Инфостарт бот Сортировка: Древо развёрнутое
Свернуть все
1. pm74 208 26.02.20 09:25 Сейчас в теме
(0) норм. вы молодец
тоже потихоньку экспериментирую с scikit-learn
с iris: ( Setosa, Virginica .. ) ковыряться конечно не очень интересно
сделал себе "песочницу" (транслятор 1с запрос-> Dataframe) для экспериментов , посмотрим получится ли что нибудь интересное
Алексей_mir2mb; +1 Ответить
2. Repich 592 26.02.20 09:36 Сейчас в теме
(1) Самое сложное в моем случае оказалось придумать сложную, но решаемую задачу.
утюгчеловек; Алексей_mir2mb; +2 Ответить
3. pm74 208 26.02.20 09:41 Сейчас в теме
(2) и у вас это получилось
у меня тоже есть пара подобных задач к которым пока не могу подступиться , просто из за нехватки опыта и времени
4. pm74 208 26.02.20 09:48 Сейчас в теме
(2) да еще вопрос , на каком "железе" это все делалось

...В моем случае ушло более 6 часов.
5. Repich 592 26.02.20 11:07 Сейчас в теме
(4) Сервер с 16 ядрами и 256 Гб ОЗУ. Но тут есть масса вариантов оптимизации, потому что обучение я делал в один поток. По идее этот процесс должен иметь неплохие возможности паралеллизации, просто у меня был дедлайн по сдаче проекта.
Алексей_mir2mb; portwein; pm74; +3 Ответить
6. ivanov660 4984 26.02.20 11:11 Сейчас в теме
Интересная тема. Есть пару вопросов.
1. Как обновляется/переучивается модель (относительно новых ошибок)?
2. Пробовали doc2vec подход?
7. Repich 592 26.02.20 11:31 Сейчас в теме
(6) 1. Вручную, просто где то раз в месяц прогоняю обучение заново. Новых классификаторов практически не появляется, так что пользы от ежедневного переобучения нет. Конечно хорошо бы еще и результаты использования (там где пользователи отвечают, что классификатор выбран неверно) тоже брать для обучения, но до этого я уже не нашел, появились другие задачи, увеличить качество с 74 до 74,5% не стоит :)
2. Нет, узнал о его существовании уже после того, как реализовал подход, описанный в статье.
8. user623969_dusa 26.02.20 14:10 Сейчас в теме
что лежит в основе алгоритма - комплексная нейронная сеть на основе ряда фурье или просто набор вероятностей?)
9. Repich 592 26.02.20 14:36 Сейчас в теме
(8) Не понял вопрос, в основе какого алгоритма? В основе алгоритма логистической регрессии?
10. Восьмой 100 17.08.24 00:21 Сейчас в теме
А есть готовое решение которое можно пощупать на 1С?
11. Repich 592 11.09.24 14:49 Сейчас в теме
(10) Что именно хочется попробовать?
Для примера опубликовал сервис снаружи, тут swagger
http://81.94.150.104:7779/apidocs/
доступным полежит месяц, потом удалю.
Если нужно кусок кода из 1С - как вызвать - могу добавить, но это обычный rest-сервис, на вход даешь текст инцидента, на выходе - получаешь классификаторы.

Если необходимо дообучить модель на ваших данных - можно и так, но это уже за деньги.
Для отправки сообщения требуется регистрация/авторизация