В нашем рабочем чате в тот день происходило что-то странное.
Сначала загорелась статусная строка: печатает один разработчик. Погасла. Загорелась снова — печатает второй. Погасла. Потом печатали двое сразу, потом трое. И всё это молча, ни одного сообщения. Люди набирали текст, читали, что получилось, и стирали.
Я сидел и смотрел на эту строку минуты полторы. Наконец кто-то дожал и отправил. Первое сообщение, которое вышло в чат в тот день, было такое:
— Нас теперь всех уволят?
Что случилось перед этим — я расскажу позже, потому что сейчас для понимания этой истории важнее другое. Важнее, что за несколько месяцев до того дня я подошёл к нейросетям в 1С и получил по лбу так, что бросил эту затею.
Вот с этого и начну. С провала.
Кто я и откуда смотрю
У меня маленький франч, всего сорок сотрудников. Программирую на 1С двадцать пять лет и до сих пор люблю это делать: в свободное время что-нибудь пишу для души — в основном для нашей рабочей базы, для клиентов сильно реже.
Прошлым летом я задумался над внедрением нейронок в наши процессы. Не в программирование даже, а вообще — посмотреть, где оно нам полезно.
И вот здесь первый неожиданный вывод: всё, что не касалось 1С, зашло почти сразу.
- Помощь кадровикам с разбором резюме.
- Разбор разговора продавца с клиентом.
- Контроль полноты описания задач — насколько внятно аналитик или разработчик написал, что вообще надо сделать.
Это заработало быстро. В интернете было полно информации: какие инструменты брать, как их связывать, что куда подавать. Многое я тогда собрал на n8n — там процесс собирается из готовых блоков, без программирования. Часть из этого мы с тех пор переделали уже на более серьёзном уровне, но первые версии родились буквально за несколько вечеров.
То есть проблема была не в том, что нейросети не работают. Они работали. Они не работали у меня в конфигураторе.
Инструменты сырые, а я — только 1С-ник
Отовсюду в тот момент слышались успехи программирования с помощью нейронок. Но это было прикладное программирование — не наше. Информация по 1С только-только начинала появляться. Инструменты появлялись тоже, но результат их использования оставлял желать лучшего.
Так ещё и для многих требовалось ставить дополнительное программное обеспечение вроде системы контейнеров и проводить танцы с бубнами, чтобы это всё настроить. Это отдельный жанр: ты ещё ни строчки полезной не получил, а уже полдня разбираешься, почему у тебя что-то не поднимается.
Дальше начиналось непонятное чисто для 1С-ника. Как, собственно, писать код не в конфигураторе, а где-то ещё?
Копировать модули целиком из Cursor или VS Code — та ещё история. Копировать готовые процедуры или части процедур — тоже неудобно. Туда-сюда, туда-сюда, и на третьем часу ты уже не помнишь, где лежит актуальный текст процедуры: в конфигураторе или в редакторе.
Про создание форм говорить вообще не приходилось. Нейронки не то что не могли создать форму с нуля — они ломали существующие. Хотя, казалось бы, что сложного: вставить нужный кусочек разметки в нужное место более общей структуры. Структура известна, место известно, кусочек известен. Нейронки не справлялись, ломали форму.
И ещё одно, чисто личное. Я кроме как в 1С нигде не программировал. Мне пришлось разбираться с целой кучей незнакомых мне тем: начиная с редакторов кода, в которых я никогда до этого не работал, и заканчивая тем, как правильно выстроить работу с хранилищем исходников. Для человека из другой отрасли это база, которую он получил на первой работе. Для 1С-ника даже с двадцатипятилетним стажем — новая земля.
Первые эксперименты
Они оказались неудачными.
Нейронка бойко могла написать какой-нибудь типовой код. Сортировку пузырьком, например. Кстати, все знают, как это делается? Я вот за двадцать пять лет программирования так ни разу такую сортировку и не написал. Нейронка сделала это красиво, с комментариями, с проверками. Хоть в учебник.
И при этом оказывалась абсолютно бесполезной на реальных задачах.
Что именно она делала не так — стоит перечислить по пунктам:
- Выдумывала процедуры. Ей нужно записать движения — она уверенно пишет вызов процедуры, которой в конфигурации нет. Имя правильное, «как будто бы должно быть», параметры логичные. Только не существует.
- Не понимала даже простейших связок между вызовами разных модулей. Что вот эта процедура вызывает вот ту, а та дёргает третью, и вместе они делают одно дело — этого для неё не существовало.
- Ничего не знала об объектах метаданных. Ни какие есть справочники, ни какие у документа реквизиты, ни кто кому подчинён.
- Писала код с синтаксическими ошибками. Да что там сложные материи — то, что она выдавала, нередко просто не компилировалось.
Про первый пункт стоит рассказать подробнее, потому что он оказался самым коварным.
Я попросил доработать проведение документа. Получил код. Читаю — красиво, аккуратно, в стиле платформы, обработка ошибок на месте. В середине вызов процедуры из общего модуля: имя понятное, по-русски, ровно про то, что нужно сделать. Параметры логичные — документ, отказ, режим проведения.
Я полез искать эту процедуру в конфигурации.
Поиск по конфигурации — дело секунд. Но я искал минуты три. Сначала в том модуле, который она назвала. Потом по всем общим модулям. Потом по всей конфигурации целиком. Потом полез в расширения — а вдруг я сам её когда-то написал и забыл.
Её не было нигде. Она её придумала — и придумала так убедительно, что я пошёл искать собственную процедуру, которой у меня никогда не было. Три минуты — ерунда. Но это были три минуты полной уверенности, что процедура есть, а я просто плохо ищу.
Вот это и есть та штука, из-за которой всё было так плохо. Не то, что нейронка чего-то не знает. С «не знаю» жить можно: не знаешь — спроси, я расскажу. Плохо то, что она не отличает «я знаю» от «я не знаю». И выдаёт второе с той же уверенностью, что и первое.
История с формами из того же ряда, только злее. Прошу вставить в существующую форму пару элементов — получаю форму, которая после этого просто не открывается. Разметка формы — это строгая структура, и если её нарушить, платформа форму не покажет вовсе. А дальше ищи, в каком месте она отъехала. Разбор поломки занимал больше времени, чем занял бы у меня руками весь этот кусочек с самого начала.
И я начал делать то, что казалось единственным разумным выходом. Я стал лечить это контекстом.
Писал инструкции. Давал больше контекста. Описывал метаданные. Говорил, какие процедуры общих модулей правильно использовать в каких случаях. Составлял памятки на несколько страниц.
Это не дало ничего, кроме роста объёма контекста и ускоренного сжигания денег.
Вот это ощущение — когда ты делаешь всё правильно, добросовестно, много, счётчик крутится, а результат не меняется, — оно, наверное, знакомо каждому, кто в это лез. Мой энтузиазм по части программирования с помощью нейросетей в 1С сильно подупал. И я месяца на три практически забросил свои исследования. Не потому что разочаровался. Потому что просто не понимал, куда двигаться.
А у коллег в это время всё получалось
Наблюдать за этим было по-настоящему интересно.
Параллельно со мной в нейросети погружались другие наши коллеги. Больше всех сделал руководитель производства. В какой-то момент он кардинально пересобрал работу аналитиков и внедрил нейронки практически на всех уровнях — именно у аналитиков, программистов это не касалось вообще.
Единственное место, где остался только человек, — сами встречи с клиентами: там аналитики говорят сами. Всё остальное — подготовка к встрече, подготовка расчётов и коммерческих предложений, разбор данных после встречи — делалось с помощью нейронок.
Программисты тоже приносили свои находки, но не так массово, как аналитики. И вот эта разница — аналитикам зашло, программистам нет — и стала моим главным вопросом. Одни и те же модели. Одни и те же люди. Одна и та же компания. Почему у аналитика работает, а у разработчика 1С нет?
Ответ я нашёл сильно позже, чем хотелось бы. Он оказался простым и, что показательно, был очевиден с самого начала — просто я смотрел не туда.
Дело в том, с чем эти люди приходят к нейросети.
Аналитик приходит с текстом. Расшифровка встречи, переписка с клиентом, техническое задание, старое письмо на три экрана, из которого надо вытащить требования. Всё это — обычный человеческий язык, и модель на нём выросла. Ей не нужно знать, что за клиент и что за проект: она читает то, что ей дали, и делает с этим ровно то, о чём попросили. Весь нужный материал приходит вместе с вопросом.
Разработчик 1С приходит с системой. Не с текстом, а с живой конфигурацией на несколько миллионов строк. Часть из них написали вы. Часть — типовая. А часть — три команды, которые правили эту типовую до вас. И ни одна из этих частей модели не знакома. Материал этот вместе с вопросом не приходит. Вопрос помещается в одну строку, а всё, что нужно, чтобы на него ответить, лежит где-то там, в конфигурации, куда модель не заглядывает.
Вот и вся разница. У аналитика вход и задача — в одной руке. У разработчика задача в одной руке, а вход — в базе, до которой у модели нет доступа.
Кадровику с резюме то же самое: резюме приходит целиком, вместе с вопросом. Продавец с расшифровкой разговора — тоже. Все наши быстрые победы прошлого лета — это задачи, где всё нужное умещалось в самом вопросе.
Как только я это увидел, стало понятно, почему инструкции не помогали.
Почему контекст этого не лечит
И вот, к чему я пришёл.
Модель обучена на открытом коде. Конфигурация вашего клиента — закрытая и уникальная.
Её не было ни в одном обучении. И не будет. Её не видел никто, кроме вас и предыдущей команды, которая её дорабатывала. Это не недостаток модели и не недоработка производителя — это свойство задачи.
Отсюда всё остальное:
Пересказать конфигурацию текстом нельзя. Возьмите свою рабочую УТ с доработками и попробуйте описать её словами так, чтобы по описанию можно было написать рабочий код. Не «в общих чертах», а чтобы имена процедур были настоящие, параметры настоящие, связи между модулями настоящие. Вы упрётесь в объём на первой же подсистеме.
А то, что влезло, устаревает. Допустим, вы героически описали. На следующей неделе разработчик правит общий модуль — и ваше описание в этом месте уже врёт. Ещё через месяц оно врёт в десяти местах, и вы не знаете, в каких именно. Врущее описание хуже отсутствующего: по отсутствующему модель хотя бы честно скажет «не знаю», а по врущему уверенно напишет вызов процедуры, которой больше нет.
Инструкции лечат не ту болезнь. Инструкция объясняет, КАК надо писать. А у модели проблема не в том, как писать, — она отлично знает, как писать. У неё проблема в том, что она не знает, ЧТО у вас есть. Никакая инструкция этого не заменяет: это не знание о правилах, это знание о фактах, и фактов слишком много.
И вот вывод, к которому я тогда шёл вслепую и сформулировал сильно позже:
Нейросети нужен не рассказ о конфигурации. Нейросети нужен способ её спросить.
Разница огромная. Рассказ — это когда я заранее вываливаю в контекст всё, что считаю важным, и надеюсь, что угадал. Способ спросить — это когда модель сама, в момент работы над конкретной задачей, идёт и выясняет ровно то, что ей сейчас нужно: какие есть объекты, что делает вот эта процедура, откуда её зовут, есть ли уже готовое решение похожей задачи.
В первом случае я пытаюсь предугадать вопросы. Во втором — отвечаю на заданные.
Отдельно про деньги, потому что это неочевидно
Когда я писал свои памятки, я думал, что плачу за них один раз. Ну, положил в начало разговора описание метаданных на десять страниц — заплатил за десять страниц, дальше работаем.
Так это не работает.
Нейросеть не помнит разговор так, как помним его мы. На каждом своём шаге она получает всю переписку заново — и ваши десять страниц заново, и предыдущие свои ответы заново. Один шаг — один раз. Сорок шагов в задаче — сорок раз. Памятка, которую вы написали один раз, оплачивается на каждом шаге до конца работы. Да, сейчас модели используют кэш и повторная отправка стоит дешевле первой, но сути это не меняет: вы платите за памятку столько раз, сколько шагов сделали.
Отсюда и получалось самое неприятное: чем добросовестнее я описывал конфигурацию, тем дороже становилась КАЖДАЯ задача — и тем меньше места оставалось на саму задачу. Причём худшее в этом даже не деньги. Худшее — что моя памятка, которая нужна была в двух местах из сорока, все сорок шагов сидела у модели перед глазами и мешала ей видеть то, что действительно относится к делу.
Спрашивать по мере надобности дешевле не на проценты. Дешевле в разы — просто потому, что спрошенное приходит один раз и ровно тогда, когда нужно.
Я на это потратил три месяца тупика и кучу денег на сожжённый контекст, поэтому позволю себе сказать прямо: если вы сейчас пишете третью версию большой памятки для нейросети по вашей конфигурации — остановитесь. Я копал в эту сторону, сокровищ там нет.
Схема: что нейронка про вашу конфигурацию знает и чего не знает
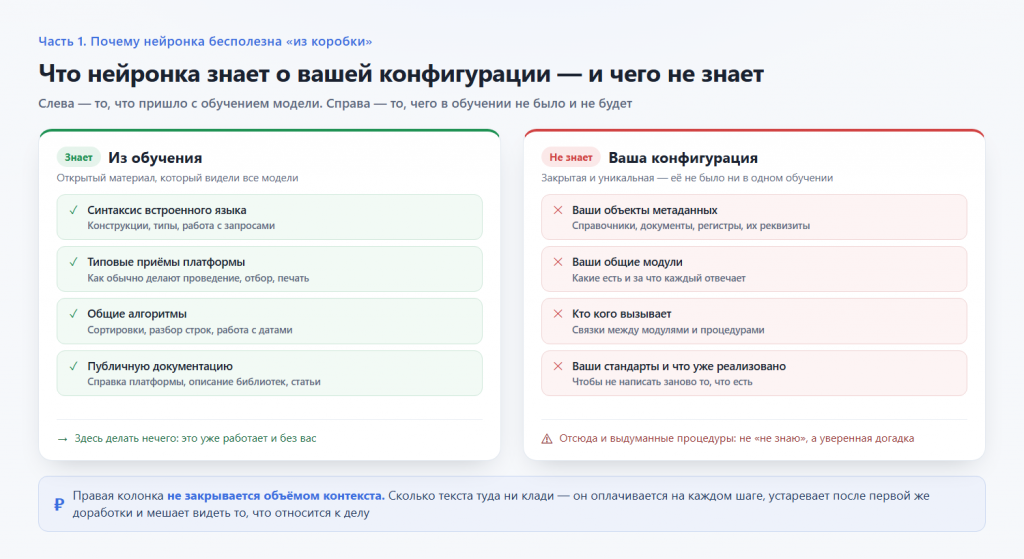
Левая колонка закрыта обучением модели и вам ничего делать не надо. Правая колонка обучением не закрывается никогда — и, что важнее, не закрывается объёмом контекста. Сколько текста туда ни клади.
Семь вопросов, на которых это видно
Скорее всего, вы через это уже проходили сами. Просто вспомните, что отвечала ваша нейронка, когда вы спрашивали её примерно такое:
- Какие общие модули есть в конфигурации и за что каждый отвечает?
- Какие у документа реализации реквизиты шапки и какого они типа?
- Какая процедура отвечает за запись движений документа при проведении?
- Откуда вызывается вот эта процедура — любая из ваших доработок?
- Есть ли в конфигурации готовая функция, которая делает вот это? Причём описанное человеческим языком, своими словами, а не именем процедуры: здесь как раз и проверяется, умеет ли ваша нейронка искать по смыслу, а не по совпадению букв.
- Какие у нас приняты стандарты именования переменных?
- Что сломается, если я поменяю тип вот этого реквизита?
Вспомнили? Ответы обычно трёх видов: правильный, честное «не знаю» и — самый интересный — уверенный и неправильный.
Третий вид и есть та самая проблема: не отсутствие знания, а его имитация. Незнание видно сразу, и с ним можно работать. Уверенная выдумка видна только тогда, когда вы полезли её проверять, — а до этого момента вы на ней уже что-то построили.
Чего я не измерял
Честно про границы этого рассказа.
Чего я не измерял. Никаких замеров тут нет вообще — это рассказ о провале и разбор его причины, а не эксперимент. Я не сравнивал разные модели между собой на этих задачах, не проверял, стало ли лучше у тех инструментов, которые были сырыми прошлым летом (наверняка стало — год в этой области это эпоха), и не мерил, сколько именно денег сжёг на раздутом контексте. Поверьте, много.
Про небольшие задачи. Если вы пишете обработки на пару сотен строк, а не живёте в чужой конфигурации с пятнадцатилетней историей, — с такими задачами хорошо справляется 1С:Напарник. Небольшие типовые задачи он решает отлично.
И отдельно про чистую типовую. Есть расхожее мнение: если работаешь с чистой типовой без доработок, то и проблемы нет — типовая же открытая, модель её наверняка видела. Так вот, нет. Типовую нейронка знает в общих чертах: примерно представляет, что в УТ есть реализация и заказ клиента, и на этом всё. Точных имён процедур, состава реквизитов, того, кто кого вызывает, — не знает. Плюс типовые постоянно меняются: релиз за релизом, и то, что модель когда-то краем глаза видела, — это уже позапрошлая редакция. Так что на чистой типовой всё ровно то же самое: нейросети нужен способ спросить конфигурацию, а не рассказ о ней.
Так что же было в тот день, с которого началась моя история
Как я говорил, в какой-то момент я забросил эксперименты на три месяца. Потом подошёл ещё раз — и в тот день сделал одну вещь по-другому.
Результат оказался такой, что мои разработчики минуты полторы набирали и стирали сообщения в чате, прежде чем кто-то решился отправить то самое, про «нас всех уволят».
А что именно я сделал по-другому — напишу в следующем рассказе.
Напоследок — вопрос к вам, и он мне правда интересен. Сколько времени вы потратили на попытки описать свою конфигурацию для нейронки и что вам это дало? Я точно такой не один: через большие памятки прошли многие. Расскажите в комментариях, до чего дошли вы. Обсудить и вместе поискать решение — с удовольствием.
Вступайте в нашу телеграмм-группу Инфостарт