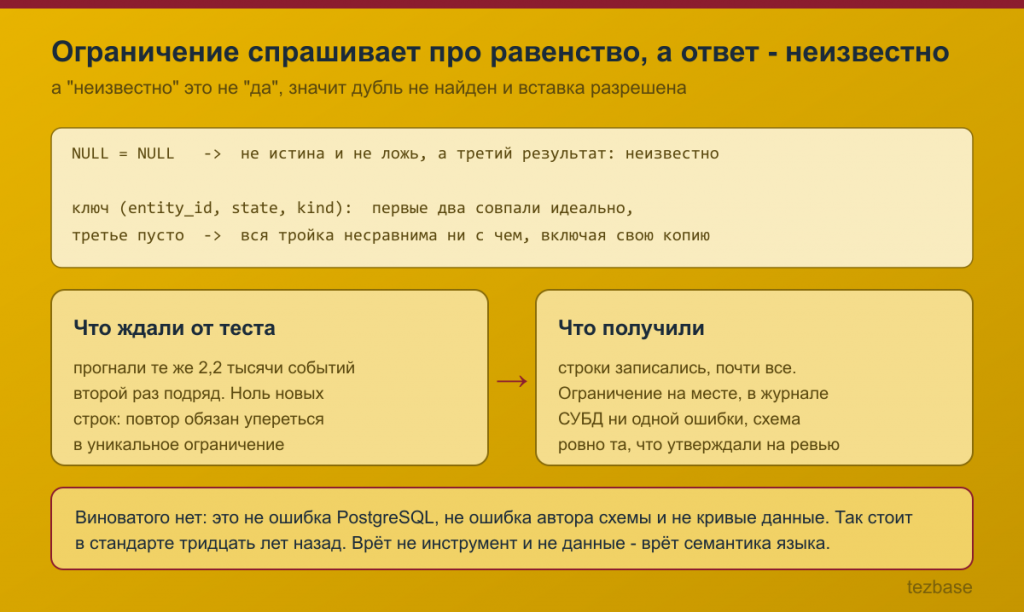
Финальный тест миграции прогонял одни и те же 2,2 тысячи событий второй раз подряд. Ждали ноль новых строк: в таблице стоит уникальное ограничение по тройке полей, повтор обязан в него упереться и отвалиться. Строки записались. Почти все. Ограничение при этом на месте, в журнале СУБД (система управления базами данных) ни одной ошибки, схема ровно та, которую утверждали на ревью.
Виновата одна колонка из трёх. Она допускает пустое значение, и на боевых данных пустой она была примерно у 79 % строк.
Дальше разбор: почему так происходит, почему это правильное поведение стандарта, как это чинится на PostgreSQL 15 и старше, что делать тем, кто сидит на четырнадцатой, и главное - как найти такие ограничения у себя, не дожидаясь своего теста.
Что вообще произошло
Таблица служебная, живёт рядом с учётной базой и хранит историю состояний по внешним операциям. Обработчик тянет события из внешней системы и кладёт их к себе. Обработчик может упасть в любой момент: сеть, таймаут, перезапуск сервиса. Значит он обязан быть перезапускаемым - повторный проход по тем же данным не должен наплодить дублей.
Защиту от дублей повесили на схему. Так честнее, чем проверять в коде: код можно обойти, а ограничение в базе обойти нельзя. Ключ выбрали из трёх полей: идентификатор сущности, состояние и признак. Условно вот так:
CREATE TABLE integration_event (
  id        bigserial PRIMARY KEY,
  entity_id uuid NOT NULL,
  state     text NOT NULL,   -- CREATED, IN_TRANSIT, RECEIVED и далее
  kind      text,            -- для части состояний неизвестен, остаётся пустым
  UNIQUE (entity_id, state, kind)
);
Смотрится нормально. Ревью прошло, тесты на подготовленных данных прошли, в схеме написано UNIQUE, все спокойны.
А теперь два одинаковых INSERT подряд:
INSERT INTO integration_event (entity_id, state, kind)
VALUES ('11111111-1111-1111-1111-111111111111', 'CREATED', NULL);

INSERT INTO integration_event (entity_id, state, kind)
VALUES ('11111111-1111-1111-1111-111111111111', 'CREATED', NULL);
Оба проходят. В таблице две строки с одинаковым набором значений. Ошибки нет, предупреждения нет, в логе пусто.
Забрать отсюда: ограничение, которое видно в схеме и которое одобрило ревью, может не работать. Наличие слова UNIQUE не доказывает, что дубль не пройдёт.
Почему так, и почему это не баг
Причина в одной строчке стандарта языка SQL, которую все знают и почти никто не применяет к уникальности.
Пустое значение (NULL) - это не "ничего" и не пустая строка. Это "значение неизвестно". Поэтому сравнение двух неизвестных значений не даёт ни истины, ни лжи, оно даёт третий результат: неизвестно. NULL = NULL не истина.
Уникальное ограничение проверяет ровно это равенство. Оно спрашивает у строк: вы одинаковые? Получает ответ "неизвестно", а "неизвестно" это не "да". Значит дубль не найден, значит вставка разрешена.
Дальше арифметика. Пустое значение в ключе делает всю тройку несравнимой. Не важно, что первые два поля совпали идеально: третье отравляет сравнение целиком, и вся строка становится неотличимой ни от чего, включая свою точную копию.
Отсюда неприятное следствие: чем чаще колонка пуста, тем реже работает ограничение. У нас признак kind заполняется только на поздних состояниях, а ранние идут без него. Посчитали долю на живой таблице:
SELECT count(*)                                    AS vsego,
       count(*) FILTER (WHERE kind IS NULL)        AS bez_priznaka,
       round(100.0 * count(*) FILTER (WHERE kind IS NULL) / count(*), 1) AS dolya
FROM integration_event;
79 %. То есть ограничение уникальности защищало 21 % строк. Из 2,2 тысячи событий под защитой было около четырёхсот шестидесяти, без защиты около тысячи семисот сорока.
Формулировка "констрейнт бесполезен для подавляющего большинства строк" звучит как эмоция, но она посчитана и не преувеличена: четыре строки из пяти шли мимо защиты.
И вот что тут важно понять про природу дефекта. Это не ошибка PostgreSQL, не ошибка разработчика схемы и не следствие кривых данных. Так написано в стандарте, так реализовано, так же ведут себя и другие СУБД, кроме одной, о которой ниже. Виноватого нет, ошибки нет, сообщения нет. Механизм тихого вранья тут новый: врёт не инструмент и не данные, врёт семантика языка, на которую все согласились тридцать лет назад.
Забрать отсюда: уникальность ключа гарантирована только на той части строк, где все поля ключа заполнены. Долю этой части можно посчитать одним запросом, и посчитать её надо заранее.
При чём тут 1С
Прямо при том, что таких служебных таблиц рядом с учётной базой сейчас много у всех: промежуточная таблица обмена, буфер интеграции, журнал вызовов веб-сервиса, очередь фоновых заданий. Структуру таблиц самой платформы мы руками не правим. Зато всё, что заводим рядом, наше целиком, и уникальность там держим сами.
Есть и знакомая половина этой истории. В языке запросов 1С семантика пустого значения ровно такая же: сравнение с NULL через равенство не сработает, нужен оператор ЕСТЬ NULL, а привести пустое к чему-то осмысленному помогает ЕСТЬNULL(). Это знает каждый, кто хоть раз делал левое соединение и получил в колонке дырку.
Разница в том, что там пустое значение видно глазами. Оно вылезает в результате запроса, портит отчёт, и его идут чинить. А в ограничении уникальности его никто не видит: ограничение молчит, потому что делает ровно то, что ему велено.
Забрать отсюда: правило "сравнение с пустым значением не даёт истину" вы уже знаете по запросам. Перенесите его на объявления собственных таблиц, там оно стоит заметно дороже.
Отклонённая гипотеза: "значит, и в MS SQL было так же"
Первое, что мы подумали, когда посчитали 79 %: дубли копились и до переезда, просто их никто не искал. Логика прямая - поведение стандартное, СУБД до миграции была MS SQL Server, значит и там ограничение пропускало пустые значения.
Гипотеза не подтвердилась, и это самое практичное место всего разбора.
MS SQL Server в уникальных индексах ведёт себя противоположно стандарту: пустые значения он считает равными между собой и пускает только одну такую строку. Вторая попытка вставить пару с пустым полем даёт нарушение уникальности. Проверяется тремя строками, на любой базе, за минуту:
CREATE TABLE #t (a int NOT NULL, b int NULL, UNIQUE (a, b));
INSERT INTO #t (a, b) VALUES (1, NULL);
INSERT INTO #t (a, b) VALUES (1, NULL);  -- нарушение уникальности
Тот же тест на PostgreSQL проходит целиком, обе строки лягут.
Следствие холодное. Переезд с MS SQL на PostgreSQL молча снимает защиту, которая до этого работала. Ни ошибок при миграции, ни предупреждений в отчёте инструмента переноса: индекс создался, ограничение создалось, отчёт чистый. Просто с этого дня оно защищает уже не все строки. Только ту долю, которая равна заполненности вашего ключа.
У нас на той же миграции был отдельный сюжет, где строки, наоборот, начали считаться одинаковыми: неразрывный пробел на переезде MS SQL в PostgreSQL. Там ломалось сравнение текста и мешало создать индекс. Здесь ломается уникальность и индекс создаётся отлично. Общего между ними только то, что оба ловятся до прода и оба не ловятся ревью.
Тот случай и десяток соседних сложены в предполётный чек-лист Проверка базы перед миграцией на PostgreSQL: невидимые символы, длины строковых измерений против лимитов обеих СУБД, режим управления блокировками, разделение итогов, внешние компоненты без Linux-сборки. Ровно этой проверки там нет, и я скажу, чем она отличается. Уникальные индексы чек-лист обходит, но ищет в них схлопывание строк на невидимых символах, а не пустые значения; гоняют его по базе 1С, а не по служебным таблицам, которые вы завели рядом с ней. Проверка из последнего раздела закрывает как раз этот угол, и в свой чек-лист переезда его стоит вписать отдельной строкой.
Забрать отсюда: если вы переехали на PostgreSQL, список ваших уникальных ограничений с необязательными колонками надо пересмотреть заново. То, что оно годами работало на прежней СУБД, о новой не говорит ничего.
Как чинить на PostgreSQL 15 и старше
Начиная с пятнадцатой версии у ограничения есть явная настройка, которая переключает поведение:
CREATE TABLE integration_event (
  id        bigserial PRIMARY KEY,
  entity_id uuid NOT NULL,
  state     text NOT NULL,
  kind      text,
  UNIQUE NULLS NOT DISTINCT (entity_id, state, kind)
);
Дословно это читается как "пустые значения не считать различными". После такого объявления вторая вставка той же тройки падает с нарушением уникальности, ради чего ограничение и заводилось.
Для существующей таблицы можно пересоздать индекс:
CREATE UNIQUE INDEX CONCURRENTLY integration_event_uq_new
  ON integration_event (entity_id, state, kind) NULLS NOT DISTINCT;
Два предупреждения, оба заработаны на живых данных.
Первое: если дубли уже накопились, команда упадёт. Это не повод её не делать, это повод сначала посчитать, сколько их, и решить, что с ними. Пятиминутная миграция превращается в разбор данных ровно в этом месте, и лучше узнать про это на тестовой копии базы. Копия при этом нужна свежая: доля пустых значений в тесте, поднятом полгода назад, к сегодняшнему проду отношения не имеет, и все выводы по ней будут про другую систему. Поднимать тест из последнего бэкапа ночным заданием умеет Тестовая база из бэкапа рабочей: она печатает скрипт восстановления и расписание к нему, а сама к СУБД не подключается.
Второе: ищите дубли тем же ключом, каким собираетесь строить индекс, иначе счёт не сойдётся:
SELECT entity_id, state, kind, count(*)
FROM integration_event
GROUP BY entity_id, state, kind
HAVING count(*) > 1;
Обратите внимание: GROUP BY считает пустые значения одинаковыми. Уникальный индекс без явной настройки - нет. Одна и та же база даёт два разных ответа на вопрос "сколько тут дублей", и это ровно то расхождение, из-за которого дефект живёт годами.
Забрать отсюда: пересоздание индекса это не одна команда, а две. Сначала запрос на дубли, потом уже CREATE UNIQUE INDEX.
Если версия младше пятнадцатой
Тут два обхода, и оба хуже обновления.
Обход первый: подставное значение. Заводим вычисляемую колонку, где пустое подменяется на что-то непустое, и уникальность вешаем на неё:
ALTER TABLE integration_event
  ADD COLUMN kind_key text
  GENERATED ALWAYS AS (coalesce(kind, '__NULL__')) STORED;

CREATE UNIQUE INDEX ON integration_event (entity_id, state, kind_key);
Работает. И создаёт новую грабку, о которой в исходной документации обычно не пишут: подставное значение живёт в том же домене, что и настоящие. В тот день, когда во внешней системе заведётся признак с текстом __NULL__, две разные по смыслу строки станут одинаковыми, и уже настоящий дубль будет отвергнут как повтор. Вероятность мала, цена высокая, разбираться будете долго.
Если идёте этим путём, берите заведомо невозможное значение. Редкого мало. Для текста годится строка со служебным символом, который во входных данных не встречается физически. Для чисел - значение за пределами допустимого диапазона, закреплённое проверкой.
Обход второй: два частичных индекса. Один на строки с заполненным признаком, второй на строки с пустым:
CREATE UNIQUE INDEX integration_event_uq_kind
  ON integration_event (entity_id, state, kind)
  WHERE kind IS NOT NULL;

CREATE UNIQUE INDEX integration_event_uq_no_kind
  ON integration_event (entity_id, state)
  WHERE kind IS NULL;
Тут важно, что индексов именно два. Часто пишут только первый, с условием IS NOT NULL, и считают задачу закрытой. Первый индекс закрывает 21 % строк, то есть ту часть, которая и без него была защищена. Пустые остаются вообще без всякой уникальности, а они и есть проблема.
Второй недостаток этого обхода вылезает не сразу: он не масштабируется на несколько необязательных колонок в ключе. Одна пустая колонка это два индекса. Две колонки это четыре комбинации, три колонки восемь. Поддерживать такое руками невозможно.
Забрать отсюда: обход существует и для пятнадцати минут работы годится. Но постоянным решением он быть не должен, и это готовый аргумент для разговора с бизнесом про обновление версии. Не про "хочется свежего": на текущей версии защита от дублей стоит нам двух индексов на каждое необязательное поле, и с каждым новым полем счёт удваивается.
Настоящий урок здесь методический
Дефект нашёлся не потому, что кто-то умный посмотрел в схему. Он нашёлся потому, что тест был поставлен правильно.
Сравните две формулировки ожидаемого результата.
"Повторный прогон должен пройти без ошибок" - зелёная всегда. Ошибок и не было: дубли записались тихо и успешно, тест бы отчитался успехом, миграция уехала бы в прод.
"Повторный прогон должен создать ноль новых записей" - проверяемая. Она даёт число, число сравнивается с нулём, и расхождение видно сразу.
Разница между этими двумя строчками в чек-листе и есть цена всего разбора. Первая проверяет, что система не упала. Вторая проверяет, что система сделала то, что обещала. Класс дефектов, о котором вся статья, ловится только второй.
И ещё одна деталь, которую стоит забрать целиком: проверка шла на боевой схеме, в транзакции, с откатом, до слияния изменений. Не на синтетическом наборе из десяти строк, где признак заполнен у всех, потому что его туда положил автор теста. Именно живое распределение пустых значений и дало те самые 79 %. На тестовых данных этой цифры не бывает никогда, там всё аккуратно заполнено.
Забрать отсюда: перепишите в своих регламентах "прошло без ошибок" на "создало ноль новых строк". Одна фраза, а ловит она целый класс тихих дефектов.
Честная граница: когда пустые значения различать надо
Было бы соблазнительно закончить советом "вешайте NULLS NOT DISTINCT везде". Не вешайте.
Есть случаи, где различать пустые значения правильно.
Архивные и справочные данные, где пустое значение неоднозначно. "Неизвестно" и "неприменимо" это разные вещи, и если они обе записаны как пустое, то две строки с пустотой действительно могут быть разными записями. Тут склеивание испортит данные молча и необратимо. Правильное лечение другое: развести смыслы явным значением, а не заклеивать уникальностью.
Версионирование и история. Если по смыслу задачи повторы с пустым полем допустимы и их надо видеть, ограничение вообще не то место, куда идти.
Границы нашего замера тоже назову прямо, потому что без них цифра выглядит убедительнее, чем есть.
79 % - это одна таблица одного проекта на срезе в 66 суток, около 2,2 тысячи событий, порядка тридцати трёх в сутки. Доля целиком определяется тем, как у вас заполняется конкретное поле, и переносить её на свою базу нельзя. Переносить надо запрос, которым она считается.
Второе, чего у нас нет: числа накопленных дублей до исправления. Ограничение не работало на 79 % строк, значит дубли либо были, либо их не создавали по какой-то другой причине, например обработчик и правда ни разу не перезапускался на середине. Ни того, ни другого мы не замерили, и придумывать не буду. Дефект поймали до прода, дальше история кончилась.
Забрать отсюда: перед тем как переключать поведение ограничения, ответьте на один вопрос про свою таблицу - две строки с пустым полем это одна и та же сущность или две разные? Если одна, переключайте. Если две, ограничение вам не поможет вовсе, чините смысл данных.
Найти такие ограничения у себя
Самое полезное после чтения это не ремонт одной таблицы. Это ответ на вопрос, сколько их всего. Запросов к системным таблицам СУБД и прав администратора для ответа не нужно: признак читается из трёх мест, и все три у вас уже есть.
Скрипты схемы. Уникальность вы объявляли сами, значит она лежит в ваших файлах миграций или в описании таблицы, которое прошло ревью. Ищете в них UNIQUE и CREATE UNIQUE INDEX и по каждому ключу смотрите на колонки: та, у которой нет NOT NULL, и есть дыра. Первичные ключи можно пропустить, их колонки обязательные по определению. Частичный индекс с условием WHERE поле IS NOT NULL тоже: пустые строки он честно оставляет за бортом. Частичный индекс с любым другим условием проверяйте как обычный, дыра у него та же. На PostgreSQL 15 и старше заодно отметьте ключи, где уже стоит NULLS NOT DISTINCT: там поведение переключено, и таблица из списка выпадает.
Конфигуратор. Если служебная таблица подключена к конфигурации как внешний источник данных, у каждого её поля есть свойство "Разрешить Null". Если флажок стоит у поля из ключа уникальности, это тот же признак, только видный прямо из дерева метаданных. Сам ключ уникальности конфигурация не знает: "Ключевые поля" внешней таблицы платформа использует, чтобы отличать строки у себя, и ограничений в СУБД они не создают. Поэтому список ключей берётся из скриптов, а конфигуратор отвечает на второй вопрос: какое из полей ключа может прийти пустым.
Запрос 1С. Дальше по каждой найденной таблице считается доля пустых значений и заодно ищутся уже накопленные дубли. Через внешний источник это обычный пакет на языке запросов, его можно выполнить в консоли запросов или из обработки:
Запрос = Новый Запрос;
Запрос.Текст =
"ВЫБРАТЬ
|	КОЛИЧЕСТВО(*) КАК Всего,
|	ЕСТЬNULL(СУММА(ВЫБОР
|				КОГДА События.Признак ЕСТЬ NULL
|					ТОГДА 1
|				ИНАЧЕ 0
|			КОНЕЦ), 0) КАК БезПризнака
|ИЗ
|	ВнешнийИсточникДанных.Интеграция.Таблица.СобытияИнтеграции КАК События
|;
|
|////////////////////////////////////////////////////////////////////////////////
|ВЫБРАТЬ
|	События.Сущность КАК Сущность,
|	События.Состояние КАК Состояние,
|	События.Признак КАК Признак,
|	КОЛИЧЕСТВО(*) КАК Строк
|ИЗ
|	ВнешнийИсточникДанных.Интеграция.Таблица.СобытияИнтеграции КАК События
|
|СГРУППИРОВАТЬ ПО
|	События.Сущность,
|	События.Состояние,
|	События.Признак
|
|ИМЕЮЩИЕ
|	КОЛИЧЕСТВО(*) > 1";

Результаты = Запрос.ВыполнитьПакет();
Доля = Результаты[0].Выгрузить();   // Всего и БезПризнака, делите второе на первое
Дубли = Результаты[1].Выгрузить();  // каждая строка - повтор, который индекс пропустил
Имена источника, таблицы и полей условные, как и сама таблица в начале статьи. Первый запрос пакета даёт долю строк, которые идут мимо защиты. Второй работает на том же расхождении, о котором шла речь в разделе про ремонт: группировка складывает пустые значения в одну группу, уникальный индекс их различает. То, что индекс пропустил, группировка покажет строкой с количеством больше единицы.
Если внешнего источника нет и заводить его ради проверки не хочется, остаётся проверка из методического раздела: прогнать обработчик второй раз на тех же данных и сравнить число строк до и после. Больше нуля - защита на этой таблице не работает, и для этого вывода не нужно знать ничего о схеме.
Список приоритетов получается сам. Ограничение, у которого поле пусто в единицах процентов, подождёт. Ограничение с долей за половину надо смотреть сегодня.
Забрать отсюда: признак читается по вашим же скриптам схемы и по свойству "Разрешить Null" в конфигураторе, доля и накопленные дубли считаются одним пакетом запросов 1С. Полчаса работы, и вы знаете, сколько у вас защиты только на бумаге.
Открытый вопрос
Теперь вопрос к вам, и он не риторический. Пройдитесь по своим скриптам схемы, посчитайте долю пустых значений пакетом из последнего раздела и напишите в комментариях, сколько уникальных ограничений с необязательными колонками у вас нашлось и какая максимальная доля пустых значений получилась. Мне интересно, 79 % это наш выброс или нормальная картина для служебных таблиц вокруг учётной системы. Соберём выборку - будет что обсудить предметно.
Проверка из последнего раздела закрывает служебные таблицы рядом с базой. Саму базу 1С перед переездом на PostgreSQL проверяет Проверка базы перед миграцией на PostgreSQL: уникальность, сравнение строк и длины полей, то есть ровно те три места, где обещание схемы расходится с поведением сервера.
Другие наши инструменты для проверки базы:
- Проверка базы перед миграцией на PostgreSQL - что именно встанет на переносе: уникальные индексы, сравнение строк, длины полей.
- Чек-ап СУБД под 1С - настройки сервера баз данных, с которых стоит начинать, когда поведение базы расходится с ожидаемым.
- Проверка базы перед переносом на MS SQL Server - обратное направление, свой набор расхождений со стандартом.
- Чек-ап чистоты базы 1С - сколько в базе накопилось данных, которые никакое ограничение уже не удержит, и сколько займёт уборка.
Вступайте в нашу телеграмм-группу Инфостарт