





Вопрос, на который обычно нет быстрого ответа: правильно ли база 1С стоит на СУБД? Статей и чек-листов по настройке SQL Server хватает, но чтобы ими воспользоваться, нужно попасть в SSMS, вспомнить два десятка представлений и самому решить, что из увиденного - норма, а что уже проблема. У 1С-ника доступа к серверу баз данных чаще всего нет, а у администратора нет контекста 1С.
Эта обработка закрывает разрыв: она собирает показатели с двух сторон и по каждому выносит вердикт - норма, внимание или чинить - с объяснением, чем именно это грозит базе 1С.
Главное отличие: обработка не подключается к СУБД
Ни строки подключения, ни пароля, ни COM, ни внешних компонент - обработка не ходит на сервер баз данных вообще. Вместо этого она печатает готовый диагностический скрипт: администратор выполняет его у себя, отдаёт результат текстом, а обработка этот результат разбирает и выносит вердикты.
Это важно там, где безопасность не разрешает вшивать доступ к SQL Server в обработку, а DBA не готов пускать разработчика на сервер. Скрипты при этом только читают системные представления - ни одной записи, ни одного DDL, ни одной смены настройки.
Что проверяется со стороны 1С (без чьей-либо помощи)
- режим управления блокировкой данных - автоматический и смешанный отдельно, с объяснением последствий;
- режим совместимости конфигурации;
- полнотекстовый поиск: включён ли и на какую дату актуален индекс;
- регламентные задания: сколько включено, и сколько фоновых упало за неделю;
- журнал регистрации за выбранный период: таймауты на блокировках, взаимоблокировки, ошибки от СУБД - по счётчикам сразу видно, есть ли проблема вообще;
- регистры накопления: разделение итогов и регистры, у которых итоги посчитаны давно;
- файловый или клиент-серверный режим, версия платформы, число активных сеансов.
Что проверяется со стороны СУБД (по результату скрипта)
- MAXDOP и порог параллелизма - с разбором, почему заводские
0и5под 1С дают очереди; - максимум памяти SQL Server и его доля от физической;
- модель восстановления и что именно держит журнал транзакций (
log_reuse_wait_desc); - авто-закрытие, авто-сжатие, авто-обновление статистики, RCSI, priority boost, optimize for ad hoc;
- файлы базы: размеры, доля лога от данных и как задан автоприрост - проценты и мелкий шаг ловятся отдельно;
- число файлов данных tempdb относительно числа ядер;
- топ ожиданий с расшифровкой: CXPACKET, PAGEIOLATCH, WRITELOG, LCK_M_*, PAGELATCH, THREADPOOL, RESOURCE_SEMAPHORE - что каждое из них означает применительно к 1С (фоновые типы ожиданий из топа отфильтрованы, чтобы не отвлекали);
- история резервных копий: когда была последняя полная, есть ли копии журнала и какой из этого следует реальный RPO.
Для PostgreSQL скрипт свой: версия, размер базы, ключевые параметры (shared_buffers, work_mem, автовакуум, max_locks_per_transaction, специфичные для 1С online_analyze и plantuner), статистика по взаимоблокировкам, временным файлам и попаданиям в кэш.
Чем это отличается от чек-листа в статье
Чек-лист говорит «проверьте MAXDOP». Обработка говорит: «MAXDOP = 0 при 24 ядрах - чинить; ноль означает „использовать все ядра“, запросы 1С короткие и частые, параллельные потоки начинают ждать друг друга - это и есть CXPACKET в топе ожиданий выше».
Отчёт отсортирован не по алфавиту, а по важности: сначала «чинить», затем «внимание», в конце справочные значения. Сверху - строка итога вида «чинить - 3, внимание - 4, норма - 12», чтобы за секунду понять масштаб. Вердикт никогда не спорит с собственным объяснением: если параллелизм уже настроен верно, CX-ожидания помечаются справочными, а не «чинить».
Библиотека из 17 скриптов - и у каждого свой разбор
Вердикт без следующего шага бесполезен, поэтому в обработку встроена библиотека диагностических скриптов. Это не «коллекция полезных запросов»: каждый скрипт заканчивается блоком «Итог», который обработка читает и переводит на человеческий язык. Вставили результат - получили не таблицу цифр, а фразу вида:
«Статистик старше месяца на таблицах от 100 тысяч строк: 21, из них старше трёх месяцев - 21. Самая старая не обновлялась 97 дней. Оптимизатор строит планы по этим данным, поэтому на больших таблицах он уже работает вслепую. Автообновление тут почти не срабатывает: его порог - около 20 % изменённых строк, а на таблице в 50 млн это 10 млн изменений».
MS SQL Server - 11 скриптов
-
Полная диагностика настроек. Тот самый чек-ап: за один прогон снимает настройки сервера и базы - параллелизм, память, модель восстановления, автоприрост файлов, tempdb, топ ожиданий, историю копий. Результат целиком уходит в разбор, и на выходе получается отчёт с вердиктом по каждому пункту. С него и начинают.
-
Кто кого блокирует прямо сейчас. Снимок текущих блокировок: кто ждёт, кого ждёт, сколько уже ждёт, из какого приложения пришёл и какой запрос выполняет. Разбор находит голову цепочки - сеанс, который держит данные и сам никого не ждёт, - и говорит прямым текстом: настройками сервера это не лечится, смотрите, что делает держатель в 1С. Сопоставить SPID с сеансом можно в консоли кластера, поле «Соединение с СУБД».
-
Долгие транзакции и что держит журнал. Показывает открытые транзакции с их возрастом и отдельно - причину, по которой журнал не переиспользуется (
log_reuse_wait_desc). Разбор различает два разных диагноза:ACTIVE_TRANSACTION- виновата конкретная транзакция, она же в верхней строке;LOG_BACKUP- виновата не транзакция, а полная модель восстановления без копий журнала. Ориентир простой: транзакции 1С живут секунды, всё, что идёт минутами, - аномалия. -
Заполненность файлов и журнала, %. Отвечает на вопрос «сколько мы ещё продержимся»: по каждому файлу - сколько занято внутри него и как задан автоприрост. Разбор отдельно ловит две вещи: журнал под 90 % и прирост, заданный процентами. Второе коварнее - чем больше файл, тем длиннее пауза на расширении, и однажды она случается в разгар рабочего дня.
-
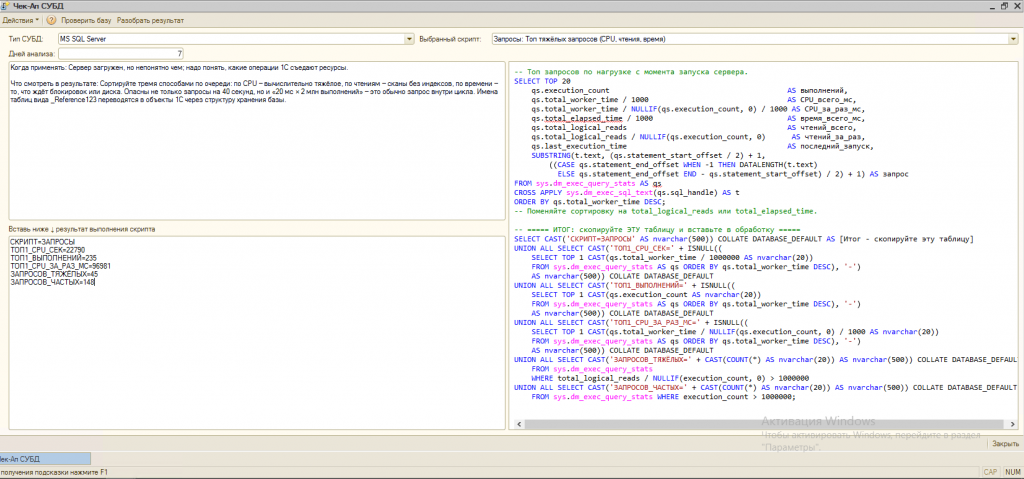
Топ тяжёлых запросов (CPU, чтения, время). Три сортировки одного среза: по процессорному времени - вычислительно тяжёлое, по чтениям - сканы без индексов, по длительности - то, что стоит на диске или блокировках. Разбор считает не только рекордсменов, но и запросы, которые читают больше миллиона страниц за вызов, и отдельно - выполняемые миллионы раз: «20 мс × 2 млн выполнений» почти всегда означает запрос внутри цикла и вредит сильнее, чем один запрос на сорок секунд.
-
Топ ожиданий сервера. Во что сервер упирается, накопленным итогом. Фоновые типы ожиданий из выдачи убраны, чтобы не занимали первые строки. Разбор расшифровывает топ применительно к 1С: CXPACKET и CXSYNC - лишний параллелизм, PAGEIOLATCH - диск или нехватка памяти, WRITELOG - медленный диск журнала, LCK_M_* - конкуренция за данные (настройками не лечится), PAGELATCH_UP - обычно один файл tempdb, THREADPOOL - кончились рабочие потоки. И честно предупреждает: счётчики копятся с перезапуска сервера, на свежеподнятом экземпляре картина ничего не значит.
-
Фрагментация индексов по порогам. Список индексов крупнее 1000 страниц с процентом фрагментации, разложенный по порогам: до 5 % не трогать, 5-30 % - REORGANIZE, больше - REBUILD. Разбор считает, сколько индексов попадает в каждую группу, и сразу напоминает про цену перестроения: REBUILD полностью логируется, в редакции Standard блокирует таблицу, а после него резко растут разностные копии.
-
Устаревшая статистика. Классический сюжет «вчера работало, сегодня висит» при том, что данных прибавилось немного. Скрипт показывает, когда статистика обновлялась в последний раз, по таблицам от 100 тысяч строк. Разбор считает, сколько статистик старше месяца и старше трёх, и объясняет, почему автообновление тут не спасает: его порог - около 20 % изменённых строк, а на таблице в 50 млн это 10 млн изменений.
-
Кто занимает tempdb и version store. Разносит содержимое tempdb на три части: временные таблицы, сортировки с хеш-соединениями и хранилище версий строк. Разбор переводит это в причины: много временных таблиц - чьи-то пакетные запросы с ПОМЕСТИТЬ на миллионы строк; много сортировок - отчёты без подходящих индексов; растёт version store - включён RCSI и живёт длинная транзакция, из-за которой версии не очищаются (лечится транзакцией, а не размером tempdb).
-
История копий и реальный RPO. Когда была последняя полная копия, была ли разностная, есть ли копии журнала. Разбор переводит это в единственную величину, которая важна бизнесу: сколько работы потеряется при отказе прямо сейчас. Отдельно ловится самая частая связка - полная модель восстановления без копий журнала: журнал растёт, а восстановиться на точку всё равно нельзя.
-
Сеансы 1С глазами СУБД. Сколько сеансов на сервере, сколько из них от 1С, кто сколько процессорного времени съел за свою жизнь и кто прямо сейчас ждёт блокировок. Разбор даёт масштаб нагрузки и подсказывает следующий шаг, если жертвы блокировок нашлись. Тут же честное ограничение: имя пользователя 1С со стороны СУБД не видно - все сеансы приходят от сервера приложений, искать конкретного человека нужно по SPID в консоли кластера.
PostgreSQL - 6 скриптов
-
Полная диагностика настроек. Версия, размер базы, ключевые параметры (
shared_buffers,work_mem, автовакуум,max_locks_per_transaction, специфичные для 1Сonline_analyzeиplantuner), статистика по взаимоблокировкам, временным файлам и попаданиям в кэш. Так же разбирается обработкой и даёт отчёт с вердиктами. -
Кто кого блокирует прямо сейчас. Цепочки блокировок через
pg_blocking_pids. Разбор находит голову цепочки и подсказывает, чем её снимать:pg_cancel_backendотменяет запрос,pg_terminate_backendубирает сеанс целиком. -
Долгие запросы и idle in transaction. Главная беда PostgreSQL под 1С: открытая и брошенная транзакция держит блокировки и не даёт автовакууму чистить старые версии строк. Скрипт показывает такие сеансы с их возрастом, разбор объясняет, чем это кончится для размера базы.
-
Топ таблиц по размеру. Из чего состоит база: данные и индексы отдельно. Разбор отдельно отмечает случай, когда индексы весят больше данных, - обычно это лишние индексы.
-
Автовакуум и мёртвые строки. Доля мусора по таблицам и дата последнего автовакуума. Разбор ловит связку «больше 20 % мёртвых строк и пустая дата»: автовакуум не успевает либо ему мешает долгая транзакция.
-
Топ запросов по нагрузке. По
pg_stat_statements, с учётом переименования колонок в 13-й версии. Разбор смотрит не только на среднее время, но и на число выполнений, и отдельно - на процент попаданий в кэш: низкий означает чтение с диска, то есть малоshared_buffersили не хватает индексов.
Скрипты показываются с подсветкой синтаксиса - ключевые слова, комментарии, строки и системные представления разными цветами - и копируются в SSMS как обычный текст. У каждого слева написано, когда его применять и что смотреть в результате.
Скрипты не падают на старых серверах
Отдельно потрачено время на версионную совместимость, потому что тут легко получить неприятность: отсутствующая колонка роняет весь пакет на этапе компиляции, и TRY/CATCH вокруг неё не помогает - до выполнения дело просто не доходит. Поэтому версионно-зависимые показатели (например, sys.dm_os_sys_info.total_physical_memory_kb, появившийся в 2012) запрашиваются динамическим SQL под TRY/CATCH: не нашлось - пропущен один показатель, а не весь чек-ап. Заявленный минимум - SQL Server 2008, и он честный.
Там же закрыт конфликт сортировок: строки из системных представлений и текстовые литералы объединяются с явным COLLATE DATABASE_DEFAULT, иначе на базе с русской сортировкой UNION ALL падает с ошибкой 451.
Как пользоваться
- Чек-ап со стороны 1С - отчёт появляется сразу, доступ к СУБД не нужен.
- Выбрать в списке нужный скрипт (первый - полная диагностика настроек) и отдать администратору либо выполнить самому, если доступ есть.
- Разобрать результат скрипта - вставить блок «Итог» из результата в поле слева и получить второй отчёт: вердикты плюс связный текст о том, что именно вернул скрипт.
- Дальше по вердиктам берутся точечные скрипты библиотеки - и у каждого работает тот же разбор.
Оба отчёта - обычные табличные документы: печатаются и сохраняются в файл, их не стыдно приложить к письму администратору или к отчёту для руководства.
Проверено на боевых базах
Перед публикацией все 11 сценариев прогнаны на двух рабочих базах: на продуктиве с ~580 сеансами и на малонагруженной (для тяжёлых запросов - чтобы никому не мешать). Прогон, кстати, сразу нашёл на живом сервере статистику 97-дневной давности, 598 запросов со сканами и tempdb в один файл.
Совместимость и требования
- Платформа 8.3.14 и новее, управляемое приложение, есть версия для обычного приложения, любая конфигурация - обработка не обращается к прикладным объектам.
- Права: для полного отчёта со стороны 1С нужны административные (чтение журнала регистрации и структуры хранения); без них недоступные проверки честно помечаются как «нет данных», а остальные работают.
- Для скриптов на стороне MS SQL нужны
VIEW SERVER STATEиVIEW ANY DEFINITION; блок истории бэкапов требует доступа кmsdbи при его отсутствии просто помечается «нет доступа». - Файловая база: первый блок проверок работает, второй неприменим - обработка сообщает об этом сама.
Что в файле
Одна внешняя обработка (.epf) без внешних зависимостей и без подключаемых компонент, код открыт. Ничего не пишет ни в базу 1С, ни в СУБД: только читает и объясняет.
Другие наши инструменты диагностики 1С
Эта обработка отвечает на один вопрос: правильно ли база стоит на сервере. Соседние вопросы закрывают остальные.
Производительность и объём:
- Карта объёмов базы 1С - из чего состоит база и куда ушли гигабайты, включая служебные таблицы платформы.
- Трансформатор SQL → 1С - что делает конкретный запрос из профайлера, переведённый в термины метаданных.
- УНИЧТОЖИТЬ в конце пакета - как переписать то, что нашли: временные таблицы в пакетных запросах.
Переезд и обновление:
- Проверка базы перед миграцией на PostgreSQL - предполётный чек-лист, если базу собираются переносить с MS SQL.
- Помощник перехода на 1С:Предприятие 8.5 - что в конфигурации придётся поправить до обновления платформы.
Администрирование и код:
- Аудит паролей СУБД - кто может извлечь пароль SQL из файла кластера 1CV8Clst.lst.
- Анализ кода внешних обработок 1С - что лежит в накопившихся .epf и сколько там техдолга.
Порядок разбора обычно такой: сначала смотрим, из чего база и как она стоит на сервере, потом спускаемся к конкретному запросу.
Проверено на следующих конфигурациях и релизах:
- Розница, редакция 2.3, релизы 2.3.25.23
- Управление производственным предприятием, редакция 1.3, релизы 1.3.261.1
Вступайте в нашу телеграмм-группу Инфостарт