Как ИИ-агент ищет код в ЕРП УХ: сравнение rlm-tools-bsl и code-index-mcp
TL;DR или коротко о результатах
- Разные интерфейсы работы. В rlm агент пишет Python-код в песочнице и может обработать данные перед выводом. В code-index использует готовые типизированные MCP-вызовы.
- Подготовка индекса. На моём корпусе code-index построил индекс за 949 с, rlm — за 1323 с. Размеры — 11,55 и 2,65 ГБ соответственно.
- Покрытие эталонов. На 24 парных заданиях микроусреднение составило 0,72 у code-index и 0,68 у rlm; макроусреднение — 0,52 и 0,50. Разница небольшая, а результаты заметно зависят от категории.
- Сквозные сценарии. В двух инцидентах агент с code-index использовал в 2,4–2,8 раза меньше токенов. В третьем расход оказался почти одинаковым.
- Расширения требуют отдельной проверки. В третьем сценарии rlm обнаружил вмешательство CFE-расширения, но у code-index это расширение не входило в индекс. Такой результат нельзя считать симметричным сравнением CFE-анализа. Хотя поначалу я обрадовался, что наконец-то нашел значимую разницу :-)
- Главная методическая ловушка — состояние сессии. Лимит вызовов rlm и дедупликация ответов code-index сделали первую версию тестового драйвера непригодной для сравнения.
Оглавление
#1. Два подхода к поиску по коду
#2. Корпус, версии и стенд
#3. Что и как измерялось
#4. Подготовка индекса: время и место на диске
#5. Скорость запросов и покрытие эталонов
#6. Три инцидента: что меняется, когда поисковиком пользуется агент
#7. Что сломало первую версию сравнения
#8. Как использовать результаты при выборе
#9. Ограничения и следующий шаг
#Вместо вывода
1. Два подхода к поиску по коду
Оба инструмента используют SQLite и подключаются к агенту через MCP — протокол взаимодействия модели с внешними инструментами. Разница прежде всего в том, как агент формулирует запрос и обрабатывает результат.
rlm-tools-bsl: обработка данных в песочнице
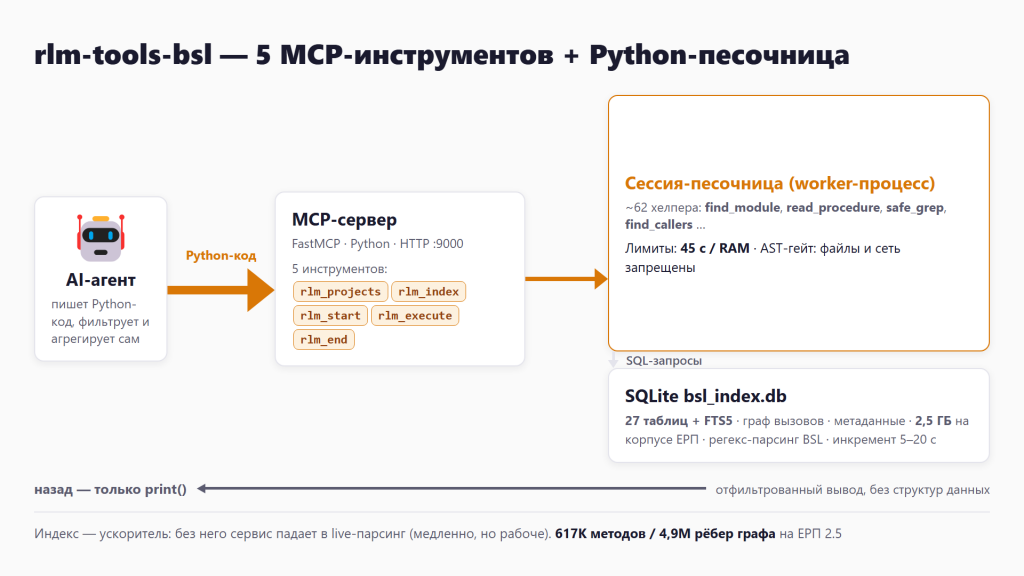
rlm-tools-bsl предоставляет шесть MCP-инструментов: управление проектами, индексацией и сессией, выполнение кода и справку.
Основная работа выполняется через Python-песочницу. Агент вызывает вспомогательные функции поиска и чтения кода, объединяет результаты, фильтрует их и выводит нужное через print().
Например, чтобы получить сведения о нескольких модулях, агент может написать цикл и вернуть только итоговую таблицу. Промежуточные данные при этом не отправляются в контекст модели.
code-index-mcp: готовые типизированные вызовы

code-index-mcp в проверенной версии предоставляет 32 MCP-инструмента: универсальные и специализированные для 1С.
Агент выбирает операцию — найти функцию, прочитать её тело, получить структуру объекта или дерево вызовов — и передаёт параметры. Произвольный Python-код агенту исполнять не нужно.
Для разбора исходников используется tree-sitter. Отдельный демон следит за изменениями файлов и поддерживает индекс.
2. Корпус, версии и стенд
Инструменты
| Параметр | rlm-tools-bsl | code-index-mcp |
|---|---|---|
| Версия | 1.36.0 | 1.2.2 |
| Реализация | Python | Rust |
| Хранение индекса | SQLite | SQLite |
| Подключение | MCP Streamable HTTP | MCP Streamable HTTP |
| Режим запуска | HTTP-сервис | Демон и MCP-сервер |
| Лицензия | MIT | MIT |
Оба инструмента запускались на одной машине в рабочих конфигурациях, описанных в эксперименте.
Исходники
| Параметр | Значение |
|---|---|
| BSL-модули | 29 897 |
| Строк BSL | около 23,5 млн |
| Файлов всего | 135 049 |
| Объём выгрузки | около 9,3 ГБ |
Это рабочая выгрузка 1С:ERP УХ релиза 3.3.3.4 (типовая) с доработками в расширении. Версия платформы: 8.5.4.1683
Машина и условия
- AMD Ryzen 5 5500U, 6 ядер / 12 потоков.
- 16 ГБ оперативной памяти.
- NVMe SSD.
- Windows 11 Pro.
Замеры выполнялись ночью, последовательно, без намеренно созданной параллельной нагрузки (никто на ноуте в этот момент не работал). Кеши ОС между повторами принудительно не сбрасывались.
Автоматизированные тесты запросов работали без LLM. Модель участвовала только в организации сквозных сценариев и сборке результатов работы.
О конфликте интересов
Я не автор этих инструментов и не связан с их разработчиками. Но с rlm-tools-bsl работаю регулярно, а основу тестового набора составили мои сессии именно с ним.
Это могло повлиять на выбор задач и способов их решения. Поэтому результаты стоит воспринимать как сравнение на одном практическом наборе, а не как нейтральное покрытие всех возможностей обоих проектов.
3. Что и как измерялось
Эксперимент состоит из трёх частей.
- Подготовка: время построения индекса, его размер и поведение после изменений файлов.
- Запросы: задержки и покрытие заранее подготовленных эталонов.
- Работа агента: диагностические выводы, число вызовов, время и расход токенов на реальных инцидентах.
Тестовые задания
При подготовке набора агент разобрал 324 вызова моих рабочих сессий. Около 77% вызовов вспомогательных функций относились к навигации и точечному чтению: найти модуль, получить список процедур, прочитать нужную процедуру или фрагмент файла.
На этой основе подготовлены 29 заданий.
| Категория | Содержание | Число заданий |
|---|---|---|
| C1. Навигация | Модули объекта, тело процедуры, сигнатуры, метрики модуля | 4 |
| C2. Метаданные | Реквизиты, табличные части, формы, структура регистра, предопределённые элементы | 4 |
| C3. Поиск | Подстроки, имена методов, регулярные выражения | 5 |
| C4. Граф вызовов | Вызывающие процедуры, иерархии, пути между процедурами | 4 |
| C5. Влияние | Ссылки на объект, движения регистров, подписки, использования в коде | 5 |
| C6. Бизнес-поиск | Поиск по формулировке задачи, синонимам и областям кода | 3 |
| C7. Пакетная работа | Сведения о нескольких модулях и процедурах, агрегаты по объектам | 4 |
Для 25 заданий подготовлены парные способы выполнения. Для четырёх — предопределённых элементов и трёх заданий C6 — эквивалентный сценарий code-index в этом наборе не подготовлен.
Это не доказательство невозможности решить их средствами code-index. Они рассматриваются отдельно и не входят в общий результат сравнения.
Ещё одно парное задание, о подписках на события, исключено из расчёта полноты: запрос для rlm содержал мою ошибку. Таким образом, итоговое покрытие сравнивается по 24 парным заданиям.
Эталоны и покрытие ответа
Эталоны составлялись агентом с помощью прямого чтения исходников и XML, текстового поиска, ручной проверки и, для части заданий, запросов к существующему индексу rlm.
Последний источник создаёт риск смещения: не все эталоны полностью независимы от участников сравнения.
Скорер извлекал из ответов элементы, предусмотренные эталоном: например, пути файлов, имена процедур и точки вызова. Пути нормализовались. LLM в оценивании не участвовала.
Далее под полнотой понимается доля элементов эталона, обнаруженных в ответе:
Полнота = число найденных элементов эталона / число элементов эталона.
Это не оценка правильности ответа целиком. Более того, метрика не штрафует за лишние или ошибочные элементы.
Использовались два способа усреднения:
- Микроусреднение: суммарное число найденных элементов делится на суммарный размер эталонов. Большие эталоны имеют больший вес.
- Макроусреднение: полнота сначала считается для каждого задания, затем берётся среднее. Все задания имеют одинаковый вес.
Поскольку задания неоднородны, общий показатель нужно читать вместе с результатами по категориям.
Повторы и состояние сессии
Для задержек каждое задание выполнялось десять раз. Полнота оценивалась по ответу последнего повтора.
В окончательной версии теста каждый повтор выполнялся в новой сессии. Это оказалось обязательным условием: rlm ограничивал число выполнений кода в сессии, а code-index мог не возвращать данные, уже переданные ранее.
Новая сессия устраняет эти эффекты, но не гарантирует холодного файлового кеша или отсутствия внутренних кешей.
4. Подготовка индекса: время и место на диске
Для полного построения индекс удалялся, после чего запускалась индексация. Выполнено по три повтора; в таблице приведены медианы.
| Показатель | rlm-tools-bsl | code-index-mcp |
|---|---|---|
| Полная индексация | 1322,6 с | 949,2 с |
| Диапазон трёх повторов | 1320,7–1330,7 с | 941,2–953,2 с |
| Размер индекса | 2,65 ГБ | 11,55 ГБ |
| Измеренный пик RAM | Нет корректного замера | Около 1,6 ГБ |
Размеры указаны в десятичных гигабайтах.
Корректно измерить память rlm не удалось: сэмплер наблюдал за процессом обёртки, а не за рабочим процессом.
На этом стенде code-index строил индекс примерно в 1,4 раза быстрее. В понятных величинах — около 16 минут вместо 22. Индекс при этом занимал примерно в 4,4 раза больше места.
Содержимое индексов различается. code-index сохраняет в базе в том числе сжатое содержимое файлов, rlm делает акцент на извлечённой структуре, метаданных и связях.
Поэтому размер — не самостоятельная оценка эффективности. Он показывает цену выбранной модели хранения. Для одного проекта разница может быть несущественной; для нескольких больших выгрузок на ноутбуке — уже заметной.
Что получилось измерить после исправления тестовой системы
| Изменение | rlm | code-index |
|---|---|---|
| Один модуль и один XML | 259,8 с | 1767,8 с |
| Двадцать модулей | 268,5 с | Более 1800 с, остановка по таймауту |
Эта таблица не сравнивает штатный инкремент двух инструментов.
У rlm выполнялся перескан корпуса: выгрузка не находилась в Git, поэтому ускоренный путь через Git был недоступен.
У code-index использовалась консольная команда, которая в данном запуске фактически пересчитывала корпус. Его обычная модель — обработка изменений файлов демоном — этим тестом не измерена.
Практический вывод ограничен: для использованного способа запуска получены именно такие времена. Делать из них вывод «инкремент rlm быстрее» нельзя. Но раз уж посчиталось - добавил в текст статьи.
5. Скорость запросов и покрытие эталонов
Задержки: преимущество code-index в этом прогоне
По сводке автоматизированного прогона типичные задержки rlm в разных категориях лежали в диапазоне от десятков до нескольких сотен миллисекунд. У code-index большинство измеренных значений находилось в пределах 9–42 мс; отдельные пакетные операции доходили до 93 мс.
Это результат конкретных вызовов на готовых индексах. В измерение входят разные пути выполнения: готовые операции code-index и выполнение Python-кода в песочнице rlm, а также возможное чтение и дополнительный разбор файлов.
Покрытие по категориям
Основная таблица включает только парные задания. Значения по категориям — средняя полнота заданий категории.
| Категория |
Число заданий |
rlm | code-index |
|---|---|---|---|
| C1. Навигация | 4 | 0,83 | 0,81 |
| C2. Метаданные | 3 | 0,44 | 1,00 |
| C3. Поиск | 5 | 0,20 | 0,20 |
| C4. Граф вызовов | 4 | 0,62 | 0,73 |
| C5. Влияние | 4 | 0,29 | 0,38 |
| C7. Пакетная работа | 4 | 0,66 | 0,19 |
| Микроусреднение по 24 заданиям | 24 | 0,68 | 0,72 |
| Макроусреднение по 24 заданиям | 24 | 0,50 | 0,52 |
В сумме code-index покрыл больше элементов эталонов. Разница составляет 4 процентных пункта при микроусреднении и 2 — при макроусреднении.
На небольшом наборе неоднородных задач это не основание объявлять универсального победителя. Гораздо полезнее посмотреть, где именно возникли различия.
Навигация: близкие результаты
Найти модуль, получить список процедур и прочитать нужный участок — наиболее частый рабочий сценарий в исходных сессиях.
Здесь результаты близки: 0,83 у rlm и 0,81 у code-index. Для выбора важны уже не столько эти два числа, сколько задержка, удобство вызовов и размер возвращаемого фрагмента.
Метаданные: преимущество code-index на выбранных заданиях
На трёх парных заданиях code-index покрыл эталон полностью, rlm — в среднем на 0,44.
Различия возникли при получении структуры объектов: реквизитов, табличных частей, измерений и ресурсов. Это один из наиболее выраженных результатов данного набора.
Отдельное задание про предопределённые элементы выполнялось только rlm и сюда не включено.
Граф вызовов: важен не только парсер, но и обрезка ответа
Результаты — 0,62 у rlm и 0,73 у code-index.
В одном задании с иерархией вызывающих оба инструмента столкнулись с ограничениями выдачи. У code-index сработал лимит числа узлов, у rlm часть дерева не попала в напечатанный ответ. При этом code-index показал больше файлов из эталонного набора.
Этот пример полезен для практики: инструмент может обнаружить связи внутри себя, но не передать их агенту в доступной форме.
Однако он не доказывает превосходство AST-разбора над регулярными выражениями. Для такого вывода нужно отдельно сравнивать найденные связи до обрезки и проверять ложные срабатывания.
Анализ влияния: code-index нашёл больше элементов эталона
В категории C5 результат составил 0,38 против 0,29.
Например, в задании о движениях регистров при проведении code-index вернул 8 элементов эталона из 8, rlm — 4 из 8.
Это преимущество в покрытии выбранного ответа. Утверждать, что результат ещё и точнее, нельзя: лишние и ошибочные элементы отдельно не оценивались.
Пакетная работа: преимущество rlm с оговоркой о запросах
В C7 rlm получил 0,66, code-index — 0,19.
Программируемая песочница удобна для задач «обойти несколько модулей, собрать сведения и вывести агрегат». Но часть потерь code-index связана с конкретными вызовами: использованный запрос bsl_sql возвращал global top-10 вместо данных по целевым модулям.
Поэтому корректный вывод такой: подготовленные для теста сценарии rlm лучше решили эти задания. Чтобы отнести разницу к архитектуре, нужно сначала исключить ошибки и неоптимальные параметры запросов code-index.
Поиск: низкая полнота не всегда означает бесполезный ответ
В C3 оба инструмента получили 0,20.
Использованные вызовы возвращали ограниченные выборки. Для задания «перечислить все вхождения» это снижает полноту. Для агента, которому нужны несколько точек входа в код, такая выдача может быть полезной.
Это разные задачи:
- найти место, с которого начать разбор;
- получить исчерпывающий список;
- точно посчитать все вхождения.
Наш показатель ориентирован на покрытие эталона. Он не измеряет, насколько быстро агент сумеет продолжить работу с найденной точки.
Дополнительные задания rlm
За пределами парного сравнения остались четыре задания.
| Задание | Результат rlm |
|---|---|
| Предопределённые элементы справочника | Пустой ответ при наличии 18 элементов в XML |
| Три задания C6: формулировка задачи, синонимы, области кода | Среднее покрытие 0,07 |
Пустой ответ find_predefined требует отдельной проверки: возможны дефект инструмента, изменение контракта или ошибка обращения к нему.
Низкий результат C6 показывает лишь то, что выбранные вызовы плохо покрыли подготовленные эталоны. Он не позволяет делать общий вывод о невозможности смыслового поиска без LLM.
6. Три инцидента: что меняется, когда поисковиком пользуется агент
Автоматизированные задания проверяют заранее заданные вызовы. В реальной работе модель сама решает, что искать дальше, сколько кода читать и когда остановиться.
Для этой части использовалась одна модель — glm-5.3-flash. Для каждого инструмента запускался отдельный субагент. Промпты и параметры генерации между парными прогонами были одинаковыми.
Доступ к исходникам разрешался только через назначенный поисковик. В итоговом ответе агент должен был указать предполагаемую причину, место в коде, цепочку рассуждения и рекомендацию.
Одинаковые настройки не устраняют вариативность поведения модели. Эти результаты показывают конкретные траектории решения, а не устойчивое среднее по множеству запусков.
Расход ресурсов
| Сценарий | Инструмент | Токены по счётчику субагента | Вызовы инструмента | Время |
|---|---|---|---|---|
| S1. Ошибка обращения по ключу | rlm | 317 543 | 37 | 38,6 мин |
| S1 | code-index | 129 321 | 43 | 17,8 мин |
| S2. «Объект не найден» | rlm | 240 047 | 25 | 24,5 мин |
| S2 | code-index | 86 167 | 49 | 14,1 мин |
| S3. «Отразить в учёте» | rlm | 131 317 | 30 | 22,1 мин |
| S3 | code-index | 129 680 | 59 | 25,2 мин |
Это счётчик расхода токенов, а не денежная стоимость. Без разбивки на входные, выходные и кешированные токены переводить числа в деньги некорректно.
S1. «Значение, соответствующее ключу, не задано»
При открытии формы договора с типом «С хранителем» возникала ошибка. Стек указывал на общий модуль ДоговорыКонтрагентовФормыУХКлиентСервер, строку 980.
Оба агента пришли к одинаковому объяснению: код обращается к ФиксированноеСоответствие ОперацииГрафика по ключу предопределённой операции, которой нет в наборе для договора этого типа.
Оба также нашли процедуру инициализации соответствия около строки 714. То есть результатом стал не пересказ стека, а связь между местом ошибки и подготовкой данных.
В этом прогоне code-index потребовал примерно в 2,5 раза меньше токенов и меньше времени, хотя агент сделал больше вызовов инструмента.
S2. «Объект не найден» в поле договора
В форме закупки поле «Договор» содержало битую ссылку, хотя нужный договор был заведён.
Оба агента обнаружили необычный признак: GUID ссылки начинался с байтов 6e 75 6c 6c, соответствующих ASCII-строке null. Далее они указали код автоподбора, формирующий ссылку из строкового идентификатора без проверки существования записи.
Совпадение диагностических выводов здесь интересно само по себе: агентам понадобилось связать отображаемую пользователю ошибку с устройством идентификатора и местом его формирования.
Расход токенов с code-index оказался примерно в 2,8 раза ниже.
При этом совпадение ответов двух агентов не заменяет проверки по данным базы и отладке. В подобных сценариях найденный код и подозрительная ссылка — основание для проверки диагноза, а не автоматическое доказательство.
S3. «Отразить в учёте»: разные доступные слои кода
Третий инцидент связан с длительным выполнением команды «Отразить в учёте» и настройками финансового учёта номенклатуры.
Задача была шире поиска одной строки: восстановить цепочку обработки, определить задействованные регистры, подписки и переопределения.
Агент с rlm обнаружил в расширении замену функции БухгалтерскийУчетПовтИсп.СчетВИерархии через &Вместо. В найденной реализации исключения перехватывались без дальнейшей передачи ошибки. Такое вмешательство потенциально важно для диагностики.
Агент с code-index разобрал типовую цепочку: фоновое задание регламентированного учёта, регистр «Международный» и отсутствие правила уточнения счёта для группы финансового учёта.
Но условия были несимметричными:
- rlm обнаружил соседнее расширение;
- code-index индексировал только каталог основной конфигурации;
- исходников расширения в его индексе не было.
Поэтому S3 показывает различие в доступном корпусе и поведении при настройке, а не кто лучше.
Кроме того, найденное переопределение и подозрительный участок типового кода — ещё не подтверждённая первопричина задержки. Для этого нужна отдельная проверка исполнения.
Следующий необходимый эксперимент — включить расширение в доступный корпус обоих инструментов и повторить сценарий.
Что можно сказать о расходе токенов
В S1 и S2 агент с code-index сделал больше вызовов, но использовал меньше токенов. В S3 расход почти совпал.
Это наглядное напоминание: число вызовов не равно стоимости решения. Несколько коротких ответов могут обходиться дешевле одного большого, особенно если его содержимое затем многократно передаётся в контексте.
Но объяснить разницу только размером выдачи пока нельзя. Для этого нужны раздельные измерения ответов инструментов, входного контекста и генерации модели.
7. Что сломало первую версию сравнения
Этот раздел оказался не менее полезным, чем сами сравнительные результаты.
Лимит выполнений rlm
В проверенной конфигурации после 25 вызовов rlm_execute в одной сессии возникала ошибка Execution call limit exceeded.
Наивный цикл повторов начинал измерять ошибки вместо выполнения заданий. Тестовая система должна учитывать жизненный цикл сессии и проверять не только HTTP-статус, но и содержимое ответа инструмента.
Дедупликация code-index
code-index мог исключать из повторного ответа данные, уже переданные в этой MCP-сессии. В ответе появлялся признак rows_elided_already_delivered.
Для агента это может быть полезным сокращением повторного контекста. Для бенчмарка — ловушка: первый и последующие вызовы перестают быть сопоставимыми по содержимому.
Это не следует путать с обычным ускорением за счёт кеша. Здесь меняется сам ответ.
В окончательной версии драйвера каждый повтор выполнялся в новой сессии, а неожиданные ошибки останавливали прогон.
Всего получилось 540 выполнений заданий:
- 25 парных заданий × 2 инструмента × 10 повторов;
- 4 дополнительных задания rlm × 10 повторов.
Индекс построен, но сервис его не использует
В моей конфигурации консольная утилита rlm и Windows-сервис обращались к разным каталогам индекса. В результате индекс существовал, но сервис переходил к резервному разбору исходников.
Это меняло задержки на порядки для отдельных операций.
Перед замером полезно проверять фактическую загрузку индекса — в данном случае по полю index.loaded в ответе rlm_start — и согласованность RLM_INDEX_DIR, окружения и пользователя, под которым запущен сервис.
Псевдонимы репозитория
При разных способах запуска code-index в моём окружении использовались разные значения псевдонима репозитория: src и default.
Практическая рекомендация — получать список репозиториев от сервера, а не предполагать, что имя осталось прежним после изменения конфигурации.
Пакетные операции требуют настройки
Для использованных пакетных вызовов code-index понадобилось включить mass_mode_tools в daemon.toml.
Если сравнивать пакетные сценарии без этой настройки, можно ошибочно принять отключённую возможность за отсутствие функциональности.
Все эти наблюдения относятся к указанным версиям и окружению. Их стоит перепроверять после обновления инструментов.
8. Как использовать результаты при выборе
По этому эксперименту я бы не выбирал инструмент по одной итоговой цифре. Полезнее начать со своих типичных задач.
| Потребность | Что проверить первым | Основание |
|---|---|---|
| Частая навигация и точечное чтение | code-index | Низкие задержки в этом прогоне при близком покрытии C1 |
| Получение структуры объектов 1С | code-index | Лучшее покрытие трёх парных заданий C2 |
| Пакетная обработка с собственной логикой | rlm | Удобство циклов и агрегаций в песочнице; лучший результат подготовленных сценариев C7 |
| Ограниченное место под несколько индексов | rlm | 2,65 ГБ против 11,55 ГБ на этом корпусе |
| Работа с соседними расширениями | rlm как первый вариант для проверки | Автоматическое обнаружение расширения помогло в S3; симметричный тест ещё нужен |
| Работа без исполнения агентом произвольного Python-кода | code-index | Готовые типизированные операции вместо программируемой песочницы |
| Автоматическое обновление после правок | Проверить штатный режим code-index на своём проекте | Событийная модель предусмотрена, но её задержка здесь не измерена |
| Снижение расхода токенов | Начать с code-index и повторить свои сценарии | Меньший расход в S1 и S2, почти одинаковый в S3 |
Отсутствие исполнения произвольного Python-кода — только один аспект безопасности. Read-only-доступ к исходникам тоже требует контроля прав, сетевого доступа и передачи конфиденциального кода модели.
Можно подключить оба инструмента. Но это не гарантирует лучший результат автоматически: агенту придётся выбирать между пересекающимися возможностями, а команде — поддерживать два индекса и проверять их актуальность.
Поэтому вариант «держать оба» тоже стоит проверять как отдельную конфигурацию, а не считать бесплатным улучшением.
9. Ограничения и следующий шаг
Этот эксперимент ограничен одним корпусом, одним стендом и одной моделью в сквозных сценариях.
Что осталось проверить:
- точность выдачи и ложные срабатывания;
- источники и независимость всех эталонов;
- устойчивость агентных результатов при повторных запусках;
- корректность и оптимальность парных вызовов, особенно SQL в C7;
- штатное событийное обновление индекса;
- S3 при одинаковом доступе к CFE;
- память рабочего процесса rlm;
- поведение на других форматах выгрузки и другом железе.
Часть результатов уже полезна: известны цена построения индекса, размер на диске, наблюдаемые задержки и проблемные места выбранных сценариев. Но некоторые вопросы требуют нового прогона, а не более уверенного объяснения старых чисел.
Вместо вывода
Ну и зачем тогда эта статья, если ты сам же написал, что нужно улучшить в тесте, чтобы все было красиво? - спросит дочитавший до конца. Затем, что я потратил довольно много времени на сравнение и непонятно, интересно ли это хоть кому-нибудь кроме меня. Поэтому оттолкнусь от реакции на статью: будет интерес - сделаю
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.