Защищенный Искусственный интеллект: правда или вымысел?
Администрирование - Информационная безопасность
Что именно мы защищаем, когда говорим об ИИ
Когда мы говорим про искусственный интеллект, надо понимать, что в определенном плане это информационная система. К ней применимы привычные подходы и меры защиты: резервирование, сегментирование доступа, контроль пользователей, авторизация, резервное копирование. В этой статье я подробно останавливаться на них не буду, но подразумеваю, что все классические меры информационной безопасности, необходимые для работы приложений или сервисов, реализованы. Речь пойдет только об особенностях самого искусственного интеллекта: какие здесь возникают новые вызовы, можно ли от них защититься и в каких случаях это возможно.
Под искусственным интеллектом почти все сразу понимают какие-то большие языковые модели. Но на самом деле искусственный интеллект очень разнообразен, существует множество разных технологий. Если говорить о его защите, их можно сгруппировать в несколько блоков.
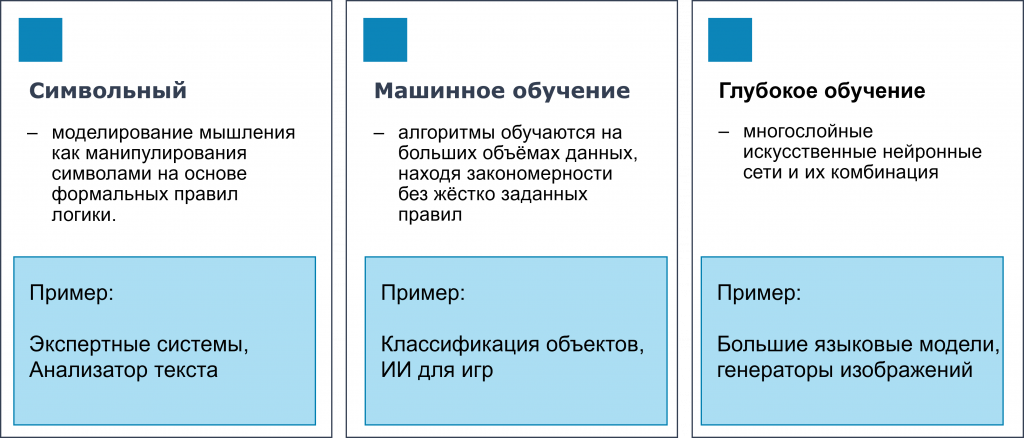
Первый – символьный, то есть то, что обрабатывает текст и работает с текстовыми запросами. Второй – обработка данных: машинное обучение, классификация объектов и работа с ними. Третий блок – сложное, или глубокое, обучение, когда технологии работают в некотором комплексе.
Что отличает искусственный интеллект от тех приложений, с которыми мы привыкли работать? Это своего рода новая архитектура. Помимо большого массива данных, с которым требуется работать, критичным становится качество этих данных. Кроме того, работа строится на базе модели.
Практика и история кибератак, развитие информационной безопасности, как правило, были сфокусированы на том, что человек получил доступ, удалил программу, зашифровал данные. Кроме нескольких очень серьезно подготовленных кибератак, подмена данных и воздействие непосредственно на корректность работы самой системы обычно не реализовывались.
С искусственным интеллектом появляется новый подход: злоумышленник или вредоносное ПО может скорректировать сам принцип работы системы так, чтобы она начала давать ложные результаты. Именно вокруг этой особенности и строятся подходы к защите, потому что это, наверное, то новое, с чем нам предстоит работать.
Ландшафт угроз: данные, модели и вычислительные ресурсы
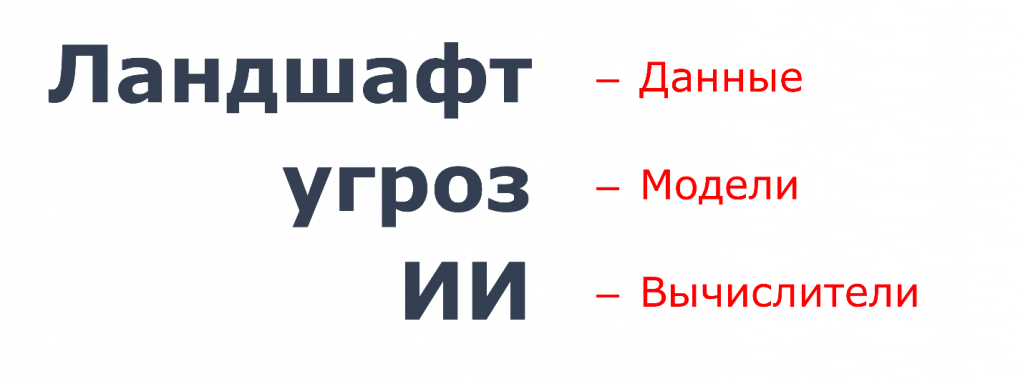
С точки зрения искусственного интеллекта ландшафт угроз, то есть то, что может стать объектом атаки, состоит из трех блоков. Это сами данные, модели, которые с ними работают, и вычислители, на которых все это работает. Вычислительные ресурсы тоже влияют на качество работы модели, и на них также могут проводиться атаки, поэтому они попадают в периметр того, что необходимо рассматривать.
Данные – это то, на чем мы обучаемся, и то, что в дальнейшем дает нам результаты. Атаки на данные бывают пяти основных видов.
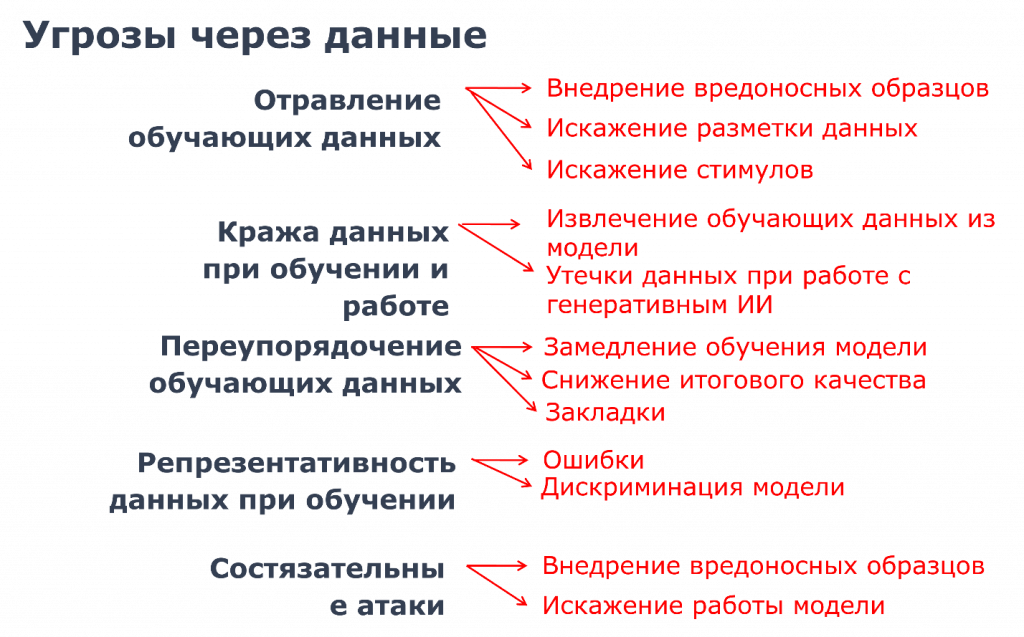
Первое – отравление самих обучающих данных. Второе – кража данных при обучении. Причем кража данных – это не только утечки и потери, которые могут быть критичны для некоторых бизнесов и приложений. Это еще и возможность впоследствии проводить атаки на модели и тем самым наносить компании более серьезный ущерб.
Переупорядочивание обучающих данных и репрезентативность данных, то есть их качество, – это схожие атаки или воздействия. Они могут быть либо шагом к дальнейшему воздействию на управляющую программу и сервисы, которые она оказывает, либо способом замедлить ее работу, ухудшить качество и сделать систему неэффективной.
Состязательные атаки – это уже непосредственное воздействие на программу, когда вносится какой-то вредоносный код, который исполняется и тем самым воздействует на ИТ-инфраструктуру, саму систему и работу приложений.
С точки зрения последствий к угрозам относится внедрение вредоносного образа, который впоследствии будет влиять на работу системы, искажение разметки данных, которое сделает ее некачественной либо позволит в дальнейшем оказывать воздействие, а также замедление системы и ухудшение качества и устойчивости ее работы.
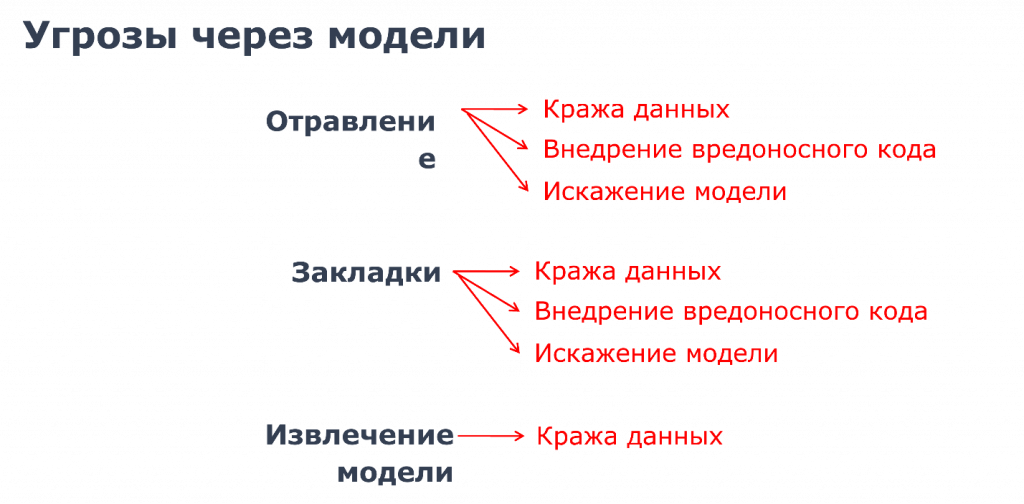
Атаки на модели имеют аналогичные блоки. Здесь идет отравление данных, отравление самой модели – то есть воздействие на то, с какими данными и как она работает, – закладки, возможность запускать в модели нового рода код или воздействия, а также извлечение модели.
Извлечение модели – это получение данных, на которых обучалась система. Как правило, туда входит много чувствительной информации или ноу-хау, с которыми работает компания.
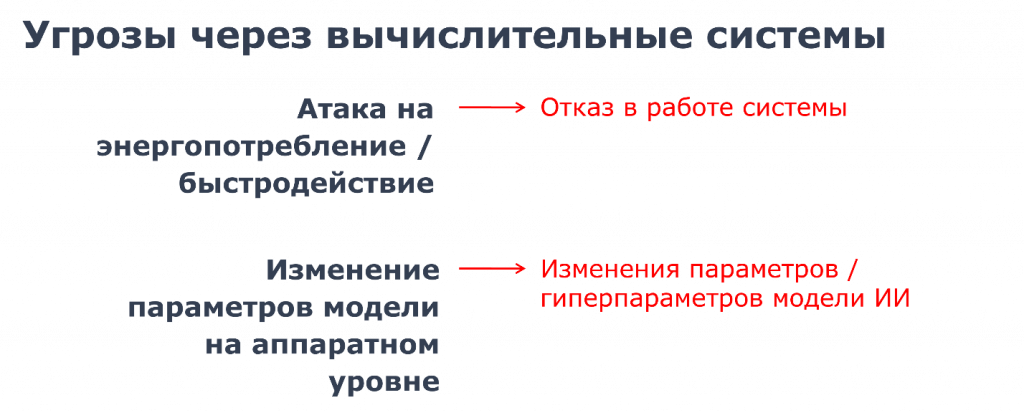
Нельзя не учитывать и атаки на вычислительные ресурсы. Большинство систем искусственного интеллекта связано с энергопотреблением и быстродействием. Замедляя систему, можно вывести процессы из работы или серьезно навредить функционированию объекта.
Безопасность ИИ
Если у данных есть угрозы, возникает вопрос: как выстраивать систему их безопасности?
Вообще все, что связано с искусственным интеллектом, похоже на корпоративную работу с сотрудниками и повышение зрелости информационной безопасности. Во многом все строится не вокруг того, какие наложенные средства мы внедрим и как их настроим. У этого есть определенный объем, но не самый большой. Намного важнее то, как мы выстроим процессы.
Требования к безопасности данных ИИ
-
Достоверность
-
Полнота
-
Безопасность
-
Несмещенность
-
Прозрачность
К безопасности ИИ предъявляется много требований, связанных с достоверностью самих данных, их полнотой и качеством, несмещенностью, а также с возможностью воздействия на них и подмены. Важна и прозрачность: откуда мы взяли данные и как с ними работаем.
Отдельно стоит отметить направление безопасной разработки ПО, которое активно развивает Федеральная служба по техническому и экспортному контролю – ФСТЭК. Для ИИ постепенно тоже создаются разного рода документы.
Очень важно вести разработку в доверенных средах, использовать доверенные данные, проверять источники и работать с ними. Это как раз одна из проблем, которая делает создание защищенного и безопасного ИИ крайне сложным. Мир работает на open source, постоянно появляются разные инструменты кодинга. Поэтому одна из больших проблем, с которой сложно бороться, и одновременно культурная задача многих компаний – проверять, с какими данными мы работаем и в каких средах это происходит.
Требования к безопасности модели ИИ
-
Все компоненты модели проходят процедуру проверки на наличие не декларированного функционала,
-
Модель разрабатывается и тестируется в
безопасной среде разработки, -
Код обученной модели шифруется
-
При создании модели - полноценное и всестороннее тестирование,
-
При эксплуатации модели - состязательное обучение
Как можно защитить модель, если это, по сути, алгоритм?
Модель защищается через создание циклов тестирования с проверкой того, как на нее можно воздействовать и как она обрабатывает данные. Важно правильно прорабатывать архитектуру системы, заранее подразумевая, что ее будут взламывать, и понимать, как в таком случае будет вести себя модель.
Кроме того, необходимо проводить состязательное обучение: учить модель работать в ситуации, когда данные смещаются, чтобы она сама могла на это реагировать.
«Наложенные» меры защиты ИИ
Есть и другой вопрос: можно ли все оставить как есть, сделать какую-нибудь «нашлепку», наложить ее сверху и обеспечить безопасность ИИ сторонними средствами? Здесь тоже все достаточно сложно.
Есть отдельное направление информационной безопасности, связанное с контролем безопасности цепочек поставок, их проверкой и анализом входных данных.
Кодирование входного потока данных. После того как входные данные созданы или где-то проверены, необходимо их шифрование и максимальная защита того, что имеется, от кражи.
Следующее направление – включение в саму архитектуру модели дифференцированных слоев, которые будут фильтровать некорректные запросы, возможные корректировки данных и работу с ними.
Еще один вариант – создание RAG-модели, то есть модели, работающей с ограниченным эталонным набором знаний, через который можно сверять качество выдаваемых ответов.
Наконец, это создание внешних детекторов состязательных атак. Такое направление уже появилось и активно развивается: создается инструментарий, позволяющий мониторить подбор параметров, попытки корректировки данных или включения в них дополнительных воздействий.
По сути, это основные наложенные меры, которые позволяют усиливать безопасность ИИ.
Стандарты в области безопасности ИИ
-
Функциональная безопасность (ПНСТ 836-2023);
-
Обеспечение доверия к ИИ (ГОСТ 59276);
-
Оценка качества систем ИИ (ГОСТ 59898);
-
Оценка робастности нейронных сетей (ГОСТ 70462);
-
Управление рисками ИИ (ПНСТ 776-2022);
-
Стандарты работы с большими данными для ИИ (ГОСТ 70889, 70466 и 59926);
-
Смещенность в системах ИИ (ПНСТ 839-2023);
-
Этические и общественные аспекты ИИ (ПНСТ 840-2023).
В России уже существуют ГОСТы – адаптированная методологическая база, которая описывает, как обеспечивать достоверность и несмещенность данных.
Сюда входят ГОСТы по функциональной безопасности. Отдельно стоит обратить внимание на стандарты по обеспечению доверия к ИИ, оценке систем качества ИИ, оценке работоспособности нейронных сетей и управлению рисками искусственного интеллекта. Это документы, которые описывают важные процессы. Есть стандарты работы с большими данными, вопросы смещенности, системы их защиты и другие аспекты обеспечения ИИ.
При этом законодательство очень сильно меняется. Если ИИ используется в отраслях, которые относятся к критической информационной инфраструктуре, – а это транспорт, космос, производство, банки и так далее, – надо понимать, что на систему искусственного интеллекта распространяются требования ФСТЭК.
Есть 117-й приказ, и с марта 2026 года действуют требования по защите ИИ. В приказе есть отдельный блок о том, что необходимо делать для защиты искусственного интеллекта. Приказы ФСТЭК, как правило, имеют приложения и ссылки на другие стандарты, поэтому совокупность приказа и набора методических документов позволяет создавать необходимые защищенные системы.
Перспективные технологии
Следующий вопрос – какие могут быть пути решения и как выстраивать эту защиту.
Во-первых, появляются более проработанные алгоритмы разработки ИИ. Постоянно развиваются направления биоподобных, нейроморфных, спайковых ИИ – технологий, которые работают по другим принципам.
В таких системах возможность провести состязательную атаку принципиально отличается. У них есть определенная устойчивость, и, по сути, речь идет о том, что такого рода системы можно обмануть примерно так же, как обманывают человека.
Мы знаем, что существует большая проблема, связанная с мошенническими схемами: людей тоже обманывают с помощью технологий. Но количество возможных атак и их сложность сильно уменьшаются, когда используются такого рода технологии.
Конечно, пока они слишком мало применялись и слишком мало изучены с точки зрения информационной безопасности. Но первичная оценка архитектур и подходов говорит о том, что это может стать хорошим направлением в защите.
Есть еще одна вещь, которую важно учитывать. Когда мы говорим про защиту ИИ, необходимо создать архитектуру системы, которая предусматривает вопросы безопасности. При этом существует отдельный блок, связанный с верификацией данных.
По-хорошему, надо создавать систему верификации на другом коде, на другой модели, чтобы две системы, работая параллельно и желательно на разных принципах, проверяли друг друга и сверяли достоверность данных.
Нейроморфное направление в этом плане достаточно интересно. Помимо потенциальной устойчивости, оно может выступать системой верификации для применяемых решений.
Пример
Один из самых удобных примеров, на котором можно рассмотреть построение защищенной системы, – система распознавания лиц. Она используется во многих местах, включает классификаторы, работу с базами и другие компоненты.
На ее примере хорошо видно, как может происходить состязательная атака. Состязательная атака – это как раз подмена параметров. Одновременно можно посмотреть, как от нее защищаться, используя наложенные средства: аналогичную модель с такими же принципами работы для мониторинга и альтернативную модель.
В этом примере разработчик создал прежде всего функциональную систему. Достоверность данных и вопросы защиты в ней проработаны недостаточно. Поэтому здесь рассматривается ситуация, в которой процессные меры еще не реализованы.
Процессные меры – отдельное направление, и их необходимо внедрять. Они развиваются вместе с рынком. Будут появляться новые методологии, кейсы, наборы тестирования, которые придется добавлять. Это процесс, с которым надо будет работать и дальше.
Я уверен, что создание защищенных архитектур решений – сейчас один из ключевых факторов конкурентоспособности и эффективности решений. Создать модель, на которую можно провести атаку, очень опасно: все вложенные в нее ресурсы могут прогореть в один день.
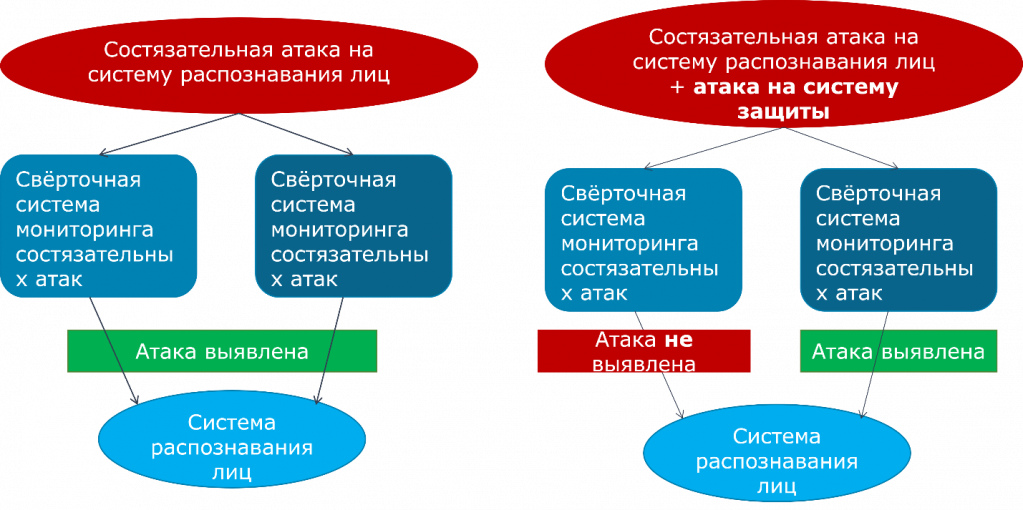
Состязательная атака, как уже говорилось, – это процесс подмены данных. Если злоумышленник проник в контур, а система не отработала появление нового пользователя внутри периметра или запросы не фильтруются, одним из способов защиты становится создание системы мониторинга, которая будет отслеживать подбор тех или иных параметров.
Если злоумышленник находится внутри контура и хочет, например, сделать себе пропуск, подменить лицо или поменять градиент так, чтобы получить возможность войти внутрь, он начинает переобучать систему.
Один из распространенных подходов к защите – мониторить запросы и выявлять подбор параметров, который показывает, что кто-то пытается изменить саму модель или внести в нее дополнительные данные.
Если злоумышленник только учится или не обладает достаточными компетенциями, он попытается атаковать систему напрямую. Система мониторинга выявит инцидент, после чего пользователя можно заблокировать, очистить периметр и продолжить работу.
Если атакующий понимает, что первая попытка обнаружена и его уже заблокировали, чаще всего он будет пытаться провести вторую атаку.
Сначала он атакует систему, которая мониторит подбор параметров, потому что сама эта система мониторинга работает на тех же классических принципах.
Если компания пишет ее самостоятельно или создает какие-то внутренние алгоритмы, возникает отдельная проблема. Многие компании, которые реализуют меры информационной безопасности штатным функционалом, не рассматривают векторы угроз, при которых атака идет на саму меру или функцию ИБ.
Это одна из слабых сторон многих программных продуктов и программно-аппаратных комплексов. Вроде бы мера ИБ существует, но на самом деле она достаточно часто сама становится инструментом, через который злоумышленник может атаковать систему.
Если система мониторинга и объект защиты построены на одной технологии, атака, скорее всего, будет успешной, и ее можно даже не заметить.
Если технологии разные, выявить злоумышленника гораздо проще. Уже в процессе подбора параметров система может обнаружить, что на нее снова оказывается воздействие.
Как может выглядеть система защиты искусственного интеллекта
В упрощенном виде система защиты искусственного интеллекта строится из нескольких блоков.
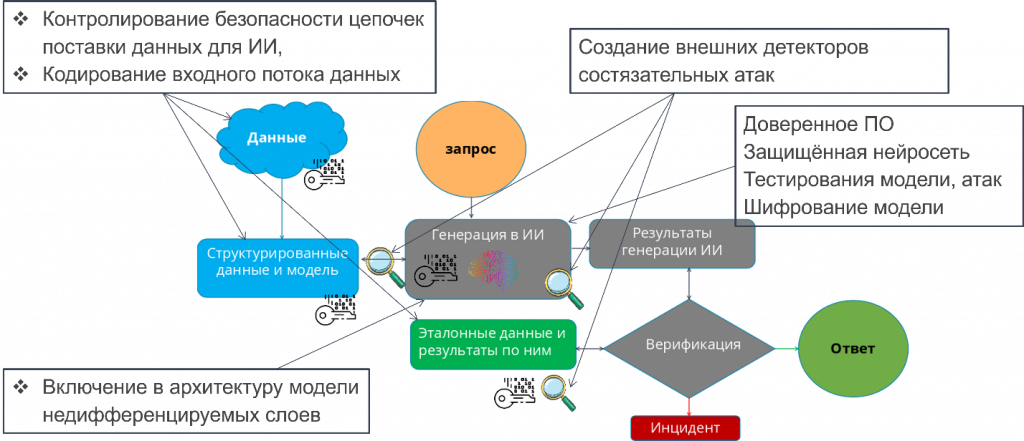
Первый блок связан с защитой данных и архитектуры. Сюда входит контроль безопасности цепочек поставки данных и кодирование входного потока трафика. На уровне сети это сегментация, защита и резервирование данных, потому что данные являются максимально важной ценностью.
Второй блок – создание внешних детекторов состязательных атак, то есть поиск мест, где происходит подмена данных.
Такие системы мониторинга должны контролировать несколько точек: точку, где происходит генерация модели, точку взаимодействия со структурой базы данных и, если архитектура выстроена устойчиво, защищенную эталонную модель на другой технологии.
Эталонную модель тоже надо мониторить, потому что атака, скорее всего, будет идти на одну из моделей, а не на обе параллельно. Сверка изменений как раз может показать такое воздействие.
Следующий элемент – сама среда, в которой все это происходит. Она должна быть доверенной, необходимо использовать доверенное программное обеспечение.
Очень важно немного расширить модель тестирования. Сейчас многие используют автотесты и другие средства автоматизации. К существующему тестированию необходимо добавить еще один вектор работы: проверять модель на разного рода попытки воздействия на нее.
Кроме того, при создании архитектуры можно создавать дополнительные слои, своего рода собственные «закладки», которые будут идентифицировать происходящую атаку.
Нужны и периодические аудиты модели.
Если инцидент уже произошел, он попадает в классическую систему управления информационной безопасностью. Дальше начинается работа по устранению вредоносного ПО или удалению злоумышленника, который попал в периметр.
Выводы
С одной стороны, защищенный ИИ разработать можно. Но говорить о защищенности искусственного интеллекта имеет смысл только тогда, когда мы понимаем, о каком именно ИИ идет речь.
Если это большая языковая или другая сложная система, сложность ее защиты будет пропорциональна количеству пользователей, охвату и количеству запросов.
Помимо среды разработки и других факторов, будет увеличиваться модель атак и количество возможных способов воздействия. Самое главное – будет расширяться модель использования системы и количество целей, ради которых на нее могут воздействовать.
Соответственно, увеличивается количество тестирований и проверок, которые необходимо проводить, и количество архитектурных моментов, которые нужно предусмотреть еще при разработке и защите системы.
Важно понимать, что это требует определенных компетенций. Человек, который создает модель, должен быть в определенном смысле параноиком и заранее подразумевать, что на разных этапах и на разные данные будет происходить воздействие.
С точки зрения затрат и сложности защиты ИИ, по большому счету, необходимо создавать эталонные альтернативные модели, которые будут сравниваться с основной моделью для ее верификации. Если мы пишем какой-то код, все равно должна существовать еще одна отладочная или эталонная модель, с которой можно работать и сравнивать результаты.
Безопасность нужно встраивать в разработку уже сейчас
Путь осилит идущий. Методологическая часть и корректировки разработки – это то, чем важно начинать заниматься уже сейчас.
Многие меры предполагают процессные изменения, изменение системы тестирования и дополнительные архитектурные решения. На самом деле они решаются не так сложно.
Понятно, что внедрить сразу 100% необходимых мер невозможно. Это нельзя сделать быстро, это долгий процесс. Но работать над этим нужно уже сейчас и включать вопросы безопасности в работу разработчиков, процессы отладки, наладки и доработки системы.
Отдельное большое направление – моделирование угроз. Сам принцип моделирования угроз позволяет понять, как переносить эти подходы на системы искусственного интеллекта и как выстраивать необходимые контуры и меры защиты.
Информационную безопасность необходимо прорабатывать, встраивать в свою работу и делать системы защищенными.
Скорее всего, большинство систем, с которыми мы сейчас работаем, имеют белые пятна, и впереди еще большой объем работы. Но по мере появления новых технологий, распространения альтернативных моделей, возможности параллельно создавать разные библиотеки, развития вайб-кодинга и других инструментов, позволяющих делать это быстрее, создавать безопасные системы будет проще. Поэтому эти подходы нужно изучать и встраивать в процессы.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

