Как замерить расход ИИ-агентов в 1С и куда он реально уходит
Я разрабатываю на 1С с ИИ-агентами: несколько рабочих чатов параллельно, и агент сам пишет и проверяет код. Лимита подписки хватило почти на всю прошлую неделю, но сделал я меньше, чем планировал, и часть своих задач пришлось урезать: расход съедал лимит раньше, чем заканчивался план. В воскресенье 25.10 лимит закончился, сработала блокировка, и я сел разбираться, куда деньги уходят на самом деле.
Это статья про измерение, а не про готовый рецепт экономии. Внутри — короткий скрипт, который каждый может запустить на своих логах, то, что он показал у меня, и приёмы, которыми я пользуюсь и почему. Доказанной экономии здесь нет: сравнивать «до» и «после» на одинаковых задачах 1С я пока не умею.
«Расход» — это стоимость токенов по ценам API (API — программный интерфейс провайдера модели), посчитанная по локальным логам Claude Code. Я сижу на подписке Max за $200 в месяц, и реально эти деньги не списываются; сумма по API показывает, сколько ресурса сжигают агенты.
Как работает счётчик
Агент — это цикл: прочитал файл, выполнил команду, ответил. На каждом шаге в модель уходит весь накопленный контекст. Провайдер кэширует его и берёт за чтение из кэша в 20 раз меньше обычного входа (для Opus 5.5 — $0,20 против $4 за миллион токенов), но берёт — на каждом шаге. Поэтому стоимость сессии растёт быстрее, чем её длина: каждый следующий шаг дороже предыдущего.
Цены Opus 5.5 за миллион токенов: вход $4, вывод $20, чтение кэша $0,20, запись кэша $8 (при хранении час; на пять минут — вход ×1,25).
Как считать: скрипт
Скрипт читает логи ~/.claude/projects/**/*.jsonl, берёт из каждого ответа модели счётчики токенов (вход, выход, чтение и запись кэша), умножает на прейскурант API и складывает по сессиям. Он показывает структуру расхода и десять самых дорогих сессий.
# Самые дорогие сессии Claude Code по локальным логам, в ценах API.
# Запуск: python3 top_sessions.py 2026-10-26 2026-11-02
import glob, json, os, sys
from collections import defaultdict
from datetime import datetime, timezone

# $ за 1 млн токенов: вход, выход, чтение кэша; запись кэша = вход x1,25 (5 мин) или x2 (1 час)
PRICE = {"claude-opus-5-5": (4, 20, 0.20), "claude-sonnet-5-5": (2, 10, 0.20), "claude-haiku-5-5": (0.1, 0.5, 0.01)}
since, until = (datetime.fromisoformat(a).replace(tzinfo=timezone.utc) for a in sys.argv[1:3])
seen, cost, turns, ctx, parts = set(), defaultdict(float), defaultdict(int), defaultdict(int), defaultdict(float)
for path in glob.glob(os.path.expanduser("~/.claude/projects/**/*.jsonl"), recursive=True):
    for line in open(path, errors="ignore"):
        try:
            d = json.loads(line)
            m, u = d["message"], d["message"]["usage"]
            t = datetime.fromisoformat(d["timestamp"].replace("Z", "+00:00"))
        except (KeyError, TypeError, ValueError):
            continue
        key = (m.get("id"), d.get("requestId"))  # один ответ бывает записан в лог несколько раз
        if d.get("type") != "assistant" or m.get("model") not in PRICE or key in seen or not since <= t < until:
            continue
        seen.add(key)
        i, o, cr = PRICE[m["model"]]
        w = u.get("cache_creation_input_tokens", 0)
        w1h = (u.get("cache_creation") or {}).get("ephemeral_1h_input_tokens", 0)
        sid = d.get("sessionId", path)
        for name, usd in (("чтение кэша", u.get("cache_read_input_tokens", 0) * cr),
                          ("запись кэша", (w - w1h) * i * 1.25 + w1h * i * 2),
                          ("ввод и вывод", u.get("input_tokens", 0) * i + u.get("output_tokens", 0) * o)):
            cost[sid] += usd / 1e6
            parts[name] += usd / 1e6
        turns[sid] += 1
        ctx[sid] = max(ctx[sid], u.get("input_tokens", 0) + u.get("cache_read_input_tokens", 0) + w)
print(f"всего ${sum(cost.values()):.0f}, сессий {len(cost)}")
print({k: f"{v / sum(cost.values()):.0%}" for k, v in parts.items()})
for sid in sorted(cost, key=cost.get, reverse=True)[:10]:
    print(f"${cost[sid]:7.2f}  ходов {turns[sid]:5}  контекст до {ctx[sid] // 1000} тыс.  ${cost[sid] / turns[sid]:.3f}/ход")
Что скрипт не учитывает: модели вне таблицы (в том числе другие семейства) он пропускает. Недельный лимит подписки не обязан быть пропорционален долларам по ценам API. Цены в таблице — по прейскуранту на октябрь 2026, провайдер может их менять.
Что показал замер
Структура расхода. За две недели (19.10 – 01.11) по моим логам на двух машинах:
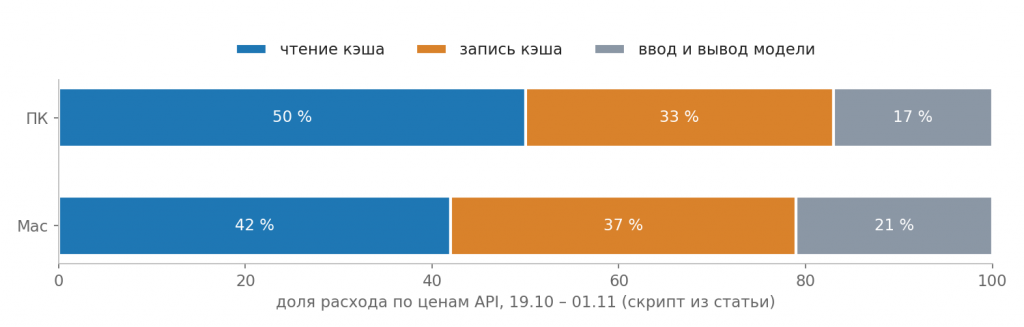
На ПК чтение кэша — половина расхода, запись кэша — треть, ввод и вывод модели — около шестой части. На Mac чтение и запись примерно поровну (42 и 37 %). Вывод простой: основную часть счёта дают не слова, которые модель пишет, а контекст, который она перечитывает и записывает в кэш. Цифры получены именно этим скриптом: запустите его на своих логах — пропорции могут отличаться.
Несколько сессий дают большую часть расхода. Неделя 19–26.10 на ПК: 225 сессий, $1 880. Шесть самых дорогих стоили по $109–315 каждая и вместе дали $1 156 — больше 60 % расхода ПК за неделю. У всех шести контекст дорастал до 880–966 тыс. токенов, а цена одного хода составляла $0,12–0,25.
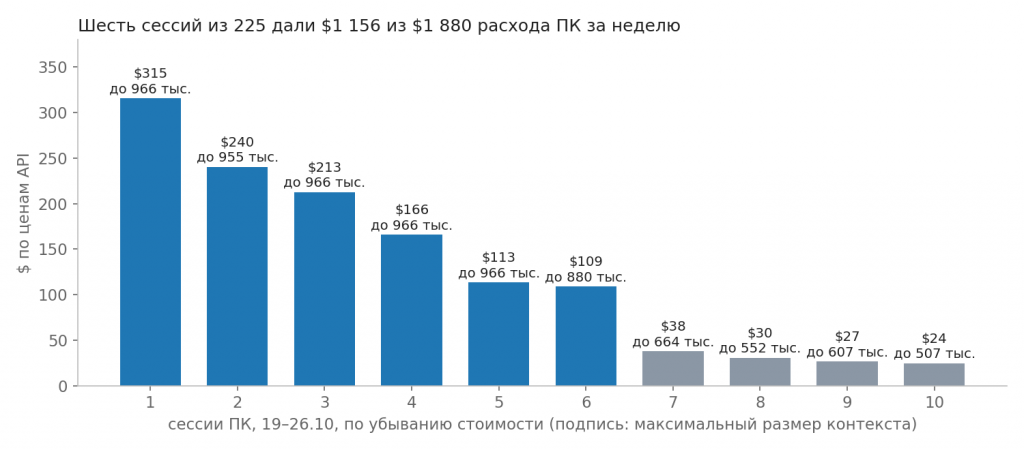
Разбор самой дорогой сессии. $315, 2 393 хода, контекст до 966 тыс. токенов. Это была не одна задача, а долгий управляющий чат. Средний ход стоил $0,13 — каждый ход заново читал весь накопленный контекст. Вывод: самые дорогие сессии — не обязательно самые «тяжёлые» задачи, а чаще всего самые долгоживущие чаты.
Первый запрос тоже не бесплатный. Его размер — это системные инструменты, список скиллов и надстройка самого приложения. По логам у меня первый запрос в командной строке — около 30 тыс. токенов, в десктопном чате — 65–80 тыс.; он не сжимается и растёт вместе с приложением.
Что мы делаем и почему
Это приёмы, которыми я пользуюсь, и причины.
1. Ограничить размер контекста автосжатием. Почему: каждый ход перечитывает всё накопленное, а самые дорогие сессии дорастали до 966 тыс. Что делаю: окно сжатия 300 тысяч токенов. Чем платим: при сжатии теряются детали разговора. В ~/.claude/settings.json:
{
  "model": "opus[1m]",
  "autoCompactWindow": 300000,
  "autoCompactEnabled": true
}
2. Уровень рассуждений — по задаче. Почему: он влияет на объём рассуждений, а значит, на токены вывода. Что делаю: effort задаю переключателем в приложении: для рутины — Medium, для сложных задач — выше. В документации Claude Code сказано, что верхнеуровневый ключ effortLevel в пользовательском файле настроек на модели Opus 5.5 не учитывается. Собственного замера у меня нет, поэтому настройку в файле проверьте у себя.
3. Модель — по задаче. Почему: цены разные. Правило, которое записано в общем файле инструкций агента:
Дочерний чат по умолчанию — Sonnet.
Opus — архитектура, проектирование, сложная отладка.
Поиск и чтение больших объёмов — субагент на Haiku.
Цены за миллион токенов (вход / вывод): Opus 5.5 — $4 / $20, Sonnet 5.5 — $2 / $10, Haiku 5.5 — $0,10 / $0,50 (для запросов до 100 тыс. токенов, дальше $0,50 / $2,50). Но чтение кэша у Opus 5.5 и Sonnet 5.5 стоит одинаково — $0,20, а оно даёт заметную долю счёта, поэтому в длинных сессиях выигрыш от Sonnet меньше «вдвое». За эту неделю на Sonnet пришлось около 9 % расхода.
4. Подсказки следующего промпта выключить. Почему: каждая подсказка — отдельный запрос модели после каждого ответа, то есть лишний вызов с полным контекстом. Настройка находится в параметрах Claude Code.
5. MCP и скиллы — только в нужных проектах. Почему: описания подключённых MCP-серверов (MCP — Model Context Protocol, протокол подключения внешних инструментов) и список скиллов попадают в каждый запрос. Команда подключения только для текущего проекта:
claude mcp add --scope local <имя> -- <команда запуска сервера>
Скиллы проекта кладу в папку .claude/skills внутри проекта, а не в общую.
6. Короткая память и «ленивые» скиллы. Почему: индекс памяти грузится в каждый чат, а у скилла в каждый запрос попадает только описание (name и description); тело читается, когда оно нужно. Индекс держу списком одностроковых ссылок, детали — в отдельных файлах. Скелет такого скилла:
---
name: reference
description: Справочные данные и предпочтения. Загружай, когда нужен факт.
---
Прочитай INDEX.md, затем только нужную справку.
7. Не продолжать сессию после долгой паузы. Почему: кэш хранится около часа; после остывания продолжение сессии заново записывает весь контекст. Что делаю: после паузы больше часа начинаю новую сессию со сводкой.
8. Регулярные задачи — лёгкие. Почему: стартовый запрос одинаково дорог для любого запуска. Что делаю: для регулярных задач Sonnet или Haiku и отдельная лёгкая папка без памяти и проектных MCP.
9. Большие модули 1С — не читать кусками. Почему: большие модули, прочитанные кусками, остаются в контексте и перечитываются на каждом ходу. Что делаем: два инструмента. Поиск: агент спрашивает «где вызывается ЗакрытьМесяцУТ» и получает строку на каждый метод с адресом, а не текст файла; иногда нужен второй запрос за телом метода. Скелет метода: вместо тела — описание, вызовы, регистры и запросы с номерами строк и раздел «не видно». Пробы на отдельных вопросах показали меньший ответ и меньший контекст, но по деньгам и качеству результат неоднозначный; на полной задаче эффект мы не снимали.
10. Сторож для shell-команд. Почему: сотни мелких команд, каждая со своим выводом, раздувают контекст. Что делаем: хук — обработчик, который Claude Code вызывает перед запуском команды. Сторож читает команду до запуска и отказывает, если агент вытаскивает кусок большого файла через cat, Get-Content и подобное, а в ответе показывает нужную команду.
11. Ферма проверки: быстрая проверка сначала, все базы в конце. Почему: ферма баз 1С проверяет долго, а лишние прогоны стоят ходов. Что делаем: быстрая проверка на одной базе, а все 12 баз — один раз в конце. Это убирает лишние прогоны, но не ожидание: агент по-прежнему опрашивает статус, и каждый опрос — ход с полным контекстом.
Что не получилось и чего не знаю
- Помогло ли всё вместе — пока неизвестно. Лимита на этой неделе хватило: в воскресенье 01.11, примерно за 10 часов до сброса, выбрано 77 % недельного лимита, неделей раньше в этот же день была блокировка. Но причина мне неизвестна: в ядре за это время много менялось, и состав задач другой. Сравнение «до и после» будет позже, на реальных задачах 1С.
- Первый запрос не сжимается: всё, что можно было вынести из него, вынесено; основная часть — надстройка приложения, её отключить нельзя.
Что сделать у себя за вечер
- Запустите скрипт за последнюю неделю и посмотрите на структуру расхода: у вас чтение кэша — тоже основная часть?
- Найдите 3–5 самых дорогих сессий. Какой у них максимальный контекст и сколько ходов? Это долгоживущие чаты или одна тяжёлая задача?
- Посмотрите, у скольких сессий контекст дорос до сотен тысяч токенов, и решите, нужен ли вам ограничитель.
- Через неделю запустите скрипт снова и сравните.
Вопрос к вам
Как вы отслеживаете расход агентов? Какие модели на каких задачах используете и что реально сработало, а что нет? Какие приёмы посоветуете для больших модулей типовых конфигураций? Буду рад, если поделитесь опытом в комментариях.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

