Гибридный поиск на чистом 1С
Разработка - Математика и алгоритмы
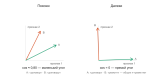
Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Вводная часть
Недавно появилась новость, что Яндекс первый в России сделал у себя возможность использовать гибридный поиск для RAG, очень за него рад, особенно учитывая, что в Open WebUI он есть уже давно. Значит мы будем вторыми в России с такой технологией и первыми, кто сделает это на языке 1С.
Проблема ИИ - это проблема чёрных ящиков. Возьмём, к примеру, векторный поиск. Мы отдали в эмбеддер понятный текст, и получаем непонятный многомерный вектор, потом сформировали поисковый промт, там происходит какая-то магия, вернулись какие-то фрагменты текста, всё это скрыто пеленой Python-библиотек, ничего не понятно. А на самом деле механизм не сложный, базовая механика довольно проста и вполне реализуема средствами 1С. Сразу оговорюсь, что чуда не будет, это не семантика, а имитация, но она логичная, понятная и отличается только механизмом векторизации.
Разбиение текста на чанки (чанкование)
Тут всё довольно просто, алгоритм двойной. На вход принимаем текстовые файлы в разметке markdown и пробуем их разбить по заголовкам, это обосновано т. к. с заголовка начинается новая мысль. Есть ограничение на длину чанка, она задаётся в символах и корректируется до ближайшего пробела, а чтобы не потерять смысл при разрезании предложения, то делается нахлест, т. е. следующий чанк начинается не с места разреза, а отступает на некоторое количество символов влево по тексту. Т.е. сначала делим по заголовкам, потом по длине. Результаты пишутся в регистр сведений ЛексическиеЧанки.
Токенизация и Векторизация
У нас задача учебная и токенами будут слова целиком, в нижнем регистре, длиннее двух символов, без буквы «ё» и пропускаем часто встречающиеся союзы и предлоги. Также отбрасываются числа длиной меньше 4-х знаков, чтобы значение года сохранялось, остальное шум.
Поддерживается три режима признаков: n-граммы, слова и гибрид, по умолчанию гибрид, он формирует и n-граммы и токены для лексического поиска. Сначала опишу режим «n-граммы».
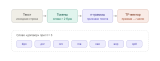
Текст векторизуется через n-граммы, т. е. каждое слово режем кусочками, добавляем специальный символ в начале и в конце слова. Размерность нашего условного векторного пространства определяется длиной n-граммы, пусть N будет равно трём, изменить настройку можно в структуре, возвращаемой функцией ПараметрыВекторизации() модуля ЛексическийПоиск. Чем больше N, тем больше разнообразие признаков и размерность пространства.
Для упрощения не делаем поиск по синонимам и считаем, что у нас все тексты на одном языке — русском. На самом деле обогащать поисковый запрос синонимами несложно, только единственный словарь синонимов русского языка, который можно опубликовать не нарушая ничьих прав датирован 1911-м годом и там, мягко говоря, слегка устаревшие понятия. Да, слова «авто» и «машина» никогда не станут близкими по смыслу, возможны ложные срабатывания на общих корнях, но это осознанные ограничения для учебной реализации.
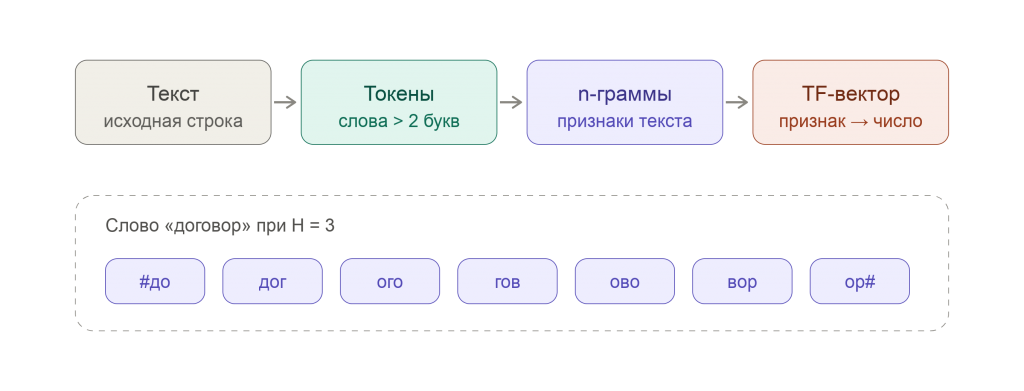
В итоге получаем огромную таблицу, где у каждой возможной n-граммы — своя отдельная колонка. «#до», «дог», «ого», «гов» — каждая занимает свой столбец. Всего таких колонок десятки тысяч. Вектор документа — это одна строка в этой таблице: в колонках тех n-грамм, что встретились, стоит число (сколько раз встретилось), в остальных — ноль.
То есть вектор — это просто «сколько раз каждый признак встретился в тексте». Каждая n-грамма — отдельное измерение, а значение — частота.
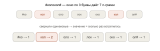
Хорошее слово для демонстрации — «колокол». В нём при N=3 один фрагмент повторяется, а остальные встречаются по разу, так что в векторе появляется значение больше единицы.
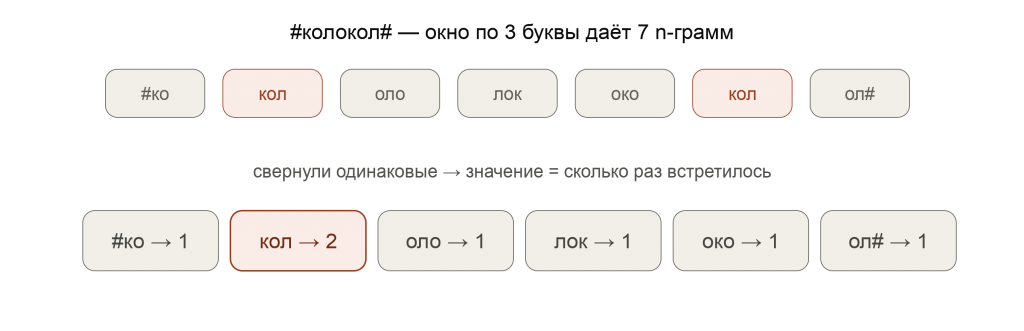
И тог: вектор слова «колокол» — это #ко→1, кол→2, оло→1, лок→1, око→1, ол#→1. Семь n-грамм на входе, шесть измерений на выходе (дубликат схлопнулся), и значения уже не все единичные — кол стоит с двойкой. Вот эта двойка и есть «частота»: значение измерения = сколько раз признак попал в текст.
Вектор хранится в разреженном состоянии, т. к. почти вся строка — нули (текст задевает 300-400 колонок из десятков тысяч), хранить полный массив глупо. Поэтому в коде вектор — это Соответствие «признак → число», где записаны только ненулевые колонки, а всё, чего в нём нет, считается нулём. Это и есть «разреженный вектор» из модуля ЛексическийПоиск.
Как считается близость
Для простоты пример на целых словах, а не на n-граммах, чтобы таблица была меньше. Два текста: A = «договор поставки», B = «договор аренды». Их векторы:
|
Признак |
А |
В |
|
договор |
1 |
1 |
|
поставки |
1 |
0 |
|
аренды |
0 |
1 |
Близость считается в три арифметических действия.
Скалярное произведение — прошлись по общим признакам, перемножили значения, сложили: 1×1 (договор) + 1×0 + 0×1 = 1. Признак, которого нет у одного из текстов, даёт ноль и в сумму не попадает — поэтому в коде и цикл идёт только по меньшему вектору, лишних умножений на ноль нет.
Норма (длина) каждого вектора — корень из суммы квадратов: у A это √(1²+1²) = √2 ≈ 1.41, у B так же ≈ 1.41.
Косинус = скалярное произведение делённое на произведение норм: 1 / (1.41 × 1.41) = 1/2 = 0.5. Тексты совпали на один признак из двух — получили ровно 0.5.
Результат всегда в диапазоне от 0 до 1: 1 — векторы смотрят в одну сторону (тексты почти одинаковы по набору признаков), 0 — общих признаков нет вообще.
Геометрия объясняет почему это называется «косинус». Каждый признак — своя ось, текст — стрелка из начала координат, а близость — насколько две стрелки смотрят в одну сторону:
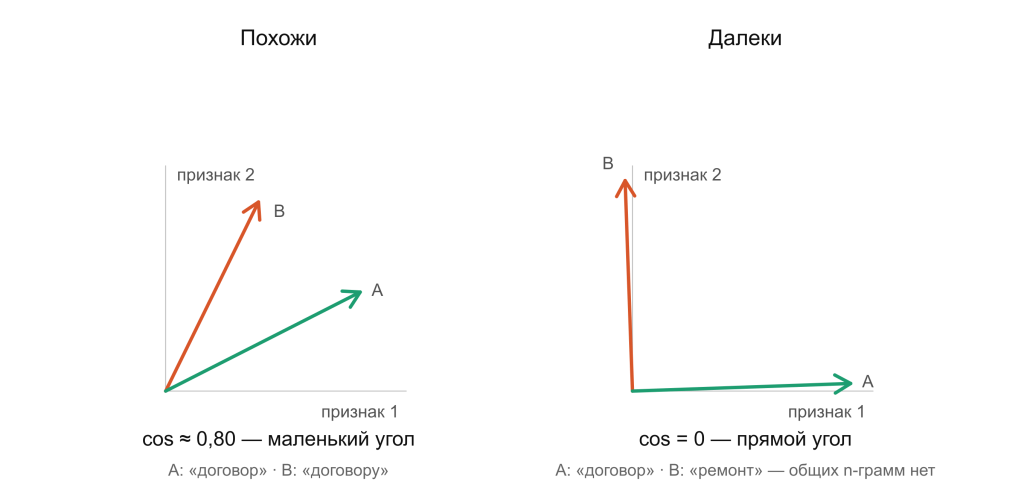
Почему считаем именно косинус, а не просто «сколько общих признаков». Если считать пересечение, длинный документ выиграет только за счёт объёма: у него больше признаков, значит больше шансов пересечься с чем угодно. Деление на нормы это убирает — оно смотрит на направление стрелки, а не на её длину. Поэтому короткий запрос и длинный документ могут оказаться близкими, если они «про одно и то же», а не потому что один из них просто большой.
Это и есть весь фокус: «умный» векторизатор вроде bge-m3 строит стрелку хитрее (в его осях «авто» и «машина» смотрят в одну сторону), но меряется близость абсолютно так же — тем же косинусом того же угла.
Что это даёт на n-граммах. Ради этого всё и затевалось — словоформы сближаются сами собой, без словаря и без морфологического анализатора:
- договор → #до дог ого гов ово вор ор# 7 признаков
- договору → #до дог ого гов ово вор ору ру# 8 признаков
- Общих 6, косинус `6 / √(7·8) = 0,80`.
Еще примеры:
- договор / договору, косинус — 0,80;
- поставка / поставки, косинус — 0,75;
- дом / домашний, косинус — 0,41;
- вход / выход, косинус — 0,45;
- контракт / договор, косинус - 0,00 - синонимы не работают.
Увеличиваем точность
Оказывается не все йогурты одинаково полезны не все компоненты вектора одинаково значимы при определении близости, и если предварительно посчитать статистику n-грамм, и присвоить веса обратно пропорционально частоте появления, то мы понизим влияние предлогов и окончаний. Это не всегда так, потому что наши n-граммы ничего не знают про состав слов, но гипотеза вполне рабочая. Статистика участия n-грамм в документах и итоговый вес можно посмотреть в регистре «ЛексическийIDF».
Разберём немного терминологию, TF и IDF — две составляющие классической формулы взвешивания признаков в поиске.
TF — term frequency, «частота термина». Сколько раз признак (в нашем модуле — n-грамма) встретился в конкретном чанке. В модуле она берётся не сырой, а сублинейной: 1 + Log(tf), чтобы восьмое вхождение не весило вчетверо больше второго.
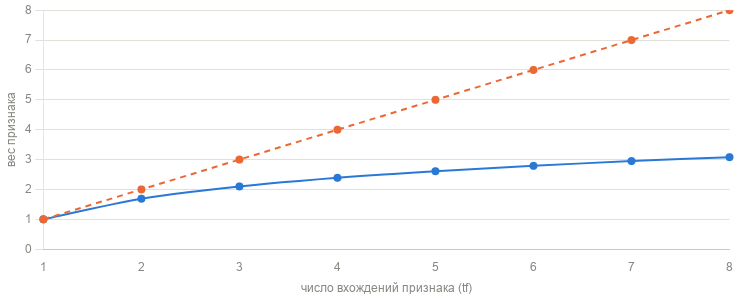
Здесь виден весь смысл сублинейности: сырой TF растёт по прямой (y = tf), а 1 + Log(tf) заваливается — разрыв между первым и восьмым вхождением сжимается с восьмикратного до примерно троекратного.
IDF — inverse document frequency, «обратная документная частота». Насколько признак редок по всему корпусу. Считается через df (document frequency) — в скольких чанках признак вообще встречается — и переворачивается логарифмом: Log(N/df). Смысл переворота — редкий признак различает тексты, частый нет. Признак (наша N-грамма), попавшая во все чанки, ничего не говорит о том, какой из них релевантен, и её вес приводится к нулю (или к минимуму).
IDF бывает обычный и сглаженный, выбор хранится в параметрах индекса.
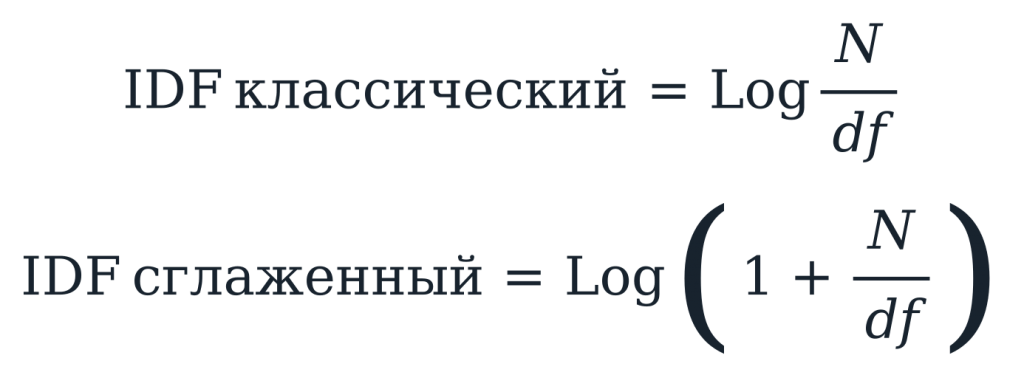
Сглаженный IDF предотвращает нулевое значение веса признака, который возможен при малом количестве чанков.
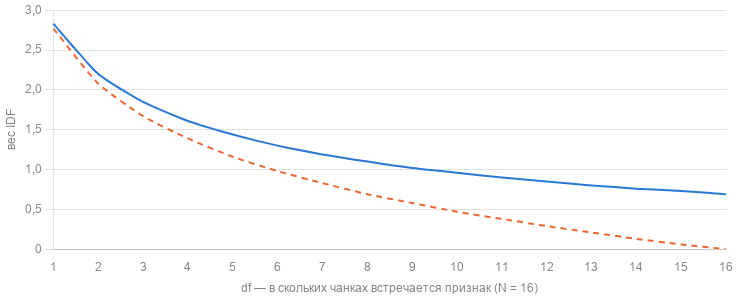
Например, какая-то n-грамма встречается во всех чанках, обычный IDF даст ноль, а сглаженный 0.69, это удобно для небольших наборов документов. На графике пример для 16 чанков.
Основной минус этого подхода — его ресурсоёмкость, мы должны пересчитывать частоту признака для всего объёма данных. Добавили один чанк — изменились частоты признаков, поэтому после обработки документа вызываем процедуру ПересчитатьIDFИВеса() и обновляем статистику.
Описание реализации
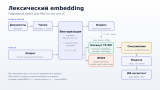
Векторной базы в 1С нет, мы её заменяем на 4 регистра:
- ЛексическиеЧанки — сам текст и его место в Исходном документе;
- ЛексическийОбратныйИндекс — частота признака и его вес;
- ЛексическийIDF — в скольких чанках встречается признак (df) и его IDF;
- ЛексическиеНормыВекторов — нормы весов.
Данные конкретного чанка TF и ВесTF и IDF хранятся отдельно, т. к. частота признака в чанке и его вес не зависят от частоты признака во всём корпусе документов, это здорово ускоряет процесс добавления нового документа в корпус.
Поиск реализован в функции ЛексическийПоиск.НайтиПоИндексу(), запрос довольно большой, но оптимизирован так, чтобы чанки, не совпадающие по признакам с запросом, в него не попадали.
Семантический поиск не ищет идентификаторы
Задача семантического (векторного) поиска стирать мелкие различия — в этом его работа. «Договор» и «договору» должны стать одним, «авто» и «машина» тоже в идеале должно быть одинаковым (у нас не так, это ограничение алгоритма). А если нужно найти что-то по идентификаторам, например, есть Идентификатор1 и Идентификатор2, как их различить? Посмотрим, как отработает наш алгоритм:
- договор / договору, косинус — 0,80;
- идентификатор1 / идентификатор2, косинус — 0,86, а вот это беда, т.к. похожесть ещё выше, чем в первом случае;
- акт0012 / акт0013, косинус 0,71;
- зуп30115 / зуп30116, косинус 0,75.
То есть у нас та же болезнь, что у настоящего эмбеддера, только по другой причине, там различия стирает обученная модель, здесь — скользящее окно по буквам.
BM25: теория и реализация
BM25 (Best Matching 25) — формула ранжирования из семейства Okapi, ей больше тридцати лет, и она до сих пор используется почти во всех гибридных поисках. Алгоритм базируется на IDF, т. к. идентификаторы в тексте очень редки и автоматически «всплывают наверх» в индексе.
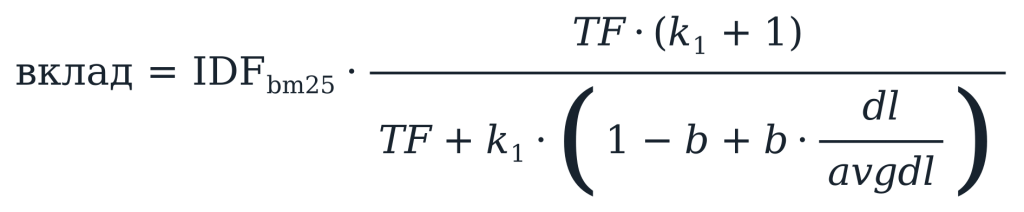
Это формула, ниже расшифровка:
- IDF_bm25 - насколько признак редок по корпусу;
- TF - сколько раз признак встретился в чанке, ресурс TF обратного индекса;
- dl - длина этого чанка в признаках, значение ДлинаВПризнаках регистра норм;
- avgdl - средняя длина в признаках, её считает СводкаПоКорпусу;
- k1 = 1,2 — скорость насыщения по частоте;
- b = 0,75 - сила поправки на длину.
Итоговый балл документа — сумма вкладов по всем признакам запроса. Никакого деления на норму, никакого корня: просто сумма. Сильно в теорию углубляться не буду, кому интересно, прочитает в сети.
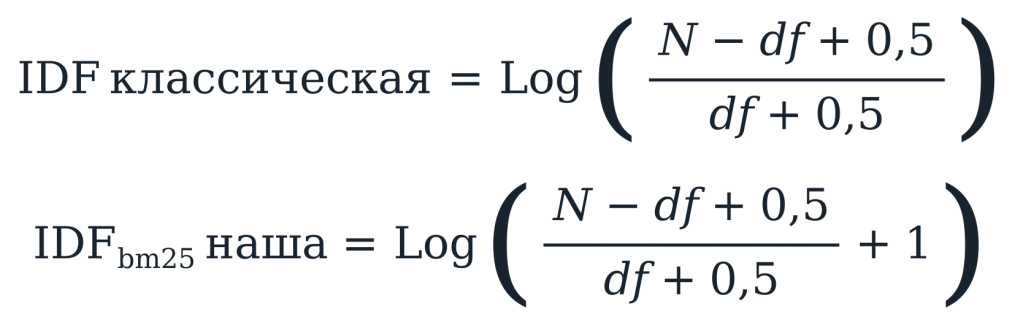
Классическая формула IDF_bm25 нам не подходит, т. к. в ней, если признак повторяется более, чем в половине документов, то он штрафуется, т. е. значения становятся отрицательными, чанк может получить отрицательный балл за то, что в нём есть распространённый признак.
N — размер корпуса, но не в документах, а в чанках. Это важная тонкость: в формулах TF-IDF и BM25 «документ» всюду означает чанк, поэтому и индекс, и нормы, и df считаются по чанкам.
df — в скольких чанках корпуса встречается этот признак; ресурс ЧастотаДокументов регистра ЛексическийIDF, получается группировкой обратного индекса по признаку.
Наша формула расчёта доработана, чтобы не было отрицательных значений.
Но тут сразу возникает вопрос, n-грамма ведь не является идентификатором, а только его частью, т. е. в данном случае сопоставляется вектор Идентификатора со статистикой компонентов вектора в документах, т. е. результат такого поиска не очень прогнозируемый, например, у «идентификатор1» и «идентификатор2» двенадцать n-грамм из четырнадцати общие и мы уже видели к чему это приводит. Но очень не хочется для лексического поиска делать отдельную математику, хочется использовать уже имеющуюся от семантического.
Тут нас спасает гибридный режим в Параметрах векторизации. К массиву признаков, состоящему из n-грамм, будет добавлен исходный токен с символом «=» в начале, дальше вся математика без изменений и IDF поднимет токен идентификатора наверх.
При смене параметров векторизации необходимо обработать заново все документы, т. е. выполнить «Обслуживание — Очистить индекс» и «Переиндексировать всё».
Реранкер, которого нет
В типовом RAG-конвейере две ветки поиска, семантический и лексический, сливаются в единый список документов, а потом происходит повторная ранжировка через специальную модель cross-encoder, она принимает пару (запрос, документ) и прогоняет её через трансформер вместе, а не по отдельности. Это очень дорогой по ресурсам этап, поэтому он не работает напрямую со всеми чанками, а только с предварительно отобранными.
Но у нас реранкера нет, а есть значение косинусной близости в диапазоне от нуля до единицы и вес BM25, который может быть любым неотрицательным, без верхней границы. Чтобы их как-то свести вместе, рассчитываем потолок BM25 и нормируем значение по нему. Потолок — это максимально возможное значение показателя для запроса.
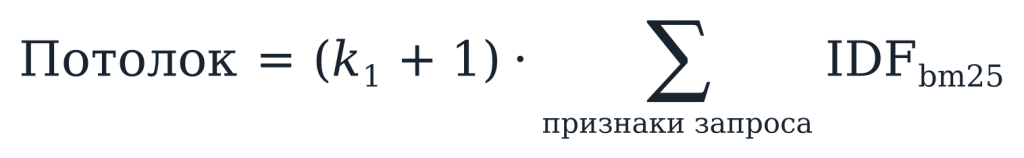
Также вводим коэффициент для смешивания результатов, он показывает какую долю в общем рейтинге имеет каждый из видов поиска, в диапазоне от нуля до единицы 0 — только семантика, 1 — только лексика, 0,5 — поровну. Смешивание происходит в соответствии с этим коэффициентом (в формуле это w).
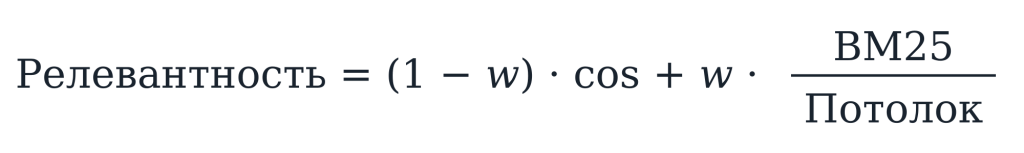
К итоговому баллу применяется порог релевантности и всё, что ниже него отсекается, это позволит избежать попадания в результат откровенного мусора.
От теории к практике
Состав корпуса документов: статьи Википедии по астрономии и математике, нормативные акты с Викитеки (главы Гражданского кодекса, Конституция), ГОСТ 34.601-90, «Война и мир». Разнородность здесь не для красоты, а для увеличения качества тестирования, было бы странно спросить про отношения Наташи Ростовой и князя Болконского, а получить в результате информацию про пояс Койпера.
Результаты тестов:
Вопрос: «Отношения Наташи Ростовой и князя Болконского».
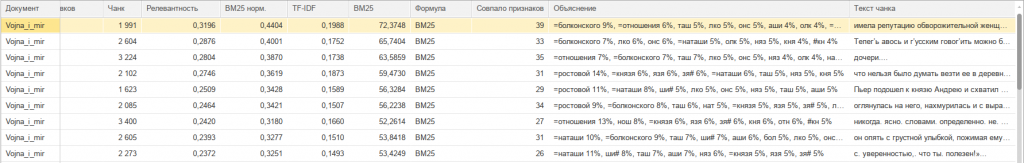
В ответе только чанки из «Войны и мира»
Вопрос: «Что за последней планетой Солнечной системы»
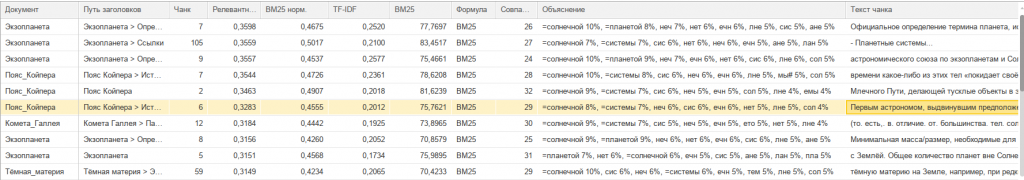
Не уверен, что в результате поиска есть ответ на заданный вопрос (его в корпусе документов может вообще не быть), но видно, что тематика выдержана, дальше уже ИИ разберётся.
Инструмент поиска для Open WebUI
Ну а теперь переходим к самому интересному и имеющему практическое применение. Поиск нам нужен не просто так, а для того, чтобы его использовал ИИ, вариантов подключения два:
- прямой вызов поиска, тут мы можем использовать «свой» механизм авторизации отдельно для каждого пользователя;
- реализация mcp-сервера для вызова инструмента поиска, удобно, но одна учётка для всех пользователей.
Для Open WebUI я тестировал именно прямой вызов, потому что он позволяет решить очень важную задачу интеграции ИИ и 1С — права. В пользовательских настройках инструмента указываем логин и пароль пользователя в 1С и получаем авторизацию на http-сервисе базы 1С с соответствующими правами.
Например, при использовании данного механизма в 1С:Документооборот, измерением Объект регистра ЛексическиеЧанки можно сделать справочник Файлы, чанки нарезать из текстового образа, а права будут наследоваться от Владельца файла и пользователи смогут с ИИ пообщаться по своим документам и не увидят ничего лишнего.
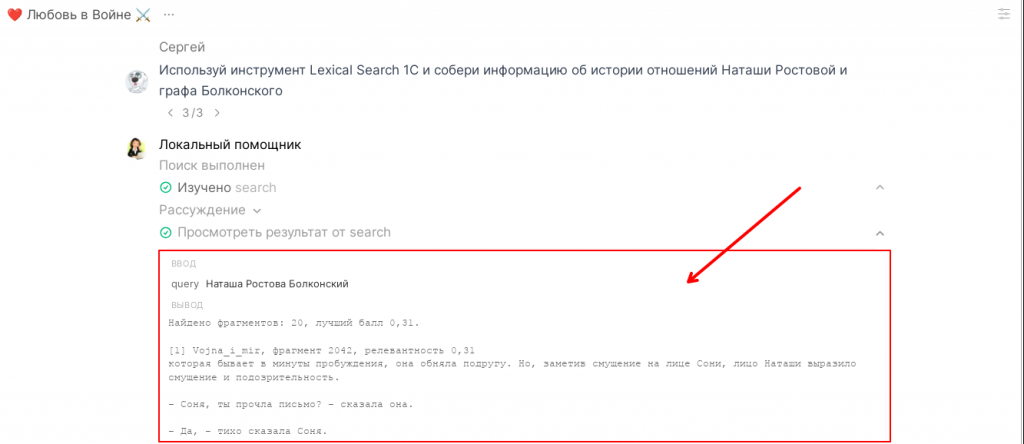
Вот пример ответа инструмента в чат Open WebUI, для тестов использовалась слабая локальная модель, поэтому пришлось указать на использование инструмента напрямую, большая и умная догадается сама.
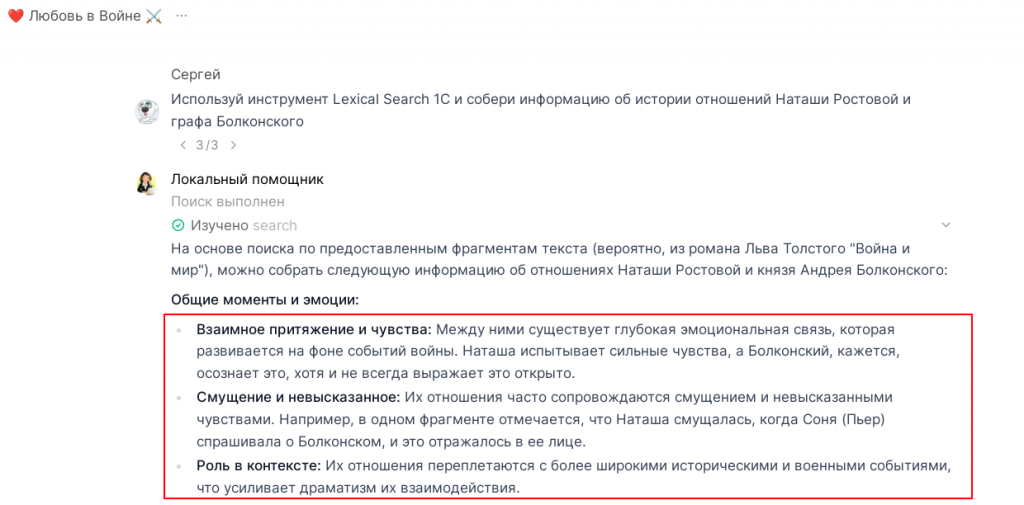
А ИИ уже из полученных фрагментов соберёт красивый реферат на заданную тему. Код инструмента для Open WebUI лежит в общем макете «lexical_search_1c».
Кстати, mcp-сервер тоже есть, в учебных целях, чтобы можно было подключить любую платформу с ИИ, но с авторизацией придётся мудрить, т. к. клиенты mcp любят Bearer или OAuth, а у нас тут Basic.
Код конфигурации написал Claude Opus, поэтому помидорами кидать в него, это лабораторная работа, не претендующая на коммерческое применение. Просто очень хотелось изучить механизм гибридного поиска, а лучший способ понять самому — это объяснить другим.
Реализацию алгоритма можно посмотреть в приложенной конфигурации, платформа 8.3.27.2325.
Проверено на следующих конфигурациях и релизах:
- 1С:Библиотека стандартных подсистем, редакция 3.1, релизы 3.1.10.622
Вступайте в нашу телеграмм-группу Инфостарт


