Дообучаем своего локального ИИ Джуна, простым языком о сложном
MIT
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Делюсь личным опытом ночного "красноглазанья" при дообучении локальных моделей.
За 22 года существования восьмёрки в интернете накопилось много примеров, когда для получения результата в коде 1С использовали вставки на VBScript, обращение к самодельным dll и их внутренним функциям. Или когда нужная функция годами использовалась самописная, а потом была реализована в платформе. Из-за этого фактически все ИИ-модели путают названия функций и методов, а в языке запросов подставляют SQL-логику.
К концу 2026 года эту проблему можно решить несколькими путями: 1) Пользоваться платными агентскими IDE (Клауд, Курсор и т.д.), которые мы потихоньку сами тюнингуем (дообучаем) нужному синтаксису и стандартам разработки. 2) Пользоваться 1С:Напарником, чей обучающий датасет день ото дня всё лучше и лучше. 3) Почувствовать себя этаким гаражным инженером с паяльником и б/у кондёрами и собрать свой вычислитель самому.
Решив пройти путь самурая, я задал вопросы, от которых зависит, возможен ли проект в Контрольную группу 1С.
Обращаюсь как частное лицо — автор личного некоммерческого проекта: учебный ассистент для разработчиков на платформе 1С:Предприятие 8.3. Проект не является коммерческим продуктом и не связан с Фирмой «1С»; его цель — помощь в изучении платформы и стандартов разработки. Доступ к платформе получил по лицензии для разработчиков (https://developer.1c.ru/); коммерческая поставка платформы мной не приобреталась.
Предполагаемый результат — языковая модель, дообученная на сведениях о платформе: она отвечает на вопросы разработчиков и предлагает примеры кода на встроенном языке. Базовая модель распространяется под Apache License 2.0. Предполагается публикация только квантованного артефакта; исходные материалы Фирмы «1С» распространяться не будут.
Материалы, которые предполагается использовать:
1. Синтакс-помощник платформы — файл `shcntx_ru.hbk` из дистрибутива платформы, доступного по лицензии для разработчиков;
2. Стандарты разработки — материалы сайта its.1c.ru, доступные в рамках лицензии для разработчиков;
3. Сведения о Библиотеке стандартных подсистем и другие общедоступные материалы для разработчиков — открытые публикации на профильных ресурсах сообщества (например, ИнфоСтарт, fastcode.im), включая модули с шапкой «Copyright (c) ООО 1С-Софт», распространяемые под CC BY 4.0.
Прошу разъяснить следующие вопросы.
1. Есть ли у Фирмы «1С» официальная позиция по дообучению языковых моделей на перечисленных материалах и где она зафиксирована?
2. Различаются ли условия для: справки из поставки платформы, материалов сайта its.1c.ru, стандартов разработки, общедоступных публикаций?
3. Как Фирма «1С» квалифицирует файл Синтакс-помощника — программу для ЭВМ, базу данных или иной объект охраны? От этой квалификации зависит порядок получения согласия.
4. Достаточно ли условие лицензии CC BY 4.0 для использования кода Библиотеки стандартных подсистем в обучении модели или требуется отдельное согласие Фирмы «1С»?
5. Покрывает ли лицензия для разработчиков использование перечисленных материалов для обучения языковых моделей, в том числе при последующей некоммерческой публикации результата, или для этих целей требуется иной тип лицензии?
6. Какие условия Фирма «1С» считает необходимыми при некоммерческой публикации обученного артефакта: формулировка атрибуции, ограничения использования, текст дисклеймера?
7. Какая формулировка указания на совместимость артефакта с платформой корректна в описании, если наименование «1С» в названии артефакта не используется?
8. Какие критерии Фирма «1С» применяет для разграничения цитирования сведений и воспроизведения текстов справки в ответах подобных систем?
9. Допустима ли публикация такого артефакта на отраслевом ресурсе для разработчиков (например, ИнфоСтарт), и есть ли у Фирмы «1С» предпочтения по площадке и по оформлению атрибуции при такой публикации?
10. Существует ли официальный программный интерфейс или сервис Фирмы «1С», решающий ту же задачу и предпочтительный для использования вместо собственной модели?
11. Существует ли порядок обращения за разрешением на подобные проекты для частных лиц: адресат запроса, форма обращения, сроки рассмотрения?
12. Планирует ли Фирма «1С» публикацию собственной открытой модели по платформе, чтобы сообщество не дублировало работу?
Ответ прошу направить в письменной форме: он будет использован для корректного оформления атрибуции и условий распространения.
На что они мне ответили:
1) Библиотеку стандартных подсистем, открытые публикации на профильных ресурсах сообщества - можете использовать как хотите и где хотите.
2) все остальное , что получили из закрытых разделов нашего сайта - для своих личных нужд - пожалуйста, но мы не хотим, чтоб Вы из этого создавали продукт для третьих лиц, даже формально бесплатный.
Из ответа следует практический вывод: датасет, собранный только на открытых материалах (БСП, публикации сообщества под CC BY 4.0), можно использовать и публиковать результат. Датасет, включающий Синтакс-помощник или стандарты с its.1c.ru, — только для личного обучения; публиковать веса такой модели нельзя. Если планируете публикацию — стройте датасет на открытых источниках.
Собираем обучающий стенд:
- Компьютер, на котором вы можете комфортно программировать и пользоваться агентской IDE (в моём случае я выбрал Opencode, потому что могу подключить любую ИИ-модель и распределить задачи).
- Инструменты доступа к материалам: MCP-сервер для Синтакс-помощника, локальный сервер стандартов разработки, ваш собственный код с примерами работы с БСП. Инструмент для дообучения Unsloth Desktop (к которому можно подключить вашего агента и он поможет разобраться в настройках).
- Компьютер, на котором будет дообучение ИИ-модели. Это может быть ваш компьютер с мощной видеокартой или облачный доступ с почасовой оплатой.
- Определиться с выбором модели для дообучения. Для себя я выбрал небольшую ИИ модель, которая помещалась в моей видеопамяти empero-ai/Qwen3.8-4B-Distill https://huggingface.co/empero-ai/Qwen3.8-4B-Distill
Список инструментов:
В качестве агрегатора открытых публикаций вы можете воспользоваться ИИ-обзором гугла, доступ к которому вы можете получить через Chrome DevTools.
Для доступа к коду использовал rlm-tools-bsl (он даже попал в список дообучения, ИИ посчитали нужным навыком) //infostart.ru/1c/articles/2707750/
Для доступа к стандартам разработки использовался локально развернутый v8std https://v8std.ru/
Для доступа к синтакс помощнику mcp-1c-helper https://github.com/Antonio1C/1c-syntax-helper-mcp
Обратите внимание: mcp-1c-helper работает с файлом Синтакс-помощника из дистрибутива платформы — это закрытый материал, используйте его только для личного обучения.
Собрав консилиум из трёх моделей «DeepSeek-V4.1-Flash-1017», «GLM-5.3-Flash», «claude-haiku-5-5», я попросил сформулировать список вопросов для дообучения, необходимых Эксперту в стеке 1С Предприятия 8. Руководителем проекта-оркестратором выбрал «DeepSeek». Некоторые вопросы я попросил включить самостоятельно (список приложен к статье). Ответственным за программирование скриптов и файлов дообучения - jsonl я выбрал локальную модель «empero-ai/Qwen3.8-35B-A3B-Distill». Когда она не справлялась, отправлял старших товарищей либо «DeepSeek», либо «GLM», либо «Qwen3.8-Flash-Next».
Список получившихся 211 тем доступен в приложении v9_train_subcategories.txt
Список тем — авторская формулировка, не копия текстов Синтакс-помощника.
А дальше можно попросить сгенерировать по темам задачи для дообучения. Генерацией у меня занимался haiku, потому что после него меньше было возвратов на перегенерацию. А возвраты были связаны с тем, что каждый результирующий файл проходил проверку русского языка — чтобы не было смеси английского и русского синтаксиса, чтобы не было выдуманных методов, которых нет в синтаксис-помощнике. Если по задаче требовалось расшифровать синтаксис, то локальный кодер удалял из справки синтакс-помощника английские имена методов.
Если требовалось пояснить код, то он прогонялся через стандарты разработки.
Если будете повторять мой опыт, потренируйтесь на нескольких темах. Логируйте промт, что собирается для отправки, и полученный результат. Вы можете узнать, что в ваш промт попали случайно подключённые скиллы, не относящиеся к теме. Что сложились кодировки UTF-8 и CP1251, смеси русских и английских команд (а это кракозябры и галлюцинации на входе и выходе).
Прежде чем запускать полный прогон по всему списку тем, определитесь с размером ответа. От этого зависит время потраченное на дообучение.
Оцените число токенов в задаче — от этого зависит параметр max_seq_length.
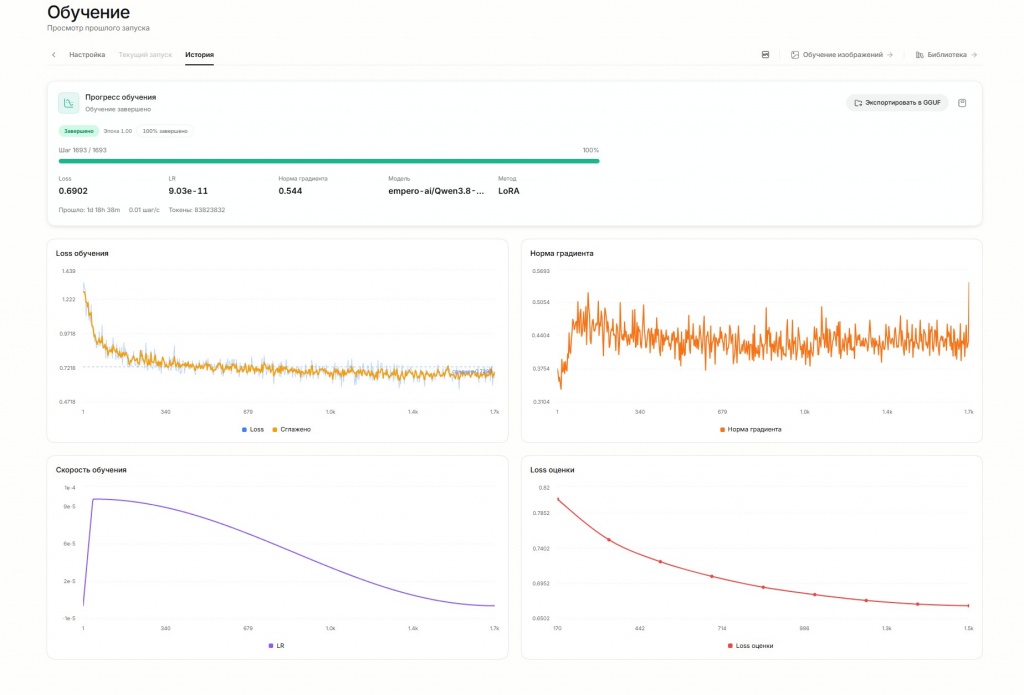
В моем случае разница max_seq_length в 2048 или 4096 и выше могла увеличить время дообучения от суток до недель. Действительно ли вам нужен такой развернутый ответ, или для понимания сути достаточно и меньше текста.
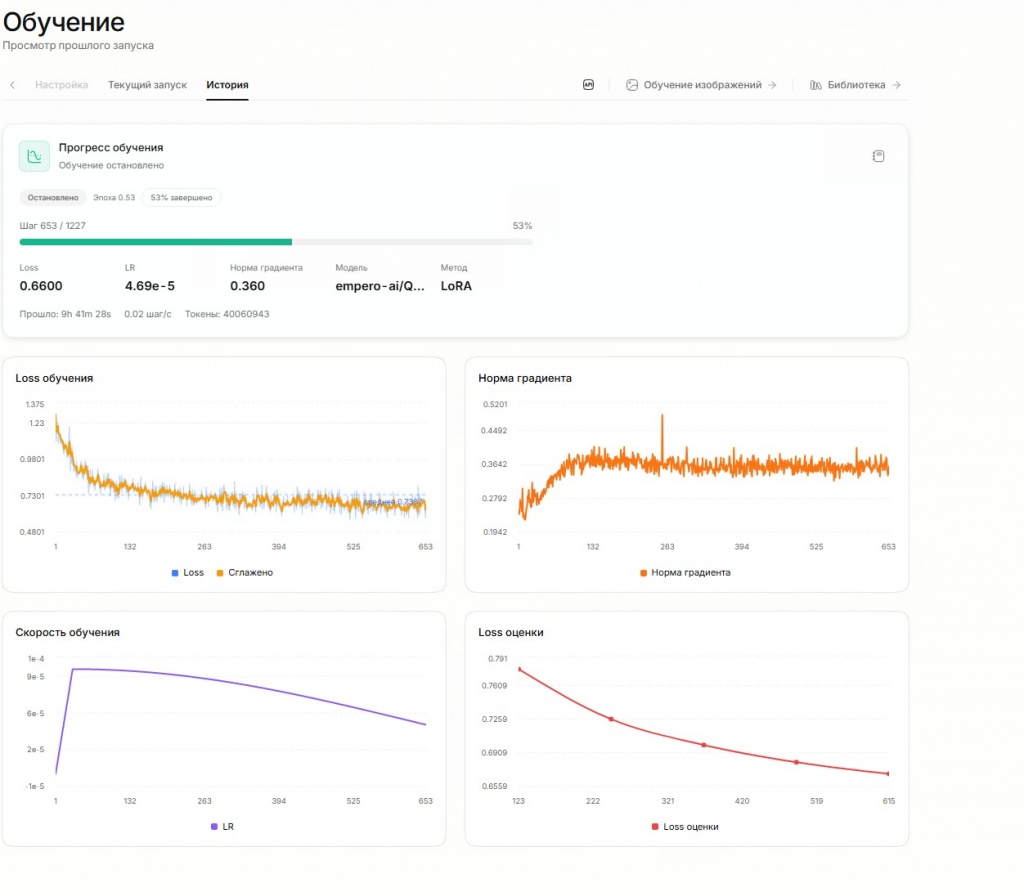
Когда соберете датасет, попросите создать тренировочный на 20-30 шагов. Чтобы протестировать и убедиться, что вам хватит времени и бюджета. Что дообучение идет в нужном русле.
Дообучение на H100 в облаке заняло 19 часов, на локальной машине после оптимизации размера датасета, подтверждённого патча скриптов Unsloth https://github.com/unslothai/unsloth/issues/17734 для Strix Halo, gfx1151 время сократилось с 20 дней до 2-х суток.
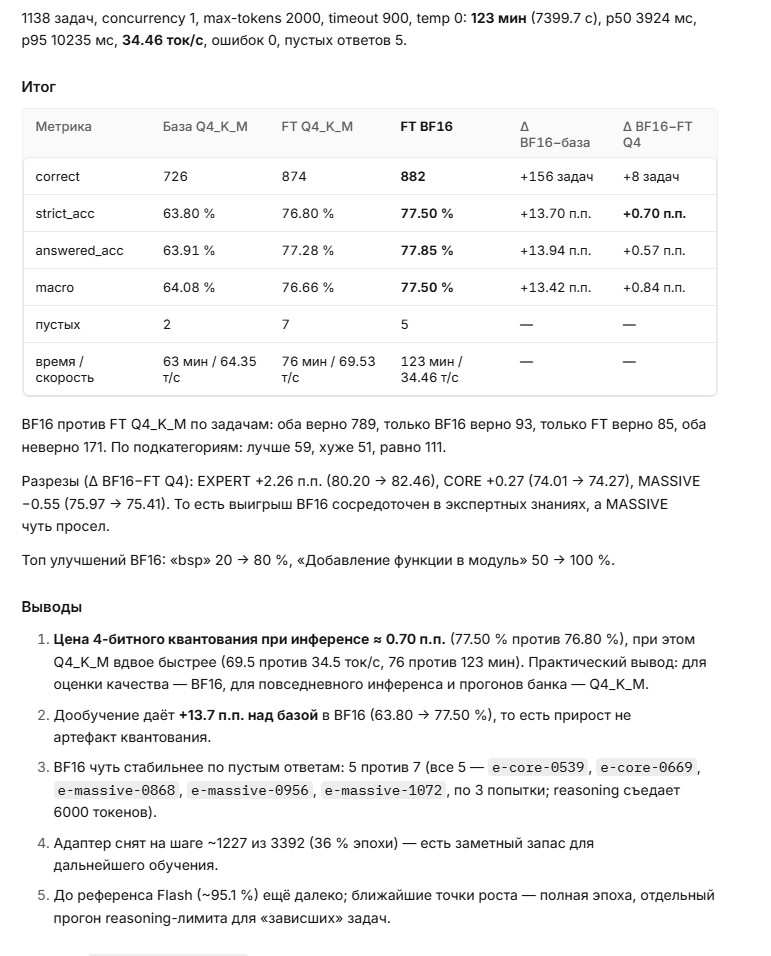
А вот для тестирования знаний я предпочел простой метод тестов, с вариантами ответов. Попросил сгенерировать по несколько вопросов, на каждую тему. Где ИИ модель должна выбрать вариант ответа. Т.к. пересечение с датасетом идет только по названиям тем, то заучивание невозможно, проверяются только знания и можно проследить прогресс дообучения. Ну или протестировать любую другую ИИ модель, а надо ли ее дообучать по Вашему списку необходимых знаний.
Статистика по количеству задач датасета на тему в файле stats_v8.md. (почти 80 тысяч, но в обучение выбрано было почти 60 тысяч).
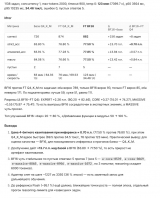
Результат тестирования показал:
Знания модели по тестам 63,80 % (726 из 1138 вопросов) → стало 77,50 % (882 из 1138) в BF16.
А дальше можно включить рекурсию и улучшать качество дата сета, добиваясь результата, который не стыдно показать облачной модели. Либо выбрать более умную модель, которую надо подтянуть всего лишь чуть-чуть. Потому что на своих же тестах, облачные модели показали знания на 95%.
Сколько это все стоило?
Всего 2 200 687 427 токенов, 362 сессии.
Локально 452,9 млн (20,6 %), облако 1 747,8 млн (79,4 %)
Если считать в килограммах обычного зернового кофе, я мог бы купить себе 8 кг хорошего африканского кофе.
В днях почти месяц, в часах, когда требовалось мое личное участие, наверное, больше 20 часов.
Можно ли ускорить? Конечно же можно, никто не мешает вам распараллелить генерацию дата сета по разным провайдерам, доверив генерацию данных одной модели. И тогда узким местом останется только сам процесс дообучения.
Вывод:
Дообучение локальной модели на материалах 1С — реально и доступно частному разработчику. Но границы использования материалов определяет правообладатель: открытые — можно, закрытые — только лично. Если планируете публиковать результат — стройте датасет на открытых источниках.
Дисклеймер. Опыт, описанный в статье, — личный эксперимент. Позиция Фирмы «1С», полученная автором в переписке: материалы БСП и открытых публикаций сообщества можно использовать свободно; материалы закрытых разделов (включая Синтакс-помощник и стандарты с its.1c.ru) — только для личных нужд, без создания продукта для третьих лиц, даже формально бесплатного. Автор не публикует веса модели, обученной на закрытых материалах, и не призывает нарушать эту позицию. Все действия с закрытыми материалами в статье — личный учебный эксперимент, не предназначенный для тиражирования третьими лицами.
P.S. Приложенные файлы, это пример, с чем я работал, они не обязательны для того ,чтобы пройти подобный моему путь, и они не сократят Время необходимое для решения Ваших задач.
P.P.S. Статья редактировалась ИИ, поэтому некоторые абзацы слишком стерильны.
Вступайте в нашу телеграмм-группу Инфостарт