Графин 7.7. (окончание)
Разработка - Математика и алгоритмы



Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Предыдущие мои публикации Граф(ин) 7.7. и Граф(ин) 7.7. (дополнение) носили, скорее, умозрительный характер, имея одной из целей продемонстрировать, что деревья в частности и графы вообще вполне уживаются с семерочной платформой. Однако после появления статьи Запрос против рекурсии или "разузлование" номенклатуры мне просто некуда было деваться – и вот пришлось сваять небольшую конфигурацию для исследования «разузловательных» процессов. В конфигурации присутствуют два справочника: НоменклатурныеПозиции и Наборы. Содержимое справочника Наборы (с реквизитами Отец, Сын, Количество) как раз и определяет исследуемый граф.
Разумеется, я начал с
Тест № 1. "Десять" Справочник содержит 6-уровневый 10-арный граф , имеющий 1 000 000 различных ветвей и при обходе такого графа таблица ВремТаблица6 на выходе цикла алгоритма содержит 1 000 000 записей. Проще говоря, корневому элементу подчинены 10 элементов, каждому из которых подчинен одинаковый набор из десятка следующих элементов и т.д.
Ориентиром для меня служил пост № 118 из темы http://forum.infostart.ru/forum14/topic35991/ :
Через таблицу значений в 77 это сделать сложнее. У вас отсутствует команда НайтиСтроки , выбирающая по фильтру нужные строки из таблицы значений. Ну, раз взялся , то помни : - контроль зацикленности каждой ветки обязателен. 1. 4 мин - не о чем говорить 2. 3 мин - очень плохо 3. 2 мин - просто плохо 4. 1.5 мин - посредственно 5. 1 мин - хорошо 6. 40 сек - отлично 7. 20 сек - Арчибальд - СУПЕРСТАР на все времена ! ( в указанное время входит копирование элементов из справочника в таблицу значений)
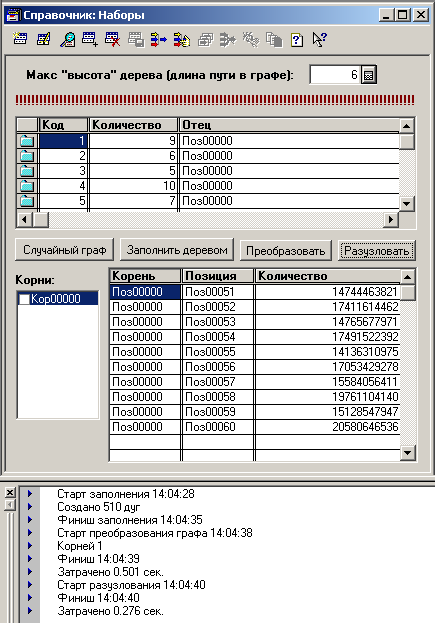
Ну, и сразу получил 0.777 секунды, из которых 0.5 - преобразование графа и 0.276 - собственно разузлование (скрин 1). Отнюдь не 20 сек, как в упомянутой статье. Но похуже, чем в статье Как не «попасть на миллион», решая задачу разузлования , хоть и не на два порядка.
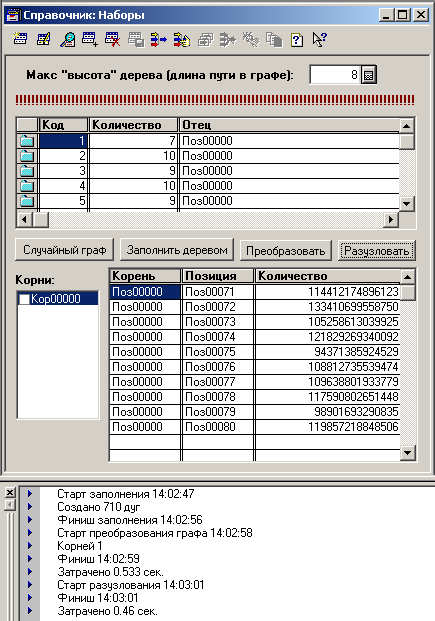
Ладно, думаю, попробуем 100 000 000 (скрин 2). 0.993 секунды.
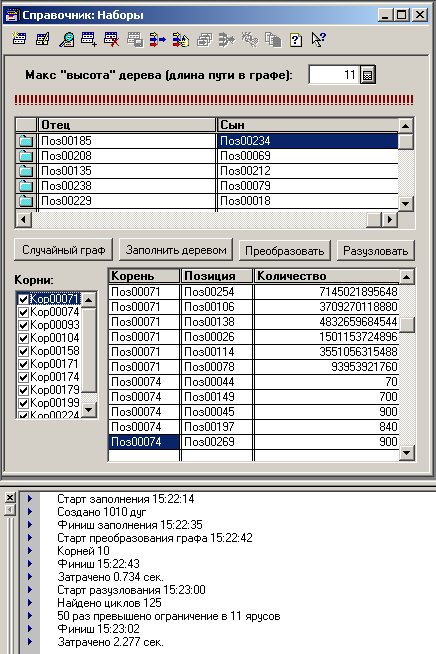
Добрался аж до 100 000 000 (скрин 3). 1.525 сек. То есть "деревья" (которые и не деревья вовсе, на самом-то деле) из Теста №1 обходить неинтересно.
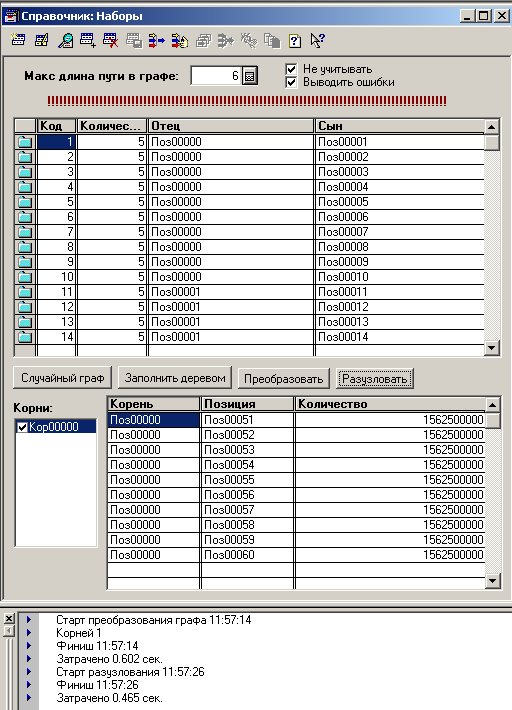
А вот заполнять список дуг (справочник Наборы) произвольным (псевдослучайным) образом, находить в полученном графе вершины, не имеющие родителей (корни), и разузловывать сразу все эти корни, либо несколько (по отметкам в списке корней) – достаточно познавательно (скрин 4). Все-таки 3.02 секунды. Правда, разузловывались десять позиций. Бывает и больше.
Все действия производятся в форме справочника Наборы. В частности, на форме кнопки для двух вариантов заполнения исходного справочника. Кнопка Преобразовать запускает конвертацию представления графа дугами в представление вершинами. Все коды открыты. В архиве – сохраненная конфигурация.
Попробуйте поиграться!
Ну и, наконец, вывод. Успешность (эффективность) решения задач весьма призрачно зависит от платформы. Зато сильно зависит от спроектированной структуры данных...
29.11.2010. Еще несколько слов о задаче разузлования. Теоретическая сложность этой задачи - О(N * lg N), где N - число (различных) узлов графа. Именно так вел бы себя алгоритм в упомянутой статье "Запрос против рекурсии...", если бы автор не отказался от конструкции "СГРУППИРОВАТЬ ПО" и не искал вместо ошибочной дуги графа все ошибочные цепочки, порожденные этой дугой. Применительно к задаче разузлования такой подход не учитывает наличия стандартизации узлов и деталей - а она реально существует. Гайка М10х17 - она и есть гайка...
Вступайте в нашу телеграмм-группу Инфостарт
См. также
Загрузка и выгрузка в Excel Математика и алгоритмы Разработчик 1С:Предприятие 7.7 1С:Предприятие 8 Бесплатно (free)
Статья посвящена распространённому вопросу - как сохранить несколько таблиц (отчетов) в формате MXL, с которым работает 1С, на отдельные листы одного Excel файла. Освещается простой алгоритм решения проблемы штатными средствами, без использования внешних модулей и библиотек (не относящихся к 1С и Excel).
23.11.2015 21512 etmarket 14
Разработка внешних компонент Математика и алгоритмы Разработчик 1С:Предприятие 7.7 1С:Предприятие 8 Бесплатно (free)
Динамическая компиляция класса обертки для использования .Net событий в 1С через ДобавитьОбработчик или ОбработкаВнешнегоСобытия, а так же генерация модулей на C# и 1С для подключения к событиям. Использование DynamicMethod и ILGenerator. Представлены примеры для использовании событий System.IO.FileSystemWatcher (Ожидает уведомления файловой системы об изменениях и инициирует события при изменениях каталога или файла в каталоге.) и SerialPort (обработка сканера штрих кода подключенного к COM порту). Обертка позволяет использовать классы .Net только на языке 1С. Реализация 1C Messenger описанного здесь http://infostart.ru/public/434771/
12.11.2015 55771 Serginio 38
Математика и алгоритмы Разработчик 1С:Предприятие 7.7 1С:Предприятие 8 Абонемент ($m)
Статья посвящена исследованию следующего вопроса: необходимо сравнить 2 наименования справочников с целью вычисления их степени сходства. По задумке, степень сходства должна выражаться в процентах.
1 стартмани
25.02.2015 27928 etmarket 46
Математика и алгоритмы Разработчик 1С:Предприятие 7.7 1C77 Абонемент ($m)
Часто при приеме на работу встречается задача про сгибание листка
1 стартмани
26.02.2013 21853 11 Sbelyi78 38
Управление взаимоотношениями с клиентами (CRM) Оптовая торговля Розничная торговля Математика и алгоритмы Разработчик Пользователь Оперативный учет 7.7 1С:Комплексная 7.7 1С:Торговля и склад 7.7 1С:Производство+Услуги+Бухгалтерия Розничная и сетевая торговля (FMCG) Транспорт, автопарки, такси Оптовая торговля, дистрибуция, логистика Управленческий учет Абонемент ($m)
Формирование маршрутов доставки на основе генетического алгоритма (решения задачи коммивояжера) для 1С Предприятия 7.7
1 стартмани
12.01.2013 31018 117 phsin 10
Математика и алгоритмы Системный администратор Разработчик Бухгалтер Оперативный учет 7.7 Бухгалтерский учет 7.7 Расчет 7.7 1C77 Россия Абонемент ($m)
Универсальная печать таблицы значений, которую не стыдно прикрутить к рабочей базе данных. Группировка данных, подсчет итогов, составление диаграмм, выгрузка в быстрый доступ к исходной ТЗ.
1 стартмани
23.05.2012 16425 66 McSeem 3
Математика и алгоритмы Разное Оперативный учет 7.7 Бухгалтерский учет 7.7 1С:Бухгалтерия 7.7 1С:Комплексная 7.7 1С:Торговля и склад 7.7 1С:Производство+Услуги+Бухгалтерия Россия Абонемент ($m)
Определение объема жидкости в цилиндрическом горизонтальном резервуаре измерением глубины жидкости
1 стартмани
03.04.2012 19119 5 akrazan 11
Математика и алгоритмы Разработчик 1С:Предприятие 7.7 1C77 Россия Абонемент ($m)
Алгоритм получения значения тригонометрических функций путем разложения их в ряд Тейлора
1 стартмани
04.03.2012 10325 4 nysysimara 10
1. Перепишите, пожалуйста, абзац с упоминанием моей статьи, а то с лету кажется, что описанное в моей статье решение занимает 20 секунд, хотя на самом деле результат правильной программы, описанной в моей статье - 0,122 секунды! Там же есть скриншот графа с 33-мя уровнями, который решается за 3,5 секунды. Разница между Вашими и моими результатами - в 5 раз (0,122 и 0,777). Это преимущества платформы. Могу обосновать.
2. Давайте называть вещи своими именами: в задаче, которую Вы решили за 0,777 секунды НЕТ ДЕРЕВА! Там есть граф из уровней с 0-го по 6-ой, вершины в смежных уровнях которого попарно связаны! В моей статье, есть рисунок этого графа, программа рисования которого на 8 занимает 10-ть строк! В ДЕРЕВЕ ветви принципиально не пересекаются! А вот преимущества запросов в немоей статье обосновываются их якобы хорошей работой для структур типа ДЕРЕВО. Там реально создаются в базе и связываются спецификациями 1 111 111 номенклатур. В том дереве 111 111 дуг! Но даже в этом случае реальные результаты рекурсии лучше!
Процедура Проц()
   //что-то сделали, при этом изменилось контекстное окружение
   Если ПораЗаканчивать Тогда
      Возврат;//контекст - из стека
   Иначе
      Проц(); //контекст - в стек ОС
   КонецЕсли;
КонецПроцедуры
То же самое делает цикл
Пока 1=1 Цикл
   //что-то сделали, при этом изменилось контекстное окружение
   //возможно, потребуется "затолкать" это окружение в некий самодельный "стек"
   Если ПораЗаканчивать Тогда
   //возможно потребуется извлечение из стека
      Прервать;
   Иначе
      Продолжить;
   КонецЕсли;
КонецЦикла
ПоказатьТак что сравнивать имеет смысл Запрос vs Рекурсия/Цикл, а не Рекурсия vs Цикл
Ставлю "плюс" на публикацию за сам алгоритм.
А с точки зрения СУБД доказано (показано), что много записей в БД - плохо, а мало - хорошо. А много бесполезных записей - очень плохо. Но это уже другая тема - тема про "запросы". ;-)
Вместо того, чтобы предостеречь Арчибальда - Вы его поощряете.
Я сейчас я ему вроде как конкурент, меня он не послушает , а Вы то что ?
Игорь.
Я четко понимаю (знаю), что Александр решал совершенно другую задачу. И Сергей - другую. Но еще, я четко понимаю, что вы ставите и решаете "свою" задачу из-за отсутствия "нормальных" средств для её решения. Типа, жизнь заставляет.
ДалееРассуждизм.
Есть такое выражение: "Если изнасилование неизбежно, то надо расслабиться и получить удовольствие." Вы расслабились, получаете... ;-) Но это не означает, что следует пропагандировать такую схему получения "удовольствия". Т.к. на самом деле больше всего удовольствия получает "насильник". А Вы его поощряете к дальнейшим деяниям, подставляя множество очередных жертв. Соучастник, Вы - наш... ;-)
КонецРассуждизма.
Вот, написано:
"Успешность (эффективность) решения задач весьма призрачно зависит от платформы. Зато сильно зависит от спроектированной структуры данных..."(с)
Т.е. думать и работать надо. А не искать готовые решения, типа: 1С, 2С...nC...."СКД"...0С.
Я Вашу "деятельность" называю поиском "Волшебной палочки".
Но, это очень мягко сказано... :-( :-( :-(
Игорь.
А как может быть ещё?
Я ничего нового Вам сказать не могу.
Я задаю Вам вопросы - Вы не отвечаете.
Ну, хоть, в этой теме ответьте мне на простые вопросы.
Как дерево из 1111111 узлов может использоваться для описания "разузлования, спецификаций..." 60 изделий? Это специально под запросы и 20 секунд сделано?
И почему Вы никак не комментируете результат по скорости на задаче в 1111111 номенклатур? А значение на ADS-е без запросов 20-35 секунд в "файловом" режиме, и 60-70 секунд в клиент-серверном режиме, именно, для 1111111 номенклатур. И почему при написании этого моего алгоритма на языку 1С-а время становится за 200 секунд? Или Вам пояснить Вашу же фразу "...если реализовать задачу на Си или Delfi, то удастся достичь лучшего быстродействия, чем указано в теме ?"(с)
Эх...
P.S. Прощу прощения у Автора данной темы. Но меня, опять, возмутил призыв Игоря к объективности при сравнении "абсолютных величин"...
Игорь.
"разговор пошел "узко-конкретный"."(с)
Да, уж... Очень - конкретный:
2 > 1 - верно.
2 грамма > 1 килограмм - ошибка.
2 грамма > 1 миллиметр - бред !!!
Сравнивайте решения для различных 1111111 номенклатур.
Или вернитесь к "изначальному" описанию схемы БД:
СвойID, РодительID, Количество, СсылкаНаНоменклатуру
Т.е. не извращайте схему БД под удобства решения частной задачи запросами.
Частных задач ("узко-конкретных") очень много - схем БД не напасётесь... ;-)
Извините. Повторяюсь. Всё написано в форуме ещё до публикации Ваше статьи. :-(
1<10<10<10<10<10<10 (~ 1 000 000 узлов) оценка 600 реальность 630
1<10<10<10<10<10 (~ 100 000 узлов) оценка 50 реальность 40
1<10<10<10<10 (~ 10 000 узлов) оценка 4 реальность 3.3
1<10<10<10 (~ 1 000 узлов) оценка 0.3 реальность 0.3
1<10<10 (~ 100 узлов) оценка 0.02 реальность 0.12
Александр.
А Вы запустите свою программу под отладчиком.
И посмотрите на "качество" компиляции/интерпретации операторов 1С по времени. Не ввода/вывода, а умножения, деления, сложения, вызова функций, СоздатьОбъект() и т.д.
Эта скорость 30-и летней давности!!!
Я такую скорость имел на IBM/370 (Ряд 2, ЕС-1045).
Я замерял время выполнения инструкции: x=x+a[i]*a[i].
На "Си" это выполняется в 1000 раз быстрее чем на 1С.
А время ввода/вывода можете считать как, порядка, 30 секунд для чтения 1111111 записей по ключу. В случае DBF в локальном режиме, думаю, и того меньше.
И еще печальный факт про "1С 7.7".
Методы внешней компоненты вызываются медленнее чем родная функция 1С-а.
Т.е. если расчетные алгоритмы пытаться ускорить на ВК, то весь алгоритм в неё и придется помещать.
Так вот оно что ! Я твой алгоритм не проверял , но теперь все понятно , как ты контролируешь зацикленность .
Секрет СУПЕРскорости представленных обработок один -
отказ от надежного гарантированного контроля зацикленности каждой ветки.
К чему это приводит - почитай в теме "Запрос против.." , чем закончились тестирование обработки Сергея на зацикленность.
Ведь если бы Сергей исправил вторую ошибку - я бы подросил ему уже заготовленную третью.. И латал бы он свой СУПЕРбыстрый алгоритм до бесконечности.
Если у тебя в алгоритме нет надежного контроля зацикленности ,
то ты тоже мог оказаться в положении Сергея : то ли
- признать ненадежность своего алгоритма и тогда все предыдущие утверждения , СУПЕРхарактеристики , сравнительные таблицы полетят в тартарары
- то ли ли просто прекратить разговор дескать Нет ! и всё.
Так вот .
"СГРУППИРОВАТЬ ПО " не применяется в алгоритме именно потому , что нужно контролировать КАЖДУЮ ВЕТКУ графа. Применение этой опции приводит к резкому ускорению в тесте №1 (тот самый опрометчивый "щелчок за секунду" как в товей обработке) , но потере контроля зацикливания каждой ветки.
Т.е. как бы для ТЗ с колонками "Узел","СписокПредков" делаю ТЗ.Свернуть("Узел","СписокПредков"). Реально так:
Для ы = 1 по ТекСписок.РазмерСписка() Цикл
ТекЗнач = ТекСписок.ПолучитьЗначение(ы);
Если ПромРез.СписокПредков.НайтиЗначение(ТекЗнач) = 0 Тогда
ПромРез.СписокПредков.ВставитьЗначение(ы,ТекЗнач);
КонецЕсли;
КонецЦикла;
Пусть в твоей таблице ПромРез колонка СписокПредков - это строка (у меня это "СтрокаКодов") и тогда ТекСписок содержит строковые коды справочника+ символ разделителя:
Для ы = 1 по ТекСписок.РазмерСписка() Цикл
ТекЗначКод = ТекСписок.ПолучитьЗначение(ы);
Если Найти(ПромРез.СписокПредков,ТекЗначКод) = 0 Тогда
ПромРез.СписокПредков = ПромРез.СписокПредков+ТекЗначКод;
КонецЕсли;
КонецЦикла;
Если так ,то не быстрее ли ?
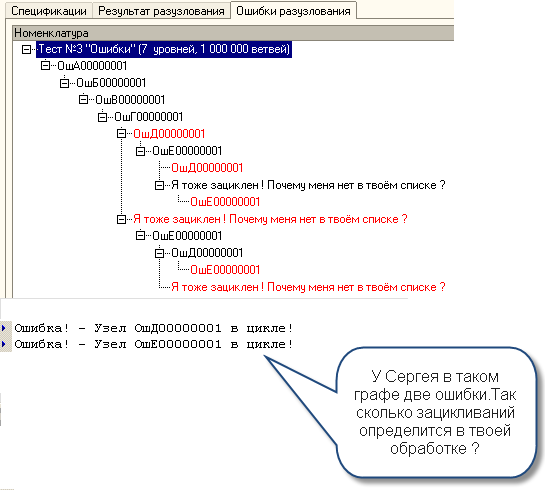
У меня на рисунке в (26) нарисовано дерево -
совершенно стандартный во всех пакетах мира вид.
Элемент "ОшГ000001" имеет двух детей : "ОшД0000001" и "Я зациклен..." и так далее.
У меня один простой вопрос : сколько, каких зацикленных элементов (или ветвей) покажет твоя программа ?
В (37) ты пишешь ссылась на (26):
А гшраф, нарисованный здесь опять-таки, по моему варианту даст 1 (дугу), по твоему алгоритму - 5 (позиций в "дереве"), а по соображениям из (35)долже бы дать 2 (вершины).
Это и послужило пружиной, толчком ко всей дальнейшей дискуссии.
Теперь же у тебя алгоритм выдает 2 дуги.
Ты же цитируешь из 37 поста ту часть, которая к 26-му отношения не имеет, а относится к другому графу, там же и изображенному. Этот граф имеет одну ошибочную дугу - это по-моему. А по-твоему - пять ошибочных цепочек.
У тебя сделана обработка "для сэбэ", заранее предполагая что тестировать её никто не будет.
Попытавшись интерактивно что-то создать в твоём справочнике я только чертыхался.
Если ты действительно хочешь узнать правду , насколько твой алгоритм надёжен.
Создай удобный интерфейс для проверки при помощи элемента дерева формексом или еще как.
Посмотри как сделано у меня :
Пользователь может без труда интерактивно задать любой граф, используя дерево.
Тут же проверить и увидеть ПОЛНЫЙ граф ошибок (см. 26).
Обработка в таком виде уже используется в УПП с легкими исправлениями.
Посмотри
Я веду речь о том , что твою и мою обработки нужно выровнять по функционалу. В таком виде как у тебя - они не сопоставимы.
P.S. Важность тестирования любого утверждения явно вытекает из моей темы :
все рассуждалки...
соображения и размышлизмы...
цифирьки о сверхскоростях ...
разлетелись в дребезги после проверки.
Теперь касательно твоей обработки. Она не прошла тест из 50-го поста (текстуально он продублирован как Тест № 1А в посте 69). Я уже не говорю, что тест на 10 миллиардов (как Тест № 1, только вместо 6 поколений 10) она вообще не сможет пройти. Вот где-то здесь несопоставимость функционала и проглядывает.
Тут же проверить и увидеть ПОЛНЫЙ граф ошибок (см. 26).
Что увидит пользователь на тесте № 1А "Десять+ошибка"? Да ничего!
И поясни мне, каков будет процесс интерактивного задания графа с картинки ниже.
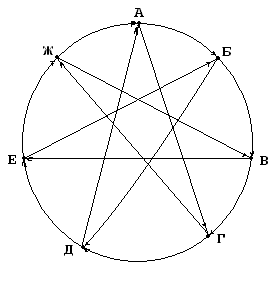
Так мы закончили рассматривать твою обработку ?
Ты считаешь , что пользователь должен лезть в код чтобы задать нужную ему ошибку зацикливания ?
И этого достаточно :
Кем не найдено ? - Тобой ?
Кем прогнаны ? - Тобой ?
Известно всё , кому ? - Тебе ?
Я тебе как раз и толкую о том , что автор разработки САМ должен создать удобный интерфейс
для проверки правильности своих суждений. Чтобы пользователь САМ интерактивно мог всё проверить и смоделировать ситуацию. У тебя этого просто нет.
И все твои утверждения повисают в воздухе - кто полезет ковыряться в чужом коде ?
Пользователь может без труда интерактивно задать любой граф, используя дерево.
Тут же проверить и увидеть ПОЛНЫЙ граф ошибок (см. 26).
И касательно удобного интерфейса для построения графов. Куда уж удобнее: вля каждой дуги указать начало, конец, количество (последнее - только для разузлования). Нет и не может быть других интерфейсов для "произвольных графов, заданных таблицей наборов {Отец, Сын, Количество}" - именно таким было твое начальное условие. Ну, а то, что в восьмерке есть встроенный объект "дерево", как в формексе, ничего не прибавляет к твоему алгоритму разузлования.
Ты обыгран на твоем поле и по твоим правилам - если в качестве правил брать условия задачи из твоей статьи, а не из комментариев к моей. Доказательство: Добавление всего одной ветки к твоему Тесту №1 ставит тебя в тупик. Это не висящее в воздухе, а твердо опирающееся на факты утверждение.
"Я веду речь о том , что твою и мою обработки нужно выровнять по функционалу. В таком виде как у тебя - они не сопоставимы."(с)
Гениально!
Тема, плавно, перешла в обсуждение интерфейса. Цвет обсуждать будем? ;-)
Игорь.
Вы уже себе доказали, что любую постановку задачи следует подгонять под доступные средства (инструменты) программисту. Что еще может сделать Ваш алгоритм с "деревом" кроме проверки циклов и подсчета "изделий"? Это всё, что требуется для "разузлования"?
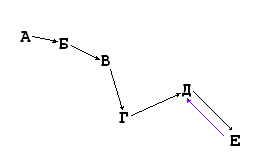

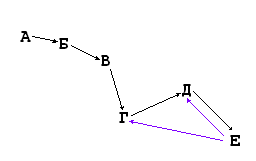
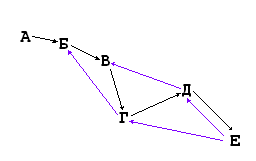


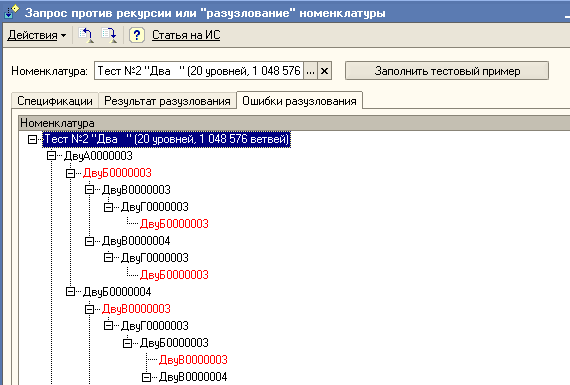
Это картинка из моей программы рисующей граф ошибок ,
на котором завалился Сергей . На красный цвет не нужно обращать внимание.
Давай для простоты ориентируйся только на (33) - это практически тот же граф , но в табличном виде .
Итак , в (33) - наш граф. А (35) - все соображения по раскрутке этого графа.
Корень в графе - один . Это позиция номенклатуры с именем "Корень". (33)
Идя последовательно от "Корень" по таблице Справочника (33) мы вытащим всю цепочку.
в (35) показано , что всех возможных ветвей для позиции номенклатуры "Корень" может быть 4.
И далее по тексту (35). Ты согласен с этими рассуждениями ?
А ты изобрази своим рисунком граф в (33).
В машине рисунков нету. Нужно последовательно обойти весь граф (34)
побывав в каждом узле и построив все возможные ветки.
Двигаемся по одинарной ветке , пока не сработало зацикливание.
Напоминаю, зацикливание есть факт нахождение на любой из веток от корня до вершины двух одинаковых элементов.
Все ! такие факты мы должны выявить.
Начинаем движение вслепую.
Ветка 1. А-Б-В- Г- Я_тоже - Е - Я_ТОЖЕ. На последнем сработало зацикливание , движение прекращаем.
Ветка 2. А-Б-В- Г- Я_тоже - Е - Д - Е.
Ветка 3. А-Б-В- Г- Д - Е - Д.
Ветка 4. А-Б-В- Г- Д - Е - Я_Тоже - Е
Итого З элемента (Е- дважды)
И число 3 и состав Е,Д,Я_тоже НЕ ЗАВИСИТ от порядка обхода.
Если же мы начнем хитрить при обходе то потеряем элемент.
Шаг 1. (А)(А-Б). Норма.
Шаг 2. (А,Б)(Б-В). Норма.
Шаг 3. (А,Б,В)(В-Г). Норма.
Шаг 4. (А,Б,В,Г)(Г-Д)(Г-Я_тоже). Норма.
Шаг 5. (А,Б,В,Г,Д,Я_тоже)(Д-Е)(Я_тоже-Е). Норма.
Шаг 6. (А,Б,В,Г,Д,Е,Я_тоже)(Е-Д)(Е-Я_тоже). Две ошибочные дуги. Их и отмечаем как ошибочные в справочнике дуг (исходном или его копии) Больше ошибок в справочнике (графе) нет.
Если же мы начнем хитрить при обходе то потеряем элемент.
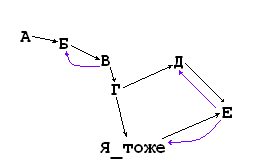
А я тебе еще раз говорю : ты должен выдать весь список зацикленных элементов.
Ты мне сказал ДВА.
Я тебе говорю ТРИ !
и спрашиваю : Чем Я_тоже - хуже(лучше) чем Е и Д.
Или Чем Е хуже (лучше) , чем Я_Тоже и Д ?
Соображения как мы обходим граф, какие там дуги, когда в нем бардак или нет не имеют никакого смысла.
Еще раз : зацикливание есть факт нахождения на одной элементарной(одинарной) ветке графа одного и того же элемента в качестве "ребенка" и "родителя".
Точка.
"Вынь и положь" такие факты на стол. Любым способом !
Этот факт обнаруживается в текущем графе для ТРЕХ элементов. Е,Д,Я_ТОЖЕ.
Этот способ я описал.
Какой в этом практический смысл и что это дает ?
Исправить ошибку зацикливания не так-то просто - пользователю нужны ВСЕ зациклившие элементы, которые должны быть отображены на графе. Ему нужно видеть полную картину , как у тебя на рисунке , только подсвечены красным цветом Е,Д, Я_ТОЖЕ.
Чтобы выдать эту полную картину , мы должны иметь все три элемента и все их ветки.
P.S. Я тебе обойду граф с любого места (получу два графа : "все родители" и "все потомки") . Могу и с Е.
Другими словами, ты идешь в своих рассуждениях от программиста, от того , как удобно обходить граф,
А я иду от пользователя , ему удобнее видеть ВСЕ зацикленные элементы.
Берем граф из знаменитого теста № 1 и добавляем одну ошибочную дугу (см. рис.). При поиске циклов я одну дугу и найду - это то, что я реально должен. А ты найдешь 10 000 цепочек. То-то обрадуется твой пользователь ;).
Даже если ты выдашь ему список из 42 узлов - мало не покажется. Все равно это необозримо, и значит, бесполезно. Мы же прикладную задачу решаем, а не абстрактную.

Конечно , ты старый и умный.. хихикаешь над нами , над молодежью.
Так вот, я тебе с юношеским максимализмом толкую :
программа обработки графа должна зафиксировать ВСЕ факты зацикливания,
а как их потом будет обрабатывать пользователь или промежуточная программа представления ошибок
- это не её ума дело. Зафиксируй и полоЖь !
А как бы я тогда анализировал ошибки , подбрасывал Сергею то одно ,то другое ?
Или как пользователь проверит что ты написал в своей теме ?
Да, мало ли что можно в "теме" намолоть ?
Скажи как я проверю , что то ,что ты написал в своей теме правильно ?
правильно ли ищутся ошибки зацикливания ? правильно ли обсчитывается огромный граф ? как ?
У тебя такой процедуры - нет . И пользователь поощряет тебя вслепую.
"Арчибальд...а, ну это хороший человек и про граф вроде неплохо пишет..! "
На рисунке представление обработки ошибок из ЗапросПротивРекурсии.epf

Сейчас нарисую граф совсем уж конкретно такой, как ты хочешь.

Никаких средств контроля правильности обработки графа для пользователя не существует.
Вспоминал 77,тужился , пыжился , чертыхался..
Потом плюнул и написал тебе (26) , дескать скажи как оно будет ?
Давай лучше по рисункам графа. Стрелочки , картинки..
Игорь.
Вы пишете: "...зацикливание есть факт нахождения на одной элементарной(одинарной) ветке графа одного и того же элемента в качестве "ребенка" и "родителя". "(с)
Но Ваш алгоритм это делает не в графе, а в "дереве".
Я Вам представил простейший алгоритм для решения задачи для "дерева". Хотя для "дерева" поиск циклов - это... ;-)
Вы "забраковали" мой алгоритм.
Почему?
А потому, что в моём решении нет ключевых, для Вас слов - "решить задачу надо запросами". И о чём тогда разговор в данной теме про "графины"? Давайте я Вам расскажу - почему очень многие задачи не следует решать запросами. Но это совсем другая тема - эта тема про запросы... ;-)
Суть в том, что ты из графа делаешь дерево, дублируя подграфы, а я работаю с произвольным графом непосредственно. Только в качестве начальной выбираю вершину, не имеющую предков.

Разложим граф на элементарные ветки
(пытаемся двигаться от корня по каждой ветке,пока по ней и только по ней, не встретим зацикливания) :
1. Корень -  КОшД01         - КошЕ01 - КОшД01                    - зациклен элемент "КошД01"
2. Корень -  КОшД01         - КошЕ01 - К я зациклен !   - КошЕ01 - зациклен элемент "КошЕ01"
3. Корень -  К я зациклен ! - КОшЕ01 - КОшД01           - КошЕ01 - зациклен элемент "КошЕ01"
4. Корень -  К я зациклен ! - КОшЕ01 - К я зациклен !            - зациклен элемент "К я зациклен !"
Вопрос : А с чего это я взял , что именно так жестко нужно проходить от корня - по каждой ветке
и не используется пред . информация о том что какой-то элемент зациклен ?
А с того, что в таком случае мы не зависим от порядка обхода графа и выдаем ПОЛНУЮ(всю) информацию о зацикливаниях в виде дерева(графа).
Как только мы начинаем использовать пред. информацию о зацикливании, то в попадаем зависимость от порядка обхода графа. И начинаем выдавать разный состав зацикленных элементов в зависимости от порядка обхода.
А это полная жуть ! Поиграйся порядком пунктов обхода 1-2-3-4, 4-3-2-1 и т.д. , учитывая пред.зацикливания, и получишь разный состав зацикленных элементов.
Поэтому НУЖЕН АБСОЛЮТНЫЙ КОНТРОЛЬ !
И правильный ответ - 3 элемента. Только 3 элемента дают полную постоянную информацию о зацикливании.
Как граф не обходи -получишь 3 элемента.
А гшраф, нарисованный здесь опять-таки, по моему варианту даст 1 (дугу), по твоему алгоритму - 5 (позиций в "дереве"), а по соображениям из (35)долже бы дать 2 (вершины).
И насчет начала обхода. Мой алгоритм выявляет все возможные корни (стартовые для разузлования) и позволяет "с кнопки" находить все ошибочные дуги.
Наконец, о безызбыточности. Ты все время говорил, что вся информация о графе должна содержаться в ТЗ {Отец,Сын,Количество}, т.е. в перечне дуг графа. Если даже поиск циклов дает тебе перечень узлов - куда ты его денешь? У меня все ясно: помечу на удаление ошибочный элемент (или даже обнулю поле Количество) и продолжу работу. В конце концов, исходной задачей было разузлование, а не раскрашивание "дерева" из найденных в графе путей.

У тебя , Huse, Сергея - контроль зацикливания относительный (облегченный).
Отсюда и СУПЕРскорости . Если попытаться организовать такой надежный контроль в ваших алгоритмах - то всё.
Всему КОНЕЦ.
Конец скорости, конец надежности
(памяти клиента может и не хватить для хранения стольких строк(веток) графа).
Таков мой скромный прогноз.
Исправить сложные ошибки зацикливания - не так-то просто. У меня пользователь получит полную картину, где что лежит и что с чем связано. Вы граф не храните : у вас два элемента Е и Д НИЧЕГО не дадут пользователю и он полностью не увидит всю картину зацикливания. Т.е. функционал у меня в сто раз выше чем у тебя или Сергея .
Мало того , на больших объемах еще и обгоняет вас всех по скорости.
"Так вот я храню ВСЕ ветки 1-4. И по ним в любой момент могу построить ВЕСЬ граф на котором отображу ошибки для пользователя и он их быстро найдет."(с)
А если пользователей много? И они "в любой момент..."(с) ;-)
Игорь.
Ваш алгоритма не будет работать в "теме" СУБД.
Т.к. СУБД придумали не для удобства программиста писать запросы (отчеты).
А для обеспечения множества пользователей (алгоритмов) достоверной информацией из БД.
Ну не годятся "регистры накопления" для задач "разузлования". ;-)
В начале обработки , копируется из базы Справочник (ВЕСЬ!) СпецификацииНоменклатуры во временную таблицу "Спецификации". На время копирования можно блокировать Справочник от изменений (пример демо и этого не показано). В дальнейшем работа идет только с временной таблицей. И никакие пользователи не мешают.
Необходимость блокирования Справочника на время исполнения всей обработки в статье не рассматривается вовсе.
Это отдельная тема другого разговора. В статье рассматривается узкий вопрос "алгоритм разузлования", сопутствующие вопросы не рассматриваются вовсе.
1) "рассматривается узкий вопрос"(с)
Тогда уберите в свой статье фразы типа:
"На предприятиях ,осуществляющих сборку"(с)
"доходить в реальных задачах"(с)
"самый быстрый, надежный" (с)
"в статье идет речь не о "заточке" для тестов №1 и № 2, а об универсальной обработке"(с)
"достаточно для создания надежного и эффективного механизма "разузлования""(с)
"она более технологична и надежна"(с)
И т.д.
2) "В дальнейшем работа идет только с временной таблицей. И никакие пользователи не мешают."(с)
Ага. ;-)
Они просто работают с разными исходными данными. Один скопировал во временную таблицу. Работает. Другой пользователь уже "поработал" и начал менять исходную таблицу. А тут подоспел результат второго пользователя. И...
3) "Необходимость блокирования Справочника на время исполнения всей обработки в статье не рассматривается вовсе."(с)
Т.е. этой "необходимости" нетУ ??? ;-)
4) "Это отдельная тема другого разговора."(с)
Нет. Игорь. Эта не отдельная тема. Т.к. скорость выполнения алгоритма - это одна из многих характеристик алгоритма. И, далеко, не первая характеристика. Но любой алгоритм в "теме" многопользовательских СУБД ОБЯЗАН обеспечивать достоверность данных для ВСЕХ пользователей. Или "потребитель" системы будет решать задачу бесконечной "консолидации документов" даже в рамках ОДНОЙ подсистемы. И если "алгоритм" не обеспечивает требуемой достоверности, то это не алгоритм, а НЕЧТО. Но работает оооо-чень быстро. ;-)
5) "Попытаюсь объяснить"(с)
Игорь. Еще раз вынужден Вам ответить и на эту фразу.
Объясните ЭТО себе!!!
Александру, про "отладчик". ;-)
Две программы.
Первая загружает в справочник "дерево" с 1111111 вершинами, из теста #1 от Игоря.
Вторая выполняет обход дерева рекурсивным методом с анализом циклов ;-) и подсчетом количеств "изделий". Каждая программа выполнялась три раза. Система 1С 7.7 на DBF, локально, монопольно. Но, в конфигурации определено 1007 таблиц. И одинаковое дерево представлено трижды. По файлу 1Cv7.DD - таблица "ДеревоА" на 8-ом месте, "ДеревоБ" на 508-ом месте, "ДеревоВ" на 1007-ом месте. Остальные таблицы БД - пустые.
Времена загрузок "дерева":
ДеревоА 148 сек.
ДеревоБ 615 сек.
ДеревоВ 1083 сек.
Времена обходов "дерева":
ДеревоА 194 сек.
ДеревоБ 673 сек.
ДеревоВ 1136 сек.
А мы тут про "графины" разговариваем... :-(
P.S. В комплексной конфигурации многие "боевые" таблицы находятся в конце файла DD.
P.P.S. При проведении тестов вентилятор процессора ревел на полную мощность. ;-)

1. Допустим , обработка дошла до Б-В и говорит тебе человеческим голосом :
"Арчибальд , это зацикливание дальше нет смысла искать..
да и запутаться можем.. там сам черт ногу сломит !".
Ты как культурный человек и говоришь ей (тоже человеческим голосом) :
"Хорошо , родная , дальше не пойдем !"
И загрустил Арчибальд,так как увидел только одну ветку-обрубок : А-Б-В.
2. Допустим , обработка дошла до Б-В и говорит мне человеческим голосом :
"Ish_2 , это зацикливание дальше нет смысла искать..
да и запутаться можем.. там сам черт ногу сломит !".
Я ей говорю запросто :
"Молчи , дура ! Твоё дело искать ! "
И пошла она дальше , и нашла все ветки и принесла мне их.
Я и выбрал ,что и как показать на экране , а что не показывать.
Смотри ниже , что я увидел :
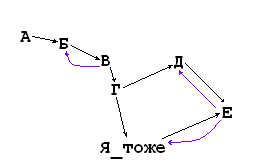

Нет , Арчибальд , не отпирайся !
Главный художественный смысл - робость перед обработкой передан верно.
А где ты оробел то ли в Б-В , то ли на кольце Г-Д-Е-Я_ТОЖе - это детали.
Теперь конкретно :
ТЫ не ПОСТРОИЛ КОЛЬЦО ! У тебя только 3 зацикленных элемента.
Ты не выдал все 4(четыре) зацикленных элемента.
Байка - верна.
Ты все время талдычишь, что я не сделал того или другого. Я утверждаю, что делать это мне здравый смысл не позволяет, ты же мне - забудь, мол про здравый смысл, делай как я сказал.
Вот цитируем тебя
2. Допустим , обработка дошла до Б-В и говорит мне человеческим голосом :
"Ish_2 , это зацикливание дальше нет смысла искать..
да и запутаться можем.. там сам черт ногу сломит !".
Я ей говорю запросто :
"Молчи , дура ! Твоё дело искать ! "
И пошла она дальше , и нашла все ветки и принесла мне их.
Займемся утверждением "и нашла все ветки и принесла мне их". Понятно, что оно ложно в части "ВСЕ". Не найдено бесконечное количество веток:
А-Б-В-Б-В
А-Б-В-Б-В-Б
А-Б-В-Б-В-Б-В
А-Б-В-Б-В-Б-В-Б
А-Б-В-Б-В-Б-В-Б-В
...
Обработка твоя может, конечно, сказать что-то типа "тут мы уже не первый раз ходим, зациклились" - но это уже будет элемент здравого смысла, т.е. вроде бы западло для тебя. Значит, должен сказать "молчи, дура, еще не все ветки построены".
Возьми, нарисуй свою картинку для гафа из 37 поста - и все понятно будет...
А еще лучше - вот для этой картинки отработай. Выдай пользователю 16 дуг, 9 вершин и 8 цепочек.

Ммм... ну, талдычу.
Это такой способ("наезд"), попытка сблизить наши здравые смыслы , э... предложение взаимопонимания.
Подтверждаю. Твоя обработка пройдет Б-В . Правда застрянет на кольце.
Сильно не придирайся к неточностям в байке.Она же - байка.
Ну, разумеется, не все. Ты очень , очень строг к художественной байке .
Конечно, речь идет о движениях по веткам до первого зацикливания.
И тогда всё становится понятно.

Приведенная картинка показывает, что дляграфа с одним циклом из двух узлов твой алгоритм находит три ошибки. Вполне очевидно, что такой алгоритм корректным считаться не может.

"Застревает" - это значит не проходит и не показывает все зацикленные элементы .
Напоминаю, зацикливание есть факт когда в графе один элемент и "родитель" и "ребенок".
Ты не все такие факты определяешь - значит, именно застреваешь.
Может , Арчибальд, может.
После прохождения обработки я имею таблицу со строковой колонкой "СтрокаКодов" и три записи в ней:
А-Б-В-Г-В
А-Б-В-Г-В
А-Б-В-Г-В
Только по этой таблице и надо ориентироваться. Подчеркиваю, по ней и только по ней.
Эта информация служит исходной для визуального построения дерева.
Из неё мы получаем :
Фактов зацикливания обнаружено 3.
Различных Элементов зацикливания - 1.
Как уж изобразить это на экране - это мой вопрос. Как хочу так и рисую.
Что нужно показать пользователю ?
Если факты зацикливания, то с этой точки зрения картинка правильная.
Если максимально сжатое изображение то

Напоминаю, зацикливание есть факт когда в графе один элемент и "родитель" и "ребенок".
Ты не все такие факты определяешь - значит, именно застреваешь.
Ну, а все цепочки предков, приводящие к отцу незаконного ребенка, остаются при этом вполне легитимными - соответственно, в перечень ошибок попадать не должны.
Тест № 1А. "Десять+ошибка"
Справочник "СпецификацииНоменклатуры" содержит 6-уровневый 10-арный граф , имеющий 1 000 000 различных ветвей и при обходе такого графа таблица ВремТаблица6 на выходе цикла алгоритма содержит 1 000 000 записей. Но сам справочник "СпецификацииНоменклатуры" в своей табличной части содержит лишь 60 записей.
Проще говоря , корневому элементу подчинены 10 элементов, каждому из которых подчинен одинаковый набор из десятка следующих элементов и т.д.
"+ошибка" - это еще одна дуга, ведущая с 6-го уровня на 1-й
Ну и результаты сообщить, конечно. Мои прилагаю.
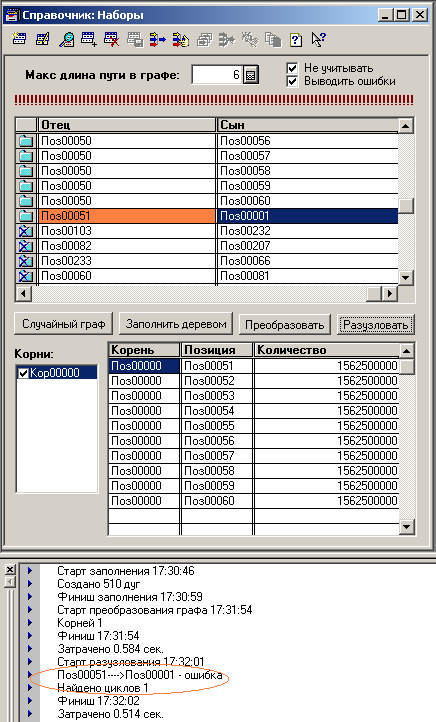
Предки , дети , зациленности...
Я собираюсь доказать , что слово "застревает" здесь самое точное.
Это значит , что если твой алгоритм не показывает все связи для графа (68) ,
то слово "застревает" - здесь самое точное !
Действительно , Дано :
есть граф (68) описан нами на рисунке и в табличной форме.
Ничего запретного в нем - НЕТ. Он вполне реален.
Теперь мы говорим обработке - обойди его , мы хотим его увидеть.
А твоя обработка говорит :
Не-А. Дальше кольца я не пойду , не хоцца - там сложности!
Что имеем ? Имеем Реальный граф - и имеем обработку, которая его полностью
не обойдет и не покажет нам его !
А зачем нам такая обработка , Арчибальд? Какой в ней прок ?
Это покажу , это не покажу...
Обработка должна обойти весь граф , зафиксировать все зацикленности.
А что делать , с этой информацией , как её интерпретировать - это не ёё ума дело !
Поэтому фраза из байки "Молчи , дура ! Твоё дело - искать !" - более чем оправдана.
И сама байка (60) несет в себе четкий , неискажающий сути проблемы смысл.
Т.е. у меня алгоритм "прёт во все щели" - он не интеллектуальный.
И в этом его сила. Нашлась связь - зацикливания нет - значит можно "переть" дальше.
Поэтому он и обходит больше ветвей , чем твой.
Вопрос для твоего алгоритма , появились новые ветки в графе- какие из них определит твой алгоритм :
Просьба по "буквам" показать путь прохождения твоего алгоритма , как идет движение и где стопорится.

Итак, А=0,Б=1,В=2,Г=3,Д=4,Я_тоже=5,Е=6,Ж=7,З=8,И=9,К=10 (в смысле, Поз00010 на скрине).
По шагам (вызовам следующего уровня): слева список предков, справа - дуги-дети
1. (0)(0-1)
2. (0,1)(1-2)
3. (0,1,2)(2-3)
4. (0,1,2,3)(3-4)(3-5) детей теперь двое, так что шаг в две строчки будет
5. (0,1,2,3,4) (4-6)
(0,1,2,3,5) (5-6)(5-9) В этом поколении уже трое детей
6. (0,1,2,3,4,6) (6-4)(6-5)(6-7)
Фиксируем ошибочную дугу (6-4)и разрываем ее
(0,1,2,3,5,6) (6-7)(6-5) Дуги (6-4) уже нет!
Фиксируем ошибочную дугу (6-5) и разрываем ее.
Свертывем предков 7-го в один список (0,1,2,3,4,5,6,7)
(0,1,2,3,5,9) (9-10)
7. (0,1,2,3,4,5,6,7) (7-8)
(0,1,2,3,5,9,10)
8. (0,1,2,3,5,6,7,8)
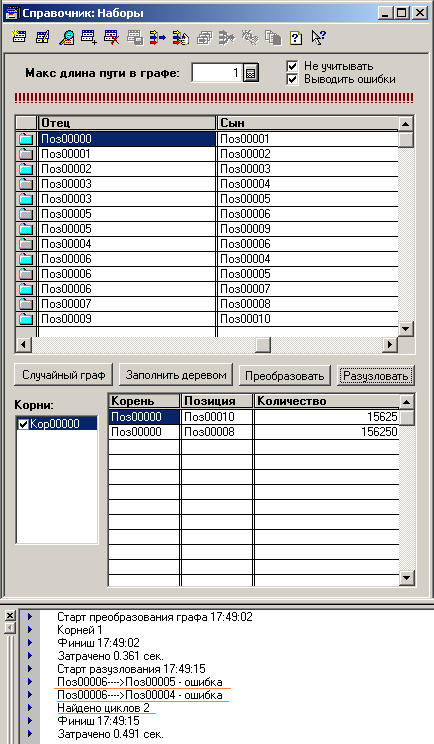
Желаю успехов разорвать, наконец, все ошибочные связи в рассуждениях Игоря.
Хотя у нас похожие подходы и выводы, возможно, мое понимание проблемы чем-то Вам поможет.
1. Игорь ошибочно считает, что контроль зацикленности - это перечисление всех циклов. Поскольку множество циклов - подмножество путей,
то задача оказывается NP-полной. Вы, как и я, понимете, что Заказчика интересует не миллион циклов, а неупорядоченное множество вероятно-ошибочных дуг,
которые нужно перечислить и дать на проверку оператору. Эта задача гораздо проще - в наихудшем случае сплошной зацикленности будет выдан полный список дуг,
существенно (слабо сказано!) более короткий, чем полный список путей. Также как если бы в IQ-тесте человека спрашивали: какая цифра в перечне кажется лишней,
а он отвечал бы перечнем чисел, содержащих ошибочные цифры!
Вроде бы все просто, да не очень! Есть пример, из-за которого Игорь "не доезжает".
Есть ациклический орграф (гамак): А->В, А->Г, Б->В, Б->Г, В->Д, В->Е, Г->Д, Г->Е. Если зациклить его дугой Е->Б, то Ваша обработка выдаст (и исключит) дуги Б->В, Г->Е (могу ошибиться).
Этот список не содержит действительно ошибочной дуги: Е->Б! Простой выход здесь в том, чтобы при обнаружении цикла в Вашем (и моем) алгоритме включить в
список подозрительных все дуги обнаруженного цикла, даже, если они окажутся потом лишними. Это не скажется на быстродействии и, возможно, будет последним аргументом
в пользу кодинга!
Я (в своем алгоритме) не спешу этого делать и вот почему: это не моя задача и не мой Заказчик. Для своего Заказчика я бы разработал специальный алгоритм, который позволил
бы указать место ошибки с максимальной точностью (найти минимальный разрез, делающие граф ациклическим). Идею этого алгоритма я изложил в теме Игоря (пост #177).
Сейчас не могу сказать, но, возможно, есть и более простой метод.
2. Мне кажется, что Игорь нечетко разделяет понятия графа и дерева. Для него граф - это такое компактное (и неудобное) представление дерева, вроде формулы
или теста для проверки "настоящих", "боевых" графов - деревьев. Хотя в жизни (но не в программах!) деревья встречаются гораздо реже. Видимо, занятия программированием,
анализ таких структур как справочники, интерпретация вложенных циклов, левого соединения в запросах, дали ему такое искаженное представление действительности. Из-за этого
он и проверяет свою и наши обработки прежде всего на деревьях, в результате чего результаты сравнения оказываются необъективными.
Сергей.
Извините, вмешаюсь.
Вы пишите: "Игорь ошибочно считает, что контроль зацикленности - это перечисление всех циклов."(с) А я думаю, что Игорь ошибочно считает, что "контроль зацикленности"(с) является самой важной составляющей в обсуждаемых алгоритмах. Т.к. слово "цикл" - это единственный термин объединяющий обсуждаемые (разные!!!) задачи, проблемы, решения...
Игорь, в моём понимании, поставил вопрос - как обойти дерево минимальным количеством запросов и перенести хоть что-то из дополнительных (надуманных) действий с узлами дерева, на сервер. Обязательно - дерево! Обязательно - запросами! Обязательно - на сервер!
Больше Игоря ничего не интересует. Печально... И, чего мы обсуждаем?
Скачал последнюю сегодня, но она отличается от старой которая была у меня.
Ведь мы же спорим именно о твоей текущей конфигурации.
Всё-таки лучше было меня явно предупредить о всех изменениях в твоей конфигурации с момента публикации.
На всякий случай,
сразу после опубликования я в свой файл обработки одно изменение Добавил колонку "Количество" на панели Спецификации.
Убрал лишнюю строку НачДата = Текущаядата(); И всё!
Как только началось тестирование в моей теме мой файл обработки неизменен как скала.
Алгоритм у меня не менялся вовсе с момента публикации.
Все мои утверждения о своей обработке касались именно этого неизменного алгоритма,
к тому же опубликованного основном тексте темы.
Если бы пришлось внести в него какие-то изменения - я бы обязательно объявил об этом всем собеседникам.
(76) У меня нашлись бы дуги Б-В и Б-Г. ;) А подход у нас, естественно, похож, только я ищу не минимальный корректирующий разрез, а строю максимальное по количеству поколений семейство потомков выбранного предка. Да к тому же, позволяю выбирать в качестве "патриархов" только тех, кто предков не имеет. Таким образом, при появлении в Вашем примере дуги Е-Б я увижу, кроме появления двух ошибочных дуг, еще одно событие: исчезновение узла Б из списка патриархов.
ты должен показать другому тест на своей обработке:
ВОТ ОНО ! СДЕЛАЙ КАК У МЕНЯ !
Как я проверю правильность создания хотя бы одной ветки в твоём тесте 10-10-10-10-10-10..., интерактивно ?
Как внесу туда нужную ошибку ?
У меня это делается так : последовательно открываешь нужную ветку и видишь какие там элементы и сколько их ? Интерактивно открываешь часть графа (спецификацию) и правишь её .
То есть я не требую от тебя такого чего нет у меня самого.
Еще и еще раз повторяю если хочешь меряться - создай удобный интерфейс проверки твоей обработки.
Без этого ты можешь утверждать что угодно - НИКТО В ТВОЙ КОД проверять не полезет.
Покажи мне картинку (твое дерево) для графа из 83-го поста. Я не требую от тебя ничего такого, чего у тебя, по твоим утверждениям, нет. Я даже не буду выяснять, как ты строил картинку. Короче, сделай хоть что-нибудь помимо безответственного трепа.

После запуска разузлования - тут же проверю у себя правильно ли сформировался Граф ошибок .
См.ниже
Заметь : пользователь имеет не обрубок какой- то ветки а ВЕСЬ ГРАФ , т.е. информацию удобную для анализа.
И тут же можно исправить ошибку или внести новую.
Задача была не в создании доп. интерфейса работы со справочником, а в разузловании. Эта задача на твоих тестах у меня решается на порядок быстрее, чем у тебя. А отобразить заодно "дерево разузлования" - это вообще смехотворное дополнение.
Для меня - это прежде всего технологичное функциональное решение - рабочее место для человека , занимающегося спецификациями в реальной конфигурации, например БП 2.0. Первое требование - здесь простота и надежность контроля и доп.функционал.
Для тебя же - это прежде всего решалка тестов №1 и №2, а доп.функционал - это так для галочки.
Пожалуй при такой разнице в подходах - сравнительный анализ и правда невозможен.
Первое требование всегда - работоспособность. Именно в этом разница в подходах заключается. У тебя же все технологично (правда, без ответа на вопрос из 83 поста), но на реальном небольшом графе с 511 дугами не работает.
Без твоего сообщения о результатах теста 1А я вынужден констатировать, что твоя обработка, возможно, способна отловить ошибки на графе с десятком дуг, но в боевых условиях непригодна.
Он с легкостью нажмет две кнопки и получит результат. Он у меня равен 19 сек.
Но нужно добавить.
Во временной таблице после окончания работы "разузлования" у меня хранятся ВСЕ ошибочные ветки.
Но Количество ошибок выдаваемых пользователю на монитор у меня ограничено - 100 ошибок.
Безболезненно можно увеличить до 1 000 шт. Только зачем ?

Дело в том , что перед публикацией я вдоволь поигрался с зацикливаниями.
Оптимизируя алгоритм и пытаясь уйти от тупого "раскладывания" графа на элементарные ветки (дерево) я приходил только к одному : ловил сам себя на зацикливаниях. Т.е. на каждый хитрый алгоритм всегда находилось зацикливание еще хитрее. Любые ускорения , свертывания промежуточных таблиц и т.д. приводили к одному к потере какой-то информации о графе - отсюда к ошибке контроля зцикливания.
Поэтому и пришел к выводу : гарантированный контроль зацикливания обеспечивает только раскладывание графа в дерево. Другими словами , на любом шаге(уровне) мы должны хранить ВСЮ, пусть даже избыточную, информацию о пройденном графе , т.е. в любой момент восстановить(отобразить) ВЕСЬ пройденный граф. Если это условие не соблюдается - жди ловушки с зацикливанием.
Вот что такое АБСОЛЮТНЫЙ контроль - хранение всей информации о пройденном графе в виде совокупности элементарных веток. Т.е. для контроля зацикленности необходимо хранение ИЗБЫТОЧНОЙ информации о графе.
Абсолютный ли у тебя контроль проверяется очень просто : должен быть удобный интерфейс для имитации зацикливаний. 3-4 сложных, глубоких зацикливаний и всё понятно.
Избыточность же информации может оказаться полезной. Но прикинь, в тесте №3 ты, ограничиваясь сотней сообщений, выдаешь только 1% найденных циклов.
Я уж не впоминаю о том, что сам же ты на меня нападал за то, что кроме перечня дуг я "избыточно" строю и пользуюсь перечнем родителей с детьми.
Правильно ли я понял из твоего кода ,в случае , когда мы находимся в "Узле":
А1 - В1 - С
                 \
                   Узел   - В1
                 /
А2 - В2 - С
Прошли "Узел" , для которого храним свернутый список предков (А1,А2,В1,В2,С) , проверяем "В1" на совпадение с любым значением из этого списка , выдаем ошибочную дугу "Узел-В1" . Так ?
Вот для чего хранится избыточная информация !
Есть ли тут еще какое зло - нужно подумать.
При поверхностом взгляде навскидку - вроде бы никаких ошибок при определении зацикливания при твоем подходе может и не быть.
Но пока скажи другое .
Ведь всё , что ты сделал можно запросто реализовать на 1с8 и рассмотреть в качестве альтернативного решения.
Так вот.
Ты привел сведения , что твой алгоритм показал менее секунды (!) в миллионном тесте №1 1-10-10-10-10-10-10 с повторениями элементов.
С другой стороны, твой алгоритм показал 10 мин(!!) в миллионном тесте №1 1-10-10-10-10-10-10 без повторений,
т.е с уникальными элементами.
Не в твоём ли контроле зацикливания причина такого падения ?
То есть когда различных элементов мало - то всё сворачивается, размер списков ничтожно мал - всё летает.
Но если элементы не повторяются , ничего не сворачивается - то жестокие "тормоза".
Возможны ли в твоем алгоритме такие изменения которые принципиально, на порядок уменьшат
катастрофические 10мин , скажем до 1мин ?
Согласен ли ты с формулировкой :
Ish_2 не удалось доказать слабость контроля зацикливания обработки Арчибальда.
Художественный смысл байки (60) и другие утверждения Ish_2 повисли в воздухе.
Из-за отсутствия независимого тестирования не нашел подверждения
и главный тезис Арчибальда "Мой контроль - абсолютен !".
Я должен в своей статье рассказать, чем закончилась последняя шутка автора.
Я должен согласовать с тобой формулировку.
Ты принял только 1 предложение. Хм... это понятно.
Второе убираем.
А чем плохо 3 предложение ? Я ничего не соврал.
Если останется только 1 предложение - мы исказим истину.
Соглашайся на 1 и 3 предложения . Идет ?
Таким образом, "отсутствие независимого тестирования" может ставить под сомнение только правильность реализации мной указанного алгоритма, но никак не тезиса об абсолютности.
Горького и ехидного в адрес Арчибальда и его обработки сказано немало.
Очевидны и неисправимые недостатки его обработки графа.
Но только Арчибальд в своей теме показал очевидное преимущество отказа от рекурсии и последовательного поуровневого обхода графа.
Это - возможность разузловывать не одну номенклатуру , а одновременно сразу несколько номенклатур (список).
Задача эта актуальна, например , при формировании плана закупок , когда нужно получить список комплектующих для некоторого состава номенклатур.
То есть подход с поуровневым обходом графа , примененный в обработке Арчибальда, содержит в себе
серьезный запас по функционалу.
ТекСписок=СоздатьОбъект("СписокЗначений");
Корень=СЗ_Подграфы.ПолучитьЗначение(ё);
лСписок = СоздатьОбъект("СписокЗначений");
лСписок.ДобавитьЗначение(Корень,Формат(1,"Ч(0)10"));
ТекСписок.ДобавитьЗначение(лСписок);
Уровень = 0;
Пока ТекСписок.РазмерСписка()<>0 Цикл
СледСписок = УдлиннитьЦепи(ТекСписок);
СледСписок.Выгрузить(ТекСписок);
КонецЦикла;
Но ведь можно и так определить функцию
Функция Ярус(СписокКорнейСПредками)
Рез = УдлиннитьЦепи(СписокКорнейСПредками);
Возврат ?(Рез.РазмерСписка() = 0, "", Ярус(Рез));
КонецФункции
и написать
ТекСписок=СоздатьОбъект("СписокЗначений");
Корень=СЗ_Подграфы.ПолучитьЗначение(ё);
лСписок = СоздатьОбъект("СписокЗначений");
лСписок.ДобавитьЗначение(Корень,Формат(1,"Ч(0)10"));
ТекСписок.ДобавитьЗначение(лСписок);
Уровень = 0;
ТекСписок = Ярус(ТекСписок);
Рекурсия голимая.
Результат выполнения теста №1 в рекурсивном варианте ниже
Я исхожу не из твоих пробных предположений , а из факта :
Ты отказался от рекурсии (как вычислительного приема) в своей обработке.
Из этого факта я сделал вывод : при поуровневом обходе графа рекурсия избыточна.
Хотя и возможна.
Обойдясь без рекурсии - ты уже всё доказал.
Я битый час сейчас наблюдал по диспетчеру задач за разузлованием "миллионников" на явной рекурсии и на цикле. Сначала рекурсия вела себя лучше (быстрее). Потом в "циклическом" варианте я заменил
СледСписок = УдлиннитьЦепи(ТекСписок);
СледСписок.Выгрузить(ТекСписок);на
ТекСписок = УдлиннитьЦепи(ТекСписок); и уложился в 5.2 минуты вместо 10 (на рекурсии - 8 мин). Я так понимаю, основное время затрачивается на выделение/освобождение памяти, так что одновременное присутствие двух длинных списков - это плохо.
Еще обна "фишка" обнаружилась. Под рекурсию памяти выделялось процентов на 5 больше, чем под цикл, однако процессор нагружался всего на 50-70% (для цикла - не менее 95). Вот как-то так.
Ты же ищешь все цепочки максимальной длины. Для этой задачи рекурсия, скорее, вредна. Лучше будет обходить "в глубину", специальным образом фиксируя пройденные цепочки. Цикл. Но не "в ширину", как у тебя.
- поярусно , в ширину (получаем минимальное количество обращений к БД, т.е. за одно обращение к таблицам - взять как можно больше данных).
С другой стороны , промежуточная таблица с колонками СтрокаКодов(у тебя СписокПредков), Номенклатура( у тебя Узел) может содержать миллион записей и лишь 2-3 из них продолжают иметь "детей" - но я вынужден копировать эту таблицу полностью в другую для следующего цикла. В этом - слабость опубликованного алгоритма.
В графах 1-10-10-10-10-10-10 или 1-2-2-2-2... этого не заметно.
Но если на 5 уровне было 1 миллион узлов ( в таблице миллион записей) , на 6 уровне 3 узла , на 7 - 6, на 8 -12 , то у меня на 6,7,8 уровнях будет каждый раз копироваться вся миллионная таблица.
Бороться , конечно, с этим можно . Но я решил не усложнять опубликованный алгоритм.
Сделать это при реальном внедрении , конечно, необходимо.
Меня недавно "убили" реальным примером : в графе 600 тыс.узлов , уровней "вообще-то" 20 , но одна цепочка имеет длину 67(!!). И вот мой алгоритм с 20 по 67 уровень 47 раз копирует таблицу из 600 тыс. записей.
Рекурсия и ручной кодинг была отброшены сразу в самом вначале без всяких прикидок.
Затем всего лишь из принципа были простейшие прикидки для кодинга.
На "реальном" примере в 600 тыс. узлов и 67 уровней алгоритм не запускался. Сам "реальный" пример мне недоступен.
"И вот мой алгоритм.." - описана гипотетическая ситуация.Результат настолько ясен, что и никаких испытаний не требуется.
С самого начала была создан Справочник СпецификацииНоменклатуры по Тесту №1 1-10-10... с уникальными узлами.
На нём и шла отладка. В конце работы пришлось создать Тесты №1,№2 с повторяющимися элементами. Сделано это было только для удобства пользователя. Ждать создания справочника с уникальными узлами слишком долго.
Ведь ,с моей точки зрения, никакой раницы , между ними нет. Алгоритм "тупой" и никак не вычисляет повторяемость элементов.
Возможно , кого-то эти тесты здорово сбили с толку.
Я заранее знал , что с уникальными элементами и правильным контролем зацикливания рухнет по быстродействию "любой кодинг" на 77, как у Арчибальда и Владимира, или на 8 как у Хьюза.
Если алгоритм не рухнул - значит облегченный контроль зацикливания. Здесь все просто ловится.
Если реализовать абсолютный контроль как у Арчибальда каждый узел хранит всех своих предков - то любому алгоритму конец.
Если же "вручную" организовать еще и функционал ( выдается не список ош.дуг, а граф ошибок)- то конец втройне.
"... с уникальными элементами и правильным контролем зацикливания рухнет по быстродействию "любой кодинг" на 77, как у Арчибальда и Владимира..."(с)
Игорь.
Ну, хватит врать!!!
Полный обход дерева (любого!!!) из 1111111 узлов за минуту (на Си) и за три минуты (на 1С 7.7) - это "рухнуть"(с) ?
Контроль "циклов" - полный. Алгоритм позволяет, действительно, интерактивно исправить ошибки в дереве в многопользовательском режиме. Никакого накопления ошибок не требуется т.к. находится очередной "цикл", пользователь вносит исправления и программа продолжает работать. И это достигается из-за полного отказа от запросной технологии. Запросов вместо рекурсии или запрос вместе с рекурсией (циклом) - не имеет значения.
Не в "рекурсии" проблема... ;-)
Ваши показатели я уже знаю - мы всё давно выяснили с Вами. Арчибальд со своим "графином" тут ни при чём.
Про 77 или 8 - мне неинтересно.
Языком молоть - не мешки ворочать.
А Вы докажите.
Создайте тему - покажите ваши результаты. Сделайте сравнительный анализ.
Без этого ,Владимир,
все Ваши рассуждения и размышлизмы - набор символов.
До редактирования Вашего сообщения было написано:
""рухнуть" - означает... Что Вас так задело ?"(с)
Отвечаю на это.
Игорь.
Огромная к Вам просьба - читайте целиком сообщения собеседников.
Меня ничего не задело в слове "рухнуло".
Меня "задевает" Ваш "конкретизм" видеть задачу - "писать запросы"(ПЗ) полностью игнорирую реальную задачу. И пытаться доказывать (утверждать) своё желание ПЗ путем вранья и "опускания" собеседников.
Теперь отвечу на Вашу фразу "Языком молоть - не мешки ворочать."(с).
Вы читали, пытались понять, задавали вопросы и т.д. по моим публикация на данном ресурсе? Я Вам, лично, не представлял тексты программы, замеры, анализ по теме "запросы"? Вы ничего не поняли? Спрашивайте...
Ну, и про "все Ваши рассуждения и размышлизмы - набор символов"(с).
Игорь. Попытайтесь из "набора символов"(с) складывать слова, фразы, утверждения, мысли и т.д. Иногда это помогает. ;-)
Последнее.
Игорь, Ваше стремление ПЗ это, на самом деле, желание получить халяву (волшебную палочку). И когда у Вас этого не получается Вас это очень сердит. Но Ваши оппоненты в этом не виноваты. Не стоит на них срывать свою злость (разочарование).
P.S. Еще раз прошу прощение у Автора темы (публикации).
Все участники дискуссии - представили свои реальные разработки.
Вы представили - длинные размышлизмы вперемешку с какими-то "цифирьками".
Почувствуйте разницу.
Публиковать свою обработку Вы не желаете.Доказывать ничего не хотите.
Желаете делиться размышлизмами: то, да сё..
Поэтому фраза "Языком молоть - не мешки ворочать" , употребленная мной, более чем оправдана.
Игорь.
Вы опять читаете отдельные буквы в моих сообщениях. :-(
Я не желаю публиковать свою "разработку", т.к. не существует таких задач которые Вы поставили в очередной публикации цикла "Мы пишем з...". Но, я всю информацию и своё мнение Вам выдал, еще до появления Вашей публикации.
Завяжем. Вы во всём правы. Пишите запросы дальше...
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 78737
Создание 26.11.10 16:18
Обновление 29.11.10 10:25
Просмотры 25047
Загрузки 45
Рейтинг
19
Комментарии 129
Код открыт Не указано
Рубрики Математика и алгоритмы
Кому Разработчик
Тип файла Конфигурация (md, cf)
Платформа 1С:Предприятие 7.7
Конфигурация 1C77
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Абонемент ($m)