Для отправки сообщения требуется
регистрация/авторизация
Дарим подарки и запись вебинара и напоминаем: курс «DevOps-инженер по 1С» стартует уже в понедельник!
Дарим подарки и запись вебинара и напоминаем: курс «DevOps-инженер по 1С» стартует уже в понедельник!
Пропустили один из самых популярных вебинаров года? Запись, презентация и дополнительные материалы доступны бесплатно – скачивайте и изучайте в удобное время. И присоединяйтесь к курсу «DevOps-инженер по 1С» – начинаем 20 октября!
Запись вебинара уже доступна
14 октября состоялся вебинар «Современный процесс разработки на 1С: как устроена разработка и CI/CD в Инфостарт Лаборатории». Он стал, пожалуй, самым посещаемым в этом году: более 1000 регистраций, порядка 500 слушателей присутствовали онлайн.
Если вы пропустили эфир или хотите пересмотреть его еще раз – предлагаем бесплатную запись вебинара, презентацию и эксклюзивные материалы. Забрать их вы можете по кнопке ниже. Изучайте и делитесь с коллегами!
В подарок – эксклюзивные материалы
Мы дарим вам два урока из нашего курса повышения квалификации «DevOps-инженер по 1С». Оцените качество и содержание уроков на практике, прежде чем принять решение об обучении.
Урок 1: Установка и настройка «Prometheus 1C exporter»
Урок 2: Настройка проверки АПК
А еще наша ИТ-Лаборатория подготовила документ «Базовые технические требования к DevOps-инфраструктуре разработки на 1С». Делимся им в нашем Телеграм-канале – не забудьте подписаться!
Старт курса – уже в понедельник
Приглашаем вас на курс повышения квалификации «DevOps-инженер по 1С», который стартует в понедельник, 20 октября.
Для всех зрителей вебинара действует специальная скидка 10% по промокоду dev10.
Выберите свой тариф
ТАРИФ «СТАРТ»
- Онлайн-встречи и закрытый Telegram-чат с преподавателем;
- Доступ к материалам после окончания – 90 дней;
- Подарки: митапы «Путь к идеальному коду» и «DevOps в 1С: CI/CD».
Цена со скидкой: 58 500 рублей (вместо 65 000).
ТАРИФ «СТАНДАРТ»
Все из «СТАРТ», плюс:
- Проверка домашних заданий и обратная связь;
- Удостоверение о повышении квалификации;
- Бесплатный доступ к видеозаписям секции Devops конференции.
Цена со скидкой: 78 300 рублей (вместо 87 000).
ТАРИФ «VIP»
Все из «СТАРТ» и «СТАНДАРТ», плюс:
- Индивидуальная консультация с авторами курса (2 часа);
- Материалы из курса «Автоматизированное тестирование в 1С».;
- Скидка 10% на одну услугу ИТ-лаборатории (DevOps аудит, внедрение, корпоративное обучение).
Цена со скидкой: 99 000 рублей (вместо 110 000).
Выбрать тарифОтветы на вопросы с вебинара
Есть ли у вас планы переходить на импортозамещенные решения от российских вендоров?
– Мы рассматривали различные российские решения, в частности, взаимодействовали с GitFlic. На данный момент продолжаем использовать GitLab Community Edition, развернутый в нашем закрытом контуре без доступа к интернету, так как он полностью нас устраивает. Тем не менее, мы следим за развитием отечественных аналогов, таких как GitFlic и GitVerse, чтобы быть в курсе тенденций.
В настоящее время у нас нет конкретных планов по переходу с GitLab. Но основным кандидатом на переход, если такая необходимость возникнет, является GitFlic благодаря наличию «коробочной» (on-premise) версии, совместимости CI/CD с GitLab и реализованной в нем поддержке пакетного менеджера OPM для пакетов OneScript.
Вы сказали, что проверяете комментарии в Хранилище на заполненность и запрещаете отправку пустого комментария. Как это реализовано? Есть ли возможность проверки до помещения изменений в хранилище в определенном формате?
– Для проверки комментариев перед помещением изменений в хранилище мы используем инструмент oproxy. Это приложение, написанное на OneScript, которое встраивается как прокси-сервер между конфигуратором разработчика и сервером хранилища.
Oproxy позволяет реализовывать триггеры (обработчики) на события взаимодействия Конфигуратора с Хранилищем и выполнять произвольные алгоритмы в этот момент, в том числе, скрипты проверки сообщений к коммитам.
Скрипты-обработчики пишутся на OneScript – это бесплатная, свободная реализация языка 1С, и любой 1С-разработчик сможет написать такой скрипт. С помощью скриптов можно реализовать различные проверки, например:
- обязательное наличие в комментарии ссылки на задачу (тикет);
- соответствие комментария определенному формату;
- запуск CI/CD-пайплайна после успешного помещения.
Таким образом можно предотвратить коммиты с незаполненными или некорректно оформленными комментариями. Мы активно используем это решение уже достаточно длительное время на проекте доработки внутренней системы учета 1С:Комплексная автоматизация.
Почему вы еще используете схему «Конфигуратор + Хранилище + GIT»? Что мешает окончательно перейти на EDT и при этом забыть про gitsync?
– Мы продолжаем использовать схему «Конфигуратор + Хранилище + GIT» для «тяжелых» конфигураций, таких как УТ, КА и ERP. Основная причина — производительность. Работа с большими конфигурациями напрямую через Git и EDT может быть медленной.
Например, полная выгрузка исходников такой конфигурации может занимать до 40 минут и больше, особенно на не самом производительном оборудовании. Этот процесс может запускаться в неожиданные моменты (например, при добавлении нового объекта) и блокировать работу разработчика.
Хотя с каждой новой версией платформы и EDT производительность улучшается, для больших и критичных проектов мы предпочитаем эволюционный переход, чтобы не нарушать отлаженные процессы разработки.
У каждого разработчика свое хранилище или общее?
– Схему «Конфигуратор + Хранилище + GIT» мы используем на проекте доработки тяжелой конфигурации 1С:Комплексная автоматизация. В большинстве задач используется одно общее Хранилище и доработки разработчиков синхронизируются с веткой master.
Мы стараемся декомпозировать задачи так, чтобы их выполнение занимало не более одного рабочего дня. Для таких небольших задач изменения из общего Хранилища помещаются напрямую в ветку master в GIT. И в целом нас это устраивает.
Недостаток такого подхода: нельзя использовать стандартный процесс код-ревью в GitLab, т. к. нет запроса на слияние. Но у нас разработчики обязаны оставлять ссылку на задачу, по которой делается коммит. Мы это проверяем автоматически при помощи oproxy, и фиксация в Хранилище без ссылки не пройдет. Благодаря этому можно сделать отбор коммитов по задаче в списке коммитов и далее провести ревью в веб-интерфейсе, оставляя комментарии к строкам кода.
Для «долгоиграющих» задачи, с которыми неудобства становятся достаточно существенными, мы применяем «Технологию разветвленной разработки конфигураций» фирмы 1С, которая подробно описана на ИТС. В этом случае под задачу с помощью специального пайплайна (конвейера) GitLab создается отдельное временное Хранилище. Разработчик работает с ним, и изменения из этого хранилища синхронизируются в отдельную feature-ветку в GIT (например, task007). При таком подходе мы используем нормальные Merge Requests в GitLab.
Разработка в расширениях и внешних обработках всегда у нас ведется в отдельных ветках.
Разработка в команде уже ведется на EDT, ветки создаются в нем же, автотесты пока запускаются локально. Какой подход лучше использовать для хранения автотестов?
– Мы рекомендуем организовать единый Git-репозиторий, в котором будут храниться как исходный код конфигурации, так и файлы с автотестами (feature-файлы). Даже если автотесты пока запускаются только локально, их исходники следует хранить в общем репозитории.
Хранение тестов рядом с кодом проекта позволяет избежать рассинхронизации между разработчиками и тестировщиками и предотвращает устаревание тестов. Такой подход упрощает настройку CI/CD-пайплайна и в целом соответствует идеологии Git, которая предполагает хранение всех артефактов проекта (кода, тестов, документации) в одном месте.
Почему вы используете множество расширений вместо того, чтобы создать какое-то одно основное, в котором сосредоточено более половины доработок?
– У нас нет такого «основного расширения». Вместо этого используется несколько крупных расширений для реализации уникальных, самодостаточных и независимых друг от друга подсистем, а также небольшие расширения для срочных исправлений (hotfix).
Некоторые расширения являются универсальными и применяются в нескольких внутренних информационных базах с разными конфигурациями (например, расширение для интеграции с BigQuery или для авторизации в 1С пользователей сайта по токенам). Кроме того, мы не объединяем все доработки в одно большое расширение из соображений надежности.
Если по какой-либо причине (например, из-за ошибки) одно большое расширение не применится в продуктивной среде, это приведет к отказу всей доработанной функциональности, и пострадают все пользователи. Такое может произойти даже из-за несущественной ошибки.
Если же что-то ломается в основной конфигурации, то чаще всего эта поломка будет влиять на ограниченное число функционала и пользователей. Т. е. разделение на несколько независимых расширений позволяет локализовать потенциальные сбои и снизить риски.
Разработчики ведут документацию? Если да, то на каком этапе и в каком инструменте?
– Да, разработчики ведут документацию. Она хранится в формате Markdown непосредственно в Git-репозитории проекта вместе с кодом и другими артефактами. Это позволяет держать всю информацию в едином месте:
- Техническая документация, связанная с разработкой, находится в репозиториях соответствующих конфигураций.
- Документация по API для интеграции с сайтом ведется в отдельном репозитории и автоматически собирается в виде HTML-справки.
- Инфраструктурная документация ведется аналитиками и IT-службой в Google Docs, а ссылки на нее размещаются в репозиториях.
Часть описаний может временно находиться в задачах (тикетах), а затем переноситься в основную документацию. Критически важные аспекты документируются сразу, остальные по мере необходимости. Также мы экспериментируем с использованием ИИ для автоматической генерации документации из видеозаписей и переписок.
Как вы решаете конфликты слияния форм?
– Основной способ решения проблемы конфликтов слияния форм – организационный. Мы стараемся не допускать одновременной работы нескольких разработчиков с одной и той же формой. Если необходимо дорабатывать типовые формы, изменения вносятся программно.
Если конфликт все же возникает при работе в EDT, для его разрешения используется встроенный инструмент сравнения и объединения. Он похож на стандартный механизм конфигуратора, но работает поверх Git и позволяет объединять изменения на уровне отдельных реквизитов и элементов формы.
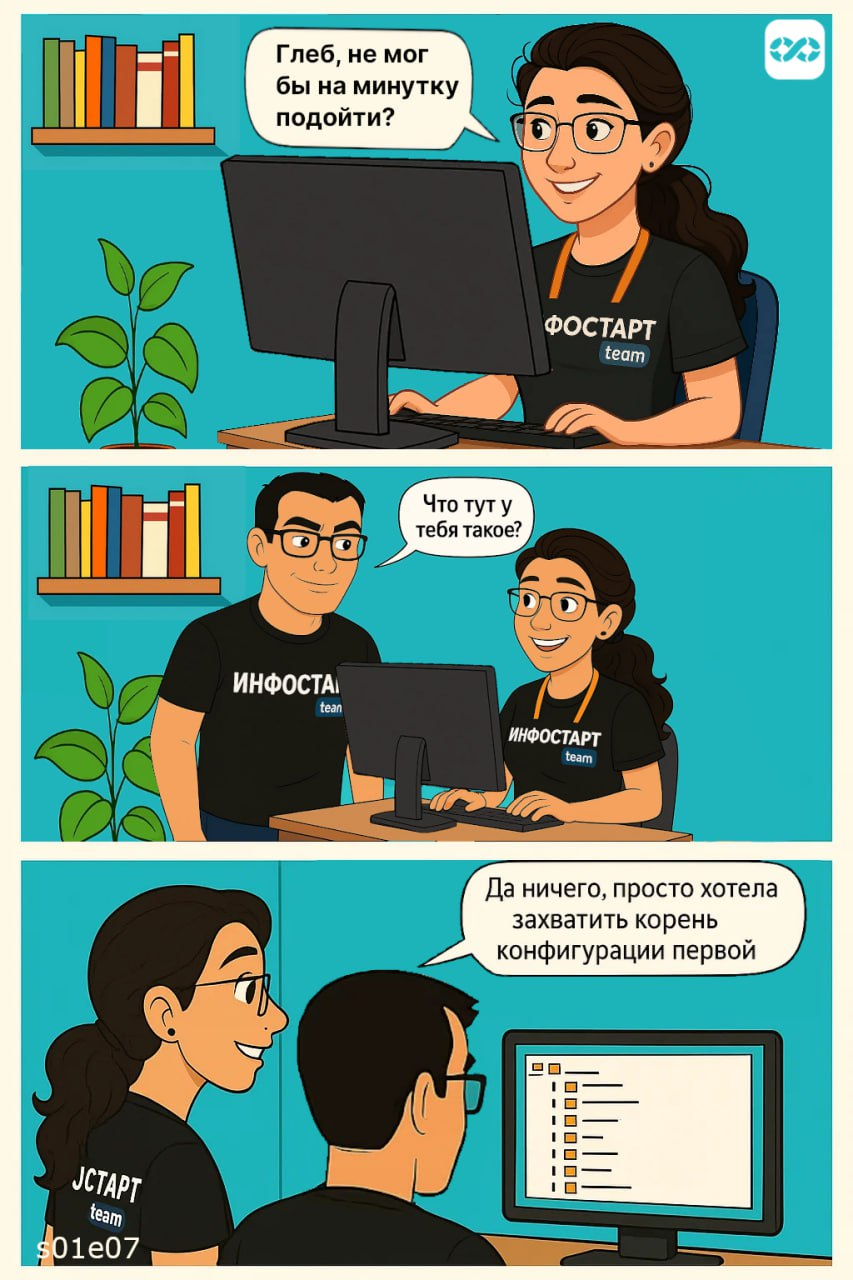
Схема «Хранилище + Git»: как вы решаете вопросы блокировки объектов в хранилище?
– Вопросы блокировки объектов в хранилище решаются организационно. Так как команда небольшая, разработчикам проще договариваться между собой. На эту тему у нас даже есть небольшой комикс (все совпадения НЕ случайны).
Код-ревью проводится до приемочного тестирования? А если функциональность некорректно запрограммирована?
– Да, по нашему процессу код-ревью проводится до приемочного тестирования для выявления проблем на ранних стадиях. По факту часто эти процессы идут параллельно: пока разработчики проводят ревью, аналитики уже могут проверять функциональность в специальной, автоматически обновляемой копии базы.
Код-ревью, в первую очередь, направлено на проверку качества кода, а не на полное тестирование функциональности. Ревьюер может визуально изучить код или загрузить исходники для локальной проверки, и даже запустить решение, чтобы проверить что-либо, но полноценное тестирование задачи на этом этапе не проводится.
Риск некорректной реализации функциональности снижается несколькими способами:
- Предварительное согласование: аналитик и разработчик согласовывают детали реализации до начала разработки;
- Опытная команда: в команде работают ведущие разработчики, которые способны самостоятельно анализировать и документировать требования.
- Автоматизация: значительная часть проверки выполняется автоматически с помощью инструментов SonarQube (с плагином bsl-ls-language-server) и CodeRabbit.ai, которые следят за стилем кода и выявляют потенциальные ошибки. Это позволяет разработчикам при ручном ревью сосредоточиться на логике.
- Кросс-ревью: практикуется перекрестное ревью, когда разработчик, не работавший с данным функционалом, проверяет код. Это обеспечивает свежий взгляд на задачу, способствует обмену знаниями и помогает выявить непонятные моменты в коде, которые следует задокументировать или переписать.
Как готовится шаблон с тестовыми данными для автоматизированного регрессионного тестирования? Подготовка данных производится каждый раз вручную?
– Используется смешанный подход. Часть сценарных тестов (feature-файлов) самостоятельно готовит необходимые для себя данные. Другая часть тестов, особенно для конфигураций с большим количеством легаси-кода, полагается на данные, содержащихся в тестовых копиях баз («эталонные базы»).
В новых и небольших конфигурациях каждый сценарный тест создает данные под себя. В юнит-тестах данные также подготавливаются непосредственно в коде самих тестов, при этом предполагается наличие в базе некоторых константных данных.
BDD-тесты уже работают в Linux?
– Да, фреймворк Vanessa Automation, который используется для BDD-тестов, уже давно работает в Linux. В Linux-окружении не функционируют только некоторые специфичные шаги, зависящие от Windows-технологий. Например, взаимодействие с UI через UIAutomation в Linux работать не будет.
Кто платит разработчику за юнит-тесты: клиент или компания? Включаются ли часы на создание тестов в общее время разработки?
– Взгляды и подходы могут различаться. В конечном счете за тесты платит тот, кто заинтересован в качестве продукта. Написание юнит-тестов – это такая же часть работы разработчика, как и написание основного кода, поэтому время, затраченное на создание тестов, должно включаться в общую оценку и стоимость разработки.
Если команда и компания придерживаются практик тестирования, то эти затраты являются неотъемлемой частью себестоимости разработки.
Как организовывать приемочное тестирование, если есть много фич, а инфобаза для тестирования одна? Если собирать ветку dev и загружать ее в базу для приемочного тестирования, то как из dev собирать релиз, чтобы туда не попали еще не принятые фичи?
– Это сложный организационный вопрос, и универсального ответа нет. Самый простой подход – «одна фича – одна тестовая база». Если это невозможно, собирать предварительную релизную ветку (pre-release) из готовых и протестированных фич и разворачивать ее на общей базе для приемочного тестирования. Однако этот процесс требует тщательной организации работы с ветками в Git, чтобы в релиз не попали незавершенные или не принятые доработки. Конкретный процесс зависит от специфики команды и проекта, и эти вопросы обсуждаются на курсе.
Будет ли в курсе обучение Vanessa ADD/Automation или это отдельный курс?
– Да, обучение Vanessa Automation входит в состав курса. Материал представлен в менее углубленном формате по сравнению со специализированным курсом по автоматизированному тестированию «Автоматизированное тестирование в 1С», но его достаточно для того, чтобы научиться писать базовые сценарии с нуля.
Слушатели VIP-тарифа дополнительно получают полный доступ к материалам курса «Автоматизированное тестирование в 1С» для более глубокого изучения темы.

Если вам удобнее смотреть новости в телеграме, то вот наша группа – ИНФОСТАРТ.
Автор:
Екатерина Баскакова
См. также
09.11.2026 1373 aduhovna 0
1
06.11.2026 2518 aduhovna 1
18
30.10.2026 1512 aduhovna 0
3
23.10.2026 1921 aduhovna 1
16
14.10.2026 3834 aduhovna 31
16