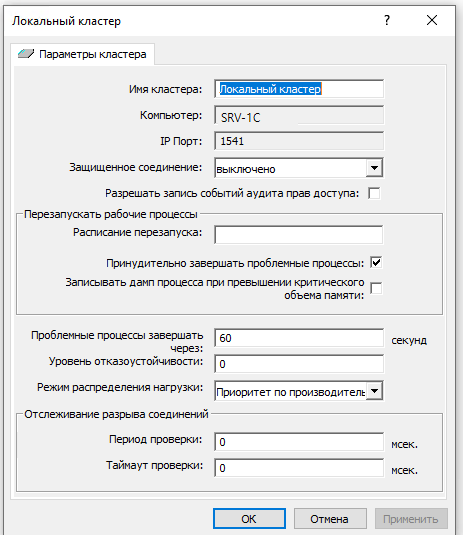
Кластер 1С настраивают один раз при установке, а дальше открывают консоль в тот день, когда что-то упало. К этому моменту половина полей остаётся в состоянии "как поставилось", и понять по ним, что именно грозит вашей базе, довольно трудно: консоль показывает числа, а не последствия.
Это вторая часть разбора. В первой я снимал настройки кода и показывал, чем оборачиваются дефолты, - "Кластер 1С работает на настройках по умолчанию". Здесь практика: как поднять сервер администрирования, если его нет, что вписывать в поля двух диалогов консоли и почему одно из них перестало быть числом. Всё снято на своём стенде, без имён баз и заказчиков.
Сначала RAS, иначе смотреть нечем
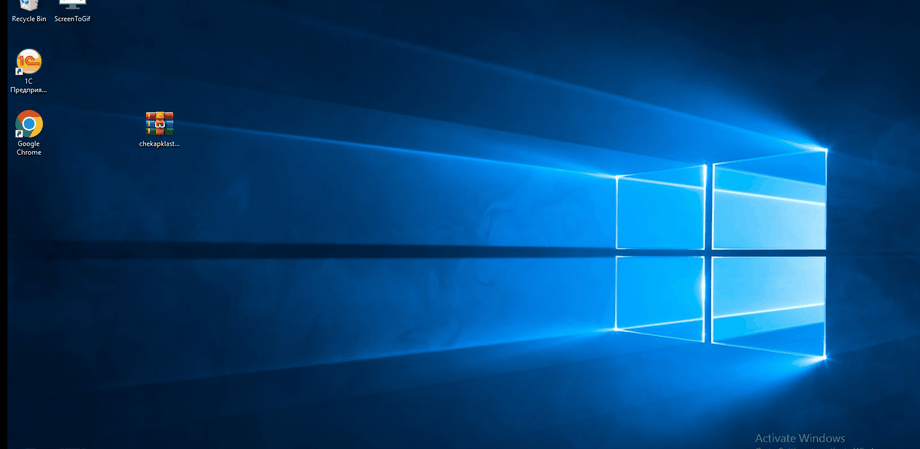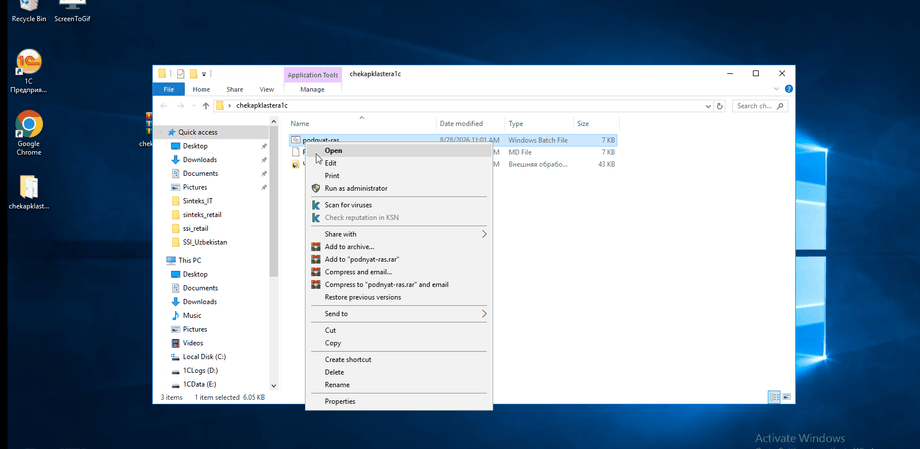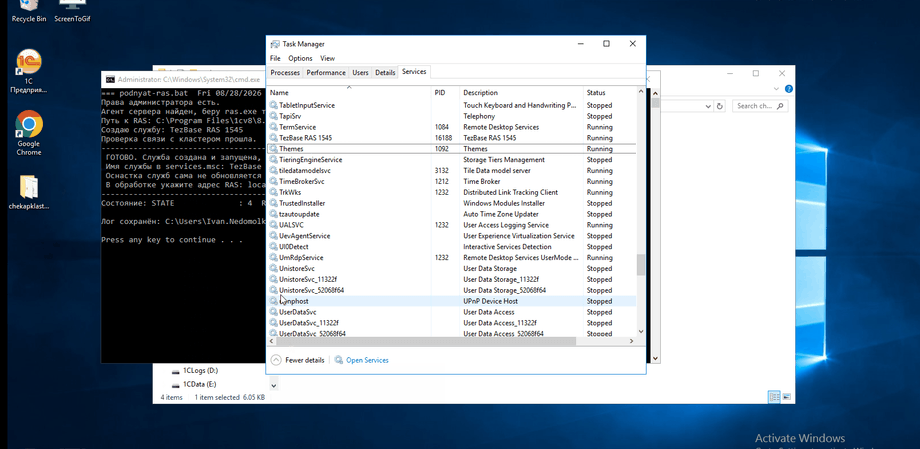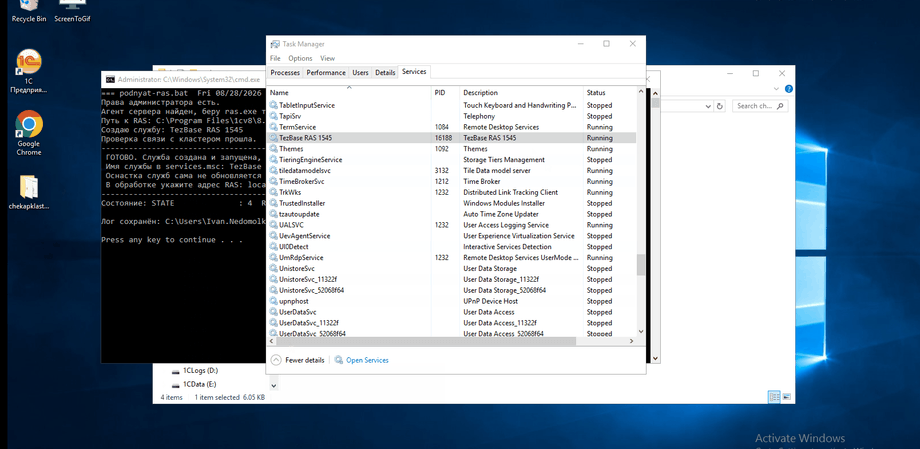
Всё, что ниже, читается и правится через сервер администрирования (RAS). Это отдельная служба, и установка платформы её не запускает: сервер 1С прекрасно живёт без неё годами, пока кто-нибудь не попробует подключиться консолью или кодом. Тогда приходит отказ соединения, и это не поломка, а просто отсутствующая служба.
Поднимается она одной командой на сервере 1С, от администратора:
sc.exe create "1C RAS 1545" binPath= "\"C:\Program Filescv8\8.3.27.1606in
as.exe\" cluster --service --port=1545 localhost:1540" start= auto
sc.exe start "1C RAS 1545"
Три вещи, на которых тут спотыкаются, и все три я собрал лично.
Первое: rac не заменяет RAS. Частый вопрос "зачем мне служба, у меня же есть rac.exe" построен на путанице. rac это консольный клиент, который сам ходит в RAS; без запущенной службы он так же бесполезен, как и код на встроенном языке.
Второе: версия RAS обязана совпадать с версией кластера. На сервере разработчика платформ обычно несколько. Если поднять RAS от самой свежей, служба стартует, порт слушает, в списке служб всё зелёное - а на первом обращении кластер отвечает "Различаются версии клиента и сервера" и называет обе. У меня на стенде стояло пять версий, RAS поднялся от 8.3.27.2325 при кластере на 8.3.27.1606, и полчаса выглядело так, будто виноват инструмент. Надёжный способ не промахнуться: брать ras.exe из того каталога, где лежит ragent.exe работающей службы агента, а не из "самой новой" папки.
Третье: путь в кавычках. Путь к платформе содержит пробелы, и без кавычек внутри binPath= служба заводится с незакавыченным путём. Работать она будет, но это давно известная дыра: подсунутый в корень диска исполняемый файл запустится вместо неё с правами системы. Аудиторы такие службы отмечают отдельной строкой.
После старта проверьте, что порт слушается: netstat -an | findstr 1545 должен показать LISTENING. И держите в голове, что "localhost" в настройках подключения означает сервер приложений, а не машину администратора: код выполняется на сервере.
Проверка, которой нет в консоли: процесс против настройки
Здесь всплывает главный признак, ради которого стоит смотреть на живые процессы, а не только на настройки. У кластера есть настройка "период перезапуска рабочих процессов": через сколько секунд процесс будет заменён на свежий, чтобы накопленная им память освободилась. У рабочего процесса, в свою очередь, есть время запуска. Сопоставим одно с другим.
Одна оговорка, без которой этот замер устареет прямо у вас на глазах. В консоли кластера на 8.3.27 численного поля "интервал перезапуска" больше нет: и у кластера, и у рабочего сервера вместо него "Расписание перезапуска". Само число никуда не делось, его по-прежнему видно и в объекте платформы, и в rac cluster list как lifetime-limit, просто задать его теперь можно не из этого диалога, а расписанием или через rac. Отсюда ловушка для любого инструмента, который читает только число: на кластере с настроенным расписанием он объявит, что процессы не перезапускаются никогда, и это будет ровно то же правдоподобное враньё, что и в первом замере. Проверять надо оба признака.
На стенде я выставил период перезапуска в тридцать минут и посмотрел на живые процессы. Один из них к этому моменту работал уже вторые сутки:
ЖизньПроцесса = ТекущаяДата() - Процесс.ВремяЗапуска;
// период перезапуска настроен: 1800 секунд (30 минут)
// процесс живёт: 200 000 секунд (2 суток 7 часов)
Прежде чем кричать "перезапуск сломан", надо назвать штатную причину, по которой процесс может так жить. Перезапуск по периоду мягкий: кластер поднимает новый процесс, а старый помечает на выключение и ждёт, пока с него сойдут все соединения. Пока хоть одно держится, старый процесс живёт - и если время принудительного завершения выставлено в ноль (а на дефолтном кластере оно часто ноль), убивать его насильно никто не будет. То есть долгоживущий процесс сам по себе не улика.
Уликой его делает пара с числом соединений. Если процесс старше периода перезапуска и на нём висят живые соединения - это одно: старый процесс кого-то дообслуживает, и надо смотреть, почему сеансы не отпускают его вторые сутки. Если же он старше периода, а соединений на нём давно нет - перезапуск действительно не отработал: либо период выставили и кластер с тех пор не перезапускали, либо где-то стоит ноль, обнуляющий механизм. Оба случая стоит знать, и ни один из них не виден ни в настройке, ни в факте по отдельности.
Настройка и то, что реально крутится в процессах, - два разных числа, и между ними стоит применение. Сопоставление ловит именно этот разрыв: настройка говорит "перезапуск раз в полчаса", факт говорит "процесс работает двое суток", а вместе они означают, что накопленное этим процессом до сих пор не освободилось.
Два диалога, в которых всё это и заполняется
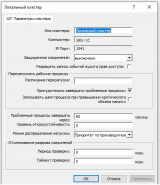
Дальше по порядку полей: что ставить и от чего это защищает. Всё, что ниже, снято переключением настройки туда-обратно на стенде, а не переписано из методички.
Расписание перезапуска. Главное поле этого диалога и единственный способ включить перезапуск процессов из консоли на 8.3.27. Пустое поле означает, что процессы не перезапускаются никогда: накопленная ими память не освобождается, пока сервер не упрётся в потолок. Ставить окно минимальной нагрузки, обычно ночь. Раз в сутки достаточно, чаще часа вредно: выключенный процесс дообслуживает старые соединения, и при частых перезапусках такие процессы плодятся быстрее, чем умирают, а память съедают именно они.
И отдельно про то, что в это поле вписывать, потому что подсказки нет ни в консоли, ни в справке rac. Расписание задаётся не привычной строкой платформы, а в стиле cron: пять полей "минуты часы день месяц день_недели". Ежедневный перезапуск в три ночи это 0 3 * * *. Привычное для 1С "каждый день; с 03:00:00" кластер не принимает и отвечает "Неправильно задано расписание перезапуска. Неверное число, в позиции 0" - я на это напоролся и подобрал формат перебором. Записанное значение кластер потом отдаёт обратно в кавычках: restart-schedule : "0 3 * * *". И ещё одна тонкость: поле есть в обоих диалогах, но принимает его именно рабочий сервер. rac на сборке 8.3.27.1606, где писалась эта статья, у кластера менять расписание не умеет - параметр --restart-schedule у rac cluster update появился между сборками 8.3.27.1688 и 8.3.27.1989.
Проблемные процессы завершать через. Тот самый срок, после которого выключенный процесс завершается принудительно, даже если на нём ещё висят соединения. Ноль здесь при включённом перезапуске означает, что процесс с зависшим соединением живёт вечно: новый уже поднят, а старый продолжает держать память. Разумное значение - от получаса до пары часов, чтобы дать людям доработать, но не бесконечно.
Принудительно завершать проблемные процессы. Галка, которой кластер разрешают самому убивать процессы, переставшие отвечать. Если у консоли никто не дежурит круглосуточно, она должна стоять: иначе зависший rphost висит до тех пор, пока его не убьют руками. Работает в паре с допустимым отклонением количества ошибок: пока то нулевое, кластер вообще не помечает процессы проблемными по ошибкам.
Уровень отказоустойчивости. Число серверов, потерю которых кластер переживёт без обрыва сеансов. На одном рабочем сервере поднимать его некуда и незачем, ноль тут честное значение. А вот ноль при двух и более серверах означает, что железо под резерв куплено, а страховки нет. Обратная крайность тоже вредна: значение выше, чем серверов минус один, физически недостижимо, кластер просто держит лишние копии сервисов.
Режим распределения нагрузки. "Приоритет по производительности" - умолчание и обычно правильный выбор. Переключать на память есть смысл только при её реальном дефиците: тогда соединения поедут на процесс с наименьшей занятой памятью, а не на самый быстрый.
Записывать дамп при завершении по превышению памяти. Имеет смысл ровно тогда, когда лимиты памяти заданы. Без дампа процесс, убитый за память, не оставит после себя ничего, и разбираться, кто её съел, будет не по чему. Цена - место на диске: дамп весит столько же, сколько сам процесс.
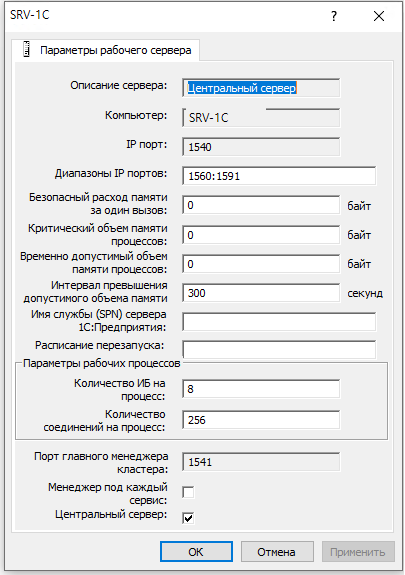
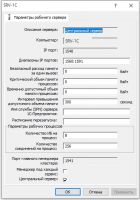
Второй диалог отвечает за память, и тут у полей есть неочевидная общая логика: ноль означает "считать автоматически", а минус один - "не ограничивать вовсе". Ноль почти везде и есть правильный ответ, а минус один - редкая осознанная настройка, которая чаще попадает в кластер по ошибке.
Безопасный расход памяти за один вызов. Ноль означает автоматическое значение - пять процентов от максимального объёма памяти рабочих процессов. Минус один здесь опаснее всего: при достигнутом лимите памяти любой вызов считается опасным и прерывается, и пользователи начинают ловить обрывы на ровном месте. Если сомневаетесь, ставьте ноль.
Критический объём памяти процессов. Последний рубеж перед свопом: ноль означает автоматические девяносто пять процентов оперативной памяти сервера, при переходе за него кластер аварийно завершает самые прожорливые процессы. Минус один снимает этот рубеж совсем, и тогда процессы вправе съесть память вместе с операционной системой.
Временно допустимый объём памяти процессов. Ноль означает восемьдесят процентов ОЗУ. При превышении сервер считается непроизводительным, и новые соединения на него не назначаются, то есть это мягкая защита до критического рубежа.
Интервал превышения допустимого объёма памяти. Работает только в паре с предыдущим полем. Ноль при заданном пороге означает, что порог есть, а реакции нет: процессы не будут завершаться при затяжном превышении. Ненулевое значение - это срок, который сервер даёт превышению пережить себя, обычно десятки секунд, чтобы тяжёлый отчёт не убивал процесс при первом же всплеске.
Количество ИБ на процесс. Восемь - умолчание платформы. Единица даёт полную изоляцию: каждой базе свой rphost, базы не мешают друг другу, но и процессов будет столько же, сколько активных баз, и память надо считать. Значение, при котором все базы помещаются в один процесс, плохо тем, что одна тяжёлая база утащит за собой соседей и по памяти, и при аварии.
Количество соединений на процесс. Потолок, при достижении которого кластер поднимает следующий процесс. Умолчание платформы - 128.
Обработка из этой статьи проходит ровно по этим полям и по каждому пишет не значение, а последствие, поэтому её вывод можно читать рядом с открытым диалогом: строка "чинить" указывает, какое поле открыть, а колонка "что делать" - что в нём поставить.
Как убедиться, что правка доехала
Отдельная беда любой настройки кластера в том, что она применяется не сразу и не ко всему. Значение записано, консоль его показывает, а живые процессы работают по старому - потому что перезапуска ещё не было. Поэтому после каждой правки полезно смотреть не только настройку, но и факт.
Прочитать записанное можно и без консоли:
rac cluster info --cluster=<uuid>
rac server info --cluster=<uuid> --server=<uuid>
В выводе видно и lifetime-limit (тот самый период в секундах, которого больше нет в диалоге), и restart-schedule строкой в кавычках. Забавная деталь: расписание rac отдаёт на чтение, а вот менять его на моей сборке 8.3.27.1606 умеет только у рабочего сервера - у кластера параметр --restart-schedule в rac cluster update появился позже, между сборками 8.3.27.1688 и 8.3.27.1989, а в 8.3.20 его нет ни у сервера, ни у кластера. Спасибо Ninel_S в комментариях за уточнение.
Дальше сравнивайте с фактом: время запуска самого старого рабочего процесса против настроенного окна перезапуска. Если процесс старше и соединений на нём давно нет, перезапуск не отрабатывает, и правка лежит неприменённой.
Что стоит проверить у себя сегодня
Короткий список, по которому проходит любой чек-ап кластера, и который можно пройти руками за десять минут:
- расписание перезапуска у рабочего сервера: пусто означает "процессы не перезапускаются никогда";
- время принудительного завершения: ноль при включённом перезапуске оставляет старые процессы жить вечно;
- поля памяти рабочего сервера: ноль это авто, минус один это "не ограничивать", и минус один почти всегда ошибка;
- интервал превышения допустимого объёма памяти: без него порог памяти задан, а реакции на него нет;
- количество ИБ на процесс: одна тяжёлая база не должна жить в одном процессе со всеми остальными.
Проверки из обеих частей собраны в отдельную обработку "Чек-ап сервера 1С: настройки кластера и рабочих процессов": она читает настройки штатным объектом платформы и по каждой печатает не значение, а последствие. Про расписание она знает, поэтому на 8.3.27 не объявляет ваш кластер ненастроенным. Лежит в Чек-ап сервера 1С: настройки кластера и рабочих процессов, менять в кластере ничего не умеет принципиально.
Вопрос к тем, кто дочитал
Откройте свойства своего рабочего сервера и посмотрите на поле расписания перезапуска. Если оно пустое, откройте рядом список рабочих процессов и найдите время запуска самого старого. Разница между этими двумя числами и есть срок, в течение которого ваши процессы копят то, что должно было обнуляться каждую ночь.
Вступайте в нашу телеграмм-группу Инфостарт