Когда речь заходит о компрессии данных в PostgreSQL, разговор почти всегда сводится к коэффициенту сжатия. Вендоры показывают красивые цифры: база становится меньше в три, пять или даже восемь раз, и подразумевается, что в целом в эти же 3–8 раз снизится нагрузка на файловую систему. Но это не всегда так, и стремление добиться максимального коэффициента компрессии само по себе может оказаться ложной целью. Более важными показателями могут стать коэффициенты усиления записи (write amplification factor) и усиления чтения (read amplification factor). Далее мы покажем, что уменьшение размера базы в k раз не гарантирует уменьшения записи в k раз. Скорее, это идеальное значение, к которому всё только стремится.
Оглавление
-
Компрессия страниц переменного размера и фиксированного размера
-
Алгоритмы сжатия: по отдельности PGLZ, LZ4, ZSTD и их сравнение
-
-
Небольшая таблица (2,6 GB → 326 MB) и большая таблица (95 GB → 12 GB)
Объекты сжатия
Существующие технологии сжатия в PostgreSQL оперируют объектами двух типов — это либо значения типов данных переменной длины (varlena) либо страницы таблиц и индексов.
Сжатие объектов varlena имеет простую организацию, не нарушающую общую идеологию хранения значений. Заголовок varlena содержит специальные поля, указывающие на параметры сжатия за которыми следуют сжатые данные. Основной недостаток такого подхода — ограниченность применения, а именно только большие значения переменной длины (как, правило, TOAST).
У страничного сжатия есть существенные преимущества. Во-первых, расширяется возможность применения — практически все данные в Postgres имеют страничную организацию. Во-вторых, размер страницы обычно значительно больше размера varlena значения, а это повышает эффективность сжатия.
Второй вариант интереснее, поскольку именно он позволяет полноценно сжимать таблицы и индексы.
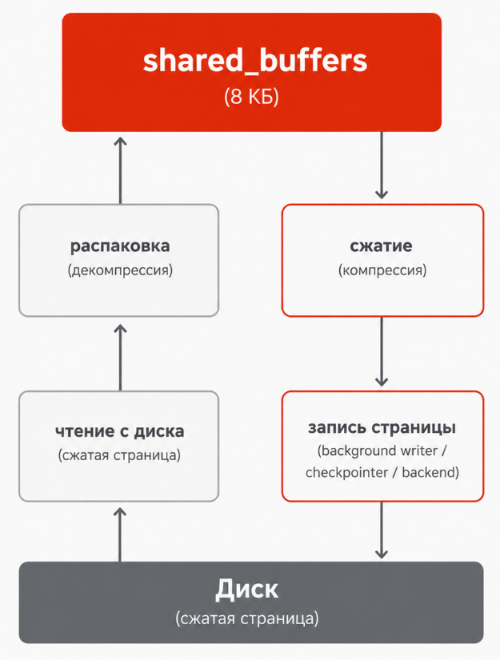
Сжатие выполняется на уровне менеджера хранения, то есть модуля PostgreSQL, ответственного за чтение и запись страниц. При чтении данных процесс считывает сжатую страницу с диска, распаковывает ее и только после этого помещает в shared_buffers. Все дальнейшие операции, использующие shared_buffers, работают со стандартной 8-килобайтной страницей и не требуют дополнительных действий. При изменении страницы ситуация аналогична. После выполнения UPDATE в памяти находится уже несжатая страница. Повторное сжатие выполняется только при записи данных на диск фоновыми процессами background writer или checkpointer, а в отдельных случаях — непосредственно backend-процессом, если ему требуется вытеснить «грязную» страницу из буферного кэша.
Таким образом, дополнительная нагрузка на процессор возникает только в двух случаях:
-
при чтении страницы с диска — на этапе распаковки;
-
при записи страницы на диск — на этапе сжатия.
Подытоживая сказанное, компрессия применяется при хранении страниц на диске, а в оперативной памяти страницы всегда находятся в обычном несжатом виде размером 8 КБ.
Рассмотрим далее распространенные подходы к сжатию страниц и связанные с ними архитектурные особенности, а затем покажем, почему при разработке CSM (Compression Storage Manager) в Tantor Postgres был выбран именно такой вариант реализации и как он проявляет себя на реальных базах данных.
Компрессия страниц переменного размера
Если рассматривать компрессию с точки зрения экономии дискового пространства, то наиболее привлекательным выглядит подход, при котором каждая страница после сжатия занимает ровно столько места, сколько удалось получить в результате компрессии. Если одна страница после компрессии занимает 1,2 КБ, а другая — 2,5 КБ, то столько они и будут занимать в файле. Дисковое пространство используется эффективно, выходит неплохой коэффициент сжатия, и на первый взгляд такое решение выглядит оптимальным.
Однако компрессия в этом случае затрагивает не только объем данных, но и сам механизм хранения страниц. В классическом PostgreSQL все страницы имеют фиксированный размер 8 КБ, благодаря чему их положение на диске определяется простым вычислением по номеру блока. После перехода к страницам переменного размера это свойство теряется, потому что для поиска страницы уже недостаточно знать ее номер, необходимо определить ее фактическое расположение в файле.
Одним из способов решения этой задачи является использование дополнительной структуры адресации, которая хранит информацию о положении каждой страницы. Именно такой принцип реализован в Compressed File System (CFS). Появление дополнительной структуры адресации само по себе не является каким-либо недостатком, это естественная плата за возможность хранить страницы переменного размера. Однако вслед за этим возникают особенности, которые неизбежно начинают влиять на эксплуатационные характеристики системы.
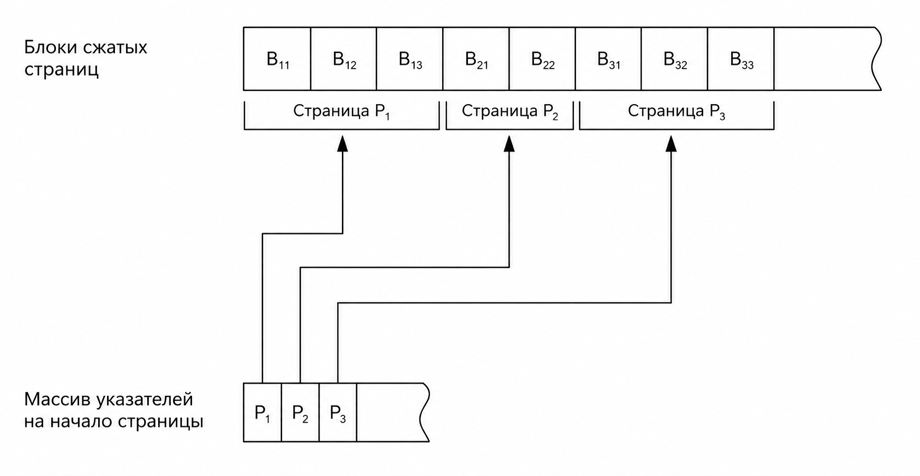
Прежде всего, усложняется обработка операций записи. Если после выполнения UPDATE размер сжатой страницы увеличился и она перестаёт помещаться на прежнем месте, ее приходится переносить в другую область файла. Освободившееся пространство постепенно накапливается, что приводит к его фрагментации и возникновению новой задачи учёта свободного и занятого файлового пространства.
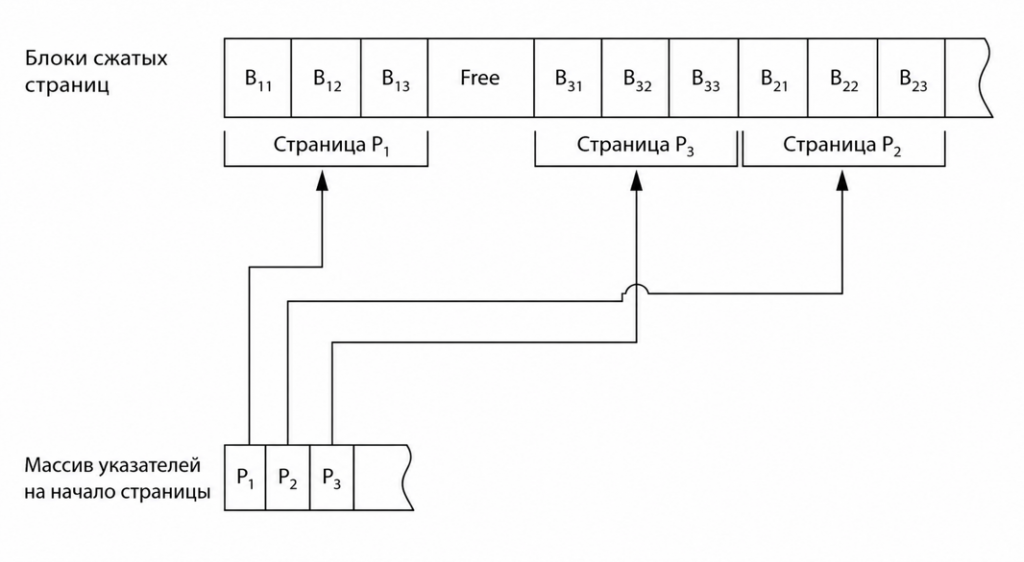
Бороться с фрагментацией можно по-разному. Например, можно периодически выполнять компактификацию данных, время от времени перекладывая страницы внутри файла. Или выделять место не произвольного размера, а блоками фиксированной длины, так вероятность повторного использования свободных областей будет выше. Оба варианта требуют дополнительных операций, которых нет в классическом механизме хранения PostgreSQL.
Есть и еще один эффект, менее очевидный, но более важный. Появление указателя на страницу крайне негативно влияет на коэффициент усиления записи SSD-дисков.
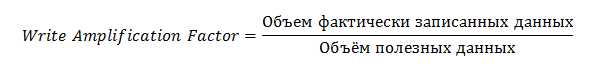
Дело в том, что SSD пишет данные блоками по 4 КБ (у некоторых моделей значение может быть выше).
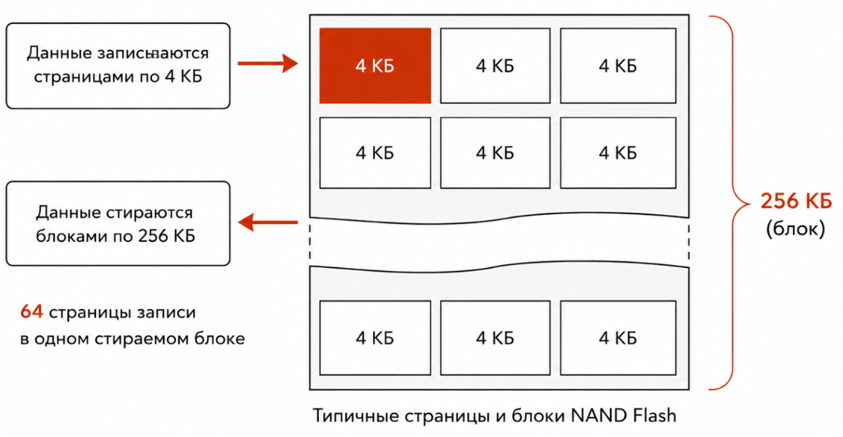
Здесь об этом чуть более углубленно
SSD-диск разбит на страницы размером от 4 до 32 КБ в зависимости от модели, а страницы, в свою очередь, объединены в блоки (обычно по 128 страниц). Запись происходит поэтапно: стирается блок, а затем в него записываются страницы. То есть, если приложение пишет 1 байт, то фактически SSD перезаписывает 4КБ. Вывод очевиден: для SSD хорошо, если приложение пишет крупными блоками и делает это через append (этим требованиям, например, соответствует журнал WAL).
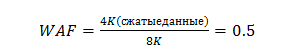
Можно даже прикинуть коэффициент усиления записи:

Значение в 1.5 раз хуже в сравнении с записью 8 КБ без сжатия. Можно пытаться оптимизировать и, например, за один раз записывать указатели сразу для нескольких страниц, но это не всегда возможно. Причём сжатые данные могут затрагивать две страницы SSD, в этом случае WAF = 2 (в два раза хуже записи 8KБ без сжатия).
Как вывод — подход позволяет получить максимальный коэффициент компрессии, но при этом в 1,5 — 2 раза увеличивается нагрузка на диск.
Компрессия страниц фиксированного размера
Если предыдущий подход стремится получить максимальный коэффициент компрессии, то при разработке CSM (Compression Storage Manager) в Tantor Postgres для нас было приоритетом улучшение всех существенных показателей менеджера хранения, а именно:
-
размер дискового пространства;
-
коэффициенты усиления записи и чтение;
-
использование CPU и ОЗУ.
Для этого мы сохранили основные свойства механизма хранения PostgreSQL. Идея заключается в том, что главный файл отношения (таблицы или индекса) по прежнему имеет фиксированный размер страницы, но меньшего размера 4 КБ, 2 КБ или 1 КБ. Размер страницы подбирается таким образом, что в большинстве случаев его было бы достаточно для хранения сжатых данных.
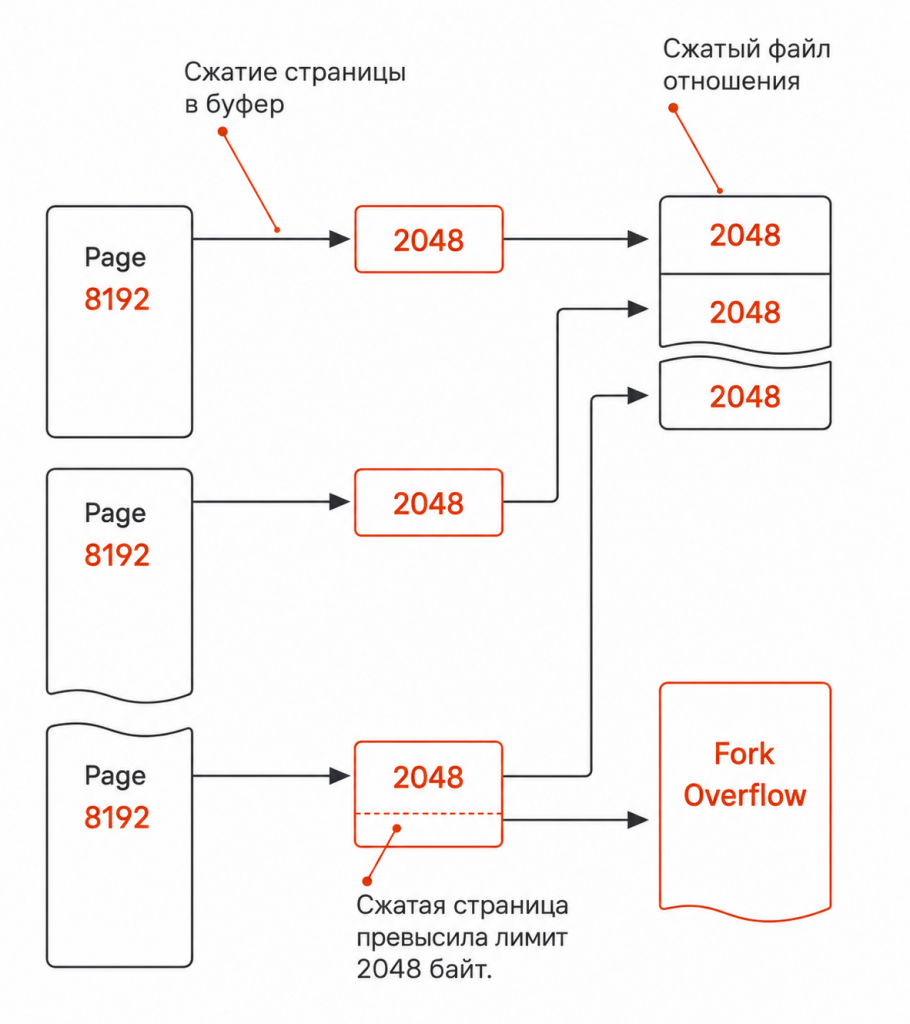
Размер страницы задается через параметр хранения compression_page...
CREATE TABLE foo (int id, varchar name) WITH (compression = lz4, compression_page = 4096);
.. и может быть впоследствии изменён:
ALTER TABLE foo SET ( compression_page = 2048);
Могут быть страницы, которые превысят ограничение, в этом случае не вместившиеся данные размещаются в специальной области хранения (overflow). Но таких случаев должно быть немного, и, как следствие, возникающие издержки будут незначительными.
В результате положение большинства страниц снова можно определить по их номеру без дополнительных структур адресации. Это позволяет сохранить простую организацию хранения данных и избежать большинства проблем, возникающих при использовании страниц переменного размера.
Теперь, если мы посмотрим на коэффициент усиления записи для страницы размером 4096 байт, то увидим, что в Tantor Postgres 18 значение WAF для сжатых отношений окажется в два раза лучше по сравнению с записью без сжатия.
Эти рассуждения подводят нас к формированию рекомендаций по выбору размера страницы и алгоритма сжатия:
-
Если выполняется активная запись в таблицу, то следует выбрать размер страницы 4 КБ и алгоритм сжатия LZ4, предполагающий минимальную нагрузку на процессор. Накладные расходы на сжатие будут минимальным, при этом мы получим двукратное уменьшение объёма и двукратное снижение нагрузки на диск, а также уменьшение использования оперативной памяти для кеширования файла операционной системой.
-
Если данные хорошо сжимаются и редко изменяются, следует использовать страницы 2 KБ. В этом случае при выборе алгоритма шифрования следует учитывать, какое влияние он оказывает на долю страниц, использующих overflow блоки. Если LZ4 справляется с задачей упаковки данных в 2K, то используем его, иначе смотрим в сторону алгоритма zstd.
-
Наконец, в редких случаях для хорошо сжимаемых данных следует использовать compression_page = 1024.
Алгоритмы сжатия
В настоящее время CSM поддерживает несколько алгоритмов сжатия, отличающихся как степенью компрессии, так и требованиями к вычислительным ресурсам.
PGLZ
PGLZ — исторический алгоритм PostgreSQL, используемый уже много лет. Основные его преимущества — простота реализации и минимальные требования к процессорным ресурсам. Степень компрессии PGLZ по современным меркам относительно невысока, и на большинстве реальных БД он заметно уступает более современным алгоритмам.
Преимущества:
-
низкая нагрузка на CPU;
-
встроенная поддержка PostgreSQL;
-
стабильное и предсказуемое поведение.
Недостатки:
-
сравнительно низкий коэффициент сжатия.
LZ4
LZ4 ориентирован на максимальную скорость работы, обеспечивает очень быстрое сжатие и распаковку при сохранении хорошего уровня компрессии. На практике именно LZ4 часто становится оптимальным выбором для высоконагруженных OLTP-систем, где важны минимальные накладные расходы на обработку данных.
Преимущества:
-
высокая скорость сжатия;
-
очень высокая скорость распаковки;
-
низкая нагрузка на CPU;
-
хороший коэффициент компрессии.
Недостатки:
-
степень сжатия обычно ниже, чем у zstd.
zstd
zstd — самый современный алгоритм из поддерживаемых, он ориентирован на достижение максимального коэффициента компрессии. В большинстве случаев именно zstd позволяет получить наименьший размер БД, а вот платой за это становится более высокая нагрузка на процессор при выполнении операций сжатия и распаковки.
Преимущества:
-
высокий коэффициент компрессии;
-
эффективная работа с большими объемами данных.
Недостатки:
-
более высокие требования к процессорным ресурсам.
Сравнение алгоритмов
По степени компрессии выходит следующая последовательность: PGLZ < LZ4 < zstd. Если же сравнивать скорость работы, то получится, что LZ4 > PGLZ > zstd. Выбор алгоритма зависит от поставленной задачи. Если приоритетом является минимальная нагрузка на процессор, имеет смысл рассматривать PGLZ или LZ4, а если нужно сократить объем данных, предпочтительным выбором станет zstd.
В нашем инструменте роли распределены так:
-
LZ4 — настроен на максимальную скорость;
-
zstd — на максимальный уровень компрессии;
-
PGLZ — просто есть:)
В планах — реализация возможности указывать степень компрессии при анализе и сжатии. Это добавит гибкости в выборе алгоритма и, возможно, повлияет на картину сопоставления их эффективности.
Ниже мы сравним эти алгоритмы на реальных данных и посмотрим, насколько теоретические различия проявляются на практике.
Анализ потенциала сжатия
Исходя из архитектуры механизма сжатия CSM? логично предположить, что максимальная степень компрессии будет составлять 8. То есть, теоретически можно достигнуть уровень сжатия в 8 раз. Теоретические коэффициенты мы проверим на реальных базах данных. Проверять будем на базах 1С.
Прежде чем включать компрессию, полезно оценить, какой эффект она даст для конкретной таблицы или индекса. Для этого в расширении pg_csm реализована функция csm_compress_analysis, позволяющая проанализировать существующие страницы отношения и оценить потенциальную степень их сжатия.
Сам механизм сжатия реализован на уровне ядра, однако все аналитические и статистические функции вынесены в расширение pg_csm. Для их использования необходимо один раз подключить расширение к базе: create extension pg_csm
Пример вызова:
select * from csm_compress_analysis('test_table','all',0.01)
Функция принимает три параметра:
-
oid — oid / имя таблицы или индекса.
-
alg_name — алгоритм сжатия (all, zstd, lz4, pglz). Можно проанализировать только эффективность одного алгоритма, и это повысит скорость анализа. По умолчанию — 'all'.
-
sample — коэффициент количества страниц, выбираемых для анализа (>0, <=1). Чем меньше, тем быстрее, но менее точно. По умолчанию = 1.
Пример запроса, показанный чуть выше, анализирует таблицу test_table, используя все алгоритмы компрессии и выборку 1% страниц.
Результат:
|
relname |
test_table |
test_table |
test_table |
|
reloid |
23 699 795 |
23 699 795 |
23 699 795 |
|
page_cnt |
623 |
623 |
623 |
|
alg_name |
zstd |
pglz |
lz4 |
|
avg_compress |
0.2713623 |
0.30786133 |
0.36462402 |
|
avg_page_sz |
2223 |
2522 |
2987 |
|
page_over_1k |
622 |
622 |
622 |
|
page_over_2k |
619 |
622 |
622 |
|
page_over_4k |
0 |
0 |
0 |
|
compressed_1k |
1 911 808 |
1 911 808 |
2 101 248 |
|
compressed_2k |
1 909 760 |
1 912 832 |
2 102 272 |
|
compressed_4k |
2 551 808 |
2 551 808 |
2 551 808 |
|
compress_ms |
31.22 |
52.74 |
7.86 |
На выходе:
-
relname — имя анализируемого отношения;
-
reloid — oid анализируемого отношения;
-
page_cnt — количество проанализированных страниц (в нашем случае это всего 1% от полного количества);
-
alg_name — алгоритм;
-
avg_compress — средний коэффициент сжатия;
-
avg_page_sz — средний размер сжатых данных;
-
pages_over_1k — количество страниц, не уместившихся в 1 КБ;
-
pages_over_2k — количество страниц, не уместившихся в 2 КБ;
-
pages_over_4k — количество страниц, не уместившихся в 4 КБ;
Добавлено, начиная с версии 18.4:
-
compressed_relation_size_1k — размер анализируемых данных в байтах, сжатых с использованием размера страницы 1024;
-
compressed_relation_size_2k — размер анализируемых данных в байтах, сжатых с использованием размера страницы 2048;
-
compressed_relation_size_4k — размер анализируемых данных в байтах, сжатых с использованием размера страницы 4096;
-
compress_ms — время в миллисекундах, затраченное процессором на сжатие страниц.
Очень важны поля pages_over_1k, pages_over_2k, pages_over_4k: они показывают, сколько страниц не смогут быть размещены в выбранном размере и будут использовать overflow.
Что такое overflow?
Если после компрессии страница вместе со служебной информацией не помещается в заданный размер (1, 2 или 4 КБ), избыточные данные сохраняются в отдельном файле *_ovr. Такая схема позволяет сохранить фиксированный размер основных страниц, однако обращение к overflow сопровождается небольшими дополнительными накладными расходами. Поэтому желательно, чтобы доля таких страниц оставалась минимальной.
Особенность работы функции csm_compress_analysis — повторяемость результата. При повторном выполнении запроса на тех же данных будут выбраны те же страницы для анализа и, следовательно, получены идентичные результаты.
Скрипты анализа
Для анализа отдельной таблицы или индекса достаточно вызова функции:
select * from csm_compress_analysis('test_table', 'all', 0.01)
Однако на практике гораздо удобнее использовать запрос:
Расширенный анализ по таблице
select
relname,
pg_size_pretty(pg_relation_size(reloid)) AS full_size,
page_cnt,
pg_size_pretty(page_cnt::bigint  8  1024) AS page_cnt_size,
alg_name,
avg_page_sz,
round(pages_over_4k::numeric / page_cnt * 100, 2) AS pages_over_4k_p,
round(pages_over_2k::numeric / page_cnt * 100, 2) AS pages_over_2k_p,
round(pages_over_1k::numeric / page_cnt * 100, 2) AS pages_over_1k_p,
pg_size_pretty(compressed_relation_size_4k) AS compress_4k,
pg_size_pretty(compressed_relation_size_2k) AS compress_2k,
pg_size_pretty(compressed_relation_size_1k) AS compress_1k,
compress_ms
from csm_compress_analysis('test_table', 'all',0.01)
Результат для sample = 0.01 (1%):
|
relname |
test_table |
test_table |
test_table |
|
full_size |
15 GB |
15 GB |
15 GB |
|
page_cnt |
19 219 |
19 219 |
19 219 |
|
page_cnt_size |
150 MB |
150 MB |
150 MB |
|
alg_name |
zstd |
pglz |
lz4 |
|
avg_page_sz |
912 |
1171 |
1259 |
|
pages_over_4k_p |
0.00 |
0.00 |
0.00 |
|
pages_over_2k_p |
0.17 |
0.21 |
0.23 |
|
pages_over_1k_p |
4.72 |
99.99 |
99.99 |
|
compress_4k |
75 MB |
75 MB |
75 MB |
|
compress_2k |
38 MB |
38 MB |
38 MB |
|
compress_1k |
20 MB |
38 MB |
38 MB |
|
compress_ms |
291.26 |
858.89 |
55.55 |
Результат позволяет оценить, насколько эффективным будет выбор размера сжатой страницы.
Все вычисляемые значения относятся только к проанализированной выборке. Например, при sample = 0.01 анализируется лишь 1% страниц отношения, поэтому размеры compress_1k, compress_2k и compress_4k будут примерно в 100 раз меньше итоговых значений для всей таблицы. Для удобства в page_cnt_size представлен размер проанализированной выборки. Однако процент страниц, использующих overflow, уже являются репрезентативным в рамках выборки и может использоваться для оценки эффективности.
Дополненный список показателей:
-
relname — имя отношения;
-
full_size — полный размер отношения;
-
page_cnt — количество проанализированных страниц;
-
page_cnt_size — размер проанализированных страниц отношения;
-
alg_name — алгоритм компрессии;
-
avg_page_sz — средний размер сжатых данных;
-
pages_over_1k_p / pages_over_1k_p / pages_over_4k_p — процент страниц, которые не поместятся в выбранный размер и будут использовать overflow.
-
compress_1k / compress_2k / compress_4k — объем проанализированных сжатых данных при различных размерах сжатой страницы;
-
compress_ms — время в миллисекундах, затраченное процессором на сжатие страниц.
Результат анализа демонстрирует интересную особенность выбора алгоритма компрессии. Несмотря на то, что средний размер страницы после сжатия алгоритмом zstd отличается от PGLZ незначительно (1171 байт против 912 байт), именно эти дополнительные байты оказываются критичными.
В результате подавляющее большинство страниц, сжатых PGLZ, с добавленными служебными данными уже не помещается в лимит 1 КБ и часть данных переносится в overflow. Для zstd таких страниц менее 5%, тогда как для PGLZ — практически 100%. Фактически это означает, что при размере сжатой страницы 1 КБ использование PGLZ становится неэффективным, несмотря на близкий средний размер сжатых данных.
В результате выбора PGLZ и размера страницы 1024 будет получен объем сжатых данных как при размере страницы 2048 — очень большой процент страниц в overflow, и сниженная эффективность работы со сжатыми данными.
Именно поэтому при выборе алгоритма недостаточно ориентироваться только на коэффициент компрессии или средний размер страницы. Не менее важно учитывать распределение размеров страниц после сжатия и процент страниц, использующих overflow.
Для анализа всей базы данных можно воспользоваться расширенным запросом, который последовательно анализирует все таблицы и индексы, суммируя результаты по каждому алгоритму компрессии:
WITH c AS (
    SELECT
        a.alg_name,
        c.relpages,
        a.page_cnt,
        a.page_cnt::bigint * 8196 AS analized_size,
        a.pages_over_1k,
        a.pages_over_2k,
        a.pages_over_4k,
        a.compressed_relation_size_4k * c.relpages / a.page_cnt sz4,
        a.compressed_relation_size_2k * c.relpages / a.page_cnt sz2,
        a.compressed_relation_size_1k * c.relpages / a.page_cnt sz1,
        COALESCE(pg_total_relation_size(c.reltoastrelid), 0) AS toast_size
    FROM pg_class c
    CROSS JOIN LATERAL csm_compress_analysis(c.oid, 'all',0.1) a
    WHERE c.relkind IN ('r','i')
)
SELECT
    pg_size_pretty(pg_database_size(current_database())) AS full_database_size,
    pg_size_pretty(sum(toast_size)) AS toast_size,
    sum(page_cnt) AS analized_pages_cnt,
    pg_size_pretty(sum(analized_size)) AS analized_size,

    alg_name,

    pg_size_pretty(sum(sz4)) AS compress_4k,
    pg_size_pretty(sum(sz2)) AS compress_2k,
    pg_size_pretty(sum(sz1)) AS compress_1k,

    round(sum(pages_over_4k)::numeric / sum(page_cnt) * 100, 2) AS pages_over_4k_p,
    round(sum(pages_over_2k)::numeric / sum(page_cnt) * 100, 2) AS pages_over_2k_p,
    round(sum(pages_over_1k)::numeric / sum(page_cnt) * 100, 2) AS pages_over_1k_p
FROM c
GROUP BY alg_name;
Вывод скрипта:
-
full_database_size — полный размер базы данных
-
toast_size — полный размер toast данных, которые не будут сжаты (так как сжимаются отдельно)
-
analized_pages_cnt — количество проанализированных страниц
-
analized_size — размер проанализированных страниц
-
alg_name — алгоритм сжатия, используемый при анализе
-
compress_4k — полный размер сжатых данных при сжатии на страницу 4096 (вычисленный по обратной пропорции)
-
compress_2k — полный размер сжатых данных при сжатии на страницу 2048 (вычисленный по обратной пропорции)
-
compress_1k — полный размер сжатых данных при сжатии на страницу 1024 (вычисленный по обратной пропорции)
-
pages_over_4k_p — процент проанализированных страниц, в сжатом виде не уместившихся на страницу 4096 и потенциально размещаемых в overflow
-
pages_over_2k_p — процент проанализированных страниц, в сжатом виде не уместившихся на страницу 2048 и потенциально размещаемых в overflow
-
pages_over_1k_p — процент проанализированных страниц, в сжатом виде не уместившихся на страницу 1024 и потенциально размещаемых в overflow
Интересный эффект — возможность повторного анализа уже сжатой базы данных. В этом случае можно напрямую сравнить прогноз потенциального эффекта сжатия CSM с фактическими результатами и оценить точность анализа.
Примеры анализа различных баз (часть колонок убрана, чтобы упростить чтение таблицы):
ERP (full_database_size = 645 GB, toast_size = 59 GB):
sample = 1 (время выполнения — 2 ч 58 мин):
|
analized_pages_cnt |
76 938 139 |
76 938 139 |
76 938 139 |
|
analized_size |
587 GB |
587 GB |
587 GB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
294 GB |
295 GB |
296 GB |
|
compress_2k |
156 GB |
172 GB |
167 GB |
|
compress_1k |
130 GB |
170 GB |
164 GB |
|
pages_over_4k_p |
0.60 |
1.28 |
1.55 |
|
pages_over_2k_p |
10.43 |
25.85 |
19.14 |
|
pages_over_1k_p |
63.68 |
97.30 |
95.39 |
sample = 0.1 (время выполнения — 39 мин 57 сек):
|
analized_pages_cnt |
7 747 202 |
7 747 202 |
7 747 202 |
|
analized_size |
59 GB |
59 GB |
59 GB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
294 GB |
295 GB |
296 GB |
|
compress_2k |
156 GB |
172 GB |
167 GB |
|
compress_1k |
130 GB |
170 GB |
164 GB |
|
pages_over_4k_p |
0.60 |
1.28 |
1.54 |
|
pages_over_2k_p |
10.38 |
25.71 |
19.04 |
|
pages_over_1k_p |
63.27 |
96.67 |
94.78 |
sample = 0.01 (время выполнения — 3 мин 43 сек):
|
analized_pages_cnt |
830 416 |
830 416 |
830 416 |
|
analized_size |
6488 MB |
6488 MB |
6488 MB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
294 GB |
295 GB |
296 GB |
|
compress_2k |
156 GB |
172 GB |
167 GB |
|
compress_1k |
130 GB |
170 GB |
164 GB |
|
pages_over_4k_p |
0.56 |
1.22 |
1.45 |
|
pages_over_2k_p |
9.86 |
24.37 |
18.07 |
|
pages_over_1k_p |
59.50 |
90.75 |
88.97 |
ЗУП (full_database_size = 51 GB, toast_size = 1982 MB):
sample = 1 (время выполнения — 11 мин 40 сек):
|
analized_pages_cnt |
6 325 661 |
6 325 661 |
6 325 661 |
|
analized_size |
48 GB |
48 GB |
48 GB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
24 GB |
24 GB |
24 GB |
|
compress_2k |
12 GB |
13 GB |
13 GB |
|
compress_1k |
8285 MB |
12 GB |
11 GB |
|
pages_over_4k_p |
0.05 |
0.22 |
0.22 |
|
pages_over_2k_p |
1.13 |
18.18 |
8.98 |
|
pages_over_1k_p |
32.82 |
83.26 |
65.81 |
sample = 0.1 (время выполнения — 3 мин 11 сек):
|
analized_pages_cnt |
659 474 |
659 474 |
659 474 |
|
analized_size |
5155 MB |
5155 MB |
5155 MB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
24 GB |
24 GB |
24 GB |
|
compress_2k |
12 GB |
13 GB |
13 GB |
|
compress_1k |
8287 MB |
12 GB |
11 GB |
|
pages_over_4k_p |
0.04 |
0.22 |
0.14 |
|
pages_over_2k_p |
1.10 |
17.50 |
8.66 |
|
pages_over_1k_p |
31.61 |
80.00 |
63.26 |
sample = 0.01 (время выполнения — 35 сек):
|
analized_pages_cnt |
93 537 |
93 537 |
93 537 |
|
analized_size |
731 MB |
731 MB |
731 MB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
24 GB |
24 GB |
24 GB |
|
compress_2k |
12 GB |
13 GB |
13 GB |
|
compress_1k |
8283 MB |
12 GB |
11 GB |
|
pages_over_4k_p |
0.03 |
0.18 |
0.12 |
|
pages_over_2k_p |
0.93 |
13.03 |
6.57 |
|
pages_over_1k_p |
23.10 |
57.57 |
45.73 |
ДО (full_database_size = 328 GB, toast_size = 41 GB):
sample = 1 (время выполнения — 2 часа 4 мин):
|
analized_pages_cnt |
37 582 106 |
37 582 106 |
37 582 106 |
|
analized_size |
287 GB |
287 GB |
287 GB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
143 GB |
143 GB |
143 GB |
|
compress_2k |
74 GB |
89 GB |
82 GB |
|
compress_1k |
66 GB |
88 GB |
81 GB |
|
pages_over_4k_p |
0.02 |
0.31 |
0.30 |
|
pages_over_2k_p |
6.88 |
45.68 |
28.61 |
|
pages_over_1k_p |
77.77 |
95.92 |
92.80 |
sample = 0.1 (время выполнения — 21 мин 36 сек):
|
analized_pages_cnt |
3 769 377 |
3 769 377 |
3 769 377 |
|
analized_size |
29 GB |
29 GB |
29 GB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
143 GB |
143 GB |
143 GB |
|
compress_2k |
74 GB |
89 GB |
82 GB |
|
compress_1k |
66 GB |
88 GB |
81 GB |
|
pages_over_4k_p |
0.02 |
0.31 |
0.30 |
|
pages_over_2k_p |
6.85 |
45.55 |
28.52 |
|
pages_over_1k_p |
77.56 |
95.66 |
92.55 |
sample = 0.01 (время выполнения — 2 мин 16 сек):
|
analized_pages_cnt |
388 962 |
388 962 |
388 962 |
|
analized_size |
3039 MB |
3039 MB |
3039 MB |
|
alg_name |
zstd |
lz4 |
pglz |
|
compress_4k |
143 GB |
143 GB |
143 GB |
|
compress_2k |
74 GB |
89 GB |
82 GB |
|
compress_1k |
66 GB |
88 GB |
81 GB |
|
pages_over_4k_p |
0.03 |
0.31 |
0.30 |
|
pages_over_2k_p |
6.70 |
44.30 |
27.80 |
|
pages_over_1k_p |
75.37 |
92.95 |
89.92 |
Примерную зависимость времени анализа от размера выборки можно оценить по приведённым выше результатам. На другом оборудовании абсолютные значения могут отличаться, однако характер зависимости, скорее всего, сохранится. Рекомендуется сначала выполнить анализ с sample=0.01 (1%), чтобы оценить время выполнения и спрогнозировать, сколько займёт анализ при sample=0.1 (10%) и больших значениях sample.
На практике анализ баз данных объемом 50, 230 и 645 ГБ показал, что в большинстве случаев вполне достаточно использовать выборку до 10% страниц (sample = 0.1). Получаемые результаты практически не отличаются от полного анализа, а время выполнения сокращается в несколько раз. Для БД объемом несколько терабайт, вероятно, будет достаточно выборки до 5%, а при необходимости процесс анализа может быть дополнительно распараллелен.
Для получения оценки прогнозируемого полного размера базы в сжатом виде нужно будет к полученному при анализе размеру (compress_1k | compress_2k | compress_4k) прибавить размер toast.
Формула расчета размера базы после сжатия
Размер_базы_после_сжатия = Размер_сжатых_таблиц + toast_size
Как видно из результатов, максимальный эффект компрессии дает алгоритм zstd. В целом и не удивительно, поскольку он сам по себе реализован как алгоритм с высокой степенью компрессии, так еще и мы настроили его на максимальную степень компрессии. Но не нужно забывать, что помимо коэффициента степени сжатия, есть еще скорость сжатия, и есть скорость работы со сжатыми данными, и тут уже лидеры могут поменяться. Этот эффект мы подробно исследуем ниже.
Анализ позволил выявить интересную закономерность. Несмотря на то что, страницы размером 1024 байта обеспечивают наибольший теоретический коэффициент компрессии, именно для них наблюдается наибольший процент страниц, не помещающихся в заданный размер и уходящих в overflow.
В протестированных базах данных наиболее удачным компромиссом оказался размер страницы 2048 байт. Он обеспечивает несколько меньший коэффициент компрессии, чем страницы размером 1024 байта, но при этом значительно сокращает количество страниц, помещаемых в overflow. В результате суммарный объем хранения данных (сжатое отношение + overflow) оказывается меньше, а общая эффективность механизма — выше. Именно поэтому во всех дальнейших нагрузочных испытаниях использовался размер страницы 2048 байт.
Сжатие данных
В предыдущем разделе мы оценили потенциальную эффективность компрессии. Теперь посмотрим, как применить ее на практике. Компрессия включается отдельно для каждой таблицы и индекса командами:
ALTER TABLE <name> SET (compression = <alg_name>, compression_page = <compression_page>)

ALTER INDEX <name> SET (compression = <alg_name>, compression_page = <compression_page>)
где:
-
name — relname или oid;
-
alg_name — алгоритм компрессии, одно из [zstd | pglz | lz4];
-
compression_page — размер сжатой страницы [1024 | 2048 | 4096].
Такой подход обеспечивает полный контроль над процессом компрессии и позволяет применять различные настройки для разных объектов базы данных.
Минимально достаточно последовательно выполнить эти команды для всех таблиц и индексов. Однако на практике такой способ оказывается довольно длительным. Например, для базы данных объемом около 50 ГБ последовательное сжатие может занимать несколько часов, а для многотерабайтных баз — уже десятки часов.
Автоматический подбор параметров компрессии
Наиболее удобным вариантом является использование скрипта alter_max_compress.sh, который автоматически анализирует каждое отношение, подбирает оптимальный размер сжатой страницы с учетом допустимого процента overflow и выполняет компрессию параллельно в несколько потоков.
Такой подход позволяет ускорить сжатие базы в разы, и 645 GB сжимается за 1.5 часа.
Скрипт имеет следующие параметры:
-
-d — имя базы данных (обязательный параметр);
-
-a — алгоритм компрессии [zstd | pglz | lz4], по умолчанию zstd;
-
-s — значение sample для csm_compress_analysis, по умолчанию 0.1;
-
-o — максимально допустимый процент страниц overflow, по умолчанию 10;
-
-t — количество параллельных потоков, по умолчанию 20;
-
-u — пользователь PostgreSQL, по умолчанию postgres;
-
-h — адрес сервера PostgreSQL, по умолчанию localhost;
-
-p — порт PostgreSQL, по умолчанию 5432.
Пример запуска скрипта:
bash alter_opt_compress.sh -d 'zup' -a 'zstd' > alter_opt_compress_zup_zstd.log
Для большинства баз данных именно этот вариант является рекомендуемым, поскольку позволяет получить практически максимальный эффект от компрессии без ручного подбора параметров для каждой таблицы и индекса.
Упрощенный вариант сжатия
Если параметры компрессии уже известны и они одинаковы для каждого отношения, можно воспользоваться упрощенным скриптом alter_compress.sh. В отличие от предыдущего варианта, он не выполняет анализ отношений и применяет выбранные параметры ко всем объектам БД. Благодаря этому время подготовки еще немного сокращается (1 час 20 минут на 645 GB), однако оптимальный размер сжатой страницы для каждого отношения уже не подбирается и не учитывается статистика overflow. Этот вариант наиболее применим к базам 1С (вместе с параметрами на автоматическое сжатие таблиц).
Параметры:
-
-d — имя базы данных (обязательный параметр);
-
-a — алгоритм компрессии [zstd | pglz | lz4], по умолчанию zstd;
-
-с — размер сжатой страницы [1024 | 2048 | 4096], по умолчанию 2048;
-
-t — количество параллельных потоков, по умолчанию 20;
-
-u — пользователь PostgreSQL, по умолчанию postgres;
-
-h — адрес сервера PostgreSQL, по умолчанию localhost;
-
-p — порт PostgreSQL, по умолчанию 5432.
Сжатие при создании таблиц
В этой части описан функционал, реализованный в еще не вышедшей на момент публикации версии СУБД Tantor Postgres (будет доступен с версии 18.6).
При использовании механизма сжатия с 1С есть одна особенность, которую необходимо учитывать. При реструктуризации первой версии (а ряде случаев и второй) платформа не изменяет существующие таблицы, а создаёт новые, переносит в них данные, удаляет старые таблицы и переименовывает новые на их место. Все эти операции выполняются последовательно в рамках одного процесса, поэтому окно для последующего выполнения ALTER TABLE или ALTER INDEX фактически отсутствует. Если компрессия не была задана в момент создания объекта, он будет создан без нее.
Для обеспечения полной совместимости CSM с механизмом реструктуризации 1С были реализованы глобальные параметры конфигурации (GUC). Их точное именование и использование будет отражено в документации. Эти параметры применяются только к командам CREATE TABLE и CREATE INDEX и позволяют автоматически задавать алгоритм компрессии и размер сжатой страницы для всех вновь создаваемых таблиц и индексов. Благодаря этому новые объекты создаются сразу с необходимыми параметрами компрессии, не требуя дополнительного выполнения ALTER TABLE или ALTER INDEX. Это обеспечивает прозрачную работу механизма сжатия при реструктуризации информационных баз 1С и индексирования полей через механизмы 1С. Тем самым полностью сохраняется совместимость с существующими процессами платформы.
Дополнительный эффект этих GUC — автоматическое сжатие базы при загрузке её из DT и при помощи ibcmd.
Практическая эффективность компрессии
В предыдущем разделе мы оценили потенциальную степень компрессии. Теперь сравним прогноз с фактическими результатами после сжатия баз данных.
Размер базы определялся стандартной функцией:
SELECT datname AS database_name, pg_size_pretty(pg_database_size(datname)) AS size FROM pg_database;
Добавим вручную размеры TOAST и прогнозируемые и реальные результаты сжатия из предыдущих таблиц:
|
database_name |
erp |
do |
zup |
|
Full_size |
645 GB |
328 GB |
51 GB |
|
Compressed_size |
219 GB |
110 GB |
11 GB |
|
Full_compress_ratio |
2.94 |
2.98 |
4.63 |
|
toast |
59 GB |
41 GB |
1982 MB |
|
max_compress_analyze |
167 GB |
77 GB |
9624 MB |
|
Full_compress_analyze (+toast) |
226 GB |
118 GB |
11 GB |
Расшифровка результатов:
-
database_name — имя базы;
-
Full_size — полный размер базы данных до компрессии;
-
Compressed_size — размер сжатой базы данных, полученный функцией pg_database_size;
-
Full_compress_ratio — фактический коэффициент компрессии;
-
toast — объем данных, исключаемых из компрессии CSM;
-
max_compress_analyze — прогнозируемый размер сжатых данных, полученный функцией csm_compress_analysis;
-
Full_compress_analyze (+toast) — прогнозируемый размер сжатой базы данных, полученный путем добавления toast, для сравнения с Compressed_size.
Как видно, фактический размер баз практически совпадает с результатами (и в даже фактически превосходит их), полученными при предварительном анализе. Это подтверждает высокую точность функции csm_compress_analysis и подтверждает эффективность её использования для прогнозирования эффекта компрессии еще до выполнения сжатия.
Стоит отметить еще одну особенность.
При тестировании альтернативных реализаций компрессии, основанных на страницах переменного размера, мы столкнулись с ситуацией, когда значение, возвращаемое функцией pg_database_size, существенно отличалось от фактически занимаемого места на диске. В отдельных случаях разница достигала 1,7 раза.
Например, для базы ERP после полного обслуживания (VACUUM и дефрагментации) функция pg_database_size показывала размер 151 ГБ, что соответствовало высокому коэффициенту компрессии 4,3. Однако фактический объем файлов базы данных на диске составлял 246 ГБ, то есть реальный коэффициент компрессии был лишь 2,6.
Поэтому для проверки результатов работы CSM дополнительно был выполнен контроль занимаемого пространства непосредственно на файловой системе:
|
database_name |
erp |
do |
zup |
|
Full_size |
645 GB |
328 GB |
51 GB |
|
Compressed_size (pg_database_size) |
219 GB |
110 GB |
11 GB |
|
Compressed_size (FileSystem) |
224140 MB (219 GB) |
112836 MB (110 GB) |
11268 MB (11 GB) |
|
Full_compress_ratio |
2.94 |
2.98 |
4.63 |
|
toast |
59 GB |
41 GB |
1982 MB |
|
max_compress_analyze |
167 GB |
77 GB |
9624 MB |
|
max_compress_analyze |
226 GB |
118 GB |
11 GB |
Пояснения:
-
Compressed_size (pg_database_size) — размер сжатой базы данных, полученный функцией pg_database_size;
-
Compressed_size (FileSystem) — размер сжатой базы данных, исходя из данных файловой системы.
Как видно из результатов, размеры, определяемые функцией pg_database_size, полностью совпадают с объемом данных, занимаемым на диске. Можно сделать вывод, что механизм CSM обеспечивает не только высокий коэффициент компрессии, но и корректное отображение реального объема базы данных средствами СУБД.
Практический эффект компрессии полностью соответствует прогнозу, полученному на этапе анализа.
Нагрузочное тестирование 1С
Экономия дискового пространства сама по себе представляет интерес, однако важнее понять, как компрессия влияет на работу реальной информационной системы. Для этого были проведены нагрузочные испытания на базе ERP с использованием той же методики тестирования, которая применяется при проверке новых релизов СУБД Tantor Postgres и описана в одной из предыдущих статей. Перед каждым запуском выполнялась одинаковая последовательность действий:
-
Восстановление БД из резервной копии;
-
Компрессия БД;
-
Расчет статистики;
-
Запуск нагрузочного теста.
Для обеспечения сопоставимости результатов каждый тест выполнялся на идентичной конфигурации оборудования и программного обеспечения.
Параметры испытаний:
-
СУБД: Tantor Postgres 18.3;
-
конфигурация: 1С ERP;
-
размер исходной базы: 645 ГБ;
-
длительность теста: 1 час;
-
количество КО: 29 000 операций.
-
CPU: 16;
-
RAM: 128;
-
I/O: SSD.
Сначала был выполнен эталонный запуск без компрессии. После этого база была сжата алгоритмом ZSTD с размером страницы 2048 байт. Размер базы уменьшился до 220 ГБ, после чего тест повторили.
Результат в цифрах:
|
|
Без компрессии |
CSM (ZSTD, page 2048) |
|
Размер базы |
645 ГБ |
220 ГБ |
|
APDEX |
0,856 |
0,868 |
|
Среднее время отклика |
1,970 |
1,948 |
Графики утилизации cpu, mem, disk i/o:
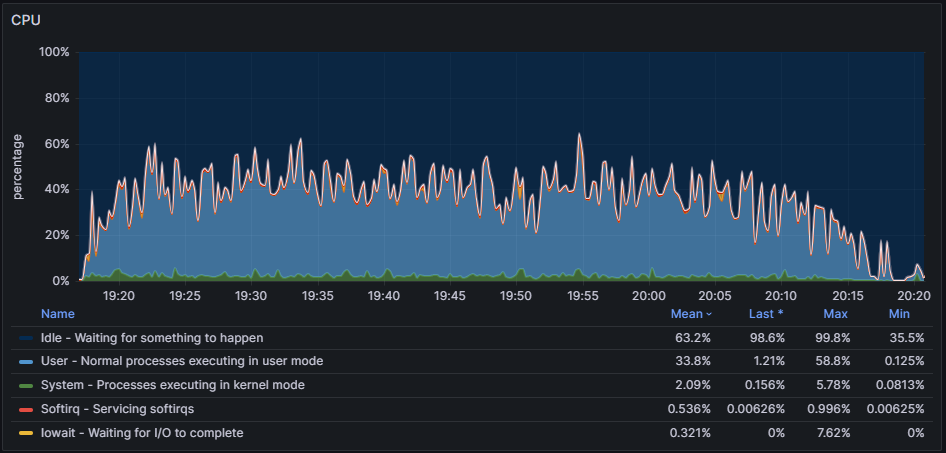
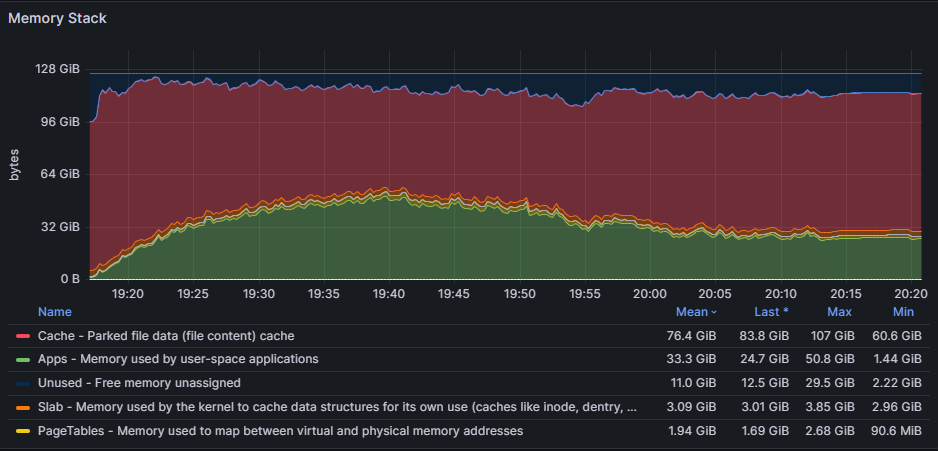
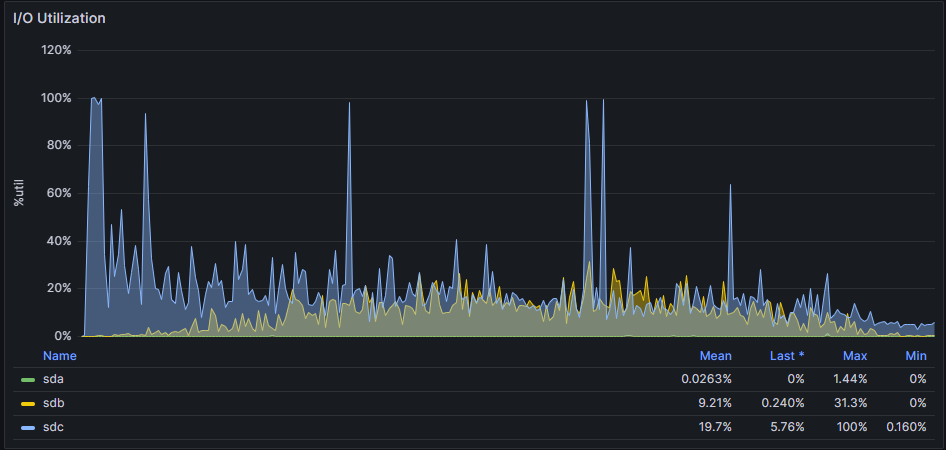
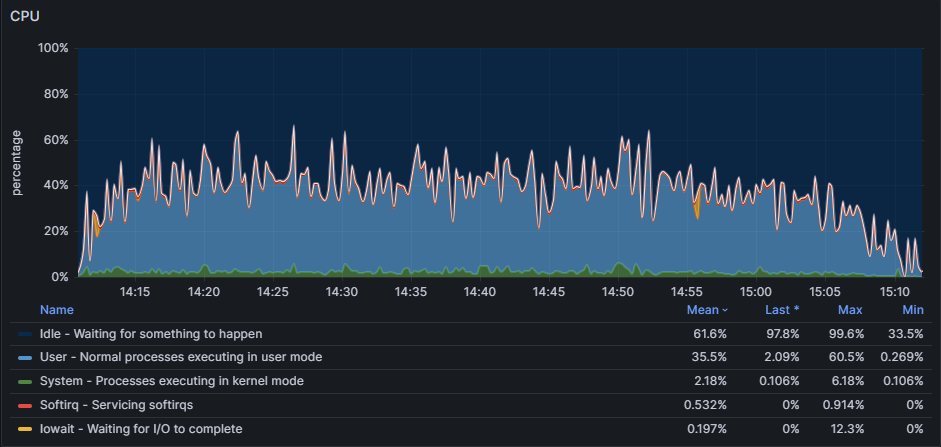
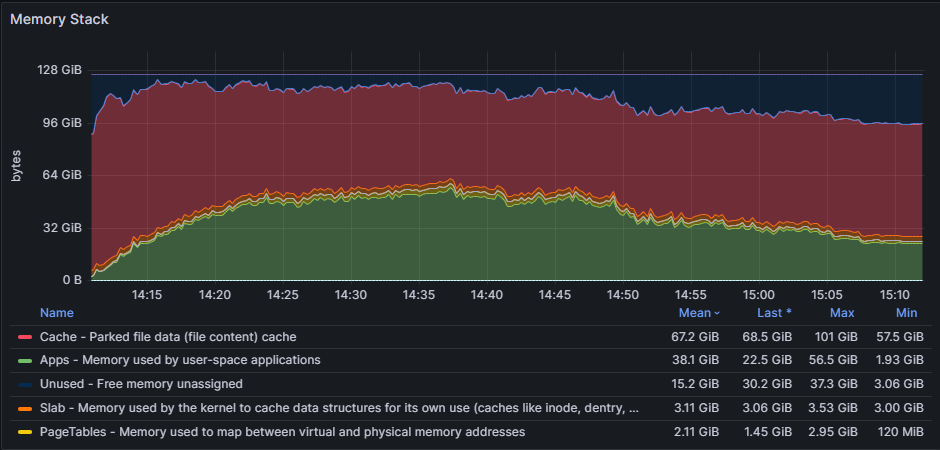
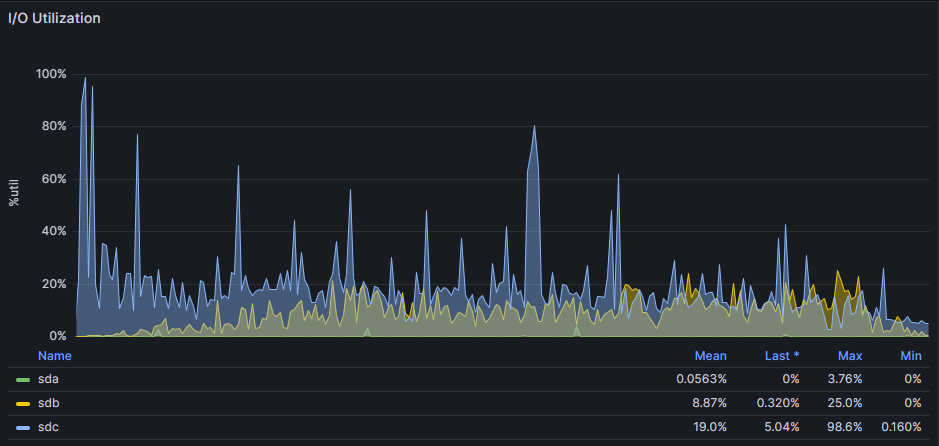
Выводы:
-
Реальный коэффициент компрессии — 2,9;
-
Показатели APDEX и среднего времени отклика практически не изменились;
-
Увеличение утилизации CPU на 2%;
-
Увеличение потребления памяти на 10% в пике;
-
Утилизация дисковой подсистемы практически не изменилась.
Подобные результаты вполне ожидаемы.
В реальной эксплуатации (и нагрузочном тестировании) производительность системы ограничивается не столько оборудованием, сколько эффективностью планировщика запросов PostgreSQL. Рабочая нагрузка не упиралась в пропускную способность дисковой подсистемы, поэтому уменьшение объема читаемых данных практически не повлияло на скорость выполнения операций.
Аналогичные испытания проводились и для других конфигураций 1С. Во всех случаях полученные результаты отличались незначительно, поэтому приводить их отдельно не имеет практического смысла. Главный вывод заключается в том, что использование CSM не приводит к заметному изменению производительности рабочих систем, сохраняя при этом существенную экономию дискового пространства.
Синтетические тесты
Нагрузочные испытания на реальной базе ERP показали отсутствие заметного влияния компрессии на производительность. Это вполне ожидаемый результат — тест не упирался в возможности оборудования, а скорость выполнения запросов в первую очередь определялась эффективностью планировщика запросов. Возникает закономерный вопрос: что произойдет, если узким местом станет дисковая подсистема? Часто можно встретить утверждение, что компрессия автоматически ускоряет работу PostgreSQL за счет уменьшения объема данных. На практике подобные заявления редко сопровождаются измерениями. Давайте проверим это экспериментально.
Скорость подъема данных в shared_buffers
В идеальном случае уменьшение объема данных должно приводить к сокращению количества операций ввода-вывода и, следовательно, ускорять загрузку страниц в кэш. Но так ли это на самом деле?
Небольшая таблица (2,6 GB → 326 MB)
Для проверки была сгенерирована тестовая таблица объемом 2,6 ГБ, которая сжималась до 326 МБ. Таблица содержала 5 миллионов строк, а данные были подобраны таким образом, чтобы достигался максимальный коэффициент компрессии при размере страницы 1024 байта.
DROP TABLE IF EXISTS test_table;
CREATE TABLE test_table (id SERIAL PRIMARY KEY,col1 INTEGER,txt varchar);
INSERT INTO test_table (col1,txt)
SELECT
i::INT, repeat(md5(i::text), 15)
FROM generate_series(1, 5000000) i;
DROP TABLE IF EXISTS test_table_zstd;
CREATE TABLE test_table_zstd (id SERIAL PRIMARY KEY,col1 INTEGER,txt varchar);
INSERT INTO test_table_zstd (col1,txt)
SELECT col1,txt FROM test_table;
DROP TABLE IF EXISTS test_table_pglz;
CREATE TABLE test_table_pglz (id SERIAL PRIMARY KEY,col1 INTEGER,txt varchar);
INSERT INTO test_table_pglz (col1,txt)
SELECT col1,txt FROM test_table;
DROP TABLE IF EXISTS test_table_lz4;
CREATE TABLE test_table_lz4 (id SERIAL PRIMARY KEY,col1 INTEGER,txt varchar);
INSERT INTO test_table_lz4 (col1,txt)
SELECT col1,txt FROM test_table;

ALTER TABLE test_table_zstd SET (compression = zstd, compression_page = 1024);
ALTER TABLE test_table_pglz SET (compression = pglz, compression_page = 1024);
ALTER TABLE test_table_lz4 SET (compression = lz4, compression_page = 1024);
ALTER TABLE test_table SET (compression = lz4, compression_page = 1024);
ALTER TABLE test_table SET (compression = off, compression_page = 1024); --ставим в одинаковые условия, чтобы данные размещались примерно одинаково

--для чистоты эксперимента перед каждым explain... выполнять рестарт инстанса и очищать файловый кэш ОС 'sync | echo 3 > /proc/sys/vm/drop_caches'
--explain (analyze, buffers) SELECT count( * ) FROM test_table_zstd T1 WHERE (T1.txt <> 'не существующая строка')
--explain (analyze, buffers) SELECT count( * ) FROM test_table_pglz T1 WHERE (T1.txt <> 'не существующая строка')
--explain (analyze, buffers) SELECT count( * ) FROM test_table_lz4 T1 WHERE (T1.txt <> 'не существующая строка')
--explain (analyze, buffers) SELECT count( * ) FROM test_table T1 WHERE (T1.txt <> 'не существующая строка')
Для каждого алгоритма создавалась отдельная таблица. В результате наполнения получили 4 таблицы с 5 000 000 строк и количеством страниц на диске 333 376. Перед каждым измерением выполнялся перезапуск инстанса и очистка файлового кэша операционной системы, что гарантировало отсутствие страниц как в shared_buffers, так и в файловом кэше ОС. Измерения проводились с помощью запроса:
explain (analyze, buffers) SELECT count( * ) FROM test_table T1 WHERE (T1.txt <> 'не существующая строка')
Контролировалось, что в плане присутствуют только shared read, а значение shared hit отсутствует. Фиксируем I/O Timings и Execution time. Затем инстанс перезапускался, и фиксировали результаты уже с подъемом данных из кэша ОС. Кроме того, эксперимент повторялся для различных значений io_method, чтобы оценить влияние современных методов ввода-вывода.
Сразу стоит отметить важную особенность текущей реализации CSM. На данный момент механизм поддерживает только синхронный доступ. При выборе worker или io_uring чтение сжатых данных всё равно выполняется синхронно, поэтому сравнение различных методов ввода-вывода корректно проводить только для несжатой таблицы.
Каждый тест выполнялся три раза, после чего рассчитывалось среднее значение. Время в таблице указано в миллисекундах.
|
Алгоритм / io_method |
off / sync |
off / worker |
off / io_uring |
lz4 |
pglz |
zstd |
||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
|
Execution time | I/O Timings |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
|
Холодный запуск |
5553 |
4512 |
3302 |
19 |
1890 |
11 |
3782 |
2825 |
4509 |
3545 |
6111 |
5104 |
|
Кэш ОС |
3628 |
2657 |
1358 |
13 |
1841 |
10 |
3559 |
2607 |
4159 |
3202 |
5796 |
4828 |
Полученный результат оказался вполне ожидаемым. На таком объёме данных физическое чтение с диска ещё не является основным ограничением. Особенно это заметно при чтении из кэша ОС, когда данные уже находятся в памяти. Для несжатой таблицы последовательность действий выглядит достаточно просто:
Страница считывается из кэша ОС → Выполняется практически бесплатный memcpy → Страница помещается в shared_buffers
Для сжатой таблицы добавляется ещё один обязательный этап — распаковка каждой страницы перед её помещение в shared_buffers.
Сравним сжатые таблицы с базовым вариантом (off/sync):
|
Алгоритм |
Холодный запуск |
Кэш OC |
|
lz4 |
−32% |
−2% |
|
pglz |
−19% |
+15% |
|
zstd |
+10% |
+60% |
Здесь хорошо видны особенности алгоритмов.
-
LZ4 оказывается наиболее быстрым. Несмотря на затраты на распаковку, небольшой объём читаемых данных практически компенсирует эти расходы;
-
PGLZ немного уступает LZ4 как по степени сжатия, так и по скорости распаковки;
-
zstd обеспечивает максимальное сжатие, однако цена распаковки уже становится заметной и полностью перекрывает выигрыш от уменьшения объёма чтения.
Отдельного внимания заслуживают результаты для worker и io_uring на несжатой таблице. Полное время выполнения уменьшается почти в два раза по сравнению с sync, хотя значения I/O Timings становятся практически нулевыми. Это ожидаемое поведение: при асинхронных методах ввода-вывода время ожидания диска перестаёт учитываться так же, как при синхронном чтении, поэтому напрямую сравнивать значения I/O Timings между различными io_method некорректно. Для анализа следует ориентироваться дополнительно на Execution Time, поскольку выполняется один и тот же запрос над одинаковым набором данных.
Однако при добавлении к сравнению результатов для worker и io_uring на несжатой таблице победитель меняется — современные асинхронные методы чтения дают значительно больший эффект, чем уменьшение объёма данных. Таблица слишком мала, чтобы выигрыш от сжатия смог компенсировать стоимость распаковки.
А пока продолжим исследование.
Большая таблица (95 GB → 12 GB)
Для следующего теста объем данных был увеличен почти в сорок раз. Тестовая таблица содержала уже 50 млн строк (размер строки увеличен в 3,5 раза), занимала 95 ГБ без компрессии и около 12 ГБ после сжатия. Количество страниц увеличилось до 12,5 млн. Проверяем снова скорость подъема (также среднее из трех итераций, разные методы доступа):
|
Алгоритм / io_method |
off / sync |
off / worker |
off / io_uring |
lz4 |
pglz |
zstd |
||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
|
Execution time | I/O Timings |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
Exec |
I/O |
|
Холодный запуск |
168 157 |
140 659 |
103 104 |
490 |
49 090 |
359 |
58 286 |
38 548 |
67 459 |
47 250 |
120 998 |
98 787 |
|
Кэш ОС |
66 514 |
45 835 |
22 533 |
505 |
44 656 |
327 |
50 943 |
31 851 |
59 154 |
39 676 |
112 291 |
91 693 |
После увеличения объёма данных картина меняется принципиально. Теперь читается уже 12,5 млн страниц, и стоимость операций ввода-вывода начинает доминировать над затратами процессора. Результаты становятся значительно интереснее.
Холодный запуск.
LZ4 сокращает время выполнения запроса почти в три раза. Особенно показательны значения I/O Timings.
Без сжатия: 140 659 мс.
После сжатия:
-
38 548 мс (LZ4)
-
47 250 мс (PGLZ)
-
98 787 мс (zstd)
То есть объём физических операций ввода-вывода действительно серьезно уменьшается.
Кэш ОС
Даже когда все данные уже находятся в кэше операционной системы, сжатие остаётся выгодным.
Относительно off/sync:
|
Алгоритм |
Изменение времени |
|
LZ4 |
−23% |
|
PGLZ |
−11% |
|
zstd |
+69% |
На первый взгляд это может показаться неожиданным, ведь обращения к диску отсутствуют. Однако в случае сжатой таблицы кэш ОС также работает со значительно меньшим количеством данных. Вместо чтения 95 GB из памяти операционной системы фактически передаётся около 12 GB, после чего страницы распаковываются уже на стороне ядра. В данном случае стоимость распаковки оказывается значительно ниже стоимости копирования дополнительных десятков гигабайт данных через подсистему памяти, поэтому LZ4 продолжает выигрывать даже без физических операций чтения с диска. Стоимость декомпрессии протокола zstd всё еще остается выше стоимости остальных протоколов.
Влияние io_method
Если же включить в наше соревнование все поддерживаемые методы доступа — получается любопытное сравнение.
На небольшой таблице:
-
основную роль играет эффективность механизма ввода-вывода;
-
выигрыш от уменьшения объёма данных практически отсутствует;
-
io_uring обеспечивает почти двукратное преимущество над любым вариантом со сжатием.
На большой таблице:
-
влияние стоимости ввода-вывода резко возрастает;
-
уменьшение объёма данных начинает почти полностью компенсировать отсутствие асинхронного I/O;
-
LZ4, несмотря на работу только через sync, проигрывает лучшему варианту без сжатия (io_uring) всего 14–19%
CSM на текущий момент использует только синхронный ввод-вывод. Когда в будущих версиях появится поддержка io_uring, можно ожидать существенного роста производительности за счёт сочетания уменьшенного объёма данных и асинхронного чтения.
Тесты с нагрузкой
В реальных «боевых» системах практически не бывает ситуаций, когда дисковая система не нагружена, и как раз более интересно, как поведет себя система при 100% нагрузке дисковой подсистемы. Для генерации нагрузки воспользуемся инструментом pg_bench. Предварительно сгенерируем таблицу, которая точно не поместится в дисковый кэш целиком.
CREATE TABLE test_io (
    id bigint PRIMARY KEY,
    payload text
);

INSERT INTO test_io
SELECT
    i,
    repeat(md5(i::text), 50)
FROM generate_series(1, 500000000) i;

CREATE INDEX test_io_idx
ON test_io(id);
Сгенерированная таблица-нагрузчик получилась 127 GB. Нагружать будем таким скриптом:
\set id random(1,200000000)

SELECT payload
FROM test_io
WHERE id=:id;
Запускаем наши нагрузчики:
pgbench -f test.sql -c 64 -j 16
Проверять эффективность сжатия будем на первом наборе, только для начала на 1 млн строк, потом повторим для набора с 5 млн строк. Используем io_method = worker. Нагрузка на диски контролируется iostat -x 1. Методика испытаний та же — запускаем по 3 раза и выводим среднее. Для полноты понимания добавим еще третий блок выполнения запросов — когда данные есть в shared_buffers.
|
Алгоритм |
off |
lz4 |
pglz |
zstd |
|---|---|---|---|---|
|
Холодный запуск |
7 683 |
2 254 |
2 212 |
2 588 |
|
Кэш ОС |
686 |
1 133 |
1 286 |
2 043 |
|
Shared_buffers |
340 |
|||
И 5 млн строк:
|
Алгоритм |
off |
lz4 |
pglz |
zstd |
|---|---|---|---|---|
|
Холодный запуск |
31 601 |
11 166 |
10 534 |
13 645 |
|
Кэш ОС |
3 447 |
5 657 |
6 000 |
9 890 |
|
Shared_buffers |
2 000 |
|||
При 100% нагрузке результаты показали практически обратный эффект. Сжатые таблицы быстрее поднимаются с диска. А еще есть один очень полезный эффект от сжатия — в кэше ОС помещается больше данных и там, где с несжатыми данными приходится уже работать с диском, со сжатыми таблицами — данные всё еще будут в кэше ОС. Таким образом, ваши 70 GB файлового кэша ОС превратятся в >200 GB.
Эффективность записи
Чтение — лишь одна сторона взаимодействия с дисковой подсистемой. Не менее важно понять, как компрессия влияет на скорость записи. Методика тестирования:
-
Отключаем checkpoint:
alter system set checkpoint_timeout to '24h'
alter system set max_wal_size to '200GB'
-
Сбрасываем статистику bgwriter и фиксируем данные о чекпойнте (для последующего сравнения):
select pg_stat_reset_shared('bgwriter');
select * from pg_stat_bgwriter;
SELECT * FROM pg_stat_checkpointer;
select checkpoint_lsn from pg_control_checkpoint();
-
Обновляем все строки таблицы:
update test_table set txt = txt || '.'
-
Контролируем что данные bgwriter и checkpoint не изменились и запускаем checkpoint:
checkpoint;
-
Фиксируем время;
-
Повторяем для сжатых таблиц;
-
Повторяем для таблиц с количеством строк 50 млн.
Полученные результаты оказались весьма показательны.
|
Алгоритм/ количество строк |
off |
LZ4 |
PGLZ |
zstd |
|
5 000 000 |
13 sec |
10 sec |
32 sec |
27 sec |
|
50 000 000 |
43 sec |
27 sec |
1 min 40 secs |
46 sec |
Протокол LZ4 показал эффективность выше чем без сжатия, то есть затраты процессора на сжатие страницы компенсируются экономией времени на запись на диск. А вот PGLZ оказался в аутсайдерах, он показал снижение эффективности около 3х раз. Плата за максимальную эффективность протокола zstd — предпоследнее место, однако с увеличением объема записываемых данных эффективность растет.
Сравнительная таблица
Соберем все результаты тестов в одну таблицу и проставим «плюсики» по эффективности.
|
Алгоритм |
off |
lz4 |
pglz |
zstd |
|
Эффективность сжатия |
- |
++ |
++ |
+++ |
|
Чтение без нагрузки |
-/+++ |
+++ |
++ |
+ |
|
Чтение под нагрузкой 100% |
-/+ |
+++ |
+++ |
++ |
|
Запись |
+ |
+++ |
- |
+ |
Заключение
В статье мы рассмотрели различные подходы к реализации компрессии страниц в PostgreSQL, показали связанные с ними архитектурные особенности и подробно разобрали механизм CSM, реализованный в Tantor Postgres. Проведенные эксперименты позволяют сделать несколько выводов:
-
практический эффект уменьшения размера базы данных полностью подтвержден. На реальных базах 1С коэффициент компрессии составил от 3 до 5 раз;
-
функция
csm_compress_analysisпозволяет с высокой точностью оценить потенциальный эффект компрессии еще до ее включения и подобрать оптимальный размер страницы для конкретной нагрузки; -
использование страниц фиксированного размера позволяет сохранить простую архитектуру хранения и избежать большинства накладных расходов, характерных для подходов с переменным размером страниц;
-
компрессия снижает объем операций чтения и записи, и по мере роста объема данных этот эффект становится все более заметным и может компенсировать дополнительные затраты процессора на сжатие и распаковку страниц;
-
нагрузочные испытания на базе 1С:ERP не выявили деградации производительности;
-
синтетические тесты показали, что на системах, где производительность ограничивается дисковой подсистемой, компрессия способна обеспечить заметный выигрыш.
Компрессию страниц имеет смысл оценивать не только по коэффициенту сжатия. Не менее важны архитектура механизма хранения, влияние на операции чтения и записи, write amplification и эксплуатационные характеристики системы в целом. Именно поэтому при разработке CSM основной целью стало не достижение максимально возможного коэффициента компрессии, а поиск сбалансированного решения, которое обеспечивает существенную экономию дискового пространства без усложнения архитектуры PostgreSQL.
Авторы статьи: Максим Трашков и Виталий Бусыгин.
Вступайте в нашу телеграмм-группу Инфостарт