Разгон PostgreSQL под 1С: optimize_for_1c, производительность, нагрузочное тестирование ~2400 сессий
База данных - HighLoad оптимизация
PostgreSQL под 1С:Предприятие 8.3 тянет отдельный список требований платформы: права роли, локаль кластера, патчи поведения и профиль нагрузки. На тысячах сеансов дефолтный кластер обычно упирается в блокировки и память на соединение; мы гоняли это на стенде СберТеха на Platform V Pangolin. Ниже, что меняли в конфигурации (optimize_for_1c, отказ от superuser, postgresql.conf) и что показал восьмичасовой прогон с порядка 2400 одновременных сессий.
1. Задача и контекст: корпоративный PostgreSQL для экосистемы 1С
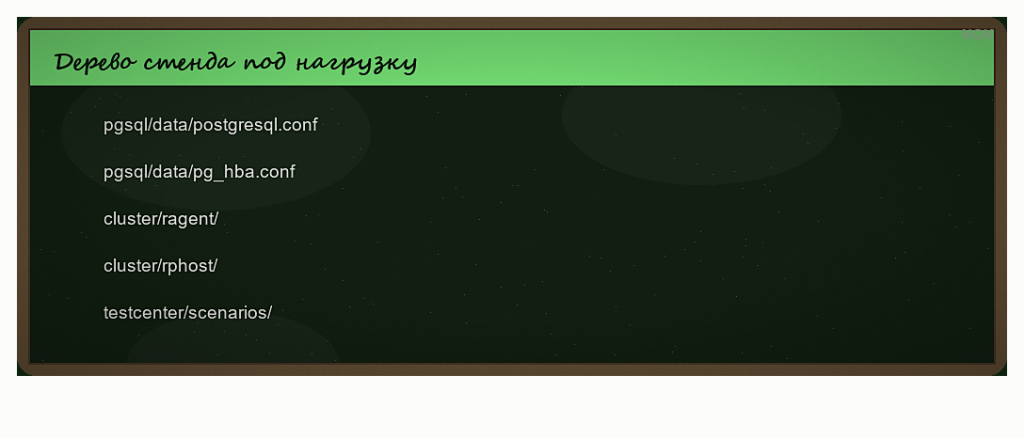
К 2022 году в Platform V Pangolin появилась линия поддержки 1С:Предприятие: формальные проверки совместимости, подтверждение от вендора 1С, попадание PostgreSQL из системных требований платформы 8 в перечень допустимых СУБД. Для администратора на практике это сводится к тому, что в ИТС фиксируют одобренные сборки и патчи под 8.3, а в проекте нельзя подставить «любой» PostgreSQL с Docker Hub и ждать штатного поведения платформы.
Параллельно в корпоративном контуре закрепили правило без superuser в прикладной зоне. Роль 1С должна создавать базы и тянуть штатные операции платформы, но не получать лишних привилегий на весь кластер.
Когда включили длительные прогоны, «ванильное» ядро и конфиг по умолчанию перестали совпадать с тем, как 1С держит транзакции, временные таблицы и блокировки. После каждого прогона меняли conf и патчи и фиксировали отдельный id прогона в тест-центре; обзор альтернативных СУБД здесь не тема.
1.1. Зачем отделять патчи 1С от «обычного» PostgreSQL
1С годами публикует патчи к PostgreSQL: операторы сравнения, типы данных, поведение планировщика. Смешать это с основной веткой без переключателя значит рисковать другими workload на том же дистрибутиве. Изменения под платформу собраны в режиме optimize_for_1c: включённый GUC подтягивает патчи и параметры, согласованные с платформой 8.3, выключенный оставляет кластер ближе к классическому PostgreSQL.
На «ванильном» PostgreSQL одноимённого GUC может не быть. Те же классы проблем (локаль, plantuner в сборках из системных требований 1С и Postgres Pro, лимиты блокировок) смотрите теми же инструментами. Если в вашем контуре нет optimize_for_1c, берите PostgreSQL из системных требований 1С или Postgres Pro, plantuner и тот же набор GUC из материалов ИТС; вместо Kintsugi обычно хватает pg_profile, log_lock_waits и технологического журнала 1С на стороне платформы.
1.2. Роль без superuser и типичная ловушка прав
Платформа исторически ожидала широкие права. Мы выделили роль с минимально необходимым набором по материалам администрирования 1С для PostgreSQL: право создавать базы (CREATEDB), работа с объектами внутри информационных баз, без прав суперпользователя на уровень кластера (изменение pg_hba, pg_reload_conf от имени postgres и тому подобное). Если после миграции с «postgres с паролем администратора» пропадает создание информационной базы, первым делом смотрим grants и membership, а не перезапускаем кластер вслепую. На открытом PostgreSQL ту же картину собираем запросом к pg_roles и системным каталогам.
Чтобы быстро увидеть, под кем висит сессия платформы и не упирается ли она в лимит прав, удобен срез активности:
SELECT
    sa.pid,
    sa.usename,
    sa.application_name,
    sa.state,
    sa.wait_event_type,
    sa.wait_event,
    left(sa.query, 120) AS query_preview
FROM pg_stat_activity AS sa
WHERE sa.datname = current_database()
  AND sa.pid <> pg_backend_pid()
ORDER BY sa.state, sa.pid;
В колонках wait_event_type и wait_event ищем Lock, LWLock, IO. ShareLock on transaction в тексте log_lock_waits относится к блокировкам транзакций (MVCC), а не к lightweight lock LockManager; при высокой конкуренции оба слоя могут всплывать рядом. На первом прогоне доминировал transaction lock; LWLock:lock_manager смотрели отдельно там, где он был в wait_event или на flame graph. LockManager в тексте оставляем, если виден LWLock:lock_manager, а не по одной строке лога без сверки с pg_stat_activity.
Если при штатном входе пользователя state долго idle in transaction, а query_preview обрывается на системном запросе платформы, чаще виноваты блокировки или неудачный план, а не «медленный диск».
2. Нагрузочный стенд и как мы измеряли результат
Тест-центр отдаёт APDEX и сырые агрегаты по операциям. На диаграмме видно, как контур «запрос сценария, ответ с метриками» стыкуется с тем, как мы сравнивали среднее время операций и ops/sec, а не только пороги APDEX.
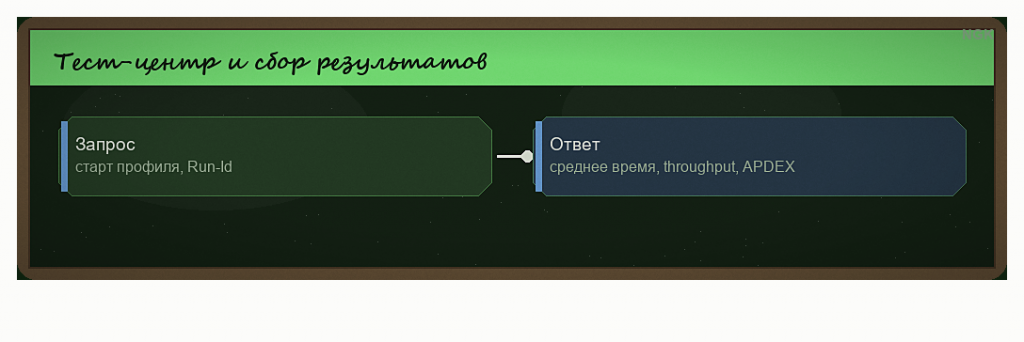
У каждого прогона свой идентификатор. Без него сравнение правок postgresql.conf теряет смысл.
Стенд собирала команда стенда вместе с нами: физический сервер СУБД на мощной машине в облачном контуре, ферма из восьми серверов кластера публикации 1С и терминальные серверы. Терминалы и rphost крутились в виртуализации, PostgreSQL остался на «железе», чтобы отделить узкие места СУБД от шума гипервизора на стороне приложения.
2.1. Сценарий через тест-центр 1С
На прикладном уровне взяли тест-центр из поставки одного из пакетов 1С, тот же инструмент, что у внедренцев. Он гоняет типовые пользовательские цепочки, фиксирует длительности и даёт сводку в терминах APDEX. APDEX удобен для SLA, но сильно завязан на ожидаемое время отклика в профиле.
Для сравнения до и после тюнинга postgresql.conf и ядра мы опирались на среднее время операций и среднее число операций в единицу времени. Эти величины не зависят от субъективных порогов и лучше показывают, сдвинулась ли производительность после правок work_mem или после разбора блокировок.
2.2. max_connections и архитектура публикации 1С
На стенде подняли max_connections до 2500, осознанное отклонение от типовых рекомендаций «около 1000». Увеличение max_connections не отменяет модель «один rphost, свои подключения к СУБД»: каждый рабочий процесс держит свои сессии, число сеансов платформы умножается на фоновые и служебные запросы.
Больший лимит в PostgreSQL снимает только искусственный потолок. Без балансировки сеансов по серверам кластера можно упереться в CPU на стороне 1С раньше, чем в память postmaster. Сверяем три числа: лимит max_connections, пик pg_stat_activity и настройки кластера 1С (число процессов, блокировка сеансов, распределение по узлам). Плюс лимиты ОС: ulimit на процессы, kernel.sem. Postmaster поднимает отдельный backend на соединение, overhead растёт быстрее, чем кажется по одной строке в конфиге; idle in transaction на сотнях сессий тоже съедает RAM.
3. Инструменты диагностики: от pg_profile до flame graph
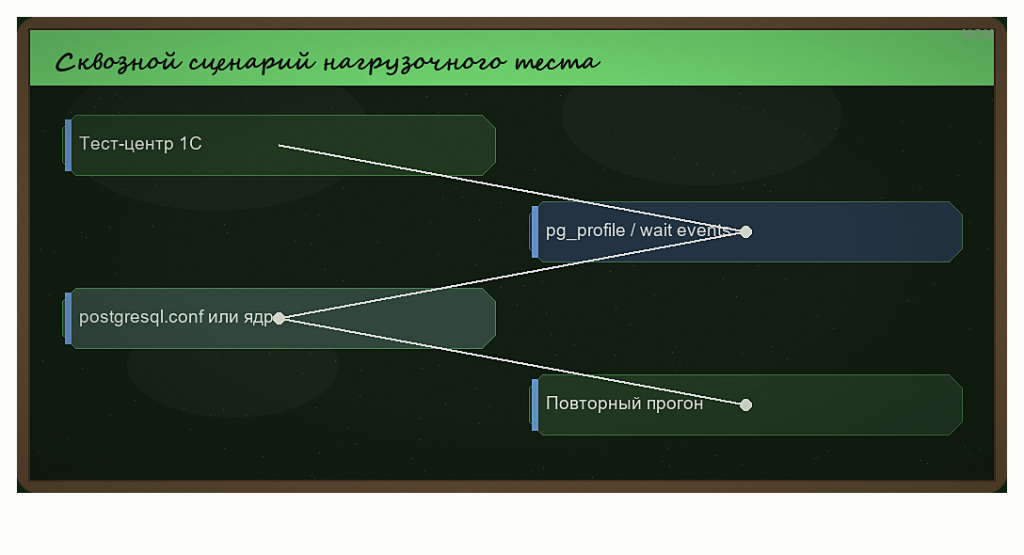
Окно pg_profile подбираем под пик тест-центра, а не под календарь DBA. Сначала фиксируем id прогона в тест-центре, потом снимаем pg_profile на тот же интервал; иначе сравнение conf бессмысленно.
По загрузке CPU не отличить блокировки от плохого плана, нужен стек от тест-центра до wait events и SQL. На уровне PostgreSQL базой стал pg_profile (при необходимости со своими отчётами): срезы по wait events, топ SQL, сравнение интервалов нагрузки. В контуре Pangolin для сессий в реальном времени использовали корпоративный мониторинг (в документации контура он может называться Performance Insights); на открытом PostgreSQL тот же класс задач частично закрывают pg_stat_statements плюс дашборды в Grafana или Zabbix по pg_stat_activity.
Параллельно для трассировки сессий PostgreSQL на стенде опрашивали pg_stat_activity с фиксированным интервалом (порядка секунды в пик), сохраняли pid, application_name, wait_event и метку времени и стыковали с интервалами операций тест-центра по часам прогона. log_min_duration_statement включали точечно, чтобы не утопить диск логами: порог ставили так, чтобы в выборку попадали только запросы, которые реально мешают SLA тест-центра.
Когда подозрение падает на блокировки, на «ванильном» PostgreSQL без Kintsugi смотрим pg_locks в связке с pg_stat_activity и при необходимости подключаем расширение pg_wait_sampling, если оно есть в сборке. auto_explain с log_nested_statements помогает поймать внезапный nested loop на временных таблицах 1С после смены статистики.
Картина блокировок в момент регламентной операции (закрытие периода, массовое проведение):
SELECT
    bl.pid AS blocked_pid,
    ka.query AS blocking_query,
    a.query AS blocked_query,
    bl.mode AS blocked_mode,
    kl.mode AS blocking_mode
FROM pg_locks AS bl
JOIN pg_stat_activity AS a ON a.pid = bl.pid
JOIN pg_locks AS kl
    ON kl.locktype = bl.locktype
   AND kl.database IS NOT DISTINCT FROM bl.database
   AND kl.relation IS NOT DISTINCT FROM bl.relation
   AND kl.page IS NOT DISTINCT FROM bl.page
   AND kl.tuple IS NOT DISTINCT FROM bl.tuple
   AND kl.virtualxid IS NOT DISTINCT FROM bl.virtualxid
   AND kl.transactionid IS NOT DISTINCT FROM bl.transactionid
   AND kl.classid IS NOT DISTINCT FROM bl.classid
   AND kl.objid IS NOT DISTINCT FROM bl.objid
   AND kl.objsubid IS NOT DISTINCT FROM bl.objsubid
   AND kl.pid <> bl.pid
JOIN pg_stat_activity AS ka ON ka.pid = kl.pid
WHERE NOT bl.granted;
В пике тяжёлый join по pg_locks лучше не гонять постоянно: снимайте через pg_wait_sampling или консоль Kintsugi, ad-hoc запрос делайте на копии или коротким окном.
Если blocked_mode и blocking_mode указывают на RowExclusive и ShareLock одновременно на одних и тех же relation, а blocked_query содержит шаблон платформенного UPDATE регистра, дальше копаем длительность транзакций и параллелизм регламентов, а не индексы конфигурации. Для transaction lock сверяем locktype и mode в pg_locks с wait_event_type Lock в pg_stat_activity.
На нижнем уровне perf record и flame graph показывали, где в ядре застревает время: lock менеджер, буферный менеджер, сортировки под work_mem. Участки стека, которые повторялись от прогона к прогону, становились аргументом за точечный патч, а не за очередное увеличение shared_buffers.
4. Platform V Kintsugi в сопровождении высокой нагрузки
Kintsugi, графическая консоль сопровождения Platform V: нагрузка по кластерам, ожидания, фильтры по сессиям, блокировкам, хостам. В пик теста с ~2400 сессиями она сокращала путь от «тормозит проведение» до конкретного wait event: меньше ручного перебора pid.
Если Kintsugi недоступна, тот же класс задач закрываем связкой pg_stat_activity с частым опросом, pg_profile или pg_stat_statements, логи PostgreSQL с log_lock_waits на время расследования и технологический журнал 1С на стороне платформы. Сводите метки тест-центра с pg_stat_activity по времени; без этого не поймёте, какая операция сценария села на Lock.
5. Первые шаги адаптации: optimize_for_1c, роли, локаль, postgresql.conf
В дистрибутиве с optimize_for_1c патчи поведения не смешиваются с прочими нагрузками. Чаще всего забывают локаль при initdb, роль без superuser и перезапуск с plantuner в shared_preload_libraries.
5.1. Локаль ru_RU.UTF-8 на этапе initdb
Прикладное создание информационной базы локаль кластера не задаёт. Если initdb прошёл с C или en_US, сортировки и сравнения строк для русскоязычных данных могут вести себя иначе, чем ожидает платформа. Кластер инициализируем с ru_RU.UTF-8 явно.
У Postgres Pro в материалах для 1С встречается профиль tune при initdb; смысл один: зафиксировать локаль до первой базы 1С.
5.2. pg_hba.conf и password_encryption
Цепочка «платформа, ODBC или драйвер PostgreSQL, pg_hba.conf» до сих пор встречается с MD5 в настройке password_encryption. Мы сознательно оставляем md5 там, где стек аутентификации платформы ещё не переведён на SCRAM; в дорожной карте внедрения заложите переход на scram-sha-256 и проверку драйвера до смены алгоритма в бою.
При миграции на scram-sha-256 проверяем метод в pg_hba (scram-sha-256), версию платформы 8.3, сборку драйвера и пересоздание пароля роли после смены алгоритма. Смешение md5 в hba и scram в postgresql.conf даёт отказ входа без понятной ошибки на стороне 1С. Актуальную связку «платформа + драйвер + СУБД» на дату внедрения сверяйте с ИТС и release notes; номера релизов здесь не фиксируем.
5.3. Блок параметров postgresql.conf по рекомендациям 1С
Актуальный перечень для сборок PostgreSQL из системных требований 1С к платформе 8 и в материалах по администрированию; для Postgres Pro отдельно описаны plantuner и plantuner.fix_empty_table для пустых таблиц, которые 1С создаёт пачками при работе с временными данными. Строки с plantuner и optimize_for_1c относятся только к совместимым сборкам, которые публикует 1С; на чистом PostgreSQL без модуля plantuner их копировать нельзя, начните с проверки списка СУБД в ИТС.
Рабочий фрагмент, который накатываем после включения optimize_for_1c и перезапуска с shared_preload_libraries:
# фрагмент postgresql.conf под 1С:Предприятие 8.3
# plantuner и optimize_for_1c — только в сборках из системных требований 1С
optimize_for_1c = on
shared_preload_libraries = 'plantuner'
plantuner.fix_empty_table = on

temp_buffers = 256MB
work_mem = 64MB
max_locks_per_transaction = 256
random_page_cost = 1.1
geqo = on
geqo_threshold = 12
collapse_limit = 8
standard_conforming_strings = off
escape_string_warning = off
row_security = off

password_encryption = md5
max_connections = 2500
Память. temp_buffers задаётся на backend (на сессию), не на весь кластер. Значение 256 MB с нашего стенда, не универсальная константа. Оценку RAM для пика считаем грубо так: число одновременно активных backend умножаем на work_mem, добавляем запас на temp (temp_buffers у активных сессий с временными таблицами) и shared_buffers; умножать 256 MB на все 2500 соединений нельзя, но и игнорировать сотни параллельных сортировок с work_mem 64 MB нельзя. temp_buffers и work_mem подбираем под RAM и пиковое число активных запросов: 1С активно использует temporary tables, урезание work_mem бьёт по сортировкам в отчётах.
Планировщик. random_page_cost около 1,1 как в рекомендациях 1С для SSD; на массивах с кэшем СХД и на медленных SATA уточняйте по планам и соотношению seq/idx scan на вашем железе. От geqo снизили collapse_limit при geqo_threshold 12 (см. фрагмент конфига): при наших профилях запросов планы на широких JOIN стали предсказуемее.
Блокировки и совместимость. max_locks_per_transaction на 256 связан с большим числом объектов метаданных в типовых конфигурациях; занижение даёт ошибки при обновлении конфигурации или реструктуризации. row_security отключают: RLS на уровне PostgreSQL 1С не использует как основной механизм разграничения.
После рестарта СУБД делаем смоке-тест сеанса и связки платформа, PostgreSQL: минимальный запрос из той же информационной базы, что участвует в прогоне (у нас 1С:Управление холдингом). Полная приёмка plantuner, восстановление dt и блокировки при регламентных операциях, в чек-листе 5.4.
Фрагмент для регламентного задания или одноразовой проверки после рестарта:
Запрос = Новый Запрос;
Запрос.Текст =
"ВЫБРАТЬ
|   1 КАК ПроверкаСоединения";

Попытка
    Результат = Запрос.Выполнить();
    Если Результат.Пустой() Тогда
        ВызватьИсключение "После рестарта PostgreSQL нет ответа от информационной базы";
    КонецЕсли;
Исключение
    ВызватьИсключение "После рестарта PostgreSQL: " + ОписаниеОшибки();
КонецПопытки;
Если запрос падает по таймауту, а pg_stat_activity показывает Lock на системных таблицах, возвращаемся к чек-листу приёмки, а не к настройкам кластера 1С.
5.4. Чек-лист приёмки после изменений
После правок postgresql.conf задачу не закрываем, пока не пройден короткий чек-лист. Перезапуск с проверкой, что plantuner поднялся (в логе postmaster нет ошибки загрузки shared_preload_libraries).
Дальше: создать пустую информационную базу, восстановить из dt, зайти тонким клиентом. Контрольный прогон регламентной операции в копии базы с мониторингом pg_locks. Сравнение conf годится только когда время операций тест-центра ложится на те же минуты, что срез pg_profile; иначе результат прогона врёт.
6. Тест 1С:Управление холдингом (~2400 сессий): что показала нагрузка
Первый длинный сценарий выбрали на 1С:Управление холдингом: около восьми часов непрерывного прогона, порядка 2400 одновременных сессий по данным стенда. Тест-центр шёл параллельно с мониторингом СУБД; APDEX смотрели, но решения принимали по среднему времени операций и по числу операций в единицу времени.
В материалах кейса стартовый симптом называли конкуренцией в LockManager; по wait_event и pg_locks на первом прогоне ведущим был transaction lock (ShareLock on transaction), LWLock:lock_manager там, где зафиксирован в мониторинге. Диск и rphost запас были; упёрлись в очереди ShareLock on transaction после включения optimize_for_1c и базового postgresql.conf: те же строки в log_lock_waits, конкурирующие transactionid в pg_locks, у части баскенд-процессов wait_event_type Lock в pg_stat_activity.
Kintsugi группировал такие сессии по интервалам тест-центра; flame graph показывал заметную долю времени в lock-related стеках. На этом прогоне главным был transaction lock; LWLock:lock_manager не подменяем им в отчётах без факта в wait_event.
Фрагмент лога ниже обезличенный и с синтетическими числами. Он иллюстрирует тип log_lock_waits и длинный UPDATE регистра нагрузочной конфигурации; это не дословная выписка одного прогона и не отчёт с замерами «до/после».
<дата> <время> MSK [<pid>] <роль>@<база> LOG:  duration: 8423.117 ms  statement:
        UPDATE _AccRgXXXX SET _FldYYYY = $1 WHERE _IDRRef = $2
<дата> <время> MSK [<pid>] <роль>@<база> LOG:  process <pid> still waiting for ShareLock on transaction <txid> after 1000.042 ms
<дата> <время> MSK [<pid>] <роль>@<база> LOG:  process <pid> acquired ShareLock on transaction <txid> after 1667.901 ms
Дальше в том же цикле меняли по одному слою и снова гоняли сценарий тест-центра: точечные изменения в ядре под профиль 1С, уточнение postgresql.conf, повторные прогоны. «Тест 2» и последующие цифры здесь не публикуем, их не было в согласованной основе кейса.
На «ванильном» PostgreSQL без корпоративных патчей те же transaction lock всплывают при тысячах сессий. Отличие Pangolin в том, что optimize_for_1c и последующие правки ядра нацелены на сочетание паттернов блокировок 1С и MVCC PostgreSQL; флаг в Pangolin по смыслу близок связке патчей 1С и plantuner в сборках из ИТС. На открытом PostgreSQL разумный порядок тот же: воспроизвести нагрузку тест-центром или регламентным сценарием, включить log_lock_waits, снять pg_profile за окно пика и только потом трогать work_mem «на глаз».
Что вынести из кейса
Первый длинный прогон на ~2400 сессиях показал, что без optimize_for_1c и согласованного postgresql.conf платформа упирается в блокировки транзакций раньше, чем в «нехватку железа». Без роли без superuser и локали ru_RU.UTF-8 при initdb типовые ошибки создания ИБ останутся; один рост max_connections этого не компенсирует.
APDEX для SLA оставьте, а тюнинг postgresql.conf оценивайте по среднему времени операций и wait_event на том же id прогона. После правки конфигурации СУБД пройдите чек-лист из раздела 5.4, без него сравнение «до/после» некорректно.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

