Из Иванова приехали две фуры: как прятать персональные данные в падежах и прозвищах
Администрирование - Информационная безопасность
Менеджер открывает обсуждение реализации, выбирает в получателях "ИИ-оператора" и пишет: "Водитель Сидоров говорит, что груз сдал. Почему ЭТрН висит?"
Если вы ещё не работали с обсуждениями: это встроенный в платформу 1С чат, Система взаимодействия. Обсуждение открывают прямо из документа, и ИИ-оператор в нём - такой же получатель, как коллеги.
Сидорова в этом вопросе быть не должно. Почему ЭТрН висит, можно ответить и без него, ведь всё видно по титулам накладной. Но менеджер так думает и так пишет, а просить его "не называть людей" бесполезно. Завтра он напишет "Петрович опять встал на Каширке", послезавтра вставит в вопрос письмо клиента с телефоном и номером паспорта. Это нормальная рабочая речь.
Отвечает менеджеру языковая модель, а живёт она часто не в вашей серверной. Задача - чтобы она ответила по существу, но Сидорова так и не увидела. Ни фамилии, ни телефона, ни паспорта, ни Петровича.
В первой статье я описывал, как ИИ-оператор маскирует персональные данные (дальше ПДн) в ответах 1С: в выборках, отчётах, текстах ошибок. Там всё относительно спокойно: у данных из базы есть тип, поле и реквизит, и по ним понятно, что прятать. Эта статья - о другом входе: о тексте, который пишет живой человек. У такого текста нет ни типа, ни поля, зато есть падежи, прозвища, "саня зайцев" строчными и Иваново, которое город.
Приёмы ниже не привязаны ни к модели, ни к моему продукту. Они пригодятся всем, кто отправляет текст из 1С куда-то наружу: модели, подрядчику, в сервис распознавания.
Содержание
- Что значит "модель не видит"
- Токены вместо людей
- Данные из базы: коротко о том, что уже было
- Шаблоны без регулярных выражений
- Люди из базы в любом падеже
- Люди не из базы, или как я подгонял правила
- Маленькая модель как сито
- Как мерить, чтобы не врать себе
- Что можно обещать службе безопасности
- Ограничения
Что значит "модель не видит"
Начну с формулировки, потому что от неё зависит всё остальное. "ПДн не покидают 1С" - неправда. Вопрос менеджера и ответ бота остаются в обсуждении, а сообщения Системы взаимодействия лежат не в информационной базе, а в отдельном сервисе. Если это облачный 1С:Диалог, переписка вместе с Сидоровым покидает компанию и хранится на серверах фирмы 1С. Если Сервер взаимодействия развёрнут на своих серверах, она остаётся внутри контура. Честное обещание другое: модель не видит ПДн. Ни из базы, ни из вопроса пользователя.
И ещё важная оговорка. Спрятать что-то из вопроса можно, только если он сначала попадает в 1С. Внешний чат-клиент, подключённый к 1С по MCP (Model Context Protocol - протокол, по которому модель вызывает внешние инструменты), отправляет текст модели напрямую. 1С в такой схеме прячет только свои ответы. Поэтому описанное ниже работает в чате внутри 1С: в обсуждениях, где ИИ-оператор - один из получателей.
С этим обещанием и будем работать. Оно проверяемо: перед моделью ставим прокси, он записывает каждый запрос, а в записях ищем фамилии и номера. Вопрос про Сидорова был и в приёмочных прогонах, только водитель там из демо-базы. Его фамилии нет ни в одном запросе к модели.
Токены вместо людей
Первое желание - вырезать ПДн или заменить звёздочками. Идея плохая. Сравните, что получит модель:
- "Водитель *** говорит, что груз сдал. *** звонил вчера, а *** ничего не получил". Кто кому звонил, уже не понять.
- "Водитель [ФИО#1] говорит, что груз сдал. [ФИО#1] звонил вчера, а [ФИО#2] ничего не получил". Смысл на месте.
Отсюда три правила.
Один человек - один токен на весь разговор. Сидоров в вопросе, Сидоров в ответе инструмента и "Сидоров А.П." в тексте ошибки проведения должны стать одним [ФИО#1]. Иначе модель решит, что людей трое.
Токен можно вернуть обратно. Если модель вызывает инструмент с [ФИО#1] в параметрах ("найди перевозки, где водитель [ФИО#1]"), 1С перед выполнением подставит настоящее ФИО. Модель находит нужного Сидорова, ни разу не увидев его фамилии.
Пользователь читает настоящие данные. Ответ модели перед показом проходит обратную замену. Менеджер видит "Сидоров", модель - [ФИО#1], и обоим удобно.
Словарь "токен ↔A038; значение" при работе через MCP живёт в памяти клиента 1С. Бот в обсуждении обрабатывает каждое сообщение в отдельном фоновом задании, а разговор тянется часами. Поэтому у бота словарь лежит в базе, в регистре, к которому нет доступа ни у одной роли. Через сутки записи удаляются. Чего это стоит, разберём в разделе про службу безопасности.
Кстати, токены модель ничуть не смущают. На просьбу "назови ИНН и телефоны физлиц" она честно отвечает, что видит одни токены, и предлагает открыть список в 1С: там пользователю видно всё.
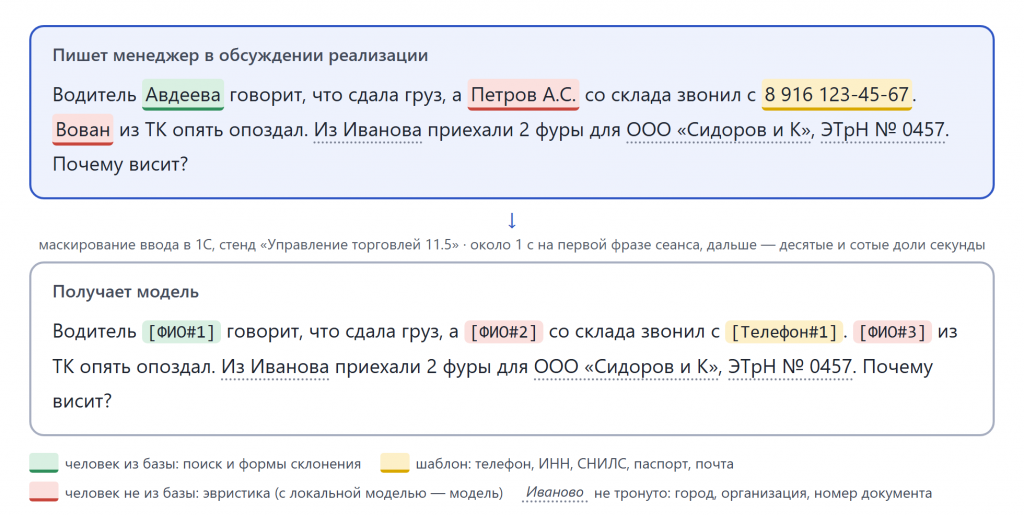
Что написал менеджер и что получила модель. Настоящий результат маскирования на демо-базе УТ без локальной модели: людей не из базы нашла эвристика. Люди вымышленные
Данные из базы: коротко о том, что уже было
Подробно об этом - в первой статье, здесь только суть. Что-то из этого почти наверняка пригодится и вам.
- По типу ссылки. Физлица, пользователи, контактные лица, контрагенты-ИП отдаются токеном вместо представления.
- По полю. Реестр "объект - поле - вид ПДн" с преднастройкой под конфигурацию. Администратор меняет его в форме, а в регистр записываются только отличия от преднастройки: так обновление не сотрёт его правки.
- Условие проверяется по значению, а не по строке запроса. ИНН юрлица открыт, ИНН физлица скрыт. Но ИНН лежит и в регистрах, где ссылки на контрагента рядом нет: в журнале счетов-фактур, после группировки, во временной таблице. Поэтому значение проверяется одним запросом на поле: "у каких объектов встречается этот ИНН". Только у юрлиц - открываем, есть у физлица - прячем. Запрос идёт в привилегированном режиме: иначе ИНН, который есть и у скрытого от пользователя физлица, окажется открытым.
- Колонки запроса прослеживаются по
СхемаЗапросачерез временные таблицы, вложенные запросы и объединения. Всё, что проследить не удалось, считается ПДн. Лучше спрятать лишнее, чем объяснять потом, откуда утечка. - Тексты ошибок. "Не заполнен паспорт сотрудника Сидорова А.П." - человек, которого модель ещё не видела. Поэтому вместе с ошибкой инструмент отдаёт контекст: людей из реквизитов документа. Ядро выдаёт им токены и заменяет в тексте, а сам контекст из ответа удаляет.
Главный вывод отсюда простой: прятать ПДн нужно в одной точке, через которую проходит всё. Если поручить это каждому инструменту, рано или поздно кто-нибудь забудет.
Шаблоны без регулярных выражений
Номера - самая благодарная часть: у ИНН, СНИЛС, телефона и паспорта есть форма. Но и тут не без нюанса. Расширение собрано в режиме совместимости 8.3.20, а там нет СтрНайтиПоРегулярномуВыражению. Так что цифры разбираются руками, посимвольно, группами через пробел, дефис и скобки.
Что ищем:
- 12 цифр подряд - ИНН физлица. 10 цифр - ИНН юрлица, он открыт;
- 11 цифр - телефон или СНИЛС в форме 3-3-3-2; 10 цифр со скобкой или в форме 3-3-2-2 - телефон;
- паспорт - 2-2-6 или 4-6;
- адрес почты.
Самое интересное здесь - что не трогать, иначе модель не сможет работать с документами:
- номера с "00" в начале: "00УТ-001245" - номер реализации, а не телефон;
- суммы с разрядами по три: "1 284 560,00" - сальдо, а не СНИЛС;
- уникальные идентификаторы ссылок;
- "КПП 502901001" рядом с ИНН юрлица.
Если последовательность целиком не подошла, проверяется каждая группа отдельно: так и находится ИНН, приклеенный к КПП. А жизнь всё равно придумает что-то новое. Последним пришёл паспорт в записи "серия 45 10 номер 223344": между серией и номером стоит слово, и шаблон, ждавший номер сразу после серии, его пропустил. Пришлось научить.
Люди из базы в любом падеже
Теперь сам Сидоров. Если человек есть в базе, его можно найти точно, а не угадывать. Алгоритм такой:
- Берём группы слов с заглавной буквы: "Водитель Сидоров" → "Сидоров".
- Ищем кандидатов среди объектов, у которых вид ПДн - "ФИО": физлица, пользователи, контактные лица.
- Каждого кандидата подтверждаем формами склонения его ФИО: "Сидорову" должно совпасть с дательным падежом "Сидоров Алексей Петрович".
- Найденному даём тот же токен, что дала бы ссылка на него в ответе инструмента. Тогда
[ФИО#1]из вопроса и[ФИО#1]из данных ЭТрН - один человек.
На каждом шаге есть грабли.
Склонение. У платформы есть ПолучитьСклоненияСтроки, но без параметра языка она молча возвращает строку как есть. Ни ошибки, ни склонения:
// Так работает. Без "Л=ru_RU" вернётся исходная строка.
Склонение = ПолучитьСклоненияСтроки(Представление, "Л=ru_RU", "ПД=Дательный")[0];
Именно так её вызывает БСП в СклонениеПредставленийОбъектов. Платформа склоняет и "Ким", и "Цой", а вот "Юн" оставляет без изменений, хотя говорят "у Юна". Таким несклонённым частям на согласную формы -а, -у, -ом, -е добавляются вручную.
Поиск кандидатов. Полнотекстовый поиск платформы понимает морфологию. Найдёт "Абрамову", "Белкиной" и даже "Гену", потому что в словаре синонимов Гена - это Геннадий. Нарицательные "белка" и "кудри" не находит, и это приятно.
Неприятно другое: морфология словарная. На демо-базе УТ "Яковлева", "Суркову", "Тимофеевой" находятся во всех падежах, а "Чиркова", "Усориным", "Тюренковой" - нет. Редкую фамилию поиск знает только в именительном падеже. Нечёткий поиск (Чиркова#) тоже ничего не дал. Помогла основа слова со звёздочкой:
// Чиркову ищем как "Чиркову" | Чирков*
СтрокаПоиска = """" + Слово + """ | " + Основа + "*";
Список = ПолнотекстовыйПоиск.СоздатьСписок(СтрокаПоиска, 50);
Слово взято в кавычки, иначе "Или" и "Не" в начале фразы станут операторами поиска. А лишнее, что приносит звёздочка ("Петров*" находит и "Петровскую"), отсеет шаг 3 - проверка по формам склонения.
Ещё два сюрприза. Поиск смотрит во все реквизиты, и "Москва" находит Абрамова по месту рождения. Поэтому ищем только слова, похожие на часть ФИО, и проверяем, в каком реквизите совпало. Кроме того, в демо-базах полнотекстовый поиск часто выключен. Включить его на базе с ботами Системы взаимодействия - отдельное приключение: смена режима требует монопольного доступа, а системные задания ботов перезапускаются раз в минуту.
Запасной путь без полнотекстового поиска - запрос по началу наименования. Первым в голову приходит ПОДОБНО "Чирков%", но с ним индекс не работает. А диапазон идёт по индексу:
// Чиркову -> основа Чирков -> от "Чирков" до "Чирковх" (последняя буква следующая)
|ГДЕ
|   Таблица.Наименование >= &Начало
|   И Таблица.Наименование < &Конец
Для коротких фамилий вроде "Ли" по началу найдётся пол-справочника ("Лиза", "Липатов"…). Поэтому короткая фамилия ищется как первое слово наименования целиком, от "Ли " (с пробелом) до "Ли!". Запасной путь находит фамилию в любом падеже, а имя без фамилии - нет. Для этого и нужен полнотекстовый поиск.
Начало предложения. "Вера" и "Роза" в начале фразы - ещё не люди: с заглавной там пишется всё. Одно слово в начале предложения считается человеком из базы, только если совпало с фамилией.
Люди, которых пользователь не видит. Поиск идёт в привилегированном режиме. Если у менеджера нет прав на карточку Сидорова, Сидоров от этого не перестаёт быть персональными данными.
На корпусе из 110 фраз логиста (о корпусах подробнее ниже) люди из базы находятся все: 0 пропусков из 43, за 15-80 мс на фразу. На слепых корпусах правила иногда промахивались и здесь: человек из базы, названный только по отчеству ("Петрович"), или латиницей ("Alexey Skovorodkin"). Таких ловит следующий слой.
Люди не из базы, или как я подгонял правила
Хуже всего с людьми, которых в базе нет. "Вован из ТК опять опоздал", "передай ковальчуку, что рейс отменён", "Мухаммад Рахимов, водитель-экспедитор". Сверять не с чем, остаются признаки.
Я честно написал эвристику:
- инициалы: "Сидоров А.П.", "А.П. Сидоров";
- окончания фамилий: -ов, -ин, -ский, -ук, -дзе, -швили, -ян;
- словарь имён с падежами и разговорными формами;
- слово после "водитель", "экспедитор", "у", "для", "передай", "скажи";
- прозвища по отчеству: "Петрович", "Валерьич";
- адрес частного лица: "улица … квартира N".
Чтобы измерить качество, нужен корпус: фразы с разметкой "вот здесь человек, а вот здесь ловушка". Я собрал 110 фраз:
- 40 с людьми из базы;
- 25 с людьми не из базы;
- 30 ловушек;
- 15 с номерами и контактами.
Первый прогон дал 44 % пропусков людей не из базы. Я посмотрел на ошибки, поправил правила и получил 12 %. Красота.
Но этот корпус я писал сам и знал свои правила, а значит, невольно подбирал фразы, которые они понимают. Нужен был автор, который правил не видел. Коллегу на сто десять фраз про Вовчиков не уговоришь, поэтому второй корпус написала языковая модель в отдельной сессии. Она получила только задание: фразы логиста, разметка людей, номеров и ловушек. Ни правил, ни кода, ни первого корпуса она не видела. Такой корпус я дальше называю слепым.
На нём те же правила пропустили 29 % людей не из базы и дали 5 % ложных срабатываний. Я исправил то, что он нашёл. Третий корпус, тоже слепой, с уменьшительными именами, сканами прописными и письмами с латиницей: 36 % пропусков. Поправил ещё раз. Четвёртый: 24 %.
Каждый следующий корпус открывал новый класс ошибок. Вот неполная коллекция пропусков:
- Вовчик, Жорик, Тимоха, Оксанка, Сергеич;
- "саня зайцев" и "рустама хабибуллина" строчными, как надиктовал голосовой ввод;
- ЯРОШЕВИЧ АЛЯКСАНДР ПЯТРОВІЧ из скана ТТН;
- Zhang Wei, Emily Carter и Hans-Peter Vogel из писем поставщиков;
- "ТК Деловые Линии Оксана Петровна": человек прятался прямо за названием перевозчика.
А вот что эвристика принимала за людей:
- "клиент Эльдорадо", ведь после слова "клиент" обычно стоит человек;
- "Новосибирской области" и "на Казанском складе", раз окончание как у фамилии;
- "сгущенка Рогачёв";
- "ТД Петрович": в сети строительных магазинов тоже, оказывается, есть отчество;
- "из Иванова приехали 2 фуры": в базе нашёлся человек по фамилии Иванов, и город превратился в него.
Ловушки корпуса тоже стоит перечислить, они прекрасны: "Мишка косолапый" вернули по браку, "Магазин на улице Пушкина просит доставку в субботу", "грузоотправителем стоит ООО 'Сидоров и К'". Любая из них обидно ломает простое правило "слово с заглавной и окончанием фамилии".
Вывод пришёл не сразу: правила обобщаются слабо. Выбрасывать их не нужно: людей из базы и номера по шаблонам они ловят надёжно, эвристика тут ни при чём. Но хвост живой речи правилами не закрыть. Каждая правка лечит только то, что вы уже видели.
Маленькая модель как сито
Раз правилам хвост не по зубам, отдадим его тому, кто понимает живую речь, - языковой модели. Только локальной: исходный текст с ПДн не должен уйти туда, откуда мы его и прячем.
Схема получилась такая.
- Правила прячут то, что знают наверняка: шаблоны, словарь диалога, людей из базы.
- Локальная модель получает текст, где всё это уже заменено токенами, и возвращает список людей и домашних адресов, дословно как в тексте.
- Каждая строка из ответа ищется в тексте как целое слово. Чего в тексте нет, то отбрасывается: выдумка модели ничего не сломает. "Ян" внутри "Января" тоже не заменится.
- Найденное получает токены, и только после этого текст уходит основной модели.
Промпт короткий. Главное в нём - что не считать человеком:
Верни JSON: {"people": ["...", ...]} — каждую строку дословно так, как она написана в тексте,
без изменения падежа и букв.
Человек — это имя, фамилия, отчество, инициалы, прозвище или уменьшительное имя конкретного
человека, в любом сочетании, написанное кириллицей или латиницей, с заглавной или строчной буквы.
Не относятся: города, страны, улицы складов, названия организаций и магазинов (даже если
похожи на фамилию), товары и бренды, должности и роли без имени, номера документов, даты, суммы.
Метки в квадратных скобках вида [ФИО#1] уже скрыты — не возвращай их.
Ответ ограничен JSON-схемой, температура нулевая. Ещё одна важная настройка: рассуждение выключено. С ним Gemma 4 26B-A4B давала тот же ответ за 36 секунд вместо 6. Сейчас на домашней видеокарте с 12 ГБ памяти фраза обычно занимает 2-4 секунды, в запросе около 300 токенов.
Чтобы исходный текст случайно не уехал наружу, в коде стоит проверка. Если адрес модели маскирования не локальный (не localhost и не частная сеть), слой модели выключается и работает эвристика. Лучше так, чем сэкономить на видеокарте и отправить Сидорова в облако с пометкой "найди тут Сидорова".
Результат. На пятом слепом корпусе (110 фраз про перевозки и ЭТрН; модель, которая его писала, не видела ни правил, ни промпта маскирования):
- люди из базы - 0 пропусков из 31;
- люди не из базы - 0 из 33;
- смешанные фразы - 1 пропуск из 40: паспорт в записи "серия … номер …";
- ложные срабатывания - 3 из 180 (1,7 %), все три - города, совпавшие с фамилиями людей из базы.
Интереснее другое: модель почти не принимает за людей лишнего. На корпусе, где у правил было 3 % ложных срабатываний, она без всяких правил прошла 123 ловушки и не ошиблась ни разу. Лишнее прятали мои эвристики, а не модель. Поэтому при доступной модели эвристика для людей не из базы выключена: шаблоны и люди из базы работают всегда, а хвост достаётся модели. Не ответила - эвристика возвращается запасным путём.
И сюжетный поворот напоследок. Когда я научил правила не прятать "Иванова" в "Из Иванова приехали 2 фуры", это слово начала возвращать модель. Пришлось ставить фильтр мест и на её находки: одно слово из справочника мест после "из", "в", "до", "под" - город, кто бы ни сказал иначе.
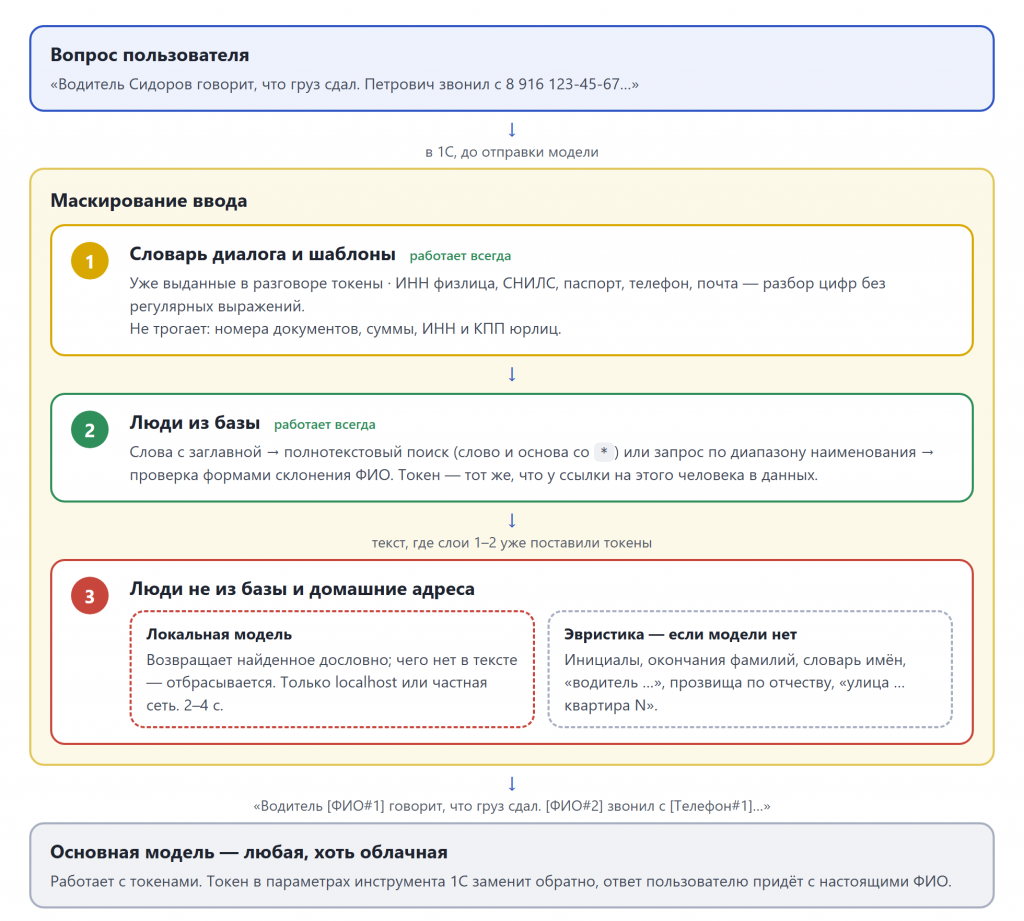 Три слоя маскирования вопроса
Как мерить, чтобы не врать себе
Эта часть мне кажется самой полезной, даже если вы не прячете ПДн, а просто чему-то учите правила.
Цифры на корпусе, по которому вы подгоняли правила, врут. Не со зла: вы просто закрыли ровно те ошибки, которые видели. 12 % на "своём" корпусе превратились в 29-36 % на чужом. Если бы я остановился на первом корпусе, в документации сейчас стояли бы 12 %.
Поэтому:
- Слепой корпус пишется без доступа к правилам, промпту и прежним корпусам. Подойдёт коллега или языковая модель в отдельной сессии, которой не показывали код. Модель удобнее: не устаёт на сотой фразе и охотно придумывает Жориков.
- Один раз. После правок по его ошибкам он становится регрессионным, а честную оценку даст только следующий слепой.
- Пороги заранее. У меня так: люди из базы - 0 пропусков, люди не из базы - не больше 10 %, ложные срабатывания - не больше 2 %. Ложные срабатывания тоже вредят: если модель вместо "Эльдорадо" получит
[ФИО#3], она не поймёт, о каком клиенте речь. - Отдельно считать группы. "Люди из базы", "не из базы", "смешанные фразы", "ловушки". Общий процент прячет главное: пропуск человека из базы недопустим, а лишний токен на "ТД Петрович" - досадно, но терпимо.
- Каждая правка - с тестом, который краснеет без неё. Иначе через месяц правки по пятому корпусу тихо сломают третий.
Для отладки в настройках есть форма "Проверить фразу". Вводите текст и видите, что получит модель: где токены, кто их поставил (база, словарь и шаблоны, модель, эвристика или список слов администратора) и была ли модель доступна. Администратору это заодно отвечает на вопрос "а почему он спрятал Эльдорадо".
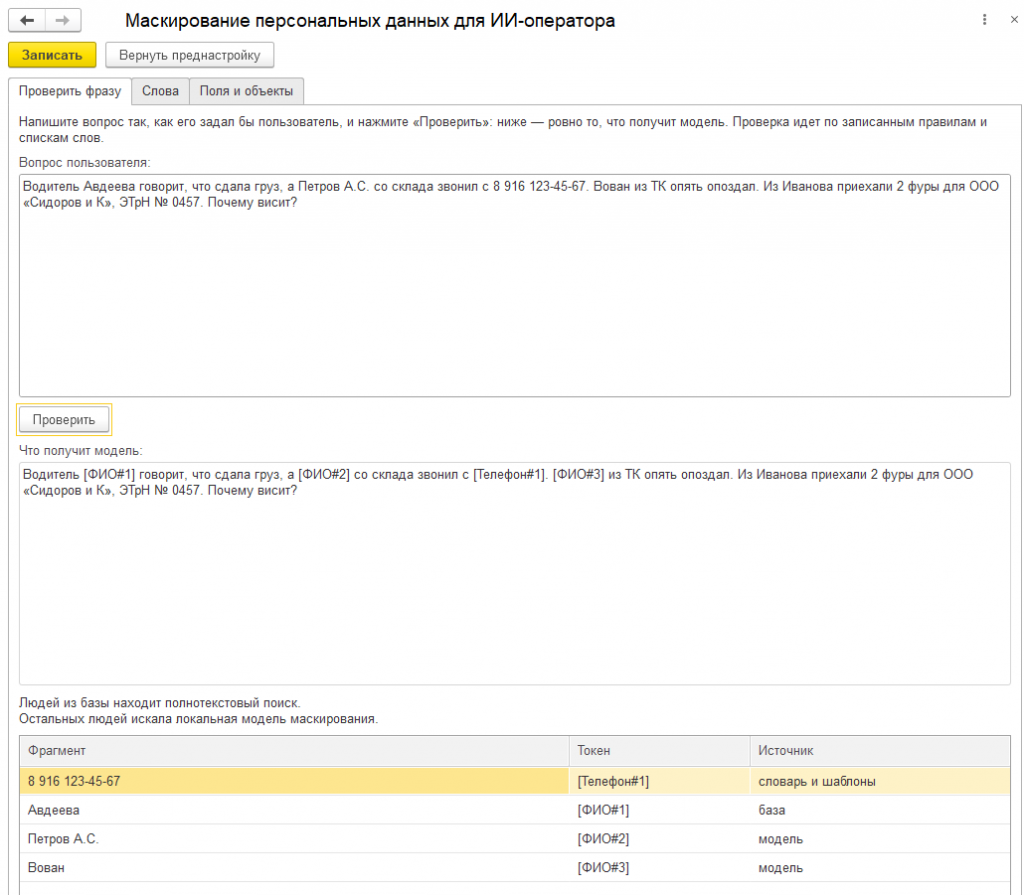 Форма "Проверить фразу" с той же фразой, теперь с локальной моделью: Петрова А.С. и Вована нашла она, а не эвристика
Что можно обещать службе безопасности
Безопасник прочитает статью внимательнее всех, поэтому сразу о цене.
Обещаем:
- люди из базы и данные по шаблонам (ИНН физлиц, СНИЛС, паспорт, телефон, почта) скрываются всегда, в данных и в вопросе;
- людей не из базы скрывает локальная модель, и на слепых корпусах пропусков людей не было;
- исходный текст уходит только локальной модели, адрес проверяется в коде;
- всё это проверяется записью запросов к модели, а не на честном слове.
Не обещаем:
- без локальной модели люди не из базы скрываются "по лучшему усилию". Редкое имя без признаков пройдёт, и цифры выше показывают, насколько часто;
- словарь "токен ↔A038; значение" у бота лежит в базе. Ролей с доступом к нему нет, записи живут сутки. Но администратор с полными правами прочитает его, как и сами данные базы;
- вопрос и ответ в обсуждении хранятся в Системе взаимодействия в открытом виде: модель их не видит, а сервис видит. С облачным 1С:Диалог переписка покидает компанию и лежит на серверах фирмы 1С. Если это неприемлемо, Сервер взаимодействия разворачивают на своих серверах, и переписка остаётся внутри контура;
- модель видит названия юрлиц, номера документов и суммы. Это не ПДн, но коммерческая тайна бывает и без людей.
Ограничения
- Проверено на русском языке и на демо-базе "Управления торговлей 11.5", вопросы - про перевозки и ЭТрН. Для другой предметной области нужен свой слепой корпус: у кадровиков свои Вовчики.
- Без полнотекстового поиска человек из базы находится по фамилии, но не по одному имени.
- Слой модели добавляет к ответу 2-4 секунды и требует локальной модели на сервере или в сети компании.
- Шаблоны прячут телефоны и почту и у юрлиц. Это лишнее маскирование, а не утечка.
- Последний слепой корпус после правок стал регрессионным. Следующей честной оценкой будет новый корпус, а не повтор этих цифр.
Что в итоге
Прятать ПДн из вопроса пользователя оказалось интереснее, чем из данных базы. У данных есть тип и поле, у живой речи - только падежи и Петровичи. Рабочая схема получилась трёхслойной: что можно найти точно, находим точно (шаблоны и люди из базы), хвост отдаём локальной модели, а качество меряем на корпусах, которые правила ни разу не видели. Без последнего пункта первые два превращаются в самоуспокоение.
Как попробовать. Всё описанное входит в ядро ИИ-оператора, оно открыто под лицензией GNU AGPL v3: github.com/RunetX/ai-operator-core. Маскирование ввода - модуль ИИО_МаскированиеВвода, данных - ИИО_Маскирование. Готовые расширения для БП 3.0, ЗУП 3.1 и УТ 11.5 лежат в Releases.
Вопросы для обсуждения в комментариях:
- Как вы прячете ПДн, когда отправляете данные из 1С наружу, будь то модель, подрядчик или сервис?
- Какое прозвище из рабочих чатов, по-вашему, не распознает никакая эвристика?
- Хватит ли вашей службе безопасности формулировки "модель не видит ПДн", или нужна только локальная модель для всего?
Цифры взяты из прогонов на стенде. Фамилии в примерах - из демо-баз и тестовых корпусов, люди вымышленные. Изображение для анонса создано нейросетью.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.