Самострой в документации: что ИИ пристроил к вашей конфигурации 1С

Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Сверка не нашла выдуманных и чужих имён в распознанных упоминаниях документов, созданных с данными об объекте. Разница между XML и паспортом из графа оказалась в полноте: роли, подсистемы и связанные отчёты лежат вне XML объекта, и без графа модель о них не знает. Автоматическая сверка имён с выгрузкой отделяет выдуманное от настоящего за секунду на документ.
- Без данных обе модели писали правдоподобные несуществующие регистры, роли и отчёты: в среднем 13,7 выдуманных и чужих упоминания на документ; средняя доля подтверждённых по документам составила 32,8% и 47,2%.
- В распознанных упоминаниях документов по XML сверка не нашла ошибок имён, но описание оказалось неполным: ролей 0 из 30, подсистем 4 из 17.
- Паспорт объекта из графа дал полноту 181 из 181 при сопоставимом объёме входа: у haiku токенов стало на 12,2% больше, у deepseek — на 6,3% меньше, чем с XML.
- Сверка ловит выдуманные имена и имена чужих объектов, но не отличает реквизит шапки от колонки табличной части и пропускает часть имён без обратных кавычек.
- Весь опыт, 80 вызовов моделей, стоил 0,47 $. В архиве инструмента три команды, промпт и 77 тестов; в архиве к статье все 60 документов с отчётами сверки, итоговая документация на 10 объектов и расширенная PDF-версия статьи.
Документацию к продукту можно писать моделью, если дать ей паспорт объекта из выгрузки и прогнать результат через сверку имён. Смысловые утверждения после этого всё равно читает человек.
Для кого: разработчики и владельцы тиражных решений на 1С, которым нужна документация к объектам продукта, и всем, кто проверяет тексты, написанные ИИ по конфигурации.
К продукту на 1С нужна документация по объектам: что делает документ, какие реквизиты заполнять, по каким регистрам он двигается, у каких ролей есть права. ИИ пишет такие тексты быстро, а вопрос, сколько в них выдуманных реквизитов и регистров, обычно решают на глаз. Я сравнила, как меняется текст, если модели не дать об объекте ничего, дать XML с модулями или паспорт из графа выгрузки, прогнала 60 документов через автоматическую сверку с выгрузкой и проверила саму сверку на документе с заранее вписанными выдумками.
Стенд
| Условие | Значение |
|---|---|
| Конфигурация | «Нано-УТ 2.0», учебная: выгрузка XML и BSL, 293 файла, 71 объект метаданных. Платформа 1С в опыте не запускалась, нужна только выгрузка |
| Объекты | документы ПродажаТовара, ПоступлениеТовара, ЗаказКлиента, ВозвратОтПокупателя, ВыплатаДенег, ПеремещениеТоваров; справочники Номенклатура, Контрагенты, ДенежныеСчета; отчёт ПродажиИПрибыль |
| Модели | anthropic/claude-haiku-4.5 и deepseek/deepseek-chat через OpenRouter, температура 0,2, один прогон на ячейку |
| Инструмент | kdoc, Python 3.12.10, выгрузка в формате 2.20 (режим совместимости 8.3.27), только стандартная библиотека; граф зависимостей по выгрузке из моего прошлого инструмента анализа влияния |
| Компьютер | Windows 11 Pro, Intel Core i5-2400, 7,9 ГБ ОЗУ, SATA SSD |
Из 14 документов конфигурации взято 6 разной формы: с табличной частью и без, с контрагентом и без, документ-основание. Остальные 8 по форме повторяют выбранные.
Как устроен инструмент
У kdoc три команды.
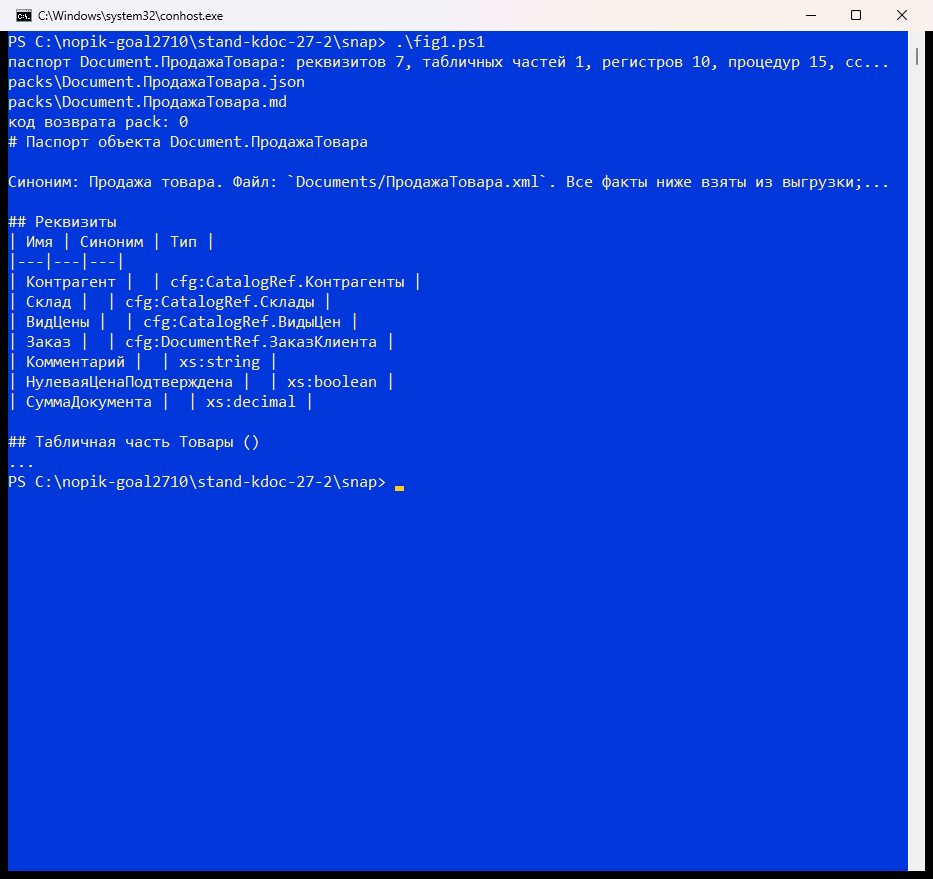
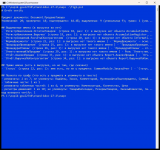
pack собирает паспорт объекта: реквизиты и табличные части с типами, движения по регистрам, процедуры модулей объекта и кто их вызывает, формы, их реквизиты и команды, роли с правами на объект, подсистемы, отчёты и запросы, где объект встречается. Каждый факт взят из выгрузки, у каждого указан файл-источник. На объект уходит 0,86 с.
pack: паспорт документа ПродажаТовара
write подставляет паспорт в промпт и вызывает модель. Промпт лежит отдельным файлом, его можно поменять под свой продукт. В нём требование писать только по данным и брать каждое имя в обратные кавычки: по кавычкам потом работает сверка. Вместе с текстом сохраняются промпт, модель, дата, токены и время.
verify извлекает из готового текста распознанные по заданным шаблонам имена метаданных и кода и сверяет их с выгрузкой. Каждое имя попадает в одну из групп: подтверждено, выдумано (в выгрузке такого нет) или чужое (имя есть, но у другого объекта или другого вида). Ниже отчёта полнота: какие реквизиты, регистры, процедуры, роли и подсистемы объекта текст не упомянул. Если есть выдуманные или чужие имена, код возврата 1. Сверка работает с любым текстом, написанным человеком или моделью, и занимает 0,84 с на документ.
Опыт: чем кормить модель
Для XML и паспорта промпт одинаков, отличается блок данных. Для контроля без данных использован отдельный промпт без запрета выдумывать. Поэтому сравнение с контролем одновременно меняет и данные, и инструкцию; отделить эффект одного фактора этот опыт не позволяет:
| Способ | Что получает модель |
|---|---|
| Без данных | только имя объекта и промпт без запрета выдумывать: контроль с отдельной инструкцией |
| XML и модули | XML-файл объекта из выгрузки и тексты его модулей как есть |
| Паспорт | вывод pack для объекта |
До генерации я подготовила эталон: 181 элемент по 10 объектам (45 реквизитов, 5 табличных частей, 60 записей о регистрах движений, 24 процедуры объектов, 30 ролей, 17 подсистем). Эталон по XML составлял отдельный субагент, без доступа к инструменту. Потом я сверила его с паспортами pack: расхождений 0, и три значения проверила по файлам выгрузки сама.
Результат: выдумки
| Способ, модель | Выдуманных и чужих имён на документ | Документов без находок verify | Подтверждено упоминаний |
|---|---|---|---|
| Без данных, haiku | 13,7 (разброс 2,6) | 0 из 10 | 32,8% |
| Без данных, deepseek | 13,7 (разброс 4,0) | 0 из 10 | 47,2% |
| XML и модули, haiku | 0 | 10 из 10 | 330 из 330 |
| XML и модули, deepseek | 0 | 10 из 10 | 331 из 331 |
| Паспорт, haiku | 0 | 10 из 10 | 590 из 590 |
| Паспорт, deepseek | 0 | 10 из 10 | 543 из 543 |
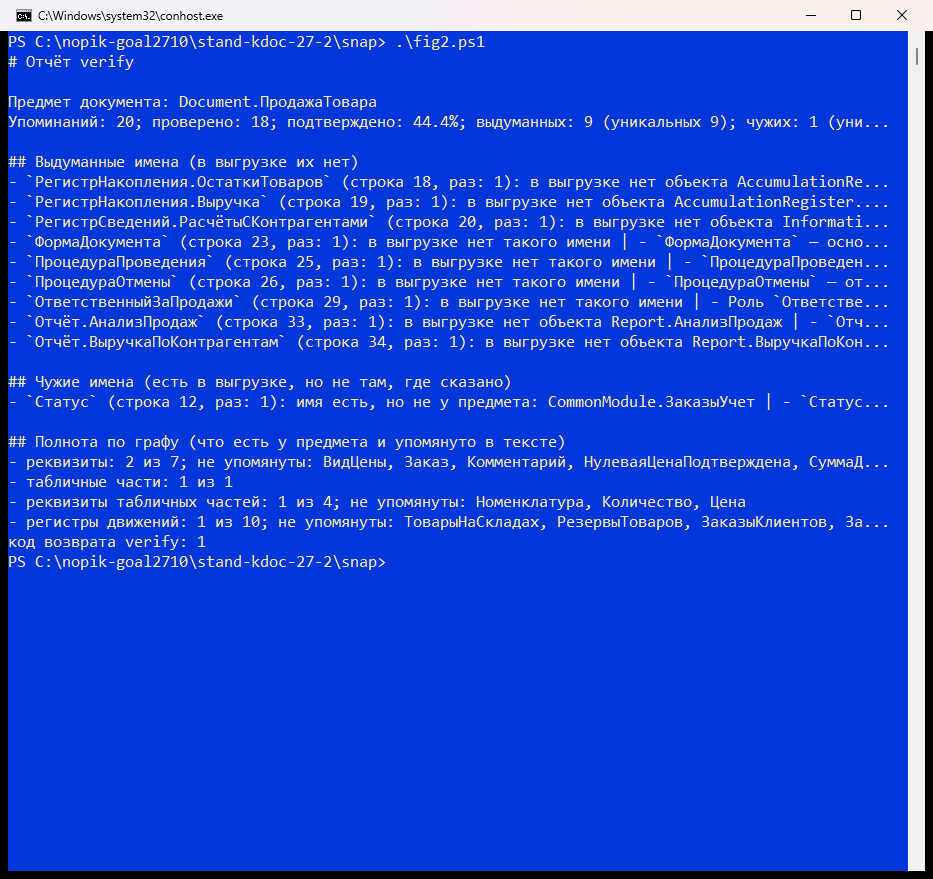
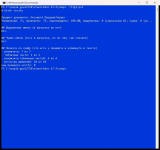
Без данных модели пишут уверенно: регистр РегистрНакопления.ОстаткиТоваров, отчёт Отчёт.ВыручкаПоКонтрагентам, роль ОтветственныйЗаПродажи, процедуры ПроцедураПроведения и ПроцедураОтмены. В выгрузке ничего этого нет.
verify на документе, написанном без данных: найдены выдуманные регистры, роли, отчёты и процедуры, код возврата 1
Я ожидала, что с паспортом выдуманных имён будет меньше, чем с XML и модулями. Опыт этого не показал: у обоих способов 0. Сверка не нашла ошибок в распознанных именах у обеих моделей с данными и прямым запретом выдумывать.
Результат: упоминания элементов эталона
| Что упомянуто в документах | XML и модули | Паспорт | Без данных |
|---|---|---|---|
| Всего по эталону, haiku | 138 из 181 | 181 из 181 | 27 из 181 |
| Всего по эталону, deepseek | 138 из 181 | 181 из 181 | 45 из 181 |
| Роли (обе модели) | 0 из 30 | 30 из 30 | – |
| Подсистемы (обе модели) | 4 из 17 | 17 из 17 | – |
Полнота здесь означает наличие имён элементов эталона в тексте по поиску с границами слова. Этот подсчёт не проверяет правильность описания роли, процедуры или реквизита. Разница между XML и паспортом — в таких упоминаниях. В XML документа нет сведений о ролях и подсистемах: права лежат в файлах ролей, состав подсистем в файлах подсистем. Модель, которой дали только XML объекта, о них не знает и честно пишет «в данных не указано». Паспорт собирает эти связи из всей выгрузки.
Стоимость и объём входа зависят от модели. У haiku генерация с паспортом стоила 0,1310 $ против 0,1155 $ с XML (на 13,4% больше), у deepseek — 0,0201 $ против 0,0196 $ (на 2,6% больше). Входных токенов на 10 документов: у haiku 48 328 с XML и 54 228 с паспортом, у deepseek 43 206 и 40 483.
verify на документе, написанном по паспорту: находок среди распознанных имён нет, код возврата 0
Проверка самой сверки
Первая версия verify на 40 документах с данными показала обратное: с паспортом в среднем 7,1 находки на документ у haiku, с XML 1,5. Ни один документ по паспорту не прошёл. Все 52 уникальные находки я разобрала с помощью субагента и выборочно проверила сама: ложными оказались все 52. Сверка принимала тип CatalogRef.Контрагенты за имя, не знала полей регистров движений, реквизитов и команд форм, стандартных Код и Наименование, имён прав.
Правила я исправила, в паспорт добавила реквизиты и команды форм, документы по паспорту сгенерировала заново. Нули в таблице выше получены второй версией сверки, а её правила уточнялись на этих же 40 документах. Поэтому независимых проверок у второй версии три:
| Проверка | Результат |
|---|---|
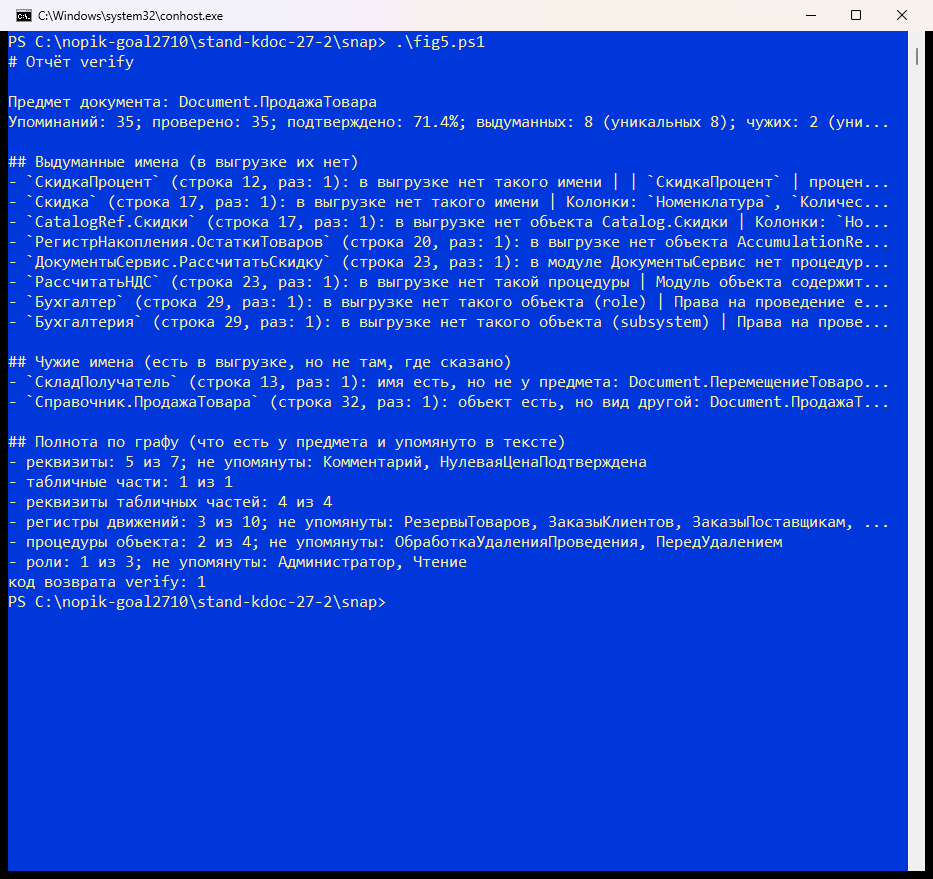
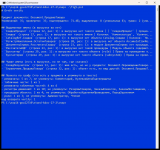
| Документ с 10 подложенными выдумками (ключ ответов записан до запуска) | найдено 10 из 10: 8 выдуманных, 2 чужих; 25 настоящих имён не тронуты; код возврата 1 |
| 20 документов без данных, созданных после правки правил | 13,7 выдуманных и чужих упоминания на документ, ни одного без находок |
| Ручной разбор находок на трёх документах | 23 находки, все настоящие; ложных 0 |
verify на документе с 10 подложенными выдумками
Ручной разбор показал и пропуски. На двух документах из трёх колонка Сумма табличной части названа реквизитом шапки, а сверка этого не видит: она проверяет, есть ли имя у объекта, но не на каком уровне. Ещё deepseek часть реквизитов и колонок писал в таблицах без обратных кавычек, часть таких имён сверка пропускает: у него 543 проверенных упоминания против 590 у haiku на тех же объектах.
Время и деньги
| Способ, модель (10 документов) | Токены вход / выход | Стоимость, $ | Генерация на документ, с, среднее / максимум |
|---|---|---|---|
| XML и модули, haiku | 48 328 / 13 664 | 0,1155 | 10,9 / 17,6 |
| Паспорт, haiku | 54 228 / 15 616 | 0,1310 | 13,9 / 20,7 |
| Без данных, haiku | 2 294 / 6 030 | 0,0321 | 5,9 / 7,6 |
| XML и модули, deepseek | 43 206 / 8 199 | 0,0196 | 21,8 / 43,2 |
| Паспорт, deepseek | 40 483 / 9 563 | 0,0201 | 24,6 / 44,3 |
| Без данных, deepseek | 1 791 / 7 105 | 0,0071 | 21,1 / 36,4 |
Всего было 80 платных вызовов (60 документов и 20 повторных по паспорту после правки), стоимость 0,47 $ по данным OpenRouter. Документ по паспорту стоит около 1,3 цента у haiku и 0,2 цента у deepseek.
Итоговая документация на 10 объектов
Лучшим вышел способ «паспорт + haiku». Во всех 10 документах сверка не нашла выдуманных и чужих имён среди распознанных упоминаний, правок по именам не понадобилось. Они лежат в архиве к статье как образец. Один документ я прочитала целиком, ещё два по разделам.
Назначение реквизита и фразы вроде «документ уменьшает остатки» модель выводит из имён: в паспорте таких сведений нет, и сверка их не проверяет. Такие места перед выдачей документации покупателю читает человек.
Пределы
- Одна небольшая учебная конфигурация, 10 объектов из 71. На УТ 11, БП 3 и расширениях инструмент не проверялся.
- Две модели, один прогон на ячейку, температура 0,2, промпт с запретом выдумывать. С другим промптом и другими моделями числа будут другими.
- Правила второй версии сверки подобраны на тех же 40 документах, где у способов с данными получились нули.
- Сверка проверяет только имена. Смысл она не оценивает, шапку и табличную часть не различает, часть имён без обратных кавычек пропускает; квалифицированные имена и имена в «ёлочках» после слов-подсказок распознаёт и без них.
- Во всех шести документах конфигурации в свойстве движений указаны одни и те же 10 регистров, а какие регистры документ пишет на деле, решает общий модуль. Паспорт перечисляет заявленные регистры и этого не уточняет.
Что проверить у себя
- Выгрузите конфигурацию в файлы (расширения в этом опыте не проверены):
1cv8.exe DESIGNER /F <база> /DumpConfigToFiles <каталог>. - Проверьте документацию, которая у вас уже есть:
python kdoc.py verify <документ.md> <выгрузка> --object <Вид.Имя>. Для надёжного распознавания берите имена в обратные кавычки; часть имён без них тоже распознаётся, но произвольный текст целиком не покрывается. - Для нового объекта соберите паспорт
pack, прочитайте его и поправьте промпт под свой продукт. - Сгенерируйте текст
writeи прогонитеverify. Документ с кодом возврата 1 исправьте по отчёту. - Прочитайте смысловые утверждения: назначение реквизитов и описание движений.
Файлы к статье
Инструмент kdoc-27-2-tool.zip. Экспериментальный конвейер документации к объектам конфигурации, проверенный на «Нано-УТ 2.0»: pack собирает паспорт объекта из выгрузки, write пишет документ моделью через OpenRouter (ключ берётся из переменной окружения OPENROUTER_API_KEY и нигде не сохраняется), verify сверяет любой текст с выгрузкой и возвращает ненулевой код при выдуманных именах, так что сверку можно поставить в сборку перед выпуском документации. Внутри промпт, который правится под продукт, README и 77 тестов. Распаковывайте Проводником Windows, 7-Zip или Python: unzip из Git Bash портит кириллические имена файлов. Тесты из чистой распаковки:
Архив к статье kdoc-27-2-companion.zip. Все 60 документов опыта с отчётами сверки, итоговая документация на 10 объектов «Нано-УТ», паспорта и эталон фактов, документ с подложенными выдумками и ключ к нему, промпты и инструкция, как их поменять, чек-лист подготовки документации с ИИ и сверкой, команды повторения опыта и расширенная PDF-версия статьи с полными таблицами.
Итог
Без данных сверка нашла в среднем 13,7 выдуманных и чужих упоминания на документ. В документах по XML или паспорту таких находок среди распознанных имён не было; отсутствие ошибок во всём тексте этим не доказано. Паспорт объекта из графа выгрузки отличился полнотой: 181 элемент эталона из 181 против 138 у XML с модулями, потому что роли и подсистемы лежат вне XML объекта. Сверка имён с выгрузкой нашла все 10 подложенных выдумок, а её первая версия ошиблась 52 раза из 52, так что проверка проверяющего в опыте была обязательной.
Практический порядок такой: паспорт объекта, генерация, сверка, чтение смысловых утверждений человеком. На 10 объектов это 139 секунд суммарного времени вызовов генерации и около 13 центов у haiku; подготовка выгрузки, построение паспортов, сверка и чтение человеком сюда не входят.
Выводы относятся к одной учебной конфигурации, двум моделям и одному прогону на ячейку.

Вступайте в нашу телеграмм-группу Инфостарт