Препарируем мозг Qwen 3.8 27B-1c
В продолжении статьи про дообучение Даем глаза локальной модели Qwen 3.8 27B
Есть Qwen 3.8 27B, дообученная (SFT + LoRA) на корпусе по платформе 1С:Предприятие — модель выложена на hugging face. Модель неплохо пишет код на встроенном языке, но на языке запросов 1С регулярно ошибается: путает виртуальные таблицы, ставит параметры не туда, подмешивает конструкции из SQL, которых в 1С нет.
Попытки классического подхода дообучать и дальше модель, собирая все новые и новые датасеты по языку запросов 1С, ни к чему не приводят. Выигрыш в accuracy дает меньше 1%. Ну и это долгий и мучительный процесс.
В процессе мучений с моделями qwen, разбора телеметрии использования модели возникла гипотеза: модели мешают знания по конструкциям SQL, т.к. лексемы схожие (SELECT, WITH, JOIN и.т.п.).
Отсюда возникает вопрос: можно ли найти конкретные нейроны, которые «тянут» модель к неправильному ответу, и аккуратно приглушить только их?
В статье — полный конвейер, который я назвал NERVE (Neuron Editing, Reweighted & Val-Evaluated):
- строим тепловую карту возбуждения нейронов на парах «правильный / неправильный ответ»;
- считаем градиентную атрибуцию — прогноз, как изменится качество, если нейрон приглушить;
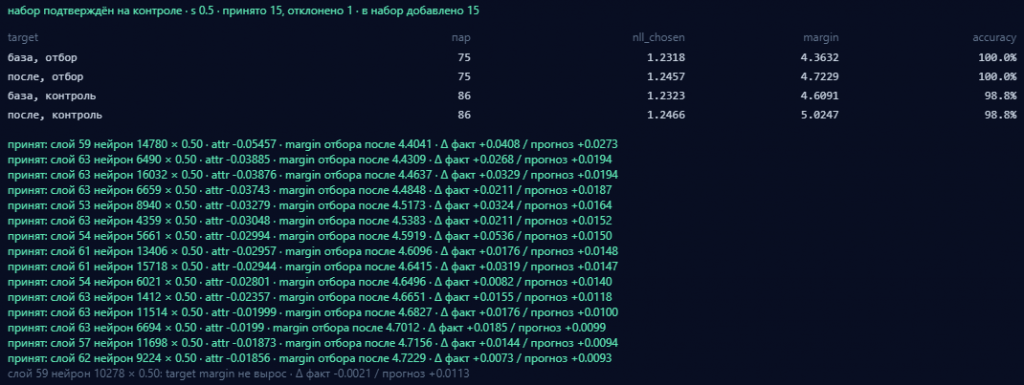
- жадно отбираем нейроны с проверкой на отложенной выборке и контрольной половине;
- копим подтверждённые правки в наборе и выгружаем правленую модель в GGUF.
Все примеры — на датасете 1c_lang_query (запросы 1С). Код — фрагменты из проекта, PyTorch + Hugging Face Transformers + PEFT.
1. Что такое «нейрон» в трансформере
Каждый слой Qwen содержит блок внимания и MLP-блок. MLP устроен по схеме SwiGLU:
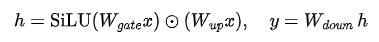
Здесь x — скрытое состояние токена (размерности hidden_size), h — промежуточный вектор (у Qwen 3.8 27B — 17 408 компонент), y — вклад MLP в residual stream. Нейроном будем называть одну компоненту h_i вместе с соответствующим столбцом матрицы W_down[:, i]: именно этот столбец определяет, что нейрон пишет в residual stream, когда активируется.
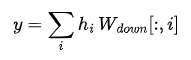
Отсюда простой и важный факт: умножить столбец W_down[:, i] на коэффициент m — это ровно то же самое, что умножить активацию нейрона h_i на m на каждом токене. m = 0 выключает нейрон, m = 0.5 приглушает вдвое, m = 1.5 усиливает. Правка не меняет архитектуру, переживает квантизацию и экспорт в GGUF.
Масштаб поиска: 64 слоя × 17 408 нейронов = 1 114 112 кандидатов. Перебирать вслепую бессмысленно, нужна карта.
2. Данные: пары «правильно / неправильно»
Для карты нужны не просто примеры, а preference-пары — тот же формат, что и для DPO: один промпт, ответ chosen (правильный запрос 1С) и rejected (запрос с типичной ошибкой). В 1c_lang_query около двух тысяч таких пар в train и отдельный val.
Ключевая идея: в паре chosen и rejected обычно совпадают на 90–95%. Если усреднять активации по всему ответу, общая часть «размажет» сигнал. Поэтому будем сравнивать только отличающиеся токены. Выравнивать две последовательности токенов через difflib.SequenceMatcher и помечать всё, что не попало в общие блоки:
def diff_token_mask(chosen_ids, rejected_ids):

    """Отмечает токены ответа, которых нет в общих блоках с другой стороной."""

    import difflib


    chosen_mask = [False] * len(chosen_ids)

    rejected_mask = [False] * len(rejected_ids)

    matcher = difflib.SequenceMatcher(None, chosen_ids, rejected_ids, autojunk=False)

    for tag, c_start, c_end, r_start, r_end in matcher.get_opcodes():

        if tag == "equal":

            continue

        for index in range(c_start, c_end):

            chosen_mask[index] = True

        for index in range(r_start, r_end):

            rejected_mask[index] = True

    # сторона без отличий получает маску на весь ответ

    if not any(chosen_mask):

        chosen_mask = [True] * len(chosen_ids)

    if not any(rejected_mask):

        rejected_mask = [True] * len(rejected_ids)

    return chosen_mask, rejected_mask
Важная деталь, на которой я споткнулся: сначала карта строилась по отличающимся токенам, а проверка качества считалась по всему ответу. Эффект правки разбавлялся примерно в 25 раз, и честные улучшения тонули в шуме. Сейчас и карта, и проверка используют одну и ту же diff-маску.
3. Тепловая карта возбуждения
3.1. Снимаем активации хуками
Модель загружается в BF16, LoRA-адаптер вливается в веса (merge_and_unload), и на вход каждого mlp.down_proj вешается forward_pre_hook. Вход down_proj — это и есть вектор h:
modules = [(name, m) for name, m in merged.named_modules()

           if name.endswith("mlp.down_proj")]


def make_hook(name):

    def hook(module, args):

        hidden = args[0]                       # [batch, seq, 17408]

        flat = hidden[0] if hidden.ndim == 3 else hidden

        rows = torch.tensor(current_mask, device=flat.device)

        selected = flat[rows].detach().float().abs()

        sums[name] = selected.sum(dim=0)       # сумма |h| по diff-токенам

        counts[name] = int(selected.shape[0])

    return hook


handles = [m.register_forward_pre_hook(make_hook(n)) for n, m in modules]
Для каждой пары делаем два forward-прохода — по chosen и по rejected — и считаем среднюю абсолютную активацию нейрона на отличающихся токенах:
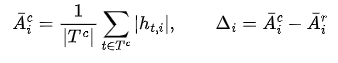
Здесь TK80; и TE1; — множества отличающихся токенов ответа chosen и rejected. Положительная дельта — нейрон сильнее возбуждается на правильном ответе, отрицательная — на ошибочном.
3.2. Статистика по парам: не только среднее
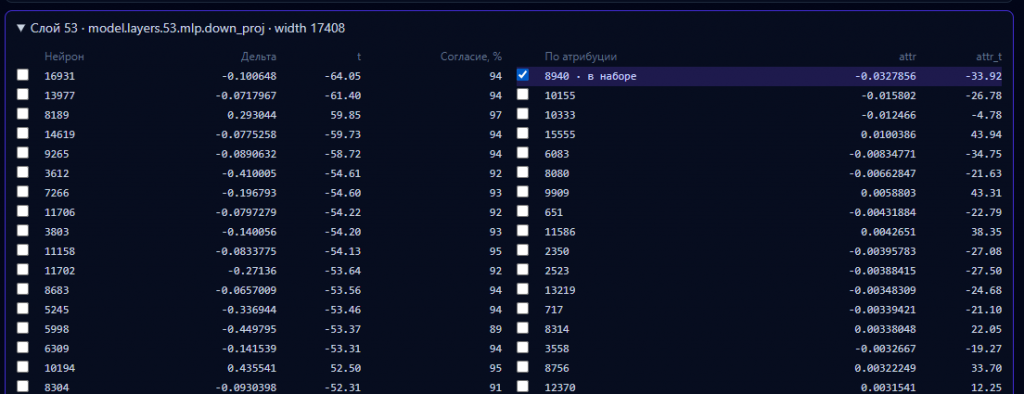
Одна пара ничего не доказывает. По всем n парам копим поэлементно сумму, сумму квадратов и число пар с положительной дельтой — этого достаточно, чтобы без хранения всех значений получить среднее, t-статистику и согласованность знака:
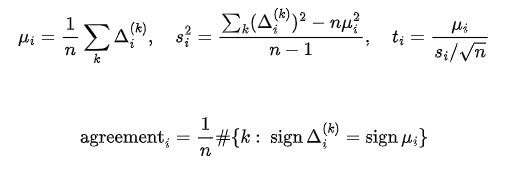
def pair_statistics(sums, sumsq, positive, count):

    """Среднее, t-статистика и доля пар со знаком среднего."""

    n = int(count)

    means, t_values, agreement = [], [], []

    for i in range(len(sums)):

        mean = sums[i] / n

        if n > 1:

            variance = max(0.0, (sumsq[i] - n * mean * mean) / (n - 1))

            std = math.sqrt(variance)

            t_value = mean / (std / math.sqrt(n)) if std > 0 else 0.0

        else:

            t_value = 0.0

        share_positive = positive[i] / n

        means.append(mean)

        t_values.append(t_value)

        agreement.append(share_positive if mean >= 0 else 1.0 - share_positive)

    return {"mean": means, "t": t_values, "agreement": agreement}
Почему ранжируем по |t|, а не по |μ|: у некоторых нейронов огромная средняя дельта, которую дают две-три аномальные пары. t-статистика штрафует такой разброс. При малом числе пар (меньше 8) t ненадёжна, и откатываемся к ранжированию по |μ|.
3.3. От миллиона чисел к картинке
Каждый слой — вектор из 17 408 средних дельт. Для тепловой карты делаем 128 корзин по индексу нейрона и берем среднее в корзине. Получается матрица 64 × 128: по вертикали слои, по горизонтали корзины, цвет — знак и сила дельты. Отдельно для каждого слоя сохраняется top-64 нейронов по |t| с дельтой, t и agreement — из них потом выбираются кандидаты на правку.
def bin_values(values, bin_count=128):

    """Среднее значений по корзинам одинаковой ширины вдоль индекса нейрона."""

    totals = [0.0] * bin_count

    sizes = [0] * bin_count

    width = len(values)

    for index, value in enumerate(values):

        bucket = min(bin_count - 1, index * bin_count // width)

        totals[bucket] += float(value)

        sizes[bucket] += 1

    return [totals[b] / sizes[b] if sizes[b] else 0.0 for b in range(bin_count)]
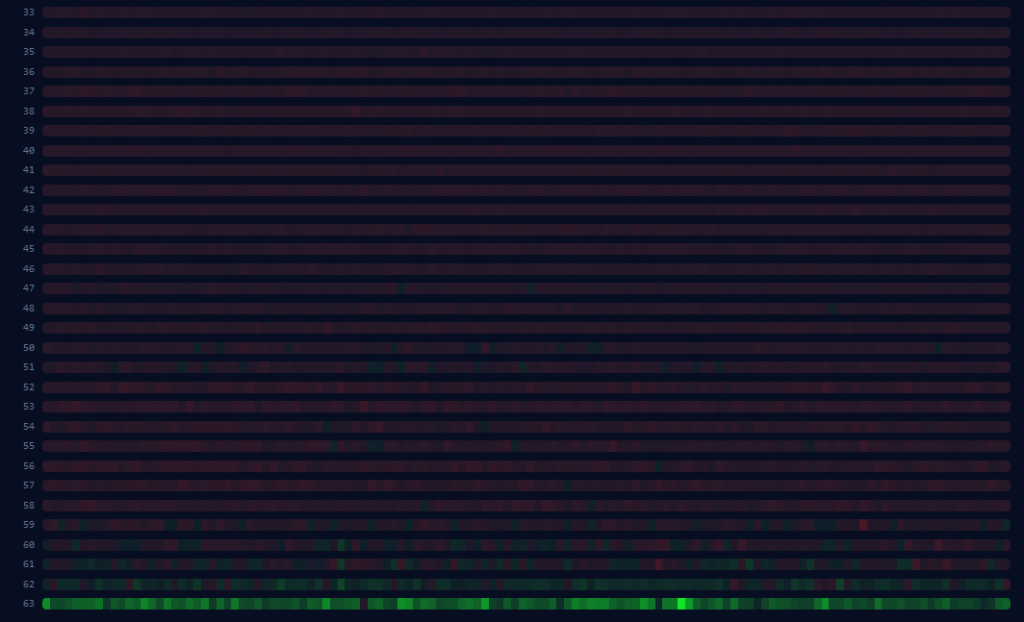 Первое, что бросилось в глаза на карте 1c_lang_query: возбуждение на ошибочных ответах есть практически в каждом слое. Модель буквально «вытаскивает» SQL-шные конструкции из всей глубины сети. Отсюда практический вывод, который определил весь дальнейший подход: нужно не только усиливать «хорошие» нейроны, но и подавлять ошибочные!
 4. Атрибуция: какой нейрон реально влияет на ответ
Активация показывает корреляцию, но не причинность: нейрон может ярко светиться на rejected и при этом почти не влиять на выбор токена. Нужна оценка вклада в качество. В качестве целевой метрики берем margin — насколько модель предпочитает правильный ответ ошибочному на отличающихся токенах:
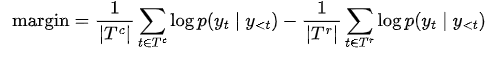
Атрибуцию нейрона считаем методом «градиент × вход» (первый порядок ряда Тейлора):
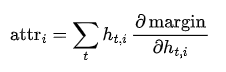
Смысл формулы: если умножить активацию нейрона на m, то в линейном приближении margin изменится на
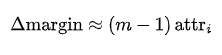
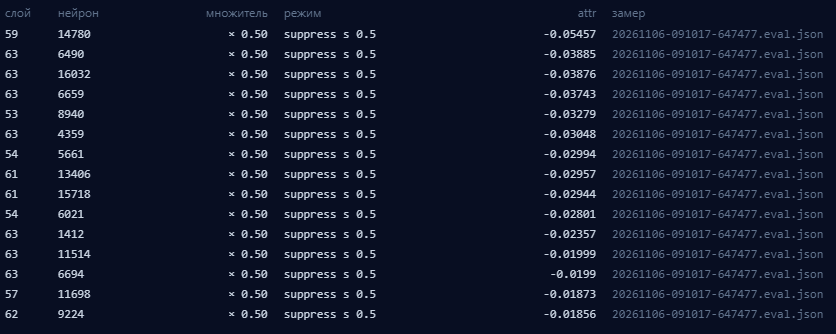
Значит, нейрон с attr < 0 своей активностью снижает margin — это и есть «ошибочный» нейрон. Приглушив его (m < 1), ожидаем рост margin. Для набора правок прогноз просто суммируется: Δmargin ≈ Σ (mK22; − 1)·attrK22;.
4.1. Как достать градиент по входу down_proj
Хитрость в том, что промежуточный h не является листом графа, и autograd.grad по нему не посчитать напрямую после forward. В том же pre-hook подменяем вход листом:
def hook(module, args):

    hidden = args[0]

    if not attribution_active:

        return None

    leaf = hidden.detach().requires_grad_(True)   # новый лист графа

    leaves[name] = leaf

    return (leaf,) + tuple(args[1:])              # down_proj считает уже от листа


with torch.enable_grad():

    out = model(input_ids=ids, attention_mask=mask, use_cache=False)

    objective = masked_mean_logprob(out.logits, ids, diff_rows)

    names = list(leaves)

    grads = torch.autograd.grad(objective * sign, [leaves[n] for n in names],

                                allow_unused=True)


attr = {}

for name, grad in zip(names, grads):

    if grad is None:

        continue

    product = leaves[name].detach().float() * grad.float()

    attr[name] = product.reshape(-1, product.shape[-1]).sum(dim=0)   # [17408]
Для chosen берем sign = +1, для rejected — sign = −1, и складываем: получаем ровно градиент margin. Функция среднего log p по отмеченным токенам учитывает сдвиг: токен j предсказывается логитами позиции j − 1:
def masked_mean_logprob(logits, input_ids, rows):

    positions = [i for i, flag in enumerate(rows) if flag and i > 0]

    if not positions:

        return None

    target = torch.tensor(positions, device=logits.device)

    picked = logits[0, target - 1].float()

    log_probs = torch.log_softmax(picked, dim=-1)

    tokens = input_ids[0, target].unsqueeze(-1)

    return log_probs.gather(-1, tokens).squeeze(-1).mean()
Атрибуция стоит дорого (backward на 27B-модели), поэтому карту с атрибуцией строим на подвыборке: для 1c_lang_query — 512 пар при длине до 2048 токенов. Карта без атрибуции — на всех 2010 парах. По атрибуции тоже считаются среднее и t, а в слой сохраняется top-64 по |attr|.
5. Как проверять правку
Атрибуция — только прогноз. Решение о каждой правке принимается по факту на отложенной val-выборке того же датасета, по которому построена карта. Для каждой пары считаем:
- nll_chosen — средний отрицательный log p по всему правильному ответу. Сторож: правка не должна портить генерацию правильного текста в целом;
- margin — по отличающимся токенам, как в атрибуции;
- accuracy — доля пар с margin > 0.
Чтобы замеры были сопоставимы между запусками, пары val сортируются по ключу запроса (query_fingerprint, а если его нет — sha1 последнего сообщения пользователя). Отдельно можно включить guard — по несколько пар val из других датасетов, чтобы правка не ломала соседние навыки. По умолчанию guard выключен: проверка идёт строго по датасету карты.
Сама правка при проверке применяется «на живую» к загруженной BF16-модели и всегда откатывается:
def scale_columns(edits):

    """Умножает столбцы down_proj на edit["scale"] и возвращает исходные значения."""

    saved = []

    with torch.no_grad():

        for edit in edits:

            weight = modules[edit["name"]].weight          # [hidden, 17408]

            index = int(edit["index"])

            saved.append((weight, index, weight[:, index].detach().clone()))

            weight[:, index].mul_(float(edit["scale"]))

    return saved


def restore_columns(saved):

    with torch.no_grad():

        for weight, index, column in saved:

            weight[:, index].copy_(column)
6. Режимы множителя
Как превратить выбранные нейроны в конкретные коэффициенты m? Есть четыре режима, параметр силы s ∈ [0, 1]:
|
Режим |
Кого трогаем |
Множитель m |
|
suppress (подавление) |
только ошибочные: attr < 0, без атрибуции — Δ < 0 |
1 − s |
|
sign |
все выбранные, по знаку дельты активации |
1 + s при Δ > 0, 1 − s при Δ < 0 |
|
attr |
все выбранные, по знаку атрибуции |
1 + s при attr > 0, 1 − s при attr < 0 |
|
manual |
все выбранные |
одно число 0…2 |
После эксперимента с 1c_lang_query режимом по умолчанию стал suppress: усиление «хороших» нейронов чаще ломало nll, а подавление ошибочных давало устойчивый рост margin.
def signed_scales(edits, mode, value):

    result = []

    for edit in edits:

        if mode == "suppress":

            source = edit.get("attr") if edit.get("attr") is not None else edit.get("delta")

            if source is None or source >= 0:

                continue                      # не ошибочный — не трогаем

            scale = 1.0 - value

        elif mode == "manual":

            scale = value

        else:

            source = edit["delta"] if mode == "sign" else edit["attr"]

            scale = 1.0 + value if source > 0 else 1.0 - value if source < 0 else 1.0

        result.append({**edit, "scale": max(0.0, min(2.0, scale))})

    return result
7. Жадный отбор с контрольной половиной
Брать сразу топ-64 нейрона и приглушать всех — плохая идея: правки взаимодействуют, и сумма линейных прогнозов перестаёт работать. Поэтому отбор жадный, по одному кандидату.
7.1. Разбиение val
Val-пары датасета делятся на две половины детерминированной хеш-функцией от ключа запроса: отбор (на ней принимаю решения) и контроль (на ней проверяю итог). Одна и та же пара всегда попадает в одну и ту же половину.
def split_half(key: str) -> bool:

    """True — пара в половине отбора, False — в контрольной."""

    return int(hashlib.sha1(key.encode("utf-8")).hexdigest()[-1], 16) % 2 == 0
7.2. Кандидаты и правило принятия
Кандидаты — top-N нейронов по |attr| по всем слоям карты (в режиме suppress — только с attr < 0), за вычетом уже принятых ранее. Дальше для каждого кандидата: применить правку поверх уже принятых, замерить на половине отбора, оставить или откатить. Правило принятия:
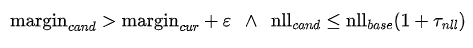
По умолчанию ε = 0.002 (на токен), τ_nll = 2%, допуск guard τ_guard = 1% по nll и margin каждого guard-эксперта. Обратите внимание: margin сравнивается с текущим набором (каждый принятый нейрон должен добавить пользу), а nll — с базой (просадки не должны накапливаться).
baseline = score(select, guard)            # без правок

current = baseline

accepted, kept = [], []

for edit in signed_scales(candidates, mode, s):

    saved = scale_columns([edit])

    summary = score(select, guard)

    ok, reason = greedy_accept(baseline, current, summary, eps, nll_tol, guard_tol)

    if ok:

        kept.extend(saved)                 # правка остаётся в весах

        current = summary

        accepted.append(edit)

    else:

        restore_columns(saved)


final_control = score(control)             # итог проверяем на второй половине

confirmed = accepted and passes(baseline_control, final_control)

restore_columns(reversed(kept))
Набор считается подтверждённым, только если на контрольной половине margin вырос, а nll не просел сверх допуска. Это главная защита от переобучения на val: жадный отбор неизбежно подгоняется под шум выборки, на которой принимает решения.
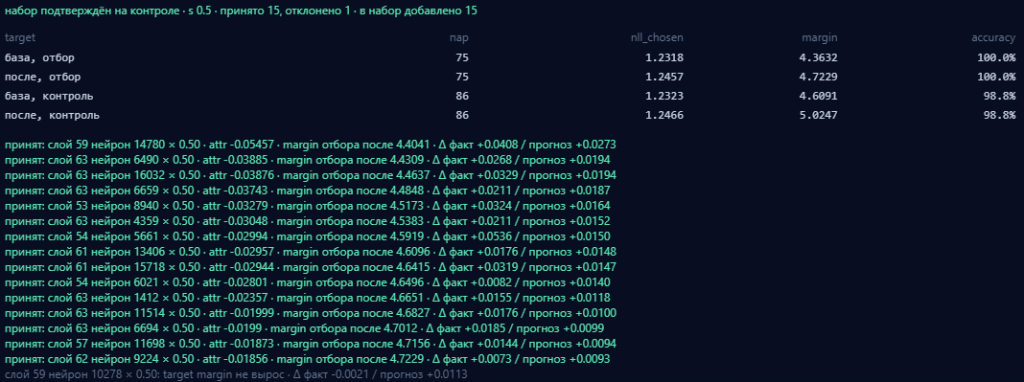
8. Гибридный режим: копим правки между прогонами
Один прогон жадного отбора — это несколько десятков кандидатов. Хочется запускать отбор повторно: другим режимом, с другой силой s, на следующих кандидатах. Для этого у каждой карты есть набор правок — JSON-файл рядом с картой:
- новый прогон стартует поверх набора: правки набора применяются к весам до замера базы;
- нейроны набора исключаются из кандидатов;
- принятые нейроны дописываются в набор только если прогон подтвердился на контроле;
- отдельная проверка «набор целиком против базы» показывает суммарный эффект.
{

  "schema_version": 1,

  "map": "20261105-125127-275881.json",

  "edits": [

    {"name": "model.layers.54.mlp.down_proj", "layer_index": 54, "index": 5661,

     "attr": -0.0123, "scale": 0.5, "mode": "suppress", "s": 0.5,

     "eval": "20261106-072151-604012.eval.json"}

  ],

  "updated_at": "2026-11-06T07:31:02Z"

}
Значения attr в примере иллюстративные.
9. Экспорт: NERVE-GGUF
Финальный шаг — выгрузить правленую модель для инференса в llama-server. Конвейер такой:
Правка столбцов W_down полностью совместима с квантизацией: квантизатор видит просто чуть другие веса. Никаких дополнительных слоёв, адаптеров или хуков на инференсе нет.
10. Результаты на 1c_lang_query
Пример: как ошибается модель до правки
Одна из задач публичных бенчмарков для 1С. Промпт:
Нужно одним запросом на языке запросов 1С вывести все даты (по дням) из заданного интервала [&ДатаНачала; &ДатаОкончания] включительно, упорядоченные по возрастанию. Интервал произвольный (может быть несколько лет), передаётся параметрами. Ряд дат строится средствами запроса, без циклов и обработки результата в модуле, без таблиц календаря из конфигурации. По сути это календарь в запросе (последовательный список дат за определённый период) без использования предварительно созданных объектов метаданных (таких как производственный календарь, график). Кроме дат должны также быть колонки с месяцами, днями недели и рассчитан стандартный выходной (суббота и воскресенье).
Ответ модели до правки:
Решение: рекурсивный запрос (recursive CTE) 1С:Предприятие 8.3. В запросном языке 1С (начиная с 8.3.17) есть конструкция РЕКУРСИВНО СОЕДИНИТЬ ВНЕШНЕ, которая позволяет «развернуть» последовательность прямо в запросе — без циклов, без таблиц календаря и без объектов метаданных.
Запрос.Текст =
"РЕКУРСИВНО СОЕДИНИТЬ ВНЕШНЕ Календарь
|
|ВЫБРАТЬ
|    База.Дата КАК Дата
|ПОМЕСТИТЬ Календарь
|
|ИЗ
|    (
|        ВЫБРАТЬ
|            &ДатаНачала КАК Дата
|    ) КАК База
|
|СОЕДИНИТЬ ВНЕШНЕ Календарь
|
|ВЫБРАТЬ
|    База.Дата + 1 КАК Дата
|ИЗ
|    Календарь КАК База
|    СОЕДИНИТЬ ВНЕШНЕ Календарь
|        ПО База.Дата + 1 <= &ДатаОкончания
|
|
|ВЫБРАТЬ
|    Календарь.Дата КАК Дата,
|    Месяц(Календарь.Дата) КАК Месяц,
|    МесяцНазвание(Календарь.Дата) КАК МесяцНазвание,
|    ДеньНедели(Календарь.Дата) КАК ДеньНедели,
|    ДеньНеделиНазвание(Календарь.Дата) КАК ДеньНеделиНазвание,
|    (ДеньНедели(Календарь.Дата) >= 6) КАК СтандартныйВыходной
|ИЗ
|    Календарь
|УПОРЯДОЧИТЬ ПО
|    Дата";
Ответ выглядит уверенно, но почти каждая ключевая строка в нём — галлюцинация:
- Рекурсивный CTE перенесён из SQL. В языке запросов 1С нет рекурсивных запросов, а «РЕКУРСИВНО СОЕДИНИТЬ ВНЕШНЕ» и ссылка на версию 8.3.17 выдуманы. Это ровно тот перенос SQL-конструкций, который видно на тепловой карте во всех слоях.
- Несуществующее соединение. «СОЕДИНИТЬ ВНЕШНЕ» в 1С нет — есть ЛЕВОЕ, ПРАВОЕ, ПОЛНОЕ и ВНУТРЕННЕЕ СОЕДИНЕНИЕ, а объединение результатов делается через ОБЪЕДИНИТЬ (ВСЕ).
- Арифметика с датой. В языке запросов к дате нельзя прибавить число: для сдвига на день нужна функция ДОБАВИТЬКДАТЕ(Дата, ДЕНЬ, 1). Во встроенном языке Дата + 1 вообще означает плюс одну секунду.
- Выдуманные функции. МЕСЯЦ() и ДЕНЬНЕДЕЛИ() существуют, а МесяцНазвание() и ДеньНеделиНазвание() — нет; названия получают через ВЫБОР … КОГДА или ФОРМАТ на стороне представления.
- Сломанная структура пакета. ПОМЕСТИТЬ стоит посреди конструкции, временная таблица ссылается сама на себя, запросы пакета не разделены точкой с запятой — такой текст не пройдёт даже синтаксический контроль.
Правильное решение строится без рекурсии: временная таблица цифр 0–9, её декартово произведение с самой собой даёт ряд чисел N, а даты получаются как ДОБАВИТЬКДАТЕ(&ДатаНачала, ДЕНЬ, N) с отбором по &ДатаОкончания.
Тот же промпт после NERVE-правки
ВЫБРАТЬ

    &ДатаНачала + (Д1.Цифра * 1000 + Д2.Цифра * 100 + Д3.Цифра * 10 + Д4.Цифра) КАК Дата,

    МЕСЯЦ(&ДатаНачала + (Д1.Цифра * 1000 + Д2.Цифра * 100 + Д3.Цифра * 10 + Д4.Цифра)) КАК Месяц,

    ДЕНЬНЕДЕЛИ(&ДатаНачала + (Д1.Цифра * 1000 + Д2.Цифра * 100 + Д3.Цифра * 10 + Д4.Цифра)) КАК ДеньНедели,

    ВЫБОР

        КОГДА ДЕНЬНЕДЕЛИ(&ДатаНачала + (Д1.Цифра * 1000 + Д2.Цифра * 100 + Д3.Цифра * 10 + Д4.Цифра)) В (6, 7)

            ТОГДА ИСТИНА

        ИНАЧЕ ЛОЖЬ

    КОНЕЦ КАК Выходной

ИЗ

    (ВЫБРАТЬ 0 КАК Цифра ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 1 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 2 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 3

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 4 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 5 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 6

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 7 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 8 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 9) КАК Д1,

    (ВЫБРАТЬ 0 КАК Цифра ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 1 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 2 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 3

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 4 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 5 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 6

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 7 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 8 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 9) КАК Д2,

    (ВЫБРАТЬ 0 КАК Цифра ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 1 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 2 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 3

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 4 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 5 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 6

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 7 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 8 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 9) КАК Д3,

    (ВЫБРАТЬ 0 КАК Цифра ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 1 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 2 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 3

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 4 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 5 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 6

        ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 7 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 8 ОБЪЕДИНИТЬ ВСЕ ВЫБРАТЬ 9) КАК Д4

ГДЕ

    Д1.Цифра * 1000 + Д2.Цифра * 100 + Д3.Цифра * 10 + Д4.Цифра <= РАЗНОСТЬДАТ(&ДатаНачала, &ДатаОкончания, ДЕНЬ)

УПОРЯДОЧИТЬ ПО

    Дата
Разница — качественная. Модель перестала изобретать SQL-конструкции и вернулась к идиоме, которой 1С-разработчики решают эту задачу на практике:
- Нет рекурсии и выдуманного синтаксиса. Вместо «рекурсивного CTE» — декартово произведение четырёх таблиц цифр 0–9, то есть ряд чисел 0…9999 (до ~27 лет — «несколько лет» с запасом).
- Только реальные функции языка запросов. РАЗНОСТЬДАТ(…, ДЕНЬ) для границы интервала, МЕСЯЦ() и ДЕНЬНЕДЕЛИ() для колонок, ВЫБОР … КОГДА … В (6, 7) для выходного — всё существует и применено по назначению.
- Правильная структура. Один запрос, корректные вложенные ОБЪЕДИНИТЬ ВСЕ, условие в ГДЕ, упорядочивание по дате. Интервал включительный: при N = РАЗНОСТЬДАТ выводится и &ДатаОкончания.
Одна ошибка всё же осталась: &ДатаНачала + N. Сдвиг даты в языке запросов делается функцией ДОБАВИТЬКДАТЕ(&ДатаНачала, ДЕНЬ, N); прибавление числа к дате — это перенос привычки из встроенного языка (где к тому же +1 означает секунду, а не день). Для полностью рабочего запроса достаточно заменить это выражение в четырёх местах. Показательно, что ошибка сместилась с уровня «неправильный язык и выдуманная архитектура решения» на уровень «одна неверная функция» — ровно то, что и ожидается от точечной правки, а не от переобучения.
Пример 2: оптимизация запроса — где правки недостаточно
Второй промпт — «Оптимизируй запрос» — на фрагменте из подсистемы управления доступом:
ВЫБРАТЬ РАЗЛИЧНЫЕ

    ЗначенияПоУмолчанию.ТипЗначенийДоступа КАК ТипЗначений,

    ЗначенияПоУмолчанию.ВсеРазрешеныБезИсключений КАК ВсеРазрешеныБезИсключений

ПОМЕСТИТЬ ЗначенияПоУмолчаниюДляПользователя

ИЗ

    РегистрСведений.ЗначенияГруппДоступаПоУмолчанию КАК ЗначенияПоУмолчанию

ГДЕ

    ИСТИНА В

        (ВЫБРАТЬ ПЕРВЫЕ 1 ИСТИНА

         ИЗ Справочник.ГруппыДоступа.Пользователи КАК ГруппыДоступаПользователи

            ВНУТРЕННЕЕ СОЕДИНЕНИЕ РегистрСведений.СоставыГруппПользователей КАК СоставыГруппПользователей

            ПО ГруппыДоступаПользователи.Ссылка = ЗначенияПоУмолчанию.ГруппаДоступа

               И ГруппыДоступаПользователи.Пользователь = СоставыГруппПользователей.ГруппаПользователей

               И СоставыГруппПользователей.Пользователь = &ТекущийПользователь)

;

ВЫБРАТЬ РАЗЛИЧНЫЕ ЗначенияПоУмолчанию.ТипЗначений КАК ТипЗначений

ИЗ ЗначенияПоУмолчаниюДляПользователя КАК ЗначенияПоУмолчанию

СГРУППИРОВАТЬ ПО ЗначенияПоУмолчанию.ТипЗначений

ИМЕЮЩИЕ МИНИМУМ(ЗначенияПоУмолчанию.ВсеРазрешеныБезИсключений) = ИСТИНА
Ответ модели до правки:
ВЫБРАТЬ

    ЗначенияПоУмолчанию.ТипЗначенийДоступа КАК ТипЗначений

ИЗ

    РегистрСведений.ЗначенияГруппДоступаПоУмолчанию КАК ЗначенияПоУмолчанию

    ВНУТРЕННЕЕ СОЕДИНЕНИЕ Справочник.ГруппыДоступа.Пользователи КАК ГруппыДоступаПользователи

    ПО ЗначенияПоУмолчанию.ГруппаДоступа = ГруппыДоступаПользователи.Ссылка

    ВНУТРЕННЕЕ СОЕДИНЕНИЕ РегистрСведений.СоставыГруппПользователей КАК СоставыГруппПользователей

    ПО ГруппыДоступаПользователи.Пользователь = СоставыГруппПользователей.ГруппаПользователей

       И СоставыГруппПользователей.Пользователь = &ТекущийПользователь

СГРУППИРОВАТЬ ПО

    ЗначенияПоУмолчанию.ТипЗначенийДоступа

ИМЕЮЩИЕ МИНИМУМ(ЗначенияПоУмолчанию.ВсеРазрешеныБезИсключений) = ИСТИНА


Ответ модели после NERVE-правки:

bsl

// ПЕРВЫЕ: получить группы доступа текущего пользователя

ВЫБРАТЬ РАЗЛИЧНЫЕ

    ГруппыДоступаПользователи.Ссылка КАК ГруппаДоступа

ПОМЕСТИТЬ ГруппыДоступаПользователя

ИЗ

    Справочник.ГруппыДоступа.Пользователи КАК ГруппыДоступаПользователи

        ВНУТРЕННЕЕ СОЕДИНЕНИЕ РегистрСведений.СоставыГруппПользователей КАК СоставыГруппПользователей

        ПО ГруппыДоступаПользователи.Ссылка = СоставыГруппПользователей.ГруппаПользователей

            И СоставыГруппПользователей.Пользователь = &ТекущийПользователь

;

// Индекс для последующего соединения

СОЗДАТЬ ИНДЕКС ИндексГруппыДоступаПользователя ПО ГруппыДоступаПользователя(ГруппаДоступа)

;

// ВТОРОЙ: получить значения по умолчанию для групп пользователя

ВЫБРАТЬ РАЗЛИЧНЫЕ

    ЗначенияПоУмолчанию.ТипЗначенийДоступа КАК ТипЗначений,

    ЗначенияПоУмолчанию.ВсеРазрешеныБезИсключений КАК ВсеРазрешеныБезИсключений

ПОМЕСТИТЬ ЗначенияПоУмолчаниюДляПользователя

ИЗ

    РегистрСведений.ЗначенияГруппДоступаПоУмолчанию КАК ЗначенияПоУмолчанию

        ВНУТРЕННЕЕ СОЕДИНЕНИЕ ГруппыДоступаПользователя КАК ГруппыДоступаПользователя

        ПО ЗначенияПоУмолчанию.ГруппаДоступа = ГруппыДоступаПользователя.ГруппаДоступа

;

// ТРЕТИЙ: получить типы значений, для которых все разрешены

ВЫБРАТЬ РАЗЛИЧНЫЕ

    ЗначенияПоУмолчаниюДляПользователя.ТипЗначений КАК ТипЗначений

ИЗ

    ЗначенияПоУмолчаниюДляПользователя КАК ЗначенияПоУмолчаниюДляПользователя

СГРУППИРОВАТЬ ПО

    ЗначенияПоУмолчаниюДляПользователя.ТипЗначений

ИМЕЮЩИЕ

    МИНИМУМ(ЗначенияПоУмолчаниюДляПользователя.ВсеРазрешеныБезИсключений) = ИСТИНА
Этот пример честнее первого показывает, что правка меняет, а что нет.
Что стало лучше — подход. Модель до правки просто «расплющила» подзапрос в цепочку соединений: результат тот же, но пропала временная таблица ЗначенияПоУмолчаниюДляПользователя (а она может использоваться дальше в пакете), и вместо ПЕРВЫЕ 1 соединение размножает строки на каждую группу пользователя. Правленая модель предложила классическую для 1С оптимизацию: один раз вычислить группы доступа пользователя во временную таблицу, проиндексировать её и заменить коррелированный подзапрос соединением — с сохранением исходного контракта пакета.
Что осталось плохо — точность. В ответе правленой модели две ошибки:
- Неверное поле соединения — критическая. Исходное условие ГруппыДоступаПользователи.Пользователь = СоставыГруппПользователей.ГруппаПользователей превратилось в ГруппыДоступаПользователи.Ссылка = …ГруппаПользователей: группа доступа сравнивается с группой пользователей, запрос вернёт пустой результат.
- Несуществующий синтаксис индекса. «СОЗДАТЬ ИНДЕКС … ПО Таблица(Поле)» — это SQL. В 1С индекс временной таблицы задаётся в самом запросе: ПОМЕСТИТЬ ГруппыДоступаПользователя … ИНДЕКСИРОВАТЬ ПО ГруппаДоступа.
Вывод: правка по карте 1c_lang_query сдвинула модель к правильной идиоме оптимизации, но не научила её аккуратно переносить поля соединений, а один SQL-рефлекс (CREATE INDEX) пережил подавление. Это ожидаемо: точечная правка убирает конкретные «ошибочные» направления в активациях, но не добавляет знаний, которых в модели нет. Такие случаи — материал для следующей итерации: новой карты по парам с ошибками в соединениях или для DPO.
11. Грабли и ограничения
- Одна метрика на карту и проверку. Margin по всему ответу против margin по diff-токенам — разница в десятки раз. Любое расхождение маски между картой и проверкой делает результаты несопоставимыми.
- Линейный прогноз работает только для малых правок. Для m = 0 и для больших наборов факт заметно расходится с Σ(m−1)·attr — поэтому решение принимается только по замеру.
- Переобучение на val. Жадный отбор подгоняется под выборку. Контрольная половина обязательна; набор без подтверждения на контроле я не сохраняю.
- Соседние навыки. Без guard правка может испортить смежный датасет. Если эксперты пересекаются по лексике (запросы 1С на естественном языке и на языке запросов), guard стоит включать.
- Стоимость. Карта с атрибуцией на 512 парах и жадный отбор на десятках кандидатов — это часы GPU на 27B-модели. Но это всё равно на порядки дешевле нового цикла DPO.
- Обрезка длинных пар. Пары длиннее max_length обрезаются по хвосту; если отличие оказалось за границей, пара выпадает из карты.
Выводы
Дообученная LLM — не чёрный ящик. Пара простых инструментов — хуки на вход down_proj, статистика по парам и градиентная атрибуция — дают карту, на которой видно, какие нейроны тянут модель к ошибке. А строгая процедура отбора с отложенной выборкой и контрольной половиной превращает эту карту в конкретную, воспроизводимую правку весов, которая без изменений едет в GGUF.
Главный практический урок на 1c_lang_query: ошибки «размазаны» по всей глубине сети, и эффективнее не только усиливать правильные нейроны, но и гасить ошибочные нейроны.
Правка всего 15 нейронов дала значительный буст в понимании языка запросов 1с!
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

