Архив базы 1С, в который можно зайти: пообъектная копия на HTTP-сервисах
База данных - Архивирование (backup)

Спросите директора почти любой компании, есть ли у них архив базы 1С, и почти наверняка услышите что-то вроде: «Конечно, есть, админ всё настроил». А теперь попробуйте задать следующий вопрос — что в этом архиве лежит, когда он был сделан в последний раз и поднимется ли из него база, если завтра утром сервер просто не включится, — и обычно на этом месте разговор как-то сам собой затихает.
Я много лет занимаюсь 1С, и мне всегда не нравилось, что архив по своей сути остаётся чёрным ящиком: он вроде бы есть, но заглянуть в него нельзя, и пока не случится беда, никто толком не знает, рабочий он или нет. А когда беда всё-таки случается, проверять уже поздно.
В этой статье я хочу рассказать, как мы пришли к другому подходу, при котором архив — это уже не файл выгрузки, а вторая, вполне живая база: полная копия рабочей, которая обновляется практически в реальном времени и в которую можно зайти в любой момент, когда захочется проверить, всё ли на месте.
Что не так с обычным архивом?
Стандартная схема знакома, думаю, всем. Для файловых баз ночью или после окончания рабочего дня, когда все наконец вышли из программы, запускается скрипт, который куда-то складывает файл выгрузки. С базами на PostgreSQL или MS SQL дела обстоят получше: копию можно делать прямо во время работы, а сами архивы — инкрементными. Но по сути получается то же самое — файл, о котором конечный пользователь ничего не знает и, по большому счёту, знать не может.
Проблем, как мне кажется, здесь три.
Первая — тот самый чёрный ящик: что у него внутри, работоспособно ли это и удастся ли из него восстановиться, остаётся непонятным до последнего.
Вторая — архивы очень часто лежат в той же инфраструктуре, что и сами базы. Сгорел сервер или пришёл шифровальщик — и архивы пропадают вместе с базами, причём ровно в тот момент, когда они нужнее всего.
Третья касается тех, кто арендует серверы или пользуется арендой 1С, что, в общем, почти одно и то же. Директор знает, что данные лежат в надёжном дата-центре и что «архивация производится», но проконтролировать это сам никак не может. А что будет, если шифровальщик проникнет в инфраструктуру самого провайдера, не скажет, пожалуй, никто.
Откуда взялась идея?
Начиналось всё вообще не с архивов. Мы делали обмен данными между множеством магазинов и центральной базой, а когда баз становится несколько десятков - типовой обмен с одним большим файлом начинает заметно буксовать. Поэтому обмен мы построили иначе, пообъектно и через отдельную управляющую систему.
В какой-то момент стало понятно, что архив — это, по сути, частный случай того же самого обмена: есть база-источник и есть база-приёмник, которая должна быть полной копией первой. Всё остальное у нас к тому времени уже было. Так появилась отдельное решение, которое мы назвали «живым» архивом.

Как это устроено?
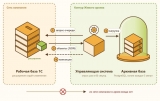
Главное отличие от обычного обмена в том, что база не обменивается с базой напрямую. Между ними стоит управляющая система, и именно она сама ходит в каждую базу. Цикл выглядит примерно так:
- Управляющая система спрашивает у рабочей базы, какие объекты накопились к выгрузке.
- В несколько потоков забирает сами объекты.
- Отправляет их в архивную базу и убеждается, что они там действительно загрузились.
- Отправляет в рабочую базу квитанции, и только после этого с объектов снимается регистрация.
В одном сообщении может быть один объект или десять — это уже как настроишь. Формат — JSON: он самый простой и, что для нас важнее, быстрее всего работает. Опрашиваем базу обычно раз в 5-10 минут, хотя можно и чаще, хоть раз в 10–20 секунд: систему это почти не нагружает.
Транспорт — HTTP-сервисы 1С, и это, пожалуй, ключевое решение во всей схеме. Сообщения формируются очень быстро, а лишней, паразитной нагрузки на процессор почти нет: по нашим замерам, дополнительная нагрузка на рабочую базу составляет 1–3%.
Изначально каждый архив мы настраивали вручную, но примерно на десятый раз это уже надоело, и я добавил в расширение, функции, автоматизирующие весь процесс: установку апача, публикацию базы, проверку подключения и формирование токена для авторизации.
Также в ходе общения с одним из клиентов появился еще один элемент схемы - предварительно настроенный роутер, который является точкой входа в сеть: бухгалтер или руководитель может включить его в сеть в своем кабинете, он получит по DHCP адрес, установит VPN тоннель в нашу сеть, и через него управляющая система начнет осуществлять выгрузку данных. Это позволяет предельно упростить настройку, реализовать подключение даже в случае отсутствия "белого" ip-адреса, отсутствия сисадмина и очень удаленного клиента. Также такой роутер позволяет реализовать архивацию в тайне от системного администратора!) Да, бывают и такие ситуации...
Да, теоретически, в рамках Zero Trust, со стороны клиента может быть установлен еще один роутер, обеспечивающий ограничение нашего доступа только одним необходимым ip-адресом и портом.
Что делает расширение в рабочей базе?
В рабочую базу ставится обычное расширение 1С, и здесь есть принципиальный момент: оно не меняет данные. Вообще. Единственное, что оно может сделать, — почистить собственную очередь к выгрузке.
Основных функций у него три:
- хранит список изменённых объектов и отдаёт его по запросу;
- формирует выгрузку запрошенных объектов;
- принимает квитанции и снимает регистрацию.
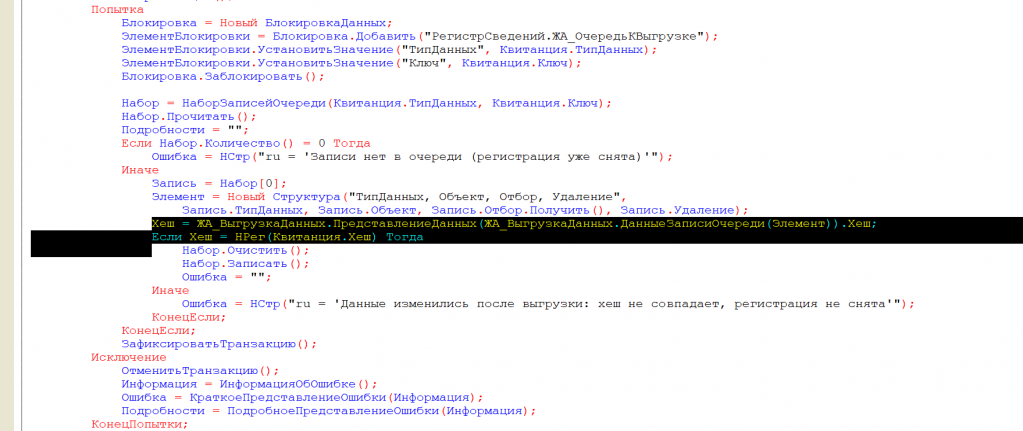
С квитанциями связана одна деталь, которую мы перенесли из того же обмена магазинов и которая лично мне нравится в этой схеме больше всего. Перед тем как снять регистрацию, расширение заново формирует JSON-представление объекта и сравнивает его хэш с тем, что был на момент выгрузки. Если хэши совпали, регистрация снимается; если нет — значит, пока объект ехал в архив, его успели поменять, и он уйдёт туда ещё раз. Благодаря этому правки, сделанные, что называется, «в полёте», не теряются.
Есть и служебная функция: расширение умеет выгрузить саму конфигурацию и подключённые расширения. Зачем это нужно, расскажу чуть ниже.
Отдельно скажу про пароли. По умолчанию в архив не передаются никакие пароли и учётные данные, которые хранятся в программе: в современных типовых конфигурациях для этого используется Библиотека стандартных подсистем с её регистром «Безопасное хранилище данных», и именно этот регистр в архив не уходит. Если же нужно, чтобы в архивной базе хранилось вообще всё, это включается на странице настроек расширения в клиентской базе. Пароли, которые хранятся мимо этого механизма, естественно, передаются в архив вместе с остальными данными. А если безопасное хранилище в архив не передавалось, то и пароли там не сохраняются, так что после восстановления их придётся завести заново.
Само расширение для рабочей базы существует в двух версиях. Стандартная предполагает возможность автоматического обновления, и это обновление — единственное, что передаётся с сервера в рабочую базу. Квитанции о получении туда, конечно, тоже приходят, но они затрагивают только служебные данные о зарегистрированных объектах и на данные клиента повлиять никак не могут, тогда как обновление расширения теоретически может делать что угодно.
Поэтому для тех, кто придерживается концепции нулевого доверия, есть вторая версия — без автоматического обновления, которая реализует исключительно однонаправленную передачу данных. Обновляет её сам пользователь: если обновление требуется для работы архива, ему приходит извещение по электронной почте (ситуация нетиповая — скорее раз в полгода, при каких-то глобальных изменениях формата), а новую версию можно скачать в личном кабинете на нашем сайте, самостоятельно проверить и установить в базу.
Отдельно расскажу о регистрации изменений, потому что с ней в расширениях связана известная неприятность: если хранить её в плане обмена внутри расширения, такой план обмена тянет за собой в расширение все объекты конфигурации. В первых внедрениях мы обходили это либо одним объектом, добавленным в конфигурацию, либо типовыми планами обмена — они покрывают почти всё, что нужно в учёте, хотя и со своими нюансами. Нашим тогдашним клиентам это не мешало: базы у них старые и доработанные ещё с тех времён, когда расширений не было. Но нам хотелось, чтобы Живой архив подключался к абсолютно типовой конфигурации, которую дорабатывают только расширениями, и в итоге мы реализовали в самом расширении собственный регистр, который хранит все изменения. Теперь типовую конфигурацию трогать не нужно совсем — достаточно одного расширения, и этот вариант уже оттестирован.
Архивная база
С архивной стороны база всегда работает на нормальной СУБД — у нас это PostgreSQL, — даже если рабочая база файловая. Для архивной базы настроена непрерывная отправка журналов транзакций и хранятся они месяц. Это даёт довольно важную вещь: откатиться можно на любой момент, а не только на «вчерашнюю ночь».
Отдельная история — изменения структуры. Допустим, конфигурацию обновили или добавили в неё реквизит, и структура архивной базы перестала совпадать с рабочей. Обмен по изменившимся типам в этот момент встаёт, а объекты начинают копиться в очереди. Управляющая система замечает рост очереди, запрашивает у рабочей базы CF и все подключённые расширения и сама устанавливает их в архивную базу, после чего зависшие объекты спокойно уходят дальше. Собственно, для этого и нужна та служебная функция выгрузки конфигурации, о которой я упоминал выше.
Конфигурация при этом может быть любой — типовой, доработанной, самописной: передаются объекты, а что это за прикладное решение, обмену, в общем-то, всё равно. Нужна только платформа не ниже 8.3.
Первичное наполнение
Залить архив с нуля пообъектно, конечно, можно, но долго: на некоторых базах, с которыми мы работали, это занимало от суток до месяца. Поэтому в случае с большими базами мы делаем проще: расширение создаёт узел плана обмена и выгружает базу в DT, этот файл уезжает на сервер архивации, и дальше передаются уже только изменения. Настройка на стороне клиента занимает около получаса, а полностью архивация запускается сама в течение суток.
В случае обычных баз 1С малого и среднего размера (до 10-20Гб) выгрузка конфигурации, расширений и полного набора данных автоматизирована, никаких дополнительных действий делать не нужно.
Шифровальщики и честные ограничения
Самое ценное в этой схеме, на мой взгляд, — разделение систем. Со стороны архива точкой входа в рабочую систему служит, условно говоря, один порт на сервере, а вот из рабочей системы в архивную входа нет вообще. Так что шифровальщик, попавший в сеть компании, до архива просто не дотянется.
Если данные испортятся на уровне СУБД, база упадёт, и обмен остановится сам собой. Естественно, по объектам, которые расширение на стороне клиента не может даже прочитать. Остальные объекты будут передаваться как обычно, и это упростит восстановление БД. Это, кстати, интересный момент с точки зрения защиты данных от потери на физическом уровне - никакие повреждения физической структуры данных переданы по такому обмену быть не могут, архив останется целым.
Хуже, когда порча идёт на уровне наполнения прикладных объектов: кривая обработка или тот же шифровальщик меняет документы, и все эти изменения честно регистрируются и уезжают в архив. Здесь выручают инкрементные архивы архивной базы — можно откатиться на момент до порчи.
Есть, впрочем, и сценарии, от которых схема сама по себе не защищает. Можно обработкой вычистить очередь к выгрузке, и тогда в архив попросту ничего не поедет. Можно подменить расширение так, чтобы оно отдавало ложные данные, и вот от этого защититься действительно сложно.
Ответ на это мы видим в анализе самого потока объектов. Если вдруг пошёл нехарактерно большой поток, например массовое удаление, или посыпались документы за давно закрытый период, система должна остановить обмен и спросить у бухгалтера, что происходит, а архив при этом останется целым. Сразу оговорюсь: этого пока нет, это в планах — в виде алгоритмов или ИИ-агентов, которые будут следить за потоком.
Где хранить копию?
Вариантов здесь два. Первый — на наших серверах (сейчас это Краснодар и Пермь). Второй — у самого клиента, но на отдельном компьютере, который я называю закрытым архивным сервером. Не все готовы отдавать наружу данные, содержащие коммерческую тайну, и это нормально.
Требование к такому серверу, по сути, одно: из сети компании на него не должно быть ни одной точки входа, а между сетью и ним стоит файрвол. Работать на нём никто не должен — его настраивают один раз, и дальше он только хранит копию. По желанию можно открыть один HTTP-порт, чтобы заходить в архивную базу и убеждаться, что всё в порядке; заходят туда под пользователем с урезанными правами, который ничего не может изменить.
Из неочевидного: на таком сервере нужна серверная лицензия 1С, потому что в файловом варианте управляющая система будет работать медленно и некорректно. Каких-то особых требований к железу, сверх обычных для 1С, при этом нет.

Как восстанавливаться?
После того как железо клиента снова поднято, мы копируем туда базу из архива, и это занимает час, максимум два. Если ждать нельзя, можно какое-то время поработать в базе на нашей стороне. Потом копия возвращается на сервер клиента, перенастраиваются коды в плане обмена — и, собственно, всё. Пользователи в современных конфигурациях — это справочник, а права живут в самой конфигурации, так что остаётся только отметить, кому разрешён вход, и задать пароли.
Теряется при этом только то, что не успело уйти по последнему опросу, то есть, как правило, меньше 5-10 минут работы. Или минуты - как настроено.
И скажу честно: боевых восстановлений у нас пока не было. Архивные базы живут и наполняются, но подниматься из них пока ни разу не пришлось — и, надеюсь, не придётся.
Чего эта схема не делает
В архив попадает всё, что лежит в самой базе и может быть добавлено в план обмена, а вот файлы, которые хранятся в томах на диске, нужно архивировать отдельно.
Для 1С:Фреш всё это, по-моему, не нужно: базы и так лежат на серверах 1С, и с точки зрения надёжности хранения это хороший вариант.
И да, похожую защиту можно собрать и без 1С — например, поставить отдельный сервер на Proxmox, который будет утягивать к себе копии и в который нельзя зайти из внутренней сети. Это вполне разумный путь, если архивировать нужно всю инфраструктуру, а не только базы 1С. Но он требует хорошего системного администратора и заметно сложнее. Для одних только баз 1С, на мой взгляд, ничего существенного он не добавит.
Вместо заключения
Для меня главный сдвиг здесь, пожалуй, не технический, а скорее в голове. Архив перестаёт быть файлом, в который приходится верить на слово, и становится базой, в которую можно зайти и увидеть сегодняшние документы. И директору, мне кажется, это объяснить куда проще, чем любые регламенты резервного копирования.
Мы оформили этот подход в решение и называем его «Живой архив». Но саму идею — пообъектную копию через HTTP-сервисы, проверку хэша при снятии регистрации, архивную базу на СУБД с инкрементными копиями и изоляцию архива от рабочей сети — вполне можно повторить и своими силами.
Буду рад вопросам и критике в комментариях. Особенно интересно, как вы проверяете свои архивы и приходилось ли вам по-настоящему восстанавливаться из них.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

