От Postman до промышленной интеграции: как 1С-разработчику работать с API без хаоса
От монолитных систем к экосистемам интеграций
За последние несколько лет я обратил внимание, что ландшафт корпоративных систем сильно изменился. Раньше мы видели монолитные системы, в основном построенные вокруг 1С, а сейчас они все чаще уступают место экосистемам, которые заставляют 1С постоянно взаимодействовать с огромным количеством сервисов.
И если этот процесс не привести в порядок, если не следовать определенным общим принципам, то все это приводит к страшным болям. Приходится просыпаться ночью из-за того, что у нас нет данных, что-то не выгрузилось, где-то что-то не обновилось или, наоборот, обновилось так, что теперь на сайте нет картинок.
Постараемся разобрать, как сделать эту работу системной, предсказуемой и безопасной.
Сегодня даже небольшие компании используют интеграции, например с маркетплейсами, облачными CRM-системами и, естественно, государственными системами: «Честный знак», ЕГАИС и так далее.
Основной формат взаимодействия со всем этим – REST API. И когда разработчик так или иначе сталкивается с необходимостью реализовать эти интеграции, ему нужно определиться с инструментарием, который он будет использовать в работе.
Инструменты делятся на две основные группы.
Первая группа – это внешние инструменты, связанные с проектированием, тестированием и изучением новых систем. К ним относятся Postman, Insomnia или очень легкий Hoppscotch.
Вторая группа – внутренние инструменты, которые находятся внутри экосистемы 1С. Как правило, это консоли HTTP-запросов, которых существует довольно большое количество.
Рассмотрим плюсы и минусы каждого инструмента, а затем перейдем к практическим примерам.
Внешние инструменты для работы с API
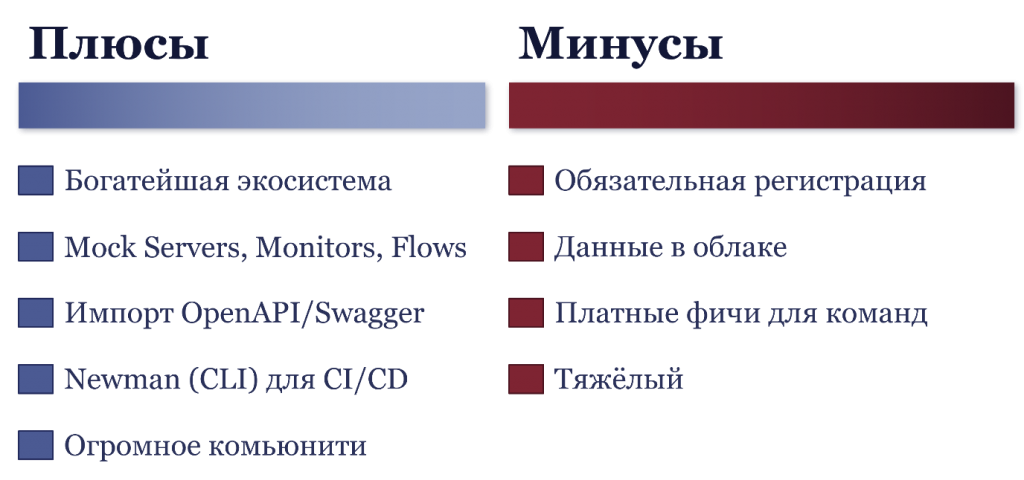
Начнем с тяжеловеса – Postman. Это абсолютный лидер рынка. По сути, не просто клиент для отправки запросов, а целая экосистема, в которую входят коллекции, окружения, огромное количество переменных, автотесты, мониторинг и многое другое.
Единственное, что здесь удручает, – с недавних пор, хотя уже несколько лет, данные находятся у Postman в облаке, включая все ваши конфиденциальные данные. В том числе токены авторизации и все остальное. Поэтому возникают вопросы со стороны служб безопасности.
Есть и некоторые нюансы, которые касаются командной разработки. Практически все возможности, используемые для командной разработки, платные.
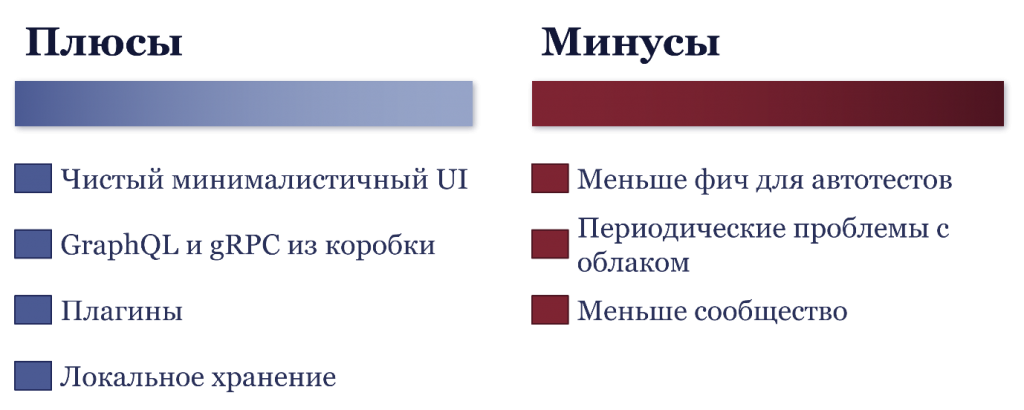
Следующий инструмент – Insomnia. Он абсолютно минималистичен, его основная цель – быстро работать.
Главное преимущество по сравнению с Postman заключается в том, что он организует локальное хранение данных на вашем компьютере или сервере, где вы его используете. Для многих служб безопасности это будет единственной альтернативой при работе с внешними сервисами.
К минусам можно отнести то, что инструментов для автотестов здесь очень мало, а сообщество довольно небольшое по сравнению с Postman.
Если вы решите найти решение какой-то проблемы в Postman, то, поскольку системы и сервисы бывают разные, вы сможете довольно легко найти его через Google. С Insomnia, конечно, будет посложнее.
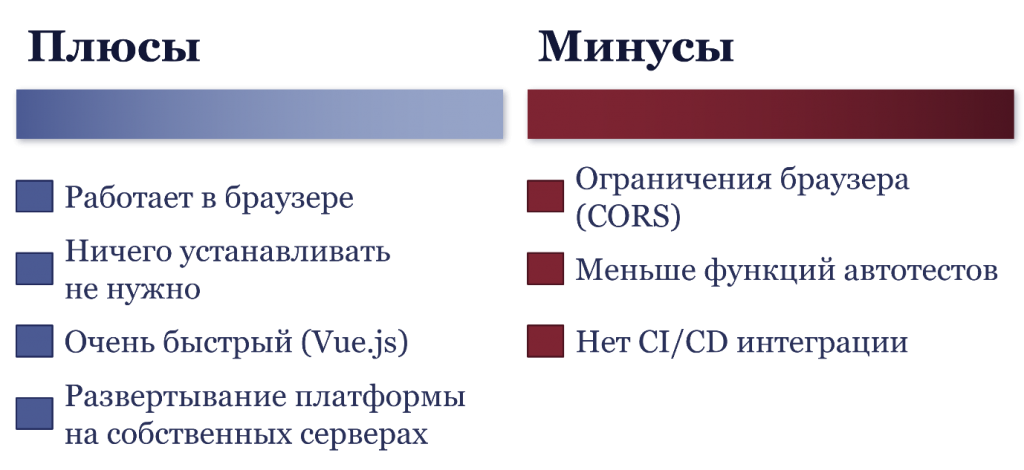
Последний внешний инструмент, который я хочу рассмотреть, – Hoppscotch. Это чисто браузерный инструмент, и в этом его особенность.
Ничего скачивать и устанавливать не нужно. Открыли ссылку, используете в браузере – все работает быстро. Единственное, поскольку инструмент браузерный, рано или поздно вы столкнетесь с ограничениями безопасности браузера. Это можно отнести к его минусам.
Но для того, чтобы кого-то обучить, быстро что-то продемонстрировать или провести тест, это довольно хороший инструмент.
Теперь перейдем внутрь контура 1С.
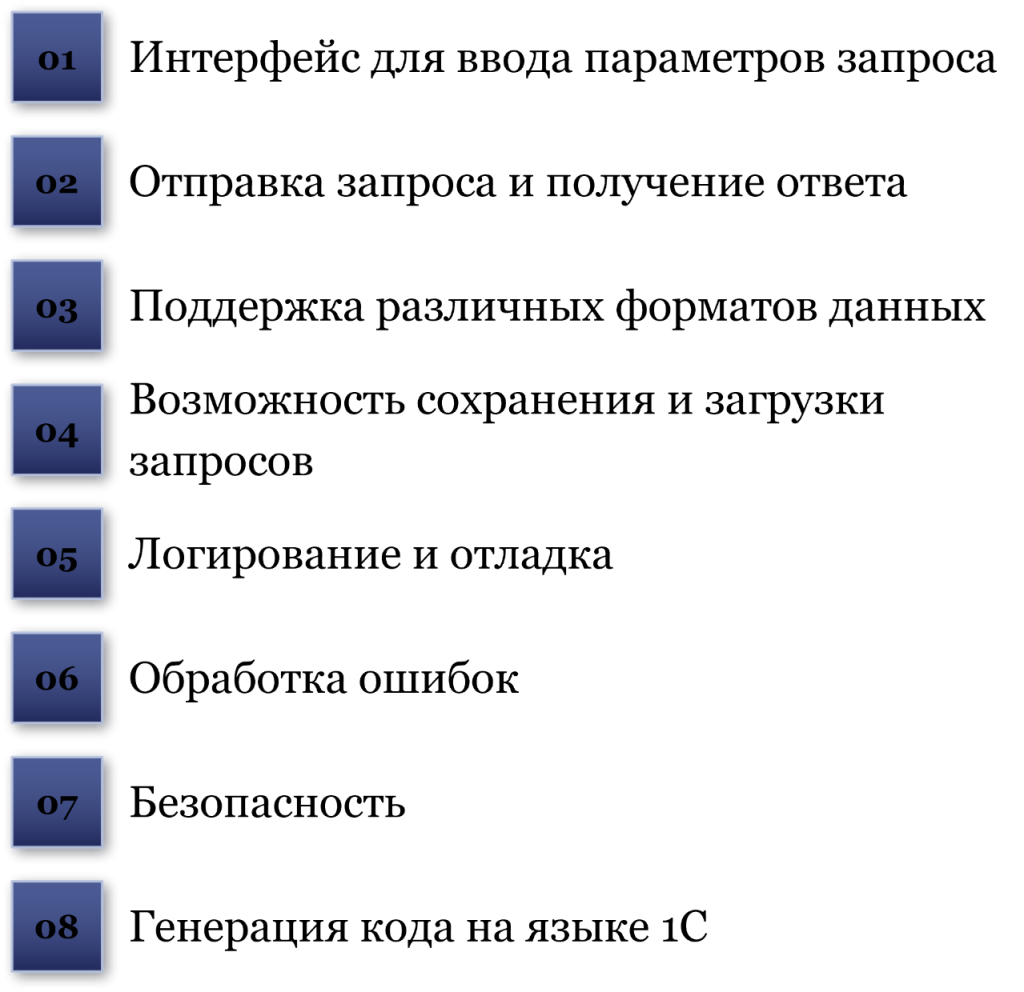
Здесь я хочу рассмотреть консоли HTTP-запросов. По большому счету это внешние обработки, которые позволяют тестировать запросы и генерировать код на встроенном языке. Большинство из них умеют это делать, что очень здорово.
Postman
Для работы с внешними сервисами мой выбор – Postman, просто потому что он является стандартом индустрии и обладает полным набором возможностей.
Честно скажу, у меня осталась версия Postman, которая еще локально хранит все данные. Она установлена на одном ноутбуке, и я ее берегу как зеницу ока. Обновление туда еще не добралось, я все время от него отказываюсь.
Работа с переменными в Postman
Разберем возможности Postman, которыми я хотел бы поделиться.
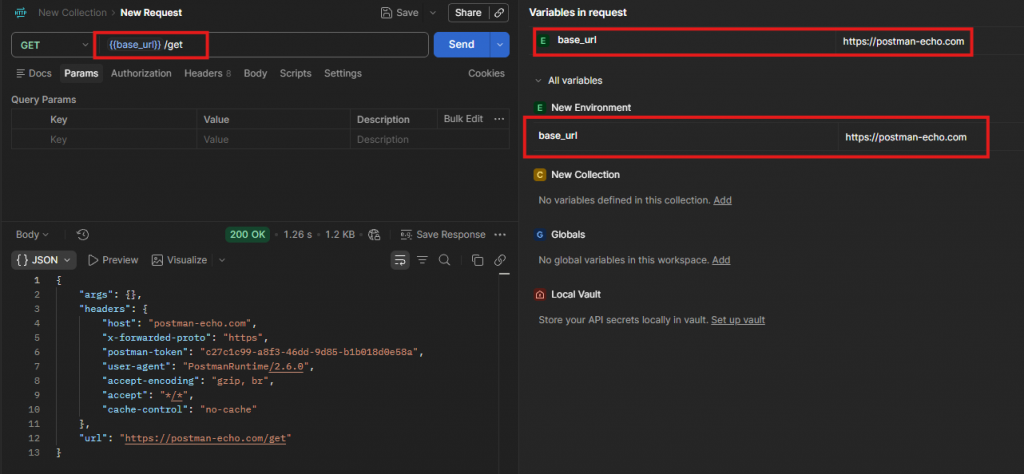
Первое – работа с переменными. Они бывают разных видов, но в целом ситуация одинакова. Переменные, как и в любом другом языке, – это инструмент для замены ручного ввода.
Когда вы работаете с каким-то сервисом, очень редко бывает всего один запрос. Как правило, их довольно большое количество. Вы можете получать токен авторизации, запрашивать список контрагентов, рассылать документы этим контрагентам. Таких запросов может быть и 50.
И если вы будете адрес сервиса указывать в каждом запросе, а поставщик по какой-то причине решит поменять этот адрес, вам придется переписывать его во всех 50 запросах.
Если же использовать переменную, в нашем случае Base URL, которая будет передаваться во все запросы коллекции, то при изменении адреса сервиса мы меняем значение переменной, и оно автоматически заменяется во всех запросах.
Работа с окружением в Postman
Поскольку у нас часто возникает задача работать с несколькими окружениями, я хотел бы продемонстрировать два варианта: продуктивное и тестовое окружения.
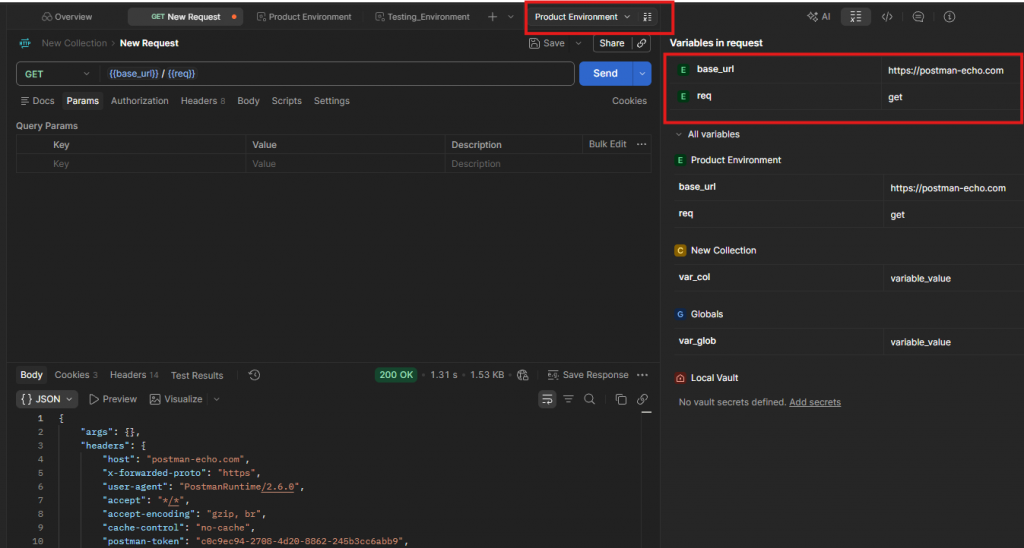
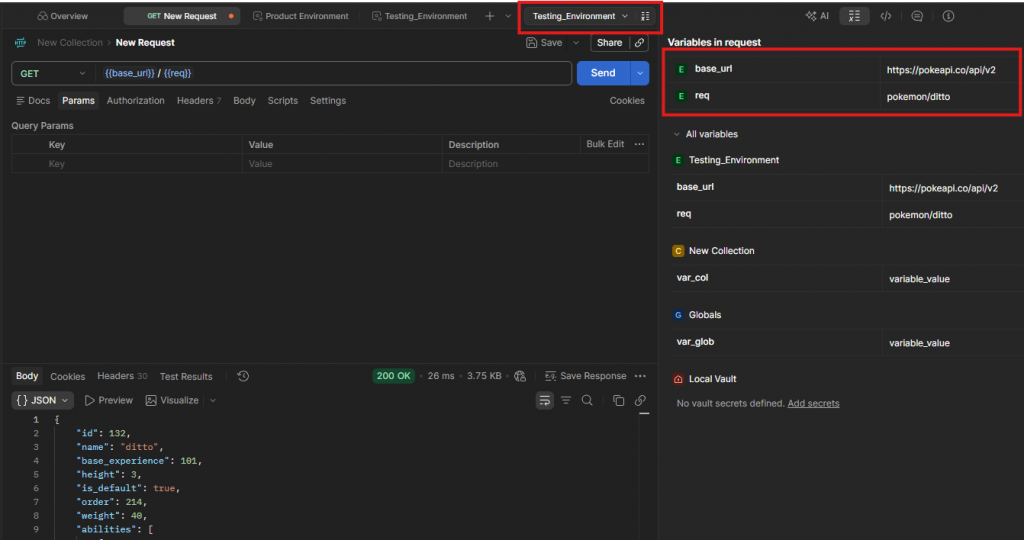
Для продуктивного и тестового окружений, как правило, используются разные сервисы и разные токены авторизации. А запросы могут быть одни и те же, потому что это один и тот же продукт.
Мы можем реализовать два окружения, в которых определим переменные. В одном окружении в переменной Base URL будет записан адрес тестового сервиса и его токен, а в другом – продуктивного.
И, просто переключаясь одним кликом между этими окружениями, мы будем формировать запросы в нужном контуре.
Работа с коллекциями в Postman
В Postman существует такой инструмент, как коллекции.
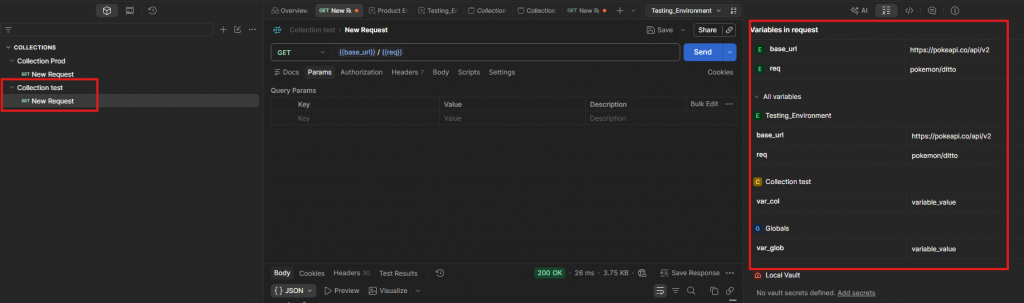
Коллекции позволяют сохранять переносимый список запросов. Вы можете не только сохранить его – там хранится вся история ваших запросов, – но и делиться им с коллегами.
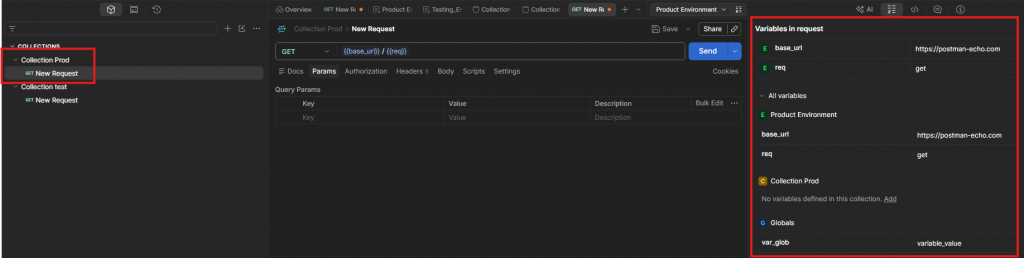
В нашем примере для тестового и продуктивного контуров реализована история всех запросов. Мы всегда можем вернуться к какому-то из них, просмотреть заново, какие результаты он возвращал, и от него начать новую ветку исследования.
Автоматизация коллекций для проведения тестов API
Когда коллекции собраны и отлажены, нам так или иначе нужно проверять работу внешних сервисов или наших собственных сервисов.
Возможно, это делается ежедневно, несколько раз в день, раз в час или раз в неделю.
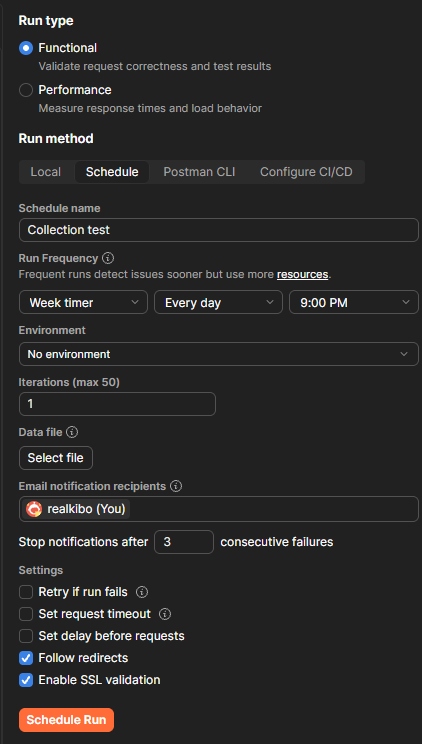
Можно, конечно, проводить такие проверки вручную и смотреть на результаты. Но в Postman существует инструмент Collection Runner, который позволяет в автоматическом режиме выполнять пакеты запросов.
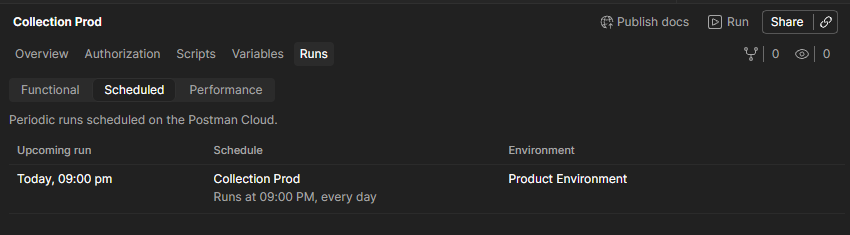
Причем это можно делать с помощью планировщика. Вы можете запланировать, в какое время будут выполняться пакеты запросов, и получать результаты мониторинга по этим автотестам.
Таким образом, вы будете знать, прошли какие-то жизненно важные запросы или нет, и сможете реагировать раньше, чем вам об этом сообщит пользователь. Я считаю, что это крайне удобно.
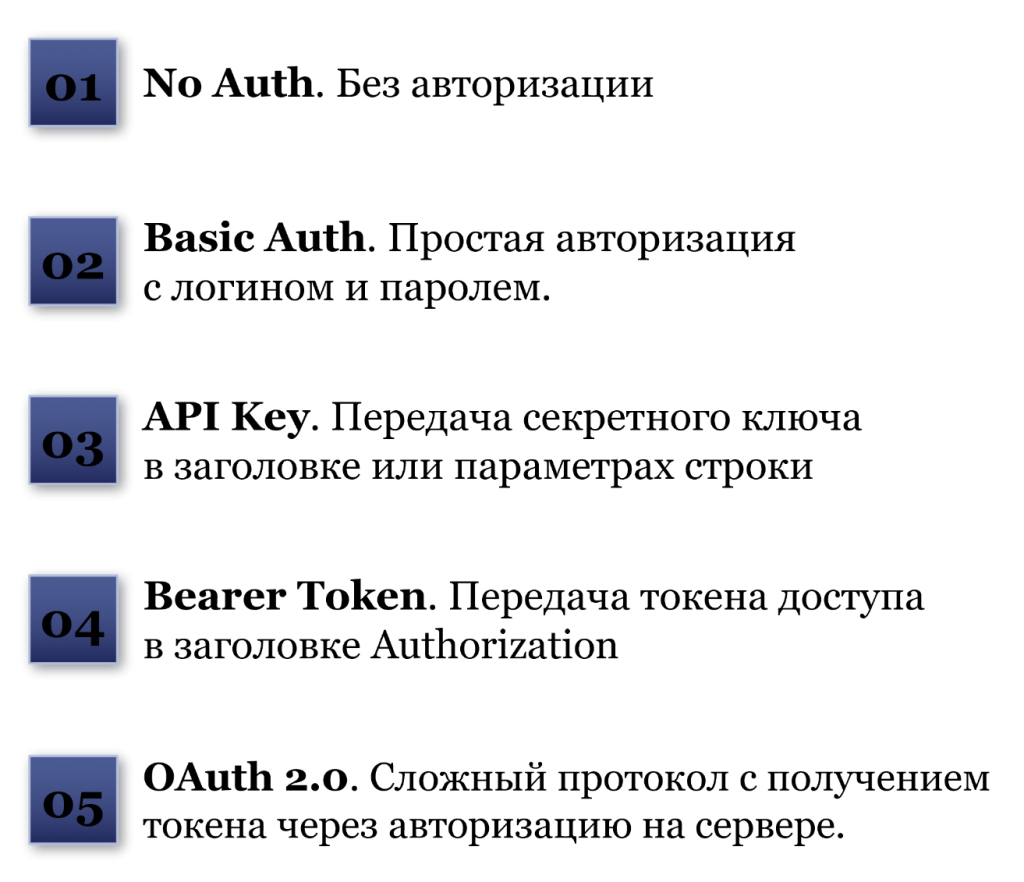
Также Postman поддерживает разные варианты авторизации, поскольку веб-сервисы зачастую требуют ее прохождения.
Поддерживается обычная авторизация с логином и паролем, авторизация через API-ключи, когда мы просто передаем ключ, Bearer-токены.
И самое интересное – поддерживается OAuth 2.0, один из самых сложных механизмов авторизации. Postman умеет открывать окно авторизации и потом сохранять полученный токен.
Конструкции запросов
Теперь перейдем в среду 1С.
При работе с API у нас используются четыре стандартных HTTP-метода:
-
GET-запросы – для получения данных.
-
POST-запросы – для передачи или создания данных.
-
PUT/PATCH-запросы – для полного или частичного обновления данных.
-
DELETE-запросы – для удаления данных.
Писать весь этот код руками – чистая рутина, которую можно легко автоматизировать. Для этого лично я использую консоль HTTP-запросов, которая находится у меня между Postman и конфигурацией 1С.
Всю инфраструктуру я изучаю в Postman: строю проект, проверяю все запросы, определяю параметры. А потом мне нужно проверить, как все это работает в 1С.
Чтобы не писать для этого отдельную программу, я добавляю в консоль HTTP-запросов все сервисы, которые использую, все запросы, параметры, тела запросов и так далее. Проверяю, как они выполняются именно на стороне 1С, нет ли каких-то ограничений. И если ограничений нет, с помощью консоли в том числе генерирую шаблонный код.
Здесь нужно понимать, что код именно шаблонный. Как вы знаете, в 1С у нас много конструкторов, и все они формируют именно шаблонный код, который мы либо оставляем, если нас все устраивает, либо дорабатываем.
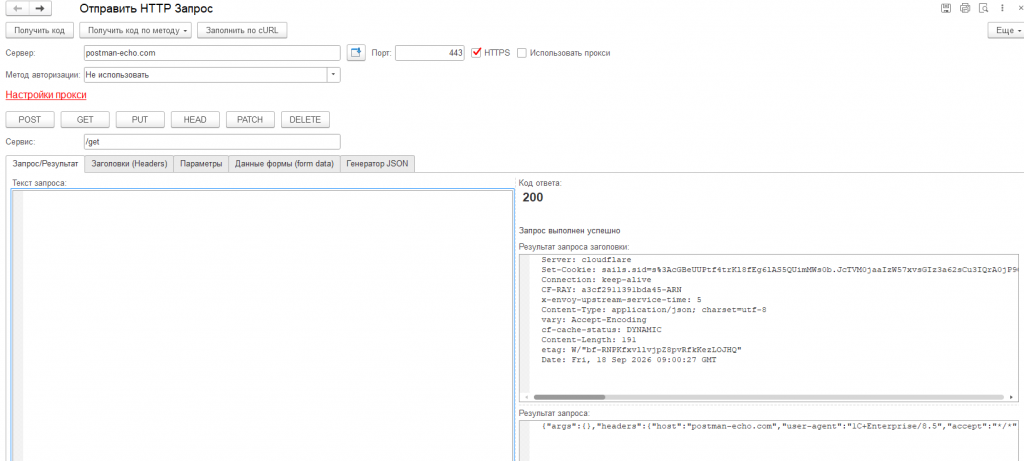
Консолей в интернете достаточно много, есть бесплатные и коммерческие. Как правило, бесплатные код на 1С не генерируют. По крайней мере, я таких не нашел.
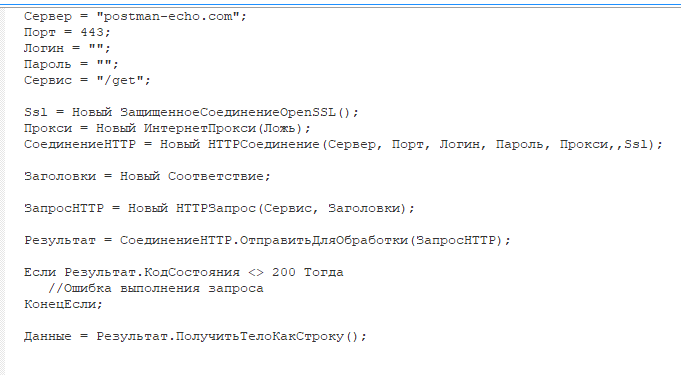
Я пользуюсь консолью, которая генерирует код.
Например, у нас есть запрос, который мы сначала выполняли в Postman. Я добавил этот же запрос в консоль HTTP-запросов и сформировал по нему код.
В результате у нас есть и подключение, и обработка результата. Мы подключаемся и получаем данные.
Это не реклама конкретной консоли, я сам ею пользуюсь. Ссылка на нее: //infostart.ru/1c/tools/835540/, возможно, кому-то она будет интересна.
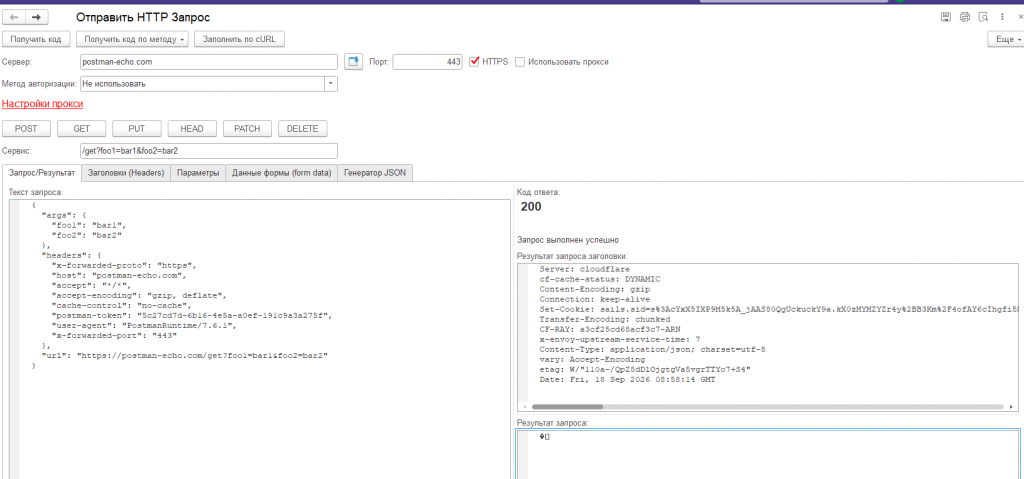
Однако запросы не всегда бывают простыми и линейными. Иногда возникает необходимость передать тело запроса.
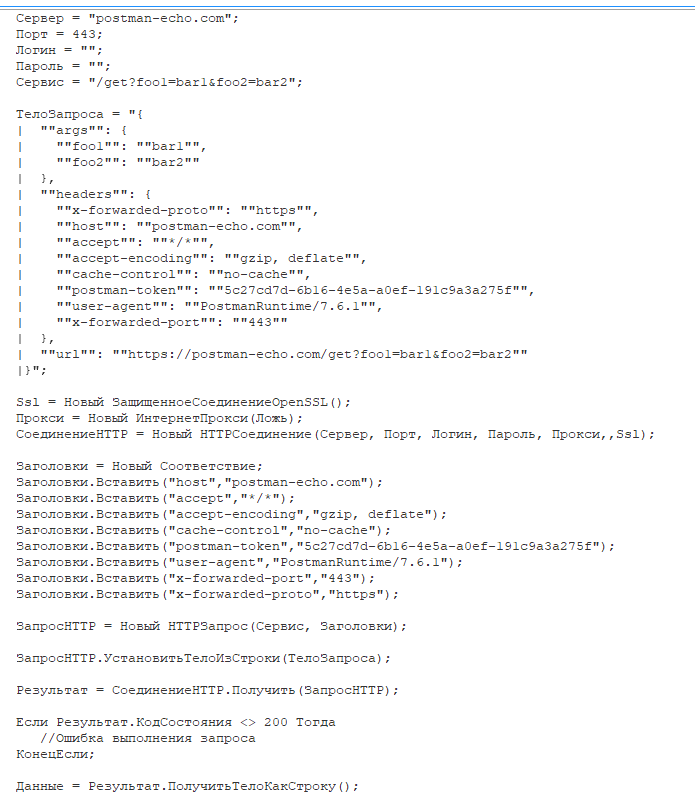
Некоторые консоли не умеют работать с телом запроса, но используемая мной консоль такую возможность поддерживает и формирует итоговый код даже при сложном варианте запроса.
Типовые ошибки
Когда мы работаем с конструкторами или консолями, мы всегда будем получать типовой шаблонный код, который не всегда оптимален и не всегда работает правильно. Могут возникать ошибки, несрабатывания, потеря данных и так далее.
Это может зависеть не только от консоли, но и от особенностей самого сервиса, с которым вы работаете, а также от человеческого фактора.
Поэтому разработчики так или иначе допускают ряд ошибок при доработке типового кода, который формирует консоль HTTP-запросов.
Я выделил шесть ошибок, которые чаще всего встречаю в работе. Все они собраны на основе собственного опыта.
Игнорирование тайм-аутов
Первая ошибка – игнорирование тайм-аутов. Когда вы пытаетесь подключиться к сервису, используя HTTP-соединение, зачастую забываете указать тайм-аут.
В результате сеанс, который подключается к сервису, зависает до момента, пока не сработает системный тайм-аут сервиса, к которому мы подключаемся.
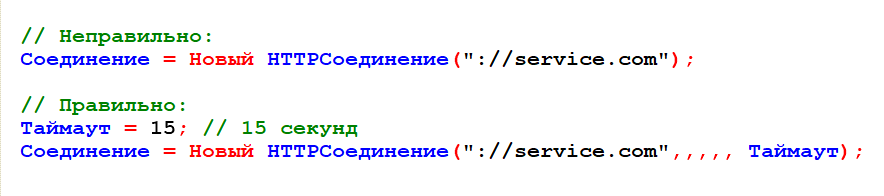
Для решения этой проблемы у нас в HTTP-соединении есть специальный параметр – тайм-аут.
Для REST API обычно я использую тайм-ауты от 10 до 30 секунд в зависимости от метода.
Если мы в эти 15 секунд, как в данном примере, не укладываемся, я разрываю соединение и либо повторяю запрос, либо больше ничего не делаю.
Неправильная кодировка и спецсимволы в URL
Вторая проблема – неправильная кодировка и специальные символы.
Она возникает, когда мы передаем параметры строки так, как они есть.
Проблемы, как правило, связаны с кириллицей, амперсандами, знаками равенства и вопросительными знаками.
Если такие символы попадаются в процессе передачи параметров, сервер зачастую возвращает ошибку 400 Bad Request. Естественно, запрос не выполняется.
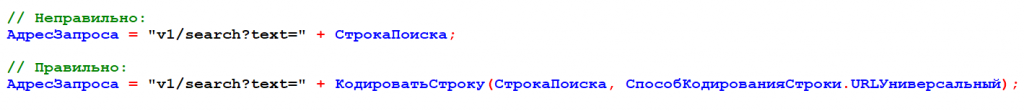
Для обхода этой ошибки я использую метод «КодироватьСтроку» с соответствующими параметрами, чтобы все эти символы правильно кодировались.
Утечки памяти при чтении больших JSON / XML
Следующая проблема – попытка прочитать огромный ответ от сервера.
Допустим, вы работаете с маркетплейсами и запросили детализацию продаж за месяц или остатки товаров на всех складах. В ответ может вернуться файл размером 150–300 МБ.
Если вы начнете целиком загружать его в оперативную память, то, конечно, при очень мощных серверах и хорошей инфраструктуре проблемы, возможно, и не будет. Но не у всех клиентов такая инфраструктура есть, и зачастую сервисы падают с ошибкой недостатка памяти, особенно на 32-битных рабочих процессах.
Может возникнуть вопрос: откуда вообще взялись эти 32-битные процессы? Мы что, в начале двухтысячных?
Вы удивитесь, таких процессов очень много. Почему их так много? Потому что при подключении некоторого специфического оборудования приходится использовать 32-битные системы.
Я, например, работал с угольной отраслью, обслуживал предприятия. Там очень много специфического оборудования, которое подключается в том числе к 1С и работает только с 32-битными системами. По-другому я не могу.
Поэтому, когда начинаю работать с чтением файла в 32-битной системе, недостаток памяти – самая популярная ошибка. Пусть у вас будет хоть миллион памяти, но ограничения 32-битной платформы мы никак не обойдем.
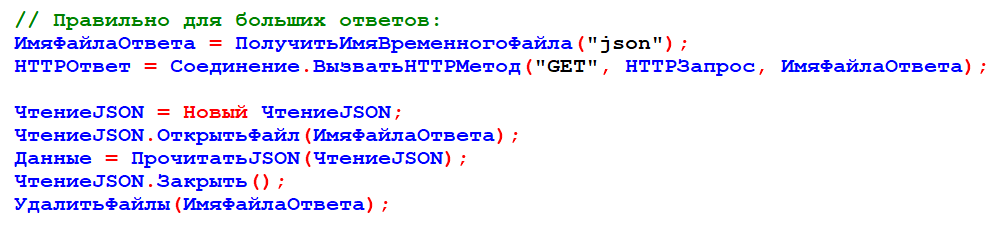
Поэтому в такой ситуации рекомендую записывать ответ во временный файл и затем производить потоковое чтение этого файла.
Жесткое кодирование тела запроса
Следующая ошибка – жесткое кодирование тела запроса. Это вообще забавная проблема, когда разработчик пытается формировать тело запроса через конкатенацию строк.
Я встречал такие случаи. Мы просто через плюс начинаем добавлять огромное тело запроса. Естественно, как только встречается кавычка или перенос строки, все ломается.
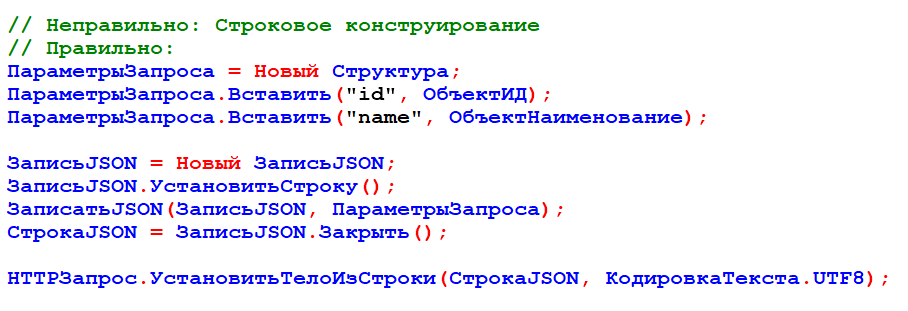
Для решения этой проблемы я рекомендую всегда использовать стандартные коллекции значений в 1С: структуры, соответствия, массивы.
С помощью метода «ЗаписатьJSON» можно формировать валидный JSON, который сам экранирует все кавычки, переносы строк и так далее. Он все сделает правильно.
Игнорирование HTTP-статусов ответа
Следующая проблема – игнорирование статусов HTTP.
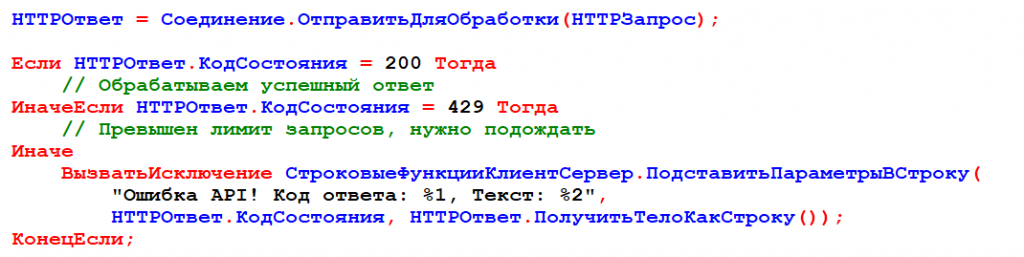
Она возникает, когда разработчик слепо доверяет серверу, рассчитывая, что все вернется правильно, и сразу начинает разбирать тело ответа, не проверяя, что вообще пришло.
Что будет, если сервер вернет ошибку 401, 404 или 500?
Например, в теле ответа будет HTML-страница с ошибкой. Мы начнем обрабатывать ее через «ПрочитатьJSON», и обработка завершится ошибкой. Зачем мы все это делали – совершенно непонятно.
Поэтому крайне рекомендую реализовывать проверку кодов состояний и обрабатывать только успешные ответы.
В документации к сервису всегда можно посмотреть, какие коды состояния он возвращает. Обычно это 200–201, но бывают варианты. Нужно посмотреть, какие состояния считаются успешными, и обрабатывать именно их. Все остальные сразу записывать в лог.
Несоблюдение лимитов
Следующая крайне популярная проблема – несоблюдение лимитов запросов.
Особенно часто она возникает при работе с популярными сервисами: Wildberries, Ozon, «Честным знаком».
Иногда разработчики реализуют интеграцию, формируют красивый цикл, который отправляет на сервер 100 000 запросов в секунду. В таком случае вы в лучшем случае получите ошибку 429, которая говорит о том, что отправляется слишком много запросов. А в худшем случае интеграционный сервис, с которого отправляются запросы, заблокируют на несколько часов.

Поэтому рекомендую либо подключать обработчик ожидания, либо реализовывать очередь отправки.
Это можно сделать с помощью регистра сведений, а затем обрабатывать очередь фоновым заданием.
Перехват ошибок и повторные вызовы в 1С
Для надежности я использую алгоритм, который называется «Перехват ошибок и повторных вызовов».
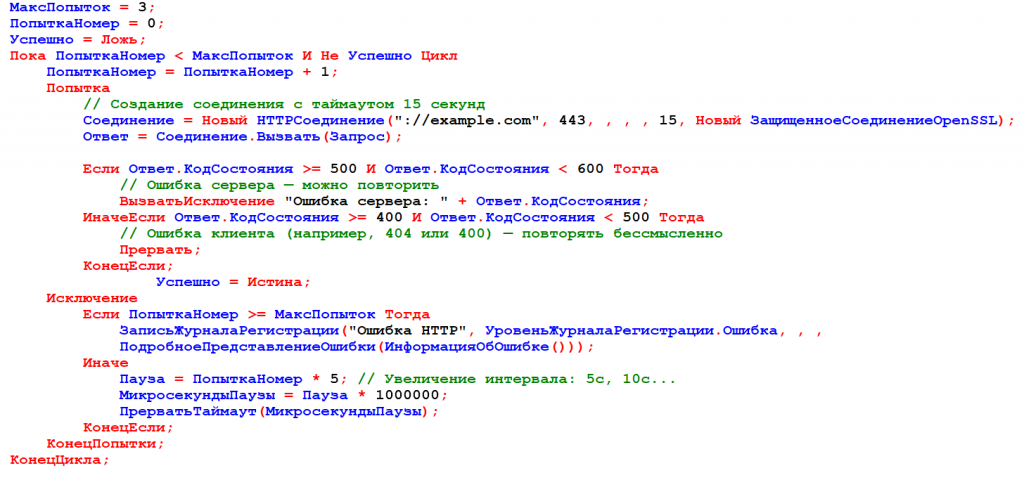
Он похож на рассмотренную обработку кодов состояния, но немного доработан.
Работает он следующим образом.
Для начала я определяю максимальное количество попыток подключения к сервису. Дальше определяю, какие бывают ошибки. Я разделил их на два основных вида.
Первый – ошибки сервера с кодами от 500 до 599.
Если это ошибка сервера, то запрос в теории можно повторить. Сервер сейчас не работает, а через секунду, через 10 секунд или через минуту может восстановиться.
Обратите внимание, в конце алгоритма я увеличиваю интервал между попытками. Это нужно, чтобы несколько попыток не отправились подряд через секунду и я не получил несколько отрицательных ответов. Сначала отправляю запрос, жду пять секунд, потом интервал увеличивается, затем еще увеличивается. В итоге мы можем получить вариант, который сработает.
Второй вид – ошибки с кодами от 400 до 499.
Повторять такие запросы, как правило, бессмысленно. Скорее всего, это ошибки нашего кода или информации, которую мы обрабатываем.
Логирование запросов и ответов при работе с API в 1С
Следующее – логирование запросов.
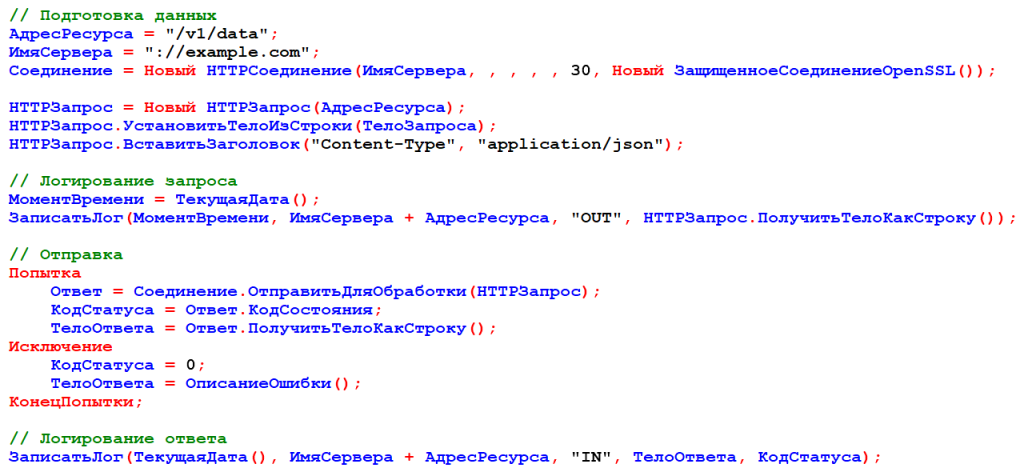
Это крайне необходимая вещь, потому что, если что-то пойдет не так, без логирования вам будет негде посмотреть, что именно произошло.
Понятно, если у вас интеграция с одним запросом, все довольно просто. Интеграция упала – вы идете и смотрите этот запрос.
А если у вас 73 запроса в рамках одной интеграции? На каком из них она упала? Как это проверять?
Конечно, если все запросы находятся в коллекции Postman, вы реализовали автотесты и пользуетесь всеми инструментами, которые я предложил, то многое уже будет известно. Но даже в таком случае я рекомендую заниматься логированием запросов.
Я видел реализации, в которых логирование выполняется одной строкой: мы отправляем запрос, получаем ответ и целиком все записываем в одну строку.
Мне такой подход не очень нравится, поэтому я делаю в логе две записи.
Первая запись – отправка запроса, подробный лог отправки.
Вторая запись – подробный лог ответа сервера.
Я делаю это по двум причинам.
Во-первых, чтобы засечь время между запросом и ответом, понять, сколько времени проходит.
Во-вторых, чтобы разделить эти события в регистре. Потом я легко могу выбирать нужные записи, мне не приходится ничего искать.
Хранить логи можно по-разному: в файле, журнале регистрации или регистре сведений.
Здесь все зависит от того, как вы собираетесь обрабатывать эти данные.
Одно дело, если вы будете записывать три события в день. И совсем другое, если 300 000 записей в день.
Нужно понимать, что если вы будете записывать 300 000 или миллион событий ежедневно, регистр сведений раздуется до огромных размеров и просто займет все место на диске. В таком случае лучше использовать временные файлы или файлы на диске.
Разбор поломки
Рано или поздно любой наш сервис сломается. Здесь не нужно питать иллюзий, что мы один раз сделали интеграцию и она будет работать всю жизнь. Так не бывает.
Во-первых, меняются спецификации. Во-вторых, меняются сами методы API.
У меня было много таких примеров при работе с интеграциями с мессенджерами. В свое время у них довольно часто менялись методы, и нужно было даже при авторизации указывать, к какой версии API вы подключаетесь.
Поэтому ошибки так или иначе возникают.
При работе с такими сбоями разработчик сталкивается с тремя основными этапами.
Первый – фиксация симптомов. Нужно определить, что именно происходит, в какое время и как проявляется сбой.
Второй – локализация проблемы. Допустим, у нас 120 запросов. Нужно определить, какой из них вызывает сбой, в каком месте и по какой причине это происходит.
Третий – восстановление. Нужно разобраться со сбоем, устранить его в текущий момент и, естественно, предотвратить повторение.
Причем это могут быть две разные стадии. Сначала вы можете придумать, каким образом быстро восстановить обмен, а затем уже системно решить проблему, чтобы она больше не повторялась.
Фиксация симптомов
Для фиксации симптомов я выделяю три основных вида.
Первый – интерактивная ошибка. Она обычно связана с тем, что разработчику или пользователю просто появляется сообщение об ошибке на экране. Например, возникла ошибка недостатка памяти или появилось другое окно, в котором говорится, что все сломалось.
Второй вид – бесконечное ожидание. Такое тоже зачастую случается, по крайней мере в моей практике. Отправляется запрос, выполняется какой-то обмен, и по непонятным причинам он либо вообще не завершается, либо возникают ситуации, когда этот обмен нагружает сервер на 100%, зависают сеансы и так далее.
Это говорит о том, что какой-то результат не возвращается, все зависает и может мешать работе пользователей.
И третий вид – самый коварный. Это тихий сбой. Он визуально никак себя не проявляет.
Допустим, вы зашли в регламентное задание, посмотрели: там все зеленое, есть дата начала, дата окончания, никаких интерактивных ошибок не было. Все прекрасно, а данных в базе нет. Именно в такой ситуации возникает вопрос, куда двигаться дальше и где искать ошибку.
Локализация проблемы
Если у нас есть качественное логирование, то для локализации проблемы мы в первую очередь обращаемся к логам.
Можно реализовать их по моему примеру, можно придумать что-то более интересное, но так или иначе какие-то логи должны быть. Сначала смотрим в них.
После того как определили, на каком этапе и на каком запросе возникает ошибка, переходим в Postman. По крайней мере, я делаю именно так.
Почему? Потому что иногда ошибки возникают не из-за сервиса или самого запроса, а из-за инфраструктуры 1С, программы «1С:Предприятие».
Чтобы исключить эту причину, я перехожу в Postman и проверяю запрос там. Если получаю тот же результат, что и в 1С, значит, проблема в поставщике сервиса или в запросе. Тогда иду в документацию, обращаюсь в техническую поддержку и выясняю причину.
Но если ошибка в Postman не повторяется, то есть там все работает замечательно, тогда нам поможет консоль HTTP-запросов. Она позволит выполнить тот же запрос непосредственно внутри контура 1С.
Также для выяснения причин можно использовать журнал регистрации и отладчик.
Восстановление
Как я уже говорил, восстановление бывает двух видов.
Первый – оперативное восстановление.
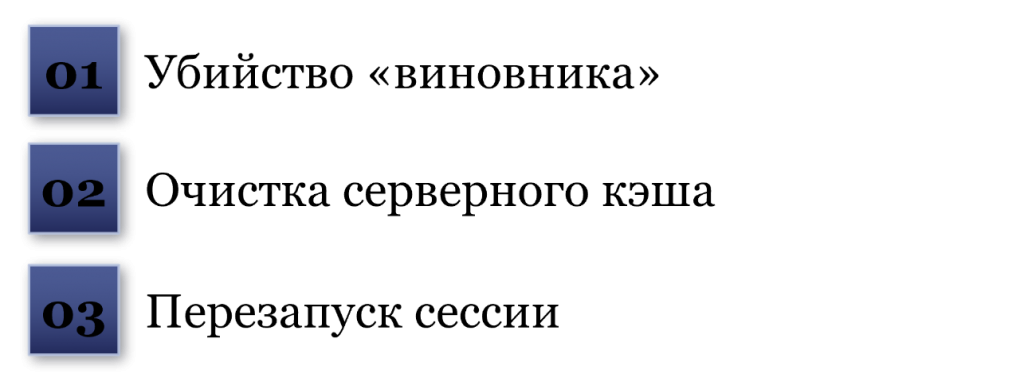
Здесь, как правило, мы все перезапускаем. Первым делом перезапускаем сеансы, службы сервера, серверы, оборудование – все перезапускаем и смотрим, восстановится ли работа.
Если это не помогает, начинаем системное исправление.
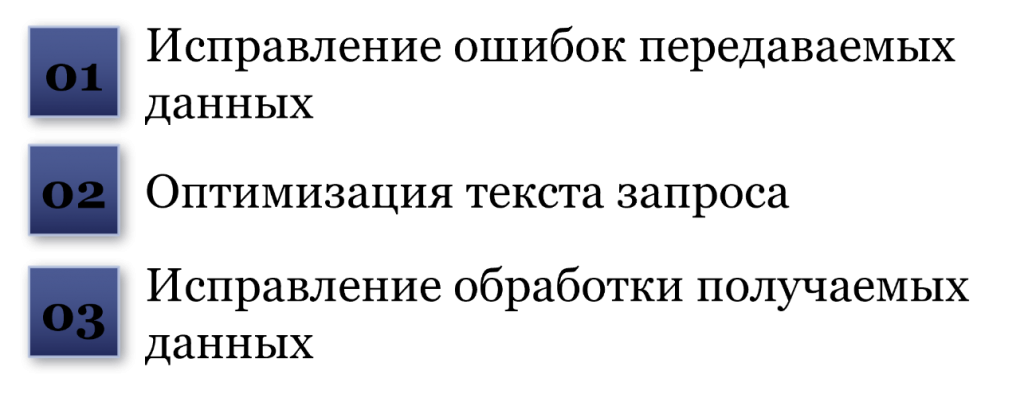
Сначала исправляем ошибки передаваемых данных. Проверяем, чтобы данные были корректными, имели нужный формат и правильно отправлялись.
Затем смотрим, какой запрос выполняется, оптимизируем и исправляем текст запроса.
И в конце исправляем обработку получаемых данных, потому что ошибки на этой стадии тоже зачастую бывают. Например, нам пришли корректные данные, мы начинаем их обрабатывать, но делаем это неправильно, и в результате они не попадают в нужные регистры.
Пример работы
Рассмотрим небольшой пример применения этого алгоритма.
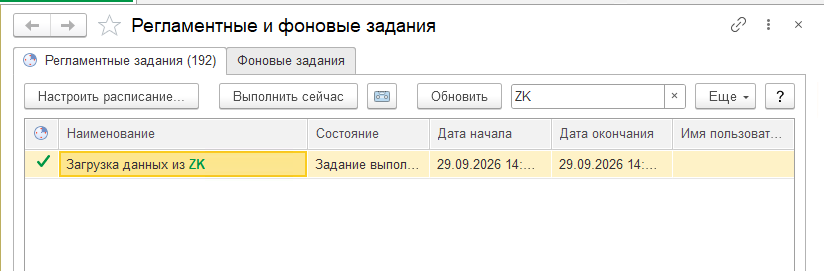
Допустим, пользователи сообщают, что заявки из внешнего B2B-портала перестали загружаться в ERP-систему. Идем в регламентное задание и видим, что оно началось, выполнилось за пять секунд и завершилось. Никакой проблемы здесь не видно. Это вызывает недоумение.
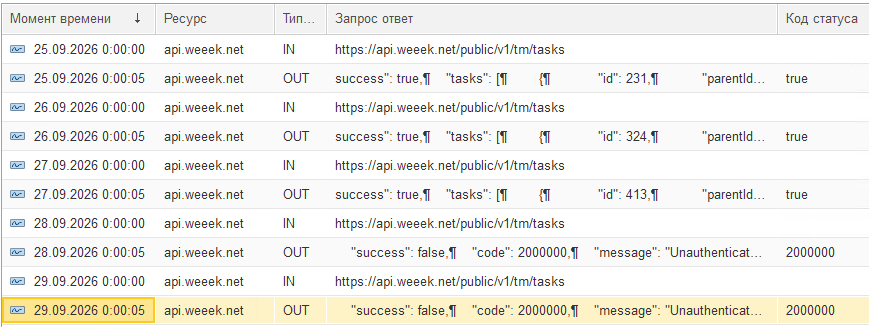
Но когда у нас есть лог, такого недоумения быть не может.
В логе сразу видно, что с определенного времени сервер начал возвращать ответы с ошибкой.
Конечно, можно сразу посмотреть на ошибку, определить, что проблема связана с неправильной аутентификацией, и начать ее исправлять.
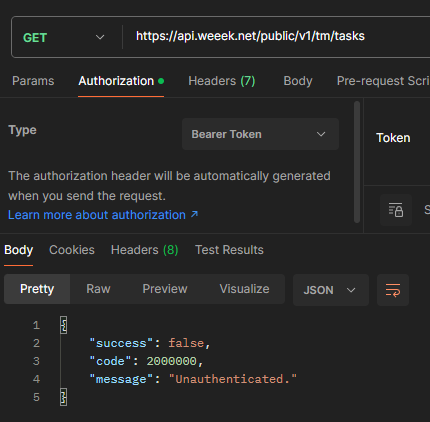
Но, как я говорил, первым делом я выхожу из контура 1С и выполняю тот же самый запрос в Postman, чтобы проверить, вернется ли аналогичный результат.
В данном случае результат тот же. Это говорит о том, что проблема именно во взаимодействии с внешним сервисом.
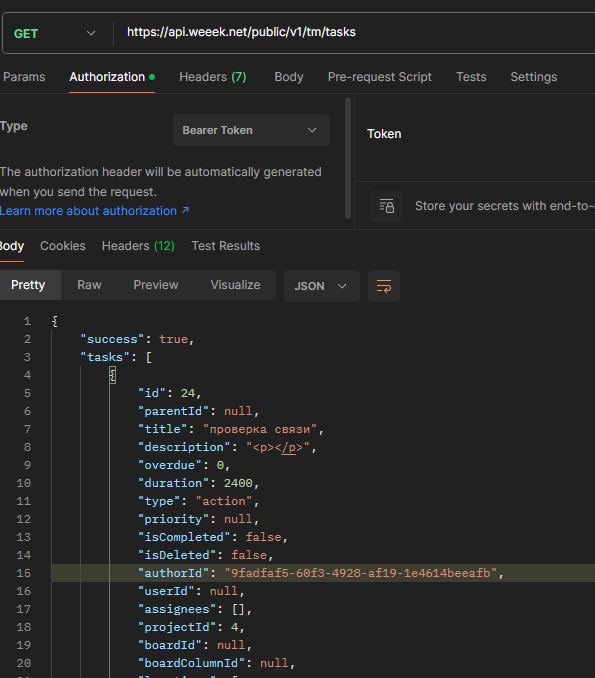
Исправить ее можно, например, повторно запросив токен авторизации в личном кабинете или обратившись к поставщику сервиса.
После подстановки нового токена авторизации мы видим, что Postman возвращает положительный результат.
Теперь можем взять этот токен и записать его в константу, регистр сведений или справочник. Неважно, где именно вы храните такие данные.
Фоновое задание подхватит новое значение, и дальше все будет выполняться нормально.
По сути, за пять минут мы решили проблему, которую без простого лога было бы довольно сложно диагностировать.
Документирование HTTP-сервисов в 1С
Документирование лично для меня очень долго было огромной болью.
Каждый разработчик, который так или иначе сталкивался с созданием собственных HTTP-сервисов, слышал такие вопросы: «А скажите, в каком формате вы дату принимаете?»
Или: «Какой ответ вернул ваш сервер? Я отправил запрос».
И вот эта бесконечная переписка с огромным количеством внешних разработчиков, которые работают с вашим сервисом, – просто беда.
В такие моменты очень хочется, чтобы весь мир тебя просто понял.
У меня есть набор методов, у этих методов есть параметры, и есть коды состояний, которые возвращает мой сервис.
По большому счету, разработчику больше ничего и не нужно.
В мире этот вопрос решен довольно хорошо.
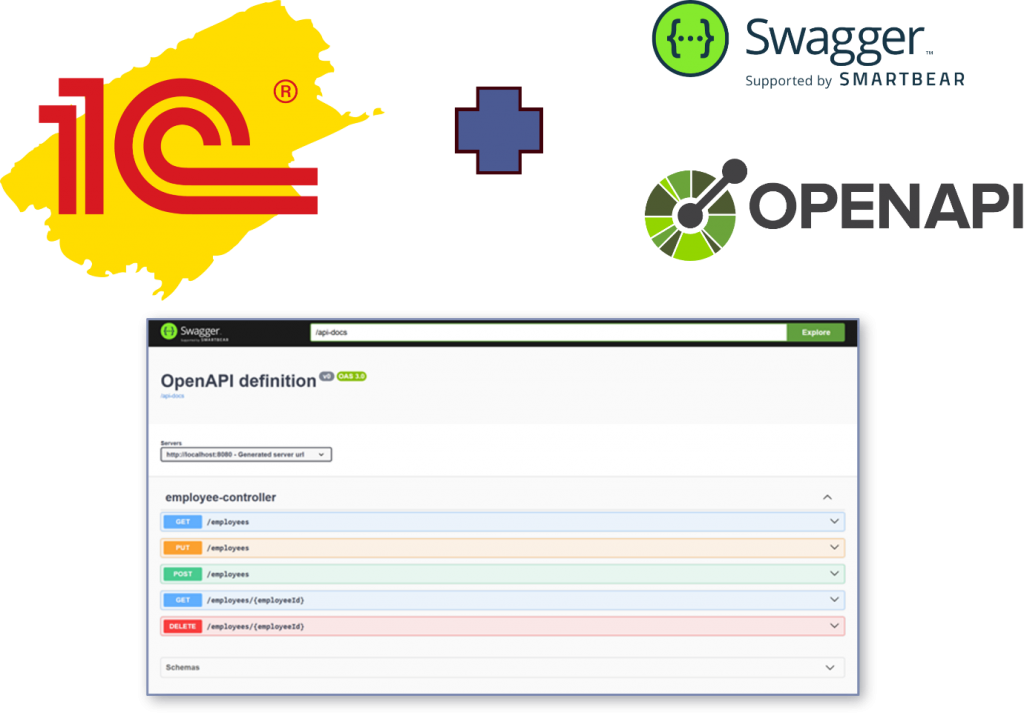
Есть Swagger, связанный со спецификацией OpenAPI. Он формирует удобный интерфейс, в котором представлен список методов.
Переходите к методу – видите список параметров, коды состояний. Можно даже тестировать запросы прямо в рамках Swagger.
А как быть с 1С? В 1С из коробки ничего подобного у нас нет.
Платформа предоставляет механизмы публикации HTTP-сервисов, мы все прекрасно ими пользуемся. Но инструменты для их документирования лично мне неизвестны. Возможно, они существуют.
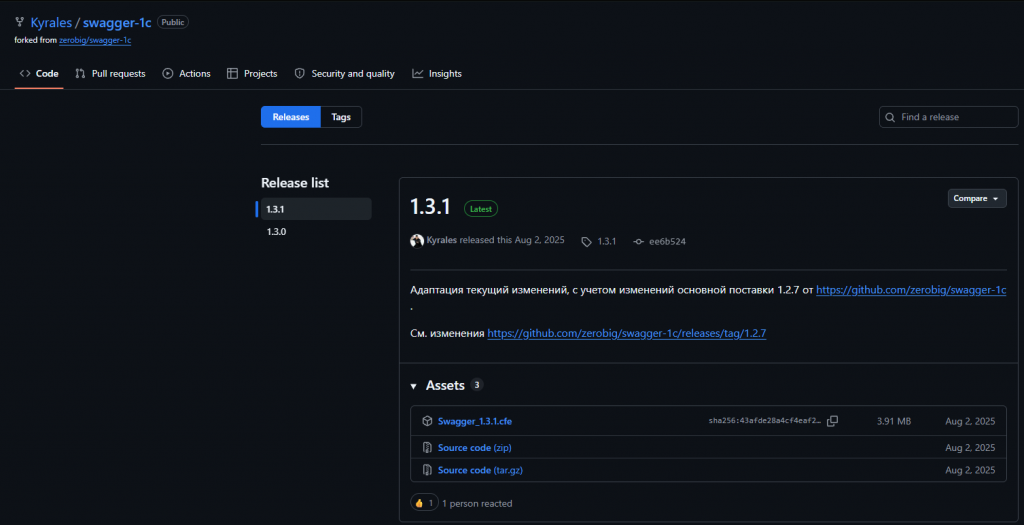
Я долго искал подобные решения. Сначала мы хотели сделать что-то самостоятельно, но потом нашли разработку, которая поставляется в виде расширения для 1С и веб-браузерного решения.
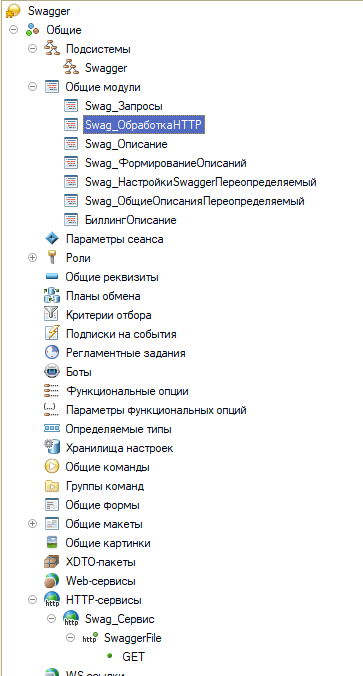
Это не реклама, просто другого подходящего инструмента я не нашел, а этот работает. Ссылка: https://github.com/Kyrales/swagger-1c/releases. Мы немного доработали его под себя, и результат нам нравится.
Главная особенность этого решения заключается в том, что оно позволяет формировать документацию на основе методов, которые вы используете в HTTP-сервисе. То есть не просто создает Swagger-спецификацию, а формирует ее именно на основе реализованных методов. И если вы что-то поменяли, документация будет обновляться.
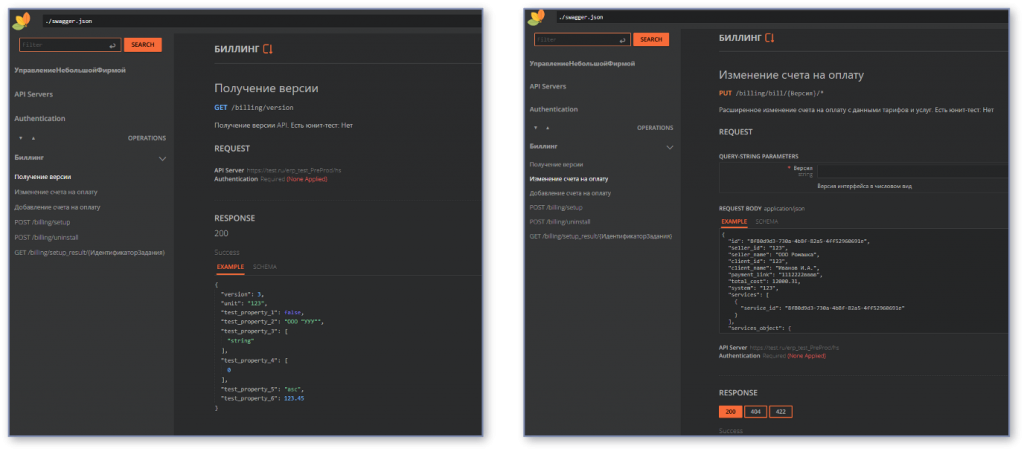
В итоге у нас в публикации реализована специальная форма.
Слева находится список методов. При выборе метода справа отображаются его параметры и возвращаемые значения, например коды 204, 422 или ошибки.
Также прямо здесь можно написать собственный запрос и проверить его на реальном или тестовом сервере. Это уже зависит от того, как вы реализуете решение. Но на продуктивном сервере я бы не стал проводить такие тесты. Лучше разделять окружения.
Хотя если контрагент, с которым вы работаете, – доверенное лицо, которое точно не будет перегружать ваш сервер, можно предоставить подобную возможность и для продуктивного контура.
Как сделать интеграции системными и предсказуемыми
Если вы не хотите, чтобы интеграции будили вас по ночам, рекомендую внедрить несколько принципов, которые помогут сделать работу более системной.
Меня мои интеграции будили по ночам несколько лет, потому что угольные разрезы, которые я обслуживал, работают круглосуточно. Звонки в три часа ночи были обычным делом, когда что-то не подгружалось из топливозаправочных систем или еще откуда-то не загружались данные. Это была огромная боль.
Поэтому в первую очередь рекомендую использовать нормальные инструменты для работы с внешними API. Я использую Postman. Можно пользоваться Insomnia, если вам важно приватное хранение токенов.
Эти инструменты я использую для работы с внешними API: чтобы разобраться в них, построить логику, изучить структуру JSON и так далее.
Следующее – используйте внутреннюю консоль HTTP-запросов. Я применяю ее в основном для того, чтобы быстро сгенерировать код и проверить запрос непосредственно в контуре 1С. Затем переношу его и тестирую уже в своей обработке, документе или другом объекте, в который внедрил этот код. На начальном этапе это крайне удобно.
Дальше обязательно обрабатывайте HTTP-ошибки. На этом пункте можно было бы поставить три восклицательных знака, потому что я очень часто вижу у клиентов, как разработчики сразу начинают разбирать тело ответа, не проверяя статус, и в результате возникают проблемы.
Без логирования, как я уже говорил, иногда разобраться в причинах сбоев очень сложно. Когда у вас один запрос, думаю, можно обойтись и без логирования. Но когда запросов 30, 50, 70 или 100, без логирования вы просто с ума сойдете.
Мы все считаем себя опытными людьми. Но опыт – сын ошибок трудных. Все мы запинаемся, допускаем ошибки и от этого страдаем. Я за 20 лет таких ошибок наделал очень много. Поэтому рекомендую учитывать те ошибки, которые я перечислил, и учиться на чужом опыте.
И последнее – рекомендую использовать Swagger для формирования документации по REST API.
Причем дело даже не столько в том, чтобы рассказать, какие у вас есть методы, параметры и ответы. Моя основная проблема заключалась в том, что мне не хватало времени поддерживать документацию в актуальном состоянии. У меня есть много методов, я что-то переписал. Теперь нужно идти в Word или на какую-то веб-страницу, все обновлять: методы, возвращаемые коды состояний и так далее. Это занимает очень много времени.
А подобные инструменты позволяют использовать код, который уже реализован в вашем HTTP-сервисе, и на его основе практически моментально обновлять страницы со Swagger-спецификациями.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TECH EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.