Архитектура ИТ-системы на базе 1С в крупной организации
База данных - HighLoad оптимизация
Добрый день. В данной статье я хотел бы очень крупными мазками обрисовать архитектуру ИТ системы на базе 1С в крупных (более 1 тысячи пользователей) организациях. Она не несет какой либо образовательной цели, это просто попытка показать – «а как у нас».
Часть 1. Архитектура.
Компания владеет крупной сетью магазинов. На текущий момент в сети где то 2700-3000 магазинов со средним количеством рабочих мест 2,4. Значительное количество операций, связанных с обслуживанием клиентов (продажа и замена сим карт, регистрация контрактов, подключение услуг новым абонентам), с товародвижением (приём и отгрузка товара, проведение инвентаризаций), все розничные операции (работа с кассовыми сменами, продажа товара, акционные механики) выполняются в 1С.
Ежедневное количество активных пользователей порядка 7000

количество чеков в пике достигает 300 в минуту, размер базы ~2.6 Тб.
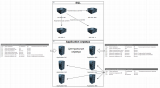
Для обеспечения работоспособности системы создан кластер со следующей архитектурой:
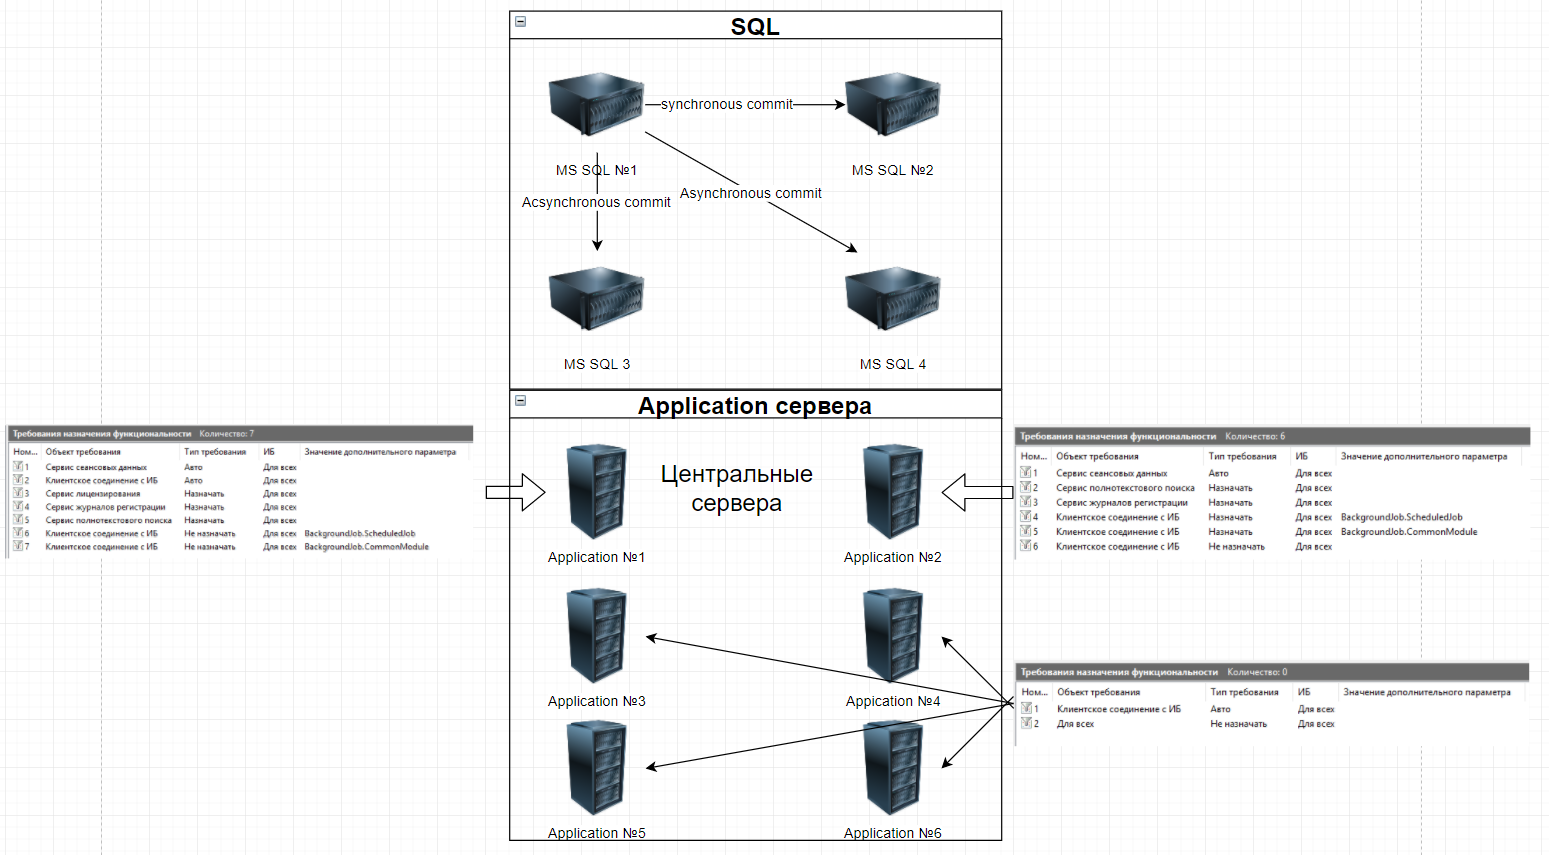
Плюсы решения:
При отказе SQL-сервера активная года автоматически переедет на работающий сервер и работа будет продолжена без прерывания для клиентов (проблему заметят только пользователи, которые запустили транзакцию в момент начала переезда), сам переезд длится порядка 1-2 секунд.
Возможность горизонтального масштабирования application кластера. Добавление нового кластера занимает примерно полдня, но для ускорения процесса в критических ситуациях возможен перевод сервера из тестового стенда в продуктив, на это уйдёт не более 10 минут.
Минусы решения:
Отсутствие полноценной отказоустойчивости. При падении одного из центральных кластеров примерно 50% пользователей получат недоступность системы, им потребуется перезайти в неё.
Особенности:
Дальнейшее я отношу к особенностям решения, а не к минусам, так как изменение архитектуры не может повлиять на ситуацию.
- Практически невозможно в течение дня безболезненно выгнать всех пользователей для срочного обновления. Даже если само обновление конфигурации займет 1 минуту процесс обновления выглядит следующим образом:
- Установка блокировки базы (делается заранее)
- Ожидание, пока все пользователи выйдут из базы (примерно 2-3 минуты с начала блокировки).
- Остановка служб на серверах, где находятся сеансовые данные. (2-3 минуты)
- Очистка сеансовых данных. (1 минута)
- Непосредственно обновление конфигурации. (1 минута)
- Запуск пользователей. (1 минута)
- Стабилизация нагрузки после входа. (3-5 минут)
Таким образом внеплановое обновление занимает в средней 15 минут и всегда связано с высоким стрессом, так как вероятность, что что-то пойдет не так значительно больше нуля, а поправить ситуацию времени нет. Каждая минута — это десятки тысяч рублей недополученной прибыли.
Причина - большой объем сеансовых данных, которые потребуется загрузить одномоментно, в случае если их не очистить (порядка 20 Гб). Практика показала, что система (именно 1С) не справляется с загрузкой такого объема данных за приемлемое время, в результате чего пользователи на протяжении 5-10 минут наблюдают окно с запуском конфигурации.
Для решения данной проблемы мы перешли на 8.3.10 и отказались в конфигурации от режима совместимости (изначально проект стартовал на 8.3.6), так что теперь критичные дефекты выпускаются с помощью расширений, а инциденты закрываются с рекомендацией перезапустить 1С и повторить попытку.
В ближайшее время мы планируем переход на 8.3.12, этим мы хотим закрыть вопрос с падением платформы на клиентах (порядка 2-3 тысяч дампов в день), а также попытаемся с помощью расширений не только исправлять дефекты, но и внедрять новый функционал.
- Зачастую проще оптимизировать нагрузку через создание индексов на уровне SQL, чем пытаться создать их средствами 1С или оптимизировать код. Напоминаю – так делать нельзя, так как это нарушение лицензионной политики 1С.
- Обязательно требуется замерять время обновления, так как несмотря на явный запрет разработчикам добавлять новые реквизиты в большие таблицы иногда всё-таки проскакивают изменения, требующие длительной реструктуризации.
Часть 2. Мониторинг.
Мониторинг мы разделяем на 3 части. 1-ый это стандартный ИТ-шный мониторинг, нагрузка на ЦПУ, занятое ОЗУ, диски, количество таймаутов и дедлоков в единицу времени и прочее-прочее, десятки их.
2 часть – доступность различных внешних ресурсов.
3 часть мониторинга — это бизнес-мониторинг, сюда мы относим:
- Количество чеков в единицу времени.
- Количество замен сим-карт в единицу времени.
- Количество отправленных платежей в единицу времени.
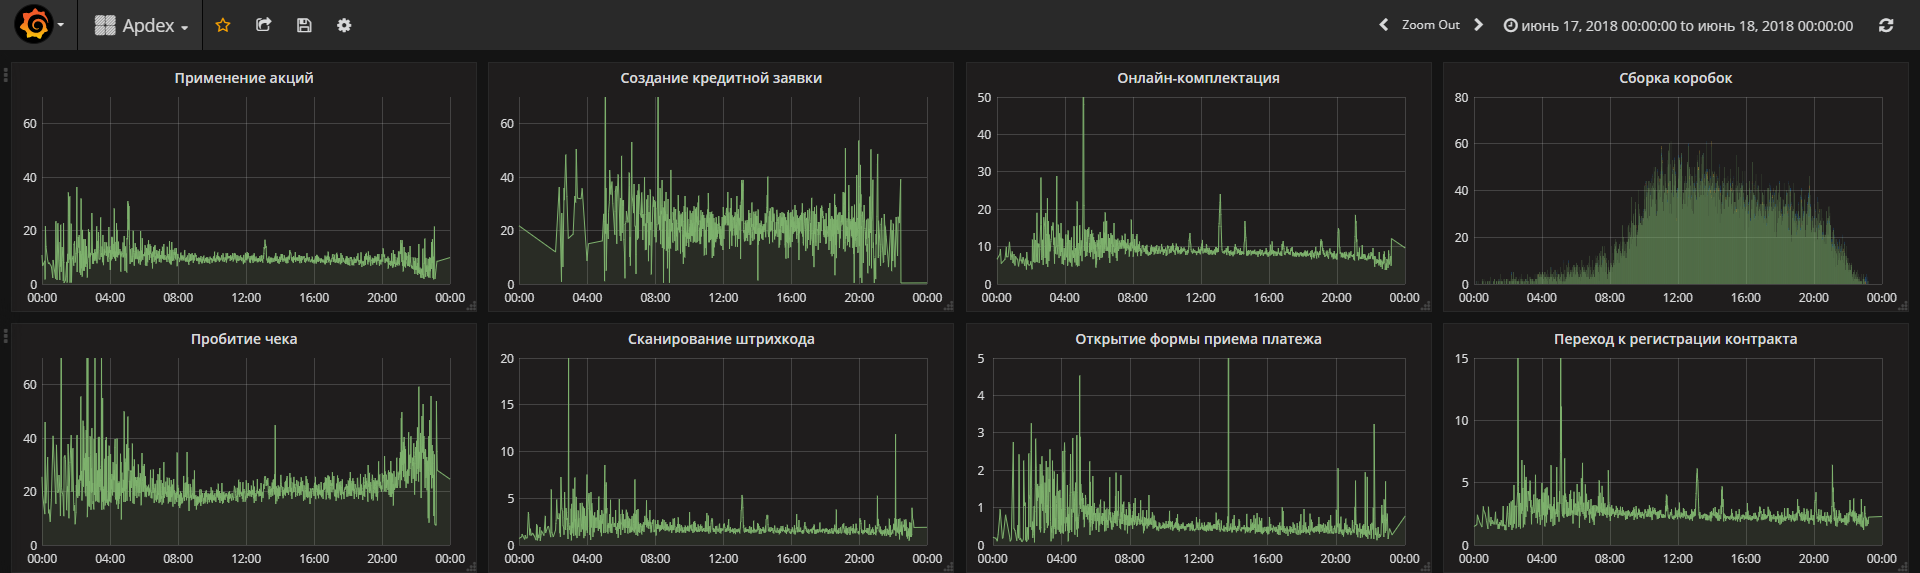
- Среднее время выполнения основных 7 операций.
- Некоторые другие специфические параметры (например отношение ошибочных регистраций контракта к успешным, количество ошибочно подключенных услуг при биллинговых операциях и другие вещи, интересные только внутри компании).
Для сбора информации по 1 и 2 частям мониторинга мы используем конфигурацию «Центр контроля качества», через него же делаем рассылки про основные инциденты, такие как повышенная нагрузка на ЦПУ, появление дампов (падение служб rphost) и пр.
К первой части так же можно отнести сбор логов технологического журнала. Фактически это одно из основных средств для расследования проблем, а также источник данных для сбора части показателей (количество TTimeout и TDeadlock, таймауты и дедлоки на управляемых блокировках, зависание rphost (тут всё достаточно тонко, если будет нужно расскажу дополнительно), среднее (AVG) и общее (SUM) время вызова (CALL и SCALL). Вообще технологический журнал позволяет собирать огромное количество полезной информации, главное научиться парсить многогигабайтные текстовые файлы. У нас за это отвечает отдельный сервис на C#.
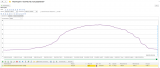
3 часть. Обычно в этой части принято считать apdex, как некий сводный показатель производительности системы, однако мы пришли к выводу что для нас наглядней смотреть просто на среднее время выполнения ключевых операций. Замеры выполняются стандартными средствами 1С и пишутся в регистр сведений, откуда уже читаются прямыми запросами и выводятся в дашборд. Сначала мы пытались изобрести велосипед в части дашбордов, но потом остановились на Grafana. Вот так выглядит график среднего времени выполнения операций за 1 день.
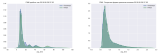
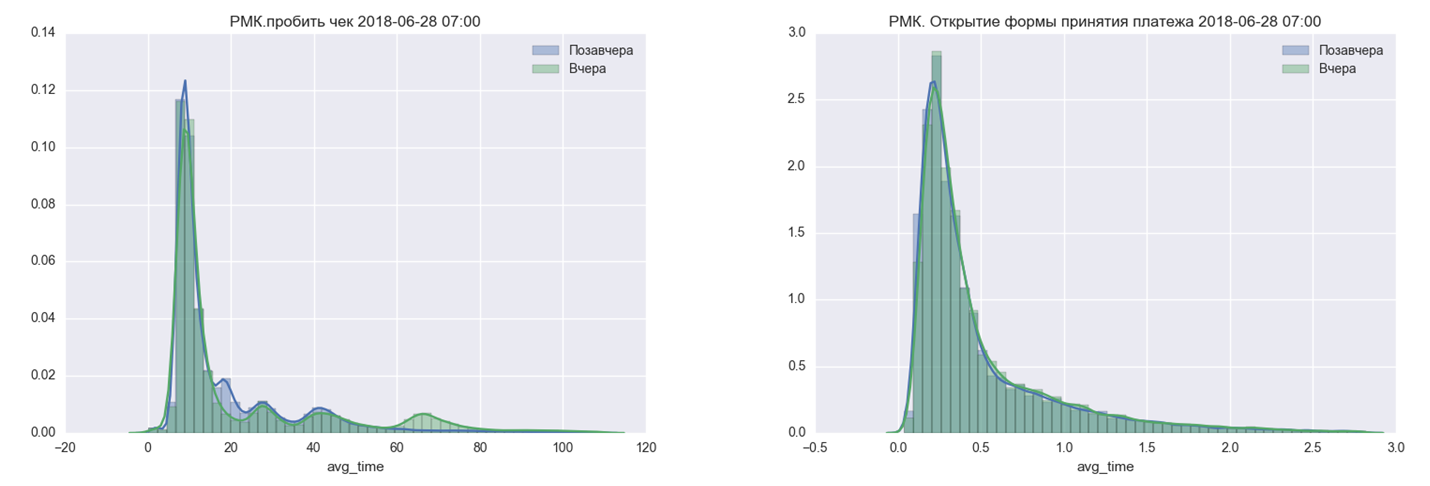
Кроме того ежедневно в почту приходит диаграмма распределения времени выполнения операций за последние два дня, это позволяет быстро понять, не изменилась ли производительность системы.
На этом я закончу вводную часть, если тема интересна – я готов рассказывать некоторые подробности, но так как на проекте уже 3 года информации накопилось очень много, если вы укажете, какое именно направление интересно – я распишу его подробней.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
HighLoad оптимизация Разработчик 1С 8.3 1С:ERP Управление предприятием 2 Бесплатно (free)
Использование оператора «В» для полей или данных составного типа (например, Регистратор) может приводить к неочевидным проблемам.
10.11.2025 15885 ivanov660 48
HighLoad оптимизация Разработчик 1С:Предприятие 8 1C:ERP Бесплатно (free)
Приведем примеры использования различных в динамических списках и посмотрим, почему это плохо.
18.02.2025 16491 ivanov660 39
HighLoad оптимизация Системный администратор Разработчик 1C:ERP Бесплатно (free)
Не всегда индексирование с дополнительным упорядочиванием полезно.
04.02.2025 15134 ivanov660 21
HighLoad оптимизация Разработчик Россия Бесплатно (free)
А вы знали, что сервер 1С при соединении с базой на сервере PostgreSQL самостоятельно устанавливает некоторые параметры? Это важно знать при настройке сервера и отладке долгих запросов. Предлагаю разобраться.
27.08.2024 10402 soulner 10
HighLoad оптимизация Технологический журнал Системный администратор Разработчик Бесплатно (free)
Обсудим поиск и разбор причин длительных серверных вызовов CALL, SCALL.
24.06.2024 19126 ivanov660 13
HighLoad оптимизация Разработчик 1С:Предприятие 8 Бесплатно (free)
Метод очень медленно работает, когда параметр приемник содержит намного меньше свойств, чем источник.
06.06.2024 24976 Evg-Lylyk 73
HighLoad оптимизация Механизмы платформы 1С Системный администратор Разработчик Стажер 1С:Предприятие 8 Бесплатно (free)
Сравним «Регистры сведений» с «Сервисами интеграции» и узнаем, кто быстрее!
28.03.2024 14632 dsdred 27
HighLoad оптимизация Разработчик 1С:Предприятие 8 1C:Бухгалтерия Бесплатно (free)
Анализ простого плана запроса. Оптимизация нагрузки на ЦП сервера СУБД используя типовые индексы.
13.03.2024 14616 spyke 29
Нет, RDP нет, тонкий клиент везде.
Мониторинг есть у сетевиков, то есть они видят, что канал пропал до точки. Мониторинга работоспособности 1С нет, хотя в целом сделать его не сложно, я уже думал об этом. Вопрос, что делать, если мы видим, что точка, которая с точки зрения мониторинга должна работать - не работает. Звонить выяснять, в чем дело? К сожалению ресурсов у нас не так много и свободных на текущий момент нет, хотя в целом, если предложить бизнесу идею - возможно он и готов будет оплатить.
Подскажите, тонкие клиенты подключаются по TCP или HTTPS? На схемах (в этой статье и других) я не вижу web-сервера, кроме того, который обслуживает различные HTTP и веб-сервисы. В комментариях также не нашел упоминаний, кроме того, что везде тонкий клиент.
Правильно ли я понимаю, что используется TCP-подключение внутри VPN?
Есть ли какие-то противопоказания к использованию HTTPS, о которых можете рассказать?
Самое главное - возможность разделить требования назначения функциональности по разным серверам. Это видно на схеме, специально её привел.
Второе - техподдержка от партнёра франчайзи, но здесь главное что мы нашли правильного франча, а в самом франче - грамотного специалиста. Не всем так везет )
Но теперь надо подробнее.
Какое железо, какие хранилища данных.
Какая конфа.
Как ведете разработку, сколько разработчиков, аналитиков. Как тестируете.
Что за проблема с падением платформы на клиентах.
Конфа - УТ 11, естественно переписанная вдоль и поперек.
Падение платформы - если вкратце - иногда при пробитии чека по эквайрингу падает платформа, в итоге имеем списанные у клиента деньги и не пробитый чек.
По железу, разработке и тестированию постараюсь ответить отдельной статьей. В двух словах не опишешь.
Для затравки: у меня, например, многомашинный кластер привносил проблем больше чем пользы (версия 8.3.10), но была возможность нарастить вертикально - в рамках одной машины. Стабилизировать его в приемлемом качестве так и не удалось... В остальном похоже было, отчетность у вас круче, а с обновлением мы экспериментировали, делали автодеплой с фоновой реструктуризацией ради минимального простоя при частых обновлениях - даже работало :)
Как раз 1С-овский кластер на текущий момент наиболее устойчивая и менее всего беспокоящая меня тема. Сейчас самое большое это невозможность распараллелить SQL и кривые руки разрабов, которые двумя строками говнокода убивают недели, затраченные на оптимизацию. Конечно эти две строки кода несложно исправить, но ведь их сначала надо найти. В общем стандартная война разработки и эксплуатации.
Зависшие сеансы это что? Клиентские сеансы? Я что то с таким не сталкивался, можно поподробней, как это выглядит?
Утечки памяти - перезапуск rphost при превышении предельного размера, но происходит это не часто. Дело в том, что у нас вся отчетность вынесена во внешнюю систему, в 1С можно строить отчеты, не превышающие при выводе 10 тысяч строк.
Сеансовые данные чищу ручками. Остановил все службы, удалил файлы. Можно скрипт конечно написать, руки никак не дойдут.
Превышение времени ожидания редко, но бывают. Примерно 1-2 раза в день. На это стоит отдельный счетчик, который сразу начинает верещать. Таймауты не связаны с кодом конфигурации, варианты, которые у нас были:
1. Пользователь запустил два сеанса и пытался одновременно в них провести один и тот же документ (там не пользователь, а робот был на самом деле). Научили его так не делать.
2. Слишком длительное обслуживание индексов. Оптимизировали скрипты и отключили обслуживание тех индексов, которые по нашему мнению не нужны.
3. Какая то проблема в SQL, в результате чего при автообновлении статистики таблица блокировалась зачастую на несколько минут. Отключили автообновление статистик в течение дня, только по ночам.
И сеансы и соединения. Например при отборе по ЖР, когда в качестве отбора указывается конкретная ссылка на объект ИС. ЖР зависает намертво, иногда настолько, что снятие сессии не обрывает соединение. В итоге невозможно обновить конфигурацию, даже если пытаться удалить соединение вручную, оно якобы удаляется и тут же появляется снова. Помогает только перезапуск rphost'ов.
После перезапуска rphost'ов по превышению размера потребляемой ОЗУ появляются сессии-фантомы. Пользователь выключил компьютер не дождавшись выхода из 1С, например программист 1С выключил компьютер будучи находившись в конфигураторе. После перезапуска rphost'ов его фантомная сессия восстанавливается и висит в консоли наряду с еще 50 фантомными сессиями.
(15)
Наши администраторы не дают прямого доступа к серверу. Максимум что доступно - консоль администрирования 1С.
Второй пример - увлеченность разработчиками временными таблицами. Их привычка пихать их к месту и не к месту привела к тому, что у нас SQL начал проваливаться именно по этому показателю.
Второй пример - увлеченность разработчиками временными таблицами. Их привычка пихать их к месту и не к месту привела к тому, что у нас SQL начал проваливаться именно по этому показателю.
Так ведь это и должно решаться техническим контролем выкладываемых изменений в рабочую базу. Если команда небольшая, достаточно одного специально обученного человека, и будет счастье.
Скажите пожалуйста, что должен включать в себя "технический контроль"?
Сотрудник, проводящий контроль релиза, должен проанализировать выполнение кода и спрогнозировать его неоптимальное использование?
Сотрудник, проводящий контроль релиза, должен проанализировать выполнение кода и спрогнозировать его неоптимальное использование?
Да. Часть проблем видно уже при просмотре кода (излишнее количество виртуальных таблиц, да и лишние вызовы сервера тоже могут быть замечены).
А то, что нельзя увидеть при беглом просмотре, можно отследить на этапе тестирования.
Конкретно этот момент можно увидеть ещё при беглом анализе кода. Когда запрос содержит большое количество виртуальных таблиц, можно на него обратить внимание.
Не нравится такой подход - можно при тестировании обращать внимание на время выполнения операций.
Можно отслеживать замеры производительности.
Можно чуть подробней? Что конкретно изматывает?
Я делаю ревью, правда постфактум. Запускаю конфигуратор: Конфигурация - Хранилище - Обновить конфигурацию из хранилища.
Затем Конфигурация - Сравнить конфигурации. 1. Конфигурация базы данных, 2. Основная конфигурация. В диалоге сравнения анализирую внесенные изменения с момента последней проверки. Потом жму F7. На следующий день всё заново. Занимает не болше часа в день.
Я тоже так делаю.
Но считаю что это малоэффективно, да и времени на это постоянно не хватает, из-за чего детально анализирую только код тех разработчиков, которые по моему мнению не имеют достаточно высокого уровня, чтобы писать оптимально. По крайней мере явные проблемы у ведущих зубров наблюдаются исключительно редко.
В Crucible к строке кода можно оставить комментарий, автору строки придет письмо. Тут же из коробки переход к таск-трекеру, чтобы посмотреть, а что за задача решалась, и т.д.
Выматывало именно то, что нужно находиться в контексте решаемой задачи, при просмотре ее кода. Когда людей хватало - это решалось внутри команды и было хорошо. Потом кризисы-шмизисы, людей, способных анализировать код, стало меньше, а задач на них - стало больше. Ревью превратился в обузу и заглох.
Человеку должно нравиться то, что он делает. Иначе от любой работы взвоет. Это бесспорно.
Расскажите, пожалуйста, еще:
Какой объем базы?
Сколько документов вводится в день?
По сколько записей в самых объемных таблицах? И какие это таблицы?
Как обслуживаете Журналы регистрации? В каком формате их используете (txt/sqlite)?
Каков размер индекса полнотекстового поиска?
Спасибо!
Повторю, тема очень интересная и проект реально крутой по объемам. Прямо очень интересно по-максимуму ознакомиться с опытом.
У меня на обслуживании РИБ. В одном только из узлов которой регистрируются по 5000 документов в день.
Естественно, мы порой встреваем в проблемы производительности. Объемы таблиц опять же не радуют. Сама база весит 500 Гб и растет довольно быстро.
Но пока всё еще руки не доходят "сделать нормально" с мониторингом и анализом ТЖ на текущие показатели. До кластера руки дошли вот только сейчас недавно, да и то - только после того, как сильно просели по производительности.
Объем базы 2.6 Тб
Документов в день порядка 200 тысяч.
В самой объемной порядка 300 млн. Это самописный регистр сведений по состоянию сим-карт.
ЖР только для ошибок. Но для информации - первое, что делает любой специалист по оптимизации системы - включает старый формат журнала регистрации. Это уже обсуждалось тысячу раз. 1С никогда не признает официально, что ошиблась с sqlite. но это так.
Про индекс полнотекстового поиска не скажу, как то видимо не упирались в него, а может он отключен у нас, исследую вопрос.
Что вы, упаси господи, ЦКК к большому ТЖ подпускать нельзя ни в коем случае. ТЖ анализируется с помощью самописных механизмов на C#, затем в ЦКК загружаются в виде внешних счетчиков.
А так да, ТЖ собирается постоянно, проблем никаких нет, это прямая рекомендация от 1С - чтобы ТЖ работал непрерывно. Естественно пишется на отдельные диски, не на СХД, где находится база данных.
Мы с шефом уже участвовали в похожем проекте и предыдущее решение было сделано распределенным. Опыт показал, что централизованное решение в нашей ситуации будет проще в поддержке и более "вкусно" для бизнеса.
Да, это розница с магазинами.
На всех торговых точках есть дублированный интернет канал, так как специфика работы такова, что без связи работа магазина невозможна.
Зависим скорее не от скорости канала, а от стабильности пинга и скорости света. На ДВ конечно операции выполняются немного медленней, чем в Москве. Примерно процентов на 30-50.
Сейчас у нас в регламентах прописано 4 Мбит, но это не только для 1С, для всего. Аварийный канал установили в 1 Мб. Для 1С в принципе достаточно будет и 512 Кбит.
Розницу(разумеется переделанную под свои особенности) разворачиваем на точках(файловый вариант).
Делаем базу-шлюз(серверный вариант)( ведем там НСИ также) на которую, как на елку, навешиваем web-сервисы для обменов через json, например.
Делаем центральную базу (ЦБ) , куда после выверки в базе-шлюзе сыпятся отчеты о розн. продажах, результатах инвентаризаций, приходах/расходах и тд.Сегментацию, планирование, ценообразование, маркетинг ведем в ЦБ.
Актуальные розничные цены держим в базе-шлюзе забирая актуальные из ЦБ.
Логистику вообще желательно выделитьв отдельную базу, которая опять же через базу-шлюз будет контактировать с центральной базой.
В базе-шлюзе держим инфу о версиях клиентов и инициируем обновления при необходимости.
Много, конечно нюансов, но сбой базы-шлюза или ЦБ никаким образом не отражается на клиентах (точках).
Олег, почему отказались от апдекса и перешли на среднее время? По идее апдекс более чувствителен к изменению времени операции.
Мы оставили только асинхронную из-за рисков увеличить время транзакции в основном узле.
Как между собой пересекаются WSFC+AG SQL и 1C-кластер? Это везде физически разные сервера? Или есть пересечения?
Хотелось бы для себя прояснить возможно ли вообще такое "пересечение", если у AG должно быть общее виртуальное имя, а у серверов 1С адреса должны быть разные.
Например, если взять два сервера, настроить failover, alwayson (например, с синхронной репликой). Они будут иметь одно имя подключения.
Теперь, например, на эти же сервера поставить два центральных 1с сервера.
Имеет место такое быть у вас? Или 1с и SQL у вас не встречаются на одном сервере? Или все исключительно на разных?
Проконсультируйте про мой пример: серверы 1с сохраняют свои уникальные имена? Они никак не пересекаются с SQL-ной отказоустойчивостью и не мешают друг другу? Или могу возникнуть вопросы?
SQL состоит из 4 машин, два в режиме Synchronous commit, еще два - Asynchronous commit. Первые две машины имеют единое кластерное имя, на которое откликается тот из серверов, который в данный момент является активной нодой.
Теоретически на асинхронные реплики можно посадить пользователей, которые только читают данные, но 1С к ней подключить без грязных хаков не получится, так как база read only, а 1С хочет писать во временные таблицы.

К слову... В 8.3.12 выявляется ряд отличий в поведении кластеризации даже от 8.3.10... То, что было не понятно, не очевидно или не взлетело на 8.3.9-10, пока приемлемо, правильно и понятно работает в 8.3.12.
Платформа растет и это приятно.
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 857978
Создание 02.07.18 15:48
Обновление 02.07.18 15:48
Просмотры 28227
Загрузки 0
Рейтинг
107
Комментарии 117
Код открыт Да
Рубрики HighLoad оптимизация
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация 1С:Управление торговлей 11
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)


