Вычисление 200 тысяч знаков числа pi
Разработка - Математика и алгоритмы
После прочтения статьи о недокументированной возможности добавления миллисекунд к дате (для тех, кто еще не знает, вот ссылка), задался вопросом: а что с числами? До какого предела точности мы можем вычислять результат?
Первое, что сразу пришло в голову - это попытаться определить машинное эпсилон, исходя из предположения, что представление числа в 1с это просто число с плавающей точкой, хранящееся как мантисса и показатель степени. В результате проверки обнаружилось, что предела деления как такового не существует.
При попытке вычисления программа просто зависает:
e = 1;
Пока 1 + e/2 > 1 Цикл
	e = e/2;
КонецЦикла;
Сообщить(е);
Получается, что мы можем делать вычисления с неограниченной точностью, а точнее пока не закончится оперативная память.
Итак, проверим это. Возьмем произвольное число, например 23 и поделим его на 10 в степени 1000, прибавим к полученному результату 1.
а = 1 + 23*Pow(10, -1000);
Сообщить(а);   //1
Возвращается вроде единица без хвостика. Однако, это только кажется. Отнимем от результата 1, а после домножим то, что получилось обратно на 10^1000:
а = 1 + 23*Pow(10, -1000);
Сообщить(а);   //1
Сообщить((а-1)*Pow(10, 1000));   //23
Наше число 23 никуда не пропало, оно хранилось в переменной а. Дробная часть, несмотря на ничтожную значимость по сравнению с целой частью, сохранилась.
Очевидно, что серьезная финансовая программа не может работать с такими стандартными типами как float и double и должна использовать тип, который обеспечивает поддержку десятичной арифметики с плавающей запятой (например, в java для этих целей используется тип BigDecimal, в Python тип Decimal). Получается, 1с предоставляет пользователю возможность рассчитывать себестоимость продукции с теоретически бесконечной точностью.
Однако, на вывод данных ограничения все же накладываются. Минимальное число (больше нуля), которое может отобразить программа это 10^(-324). Не спрашивайте почему.
а = Pow(10,-324);
Сообщить(а); //0,000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000001
а = Pow(10,-325);
Сообщить(а); //0
Следовательно, мы можем производить различные математические вычисления с космической точностью. И это без всяких внешних компонент.
Теперь перейдем к теме и попробуем рассчитать число пи со сколь угодно малой погрешностью.
Сначала немного теории...
Один из самых простейших способов вычислить число пи - это использовать известную с начала XVIII века формулу Джона Мэчина:
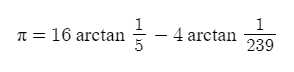
Самое замечательное в ней то, что арктангенс прекрасно раскладывается в ряд Тэйлора:
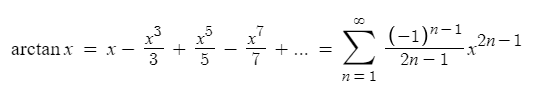
Переводим это в код:
Пи = 0;
Для Сч = 1 По 1000 Цикл
	Зн = ?(Сч%2 = 0, -1, 1);
	Ч = (Сч*2-1);
	Пи = Пи + Зн*(16/(Ч*Pow(5,Ч)) - (4/(Ч*Pow(239,Ч))));
КонецЦикла;
Сообщить(Пи)  //3,141592653589793238462643383529999816173450437691564002130.......
И.... Сразу получаем... Всего 27 верных знаков после запятой.
Увеличение счетчика не приводит к точности вычислений.
Вы, конечно же, догадались в чем здесь проблема. Дело в том, что при делении, например, 1 на 3 выводится результат 0,333333333333333333333333333, ограниченный только 27 знаками. Можно ли обойти это ограничение? Оказывается, точность деления зависит от точности числителя дроби и следовательно, если мы добавим к нему очень малую величину, то результат будет вычислен с той же точностью.
Немного подправим код выше:
Пи = 0;
Ош = Pow(10,-2000);
Для Сч = 1 По 1000 Цикл
	Зн = ?(Сч%2 = 0, -1, 1);
	Ч = (Сч*2-1);
	Пи = Пи + Зн*((16+Ош)/(Ч*Pow(5,Ч)) - ((4+Ош)/(Ч*Pow(239,Ч))));
КонецЦикла;
Далее попробуем сравнить точность полученного результата со справочным значением числа пи (первые 4 млн. знаков можно взять отсюда). Для этого будем извлекать по 10 знаков полученного числа в строку:
 //Число получено, но 1с отображает только 324 знака после запятой
 //Выведем домножением остальные символы
ПиСтрокой = "3.";
Для Сч = 1 По 100 Цикл
	ПиСтрокой = ПиСтрокой + Сред(Пи, 3,10);
	Пи = Пи*Pow(10,10)%1;
КонецЦикла;

//Сравнение с оригиналом:
ПиОриг = "3.1415926535897932384626433832795028841971693993751058209749445923078164062862089986280348253421170679821480865132823066470938446095505822317253594081284811174502841027019385211055596446229489549303819644288109756659334461284756482337867831652712019091456485669234603486104543266482133936072602491412737245870066063155881748815209209628292540917153643678925903600113305305488204665213841469519415116094330572703657595919530921861173819326117931051185480744623799627495673518857527248912279381830119491298336733624406566430860213949463952247371907021798609437027705392171762931767523846748184676694051320005681271452635608277857713427577896091736371787214684409012249534301465495853710507922796892589235420199561121290219608640344181598136297747713099605187072113499999983729780499510597317328160963185950244594553469083026425223082533446850352619311881710100031378387528865875332083814206171776691473035982534904287554687311595628638823537875937519577818577805321712268066130019278766111959092164201989";
Сообщить("Пи оригинал: " + ПиОриг);
Сообщить("Пи вычислен: " + ПиСтрокой);

Для Сч = 3 По 1002 Цикл
	Если Сред(ПиОриг, Сч, 1) <> Сред(ПиСтрокой, Сч, 1) Тогда
		Прервать;
	КонецЕсли;
КонецЦикла;
Сообщить("Точность вывода знаков после запятой: " + (Сч-3));//Точность вывода знаков после запятой: 1 000
В результате за 1 секунду мы получили 1000 верных знаков. Напомню: в конце XIX века Вильям Шенкс нашёл 707 знаков числа пи, потратив на это 20 лет своей жизни. Однако, в 40-х годах, с помощью первых появившихся ЭВМ, было выяснено, что в своих расчетах он допустил ошибку на 520-м знаке и дальнейшие его вычисления оказались неверными.
Далее попробуем вычислить больше знаков и воспользуемся для этого формулой Бэйли — Боруэйна — Плаффа, выраженной через отношение двух полиномов:
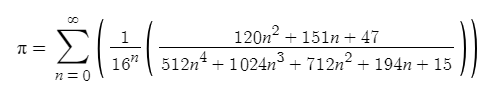
Код:
Пи = 0;
Ош = Pow(10,-10002);
Ст16 = 1;
Для Сч = 0 По 8298 Цикл
	к1 = Сч;
	к2 = к1*к1;
	к3 = к2*к1;
	к4 = к3*к1;

	Числ = (120*к2+151*к1+47)+Ош;
	Знам = (512*к4+1024*к3+712*к2+194*к1+15)*Ст16;
	Ст16 = 	Ст16 * 16;
	Пи = Пи + Числ/Знам;
КонецЦикла;
После сравнения с оригиналом получаем за 25 секунд 10 000 верных цифр после запятой. Уже что-то.
И напоследок, нельзя не привести способ вычисления пи согласно безумной формуле братьев Чудновских (вдруг кому пригодится), с помощью которой они установили рекорд вычисления (на тот момент): 5 триллионов знаков после запятой!
Но для этого нам понадобится изначально вычислить квадратный корень из числа 10005, входящий в формулу. Для этого воспользуемся итерационной формулой Герона.
а = 10005;  //Число из которого извлекам корень
КвКорень =sqrt(а);  //его начальное приближение
Ош = Pow(10,-300000);
Для Сч = 1 По 15 Цикл
	КвКорень = (КвКорень+(а+Ош)/КвКорень)/2;
КонецЦикла;
И теперь вычислим пи методом Чудновских:
Пи = 13591409;
ak = 1;
k = 1;
Для Сч = 1 По 20010 Цикл
	ak = (ak * -((6*k-5)*(2*k-1)*(6*k-1))+Ош)/(k*k*k*26680*640320*640320);
	Пи = Пи + ak*(13591409 + 545140134*k);
	k = k + 1;
КонецЦикла;
Пи = (Пи * КвКорень+Ош)/4270934400;
Пи = (1+Ош)/Пи;
В результате 283 789 точных знаков за 3 минуты! «У кого есть охота, пусть идёт дальше», как сказал когда-то Людольф ван Цейлен, вычислив 4 столетия назад 20 точных знаков числа пи после 10 лет упорной работы.
Спасибо, что дочитали до конца.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
См. также
Математика и алгоритмы Разработчик 1С 8.3 Абонемент ($m)
Данная внешняя обработка для платформы 1С:Предприятие реализует усовершенствованный алгоритм Левенштейна для вычисления схожести строк с учетом различных лингвистических особенностей русского языка. В отличие от классической реализации, этот алгоритм учитывает фонетические, визуальные и контекстные особенности набора текста.
1 стартмани
07.11.2025 7131 18 InFlach 17
Математика и алгоритмы Запросы Разработчик 1С:Предприятие 8 Бесплатно (free)
Рассмотрим быстрый алгоритм поиска дублей с использованием hash функции по набору полей шапки и табличных частей.
08.07.2024 9285 ivanov660 9
Математика и алгоритмы Разработчик 1С:Предприятие 8 1C:Бухгалтерия Россия Абонемент ($m)
На написание данной работы меня вдохновила работа @glassman «Переход на ClickHouse для анализа метрик». Автор анализирует большой объем данных, много миллионов строк, и убедительно доказывает, что ClickHouse справляется лучше PostgreSQL. Я же покажу как можно сократить объем данных в 49.9 раз при этом: 1. Сохранить значения локальных экстремумов 2. Отклонения от реальных значений имеют наперед заданную допустимую погрешность.
1 стартмани
30.01.2024 17094 stopa85 12
Математика и алгоритмы Бесплатно (free)
Разработка алгоритма, построенного на модели симплекс-метода, для нахождения оптимального раскроя.
19.10.2023 25384 user1959478 57
Математика и алгоритмы Разное 1С:Предприятие 8 1C:Бухгалтерия Россия Абонемент ($m)
Расширение (+ обработка) представляют собою математический тренажер. Ваш ребенок сможет проверить свои знание на математические вычисление до 100.
2 стартмани
29.09.2023 15803 maksa2005 8
Математика и алгоритмы Инструментарий разработчика Разработчик 1С:Предприятие 8 Россия Абонемент ($m)
Что ж... лучше поздно, чем никогда. Подсистема 1С для работы с регулярными выражениями: разбор выражения, проверка на соответствие шаблону, поиск вхождений в тексте.
1 стартмани
09.06.2023 25785 13 SpaceOfMyHead 20
Математика и алгоритмы Разработчик 1С:Предприятие 8 Бесплатно (free)
Три задачи - три идеи - три решения. Мало кода, много смысла. Мини-статья.
03.04.2023 17813 RustIG 10
Механизмы платформы 1С Математика и алгоритмы Разработчик 1С:Предприятие 8 Россия Бесплатно (free)
В статье анализируются средства платформы для решения системы линейных уравнений в 1С. Приводятся доводы в пользу некорректной работы встроенных алгоритмов, а значит потенциально некорректного расчета себестоимости в типовых конфигурациях.
23.11.2022 16703 gzharkoj 17
а = 3 / 7;
а = а + 1;
результат = а * 7;
Сообщить(Формат(результат, "ЧГ="));
напишет: 10,000000000000000000000000003
И на будущее: не используйте 1с в алгоритмических расчетах, любой ЯВУ будет в ~10...100...1000 раз быстрее!
тем более, если учесть разрядность чисел в 1с... не каждый интерпретатор имеет такие числа... например, OneScript не имеет... а тем более с такими не документированными возможностями, которые рассматриваются в этой статье...
У интерпретаторов есть одна особенность. Скорость работы алгоритмов зависит от числа и качества библиотечных функций, которые интерпретатор использует при вычислениях...
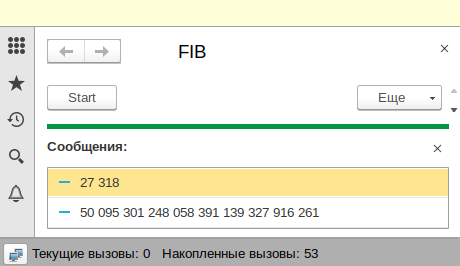
попробовал протестировать сам... взял свой компилируемый Net язык, Python 3.5, и 1С 8.3.13.1644
запустил вот этот код:
n = 139
j = 0
while j < 100000:
    j = j + 1
    fib1 = 1
    fib2 = 1
    i = 0
    while i < n - 2:
        fib_sum = fib1 + fib2
        fib1 = fib2
        fib2 = fib_sum
        i = i + 1
print(fib2)
Показатьи соответственно:
n=139;
j = 0;
Пока j < 100000 Цикл
    j = j + 1;
    fib1 = 1;
    fib2 = 1;
    i = 0;
    Пока i < n - 2 Цикл
        fib_sum = fib1 + fib2;
        fib1 = fib2;
        fib2 = fib_sum;
        i = i + 1;
	КонецЦикла;
КонецЦикла;
Сообщить(fib2);
Показатьрезультат такой:
компилируемый Net язык - 0,21 сек
питон - 5,7 сек
1С - 112 сек
т.е. 1С действительно подтвердила, что она очень медленная, но и Питон показал, что он все таки не компилятор...
Правда в этом тесте надо учесть,что разные языки используют разные числовые библиотеки... у 1С самые многоразрядные числа и она в них считает от начала и до конца.. А Питон судя по всему повышает разрядность чисел динамически по мере необходимости... мой язык считал в Net типе Decimal...
Скажу честно, от 1с ожидал большего :)
так что соглашаюсь с вами - Питон значительно быстрее 1с...
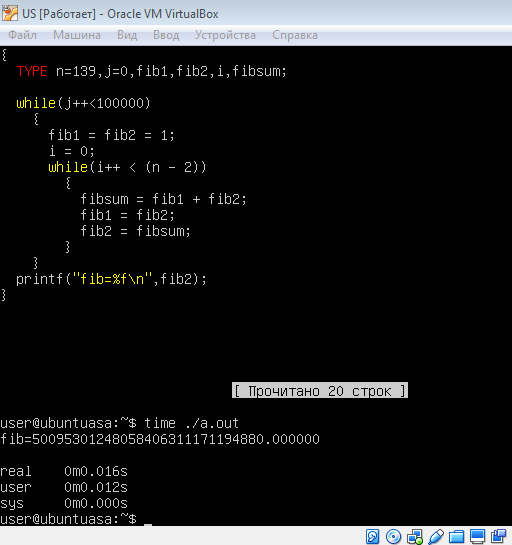
У вас тут результат отличается от вашего же питоновского ниже ;)
А питон иногда может быстро, почти как C
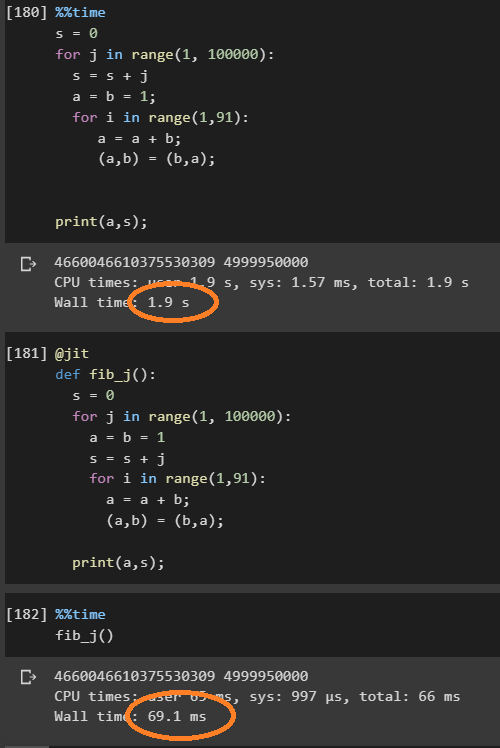
Смотрите, достаточно обернуть ф-ю с вашим кодом в аннотацию @jit из пакета Numba, как она начинает работать на 2 порядка быстрее - 0,07 сек против 1,90 сек просто питоном ;) Потому что предварительно компилится в C.
Но есть и ньюанс, именно в данном случае нифига не помогает, т.к. Numba использует Int64 - т.е. числа до 9223372036854775807,
так что после fib(91) ф-я начинает выдавать чепуху.
вот тут можно убедится (нужно быть залогиненым в гугл, чтобы увидеть Jupyter notebook)
(22)
(a, b) = (a+b, a)И
 a = a + b
 b = a + b
Ну и сократить цикл в 2 раза, и при нечетном аргументе еще раз после цикла "a = a + b".
ЗЫ: У меня на райзен 5 1600 это работает меньше секунды для 139-го члена, а с PyPy - да, на порядок быстрее. Ну и на асме вообще огонь....
c:\1>test.bat
Текущее время: 16:35:36,56
Введите новое время:
c:\1>test.exe
fib=50095301248058389000000000000.000000
Текущее время: 16:35:36,70
Введите новое время:
c:\1>5,00953012480584E+28
Время в секундах: 0,0219402
на Си конечно можно писать более быстрые программы, чем на любом языке более высокого уровня, но и трудозатраты значительно больше... а на ассемблере еще быстрее, и труднее...
Так ты и в питоне можешь считать в Decimal
а в моем языке статическая типизация, поэтому пришлось указать Decimal...
for j in range(1, 100000):
  a = b = 1;
  for i in range(1,139):
     a = a + b;
     (a,b) = (b,a);

print(a);
50095301248058391139327916261
real 0m1,904s
user 0m1,900s
sys 0m0,004s
в моем языке наоборот, циклы Пока почти на 30% быстрее... :)
0.28 против 0.21
у меня этот код вот так выглядит:
Для j Из Ряд(2, 100000)
    Перем a,b тип Число = 1
    Для i Из Ряд(1,137)
        a += b
        Присвоить a,b = b,a
    КонецЦикла
КонецЦикла
ВыводСтроки b
Показатьу меня в ряде верхний предел включительно, поэтому числа скорректированы, но результат тот же...
for j in range(0, 100000):
  a = b = 1;
  for i in range(1,138):
     (a,b) = (b + a,a);

print(a);50095301248058391139327916261
real 0m1,167s
user 0m1,167s
sys 0m0,000s
в данном случае я получил на Питоне 3.5 предсказуемую экономию времени примерно на 20%, а вы пишете, что в 2 раза почти... а ведь мы экономим только одно чтение и одну запись локальной переменной... это не может дать в 2 раза...
аналогичную экономию я получил и на своей перфоленте...
кстати, на FASMе что-то у меня не заработал ваш код, а разбираться почему мне не захотелось... извините уж, но слишком давно я на ассме не писал и вряд ли уже буду... есть много не решенных других задач, жаль время тратить...
1. На питоне 2.7 алгоритм с двумя присваиваниями 1.904 секунды.
2. На нем же алгоритм с одним присваиванием 1.167 - это не в 2 раза, конечно, но и не 20%.
3. На PyPy алгоритм с одним присваиванием 0.181.
По поводу кода, то код ядра интерпретатора вряд ли пишется отдельно для винды и линуха - там лишь механизм взаимодействия с ОС в некоторой части отличается. Сам интерпретатор идентичен. Винда может память выделять иначе, но вряд ли это будет существенно влиять, т.к в этих алгоритмах память почти не используется - четыре переменные всего.
ЗЫ: а по поводу ассемблера, то это лишь тест оставшихся способностей преодолевать сложность))) Я скину для винды код, ибо у меня есть семерка на виртуалке. Поглядим что там как)))
ОС вряд-ли тут может играть какую-либо роль... а реализация интерпретатора может...
ЗЫ: способности преодолевать сложности у меня еще остались, а то я бы создание собственного языка программирования не ослил... а вот со временем жуткий напряг... и тут вряд ли я могу что-то поменять в ближайшее время...
ну вот, а говорили, что даже посмотреть мой язык не сможете, т.к. не на чем.. :)
50095301248058391139327916261
real 0m0,181s
user 0m0,169s
sys 0m0,012s
n=139;
j = 0;
Пока j < 100000 Цикл
    j = j + 1;
    fib1 = 1;
    fib2 = 1;
    i = 0;
    Пока i < n - 2 Цикл
        fib_sum = fib1 + fib2;
        fib1 = fib2;
        fib2 = fib_sum;
        i = i + 1;
    КонецЦикла;
КонецЦикла;
Сообщить(fib2); ПоказатьА теперь попробуйте тот же код в ином оформлении:
т = ТекущаяУниверсальнаяДатаВМиллисекундах();
n=139;
j = 0;
Пока j < 100000 Цикл j = j + 1;fib1 = 1;fib2 = 1;i = 0;Пока i < n - 2 Цикл fib_sum = fib1 + fib2;fib1 = fib2;fib2 = fib_sum;i = i + 1;КонецЦикла;КонецЦикла;
Сообщить(ТекущаяУниверсальнаяДатаВМиллисекундах() - т);
Сообщить(fib2);
Неожиданно? Да, 1С не хватает оптимизации, но не все так печально.
вы, наверное, из конфигуратора под отладчиком запускали... поэтому у вас могла большая разница получиться...
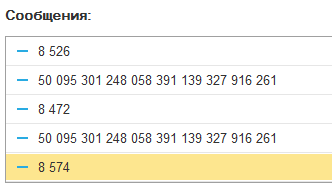
сравнил код... у вас все в одну строку, а у меня только циклы были в одну строку... и уже давало 14 656... это не 1с, а ребус какой-то... :)
50 095 301 248 058 391 139 327 916 261
8 110
50 095 301 248 058 391 139 327 916 261
8 125
50 095 301 248 058 391 139 327 916 261
12 743
50 095 301 248 058 391 139 327 916 261
12 682
50 095 301 248 058 391 139 327 916 261
12 659
50 095 301 248 058 391 139 327 916 261
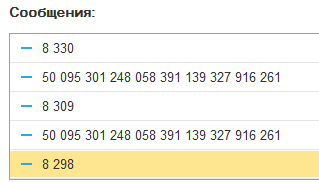
ладно, еще можно понять, когда в одну строку быстрее работает, да и то с трудом (метка строки по идее должна просто пропускаться)...
ЗЫ: исходники в теме про асм.

	mov	rcx	,100000
l0:
	push	rcx

	mov	rcx	,138
	mov	rbx	,1
	mov	rax	,rbx
	mov	r8	,0
	mov	r9	,r8
l1:
	add	rax	,rbx
	adc	r8	,r9
	xchg	rax	,rbx
	xchg	r8	,r9
	loop	l1

	pop	rcx
	loop	l0

	mov	rbx,30
	lea	rsi,[msg]
l2:
	sub	rdx,rdx
	mov	rcx,10
	div	rcx

	add	dl,30h
	mov	[rsi+rbx],dl
	dec	rbx

	or	rax,rax
	jnz	l2

	mov	edx,msg_size
	lea	rsi,[msg]
	mov	edi,1		; STDOUT
	mov	eax,1	; sys_write
	syscall

	xor	edi,edi	; exit code 0
	mov	eax,60	; sys_exit
	syscall

segment readable writeable

msg db '                                                  ',0xA
msg_size = $-msg ПоказатьВ итоге на моем домашнем iIntel® Core™ i7-2670QM CPU 0.036 секунд - и это больше, чем на моем рабочем i7-5500U на С++ (видимо из-за SSE - здесь просто целочисленная 128-битная арифметика, 64-битная быстрее на 0,005 сек).
sergey$ time ./a00
            4114278174457313509

real	0m0,036s
user	0m0,032s
sys	0m0,000s
что-то результат у вас не понятный... вроде вот так должно быть:
фиб(138) = 30 960 598 847 965 113 057 878 492 344
фиб(139) = 50 095 301 248 058 391 139 327 916 261
наверное на ассемблере все же сложнее :)
50 095 301 248 058 388 718 985 150 464
вместо
50 095 301 248 058 391 139 327 916 261
где-то намутили...
результат 50 095 301 248 058 391 139 327 916 261?
результат 50 095 301 248 058 391 139 327 916 261?
Вообще, если без вывода бинарного значения, то 0,017 секунд получается.
ЗЫ: В общем С++ - читер, т.к. при компиляции с О3 он часть расчетов не делает - сворачивает. При компиляции без оптимизации 0,072 время, т.е. в 5 раз дольше.
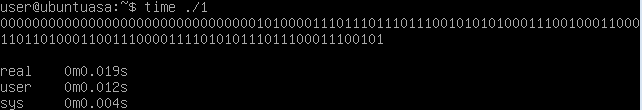
Кстати, еще сильно влияет на результат метод измерения времени... встроенный в компьютер таймер интервалы менее 50 миллисекунд очень не надежно измеряет... только в тиках процессора более менее точно получается, да и то, зависит от реализации (мир теперь многопоточный)...
Вообще, как-то с другом в школе еще писали транслятор. Т.е. он писал, а я ему делал механизм рассылки. Как раз на С все пилилось, а рассылку он вкомпилил с asm'а - дело было еще на УКНЦ в институте развития образования. И у нас бы все получилось, если бы не закон Мура)))
$ time ./1.bin
       50095301248058391139327916261

real	0m0,005s
user	0m0,005s
sys	0m0,000s
Скрытый текст |
|---|
Полный код:format ELF64 executable 3
segment readable executable
entry main
main:
mov rcx ,100000
l0:
sub rbx ,rbx
inc rbx
mov rax ,rbx
sub r8 ,r8
mov r9 ,r8
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
add rax ,rbx
adc r8 ,r9
xchg rax ,rbx
xchg r8 ,r9
dec rcx
jz lX
jmp l0
lX:
lea rsi,[msg]
mov rbx,35
l2:
push rax
xor rdx,rdx
mov rax,r8
mov rcx,10
div rcx
mov r9,rax
mov r8,rax
pop rax
div rcx
or r9,rax
add dl,30h
mov [rsi+rbx],dl
dec rbx
or r9,r9
jnz l2
mov edx,msg_size
mov edi,1 ; STDOUT
mov rax,1 ; sys_write
syscall
l3:
xor edi,edi ; exit code 0
mov eax,60 ; sys_exit
syscall
segment readable writeable
msg db ' ',0xA
msg_size = $-msg
Показать |
слегка помогут комментарии в листинге, но это не слишком упростит восприятие программы, только понимание того, что и где происходит...
Я, конечно, со времен КР580ВМ80, Z80 и i286, i386 на ассемблере больше не писал... уже навыки не те, забывается и от жизни отстал, но писал много и прекрасно знаю, что на ассемблере писать сложнее, чем на Си, на Си сложнее, чем на Бейсике и т.д.
У ассемблера, как языка, есть только два достоинства, скорость и компактность бинарного кода... у языков высокого уровня достоинств гораздо больше, чем и обусловлен выбор большинства программистов...
Но тем не менее достаточно просто все на асме в том случае, если тебе известно, как в памяти представлен тот или иной тип данных, как ее там выделить, как освободить - ведь асм, по-сути, все это у ОС выбирал.
Я в свое время достаточно большой проект делал на Borland Pascal, и там была интерфейсная часть (текстовый интерфейс + VESA 800*600*16 - давно это было, под MS DOS 6.22 RTL PM), которая была написана на асме чуть менее, чем вся (стек окон, рисование объектов интерфейса, выделение цветом текста при выводе (с 0х0 для перфикса цвета), ...). С тех пор не считаю асм сложным языком (по крайней мере 16-битный вариант).
	т = ТекущаяУниверсальнаяДатаВМиллисекундах();
	Для х = 1 по 100000 Цикл
		а = 1;
		б = 1;
		для у = 2 по 139 Цикл
			а = а + б;
			д = а;
			а = б;
			б = д;
		КонецЦикла;
	КонецЦикла;
	Сообщить(ТекущаяУниверсальнаяДатаВМиллисекундах() - т);
Сообщить(а); ПоказатьВ итоге:
1С = 27 сек
Python = 1.9 сек
С++ = 0.016 сек
Asm = 0.005 сек
Т.е. асм в 3 раза быстрее С++, который в 100 раз быстрее, чем питон, который в 14 раз быстрее, чем 1С. Сейчас на PHP протестю )))
$i = 100000;
while($i--) {
  $a = $b = 1;
  for($j = 1; $j < 139; $j++ ) {
        $a = $a + $b;
        $tmp = $a;
        $a   = $b;
        $b   = $tmp;
  }
}
print($a);
Показать5.0095301248058E+28
real 0m0,321s
user 0m0,317s
sys 0m0,004s
$ php -v
PHP 7.2.19-0ubuntu0.18.04.1 (cli) (built: Jun 4 2019 14:48:12) ( NTS )
Copyright © 1997-2018 The PHP Group
Zend Engine v3.2.0, Copyright © 1998-2018 Zend Technologies
with Zend OPcache v7.2.19-0ubuntu0.18.04.1, Copyright © 1999-2018, by Zend Technologies
Пока j < 100000 Цикл
j = j + 1;
fib1 = 1;
fib2 = 1;
Каждый раз заново считает fib2
А почему бы тогда не посчитать такой цикл?
Пока j < 100000 Цикл
j = j + 1;
fib1 = j;
fib2 = j;
Рейтинг: 282
Вы можете заказать платную консультацию или разработку у автора. Будет создан приватный заказ на «Бирже заказов» для автора.
№ 1033891
Создание 28.05.19 12:00
Обновление 28.05.19 12:00
Просмотры 19490
Загрузки 0
Рейтинг
80
Комментарии 98
Код открыт Да
Рубрики Математика и алгоритмы
Кому Разработчик
Тип файла Нет файла
Платформа 1С:Предприятие 8
Конфигурация Универсальные
Операционная система Не имеет значения
Страна Россия
Отрасль Не имеет значения
Налоги Не имеет значения
Вид учета Не имеет значения
Доступ к файлу Бесплатно (free)