Оценка скорости кода. Сложность алгоритма

07.10.19

Разработка - Рефакторинг и качество кода

Эта тема одной из первых всплывает на собеседовании программистов языков вроде Java и C, но она почти неизвестна в "мире 1С". Поговорим о вычислительной сложности алгоритмов.

Основными измеримыми показателями алгоритмов являются сложность и расход памяти. На расходе памяти останавливаться отдельно не будем, поскольку тут все довольно интуитивно понятно: чем больше промежуточных данных мы вынуждены создать в ходе работы алгоритма - тем больше расход, а вот про сложность стоит поговорить подробнее.

Итак, сложность алгоритма - это показатель зависимости роста времени выполнения программы от количества входных данных. Иными словами, насколько вырастет число итераций некоторых действий при росте числа входных данных. При этом абсолютное время каждого конкретного действия в данной концепции значения не имеет, поскольку это скорее всего какой-то внешний параметр, на который конкретный алгоритм не имеет никакого влияния. Имеет значение только, как быстро растет количество повторений.

Тут можно подумать: что за ерунда? Если надо обработать массив из 10 элементов - надо выподнить что-то 10 раз. Если из 100 элементов - 100 раз, как может быть иначе?

Может. Рассмотрим на примере. Всем изместный алгоритм пузырьковой сортировки выглядит как двойной цикл, примерно так:

Для и1 = 0 По Массив.ВГраница() Цикл
	Для и2 = 0 ПО Массив.ВГраница() Цикл
		...

Тут несложно увидеть, что c ростом размера массива - количество итераций цикла будет расти с квадратичной зависимостью: на каждый новый элемент массива в "верхем" цикле мы обойдем весь массив еще раз в нижнем цикле. На графике это будет выглядеть так:
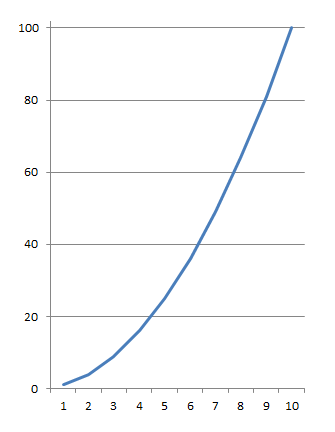
похоже на параболу.

Если массив имеет 4 элемента - цикл выполнится 16 раз. Если 5 - 25, 6 - 36 и т.д. Это называется квадратичной сложностью. На самом деле есть оптимизации позволяющие сократить это время более чем вдвое, чтобы формула сложности выгляделя так: n²/2 - n/2, но поскольку мы говорим не о каких-то точных значениях, а об оценке алгоритма и фрагмент n² тут доминирует над остальными операциями, всей остальной частью формулы обычно пренебегают и говорят, что сложность алгоритма пузырьковой сортировки - n². Записывают обычно в таком виде: O(n²), это называется "нотация большого О".

В разработке прикладных решений понимание того факта, какой сложносьтю обладает разработанный алгоритм не всегда нужно, поскольку высокая (квадратичная или даже выше) сложность обычно нивелируется небольшим количеством обрабатываемых данных и высокой производительостью серверов в энтерпрайзе. Ну какое количество строк может быть в накладной? 50? 100? 500? Алгоритм с квадратичной зависимостью на 10 строках будет иметь 100 итераций, а на 100 - 100 тысяч. Казалось бы колоссальный рост, но если выражать его в секундах - то на хорошем Xeon мы выросли с 0,0005 до 0,5 секунды - кому это будет интересно на фоне того сколько он будет проводиться? Ну документ большой, работает долго, подумаешь..

Но!

Во-первых, строк не всегда 500. Если вы имеете дело с каким-нибудь хитрым алгоритмом анализа остатков или распределения товаров, где, например, 25 тысяч товаров умножаются на 300 магазинов - строк уже не много не мало 7,5 миллионов. Каждая новая строка в таком случае будет добавлять 7,5 миллионов итераций, что уже, согласитесь существенно. Тут стоит всеми правдами и неправдами стараться перестроить алгоритм так, чтобы вместо одного вложенного цикла, дающего сложность O(n²), у нас было 2,3,4 обычных цикла, дающих сложность O(2n), O(3n), O(4n) соответственно. Как добиться такой замены - отдельный вопрос, это не всегда возможно (например пройти первый раз - построить индекс - пройти второй раз с поиском не перебором, а по индексу с логарифмической сложностью), но если возможно - делать стоит однозначно. На следующем графике приведен рост временивыполнения алгоритмов O(n), O(4n) и O(n2):
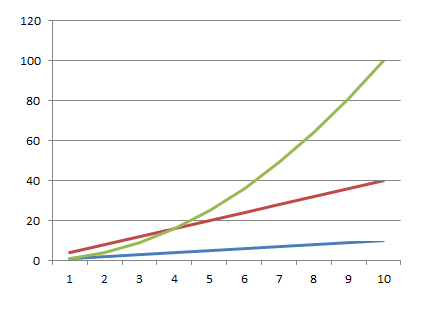
обратите внимание, тут всего 10 элементов на входе, если будет больше - линейные алгоритмы просто не оторвутся от оси на фоне роста квадратичного.

Во-вторых, зависимость не всегда квадратичная. Если так случится, что вы зачем-то вложите 3-й цикл (не вспомню конкретных задач, но я такое встречал и даже писал), зависимость уже будет кубической, а она растет еще быстрее. Чтобы проиллюстрировать это - сведем на одном графике линейную, квадратичную и кубическую зависимость.
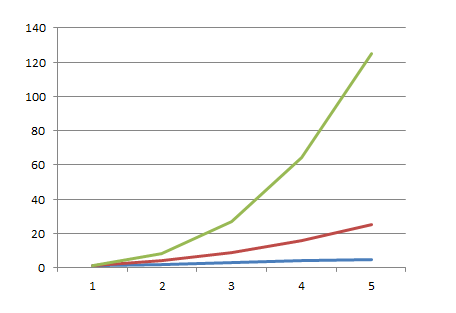
на этом графике всего лишь 5 элементов по той же причине.

На самом деле, хитрые компьютер-саенс специалисты для большинства типичных операций имеют алгоритмы лучше чем квадратичной сложности. Как правило, алгоритм обработки большого объема данных обходитя в log(n), а в некоторых случаях вообще обходится константной сложностью (это когда время выполнения вообще не зависит от объема данных). Все алгоритмы сортировки, поиска и т.п. так умеют. Достигается это иногда при помощи улучшения самого алгоритма, иногда построения хитрых индексных или хэш- таблиц, но достигается всегда. Почти ). Поэтому когда вы реализуете алгоритм, обладающий квадратичной или хуже сложностью - задумайтесь: не стоит ли его оптимизировать?

Вступайте в нашу телеграмм-группу Инфостарт

Компьютер-саенс сложность алгоритма вычислительная нотация большого О

Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».

  • 0% комиссии — оплата напрямую исполнителю;
  • Исполнители любого масштаба — от отдельных специалистов до команд под проект;
  • Прямой обмен контактами между заказчиком и исполнителем;
  • Безопасная сделка — при необходимости;
  • Рейтинги, кейсы и прозрачная система откликов.

См. также

Рефакторинг и качество кода Обновление 1С Разработчик 1С 8.3 Бесплатно (free)

Первоначальная задача заключалась в локальном переносе добавленных объектов метаданных (справочников, документов) и кастомной логики в расширение без потери накопленных данных. Но в ходе проекта, когда работы были уже практически завершены, заказчик принял решение полностью вернуть конфигурацию к типовому виду и перенести в расширение все измененные свойства стандартных объектов, включая изменения типов реквизитов.

22.09.2026    278    1c-izh    0    

4

Рефакторинг и качество кода Тестирование QA Разработчик Бесплатно (free)

Штатная страховка внутри цепочки обработки умеет прятать дефекты того шага, который стоит перед ней. У нас так и вышло: валидатор чинил результат постфактум, на выходе всё выглядело корректно, и никто не видел, что предыдущий шаг молча теряет данные. Вылезло это только на независимой проверке чужими глазами. Разбираю, чем инвариант отличается от сценарного теста и почему обычное умножение вытащило дефект из красивой метрики 0,997. Отдельно про 13 дублей, которые приехали из источника ещё до всякой обработки, и про две находки, которые оказались вообще не моими: они жили в эталонной реализации, откуда я списывал логику. Вторая часть про лимит выхода модели: почему обрезка ответа по длине это тихий ноль в мониторинге и как смена формата на дельты уронила выход до 4 951 токена. Есть отклонённые гипотезы и честный список того, чего мы так и не померили.

21.09.2026    296    nedomolkov.ivan    2    

1

WEB-интеграция Рефакторинг и качество кода Системный администратор Разработчик 1С 8.3 Бесплатно (free)

Я сел проверять внутренний поисковый сервис по коду: можно ли доверять ему в автоматическом режиме. Сверка с обычным текстовым поиском по файлам дала 261 из 261, 264 из 264 и 182 из 182 совпадений, разбор структуры файла - 318 функций из 318. Стопроцентная точность. Этот же замер и вскрыл, что опираться на сервис нельзя: искал он безупречно, только совсем не в том месте, которое я ему называл. Внутри разбор трёх дефектов, сложившихся в один тихий отказ: аргумент, проглоченный без ошибки; умолчание, выставленное когда-то наугад; снимок данных, у которого в ответе не указан возраст. Плюс регулярное задание, которое вся команда считала работающим и которого не существовало никогда. Перенос на 1С прилагается: готовый цикл проверки, после которого HTTP-сервис перестаёт молча принимать мусор.

21.09.2026    291    nedomolkov.ivan    0    

0

Логистика, склад и ТМЦ Рефакторинг и качество кода Разработчик Аналитик Руководитель проекта 1С 8.3 Бесплатно (free)

Кладовщик получает задачу: на складе проверки лежат две штуки. Идёт в зону, а там всё на месте и никакой задачи в складской системе нет. Так работала автоматическая сверка остатков между учётной и складской системами: разницу она переносила документом, а комментарий к этому документу восемь месяцев отправлял людей искать несуществующий ноль. Робота разобрали до кода. Обе сравниваемые величины оказались синтетическими: слева физический срез с вычетами по активности и окнами в 60 минут и 12 часов, справа учётный остаток на конец дня минус трёхчасовой хвост непроведённых ордеров. Порог срабатывания стоял в нуле, поэтому робот исправно оформлял собственный шум измерения: за 60 дней он сам создал 62,7% оборота технического склада, а 2 081 артикул из 2 102 приезжал туда и уезжал обратно. Внутри обе формулы, замер лага отгрузки, снятая гипотеза и честная граница данных.

21.09.2026    268    nedomolkov.ivan    0    

0

Рефакторинг и качество кода Нейросети Разработчик 1С 8.3 Бесплатно (free)

Как за вечер проверить, годится ли локальная модель для поиска ошибок в вашем коде 1С, и не обмануть себя по дороге. Разбираю замер Qwen2.5-Coder 1.5B, 3B и 7B на коде с заранее известными дефектами: почему полноту и шум надо считать раздельно, как 3B набирает высокий балл, вообще не читая код, сколько минут уходит на боевую процедуру на процессоре и на GTX 1650, и чем кончилась попытка подложить модели справку по методам платформы.

16.09.2026    1235    nedomolkov.ivan    4    

1

Инструментарий разработчика Нейросети Рефакторинг и качество кода Аналитик Пользователь Руководитель проекта Бесплатно (free)

Железо перестало быть проблемой, и качество ответов немедленно встало в потолок. Дальше пошли три улучшения, каждое из которых выглядело очевидно правильным: свой справочник стандартов, код процедур в поисковом индексе и переписывание вопроса отдельной моделью. Первое работало, но стоило пятнадцать тысяч токенов в каждом запросе. Второе уронило находимость на двадцать процентов. Третье уронило качество с 0,864 до 0,782 и растянуло прогон с 88 секунд до 302. Рассказываю, чем я это померил, почему на глаз ни одно ухудшение не видно и почему добавление правдивой информации регулярно делает поиск хуже.

14.09.2026    703    solbol    0    

3

Рефакторинг и качество кода Нейросети Разработчик 1С:Предприятие 8 Бесплатно (free)

Продолжение статьи «BSL Language Server внутри 1С:EDT: коннектор, которого не хватало». Там мы научили EDT видеть расширенную диагностику BSLLS, а здесь замкнем контур: научим ИИ-агентов автоматически исправлять эти ошибки строго по официальным стандартам разработки 1С.

02.09.2026    1879    malikov_pro    2    

6
Комментарии
Подписаться на ответы Инфостарт бот Сортировка: Древо развёрнутое
Свернуть все
1. пользователь 07.10.19 15:27
Сообщение было скрыто модератором.
...
2. EVKash 16 07.10.19 16:27 Сейчас в теме
(0)
Эта тема одной из первых всплывает на собеседовании программистов языков вроде Java и C, но она почти неизвестна в "мире 1С".

Может быть потому, что основным методом получения информации в 1С является язык запросов? Оптимизировать нужно запросы. И не делать запросы в цикле. Но это как бы всем известно.
3. nomad_irk 84 07.10.19 18:04 Сейчас в теме
(2)далеко не всем и не всегда. Любое разыменование - запрос в ИБ, но кто ж об этом задумывается кода обрабатывает какие-нить документы/справочники пакетно?

По поводу статьи: имхо, в 1с со сложностью кода все сложно и просто одновременно. Если требуется сортировка какого-то большого массива данных, будет быстрее загнать этот массив данных в запрос/набор, умеющий выполнять сортировку по значению и выполнить сортировку с помощью SQL/набора, чем пытаться самому, честно, используя объектный подход, с помощью цикла(-ов) выполнять сортировку.
5. kote 539 08.10.19 08:31 Сейчас в теме
(2)
в корне неверное представление..
В языке запросов описанное тоже имеет место.. Ну например, при объединении таблиц, когда нужно получить перемножение таблиц - это полный аналог 2х циклов вложенных друг в друга..
6. nomad_irk 84 08.10.19 08:41 Сейчас в теме
(5)Может все же при соединение таблиц, а не объединении?
10. kote 539 16.10.19 10:46 Сейчас в теме
(6) Да, так будет точнее - пример приведен для соединения таблиц
4. stepan_s 08.10.19 06:18 Сейчас в теме
На сколько я понимаю - статья для того, чтоб обратить внимание на проблему обработки больших массивов данных простыми циклами?
Не уловил мысли что предлагается конкретно :( Тема верная, но какие подходы нужно выбирать?
И самое важное....
Как много ситуаций, когда на клиента приходят данные огромного объема? И эти ситуации действительно адекватны?
7. capitan 2598 09.10.19 17:37 Сейчас в теме
Поэтому когда вы реализуете алгоритм, обладающий квадратичной или хуже сложностью - задумайтесь: не стоит ли его оптимизировать?

даже люди профессионально преподающие алгоритмы спокойно к этому относятся.
Все дело в величине выборки
Т.е. в данном случае оценивается величина выборки/сложность алгоритма
Выборок действительно большого объема в 1С не так уж и много, тем более требующих самостоятельной реализации сортировки
Это хорошо для модной темы биг дата.
А в 1С обычно решение нужно вчера, поэтому если вы его сделаете на простейшем алгоритме сегодня, а не на супер навороченном через месяц - все вас от этого прославят в веках
И как правило не бывает ничего бесплатного - более быстрый алгоритм требует больших ресурсов и наоборот
RustIG; Артано; +2 Ответить
9. Артано 803 11.10.19 17:43 Сейчас в теме
(7) Практически снято с языка. Добавлю только, что алгоритмы для обработки больших массивов данных это зачастую штучная работа, и в любом случае должно быть деление для условных алгоритмов сортировки на две категории:

1. Сортировать();
2. СортироватьМногоДанных();
8. kuzyara 2268 11.10.19 10:52 Сейчас в теме
Полезней было бы привести примеры расчета O для запросов.
11. Pixar0000 18.10.19 15:00 Сейчас в теме
аффтору просто стоит "вспомнить" первый курс института, курс прикладная математика, если филолог то, соррян
It-developer; +1 Ответить
12. RustIG 1986 18.09.20 05:52 Сейчас в теме
На самом деле, хитрые компьютер-саенс специалисты для большинства типичных операций имеют алгоритмы лучше чем квадратичной сложности. Как правило, алгоритм обработки большого объема данных обходитя в log(n), а в некоторых случаях вообще обходится константной сложностью (это когда время выполнения вообще не зависит от объема данных). Все алгоритмы сортировки, поиска и т.п. так умеют. Достигается это иногда при помощи улучшения самого алгоритма, иногда построения хитрых индексных или хэш- таблиц, но достигается всегда. Почти ). Поэтому когда вы реализуете алгоритм, обладающий квадратичной или хуже сложностью - задумайтесь: не стоит ли его оптимизировать?


Тема актуальная - в профессиональной среде задачи обработки большого массива данных встречаются часто.
Поясню: есть задачи "прямые" - например, пользователь создает документы, спрашивается "сколько документов создали все пользователи за неделю?" Это прямая задача - для решения мы просто арифметически складываем кол-во документов за период.

А есть обратные задачи - оптимизационные или поиск оптимума. Когда надо найти наилучший вариант или вообще найти один из возможных вариантов.

Меня вопрос оптимизации алгоритмов сильно интересует.
Но до сих я не понял, где взять эти алгоритмы?

Под каждую задачу - они индивидуальны, но еще надо идентифицировать задачу правильно - к какой группе алгоритмов ее отнести, чтобы начать применять тот или иной алгоритм...

Как это делается?
13. m-rv 987 20.09.20 13:30 Сейчас в теме
(12) речь не идет о том, что есть какой-то универсальный способ оптимизировать любой алгоритм, но безусловно, знание классических примеров очень кстати и возможно поможет увидеть за своей задачей один из них. какие они бывают - ну вот например, гляньте: https://neerc.ifmo.ru/wiki/index.php?title=%D0%90%D0%BB%D0%B3%D0%BE%D1%80%D0%B8%D1%82%D0%BC%D1%8B­_%D0%B8_%D1%81%D1%82%D1%80%D1%83%D0%BA%D1%82%D1%83%D1%80%D1%­8B_%D0%B4%D0%B0%D0%BD%D0%BD%D1%8B%D1%85
Для отправки сообщения требуется регистрация/авторизация