Пятнадцать тестов на маленькую функцию, все пятнадцать зелёные. Потом ту же функцию прогнали через состязательный аудит: пять независимых проверок одного и того же кода, задача каждой сформулирована жёстко - найти конкретные дефекты и показать вход, на котором они воспроизводятся. Нашли восемь. Все восемь настоящие. Один молча терял записи.
Функция на вид скучная. Берёт план группировки записей, берёт решения языковой модели по этому плану и применяет их строго по правилам, одинаково при одном и том же входе: эти две группы слить, эту запись перекинуть вон туда. Группы я дальше называю кластерами, к кластеру серверов 1С и к кластеру СУБД они отношения не имеют, это наборы похожих записей. Писал функцию я сам, тестами покрывал тоже сам.
Дальше я разберу, что именно нашли, почему мои тесты этого не видели, и чем закончилась вторая часть той же истории, где один из шагов обработки упирался в лимит выхода любой модели.
Сразу про границу: это не код на встроенном языке
Честно, чтобы дальше не было обид. Функция, о которой речь, живёт не в конфигурации. Это обвязка вокруг языковой модели: отдельная служба со своим набором тестов, со своими переменными окружения и запуском в контейнере (изолированная упаковка приложения со всем окружением, ставится и переносится целиком). Внутренний язык другой.
Я всё равно тащу эту историю сюда, и вот почему. Всё, что здесь произошло, произошло не из-за языка. Пятнадцать тестов написал автор функции. Восемь дефектов нашли те, кто функцию не писал. Между этими двумя фактами нет ничего специфичного для среды: ровно та же механика работает на модуле обработки, на общем модуле, на процедуре проведения документа. Если у вас есть свой набор тестов на свой же код, история про вас.
Что переносится один в один: сама постановка проверки, приём с инвариантом на уровне функции и вывод про эталон, которому доверяют по умолчанию. Что не переносится: инструментарий и цифры по токенам, они привязаны к языковым моделям.
Вывод раздела. Если вы читаете дальше, читайте как методику проверки, а замеры по токенам пропускайте, они здесь для второго сюжета.
Почему пятнадцать тестов пропустили восемь багов
Первая реакция на такой счёт всегда одинаковая: мало тестов, надо было писать тридцать. Я тоже так подумал. Это неверный вывод, и он опасен тем, что выглядит как работа над ошибками.
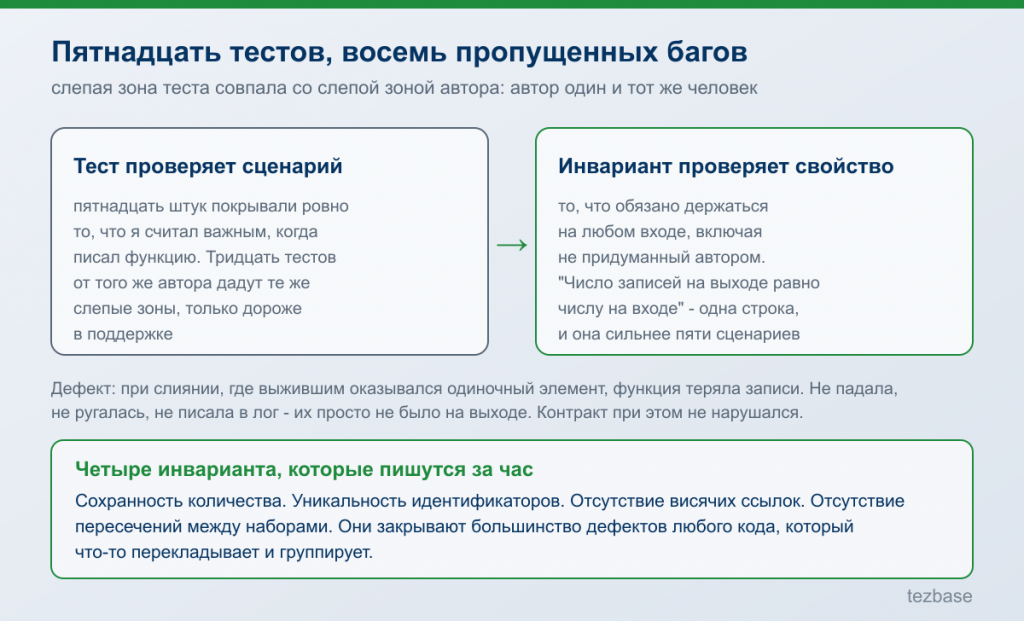
Пятнадцать тестов проверяли ровно то, что я считал важным, когда писал функцию. Я знал, какие ситуации бывают, я их и покрыл. Слепая зона теста совпала со слепой зоной автора просто потому, что автор один и тот же человек. Тридцать тестов от того же автора дадут те же слепые зоны, только дороже в поддержке.
Дефект, который выяснился первым, звучит так. При слиянии кластеров, где выжившим оказывался одиночный элемент, функция теряла записи. Не падала, не ругалась, не писала в лог. Просто на выходе их не было. Формально контракт при этом не нарушался: модель имеет право сливать одиночные элементы, такое решение легальное. Но функция обязана быть без потерь сама по себе, независимо от того, какие решения ей скормили. Этого инварианта у меня в тестах не было, потому что я его ни разу не сформулировал вслух.
Вот в этом и суть. Тест проверяет сценарий. Инвариант проверяет свойство, которое обязано держаться на любом сценарии, включая те, которые автор не придумал. У меня было пятнадцать сценариев и ноль инвариантов.
Практический минимум для тех, у кого независимых проверяющих под рукой нет вовсе: машина автором не является, и это уже половина ценности. Инварианта она не проверит, потерю записей не увидит, замысла не знает - у неё каталог правил, и только. Зато читает всё подряд и без снисхождения к своему. Я прогнал Анализ кода внешних обработок 1С по семнадцати собственным обработкам, тем самым, которые лежат на Инфостарте и которые у меня покупают: 239 замечаний, 186 критичных, два красных светофора на моих же файлах. Ни одного из восьми дефектов этой статьи он бы не нашёл, и это честная граница метода: машина ловит классы, человек ловит смысл.
Вывод раздела. Прежде чем добирать тесты, выпишите свойства функции, которые обязаны выполняться всегда. "Число записей на выходе равно числу на входе" это одна строка проверки, и она сильнее пяти сценарных тестов.
Что нашли, кроме потери записей
Остальные семь находок скучнее по драматургии, но лечатся так же. Коротко, по существу:
- дубли между списками: один и тот же элемент оказывался сразу в двух результатах, и никто не проверял пересечение;
- коллизии идентификаторов: два разных объекта получали один идентификатор при перенумерации после слияния;
- отсутствующие идентификаторы: ссылка на кластер, которого в результате уже нет, потому что его слили;
- дублирующиеся исходные ссылки: одна и та же исходная запись приезжала в результат дважды.
Общее у всех четырёх одно: это нарушения целостности результата, которые видны, только если задать вопрос про сам результат целиком. Сценарный тест смотрит на конкретный кейс и говорит "ага, слияние отработало". Он не спрашивает "а вообще-то в этом результате нет дублей?".
Вывод раздела. Список инвариантов почти всегда одинаковый для любого кода, который что-то перекладывает и группирует: сохранность количества, уникальность идентификаторов, отсутствие висячих ссылок, отсутствие пересечений между наборами. Четыре проверки закрывают большинство таких дефектов и пишутся за час.
Валидатор оказался соучастником
Самая обидная часть. Почему всё это доехало живым до аудита и не всплыло в первый же рабочий день?
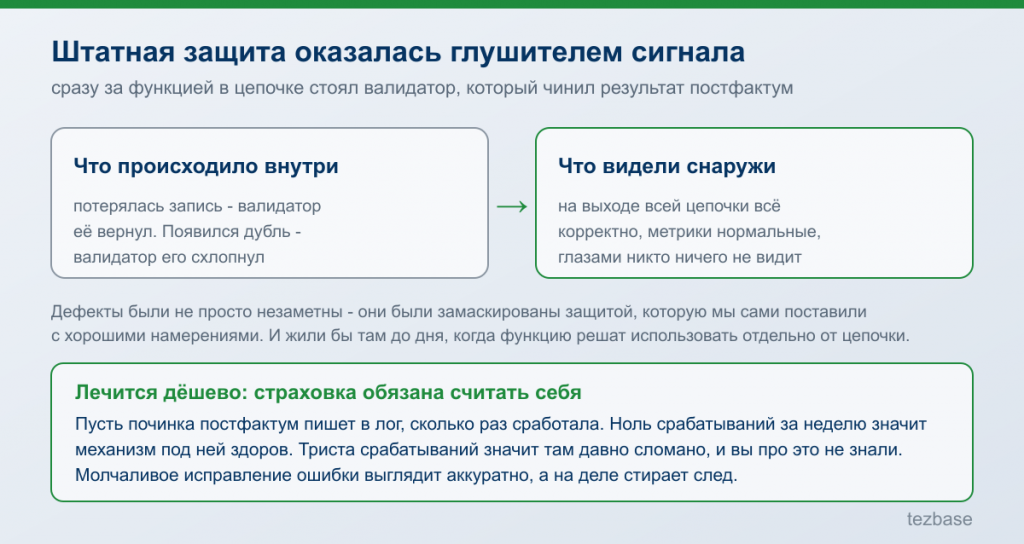
Потому что сразу за нашей функцией в цепочке шагов стоял валидатор, который чинил результат постфактум. Потерялась запись, валидатор её вернул. Появился дубль, валидатор его схлопнул. На выходе всей цепочки всё было корректно, метрики были нормальные, глазами никто ничего не видел.
То есть дефекты были даже не просто незаметны. Они были замаскированы штатной защитой, которую мы сами и поставили, причём поставили с хорошими намерениями. И жили бы там до момента, когда функцию решат использовать отдельно от цепочки. У нас как раз к этому и шло.
Я после этого стал смотреть на любую починку постфактум с подозрением. Валидатор, нормализатор, "обработка исключений на всякий случай", перепроведение по расписанию, которое молча правит остатки. Всё это одновременно и полезная страховка, и глушитель сигнала. Пока страховка молчит, вы не знаете, работает под ней исправный механизм или сломанный.
Лечится дёшево: пусть страховка считает, сколько раз она сработала, и пишет это в лог. Ноль срабатываний за неделю значит механизм под ней здоров. Триста срабатываний значит там что-то давно сломано, и вы про это не знали.
Вывод раздела. Любая починка постфактум обязана вести счётчик. Молчаливое исправление ошибки выглядит аккуратно, а на деле стирает след.
Арифметика поймала то, чего не поймали тесты
Отдельно расскажу про приём, который я теперь применяю везде, потому что он бесплатный.
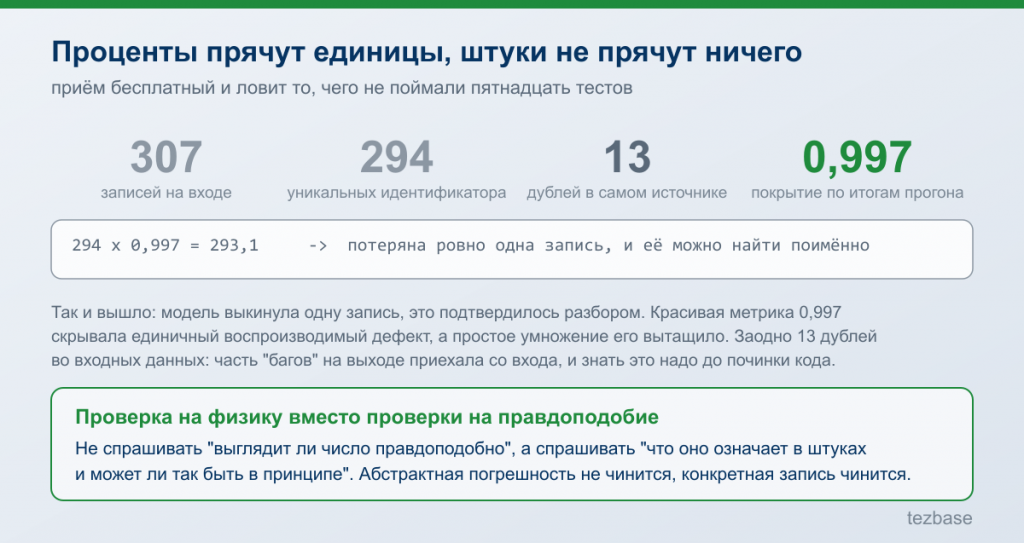
Исходные данные того прогона: 307 записей, из них 294 уникальных идентификатора. Разница даёт 13 дублей в самом источнике, до всякой обработки. Уже полезно: часть "багов" на выходе приехала со входа, и знать это надо до того, как начнёшь чинить свой код.
Дальше интереснее. Замер покрытия по итогам прогона дал 0,997 при шести дублирующих размещениях. Число само по себе выглядит отлично, 99,7 процента, кто будет придираться. А теперь умножаем: 294 умножить на 0,997 равно 293,1. Значит потеряна ровно одна запись. Не "почти всё на месте", а конкретно одна штука, и её можно найти поимённо.
Так и вышло: модель выкинула одну запись, это подтвердилось разбором. Красивая метрика 0,997 скрывала за собой единичный воспроизводимый дефект, а простое умножение его вытащило.
Приём формулируется как проверка на физику: не спрашивать "правдоподобно ли выглядит число", а спрашивать "что это число означает в штуках, и может ли так быть в принципе". Проценты и коэффициенты прячут единицы. Штуки не прячут ничего.
Вывод раздела. Любую относительную метрику переводите обратно в штуки. Если 0,997 превращается в "потеряна одна запись", у вас появилась задача с конкретным входом. Абстрактная погрешность так не чинится.
Два бага из восьми были вообще не мои
Находка, ради которой я и решил про это написать.
Когда разобрали все восемь дефектов, выяснилось, что два из них присутствуют и в эталонной реализации, с которой я сверялся, когда писал функцию. То есть я честно посмотрел, как это сделано в образце, честно повторил логику, и вместе с логикой унаследовал дефект.
Это меняет картину целиком. Пока думаешь, что баг твой, работа выглядит как "поправить у себя". Как только выясняется, что баг в образце, вопрос становится другим: сколько ещё реализаций скопировали то же самое.
У нас в отрасли это ровно то, что происходит с типовыми механизмами и с чужими примерами кода, которые расходятся по проектам. Кусок, который выглядит проверенным, потому что он из авторитетного источника, никто не читает критически. Ему доверяют по факту происхождения.
Скажу прямо своё мнение: доверие к эталону это самая дорогая привычка в разработке. Дефект в собственном коде живёт в одном месте. Дефект в образце размножается со скоростью копипасты и обнаруживается через год у пяти клиентов одновременно.
Вывод раздела. Когда нашли у себя баг, потратьте десять минут и проверьте источник, откуда взяли логику. Если баг там тоже есть, задача выросла: надо чинить не только своё.
Второй сюжет: шаг, который упирался в лимит любой модели
Та же история, другой конец цепочки. Шаг согласования выдавал весь план целиком, каждый раз переписывая его заново от начала до конца. Выход получался 50-65 тысяч токенов.
Что при этом происходило на практике. Одна модель еле влезала: 54 528 токенов выхода, 481 секунда работы, причём первая попытка приходила пустой и требовался повтор. Вторая обрезалась ровно на лимите в 64 000 токенов, с признаком завершения "по длине", 859 секунд.
Вот на этом моменте стоит задержаться, потому что грабля тихая. Ответ, обрезанный по длине, приходит валидным на вид. Разбирается, парсится, читается. Он просто неполный. Если не проверять признак завершения ответа, вы получаете тихий ноль: система работает, мониторинг спокоен, а часть решений потерялась по дороге.
Первая мысль была очевидная и неправильная, про неё ниже отдельно. Правильное решение оказалось в смене формата ответа. Вместо того чтобы каждый раз выдавать весь план заново, шаг стал выдавать только дельты: что с чем слить и что куда переназначить. Применение дельт делает уже обычный код, который на одном входе всегда даёт один результат, тот самый, с которого начался этот разбор.
Результат: выход упал до 4 951 токена. Это сокращение в 10-13 раз относительно прежних 50-65 тысяч. Первая попытка отрабатывает сразу, без повторов, 243,9 секунды. Один типичный прогон в новом формате это 19 слияний и 72 переназначения, то есть 91 действие, которые в старом формате приходилось переписывать целиком вместе со всем остальным планом.
Качество при этом даже выросло: разбиение дало 60 кластеров против 21 у прежнего монолитного варианта, рост в 2,86 раза по детализации.
Вывод раздела. Упор в лимит ответа это дефект формата обмена, а не характеристика модели. Пока шаг каждый раз выдаёт весь результат заново, он будет упираться в потолок любой модели, которую вы поставите. Отдавайте изменения, применяйте их своим кодом.
Отклонённые гипотезы
Две штуки, обе выглядели разумно, обе оказались мимо.
Гипотеза первая: дописать тестов. Естественная реакция на счёт 15:8. Отклонена по причине из второго раздела: тесты пишет тот же автор с теми же представлениями о том, что бывает. Проверил на себе задним числом, попробовав придумать тесты на найденные дефекты "как будто я их ещё не знаю". Придумались два из восьми. Остальные шесть я бы не написал никогда, потому что не считал такие ситуации возможными. По итогам разбора в набор добавлено 6 регрессионных тестов. Это фиксация уже найденного, находить новое они не помогут. Полный набор до разбора был 195 прошедших тестов, и он ничего из этих восьми не поймал.
Гипотеза вторая: взять модель с большим лимитом выхода. Тоже логично: раз обрезается на 64 000, нужна та, которая держит больше. Отклонена арифметикой. Требование к размеру выхода не выполнялось ни на одной из проверенных моделей, причём по разным причинам: у рассуждающих объём выхода доминируют внутренние рассуждения, у обычных число действий в плане. Смена модели двигала бы потолок на десятки процентов, а нужно было в десять раз. Формат дал десять с лишним. Правильным выводом стало перевести целевой показатель размера выхода из требования в предупреждение: как метрика он недостижим и только зашумляет мониторинг.
Вывод раздела. Если решение "взять инструмент помощнее" даёт выигрыш в проценты, а нужны разы, инструмент ни при чём. Смотрите на формат обмена.
Три грабли рядом, которые съели больше всего времени
Не про аудит, но из того же разбора, и мне их жалко выбрасывать.
Библиотека игнорировала настройку таймаута. Внутри были жёстко зашиты 30 секунд, параметра в настройках не существовало вообще. Большие группы падали, причём падали с пустым текстом ошибки. Урок оттуда: пустой текст исключения почти всегда означает сетевую библиотеку, которая не потрудилась сформировать сообщение. Пишите в лог тип исключения сразу, вместе с текстом. Одна строка в обработчике экономит полдня гадания.
Белый список переменных окружения не содержал нужного флага. Флаг физически не доходил до контейнера. Тесты этого не ловили, потому что подменяли вызов уровнем выше того места, где флаг читается. Классика: тест зелёный, в бою не работает, потому что тестируется не тот слой.
Целевой показатель, недостижимый как метрика. Про него было выше. Добавлю только, что месяц мы гонялись за этой цифрой сменой моделей, и это чистый убыток.
Вывод раздела. Пустое сообщение об ошибке тоже подсказка, и в нашем случае она с самого начала указывала на сетевую библиотеку.
Чего мы не померили, и это честно
Метод состязательного аудита в этом тексте выглядит бесплатным. Он не бесплатный, и вот дыры в моих данных:
- Цена аудита не измерена. Пять независимых проверок это время и деньги, и я не могу сказать, во сколько они обошлись против стоимости восьми дефектов, доехавших до боевой эксплуатации. Главная цифра для практического решения, и её у меня нет.
- Ложные находки не посчитаны. Я говорю "восемь реальных", но не фиксировал, сколько всего находок было заявлено и сколько отсеялось при проверке. Без этого числа нельзя оценить, сколько времени уходит на разбор мусора.
- Не проверено, хватило бы трёх проверок вместо пяти. Возможно, кривая насыщения выходит на плато после третьей. Возможно, наоборот, восьмая нашлась бы только на седьмой попытке.
- Два бага в эталоне на момент разбора не были исправлены. Отдал владельцу, дальше не отследил.
Пишу это не для галочки. Если кто-то повторит эксперимент и посчитает цену, это будет полезнее самой истории про восемь багов.
Вывод раздела. Прежде чем ставить независимую приёмку в процесс, заведите два счётчика: сколько находок заявлено и сколько подтвердилось. Без второго числа метод невозможно защитить перед тем, кто за него платит.
Открытый вопрос
Прямой ответ на вопрос из заголовка: свои тесты не бесполезны, они ловят регрессии и держат контракт. Но искать неизвестные дефекты в своём коде своими же тестами нельзя по устройству процесса. Автор не видит своих слепых зон, на то они и слепые.
Теперь вопрос к вам, и он мне правда интересен. У кого-нибудь была ситуация, когда типовой механизм или кусок кода из авторитетного источника оказался с дефектом, и вы этот дефект унаследовали копипастой? Мне интересно, как вы его в итоге поймали: тестом, инцидентом в бою или случайно. Расскажите в комментариях, я такие истории собираю.
Состязательный аудит из статьи гонялся руками. Для кода на встроенном языке ту же работу частично делает движок: Анализ кода внешних обработок 1С разбирает модуль лексером и парсером и показывает находки с подсветкой прямо по тексту. Слепых зон автора он не закрывает, но пятнадцать очевидных мест перед независимой проверкой снимает.
Другие наши инструменты для работы с кодом:
- Анализ кода внешних обработок - разбор чужого модуля с находками по тексту, первый проход перед тем, как звать живого проверяющего.
- ИИ-слой анализатора кода - движок находит место, модель объясняет и предлагает правку. Вторая пара глаз на тот же модуль, без автора.
- Выгрузка метаданных для LLM - отдать проверяющей модели структуру вашей конфигурации, чтобы находки шли по вашим типам, а не по выдуманному API.
- Матрица прав доступа для нейросети - что увидит в базе внешний инструмент, которого вы пускаете проверять. Смотреть до того, как пустили.
Вступайте в нашу телеграмм-группу Инфостарт