"Мы ничего не меняли, а оно стало тормозить." Эту фразу слышал каждый, кто сопровождает базу, и половина из нас произносила её сама.
Формально она правда. Конфигурацию не трогали, релиз не ставили, регламенты те же. И база при этом честно встала.
Ниже разбор одного такого случая: месяц поисков, десять секунд на развязку и виновник, которого никто не менял. Главное в нём - почему код, проживший годы без единой жалобы, вдруг становится виновником, и как найти такое место у себя.
Сразу про слово "профиль", дальше оно встречается часто. Профиль - это много снимков подряд того, чем процессор занят прямо сейчас: раз в несколько миллисекунд записывается, какая функция выполняется, потом всё это складывается в таблицу "функция и её доля времени". Ближайший знакомый аналог - "Замер производительности" в Конфигураторе, он делает то же самое, только по строкам кода и только внутри 1С.
Почему "ничего не меняли" - это чистая правда
Меняется не код. Меняются данные, и меняются они сами, без нашего участия.
У номенклатуры выросло число характеристик. У контрагента накопились договоры за три года. В табличную часть документа вместо десяти строк стало приходить восемьсот. Никто ничего не программировал, а алгоритм, который перебирает это в цикле, стоил копейки на сотне позиций и стал неприемлемым на десятках тысяч.
Обычно тут ждут, что время вырастет во столько же раз, во сколько выросли данные. Вот это ожидание и подводит.
- Линейно - данных вдвое больше, работы вдвое больше. Так ведёт себя почти всё, и это норма.
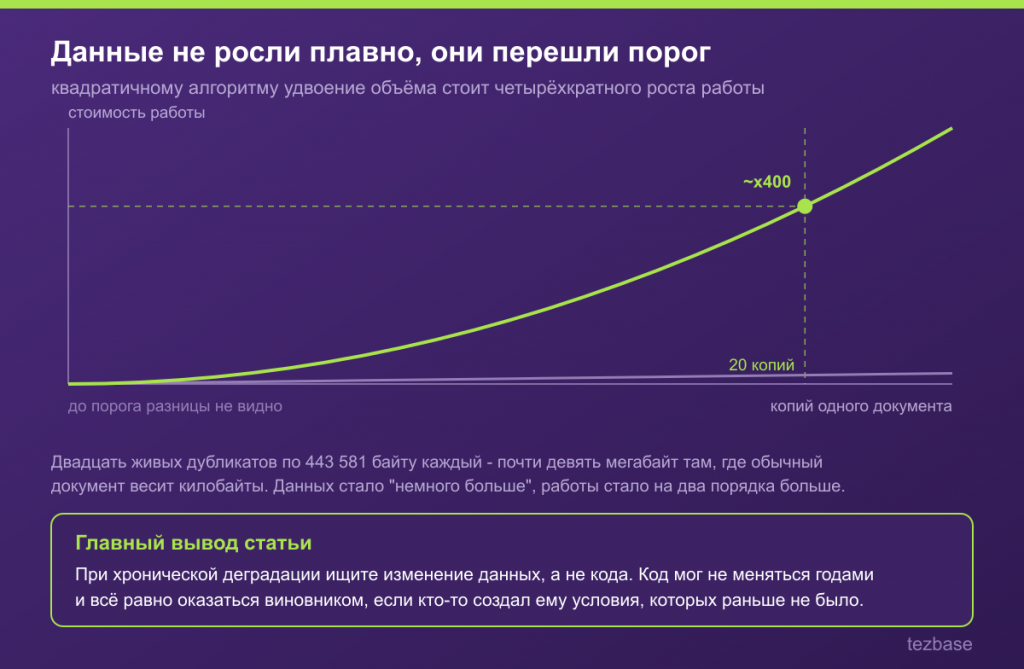
- Квадратично - данных вдвое больше, работы вчетверо. Втрое больше данных - в девять раз работы. В двадцать раз больше - в четыреста раз работы.
Узнаваемый пример квадратичного кода на встроенном языке - склейка строки в цикле:
Для Каждого Стр Из Таблица Цикл
    Текст = Текст + Стр.Наименование;   // новая строка целиком на каждой итерации
КонецЦикла;
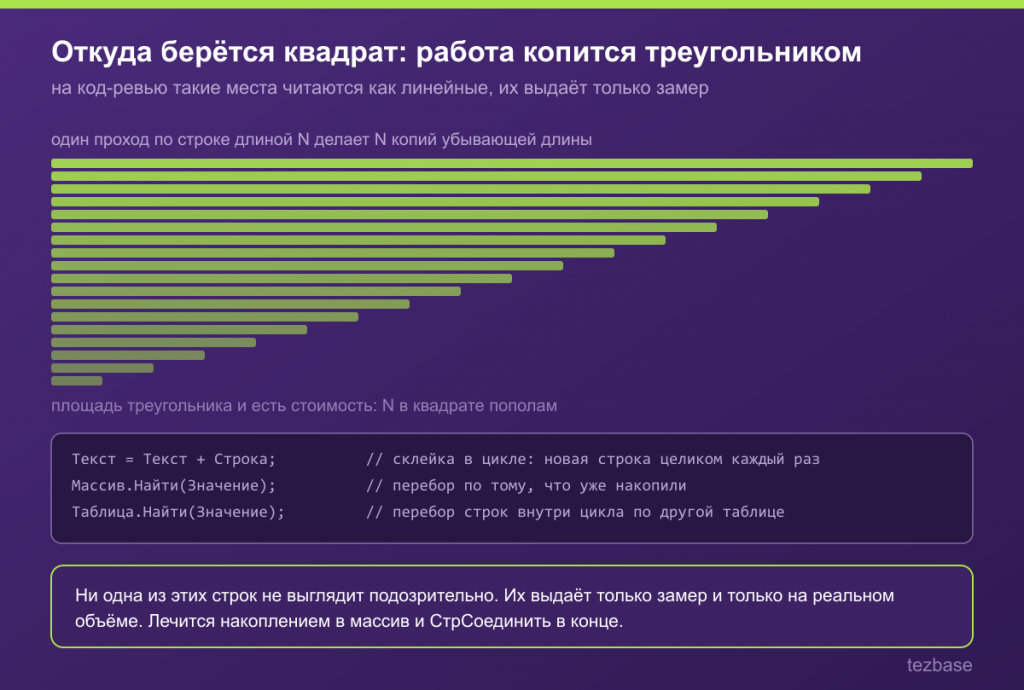
Каждая склейка копирует всё, что уже накоплено. Тысяча итераций стоит не тысячу операций, а около полумиллиона скопированных символов. На сотне строк этого не заметить, на сотне тысяч операция встаёт колом.
Отсюда и главная особенность такой поломки: плавной деградации у неё не бывает. До порога квадратичность не видна вообще, после порога система не справляется, промежуточного состояния почти нет. Поэтому жалоба и звучит как "неделю назад всё летало". Летало, да. Данные перешли порог.
Вывод, ради которого написана статья. При хронической деградации ищите изменение данных, а не изменение кода. Код мог не меняться годами и всё равно оказаться виновником, если кто-то создал ему условия, которых раньше не было.
Как проверить свою базу
Сначала три признака, по которым это узнаётся ещё до всякого замера.
- Жалоба привязана ко времени, а не к релизу. "Неделю назад летало" при том, что релиза не было и регламенты те же. Первым делом смотрим не историю правок, а что выросло в данных за тот же период.
- Время растёт быстрее объёма. Это подпись квадратичности, и видно её по двум замерам, без всякого профилировщика.
- Виновник не там, где смотрят. Типовые инструменты покажут тяжёлый запрос. Вопрос "почему он выполняется столько раз" задают заметно реже, а ответ обычно в нём: запрос внутри цикла по выросшей коллекции.
Что именно выросло, гадать не нужно. Карта объёмов базы 1С выводит топ объектов по числу записей и показывает табличные части отдельными строками - это и есть те коллекции, по которым кто-то ходит циклом. Снимать её стоит дважды с разрывом в месяц-другой: одно число не говорит ничего, два подряд показывают, что растёт быстрее остального.
Дальше замер на двух объёмах, главный инструмент во всей статье. Берём операцию, выполняем на двух разных количествах данных и делим одно время на другое. Число секунд само по себе не говорит ничего, работает только отношение. Вдвое данных и вдвое времени - линейно, живите спокойно. Вдвое и вчетверо - вы на квадратичной кривой.
Теперь честно про то, где на этом застревают. Звучит как "урежьте копию базы вдвое", а выкинуть половину документов, не порушив остатки и ссылочную целостность, само по себе задача на неделю с согласованием. Так вот, делать это не нужно.
- Режьте не базу, а ту коллекцию, по которой ходит подозреваемый цикл. Перебираются строки документа - хватит одного документа: проведите его на 400 строках и на 800, возьмите отношение. Ссылочная целостность тут не при чём вовсе.
- Две точки берутся и без урезания. Та же операция на тестовой базе и на боевой - это уже два объёма, надо лишь знать оба количества. Годится и одна база в разные месяцы, если время где-то записано.
- Малый масштаб работает. Отношение не требует боевых объёмов: 100 строк против 200 отвечают на вопрос так же, как 100 тысяч против 200 тысяч. Мерить только надо после прогрева, иначе второй прогон окажется быстрее из-за кэша.
Тем же отношением закрывается и вопрос "у меня уже проблема или ещё нет". Универсальной границы нет, она у каждого алгоритма своя, но свою вы получаете прямо здесь: больше двух при удвоении данных значит, что вы уже на кривой, и вопрос лишь в том, когда упрётесь.
Где квадратичность прячется в коде
Беда в том, что на код-ревью такие места читаются как линейные: второй цикл спрятан внутри вызванной функции, и глазами его не видно. Две конструкции, которые встречаются постоянно:
// 1. проверка "уже встречали?" перебором по тому, что уже накопили
Для Каждого Стр Из Заказы Цикл
    Если Обработанные.Найти(Стр.Код) = Неопределено Тогда
        Обработанные.Добавить(Стр.Код);
    КонецЕсли;
КонецЦикла;

// 2. перебор таблицы внутри цикла по другой таблице:
//    стоимость - произведение размеров двух таблиц
Для Каждого Стр Из Заказы Цикл
    Найденная = Остатки.Найти(Стр.Номенклатура, "Номенклатура");
КонецЦикла;
В первой Найти просматривает массив целиком, а массив растёт с каждой итерацией. Работа складывается треугольником: первый проход почти бесплатен, последний идёт по всему накопленному, сумма даёт тот самый квадрат. Лечится соответствием, где ключ и есть код.
Механически ловится только склейка в цикле, показанная выше: на неё у меня отдельное правило в Анализе кода внешних обработок 1С, находка приходит с номером строки. Обе конструкции из листинга не ловит ни одно правило, и обещать, что скоро будет, я не стану: вложенный перебор без вывода типов от невинного кода отличается плохо, а правило, которое врёт, хуже отсутствующего. И сколько итераций выйдет на ваших данных, статический анализ не скажет в любом случае.
Случай, который стоил месяца
Сразу про источник, чтобы потом не спотыкаться. Случай не мой. Его разбирал коллега, с которым мы работаем по другому проекту, а фактура тут - его записи по инциденту и снятый им профиль. Записи я читал целиком, все числа ниже оттуда. Своими руками я этот сервис не чинил и в конце честно перечислю, чего в этих записях не оказалось.
Корпоративная вики крупной розничной сети деградировала месяц: процессор под потолок, страницы открываются через раз, в логах чисто. Сервис не 1С, это Node.js на Linux, поэтому дальше речь про механизм, а не про команды.
Три объяснения закрыли замером, и каждое уложилось в строку, потому что с числом спорят только другим числом. База данных: попадание в кэш 99,96 %, на диск она почти не ходит. Распухшее служебное состояние совместного редактирования: максимальное 320 килобайт, открывается за 0,18 секунды. Однопроцессный режим: сервис действительно работал в один процесс.
На третьем и потеряли месяц, разберу его подробно. Один процесс не успевает обслуживать всех - объяснение выглядело исчерпывающим, и его пошли чинить. Сервис разнесли на несколько процессов. Страницы после этого отвечать стали, зависания прекратились, жалобы прекратились тоже. А загрузка процессора не сдвинулась ни на процент.
Вот здесь и надо было насторожиться. Вместо этого задачу закрыли формулировкой "внутренняя проблема приложения": где-то внутри что-то не так, вернёмся позже. Позже не наступило - жаловаться перестали, метрику никто не смотрел, и следующие недели сервис горел в тишине. Однопроцессный режим был усилителем: он объяснял, почему пользователь видит зависший сайт, и ничего не объяснял про занятый процессор.
Правило, которое я забрал из этой истории: симптом ушёл, а метрика осталась на месте - значит починили усилитель. Задача не закрыта, она только началась.
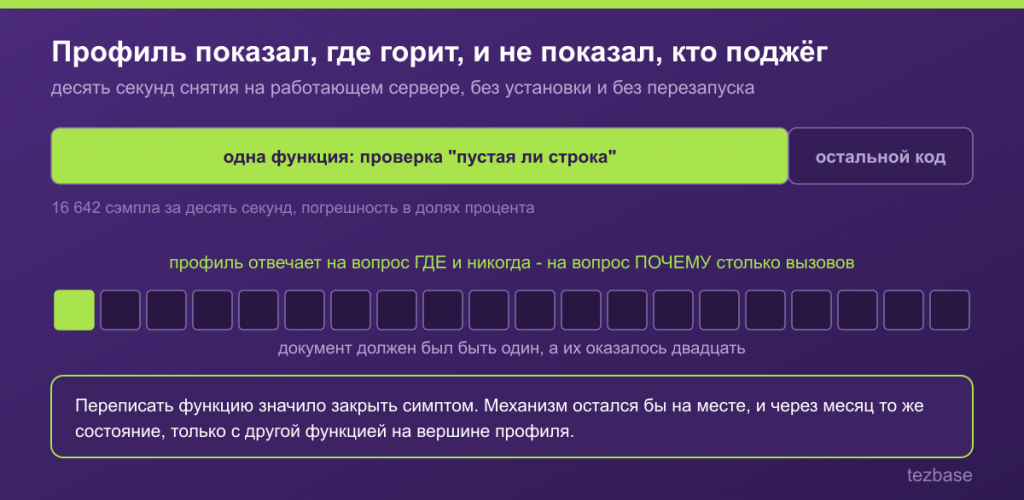
Развязка заняла десять секунд. С работающего сервера сняли профиль: 16 642 снимка, и в 80 случаях из ста сервер оказывался в одной и той же функции. На такой выборке погрешность - доли процента, это измерение, а не оценка. 80,0 % процессорного времени сидели в проверке "пустая ли строка" внутри кода, который собирает документ обратно в текст.
Функция оказалась ровно из того семейства, что разобрано выше: перед каждой записью в вывод она просматривала всё, что уже накопила. Выглядело это так:
// вызывается перед КАЖДОЙ записью в выходной буфер
/(^|\n)$/.test(this.out)
Если регулярные выражения не ваш язык, вот та же строка словами: "накопленный текст пуст или заканчивается переводом строки?" Проверка копеечная. Дорогой её делает то, что накопленный текст к концу большого документа - сотни килобайт, и просматривается он заново на каждую запись.
И тут развилка, на которой ломается половина расследований. Профиль назвал функцию, соблазн - переписать её и закрыть задачу. Но вопрос звучит иначе: почему её стали звать столько раз?
Ответ был в данных. Квадратичный алгоритм разогнали двадцать копий одного документа по 443 581 байту каждый - не помеченных на удаление, не архивных, полноценных, которые сервис обязан обрабатывать наравне с остальными. Почти девять мегабайт там, где обычный документ весит килобайты. Наплодил их собственный экспортёр сервиса, лежали копии в личной коллекции, куда никто не смотрит, и в отчёты не попадали. Объём вырос в двадцать раз, работа - примерно в четыреста.
Переписанная функция дала бы выигрыш в разы и оставила бы на месте механизм, который через месяц привёл бы к тому же, только с другой функцией на вершине. Профиль показал, где горит, и ничего не сказал о том, кто поджёг.
Как сняли профиль: четыре команды, если у вас есть Linux рядом
Дальше Linux и контейнеры. Если рядом с вашей 1С крутится такой сервис - обмен, публикация, интеграционная прослойка, хранилище вложений, - раздел ваш: четыре команды снимают профиль с живого процесса без установки и без перезапуска. Если такого сервиса нет, пропускайте, ваш способ описан выше и он не хуже.
# 1. найти горячий процесс на самой машине
ps -eo pid,pcpu,etimes,comm --sort=-pcpu | head

# 2. у процесса в контейнере два номера: снаружи один, внутри свой.
#    дальше нужен внутренний - это последнее число в строке
grep NSpid /proc/<PID>/status

# 3. послать процессу сигнал USR1. это НЕ остановка: kill только шлёт
#    сигналы, а USR1 у Node включает отладчик. перезапуска нет,
#    пользователи ничего не замечают
kill -USR1 <PID>
#    в логах контейнера появится: Debugger listening on ws://127.0.0.1:9229

# 4. снять профиль за десять секунд
docker exec <контейнер> node /tmp/prof.js
Скрипт четвёртого шага - три десятка строк на голом Node без зависимостей: Profiler.enable, Profiler.setSamplingInterval, Profiler.start, десять секунд сна, Profiler.stop, сложить счётчики попаданий по функциям. Отладчик после этого слушает порт до перезапуска процесса, и два процесса на один порт не повесить.
Одно отсюда переносится на 1С целиком: профиль снимается под той нагрузкой, которая создаёт проблему. Снятый на спокойной системе он покажет то, что вы и так знаете, и подтвердит любую вашу гипотезу. К "Замеру производительности" в Конфигураторе это относится ровно так же.
Чего в этой истории нет
Скажу прямо, чтобы не выдавать это за законченное расследование.
- Пары "до и после" нет. Есть измеренное "до" и доказанный диагноз. Что стало с загрузкой процессора после удаления дубликатов, в записях по инциденту не зафиксировано, и я не буду делать вид, что знаю.
- Граница не измерена. На каком объёме документа алгоритм становится проблемой, в записях нет. Свою границу вы посчитаете отношением, как описано выше, а универсальной цифры я не дам.
- Причина причины не найдена. Почему экспортёр создал двадцать копий, не разобрано. Пока это не выяснено, дубликаты могут появиться снова, и в следующий раз никто не свяжет одно с другим.
- Соседние коллекции не проверены. Если инструмент отработал так однажды, вопрос напрашивается сам, а ответа на него в записях нет.
Открытый вопрос
Виноват там оказался свой же инструмент, наплодивший копии в разделе, куда никто не смотрит. Как вы ловите такое у себя - есть ли практика сверять, что фактически лежит в базе, с тем, что показывают отчёты? Там сверки не было, и потому девять мегабайт дубликатов прожили незамеченными до дня, когда сервис перестал справляться.
Вступайте в нашу телеграмм-группу Инфостарт