База ERP, четыреста пользователей, сервер загружен, 1С подвисает. Доступа к SQL Server нет и не будет. Внешних обработок в справочнике несколько десятков, и какая именно строка виновата, угадать невозможно.
Оптимизировать можно бесконечно. Вопрос в том, с чего начать.
Центр управления производительностью эту задачу решает, но это платная лицензия и отдельная стройка. При этом платформа давно умеет рассказать о себе почти всё: механизм называется технологический журнал, он встроенный, бесплатный и включается одним файлом.
Что такое технологический журнал
Это подробный лог работы самого сервера 1С: каждое обращение к СУБД, каждая установка управляемой блокировки, каждый серверный вызов, каждое исключение.
Проще всего понять его через то, что вы уже знаете.
| Журнал регистрации | что делали пользователи: провёл документ, изменил справочник, вошёл в базу. Пишет прикладной уровень, читается из предприятия |
| Замер производительности в конфигураторе | сколько времени заняла каждая строка встроенного языка. Работает в одном сеансе и только под отладчиком |
| Технологический журнал | что делала платформа: обращения к СУБД, ожидания блокировок, серверные вызовы, исключения. Пишет сервер приложений, по всем сеансам сразу, без отладчика и без правки конфигурации |
То есть журнал регистрации отвечает на вопрос "кто это сделал", замер - "какая строка кода тормозит в моём сеансе", а технологический журнал - "что происходит на сервере прямо сейчас у всех четырёхсот человек". Для разбора зависаний нужен третий.
Включается он файлом logcfg.xml. Лежит файл в каталоге conf рядом с каталогом bin установленной платформы, например:
C:\Program Files\1cv8\8.3.17.1386\bin\conf\logcfg.xml
Платформа подхватывает файл примерно за минуту, перезапускать сервер не нужно. Чтобы журнал выключить, файл удаляют, и это тоже подхватывается на лету.
Прав администратора машины для этого обычно не требуется. Общий каталог C:\Program Files\1cv8\conf закрыт на запись всем, кроме администратора, а вот conf рядом с bin работающей версии службе 1С доступен. Если и он закрыт, вы это увидите сразу: файл не запишется.
Работает это и в клиент-серверном варианте, и в файловом: в файловом всё происходит на машине пользователя, и conf берётся от той версии платформы, которой запущено предприятие.
Пишет журнал в каталог, который вы укажете, раскладывая его так: подкаталог на каждый процесс кластера (rphost_1234, rmngr_5678, ragent_9012), внутри файл на каждый час с именем вида 26090411.log. Восемь цифр это год, месяц, день, час.
Как выглядит строка
Одно событие это одна строка (иногда несколько, если внутри многострочный контекст). Строение всегда одинаковое:
11:34.653004-793936992,CALL,1,process=rphost,p:processName=MY_BASE,
t:clientID=3154,Usr=Ivanov,Memory=23039860,MemoryPeak=41583567,CpuTime=19093750
Разбирается это так:
11:34.653004- минута, секунда и микросекунды внутри часа. Час знаете из имени файла;-793936992- длительность события в микросекундах. Здесь это 793 секунды, тринадцать минут;CALL- имя события;1- уровень события: глубина вложенности, по нему видно, что вызвано из чего;- дальше пары
имя=значениедо конца строки.
Две вещи, на которых спотыкаются все, кто читает журнал впервые. Длительность в микросекундах, поэтому 1 000 000 это одна секунда. И значения бывают набиты запятыми и кавычками: в свойстве Sql лежит текст запроса целиком, в Context - стек вызовов на несколько строк. Наивное деление строки по запятой на таких событиях врёт.
Какие события бывают и что каждое ловит
Полный список у 1С длинный. Ниже те одиннадцать, которые я видел своими глазами в журналах боевой ERP и тестовой базы, и которых хватает для диагностики.
Блокировки
TLOCK - установка управляемой блокировки, той самой, что ставится через БлокировкаДанных и живёт в менеджере блокировок 1С. Блокировки СУБД это другой механизм и в TLOCK они не попадают. Ключевое: длительность здесь это время ОЖИДАНИЯ блокировки, работа под ней сюда не входит. Внутри лежат Regions (какие пространства блокируются), Locks (что именно), WaitConnections (номера соединений, которых ждём) и Context. Это главное событие для вопроса "кто кого держит".
Приём чтения: круглая длительность вроде 20 или 30 секунд почти наверняка значит, что сеанс дождался отказа по таймауту, доступа он так и не получил.
TTIMEOUT - таймаут ожидания управляемой блокировки истёк. Это уже отказ в работе, пользователь получил ошибку.
TDEADLOCK - взаимоблокировка на управляемых блокировках. Два сеанса ждут друг друга, платформа снимает одного.
Данные
DBMSSQL - обращение к СУБД. В Sql лежит текст запроса целиком, вместе с параметрами, в Rows - сколько строк вернулось, в RowsAffected - сколько изменено, в Context - откуда позвали. Основное событие для тяжёлых запросов.
SDBL - обращение к модели базы данных 1С, до трансляции в SQL. Здесь видно, что попросил встроенный язык: чтение объекта по ссылке, запись набора записей, выполнение запроса. Одна операция обычно даёт и SDBL, и DBMSSQL, поэтому их длительности не складывают.
Практическая польза: если SDBL долгий, а DBMSSQL под ним быстрый, дело не в СУБД. Значит время ушло в саму платформу, и смотреть надо на объектную модель, а не на индексы.
Вызовы
CALL - серверный вызов. Свойство Usr здесь и в остальных событиях содержит имя пользователя информационной базы, а у фоновых и регламентных заданий там служебное имя вроде DefUser. Различать это важно: живой человек и регламентное задание лечатся по-разному. Здесь живут Memory и MemoryPeak (байты рабочего процесса), CpuTime, InBytes и OutBytes (сколько данных прошло между клиентом и сервером), callWait (время ожидания в очереди).
Два разных диагноза из одного события. Большой MemoryPeak означает вызов, который жрёт память рабочего процесса, а процесс общий на все сеансы: упёршись в лимит кластера, он перезапустится вместе с чужими людьми. Большой callWait означает нехватку рабочих процессов, и это про настройку кластера, к скорости кода отношения не имеет.
Context - отдельное событие, хотя такое же слово есть и среди свойств. Платформа пишет им текущий контекст исполнения. Разбирая свой первый журнал, я долго не мог понять, откуда в своде взялось событие с таким именем, и решил, что у меня ошибка разбора. Ошибки не было.
Ошибки
EXCP - исключение. В Descr текст, в Exception класс. Тут есть подвох, о котором ниже отдельно: большая часть этих событий к вашей конфигурации отношения не имеет.
EXCPCNTX - контекст, в котором произошло исключение. Ценнее самого EXCP: даёт стек вызовов и запрос, на котором всё сломалось.
QERR - ошибка выполнения запроса. В Query лежит сам запрос на языке 1С. Ловит опечатки в тексте запроса и обращения к несуществующим полям, которые в коде живут годами и всплывают только на редкой ветке.
Соединения
CONN - установка и разрыв соединения с сервером. Длительность здесь означает время жизни соединения, поэтому мерить ей производительность бессмысленно.
SESN - работа сеанса.
Эти два самые объёмные и самые бесполезные для разбора конкретной проблемы. По моему замеру CONN дал 931 событие при 35 022 всего, и ни одно из них ничего не объяснило. Включать их стоит только под конкретный вопрос про соединения.
Рабочий logcfg.xml, с которого стоит начинать
Блокировки и ошибки пишем целиком, они редкие. Тяжёлое пишем от ста миллисекунд. Журнал храним час.
<?xml version="1.0" encoding="UTF-8"?>
<config xmlns="http://v8.1c.ru/v8/tech-log">
    <log location="C:\logs\tezh" history="1">
        <event><eq property="name" value="TLOCK"/></event>
        <event><eq property="name" value="TTIMEOUT"/></event>
        <event><eq property="name" value="TDEADLOCK"/></event>
        <event><eq property="name" value="EXCP"/></event>
        <event><eq property="name" value="QERR"/></event>
        <event>
            <eq property="name" value="DBMSSQL"/>
            <ge property="duration" value="100000"/>
        </event>
        <event>
            <eq property="name" value="SDBL"/>
            <ge property="duration" value="100000"/>
        </event>
        <property name="all"/>
    </log>
</config>
Три вещи, которые тут стоит знать. duration задаётся в микросекундах, поэтому сто миллисекунд это 100000. history задаётся в часах, и платформа сама удаляет каталоги старше. <property name="all"/> означает "пиши все свойства события": без этой строки в файле окажутся одни имена событий без начинки.
Сколько это стоит работающей базе
Главный страх при слове "включить журнал на проде" - что станет хуже. На боевой ERP в рабочее время ни одной жалобы от пользователей не было.
Дорого обходится диск: 4 мегабайта в минуту при полном наборе событий без порогов на тестовой базе, где никто не работал, без малого 6 гигабайт в сутки. Рычага два.
Порог. Подавляющее большинство обращений к СУБД быстрые, и порог в сто миллисекунд срезает объём радикально. Плата честная: тысяча запросов по пятьдесят миллисекунд грузит базу сильнее одного долгого, а с порогом вы их не увидите.
Время хранения. history="1" хранит последний час, для разбора инцидента хватает. Одно неочевидное: чистит платформа только внутри текущего каталога. Включаете журнал раз за разом в новые папки - старые не убирает никто, у меня за день проб набралось 1,1 гигабайта в двенадцати каталогах.
Три ловушки, о которых редко пишут
Каждая тихая: ничего не падает, отчёт получается красивый и неверный.
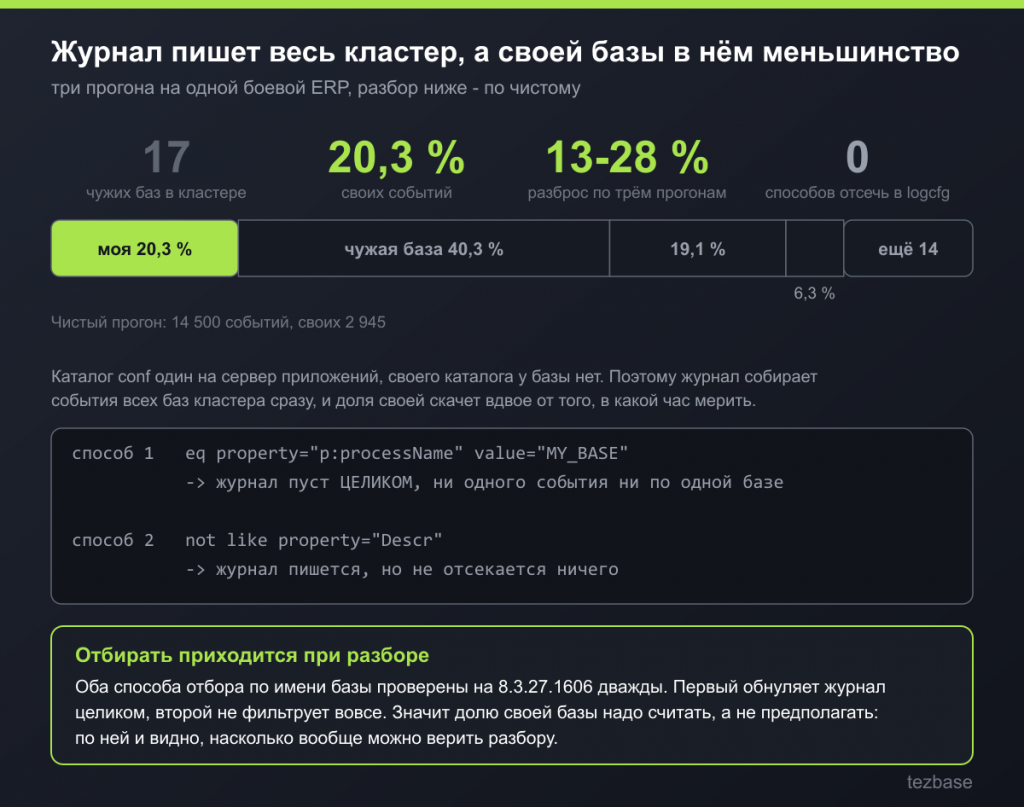
Журнал пишет весь кластер, а не вашу базу
Каталог conf один на сервер приложений, поэтому журнал собирает события всех баз кластера сразу.
Три прогона на одной боевой ERP: 13,2 % событий моей базы из 23 198, 28,4 % из 73 672 и 20,3 % из 14 500. От 70 до 87 процентов журнала это чужая работа, и доля скачет больше чем вдвое от прогона к прогону.
Отбирать свою базу приходится при разборе, по свойству p:processName (слово process сбивает, там лежит имя информационной базы). Фильтр в самом logcfg.xml, строка <eq property="p:processName" value="MY_BASE"/>, у меня дважды на 8.3.27.1606 обнулял журнал целиком. Если у вас он работает, покажите конфиг в комментариях, прогоню и допишу.
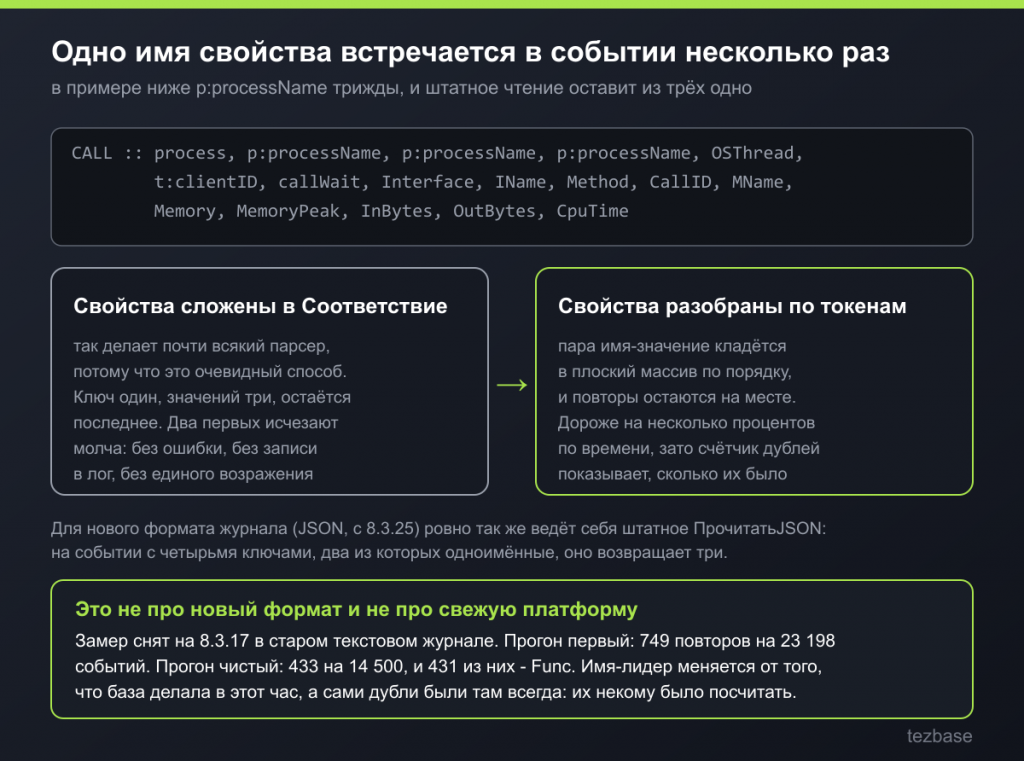
Одно имя свойства встречается в событии несколько раз
На 14 500 событиях боевой ERP нашлось 433 повтора имён свойств внутри одного события.
CALL :: process, p:processName, p:processName, p:processName, OSThread,
        t:clientID, callWait, Interface, IName, Method, CallID, MName,
        Memory, MemoryPeak, InBytes, OutBytes, CpuTime
Три p:processName подряд в одном событии, форма из соседнего прогона того же журнала. Разбор, который складывает свойства в Соответствие (так делает почти всякий инструмент), оставит последнее значение и потеряет предыдущие, молча и без ошибки.
Живой журнал наивным чтением не читается вообще
Чтение = Новый ЧтениеТекста(ПолноеИмя, КодировкаТекста.UTF8);
Ошибка совместного доступа, ноль прочитанных строк. Пятый параметр конструктора, МонопольныйРежим, по умолчанию Истина, а платформа держит файлы текущего часа открытыми на запись.
Чтение = Новый ЧтениеТекста(ПолноеИмя, КодировкаТекста.UTF8, , , Ложь);
Пока журнал выключен, всё работает и без этого. Тот же параметр нужен для любого лога, который кто-то пишет прямо сейчас.
Что даёт один прогон
На событиях своей базы за один прогон:
- 30 015 998 микросекунд ожидания управляемой блокировки на регистре сведений. Тридцать секунд ровно: сеанс дождался отказа по таймауту;
- один
TTIMEOUTв подтверждение; - 278 030 992 микросекунды на один запрос к СУБД. Четыре с половиной минуты, один общий модуль, конкретная строка;
- максимум по
SDBLиCALLоколо 1 432 секунд. Двадцать четыре минуты в одном серверном вызове; - 3 972 мегабайта пика памяти рабочего процесса в одном вызове;
- один и тот же регистр сведений блокировался 317 раз за прогон.
В мониторинге не видна ни одна из шести: он показывает среднее, а тут единичные события. И ни одну нельзя было угадать, глядя на код.
Нейросеть нашла ошибку в моём же отчёте
Побочный эффект, которого я не ждал: вместе с разбором базы модель вернула замечание к самому инструменту. В своде рядом с "Суммарно, мкс" стояла колонка "Доля", и модель написала, что раздел несогласован: у TLOCK суммарная длительность 61 801 276 микросекунд, наименьшая в таблице, а доля 72,5 процента, наибольшая.
Формально ошибки не было, "Доля" считала число событий, но модель прочитала её как долю времени, как прочитал бы и человек. Колонок стало две, доля событий и доля времени. У человека спросить "понятна ли эта таблица" дорого, у модели бесплатно.
Что с этим делать дальше
Читать журнал глазами невозможно, за час набегают сотни мегабайт. Раньше это означало либо ЦУП, либо свой парсер, теперь есть третий путь: сводка журнала укладывается в несколько килобайт, и нейросеть за минуту расставляет проблемы по приоритету, называет модуль и строку и говорит, чем это подтверждается.
Условие одно: файл должен быть markdown и объяснять сам себя, что длительности в микросекундах и что у TLOCK это ожидание, иначе вместо разбора инженера придут общие слова.
Все числа этой статьи сняты отдельной обработкой: Разбор технологического журнала. Она включает и выключает журнал, читает его, считает потери и складывает сводку в markdown для нейросети, без внешних компонент.
Другие наши инструменты:
- Чек-ап СУБД под 1С - в каких условиях база работает: настройки сервера, память, файлы данных.
- Трансформатор SQL в 1С - переводит
_Document123из тяжёлогоDBMSSQLобратно в имена справочников и регистров. - Оптимизатор временных таблиц - где в пакетном запросе не хватает индекса и где лишний проход по временной таблице.
- Анализ кода внешних обработок 1С - что делает с базой обработка, всплывшая в контексте тяжёлого события.
Вступайте в нашу телеграмм-группу Инфостарт