


В прошлой части я рассказывал про день, когда нейронка за полтора часа связала систему биллинга нашего сервиса аренды с бухгалтерской базой. Я тогда решил, что нашёл рецепт: дай что читать, дай где проверить, дай чем дотянуться до конфигурации — и получишь результат.
Рецепт я понёс команде. Но он не завёлся.
«А у меня оно считает с обеда»
Сначала всё выглядело нормально. Я рассказал, что делал, расписал порядок настройки, ответил на вопросы. Ребята пошли пробовать — благо желающих после того случая было хоть отбавляй, писали даже те, кто раньше над нейронками откровенно посмеивался.
А дальше в чате пошло вот такое:
— Слушай, а у меня оно считает с обеда. Это нормально?
— У меня вообще не стартует, ругается и падает.
— Работает, но пока дождёшься — уже сам всё сделаешь.
Задачи у ребят были не сложнее моей. Инструменты те же самые, модель та же самая, постановка та же самая. Но не работает. Основная причина стала понятна в первую же секунду, когда у коллеги расчётное время индексации показало несколько дней. Компьютер без видеокарты просто не мог её посчитать за обозримое время, и никакие формулировки этого не меняли.
Один из ребят тогда же в чате обронил: «Да у меня комп старше, чем мой стаж в 1С».
Про наши машины
У нас маленькая франчайзи-компания, сорок человек. Машины у сотрудников очень разные. У кого-то мощный компьютер с кучей памяти и хорошей видеокартой — обычно у тех, кто в свободное время играет. А у кого-то старичок с бородой, купленный шестнадцать лет назад за бесценок.
И до сих пор это никого не волновало, потому что для нашей работы хватало с запасом. Разработчик подключается к нашим серверам и работает там: конфигуратор, база, всё тяжёлое крутится на сервере. Его собственная машина, по большому счёту, показывает картинку. На такой работе шестнадцатилетний компьютер живёт прекрасно, я сам видел.
А вот для работы с нейронкой дома — уже нет. И вот тут выяснилось, почему.
Куда именно упирается железо
Сейчас будет самая важная часть статьи, и она про одно понятие. Если вы уже знаете, что такое индексация конфигурации, — пропустите пару абзацев. Если нет — оно того стоит, потому что дальше всё крутится вокруг него.
Чтобы нейронка могла спросить конфигурацию, а не гадать о ней (ровно то, к чему я пришёл в прошлой части), нужен поиск по смыслу. Не по имени процедуры и не по совпадению букв, а по смыслу: я спрашиваю «где считается себестоимость» и получаю нужные модули, даже если слова «себестоимость» там нет вообще ни разу.
Работает это так. Конфигурацию нужно один раз прочитать целиком и разложить по кусочкам: модуль, процедура, описание объекта, реквизит. Каждый кусочек прогоняется через отдельную небольшую модель, и она выдаёт для него набор чисел — своего рода отпечаток смысла. Похожие по смыслу кусочки дают похожие отпечатки. После этого поиск превращается в сравнение чисел: берём отпечаток вопроса, ищем ближайшие к нему отпечатки кусочков — и получаем ответ по смыслу, а не по буквам.
Вот эта разовая работа — прочитать всё и посчитать отпечатки — и называется индексацией.
Сколько таких кусочков в конфигурации? Десятки тысяч, а на больших конфигурациях — сотни тысяч. И для каждого нужно посчитать отпечаток. Арифметика там несложная, но её очень много, и она однотипная. А это ровно та работа, для которой придумана видеокарта: она считает такие вещи не по одному, а пачками. Обычный процессор считает их по чуть-чуть, зато умеет много другого — чего здесь как раз не требуется.
Вот в это и упёрлись все, у кого «считает с обеда».
Замер: одна машина, два прогона
Чтобы не спорить на пальцах, я сделал замер сам. Одна и та же машина, два прогона: один раз с видеокартой, один раз без неё.
Свод взял один и тот же: справку разработчика по платформе — синтакс-помощник, конструкции встроенного языка и язык запросов. Это 26 035 записей. Один и тот же набор, одна и та же модель отпечатков, разница только в том, чем считать.
На процессоре (Intel Core i9-11900KF, восемь ядер) — устойчиво 2,4 записи в секунду. Весь свод считается примерно три часа.
На видеокарте (GeForce RTX 3080 Ti) — 128 записей в секунду. Тот же свод — три с половиной минуты.
Три часа против трёх с половиной минут. Причём справка — это ещё маленький свод, он вообще не про размер конфигурации.
Большая 1С:ЕРП — величина совсем другого порядка. У меня на видеокарте она считается часа полтора-два. Сколько бы она считалась на процессоре, я до конца не гонял: из тех же чисел получается несколько суток, а занимать машину на несколько суток ради красивой цифры в статью мне было жалко. Так что вот эта оценка — арифметика, а не замер, и я её так и подаю.

Один и тот же набор из 26 035 записей справки разработчика. Слева — процессор, 2,4 записи в секунду, около трёх часов. Справа — видеокарта, 128 записей в секунду, три с половиной минуты. Внизу — основная машина нашего серверного парка: 64 ядра на частоте 4 гигагерца и 768 гигабайт оперативной памяти, а видеокарты нет ни одной.
«Ну так поднимите всё на сервере»
Это первое, что приходит в голову, и мы, конечно, начали именно с этого. У нас же есть сервера, хорошие. Пусть считает там, а люди подключаются.
Не получилось, и причин было три.
Первая: там боевая среда. На этих серверах, кроме нашей собственной разработки, живёт сервис аренды 1С — то есть клиенты, которые прямо сейчас в своих базах работают. Ставить туда сырую экспериментальную обвязку, которая в тот момент падала через раз, — идея так себе. Мы её даже не обсуждали всерьёз.
Вторая: сеть. Чтобы разработчик из дома дотянулся до такой службы на сервере, нужен защищённый канал внутрь. В боевой среде это не «поднял за вечер»: это отдельная работа, где надо думать про доступы, разграничение и последствия. У нас такое с наскока не делается, и я считаю, что правильно: лишняя дверь внутрь боевого контура обойдётся дороже любого выигрыша в скорости.
Третья, и самая обидная: видеокарт на серверах нет. Ни на одной машине. Парк собирался под 1С — а ей видеокарта не нужна, ей нужны ядра, память и быстрые диски. Вот этого там с запасом: основная машина нашего парка — 64 ядра на частоте 4 гигагерца и 768 гигабайт оперативной памяти. Машина сильная, и парк собран именно на таких.
И вот тут меня, признаться, накрыло. Сильная серверная машина, на которой держится вся наша работа, на этой задаче проигрывает домашнему компьютеру, собранному ради игр. Не потому, что он плохой, — а потому, что нужного узла в нём просто нет. Никакое количество ядер это не заменяет: они считают по очереди то, что видеокарта считает пачкой.
Что мы сделали
Решение оказалось до обидного простым: мы отделили дорогую работу от дешёвой.
Индексация — работа разовая. Посчитали отпечатки один раз, и дальше они просто лежат. А сам поиск по готовому индексу — работа копеечная: сравнить отпечаток вопроса с готовыми. Это доли секунды, и это работает вообще на любой машине, включая тот самый шестнадцатилетний компьютер.
То есть видеокарта нужна не «для работы с нейронкой». Она нужна ровно на одном шаге, который делается один раз.
Дальше понятно. Ребята доработали нашу сборку: она научилась передавать готовые слепки проиндексированных конфигураций от одного разработчика к другому. Кто-то один разворачивает базу клиента, индексирует у себя на машине с видеокартой и по одной кнопке отдаёт готовый слепок коллегам. Разворот из слепка — минуты вместо часов, и видеокарта на той стороне уже не нужна.
Второе наблюдение, которое сделало это по-настоящему удобным. У большинства наших клиентов базы типовые с доработками, и объём доработок по отношению к объёму самой конфигурации — три-пять процентов, редко десять. А значит, когда слепок по базе уже есть, после очередной доработки не надо пересчитывать всё заново: доиндексируется только то, что изменилось. Это уже минуты и на слабой машине.
Оговорюсь честно, чтобы не было недопонимания. Всё это работает у нас внутри команды и только по нашим же клиентским базам — тем, которые мы сами ведём и за которые сами отвечаем. Это наша внутренняя кухня, а не рецепт «возьмите готовое и разверните». Кто и на каких условиях имеет дело с конкретной базой — вопрос не технический, и решать его каждому за себя.
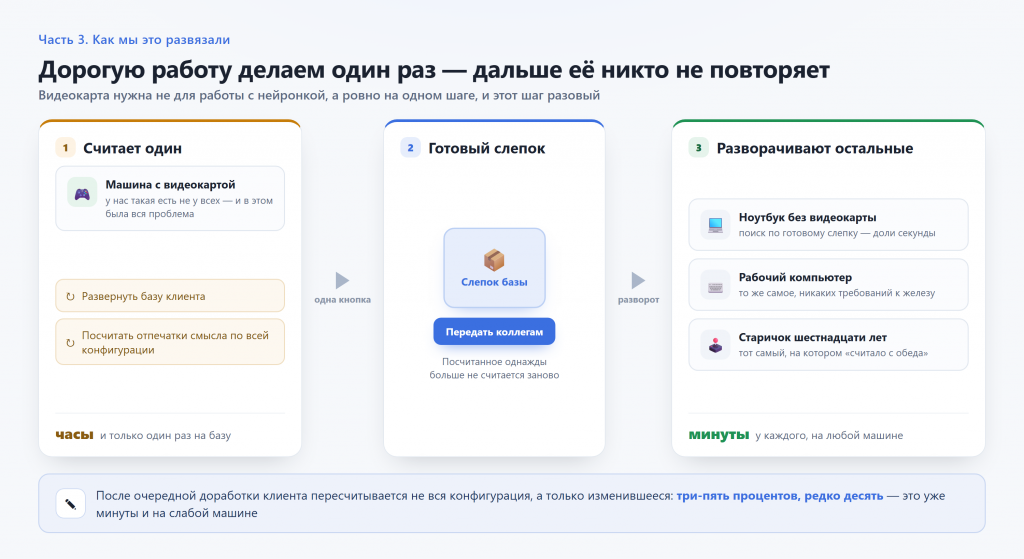
Дорогая работа делается один раз на машине с видеокартой. Дальше по команде расходится готовый слепок, и разворот у каждого занимает минуты на любом железе. После доработок пересчитывается не вся конфигурация, а только изменившиеся три-пять процентов.
Теперь главное: что я из этого понял
Вывод оказался шире, чем история про видеокарты, и он мне до сих пор кажется самым полезным из всего, что я тогда вынес.
Приём, который работает у одного человека, не становится приёмом команды, пока не решён вопрос: где это считается и кто за это платит.
Мой день с биллингом был личным достижением. Я честно думал, что дело в том, как я поставил задачу и что подключил. А половина условий у меня оказалась не заслугой, а случайностью: просто машина подходящая. Как только тот же самый приём поехал к десяти людям, случайность немедленно вылезла наружу.
И вот на этом, по моим наблюдениям, ломается большинство попыток завести нейронку в команде, а не в одиночку. У одного получилось — все воодушевились — раздали инструкции — не пошло — решили, что «нейронки не для 1С». А там не про нейронки вообще, там про то, где считается индекс.
Отдельно скажу про то, что мы путали сами и что путают почти все, с кем я об этом разговаривал. В работе нейронки с конфигурацией есть три совершенно разные нагрузки, и их валят в одну:
- Разовая и тяжёлая — посчитать индекс. Упирается в видеокарту, считается часами, делается один раз на базу.
- Постоянная и лёгкая — искать по готовому индексу. Доли секунды, любая машина.
- Внешняя — работа самой нейронки, которая отвечает на вопросы. Это уже не про ваше железо, а про плату за обращения и про то, куда уходят ваши данные.
Ошибка — считать, что раз железо нужно для первого, то оно нужно и для второго. Пока мы этого не разделили, вопрос звучал как «купить всем видеокарты или забыть про это». А после разделения он стал звучать так: «где считаем и как передаём результат остальным».
И вопрос, который стоит задать раньше всех прочих, если собираетесь звать в это дело команду: есть ли у вас хоть одна машина, на которой это посчитается за обозримое время? Если нет — это не приговор. Это значит, что расчёт надо выносить куда-то ещё, и решить это надо до того, как звать людей, а не после того, как у них не завелось.
Чем такое делают
Единственно правильного ответа тут нет, и мой вариант точно не единственный. Что вообще бывает.
Своя машина с видеокартой. Самое простое, самое быстрое и самое дешёвое, если такая машина уже есть. Ограничение: считает один человек и только пока его компьютер включён. Для одиночки это идеально, для команды — то, с чего начались наши проблемы.
Отдельная машина под расчёт. Одна на команду, с видеокартой, стоит в офисе, к ней подключаются. Дороже, но сразу общая, и никто ни у кого не спрашивает «а ты не выключил?». Мы к этому в итоге и склонялись, просто слепки закрыли вопрос раньше.
Аренда видеокарты по часам. Посчитал в облаке — забрал результат — выключил. Платите за часы, своего железа не надо вообще. Но тут надо очень внимательно смотреть, что именно вы туда отправляете: код клиентской базы уезжает на чужие мощности, и это вопрос не технический, а договорной. У нас, например, по части клиентов такое просто не согласовать.
Внешние службы, которые считают отпечатки за деньги. Тогда своё железо не нужно совсем, платите за объём. Оговорка ровно та же, и она тут даже острее: наружу уезжает не разовая задача, а весь свод целиком.
Инструменты, которым индексация не нужна вовсе. Такие тоже есть — они не разбирают конфигурацию заранее, а берут нужное на лету, по ходу разговора. Платят за это глубиной: без предварительного разбора часть связей просто не видна. Зато и требований к железу никаких — 1С:Напарник, например, никакой видеокарты от вас не потребует, и для большинства это первый разумный шаг.
Что выбрать — зависит от того, сколько у вас баз, насколько они большие и что вам вообще можно выносить наружу по договору с клиентом. Честного сравнения всех со всеми я не делал: у нас условия задали два ограничения — боевая среда и клиентские данные, — и после них вариантов осталось не так много.
Сколько это заняло у меня
Поиск причины — нисколько. Что на процессоре это будет считаться долго, было понятно ещё до первых прогонов: работы много, и она однотипная. А когда у человека расчётное время индексации показало несколько дней, вопрос «почему» отпал сам собой. Время ушло не на поиски, а на замер, который переводит «долго» в конкретные цифры, и на решение, что с этим делать.
Сама доработка — передача слепков — заняла у ребят несколько дней.
Разворот из слепка у коллеги — минуты вместо часов на собственную индексацию. Это уже не оценка, это то, что мы видим каждый раз.
Если бы я мог отмотать назад, я изменил бы ровно одну вещь: начинал бы разговор с командой не с рецепта, а с вопроса про железо — у кого какая машина. Тогда половины сообщений в чате просто не было бы, а замер лёг бы на стол до раздачи инструкций, а не после.
Чего я не измерял
Кратность на большой конфигурации. Замер по справке платформы честный, я за него отвечаю. А вот перенос на 1С:ЕРП я посчитал арифметикой и до конца не проверял. Может оказаться, что там всё ещё хуже: чем длиннее кусочки текста, тем тяжелее каждый отпечаток.
Разные видеокарты между собой. У меня NVIDIA GeForce RTX 3080 Ti, других я не пробовал. Где начинается «хватает» и где кончается — не знаю. Вполне возможно, что вдвое более скромной хватило бы за глаза.
Серверные видеокарты. Их у нас нет, руками я их не щупал, и что-либо про них говорить не буду.
Стоимость облачного варианта. Мы его отмели по клиентским данным, а не по деньгам, так что такой цифры у меня тоже нет.
Другой масштаб команды. Нас сорок человек, разработчиков заметно меньше. Как это устроено там, где разработчиков сотня и десяток офисов, я не знаю. Подозреваю, что слепками по кнопке там уже не обойтись.
Что было дальше
Железо перестало быть проблемой. Индекс считался один раз, слепки расходились по команде, у всех наконец стало работать одинаково.
И качество ответов тут же встало в потолок.
Дальше начались улучшения. Каждое выглядело настолько очевидным и правильным, что мы даже не сомневались. Три из них я разберу подробно — потому что два сделали хуже, а одно чуть не съело само себя. И заметили мы это только тогда, когда начали делать замеры.
Но об этом — в следующий раз.
Если вы попали сюда с середины: первая часть — про то, почему нейронка выдумывает несуществующие процедуры, а вторая — про день, когда всё получилось с первого захода.
Вопрос к вам: если у вас работает поиск по смыслу по конфигурации — где вы его считаете? Мне особенно интересны случаи, когда обошлись вообще без видеокарты и остались довольны результатом. Напишите в комментариях: если такое возможно, значит мой вывод про железо слишком категоричен, и мне хотелось бы об этом знать.
Вступайте в нашу телеграмм-группу Инфостарт