Эволюция разработки на 1С в Т-Банке
Я расскажу про систему Sage Observability и о том, почему мониторинги при разработке на 1С превратились из инструмента nice-to-have в must-have на нашем примере.
Пару слов о себе. Занимаюсь 1С с 2006 года – уже 20 лет. Основные компетенции – автоматизация на базе «1С:Зарплата и управление персоналом» и «1С:Бухгалтерия предприятия»: внедрение, поддержка, интеграция и миграция.
В октябре 2020 года я пришел в Т-Банк как разработчик. Сейчас руковожу группой разработки 1С Platform, отвечаю за развитие экосистемы 1С и стабильность критичных HR- и финансовых процессов.
Эволюцию 1С в Т-Банке мы начали с инженерной базы: перевели разработку на Git, отказались от хранилища конфигураций и Jenkins, провели импортозамещение, перешли на GitLab CI, формализовали релизный цикл и внедрили практики DevOps.
Важно: наша команда пока не перешла на EDT, хотя отдельные попытки предпринимаются. Большинство разработчиков остаются на конфигураторе и файлах. Но даже на таком стеке мы получили все преимущества Git Flow.
Git сразу открыл нам доступ к инфраструктуре качества. Мы подключили линтер и статический анализ кода SonarQube, проверки EDT и АПК. Важно отметить, что все три проверки работают одновременно, поскольку они отлично дополняют друг друга.
Ввели обязательные Code Review вторым разработчиком и approve перед слиянием в master. Внедрили культуру тестирования, начали системно писать тесты в YAxUnit и Vanessa Automation, запускать их в контейнерах. Результаты выгружаются в Allure, а релизы автоматически блокируются при критических ошибках.
Мы проверили масштабируемость: сгенерировали большой объем синтетических данных, в несколько раз превышающий реальные объемы, провели нагрузочное тестирование интеграций и ключевых операций, сделали прицельный рефакторинг узких мест.
В результате сейчас мы имеем предсказуемые релизы, прозрачное качество и готовность к росту без радикального рефакторинга.
Этапы развития 1С
Возникает вопрос: что делать дальше, куда развивать 1С прежде всего в техническом плане? На наш взгляд, направлений несколько.
Первое – наращивать скорость Delivery, чтобы пользователь получал ценность как можно быстрее.
Второе – архитектурная эволюция. Мы движемся к модульности внутри 1С, автономности доработок, чтобы их можно было легко отчуждать и переносить между проектами.
Третье – платформизация. У нас постепенно шаблонизируются репозитории и пайплайны, вводятся единая naming-конвенция и общие библиотеки, готовится качественная документация как для пользователей, так и для разработчиков, налаживаются процессы.
Четвертое – observability, то есть надежность и наблюдаемость. Формируются SLA на услуги, предоставляемые 1С-сервисами, отлаживаются мониторинг и алертинг, минимизируется шум, внедряется практика эффективного реагирования. Именно об этом я расскажу подробнее.
Зачем нужен многоуровневый мониторинг
Когда у вас одна, две или три базы, все просто и понятно. Их легко мониторить, легко реагировать на сбои, устранять проблемы, находить виновников и пострадавших.
Но когда у вас десятки баз на разных конфигурациях, разных релизах и разных серверах, разные пользователи и команды поддержки, контролировать состояние такого обширного парка систем становится нетривиальной задачей.
Здесь уже нужен системный мониторинг и алертинг, чтобы мы узнавали о проблемах и сбоях на сервисах раньше, чем об этом нам сообщит пользователь и начнет эскалировать проблему.
Ключевая задача заключается в том, чтобы проактивно выявлять и купировать инциденты. Желательно, чтобы не пользователь обращался к нам в канал поддержки, а мы сами приходили к пользователю и узнавали, что у него происходит.
В наших условиях необходимо выстроить многоуровневое наблюдение.
Первый слой – мониторинг производительности на аппаратном уровне: CPU, RAM, ввод-вывод, сеть, состояние дисков, ошибки и события операционной системы.
Второй слой – кластер 1С и СУБД. Он достаточно легко мониторится через RAS/RAC. Мы смотрим состояние лицензий и рабочих процессов, очереди, длительные и зависшие запросы, блокировки и ожидания на блокировках, ошибки журнала регистрации, события технологического журнала, редкие падения, перезапуски и аварийные завершения.
К этим слоям мы добавили две новые категории.
Первая – мониторинг услуг. У нас есть SLA по ключевым операциям, выстроенные вокруг ожиданий пользователей, чтобы фактические объем и качество услуги соответствовали нашим договоренностям.
Вторая – мониторинг интеграций. Это SLA по обменам, когда между системами заключается соглашение о том, какой объем данных за какой период наш сервис может передать, чтобы, с одной стороны, не захлебнуться, а с другой – не затронуть процессы другой системы.
Мониторинг интеграций 1С
Когда у вас несколько баз, мониторить интеграции просто. Но когда баз становится несколько десятков, в каждой работает более 50 интеграций, есть десятки зависимых систем и разные релизы, мониторинг интеграций выходит на первый план.
Ошибки в интеграциях часто приводят к масштабным сбоям и проблемам, причины которых приходится выяснять очень долго. Поэтому интеграционный мониторинг у нас находится в числе главных приоритетов.
По каждой интеграции мы контролируем длительность загрузки и выгрузки, а также расписание – выполняется ли обмен в принципе, не было ли сбито расписание в результате ручных действий или программных доработок.
Как это работает в масштабе? У нас есть готовые шаблоны кода для встраивания мониторинга и алертинга, а также автоматическая разметка интеграций по тегам. Мы сразу видим базу, систему, с которой она интегрируется, критичность, контакты владельца и команды.
Таким образом, команды эксплуатации и специалисты SRE могут быстро находить виновников и пострадавшие системы.
Кроме того, у нас есть предиктивные уведомления: система сигнализирует не о факте нарушения, а о риске нарушения, когда мы приближаемся к верхней границе. Это так называемые warning.
В результате при запуске каждой новой интеграции заключается SLA с системой, а сама интеграция ставится на мониторинг.
Бизнес-мониторинг на примере 1С:ЗУП
Как это часто бывает, к изменениям нас подтолкнули серьезные сбои. Однажды выплата зарплаты прошла только последним или предпоследним рейсом – около десяти часов вечера. Обычно выплата проходит в районе обеда третьего и семнадцатого числа месяца.
Тогда произошла череда сбоев в обменах между системами. 1С тоже захлебнулась и начала неприятно подвисать. Появились жалобы сотрудников и эскалации: почему выплата не прошла вовремя?
Для нас как для банка это не только риск нарушения закона из-за несвоевременно выплаченной зарплаты, но и репутационные риски. Конечно, очень хотелось бы, чтобы 1С оправдывала свое название и выполняла операции за одну секунду, но так получается не всегда.
После этого все наши основные конфигурации – ЗУП и бухгалтерию – мы условно разделили на бизнес-услуги. У каждой услуги есть свой владелец, критичность, SLA и метрики качества.
Пользователь ожидает, что система будет соблюдать эти SLA и выполнять определенные операции за установленное время. В первую очередь это касается операций, сбой или значительная деградация которых влечет финансовые и репутационные риски: несвоевременную выплату заработной платы и налогов, штрафы за несданную вовремя отчетность и другие подобные последствия.
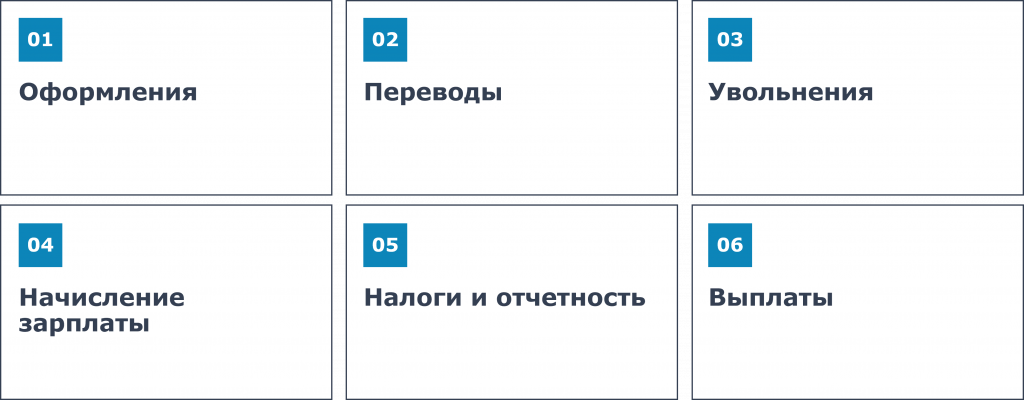
На примере ЗУП это время оформления сотрудника – от момента принятия оффера до заведения в систему. Нам нужно завести физическое лицо, оформить прием, отправить все это в ЭДО, подписать документы и передать сведения в СФР.
Сюда же относятся переводы – как внутри одного юридического лица, так и между юридическими лицами; увольнение, при котором нужно подготовить комплект документов, отправить его сотруднику и провести выплаты; начисление зарплаты, когда необходимо подготовить все данные табельного учета, ввести отклонения, заполнить документ начисления зарплаты и провести его; налоги, отчетность, прежде всего по НДФЛ, и выплаты.
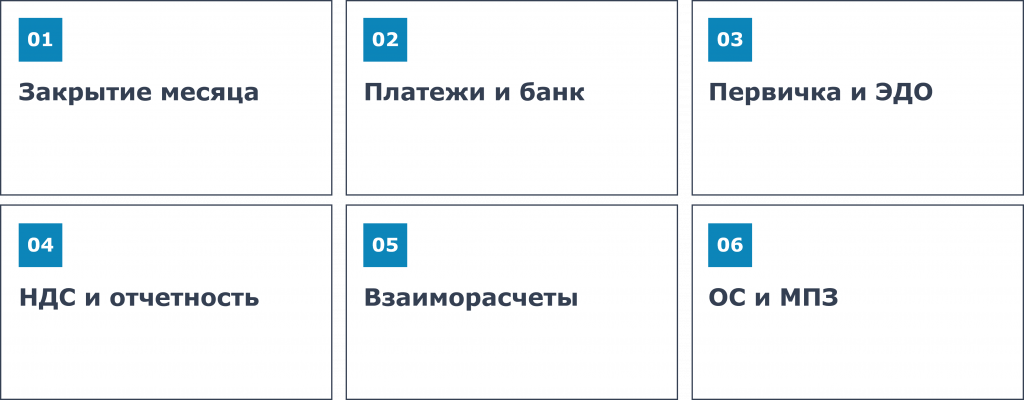
Для бухгалтерии тоже можно выстроить SLA вокруг типовых операций. Прежде всего это наиболее сложное закрытие месяца, а также операции по разнесению платежей, внесению первичных документов и электронному документообороту, все, что связано с НДС и отчетностью, акты сверки взаиморасчетов, оформление основных средств и материально-производственных запасов.
Пример бизнес-метрики
Рассмотрим эту практику на примере. Допустим, мы заключили соглашение о времени выполнения определенной операции. Например, гарантируем, что закрытие месяца будет выполняться за пять минут.
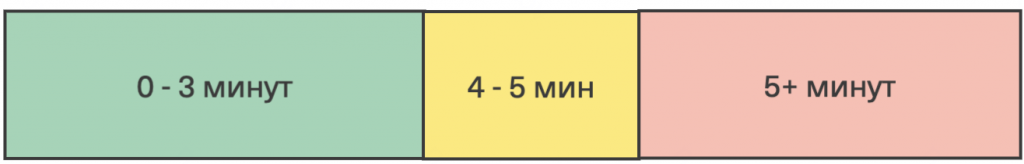
В режиме реального времени мы хотим видеть, как система справляется с нагрузкой, – в формате светофора. Если операция выполняется от нуля до трех минут, все в порядке. Если она занимает четыре-пять минут, появляется warning – предиктивное уведомление. Мы хотим, чтобы в этот момент наш дежурный получил оповещение.
Если операция выполняется дольше пяти минут, возникает alert, фиксирующий нарушение SLA, и автоматически создается инцидент.
Дальше за определенный период мы можем отслеживать метрики надежности: общий uptime сервиса, количество запусков и их распределение по зонам – сколько запусков было в зеленой, желтой и красной зонах.
За месяц можно рассчитать бюджет ошибок – допустимую долю запусков, которые вышли за пределы SLA.
Почему мы выбрали Sage Observability
Возник вопрос: какой инструмент использовать, чтобы закрыть все эти потребности?
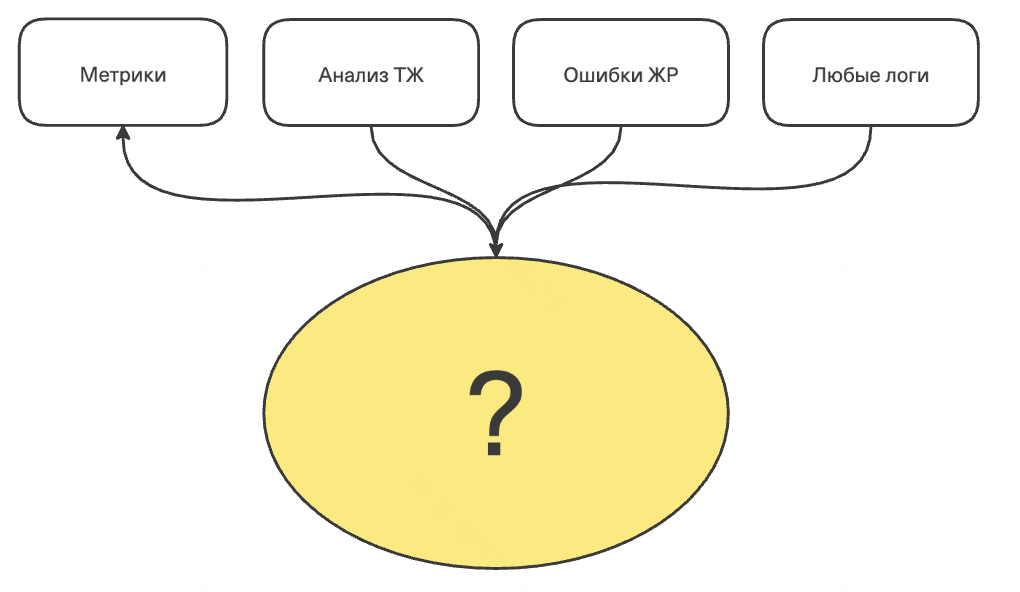
Хотелось, чтобы мониторинг 1С жил отдельно от самой 1С, чтобы она не мониторила сама себя, а этим занимался сторонний сервис. Хотелось реализовать это не средствами 1С, не зависеть от новых продуктов и лицензий. При этом инструмент должен быть легким, удобным и быстрым. Самое главное – в нем должна быть ролевая модель. И, как сейчас принято, хотелось получить AI-помощников, которые позволят анализировать инциденты и находить паттерны проблем.
Мы обратили внимание, что системы не на стеке 1С используют Sage Observability. Изначально этот инструмент был создан для нужд Т-Банка и эксплуатировался внутри, но сейчас он доступен всем желающим.
Sage Observability – это платформа наблюдаемости и непрерывной аналитики операционных данных. Если мониторинг отвечает на вопрос, что произошло, то платформа наблюдаемости позволяет понять, почему это произошло.
Она дает возможность в режиме реального времени собирать телеметрию инфраструктуры, приложений и сервисов и рассматривать эти данные во взаимосвязи. Sage помогает анализировать пользовательский опыт, предсказывать потенциальные сбои, видеть их первые симптомы и быстро понимать первопричину.
В результате данные остаются не просто цифрами, а становятся инструментом для моментального принятия решений.
Sage позволяет собирать в одном месте три типа данных: логи, метрики и трейсы. Это дает единое окно наблюдаемости – от инфраструктурных событий до действий пользователей.
Данные хранятся в собственном хранилище HDB, которое примерно в 12 раз эффективнее Elasticsearch. Быстрый и удобный поиск реализован через язык запросов MQL, позволяющий мгновенно находить нужные события и аналитические срезы.
У Sage есть собственная система визуализации, а также интеграция с Grafana.
Можно объединять данные и видеть все события системы за определенный период, чтобы быстро выяснить причину сбоя, предсказывать возможные сбои и предупреждать о риске нарушения SLA.
Анализ логов и метрик помогает быстро находить причины инцидентов. Есть возможность обогащать данные. Она полезна в тех случаях, когда в логи и метрики выгружаются идентификаторы, но в итоговом выводе требуется человекочитаемое описание. Для этого можно использовать справочники и настраивать маппинг.
Также есть трейсинг, который позволяет анализировать путь запросов в распределенных системах.
Как Sage работает на стороне 1С
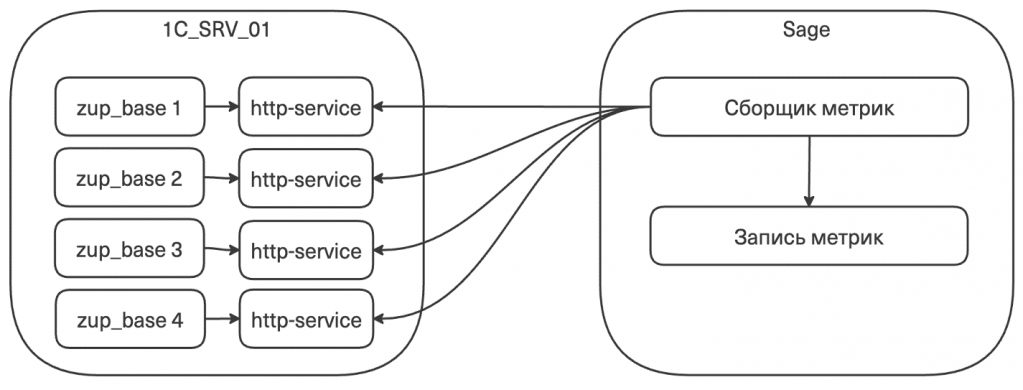
На стороне 1С все устроено достаточно просто. В каждую базу через расширение встраивается и публикуется HTTP-сервис, из которого сборщик метрик – скрейпер – получает метрики в формате OpenMetrics.
Это формат, в котором передаются название метрики и ее значение. В фигурных скобках можно указывать дополнительные параметры и в дальнейшем использовать их при поиске.
На стороне Sage мы настраиваем, с какой периодичностью скрейпер обращается к сервису и собирает метрики, например один раз в минуту. Sage снимает состояние и записывает его в свою базу данных.
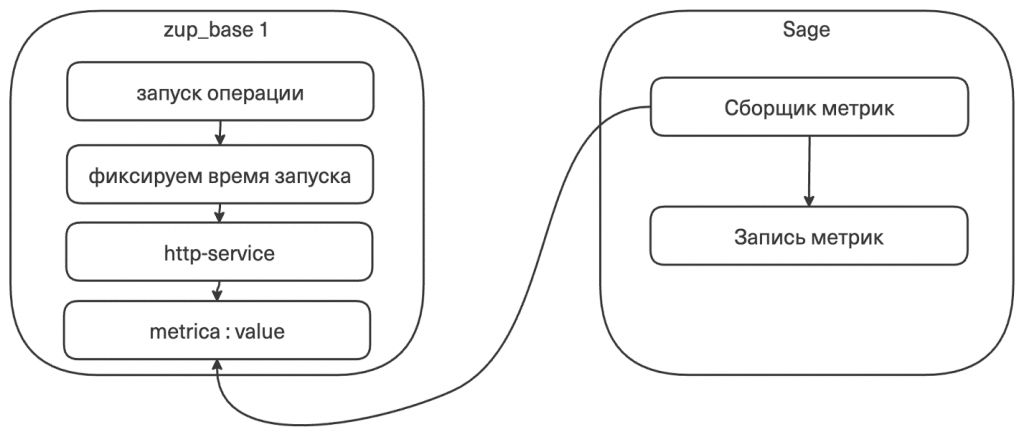
Здесь важно отметить, что в каждой конфигурации 1С в Библиотеке стандартных подсистем есть подсистема «Оценка производительности». Она тоже измеряет длительность ключевых операций и рассчитывает показатель APDEX.
Возникает вопрос: почему мы стали использовать собственное решение? Главное отличие заключается в логике замеров. Встроенная подсистема фиксирует только успешно завершенные операции. Если в процессе произошла ошибка, замер просто не попадает в статистику. В результате реальный пользовательский опыт не учитывается.
Мы пошли немного другим путем. В момент запуска операции – например, обмена между системами или действия пользователя – в служебный регистр добавляется запись о времени старта. Sage через определенные интервалы обращается к сервису и отсчитывает, сколько времени эта операция выполняется в реальном времени.
Если в процессе произошла ошибка, запись остается. Благодаря этому мы видим, как сначала приближаемся к индикаторам нарушения SLA, а затем выходим за его пределы.
Если операция завершается успешно, запись удаляется и метрика обнуляется. Так мы получаем более честную картину пользовательского опыта: видим не только то, что завершилось успешно, но и то, где система действительно споткнулась.
Как срабатывают предупреждения и алерты
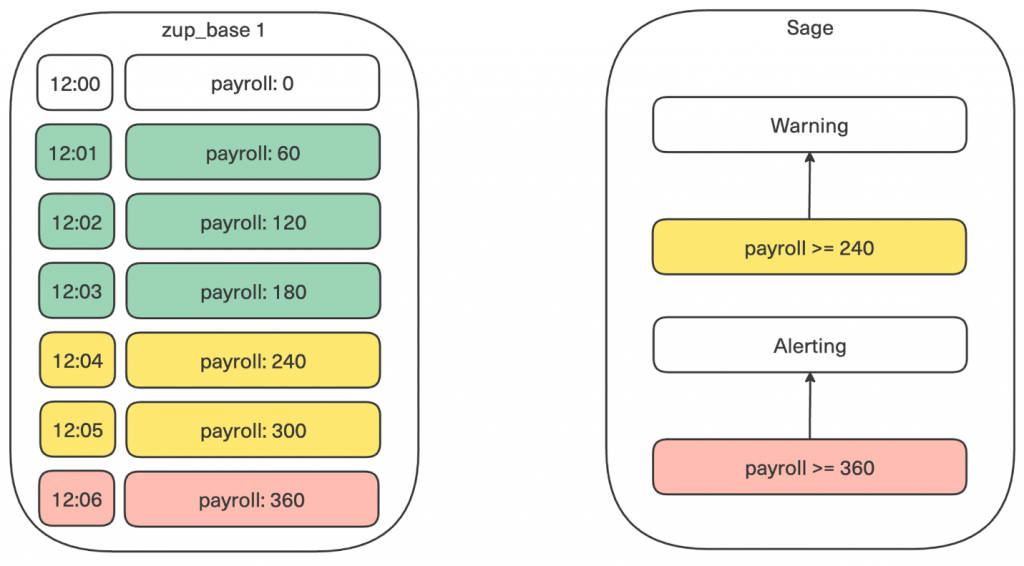
Представим абстрактную ситуацию. Мы настроили метрику на время начисления зарплаты. С шестой минуты хотим видеть уведомление о нарушении SLA, а с четвертой – предупреждение о том, что нарушение еще не произошло, но мы уже к нему приближаемся.
Например, Sage обращается к нашему HTTP-сервису в 12:00 и видит, что метрика равна нулю. В 12:01 он видит, что с момента запуска прошло 60 секунд. Пока мы укладываемся в SLA и все хорошо. Такая же картина сохраняется в 12:02 и 12:03.
В 12:04 Sage видит, что значение метрики достигло 240 секунд, и срабатывает правило предупреждения. В этот момент дежурному сотруднику может прийти оповещение в мессенджер.
В 12:06 значение метрики достигает 360 секунд и загорается индикатор alert. Это означает, что мы вышли за время, о котором договаривались. Так будет продолжаться до тех пор, пока операция не завершится и метрика не вернется к нулевому значению.
Log collector
Sage выступает для нас единым местом хранения логов и метрик.
Туда мы выгружаем ошибки журнала регистрации. Отдельное фоновое задание обращается к базе, выбирает события с типом «Ошибка» и выгружает их в Sage.
Также у нас настроен сбор логов технологического журнала с помощью Vector. Эти данные тоже отправляются в Sage.
Дальше мы можем выполнять поиск и на основе поисковых запросов настраивать алерты. Условием может быть как определенный паттерн, так и общее количество ошибок за указанный период.
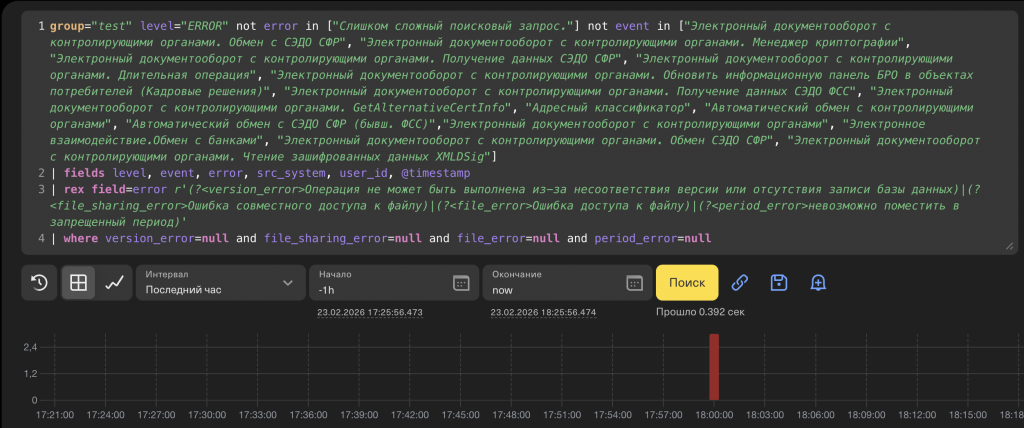
Например, с помощью регулярных выражений мы убираем шум, который создает типовая конфигурация. Его можно исключить из фильтра и оставить только те ошибки, которые не относятся к типовому функционалу.
Затем на основе поискового запроса настраивается alert. Он использует этот запрос и при выполнении заданных условий отправляет уведомления.
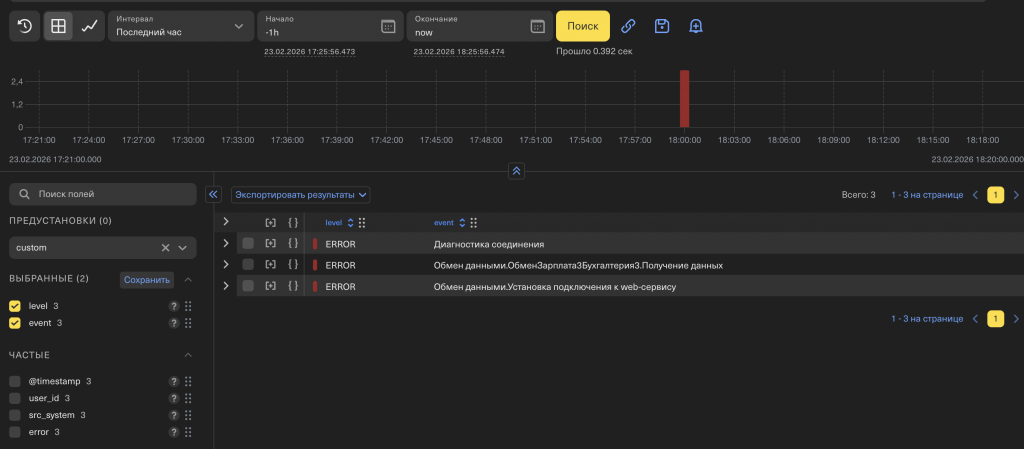
В одну из таких выборок, например, попало несколько событий, связанных с обменом.
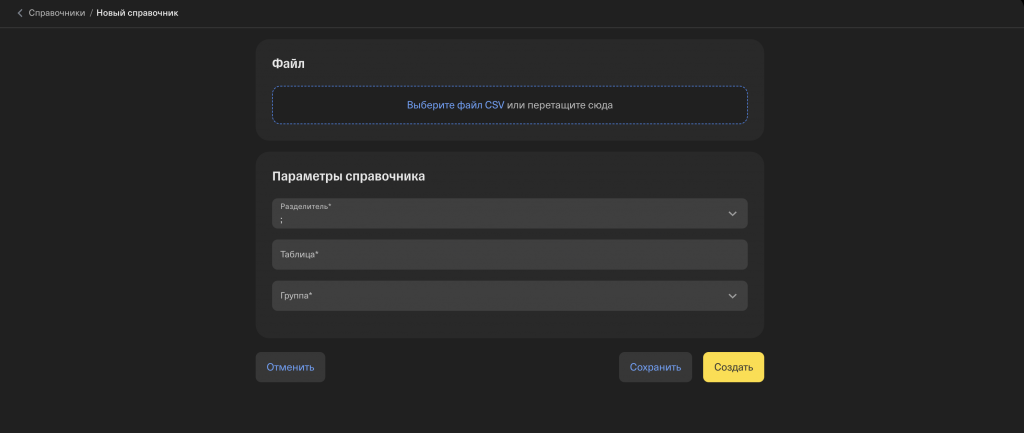
Если мы выгружаем в логи или метрики идентификаторы, анализировать их не всегда удобно. Хочется видеть понятные описания.
Например, мы выгружаем только ID пользователя, а хотим видеть его имя. Для этого можно загрузить справочник через Excel, настроить маппинг по идентификатору и выводить результат в понятном человеку виде. Это также помогает значительно сократить объем хранимых данных.
Трейсинг, Grafana и поиск аномалий
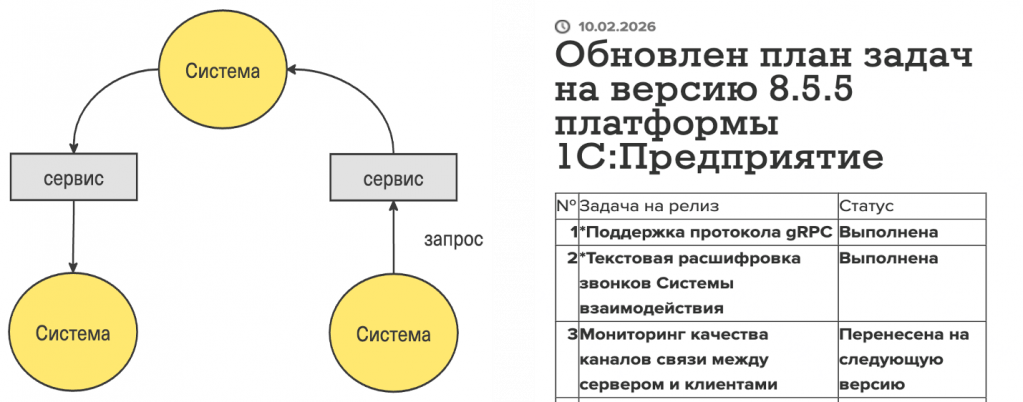
Трейсы показывают жизненный цикл запроса, проходящего через несколько систем и сервисов. Мы можем отслеживать его состояние при переходе из одной системы в другую.
Загрузка трейсов осуществляется с помощью gRPC. Поддержку gRPC нам обещают в версии 8.5.5. Тогда мы сможем подробнее попробовать этот механизм и рассказать о нем что-то интересное.
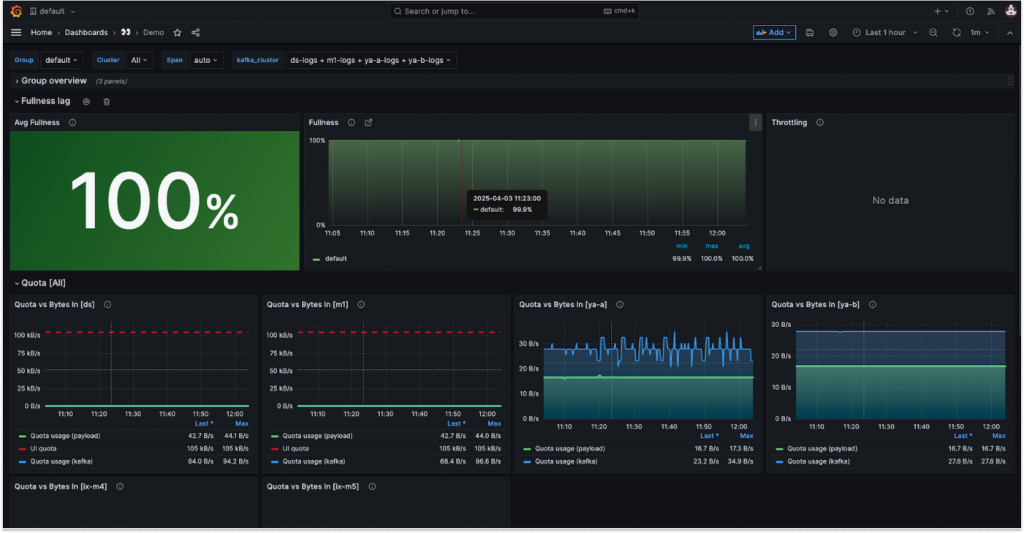
Наряду со встроенной визуализацией есть выгрузка данных в Grafana для мониторинга и анализа логов и метрик, если этот интерфейс более привычен.
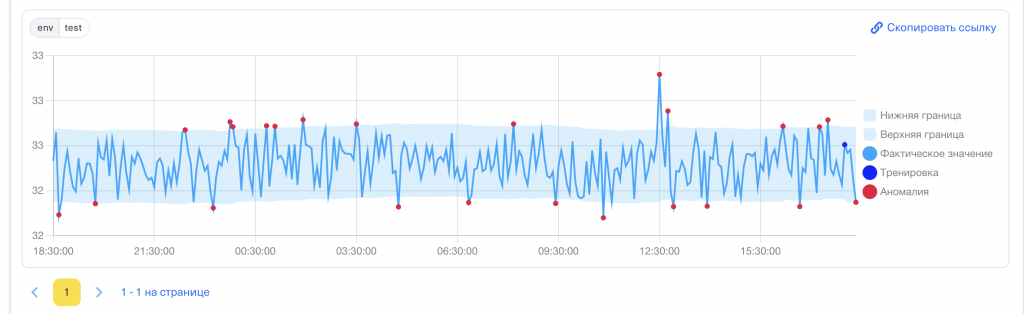
Также есть AI-инструмент Anomaly Analyzer, который позволяет настраивать алерты для наших сервисов. Это инструмент поиска аномалий во временных рядах.
Временной ряд в нашем случае – значение определенной метрики в конкретный момент. Инструмент анализирует значения метрики с учетом сезонности. Для нас сезонность – это, например, время внутри дня. На основе этих данных он строит прогноз для метрики на некоторый период вперед.
Если метрика достигает странных значений и выходит из прогнозируемого интервала, инструмент определяет это как аномалию и сообщает нам.
Что дала нам интеграция с Sage
Что мы как 1С-специалисты получили после перехода на Sage?
Прежде всего, единое место хранения логов и метрик. Нам больше не нужны костыли или кустарные сборки Elasticsearch.
Мы получили быстрый поиск и алертинг: можем быстро находить ошибки и настраивать любое количество алертов на события.
У нас появились бизнес-метрики. Мы можем мониторить интеграции и ключевые бизнес-операции, критичные для пользователей.
Интеграция с 1С получилась достаточно простой: через расширение ее можно спокойно добавить в любую конфигурацию.
Теперь мы не только пишем тесты для новых функций, но и сразу ставим эти функции на мониторинг – конечно, если они выполняются достаточно долго.
Первое время после внедрения у нас было очень много шума и алертов. Постепенно мы отрегулировали уровень шума и пришли к модели, в которой мониторинг и наблюдаемость работают в связке, а система сама сигнализирует о проблемах.
Это дает нам прозрачность процессов, предсказуемые сроки и снижение операционных рисков. Проще говоря, у нас стало меньше авралов, больше управляемости и уверенности в результате.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт