«Вспомнить все» - создание персональной поисковой системы
Файлы
ВНИМАНИЕ: Файлы из Базы знаний - это исходный код разработки. Это примеры решения задач, шаблоны, заготовки, "строительные материалы" для учетной системы. Файлы ориентированы на специалистов 1С, которые могут разобраться в коде и оптимизировать программу для запуска в базе данных. Гарантии работоспособности нет. Возврата нет. Технической поддержки нет.
Подписка PRO — скачивайте любые файлы со скидкой до 85% из Базы знаний
Оформите подписку на компанию для решения рабочих задач
Оформить подписку и скачать решение со скидкойВы можете заказать платную доработку или адаптацию этой разработки под вашу конфигурацию на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.
Проблема = Мотивация
- началось как проект «личной автоматизации» по причине не однозначного общения с БИТРИКС24.
Ситуации:
- ТОЧНО ПОМНЮ ! ... месяцев 5-8 назад делал задачу. В задаче Описание проблемы, метаданных, методики, алгоритм, история исправленных ошибок. Поиск по всем возможным вариантам — результата не дает . Начинается повторное «изобретение» решения
- режим работы с «онлайн» БИТРИКС уведомлениями — отвлекает. Отвлекаться на каждую задачу — чат = потеря концентрации. Цель — раз в несколько часов — смотреть сводки.
- как найти и связать нескольких задач, если пользователи их не связали и не помнят как они называются ?
Рабочая Информационная среда — Файлы (офис, текст md), NextCloud заметки файлы, Битрикс = оперативка. Сценарий работы с задачей:
- получили Проблему - битрикс/почта
- изучение методик — Nextcloud / файлы
- описание сценариев решения Nextcloud / файлы
- описание метаданных и их взаимосвязи - Nextcloud / файлы
- Вопросы для контроля, тестовый пример - Nextcloud / файлы
- …
- ТЗ в «читаемом» виде (самому себе) - Nextcloud / файлы
- В лучшем сценарии — финальный «красиво оформленный» результат исследования — копируется в описание или чат задачи БИТРИКС24 /
Реальность. «Исследование» может быть прервано на любом этапе, по множеству причин … и в оперативный контур битрикс, писать нечего. Как связать «то,что есть» (всякие черновики в файлах, NC) и оперативные данные контура БИТРИКС24?
Получается ситуация : вся информация есть, но единой картины нет. Встроенные ИИ-помощники «видят» только свой кусочек данных и «очень ограничено». (Например — попробуйте спросить БИТРИКС — о связи задач ). и не знают контекста из других систем.
Ниже — как развивался проект. Постараюсь без глубоких технических деталей, простыми словами.
Этапы развития
Этап 1. Сначала просто собрал всё в одну кучу
Первым делом — выгрузка данных из Битрикс24 (задачи, комментарии, групповые чаты) в единую базу данных. Плюс сразу же прикрутил полнотекстовый поиск по всему массиву.
Идея была простой: прежде чем что-то «умное» строить, надо, чтобы данные хотя бы лежали в одном месте и по ним можно было быстро искать по словам.
Этап 2. Добавил новые источники
Последовательно добавили:
-
Почту (IMAP) — письма стали полноценным источником.
-
Файлы и вложения — документы из задач и чатов, с извлечением текста.
-
NextCloud — заметки как источник данных.
-
Битрикс База знаний 2.0
-
Файловое хранилище.
Теперь в одном месте были задачи, чаты, письма, заметки и документы. Разные по природе, но собранные вместе.
Этап 3. Навел порядок — добавил теги
Когда данные стали разнородными, встал вопрос: как отделить важное от шума? Основной источник шума — БИТРИКС с его служебными сообщениями «задача просрочена», расшифровка разговора, ответы пользователей «да», «нет», «ОК», «принял» … всякие бессмысленные обсуждения
Появились теги — автоматическая классификация записей:
|
аналитика |
|
|
|
|
|
бухгалтерия |
|
|
заказы-доставка |
|
|
ит-поддержка |
|
|
клиенты |
|
|
маркировка |
|
|
|
|
|
методики |
|
|
|
«1С УТ», «1С — УПП», «1С — ERP», «1С — Обмены» ... |
|
|
... |
-
«прочее» — всё, что не попало ни в одну категорию.
Теги позволили не просто искать, а искать осмысленно: отсекать мусор типа «ок» и «принял», поднимать важное.
Описание тэгов — живой процесс. Раз в день регламент присылает 10 «самых» крупных сообщений с тэгом «прочее» на разбор.
Этап 4. Перестроил систему: из базы — в «вики»
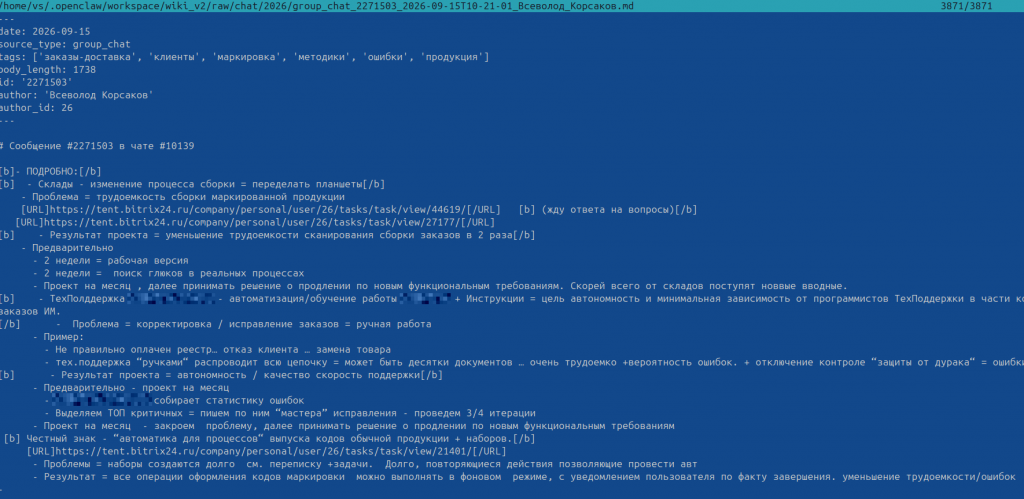
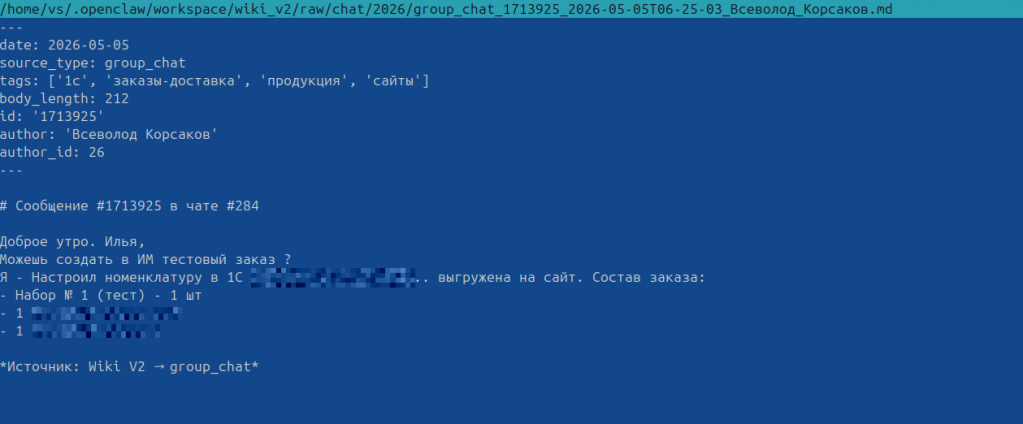
Следующий шаг — превратить сырые данные в структурированную базу знаний. Данные из PostgreSQL выгрузились в файлы-заметки (Markdown), сгруппированные по годам, с метаданными в начале каждого файла. Получилась своего рода «WIKI RAW» — библиотека записей, которую можно перестраивать, чинить и дополнять независимо от источника.
Это важный архитектурный сдвиг: сырые данные отдельно, готовые к поиску заметки отдельно. Можно пере собрать вики из сырых данных, не трогая саму базу и не обращаясь повторно к источникам.
пример "сырых" файлов
Этап 5. Связал статьи между собой.
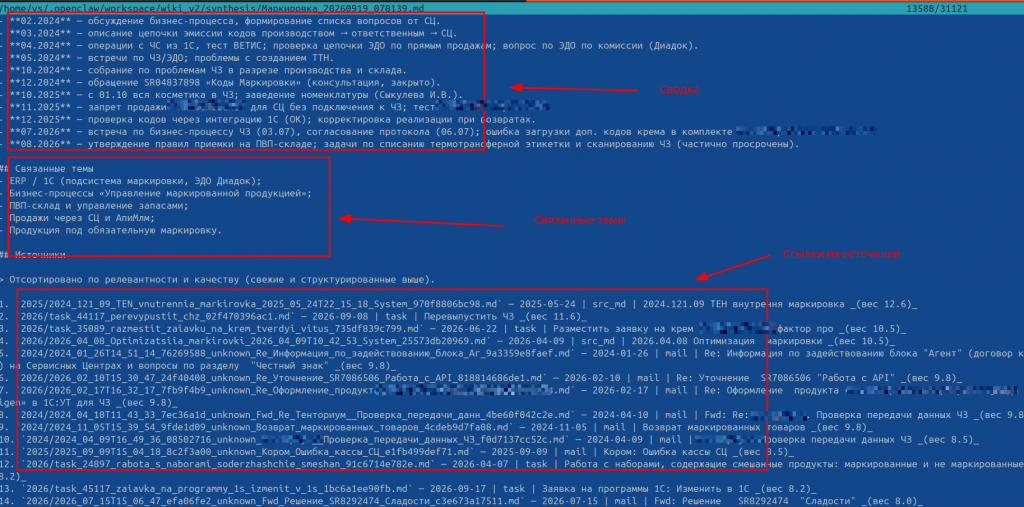
Когда записей стало десятки тысяч, простого поиска стало мало. Появился слой «связывающих статей» (синтез) — обобщённое знание по темам. Вместо того чтобы читать сто разрозненных сообщений про одну проблему, можно прочитать одну сводку, которая уже собрала суть, факты, решения и противоречия по теме.
Фактически это переход от «поиска по документам» к «знанию по темам».
пример сводки по теме "маркировка"
Этап 6. Оптимизация: скорость и порядок
Дальше — доводка, чтобы всё это работало быстро и не падало:
-
инкрементальные обновления (не пере собирать всё каждый час, а только изменившееся);
-
ускорение индексации данных.
-
… процесс оптимизации бесконечный
Текущее состояние системы — подробно
Сейчас это полноценная система, работающая по принципу «конвейера»: данные стекаются → хранятся → обрабатываются → по ним можно проводить поиск и агенты отвечают на вопросы. Обработанная аналитика опять падает в wiki — обогащает знания.
Функциональные блоки
1. Источники данных
Всё, что является моим рабочим и смежным контекстом , стекается в систему:
-
Битрикс24 — задачи, комментарии к ним, групповые чаты, Collab (посты в группах), База знаний;
-
Почта — письма через IMAP;
-
NextCloud — заметки (Notes);
-
Файлы и вложения — документы из задач, чатов и писем, с извлечением текста из PDF и офисных форматов.
-
Мои документы, файловые хранилища ...
2. Единое хранилище. Обработка и классификация
Все данные попадают в одну базу (PostgreSQL), в единой структуре. Задачи, сообщения чатов, письма, заметки и вложения — всё в одном месте, разделено только «типом источника»… что дает возможность расширять систему типов входящих сообщений не меняя сам конвеер обработки. Для всех входящих сообщений выделяется его содержание в markdown. Это основное хранилище - единый источник правды. Следствие архитектуры - в любой момент можно «пересмотреть» систему тэгов / индексации / фильтров перестроить raw / wiki -исходные данные для генерации wiki. Сгенерить несколько wiki по разным темам областям . Данные автоматически тегируются — по существующей таблице тэгов.
3. Поиск — два уровня
-
Точный поиск — по словам и словоформам. Находит «заказ» и по слову «перемещение», и по «перенос» (учитываются синонимы).
-
Смысловой поиск — по смыслу. Понимает, что «как подписать ЭЦП» и «установка ЭЦП» — про одно и то же, даже если слова разные.
Эти два уровня работают вместе: один ловит точные совпадения, другой — смысловую близость и перефразировки. Так поиск становится по-настоящему «умным».
Текущая структура системы — функциональные блоки и их связь
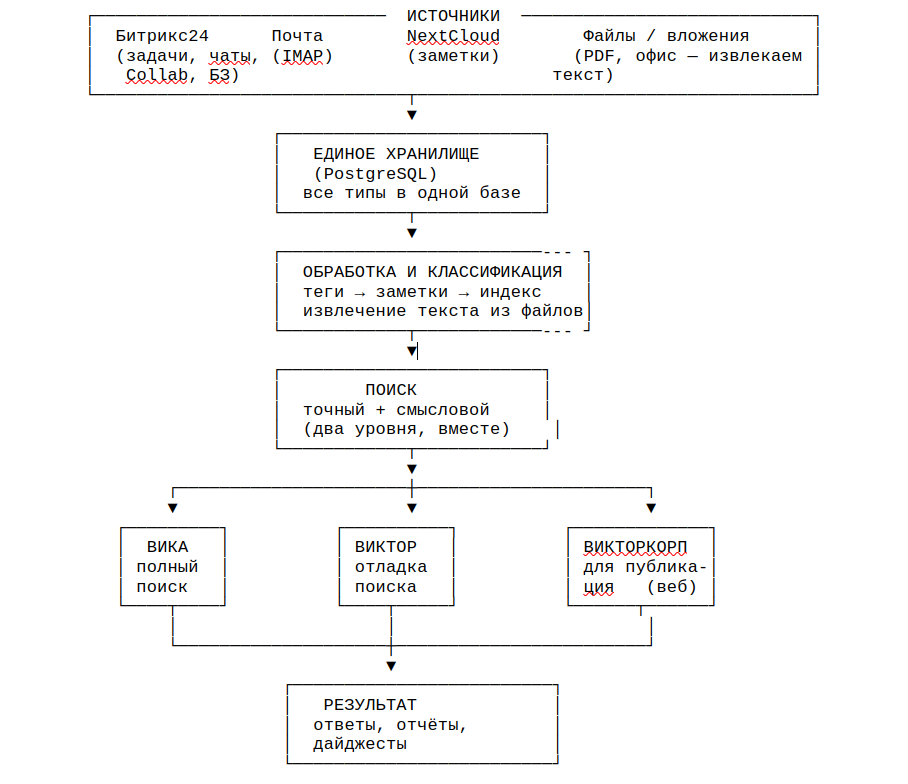
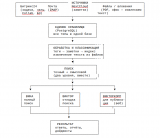
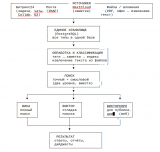
Система — это конвейер, где данные проходят несколько ступеней, от источников до готового ответа. Вот как блоки связаны между собой:
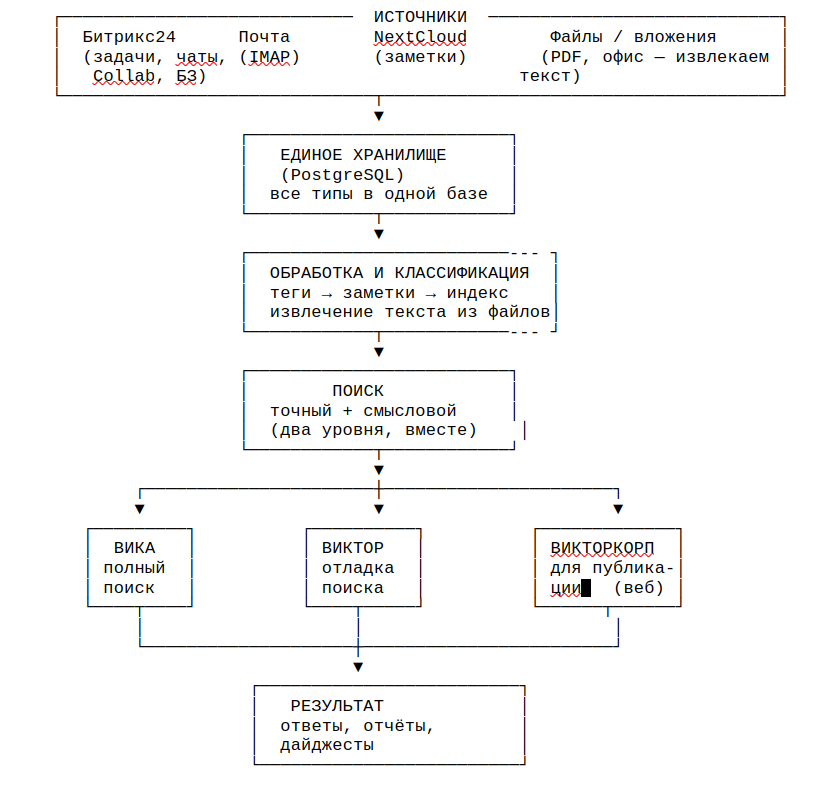
Как читать схему: данные идут сверху вниз. Вверху — источники информации, внизу — то, что пользователь получает. Между ними — единое хранилище, обработка и поиск, а на финальной ступени — три ассистента, которые превращают найденное в ответ.
Ключевая идея схемы — одна воронка данных на всех: и отчёты, и поиск, и ассистенты работают с одним и тем же хранилищем, а не с разрозненными источниками. Поэтому ответ ассистента может опираться сразу и на задачу из Битрикса, и на письмо, и на документ, заметку NC ... .
ИИ-ассистенты поверх поиска. Три ассистента: в чём функциональное отличие
Основной для меня блок взаимодействия - ассисенты. Вика, Виктор, ВикторКОРП = все производные от слова wiki.
На первый взгляд три помощника избыточно выглядят одинаково — у них общий механизм поиска (один и тот же движок, один и тот же промпт, одни и те же настройки). Отличаются они назначением и точкой входа, то есть тем, кто и как с ними работает.
Вика — «спроси что угодно»
Полноценный ассистент для работы в чате. Отвечает на вопросы по всей базе знаний, используя полный поиск и слой синтеза — обобщённые сводки по темам, которые собраны заранее. Благодаря этому Вика выдаёт осмысленный развёрнутый ответ, а не «кучу цитат». Это основной «стабильный» ассистент — его не трогают при экспериментах.
Виктор — «рабочая лошадка для отладки»
Тот же механизм, что и у ВикторКОРП, но вызывается изнутри — в чате, для проверки качества поиска. На нём ставят эксперименты: пробуют новые веса, формулировки промпта, параметры поиска. Это своего рода песочница: настраиваем и отлаживаем здесь, чтобы не ломать то, что работает.
ВикторКОРП — «для публикации во вне»
Назначение - попробовать часть информации опубликовать в корпоративную сеть.
Доступ через стандартный Open WebUI с аккаунтами и историей диалога … , через который внешние пользователи могут общаться с ассистентом в браузере. Главное отличие — изоляция: он полностью отвязан от внутренней «служебной кухни» и не имеет доступа к внутреннему контексту разработчика.
Дальнейшие планы = Виктор и ВикторКОРП — подразумевают в дальнейшем
- Разделение областей знаний
- использования агентов цензоров на «входе — выходе»
Техническая реализация ВиктораКОРП. Ключевые точки механики:
Open WebUI — веб-интерфейс с аккаунтами (admin@tentorium.ru), история диалога…
proxy.py — бот-прокси на FastAPI, маскируется под OpenAI-совместимый API (/v1/chat/completions). Open WebUI подключается к нему как к обычному OpenAI-эндпоинту — поэтому фронтенду всё равно, что за ним не OpenAI, а своя модель.
Изоляция — прокси физически отдельный процесс, ходит напрямую в «локальную» Ollama и Wiki (FTS5). Контекст Claw в цепочку не попадает вообще — внешний пользователь видит только Виктора.
Цензор v1 — детерминированный фильтр (список запрещённых слов + regex + лог). Проверяет и вопрос, и ответ. При нарушении — ответ-отказ «Запрос не соответствует правилам».
Итоговая таблица отличий агентов
|
|
Вика |
Виктор |
ВикторКОРП |
|---|---|---|---|
|
Кто работает |
чат, разговор с ассистентом |
разработчик (внутри) |
Внешний пользователь (веб) |
|
Роль |
полный стабильный поиск |
отладка и проверка |
Ограниченный поиск по теме + цензор |
|
Точка входа |
чат-агент |
вызов изнутри |
браузер (Open WebUI) |
|
Слой синтеза |
да |
как у ВикторКОРП |
да |
|
Цензор |
— |
— |
есть |
|
Изоляция от «кухни» |
автономна |
— |
полная |
Механизм поиска у всех трёх один, а отличаются они тем, кто пользуется и насколько результат защищён от вмешательства. Цель — экспериментировать и отлаживать, не ломая стабильного помощника для рабочих вопросов.
Методики: на чём построен подход
В основе проекта лежит известная в AI-сообществе концепция LLM Wiki, которую Андрей Карпатый опубликовал в апреле 2026 года. Её главная идея — относиться к знаниям так же, как компиляторы относятся к коду: один раз обработать данные и пользоваться результатом постоянно, вместо того чтобы заново переваривать сырьё при каждом запросе.
Вместо классического подхода «нашёл в момент запроса» (RAG, где модель каждый раз ищет похожие куски сырого текста в векторной базе), LLM Wiki предлагает структуру из трёх папок: raw/ (сырые исходники) → wiki/ (сжатые, логически связанные статьи) → index.md (карта всей базы, которая помещается в контекстное окно модели).
…
Этот сдвиг парадигмы дает следующие преимущества перед RAG: 1. Радикальная экономия токенов (до 95%) В классическом RAG при каждом запросе модель вынуждена «переваривать» множество сырых фрагментов текста, содержащих воду, шум и повторяющуюся информацию. В LLM Wiki знания уже очищены и сжаты до самой сути (На малых и средних объемах данных)
...
Меньше расход токенов — меньше требования к ресурсам — меньше платить денег :)
Первоисточник: заметка Андрея Карпатого «llm-wiki.md» (GitHub), апрель 2026.
Подробней — см.вложение wiki_metod2026.txt
Программное обеспечение. Железо и безопасность
- Ubuntu LTS, OpenClaw, OpenCode, Ollama
- агент «живет» + PG +Скрипты + все сервисы на мини ПК с amd h6800.
- локальная модель AMD Ryzen 9 5950X RAM128gb 2rtx3060-12gb=24gb VRAM (включается "автоматически" cron для построения отчетов ... в бездействии - засыпает )
- для исключения «утечки информации», все агенты WIKI работают на локальных моделях (ornith-1.5:35b-ctx128k , qwen3.8:27b-ctx128k, nemotron-3.5-lightning:30b-ctx128k) В данной конфигурации модели 30-35b «почти» входят в VRAM … что-то периодически кэшируется в RAM.
Производительность
- отчет 5 сек
- «сложные исследования» 2-7 минут
...
Количество данных
Чтобы понять масштаб данных:
|
Что |
Сколько |
|---|---|
|
Сообщений и записей в базе (всего) |
~290 000 |
|
Комментарии к задачам |
~231 000 |
|
Задачи |
~21 800 |
|
Сообщения групповых чатов |
~16 300 |
|
Письма |
~5 000 (личные) |
|
Заметки и документы |
~1650 (личные) |
|
Пользователи (справочник) |
~300 |
|
Вложения (файлы) |
~28 900 |
|
Готовых заметок (wiki) |
~100 000 -140 0000 (от условий фильтров/тэгов) |
Данных по факту в БИТРИКС и других источниках — «значительно» БОЛЬШЕ. На данном этапе осознано ограничена область данных «ИТ службой» и смежными темами.
Данные охватывают период с 2023 года по настоящее время.
Что я получил в итоге … и неожиданные моменты
- То что ожидалось, легко решаются вопросы типа:
- Год назад , с Ивановым обсуждали тему «nnnn» найди, что есть по этой теме, выведи задачи и чаты
- Исследуй проект NNNNNN, сообщи его статус, динамику за последние 10 дней, как бизнес аналитик посоветуй, на что обратить внимание
- Заработал режим «автоматической» связи по темам оперативных данных БИТРИКС и «черновиков» из других источников
- Вместо постоянного мониторинга БИТРИКС несколько раз в день смотрю сводку структуры типа:
- Таблица. ТОП Задач по активности
- Ид.Задачи1 . Наименование, ДайджестКраткий
- Ид.Задачи2 . Наименование, ДайджестКраткий
- Ид.Задачи3 . Наименование, ДайджестКраткий
- ...
- Далее по каждой задаче: подробный дайджест
- О чем
- Текущее состояние
- Последние ИЗМЕНЕНИЯ, ЧТО РЕШИЛИ
- Таблица. ТОП чатов по активности … аналогично
- Таблица. ТОП collab по активности … аналогично
- Последние комментарии в «моих задачах»
- Последние ответы на «мои комментарии»
- Какими задачами занимался Иванов последние 10 дней (по всем источникам)
- О чем писал Иванов последние 10 дней (по всем источникам)
… во всех отчетах выводится ссылка исходного объекта … прямо из отчета можно перейти в связанный контекст БИТРИКС.
Отчетов получилось более 5
Не неожиданные результаты.
Появилась "непланируемая" возможность "онлайн" анализа процессов БИТРИКС
- Кластеризация проблем за период
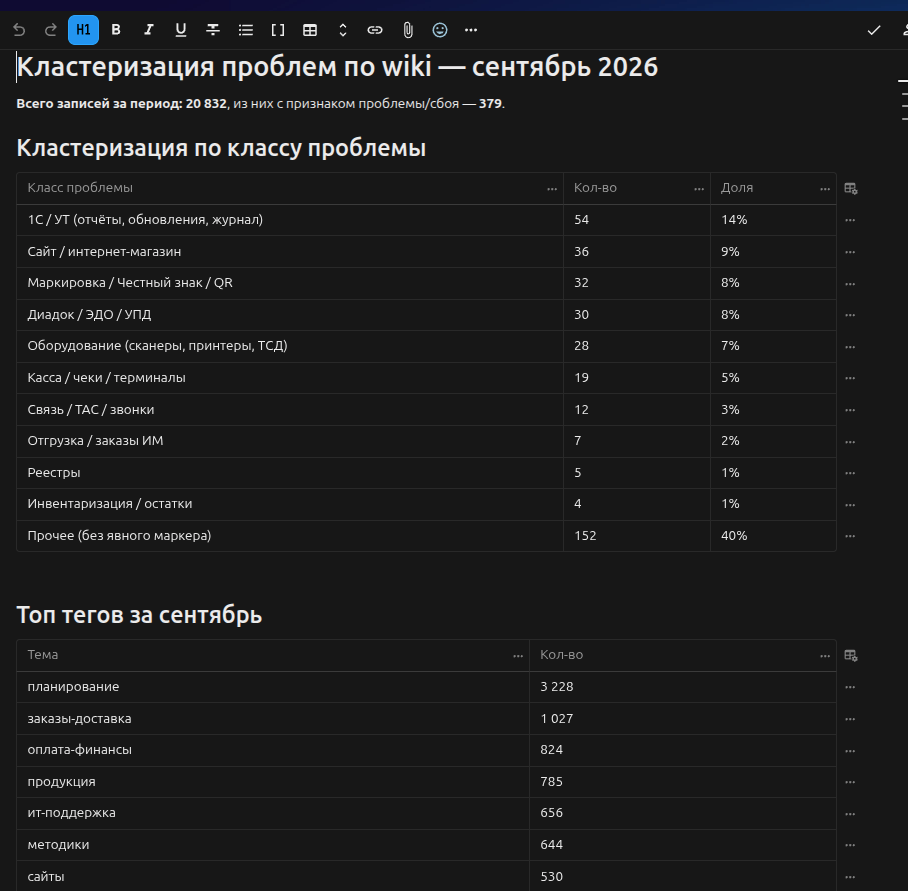
- отчеты «Тепловая карта» - в целом по организации / процессу / сотруднику / участку / проекту
типа:
https://habr.com/ru/companies/lansoft_career/articles/1040150/
- отчеты «Бутылочное горлышко» - в целом по организации / процессу / сотруднику / участку / проекту
типа:
https://weeek.net/ru/blog/bottleneck
- (выкладывать не буду — слишком много персональных данных)
- анализ проблем процессов "человеческим языком". Пример:
-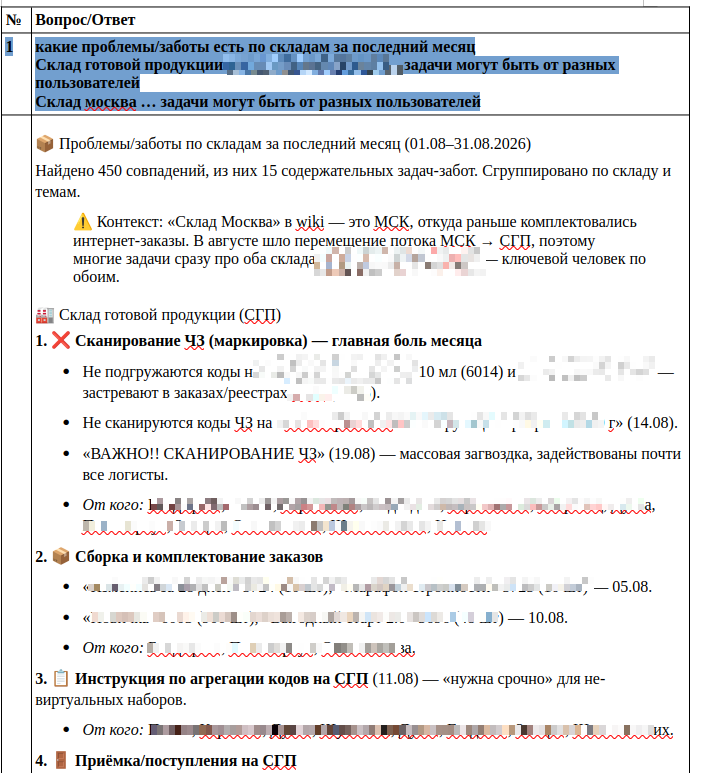
… Далее отчет на 4 страницы с описанием проблем, инициаторов, отвественных, хронологии, «заторах»в процессах.
На вопрос «Какие проблемы на складах за последний месяц» = «литературное эссе на тему проблем на складах» :) … но основанное на оперативных данных БИТРИКС.
На вопрос «Сгруппируй ошибки по складам по теме сводно, выведи в виде таблицы» = получим краткую таблицу из 10-20 строк с основными проблемами, постановщиками, ответственными.
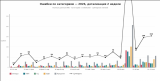
Появилась возможность контроль процессов в динамике, пример — сравнение динамики ошибок после обновления 1С торговли:
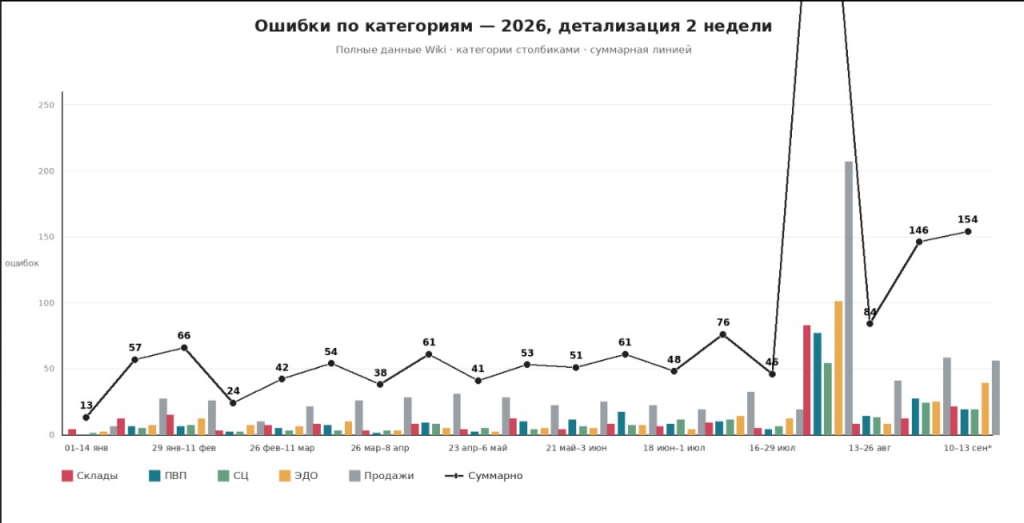
- … тема в процессе изучения. Практические вопросы закрыл … далее пробую разные варианты аналитики.
Элементы практики.
- заметил значительное улучшение качества ответов, если рейтинг данных БИТРИКС НИЖЕ чем «методик» и сводок. Когда в контуре wiki была ТОЛЬКО информация БИТРИКС - аналитика была "так себе" (очень много информационного шума в БИТРИКС). Что в подтверждает подход "LLM - WIKI".
- Вывод — информации. Самым функциональным, удобным, по моему опыту оказалась публикация в заметки Nextcloud. Сохраняется оформление md, можно поднять историю, после редактирования — отправить «на вход» системы. Есть функция "публикации" - единая для всех. Любой отчет, любое исследование : "Публикуются в каталог ИмяОтчета + ДатаВремя *.md" , публикуются в NextCloud ИмяОтчета + ДатаВремя. В чат, для "экономии токенов" выводится только сводка или "начало".
- Приемы пополнения базы — с наименьшими телодвижениями добавить информацию в базу:
- письмо самому себе. Нашел инструкцию, статью, документ — просто отправляю на свой email , сообщение фильтруются в папку, раз в полчаса робот забирает сообщения из почты
- каталог «raw source» - просто каталог бинарных/текстовых файлов — в которых робот парсит новые раз в час
- заметки, которые веду в Nextcloud по наличию определенного тэга выгружаются в «raw source»
Итоги:
- полученный результат — превзошел ожидания. Методика "LLM - Wiki" - себя оправдала. Имеющиеся в наличии «древние» железяки еще на что-то способны :) .
Критичный для себя функционал - завершил. Планы.
- интеграция с Obsidian
- агенты цензоры + что-то выставить в корпоративную сеть. Вопрос связан с ресурсами, для многопользовательской работы...
- попробовать через «обертку» подключить модель к Битрикс24 /NextCloud — дабы встроенные агенты имели мой «рабочий контекст» - тем самым обойти ограничение встроенных ассистентов.
- Пробовал в Nextcloud… вроде работает. Но:
- мне не понятна нагрузка на модель в этом сценарии… похоже Nextcloud или ВикторКОРП — постоянно небольшими запросами держат модель в памяти… что-то делают. Мне не нравится эта фоновая нагрузка. Еще не разобрался, отключил.
- большое время реакции в NC при выполнении запросов
- вынести настройки в nextcloud - править не файлы настроек сущность NC либо "заметки" , либо "Таблицы"
- для меня удобней
- ... и можно безопасно отдать на редактирование "не администратору" ... разделить доступ средствами NC
- В случае косяка - просто восстанавливаем версию средствами NC.
Вступайте в нашу телеграмм-группу Инфостарт

