Вопрос от руководителя звучит буднично: сколько мы в прошлом квартале закупили у поставщиков, с которыми работаем меньше года. В отчётах такой цифры нет. Закупки есть, контрагенты есть, даты первых документов есть, вместе они нигде не сходятся. Дальше выбор: садиться за компоновку данных на полдня или открыть чат с нейросетью и спросить обычными словами.
Второй путь упирается в стену на первом же шаге. Нейросеть не видит вашу базу. У неё нет ни одной вашей строки, и достать их сама она не может: модель работает с тем, что человек положил в окно чата.
Дальше разбираю три способа это обойти, которые пробуют первыми, и показываю, почему каждый ломается. Потом - что должно лежать в файле, чтобы ответ модели можно было проверить. В конце числа боевого прогона на небольшой базе ERP и честные границы, за которыми подход перестаёт работать.
Чья это задача
Ваша, если руководитель или аналитик регулярно приходит с вопросами, под которые нет готового отчёта. Речь про разовый вопрос к своим же данным, который задают и больше не повторяют: кто из контрагентов пропал за полгода, по каким позициям цена менялась чаще всего, сколько документов провёл сотрудник, который увольняется.
Каждый такой вопрос стоит часа-двух работы: понять, в каких объектах лежат данные, написать запрос, собрать вывод. Через неделю вопрос будет другой, и час уйдёт заново. Отчёт при этом писать незачем: он нужен один раз.
Аудитория этой боли шире 1С-ников. Тот же вопрос себе задаёт владелец небольшой торговой компании, у которого база есть, а программиста в штате нет.
Путь первый: выгрузить отчёт в xlsx и положить файл в чат
Самое очевидное действие. Открыть подходящий отчёт, выгрузить в таблицу, перетащить файл в чат, спросить.
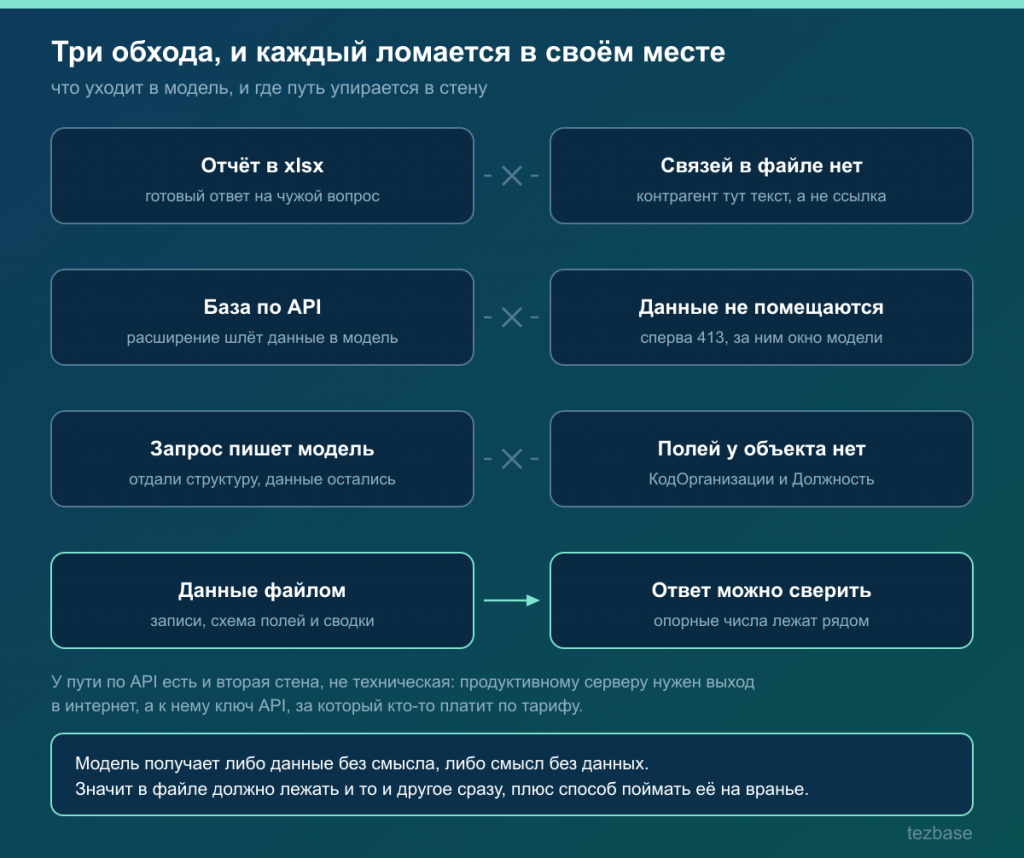
Работает ровно до первого вопроса, который выходит за пределы этой таблицы. Причина в том, что отчёт - готовый ответ на чужой вопрос. В него уже заложены отборы, группировки и итоги, которые кто-то выбрал до вас, а всё остальное из него выброшено.
Конкретнее. В выгруженной таблице контрагент - это строка с наименованием. Не ссылка, а просто текст. У модели нет способа понять, что вот эта строка в таблице закупок и вон та строка в таблице продаж - один и тот же контрагент, если наименования хоть чем-то отличаются. Нет способа узнать, что у контрагента есть договоры, а у договоров есть условия. Связи между объектами в xlsx не существует как понятия.
Модель на таком файле отвечает честно и бесполезно: пересказывает таблицу. Спросите её про то, чего в таблице нет, и она либо скажет, что данных не хватает, либо достроит ответ сама. Второе хуже, и к нему я вернусь.
Что это даёт: ответы на вопросы внутри одной таблицы. Ровно то, что вы и так видите глазами.
Путь второй: подключить базу к модели по API
Путь для тех, кто умеет программировать. Ставим расширение, оно собирает данные запросом и отправляет их в модель по HTTP, ответ показываем пользователю. На площадке таких решений несколько, и они честно работают.
Две стены, и обе не обходятся аккуратным кодом.
Первая - размер. Запрос к модели ограничен сверху, и данные из типовой конфигурации в него не помещаются. Под Быстрым анализом данных с семантическим поиском метаданных пользователь EuLER описывает это прямо: при попытке передать таблицы ERP он получил ответ "413 Request Entity Too Large". Сам по себе 413 лечится настройкой веб-сервера, это лимит на размер тела запроса. Но за ним стоит потолок, который настройкой не двигается: окно модели. Слать можно порциями, поместиться в окно целиком нельзя.
Вторая - выход в интернет от сервера базы. Под Универсальными модулями интеграции 1С с DeepSeek, GigaChat и агрегатором ИИ пользователь MaxS пишет ровно то, обо что спотыкаются такие внедрения: "Полезно, но получается, что базе данных нужен интернет". Дальше начинается разговор с безопасниками, и он редко заканчивается за неделю.
К этому добавьте ключ API, который надо где-то купить, где-то хранить и по чьему тарифу платить за каждый вопрос.
Что это даёт: рабочую конструкцию, если вам согласовали интернет с продуктивного сервера и вы готовы платить за токены. Для разового вопроса руководителя цена подготовки несоразмерна.
Путь третий: пусть модель сама напишет запрос
Самый красивый на вид. Отдаём модели структуру метаданных, она пишет текст запроса, мы его выполняем и получаем цифру. Выглядит как решение всех проблем сразу: данные из базы не уезжают, объём передаваемого крошечный.
Ломается это на том, что модель не отличает поле, которое в базе есть, от поля, которое в ней должно было бы быть. Тот же EuLER под той же публикацией приводит случай: модель построила запрос к справочнику сотрудников по полям КодОрганизации и Должность, которых у этого справочника нет. Его формулировка - "чистая галлюцинация".
Неприятность здесь в том, как эта ошибка выглядит. Запрос с несуществующим полем упадёт на выполнении, и это лучший исход. Хуже, когда поле существует, но означает другое: Дата документа и дата его проведения, цена с налогом и без, количество в базовых единицах и в единицах упаковки. Запрос отработает, цифра появится, проверять её никто не станет.
Что это даёт: быстрый черновик запроса, который обязан прочитать человек, знающий конфигурацию. Ответ без такой вычитки доверия не заслуживает.
Что должно лежать в файле, чтобы ответ можно было проверить
Все три пути ломаются в одном месте. Модель получает либо данные без смысла, либо смысл без данных. Значит в файле должно быть и то и другое сразу, плюс способ поймать модель на вранье.
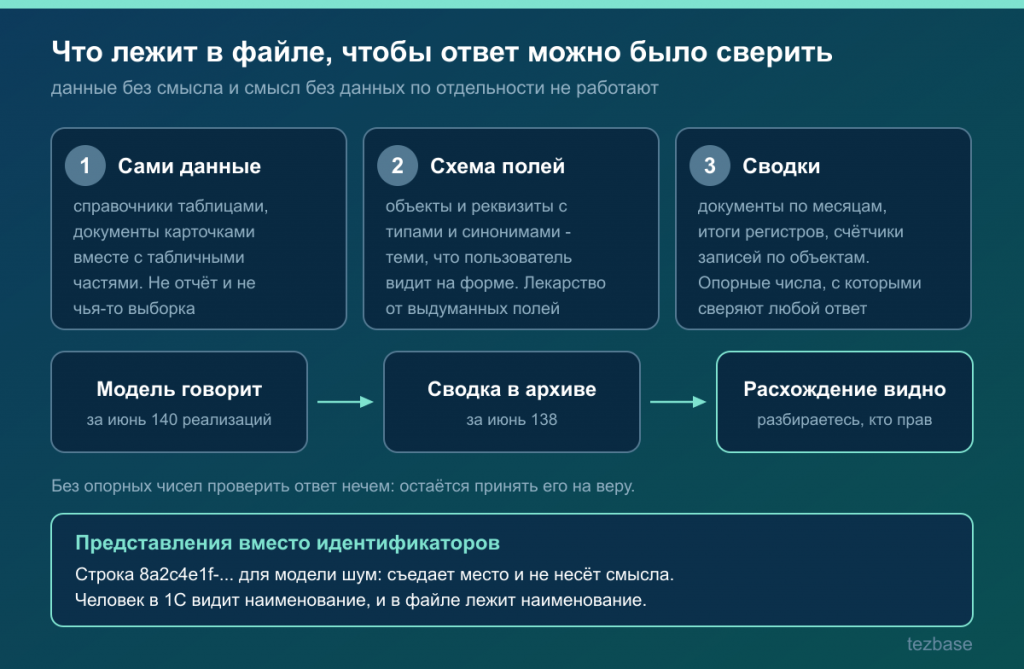
Сами данные. Не отчёт, не итоги, не выборка, которую кто-то отобрал заранее. Записи объектов как они лежат в базе: справочники таблицами, документы карточками вместе с табличными частями. Тогда вопрос "а покажи по этому контрагенту всё" имеет ответ.
Схема полей рядом с данными. Перечень объектов и реквизитов с типами и синонимами, теми самыми, которые пользователь видит на форме. Это лекарство ровно от галлюцинации: когда список полей лежит в том же наборе файлов, что и данные, модель перестаёт достраивать поля по памяти. А вы получаете возможность проверить её ответ, не открывая конфигуратор.
Готовые сводки. Документы по месяцам, итоги регистров, счётчики записей по объектам. Их задача не в том, чтобы что-то посчитать за вас. Их задача - дать опорные числа, с которыми можно сверить любой ответ модели. Она говорит, что за июнь было 140 реализаций; вы смотрите в сводку и видите 138. Дальше разбираетесь, кто из вас прав. Без опорных чисел проверить ответ нечем в принципе, и вся затея превращается в гадание.
Представления вместо идентификаторов. Строка вида 8a2c4e1f-... для модели - шум, который съедает место и не несёт смысла. Человек в 1С видит наименование, и в файле должно лежать наименование. Идентификаторы нужны в другом формате и для другой задачи, об этом ниже.
Практический вывод: набор из данных, схемы и сводок - это минимум, при котором ответ модели можно опровергнуть. Всё, что меньше, даёт ответ, который остаётся только принять на веру.
Как это сделано в обработке
Под этот разбор мы собрали внешнюю обработку: Выгрузка данных 1С для нейросети: Markdown для чата, JSON для программы. Она читает метаданные текущей базы и выгружает данные в два формата сразу.
Markdown - чтобы положить файлы в чат и спрашивать словами. JSON со схемой - чтобы те же данные забрала другая программа: с типами, ссылками и табличными частями.
Правила JSON простые и описаны в самом архиве: ссылка едет структурой из типа, идентификатора и представления, перечисление - из имени и значения, табличные части лежат отдельным разделом записи, даты в ISO. Пустые по правилам 1С значения опускаются, отсутствие поля читается как пустое значение.
Внутри архива всё разложено по назначению:
markdown/
  00-ЧИТАТЬ-ПЕРВЫМ.md     что за база, как читать, что можно спросить
  01-Структура-базы.md    объекты и их поля с синонимами
  02-Сводки.md            документы по месяцам, итоги регистров, состав выгрузки
  10-<Раздел>.md ...      данные по разделам учёта
json/
  manifest.json           состав выгрузки, счётчики, правила чтения
  schema.json             поля объектов с типами и табличными частями
  <ПолноеИмя>.json        сами данные
Работа идёт тремя шагами, и первый из них интереснее остальных.
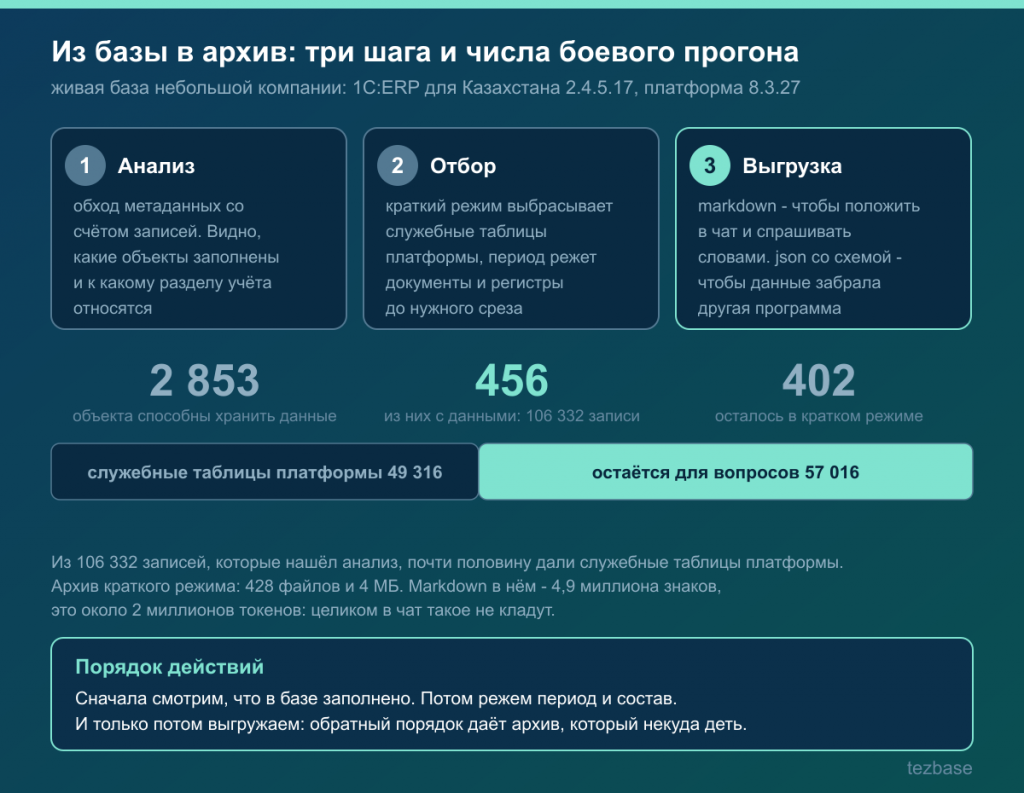
Шаг первый - посмотреть, что в базе вообще есть. Обход метаданных со счётом записей: видно, какие объекты заполнены, сколько в них строк и к какому разделу учёта они относятся. Объекты при этом делятся на три класса: бизнес-данные, классификаторы и служебные таблицы платформы.
Этот шаг стоит проделать даже без всякой выгрузки, потому что результат почти всегда неожиданный. Минимальный вариант на встроенном языке, который можно запустить прямо сейчас:
Для Каждого ОписаниеСправочника Из Метаданные.Справочники Цикл
    Запрос = Новый Запрос;
    Запрос.Текст = "ВЫБРАТЬ КОЛИЧЕСТВО(*) КАК Всего ИЗ Справочник." + ОписаниеСправочника.Имя;
    Выборка = Запрос.Выполнить().Выбрать();
    Выборка.Следующий();
    Если Выборка.Всего > 0 Тогда
        Сообщить(ОписаниеСправочника.Имя + ": " + Выборка.Всего);
    КонецЕсли;
КонецЦикла;
Дописать сюда документы и регистры - пятнадцать минут. Код платформенный: конфигурацию не меняет и в таблицы базы данных мимо платформы не лезет. Но каждый оборот цикла это отдельный КОЛИЧЕСТВО(*) по таблице, а справочников в ERP восемьсот с лишним, так что на боевой базе в разгар рабочего дня такой обход лучше не запускать.
Шаг второй - снять галочки с лишнего. Режим "Краткий" сразу выбрасывает служебные таблицы платформы: обработчики обновления, версии объектов, настройки отчётов, ключи доступа. Режим "Полный" берёт всё заполненное. Период ограничивает документы и регистры.
Шаг третий - выгрузить. Файлы собираются на сервере, наружу уходит один архив.
Одна техническая деталь, которая важна на практике. Работа идёт шагами по несколько секунд: форма не висит, длинная выгрузка не упирается в таймаут, состояние между шагами лежит файлом. Поэтому прогон переживает и веб-клиент.
Имён объектов обработка не знает заранее ни одного - она читает метаданные той базы, в которой запущена. Прогоны шли на "Управление торговлей 11.5" и на ERP для Казахстана, правок кода между ними не было.
Что показал боевой прогон
Прогон на небольшой базе ERP: конфигурация 1С:ERP Управление предприятием 2 для Казахстана 2.4.5.17, платформа 8.3.27. Обычная живая база небольшой компании, не демонстрационная.
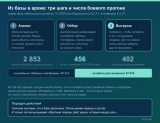
Сначала масштаб конфигурации. 852 справочника, 555 документов, 1 187 регистров сведений, 202 регистра накопления. Четыре этих вида дают 2 796 объектов, а всего объектов, способных хранить данные, в конфигурации 2 853.
Теперь то, ради чего первый шаг и нужен. Данные нашлись только в 456 объектах из 2 853. Всего 106 332 записи. Остальные пять шестых конфигурации в этой базе пустые: механизмы, которые компания не включала, разделы учёта, которые она не ведёт, объекты, оставшиеся от типовой поставки.
Дальше ещё интереснее. Краткий режим оставил 402 объекта и 57 016 записей. Разницу в 54 объекта и 49 316 записей дали служебные таблицы платформы. То есть почти половина всех записей в базе - это внутренняя кухня платформы: версии объектов, сведения об обновлениях, настройки пользователей. Для вопроса руководителя они бесполезны полностью, и место в окне чата занимают наравне с полезными.
Бизнес-ядро этой базы выглядит скромно: 2 организации, 22 сотрудника, 327 контрагентов, 3 730 документов за два года. Только объём делают не они. Три четверти краткой выгрузки, 42 288 записей из 57 016, лежат в регистрах: движения по документам, графики работы, суммы в валюте, производственный календарь. На сами документы приходится шесть с половиной процентов записей, и это ломает обычную прикидку "у меня документов немного, значит и выгрузка будет маленькая".
Технические итоги краткого прогона: 428 файлов, архив 4 МБ. В распакованном виде один только Markdown весит 7,8 МБ, разницу даёт сжатие.
И число, которое отрезвляет: 4,9 миллиона знаков Markdown - это около 2 миллионов токенов. Краткий режим, служебные таблицы уже выброшены. Целиком в чат такое не кладут, и обработка говорит об этом сразу после анализа, до всякой выгрузки. Оценка грубая, она считается по длине текста, а не токенизатором конкретной модели, но порядок величины от этого не меняется.
Практический вывод из прогона один, и он про порядок действий. Сначала смотрим, что в базе заполнено, потом режем период и состав, и только потом выгружаем. Обратный порядок даёт архив, который некуда деть.
Где инструмент заканчивается
Три границы, о которых честнее сказать здесь, чем услышать в комментариях.
Большие базы. Если у вас миллионы документов, в чат они не поместятся ни в каком режиме. Арифметика выше показывает масштаб: два года небольшой компании дают два миллиона токенов. Для крупной базы этот подход работает только на узком срезе: один раздел учёта, один месяц, один участок. Вопрос "проанализируй мою базу" на таком объёме не имеет смысла ни с какой обработкой.
Хранилища значений. Настройки, макеты и прочее, что лежит в базе двоичным куском, не выгружается. В записи остаётся пометка. Читать их модели всё равно нечем, но знать об этом лучше заранее.
Персональные данные. Выгрузка отдаёт то, что лежит в базе, и не маскирует ничего. Фамилии сотрудников, ИИН, названия контрагентов, суммы договоров уедут в файл как есть. Если файл потом уходит в облачный чат, это решение нужно принимать осознанно и, скорее всего, согласовывать. Для случая, когда данные отдавать наружу нельзя, у нас есть отдельный инструмент, "Анонимизатор базы данных PRO": он проходит по базе и подменяет персональные данные правдоподобной синтетикой, сохраняя длины и контрольные суммы. Смешивать эти две задачи в одной обработке мы сознательно не стали.
Открытый вопрос
Спорная часть этого разбора для меня такая: сводки. Я считаю, что без опорных чисел в том же наборе файлов ответ модели бесполезен, потому что его нечем опровергнуть. Но сводки занимают место, и кто-то скажет, что честнее отдать модели больше сырых данных, а проверку делать отдельным запросом в базу.
Вопрос к вам, и он мне правда интересен: кто уже пробовал спрашивать нейросеть про свои данные из 1С, и чем закончилось? Отдельно интересны случаи, когда модель ответила уверенно и неправильно, и вы это заметили. Чем именно поймали - глазами, сводкой, запросом? Мне кажется, что на площадке про это говорят мало, потому что рассказывать про свою ошибку скучнее, чем про удачный промпт.
Обработка из этой статьи: Выгрузка данных 1С для нейросети: Markdown для чата, JSON для программы.
Другие наши инструменты для работы с нейросетью:
- Выгрузка структуры метаданных 1С для нейросети - отдаёт модели устройство конфигурации без единой строки данных; нужна, когда вопрос про код и метаданные.
- Журнал регистрации, свёрнутый для нейросети - сворачивает журнал до размера, с которым модель может работать, когда разбираетесь, кто и что менял в базе.
- Матрица прав доступа для нейросети - выгружает роли и права в том же ключе: данные плюс схема, чтобы ответ про доступы можно было проверить.
Вступайте в нашу телеграмм-группу Инфостарт