В прошлой части поиск по конфигурации дошёл до 0,864: правильный ответ попадал в первую десятку у девяноста пяти вопросов из ста десяти. А закончил я тем, что однажды замер по торговому набору выдал 0,073.
Вот как это было.
Шёл первый час ночи. Мы поднимали версию библиотеки, которая считает на видеокарте отпечатки смысла, — рутинная работа. Нейронке досталась проверка: доказать, что числа на выходе не изменились. Если изменились, все базы придётся индексировать заново, а это часы на каждую.
Прежде чем что-то менять, нужно снять точку отсчёта. Нейронка прогнала наш стенд — сто десять вопросов по УТ 11.5 с заранее известными ответами — и получила:
- правильный ответ в первой пятёрке — у восьми вопросов из ста десяти, 0,073;
- в первой десятке — у девяти, 0,082.
Цифра 0,073, которой кончилась прошлая часть, — это пятёрка. По десятке, которой я мерил весь цикл, вышло 0,082. Разница тут не важна: обычно было около 0,85 и в пятёрке, и в десятке. Обвал больше чем в десять раз.
А накануне в основную ветку легла большая пачка доработок: новые формулы, по которым записи в индексе получают номера, и новый формат хранения векторов. Первое, о чём я подумал: две недели работы коту под хвост. Где-то в свежих изменениях мы сломали поиск, и искать это «где-то» предстояло в нескольких сотнях тысяч строк кода.
Эта часть — про то, чем кончилась та ночь, и про похожие грабли, которые бывают только в 1С. Обе истории об одном: инструмент работает, ошибок не выдаёт, число показывает, а верить ему нельзя.
Первое объяснение было уверенным и наполовину неправильным
Нейронка работала в Claude Code. Увидев результат, она написала: «Числа подозрительно низкие. Сверяю с прошлыми прогонами того же набора». Сверила и через минуту выдала объяснение:
Это не качество поиска, это последствие свежей смены формул номеров: точки в хранилище пронумерованы по-старому.
Звучит убедительно. И бьёт ровно туда, чего я боялся, — в свежую пачку доработок.
Первая половина фразы потом подтвердилась: поиск был ни при чём. А вторая не выдержала первой же проверки. Стенд засчитывает попадание не по номерам записей, а по именам: модуль, процедура, объект. Как бы записи ни были пронумерованы, имя правильного ответа от этого не меняется. Нейронка сама открыла правила подсчёта и через несколько минут от своей версии отказалась.
Дальше она сделала то, что стоило сделать первым делом: проверила поиск на заведомо годной основе. Собрала из выгрузки свежий индекс типовой УТ 11.5 — 296 821 запись за 46 минут на NVIDIA GeForce RTX 3080 Ti — и прогнала тот же набор:
- в пятёрке — 0,855;
- в десятке — 0,873.
Всё как обычно. Поиск был в полном порядке. Сломана была линейка.
Что было не так с линейкой
Разбирались с ней днём. В рабочей папке стенда лежали двадцать две базы: индексы разных конфигураций, собранные в разное время за последние два месяца. Отстали от текущих правил все до одной:
- формат хранения векторов у всех был первого поколения, а поиск к тому времени ждал второго;
- формула номеров записей не была текущей ни у одной;
- одна база и вовсе стояла на четвёртой версии схемы хранения, когда текущей была восемнадцатая.
Главным оказался первый пункт. Поиск ждал хранилище, устроенное по-новому, а читал устроенное по-старому. Поиск и хранилище разговаривали на разных языках. При этом ни одной ошибки: числа сравнивались с числами, строки выдачи выстраивались по порядку, стенд честно считал, сколько правильных ответов попало на полку. Попадало восемь.
Виновата всё-таки была свежая пачка доработок, только не так, как я боялся. Поиск она не сломала. Она сменила формат хранения векторов, а базы стенда остались в старом.
Картина знакомая каждому, кто дорабатывал проведение в 1С. Алгоритм проведения поменяли, а документы прошлых периодов никто не перепровёл. Отчёт по регистру формируется без единой ошибки и показывает итог. Только часть движений в нём записана по старым правилам, часть по новым, и отчёт честно складывает одно с другим.
Но самое неприятное было даже не это. У каждого индекса записано, по каким правилам он собран: версия схемы хранения, формула номеров записей, формат векторов, правила, по которым собирается текст для отпечатка, модель, которая этот отпечаток считала, и его размерность. Мы называем эти записи пломбами. Индексатор пломбы читает: увидел старую — сам уходит на полную переиндексацию. А стенд не читал их вовсе. Он открывал любой индекс, какой ему дали, и печатал число.
Тихий отказ
Такие поломки я называю тихим отказом. Механизм работает, ошибки нет, результат есть, а верить ему нельзя.
Громкий отказ — это ошибка: красная строка, упавший прогон, сообщение, мимо которого не пройти. С ним всё просто, его чинят. Тихий отказ выглядит как нормальная работа. Стенд не упал, он посчитал. Отчёт лёг в папку, и цифра в нём была.
В ту ночь нас спасло одно: цифра была абсурдной. Обвал в десять раз подозрителен сам по себе, и нейронка заподозрила неладное с первой минуты. А теперь представьте, что старые индексы роняли бы качество не в десять раз, а на несколько процентов. С 0,864 до 0,82. Такое падение выглядит правдоподобно, ровно как от неудачной доработки. Мы бы искали виноватого в свежем коде. И нейронка нашла бы его так же уверенно, как в первую минуту той ночи нашла «смену формул номеров». Это не замер, а рассуждение, но мне от него до сих пор не по себе.
С нейронкой тихий отказ обходится особенно дорого. Она получает от инструмента число и не видит, в каких условиях оно получено. Спорить с правдоподобным числом ей не из чего: если инструмент не сказал, что считал по старой базе, этого не скажет никто. И дальше на этом числе строится всё остальное — выводы, правки, следующие замеры.
Нейронка сделала ровно то, чему мы её учили
Есть в этой истории деталь, над которой я думал дольше, чем над самой поломкой.
Большую работу мы режем на потоки со строгими границами. Для этого у нас есть свой навык для Claude Code — нарезка плана на параллельные потоки. Он берёт утверждённый план и выясняет, какие его куски можно вести одновременно, не мешая друг другу. Рисует карту: что за чем идёт и что от чего зависит. На каждый поток пишет самостоятельное задание, которое можно выполнить без всякого другого контекста: что делать, чего не трогать, что считать готовым и куда нести находки за пределами своего куска. Код навыка открыт целиком и лежит на GitHub, русская версия там же.
За границу своего потока нейронка выходить не должна. Правило простое: в чужой кусок не лезешь, найденное записываешь для людей.
Так она и поступила. Поняв, что сломан стенд, а не поиск, написала: «Диагностику стенда дальше не веду — это отдельная находка, не задача потока». Обошла сломанный стенд свежим индексом, довела свою проверку до конца — после подъёма версии числа не изменились, переиндексация не понадобилась — и в отчёте отдельным пунктом записала: индексы стенда непригодны как мерило, стенд надо чинить отдельной задачей.
Формально безупречно. Но если бы я не прочитал этот пункт, сломанная линейка так и лежала бы, дожидаясь следующего, кто придёт мерить.
Когда я спросил, как чинить, нейронка первым делом предложила чинить не базы, а прибор:
Пересоберу базы — через две недели, на следующем подъёме формул, стенд снова тихо соврёт.
Пересобрать базы — полдела. Нужно, чтобы стенд перестал считать там, где считать нельзя.
Отказаться, а не предупредить
Вот что стенд делает теперь.
Сверяет пломбы до прогона. Прежде чем считать, стенд читает пломбы индекса и сравнивает их с текущими правилами. Разошлась хоть одна — прогона не будет. Вместо числа стенд пишет, что именно разошлось и что нужно пересобрать.
Сверяет, не открывая индекс. Деталь, которую легко проглядеть. Обычное открытие само поднимает схему индекса до текущей версии, а индекс без записанной версии пересоздаёт. То есть «просто посмотреть, чем собран индекс» через обычное открытие значило бы изменить, а то и снести ровно то, что просили измерить. Поэтому пломбы читаются прямо из файла, до открытия.
Отказывает сразу. Большая часть пломб видна из настроек и самого файла, и эта проверка идёт до загрузки моделей. Отказ приходит мгновенно, а не через минуту ожидания. Иначе за обходной путь хватались бы от досады.
Записывает условия в отчёт. В каждом отчёте теперь лежит, на чём он снят. Сравнивать два отчёта, снятых в разных условиях, стенд отказывается. А условие, которое в отчёте не записано, считается разошедшимся: иначе два старых отчёта без условий сравнивались бы «пусто с пустым» и молча выдавали разницу, объяснимую чем угодно.
Оставляет выход, но со следом. Померить заведомо старый индекс можно, если очень надо. Для этого стенду нужно прямо сказать «да, я знаю», и отчёт будет помечен как снятый на несопоставимой основе.
Мерило пересобрали, сняли на нём опорный отчёт — те же 0,855 и 0,873 — и проверили стенд в обе стороны: на старой базе он отказывает со списком расхождений, на новой прогон проходит. Всё это заняло вторую половину дня.
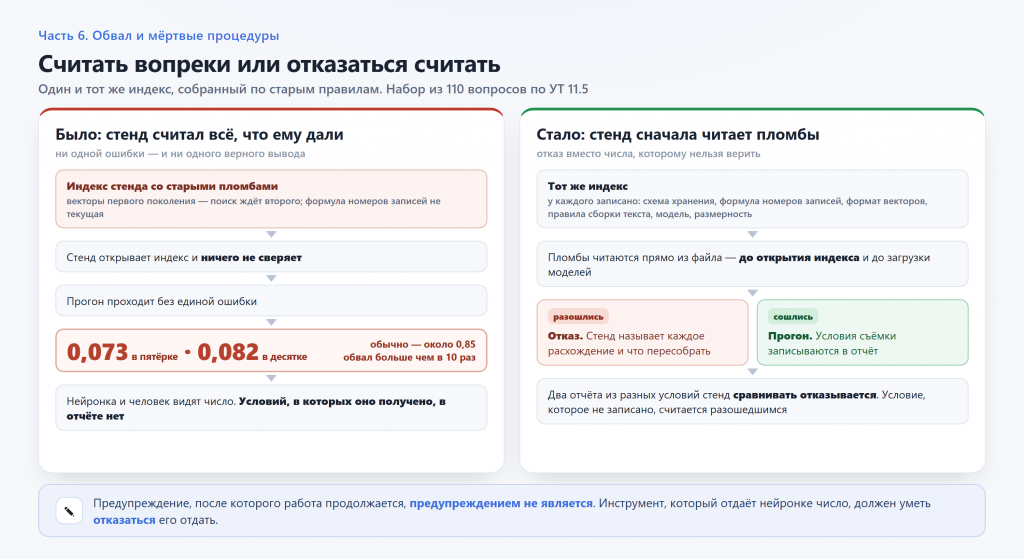 Слева — как было: стенд открывал индекс со старыми пломбами, ничего не сверял и выдавал 0,073 в пятёрке и 0,082 в десятке без единой ошибки. Справа — как стало: пломбы читаются из файла до открытия индекса; разошлись — отказ с перечнем расхождений, сошлись — прогон, и условия съёмки записываются в отчёт. Набор из ста десяти вопросов по УТ 11.5.
Почему не предупреждение
Напрашивается вариант помягче: пусть стенд предупреждает о старых пломбах и всё-таки считает. Мы его рассматривали и отвергли.
Довод за предупреждение понятный. Пересборка индекса стоит часов, а померить хочется сейчас. Строгий отказ у измерительного инструмента выглядит придиркой.
Но цена ошибки несимметрична. Отказ стоит времени. Неверное число, которое легло в отчёт и потом стало точкой отсчёта, стоит доверия ко всем замерам после него.
И главное: кто прочитает предупреждение? Ночью стенд гоняет нейронка. Она берёт из отчёта число и идёт дальше. Утром человек читает сводку, где число есть, а строк из журнала нет. Предупреждение, после которого работа продолжается, предупреждением не является.
Правило, которое я из этого вынес: инструмент, который отдаёт нейронке число, должен уметь отказаться его отдать.
Та же болезнь в соседнем приборе
В те же сутки то же самое нашлось в другом нашем инструменте — в приборе, который сравнивает отпечатки смысла до и после подъёма версии. Независимая проверка нашла в нём пять дыр, и все в самом приборе, а не в его выводах. Вот три из них:
- расхождение считалось только по словам, общим для двух снимков; разойдись наборы слов полностью — прибор напечатал бы «расхождение ноль», то есть «всё совпало» ровно там, где не совпало ничего;
- в снимок записывалось устройство, на котором попросили считать, а не то, на котором считали: без рабочей видеокарты расчёт молча уходит на процессор, а снимок записался бы под меткой «видеокарта»;
- поправь формулировку одной записи в эталонном наборе — и прибор честно объявил бы виноватой версию библиотеки.
Все пять починили. А когда разбирали стенд, нейронка сама провела параллель: «Это ровно та же болезнь, что мы вчера лечили в приборе для отпечатков: инструмент выносит вердикт там, где должен отказываться».
Грабли, которые бывают только в 1С
Вторая история старше, и она про граф вызовов — тот самый, что знает, кто кого вызывает.
Граф строился по тексту модулей: нашёл в коде вызов — провёл стрелку. Работал он отлично. По крайней мере, так мне казалось. И всё в нём выглядело просто: есть входящие стрелки — процедуру кто-то вызывает, нет — не вызывает никто.
А потом ребята научили граф читать описания форм. В 1С связь «событие элемента формы — процедура-обработчик» хранится не в модуле, а в описании самой формы. Процедуру вызывает платформа, когда событие наступает. В тексте модулей такого вызова нет нигде: процедура объявлена и ни разу не вызвана.
На УТ 11.5 таких привязок нашлось 42 501. И у 40 298 разных процедур из них не было ни одного вызова в коде. Сорок тысяч процедур, которые до этого граф считал никем не вызываемыми. В одной типовой конфигурации.
Тот же замер нашёл вторую потерю, тише. Из 11 904 вызовов в модули менеджеров 4 789 вели не в справочники и документы, а в менеджеры регистров, отчётов, обработок и прочих объектов. Граф знал только справочники и документы, и эти вызовы просто пропадали: без ошибки, без пометки. Почти сорок процентов всех вызовов менеджеров.
И вот что важно: эту потерю никто не проглядел. Её выбрали сознательно, на раннем этапе, чтобы граф не выдумывал ложных связей. Решение было разумным. А тихой потеря стала потому, что граф о ней никому не говорил.
Обе дыры ребята закрыли за один день: вызовы менеджеров всех видов, привязки событий форм, обработчики команд.
Где в 1С вызов живёт не в коде
Обобщение, которое я отсюда вынес: в 1С часть графа программы лежит не в тексте модулей, а в описании объектов. Инструмент, который читает только код, слепнет на целом классе связей — не потому что плохо написан, а потому что смотрит не туда.
Вот где такие связи живут и что из этого видит наш граф сейчас:
- Описание формы. Событие элемента или самой формы → процедура-обработчик. Граф видит: 42 501 привязка на УТ 11.5.
- Команды объектов. Команда → её обработчик. Видит: 666 привязок.
- Подписки на события. Объект-источник, событие и процедура в общем модуле заданы отдельным объектом метаданных. Видит.
- HTTP-сервисы и веб-сервисы. Метод сервиса → процедура-обработчик. Вызывающая сторона при этом вообще снаружи, в чужой системе. Видит.
- Подключаемые команды Библиотеки стандартных подсистем (БСП — набор готовых механизмов, который есть почти в каждой типовой конфигурации). Печать и прочие команды подключаются через соглашения библиотеки. Граф берёт только то, что объявлено прямо в модулях менеджеров, — на УТ 11.5 это 27 команд, все печатные — и помечает такую связь как менее надёжную: это вывод по соглашению, а не прямая запись. Команды, объявленные через переопределяемый модуль, сюда не попадают, и это сознательно.
И есть связи, которых не увидит никакой разбор текста — ни наш, ни чужой:
- общий модуль, который получают по имени, строкой, через ОбщегоНазначения.ОбщийМодуль;
- код, собранный в строку и выполненный через Выполнить или Вычислить;
- вызовы из внешних обработок и отчётов, которых в конфигурации нет вовсе.
Здесь граф теперь поступает так же, как стенд: не молчит. Когда его спрашивают, кто вызывает общий модуль, он добавляет к списку оговорку: обращения по имени и через Выполнить и Вычислить сюда не попадают, настоящих вызывающих может быть больше. Когда спрашивают, какие документы пишут в регистр, — оговаривает, что видит только документы, у которых регистр указан в движениях, а запись из кода общих модулей, обработок и форм в список не входит. Короткий или пустой список больше не читается как «больше никто».
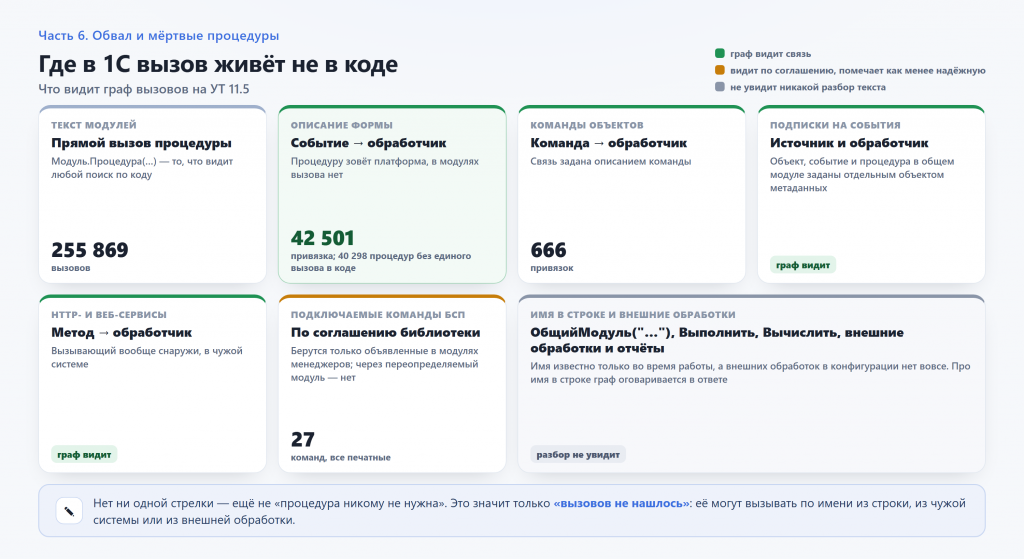 Где в 1С может жить вызов процедуры и что из этого видит граф вызовов на УТ 11.5. Прямых вызовов в тексте модулей — 255 869. Привязок событий форм — 42 501, и у 40 298 процедур из них нет ни одного вызова в коде. Обработчиков команд — 666, подключаемых команд БСП — 27. Подписки и сервисы граф связывает. Вызов по имени в строке и из внешней обработки не увидит никакой разбор текста.
Отсюда практический вывод. Ответ графа про процедуру бывает трёх сортов: вызов доказан (есть прямая связь), вызов выведен по соглашению (стоит проверить глазами) и «вызовов не нашлось». Третий ответ — ещё не «процедура никому не нужна». Её могут вызывать по имени, собранному в строке, из чужой системы или из внешней обработки. Решать по такому ответу, что процедуру можно выбросить или не переносить в новую версию конфигурации, нельзя.
Что общего у двух историй
Тихий отказ страшнее громкого. Громкую ошибку чинят, тихой пользуются. Стенд, который считает по устаревшей базе, и граф, который молча теряет класс связей, опаснее упавшего стенда и графа, который не собрался.
Нейронка не видит того, чего не сказал инструмент. Она работает с тем, что ей дали: числом, списком, пустым ответом. Условия, при которых получено число, и границы, за которыми список неполон, должен называть сам инструмент.
Отказ и оговорка — не придирка. Стенд отказывается считать там, где число было бы неправдой. Граф оговаривает, чего не видит, там, где пустой список был бы неправдой. Оба стали неудобнее — но зато обоим стало можно верить.
Как вообще узнают, кто вызывает процедуру
Способов несколько, и победителя среди них нет.
Спросить того, кто писал. Быстрее и точнее ничего нет, пока автор доработки работает рядом. С кодом, который другая команда написала несколько лет назад, это уже не работает.
Поиск по тексту модулей. Находит прямые вызовы. Там, где вызова в коде нет, — в формах, командах, подписках, заданиях — искать надо уже в описаниях объектов.
Граф связей, построенный по выгрузке. Видит ровно те связи, которые умеет строить. Прежде чем ему верить, стоит знать, какие связи он строит и о каких молчит.
Открытые анализаторы кода сообщества. Некоторые из них отмечают процедуры, у которых не нашлось вызовов. Что при этом считается вызовом, каждый анализатор решает по-своему. Прежде чем опираться на такую отметку, стоит знать, считает ли анализатор вызовом привязку события в описании формы. Иначе в «невызываемые» попадут обработчики, которые платформа зовёт каждый раз, когда пользователь нажимает кнопку.
Замер производительности на живой базе. Покажет, что на самом деле выполнялось, но только в тех сценариях, которые вы прогнали. Процедура из редкой ветки в замер не попадёт.
Нейронка. Ответит по тому, что ей дадут: по тексту модулей — как поиск по тексту, по графу — как граф. Своего знания о вашей конфигурации у неё нет, об этом была первая часть.
Сколько это стоило
Ночь с обвалом. От цифры 0,073 до свежего индекса с привычными 0,855 прошло чуть больше часа, из них 46 минут — сама индексация на видеокарте.
Починка стенда. Около трёх часов на следующий день: сверка пломб, условия в отчёте, отказ сравнивать несопоставимое, пересборка мерила — около часа видеокарты — и проверка в обе стороны.
Граф и описания форм. Один день работы ребят: вызовы менеджеров всех видов, привязки событий форм и обработчиков команд, замер на УТ 11.5.
Во что обошёлся бы тихий отказ, если бы цифра не была абсурдной, я не знаю и считать не берусь.
Чего я не измерял
Врал ли стенд раньше. Все отчёты, снятые до той ночи, условий съёмки не содержат, включая цифры из прошлых частей. На чём их снимали, я знаю из журнала замеров, а не из самих отчётов, и сравнивать такие отчёты стенд сегодня откажется.
Поймала бы нейронка поломку поменьше. Обвал в десять раз кричит сам. Что было бы при падении на несколько процентов, — рассуждение выше, а не замер.
Процедуры, которые платформа зовёт по имени. Обработчики событий в модулях объектов, в модуле приложения, в модуле сеанса — связь держится на том, что процедура с нужным именем лежит в нужном модуле. Отдельно этот класс я не мерил.
Другие конфигурации. 42 501 привязка и 40 298 процедур — это УТ 11.5. В 1С:ЕРП форм заметно больше, но замера там нет.
Кому это не нужно. Чужой код в 1С удаляют редко: обычно он живёт вечно, даже когда давно никому не нужен. Но вопрос «кто это вызывает» встаёт и без удаления: когда меняешь процедуру и хочешь знать, что заденешь, и когда решаешь, переносить ли старую доработку в новую версию конфигурации. Если ни того ни другого вы не делаете и качество своих инструментов не меряете, половина этой части вам ни к чему. Вторая половина — про то, что число без условий, в которых оно получено, ещё не результат, — пригодится всем, кто хоть раз поверил отчёту.
Дальше
Все истории цикла до сих пор — про то, как мы учились не верить собственным цифрам на слово: выдуманным процедурам, очевидным улучшениям, которые делали хуже, и линейке, которая врала с честным лицом.
В последней части — проект, который стал первым настоящим испытанием всего нашего набора: переход клиента с УТ 11.4 на 11.5. Пятнадцать тысяч часов доработок, несколько сменившихся команд и ни одного комплексного описания. Без нейронок мы делали бы это больше года, а с нейронкой сделали за…
Если вы попали сюда с середины: пятая часть — про процедуру, которую вызывают тридцать три других и ни одна не помогает её найти, а четвёртая — про три очевидных улучшения, два из которых сделали хуже.
Вопрос к вам: как вы выясняете, кто на самом деле вызывает процедуру, прежде чем её менять?
Вступайте в нашу телеграмм-группу Инфостарт