rphost раздулся: находим сеанс и выводим процесс за 3 шага через rac, замеры на 8.3.27
- Что проверено и на чём
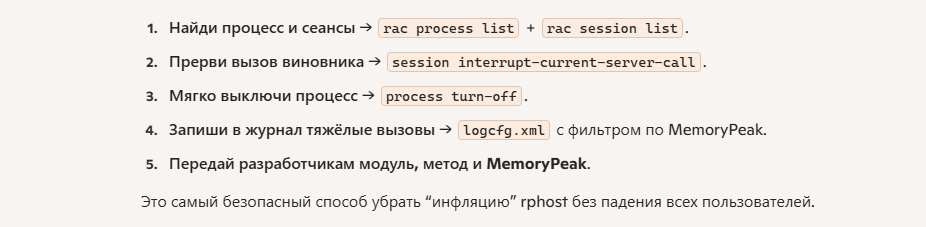
- Шаг 1. Найти процесс и сеансы
- Шаг 2. Прервать вызов виновника
- Шаг 3. Вывести процесс:
rac process turn-off - После инцидента: записать в журнал, какой метод занял память
- Откуда берётся память: замеры по приёмам BSL
- Linux: арены glibc,
malloc_trimи systemd - Что кластер делает сам
- Если не работает
- Что не проверено
- Чек-лист дежурного
- Вопрос читателям
- Другие материалы автора по теме
Инструкция администратору кластера 1С: три шага (найти сеанс, прервать вызов, вывести процесс), запись технологического журнала и замеры на платформе 8.3.27.2130. К статье приложена утилита: первые три шага она выполняет одной командой каждый.
Рабочий процесс rphost растёт по памяти, сервер начинает свопить, на процессе сидят пользователи. Убить процесс просто, но вместе с ним рвутся все его сеансы. Статья показывает порядок действий, который я прогнал на стенде: найти сеанс, занявший память, прервать его вызов, вывести процесс из работы так, чтобы остальные сеансы дожили до конца, и записать в журнал, какой метод виноват. У каждого шага реальный вывод и замер. Там, где мне не хватило стенда, так и написано.
Вот результат первого шага. Одна команда, 0,9 секунды, три сеанса на процессе, виновный сверху:
Порог: 300 МБ (memory-size процесса)
PID      Память, МБ  Соед.  Сеансов  Работает  Выше порога
13084           492      6        3        да  ДА

Сеансы процесса PID 13084 (по убыванию memory-current):
Сеанс   Пользователь       Приложение     База         Сейчас, МБ  5 мин, МБ  Вызов, с
6       DefUser            BackgroundJob  rlab                480          0        72
8       DefUser            BackgroundJob  rlab                  9          0        63
4       DefUser            COMConnection  rlab                  0          0         0
Что проверено и на чём
Все числа получены на этом стенде 29.09.2026. Версии указаны, потому что часть находок зависит от них.
| Компонент | Версия | Как использовался |
|---|---|---|
| Платформа 1С | 8.3.27.2130, Windows x86 | локальный кластер (ragent, ras), rac, серверная база |
| СУБД | Postgres Pro 1C 16 в Docker (Debian 12) | база кластера. Обычный postgres:16 не подошёл: CREATE EXTENSION mchar завершается ошибкой |
| Нагрузка | фоновые задания серверной базы | синтетическая: таблица значений, запрос, JSON. Сеансов с формами и живых пользователей на стенде нет |
| Технологический журнал | logcfg.xml в каталоге пользователя |
процессы кластера запущены под моей учётной записью |
| glibc | 2.36, Debian 12, 4 ядра, Docker | две программы на C. Это не rphost, а модель аллокатора |
| Утилита и скрипты | Python 3.12, Git Bash, PowerShell 5.1 | всё из архива |
| Платформа под Linux | не запускалась | пути, кодировка вывода rac и поведение rphost проверьте у себя |
Нагрузочный модуль (RLab.bsl) лежит в архиве в каталоге stand. Как поднять такой же кластер, описано в stand/README.md.
Шаг 1. Найти процесс и сеансы
Нужен запущенный сервер администрирования ras, rac подключается к нему. Два вызова дают всё, что нужно:
Единицы в выводе, которые легко перепутать:
| Поле | Где | Единица | Как проверено |
|---|---|---|---|
memory-size |
process list |
килобайты | 351124 в rac и 351124 КБ PrivateMemorySize64 того же PID в Get-Process |
memory-current |
session list |
байты | у задания на 600 тыс. строк 301779996, а MemoryPeak того же вызова в журнале 301783072 |
duration-current |
session list |
миллисекунды | 72 000 у задания, запущенного примерно за 70 секунд до замера |
process |
session list |
UUID процесса | совпадает с process в process list |
infobase |
session list |
UUID базы | имя базы даёт rac infobase summary list |
Поля memory-peak у сеанса нет. Есть memory-current, memory-last-5min и memory-total. Скрипты, которые ищут memory-peak, ничего не найдут.
Утилита rphost_memory_doctor.py scan склеивает эти вызовы: сопоставляет сеансы с процессом по UUID, переводит единицы и сортирует по памяти. Код возврата 2 означает, что есть процесс выше порога, так что её можно повесить на мониторинг. Путь к rac на Linux в примере типовой, у вас он может отличаться:
Без утилиты то же делает find_bloat_sessions.sh (bash и awk). Вывод скрипта на стенде:
Процесс 23356, идентификатор в кластере: 1348094d-59ba-43f5-8466-62cd1f9386cf
СЕАНС ПОЛЬЗОВАТЕЛЬ ПРИЛОЖЕНИЕ ПАМЯТЬ, МБ ВЫЗОВ, С
13      DefUser              BackgroundJob           288         43
15      DefUser              BackgroundJob             5         35
Есть тонкость для Windows. rac.exe заканчивает строки парой CR LF и пишет кириллицу в кодовой странице консоли (cp866). В awk без tr -d '\r' сравнения $2==pid дают ложь. Python с decode("utf-8") падает на первом русском слове. Скрипты и утилита из архива это учитывают.
Шаг 2. Прервать вызов виновника
rac умеет две вещи с сеансом. interrupt-current-server-call прерывает текущий серверный вызов, terminate завершает сеанс. Обе принимают --error-message, текст увидит пользователь:
Ключ --session ждёт UUID сеанса; номер из колонки session-id ему не подходит. Утилита переводит номер в UUID сама, и без --yes только печатает команду:
На стенде после команды сеанс 6 пропал из списка в течение десяти секунд. Память процесса при этом осталась на месте:
Порог: 300 МБ (memory-size процесса)
PID      Память, МБ  Соед.  Сеансов  Работает  Выше порога
13084           493      5        2        да  ДА
До команды процесс занимал 492 МБ, после - 493 МБ. Я повторил замер на трёх размерах таблицы значений. Задание строит таблицу из четырёх колонок и держит её в памяти, после чего завершается:
| Строк в таблице | Пик памяти сеанса, МБ | Пик памяти процесса, МБ | Процесс в конце замера, через 40-70 с после конца сеанса, МБ |
|---|---|---|---|
| 250 тыс. | 119 | 224 | 223 |
| 500 тыс. | 240 | 302 | 297 |
| 1 млн | 480 | 491 | 484 |
Получается около 480 байт на строку для такой таблицы (строки вида «Номенклатура 123», число, дробное число). Сеанс завершился, а процесс rphost память ОС не вернул:

Рис. 1. Замер rac process list и rac session list раз в 3 секунды. Красная линия: процесс. Синяя: сеанс.
Оговорка про область вывода. Это Windows и платформа 8.3.27.2130. Что делает с освобождённой памятью rphost под Linux, я не проверял. Модель аллокатора glibc разобрана ниже в отдельном разделе.
В rac session interrupt-current-server-call я проверил только фоновое задание. Как ведёт себя сеанс пользователя с открытой формой после прерывания вызова, на стенде не смотрел.
Шаг 3. Вывести процесс: rac process turn-off
Когда сеанса-виновника уже нет, а процесс держит память, остаётся выключить сам процесс. В rac help process три команды: info, list и turn-off. Команды process update или process edit в этой версии нет, ключей --is-running и --is-enabled тоже.
Что произошло на стенде, по шагам:
- К этому моменту тяжёлое задание уже прервано (шаг 2). На процессе PID 13084 остались лёгкое задание и COM-соединение, которое я держал открытым.
- Команда вернула 0. В течение нескольких секунд в списке появился новый процесс PID 23020 с памятью 79 МБ.
- Старый процесс продолжил работать. Лёгкое задание доработало до конца, а вызов
Пинг()в COM-соединении вернул тот же номер соединения (209) до и после команды. - Когда последний сеанс закончился, старый процесс пропал из списка. Это случилось примерно через 40 секунд после
turn-off.
== 5. scan сразу после drain
PID      Память, МБ  Соед.  Сеансов  Работает  Выше порога
13084           499      5        2        да  ДА
23020            79      1        0        да

== 6. примерно через 40 с
PID      Память, МБ  Соед.  Сеансов  Работает  Выше порога
23020           122      3        0        да

Рис. 2. Красная линия: старый процесс. Синяя: память его сеанса. Зелёная: новый процесс. Оранжевая вертикаль: момент команды.
Мягкий вывод не гарантирует, что старый процесс освободится быстро. Он живёт, пока живёт последний его сеанс, а интерактивный сеанс может висеть весь рабочий день. Поэтому скрипту вывода я добавил ключ ожидания: soft_drain_rphost.sh 13084 --yes --wait 300 печатает число соединений раз в 5 секунд и сообщает, когда процесс завершился. Версия для PowerShell - soft_drain_rphost.ps1 -TargetPid 13084 -Yes -WaitSec 300.
Не проверено: сеансы толстого и тонкого клиента с открытыми формами, долгие транзакции в СУБД в момент выключения, выключение процесса под нагрузкой сотни соединений.
После инцидента: записать в журнал, какой метод занял память
Найденный сеанс отвечает на вопрос «кто». Вопрос «что он вызвал» решает технологический журнал. Событие CALL содержит свойства Memory и MemoryPeak, по второму можно отфильтровать только тяжёлые вызовы. Конфигурацию печатает утилита:
Файл кладётся в каталог conf платформы. В C:\Program Files (x86)\1cv8\conf без прав администратора записать нельзя. Я положил файл в каталог пользователя (%LOCALAPPDATA%\1C\1cv8\conf\logcfg.xml), и журнал заработал для всех процессов кластера, потому что я запускал ragent под своей учётной записью. Как ведёт себя служба под другой учётной записью, я не проверял.
Запись, которую получил стенд для задания на 600 тыс. строк:
45:02.714000-25066973,CALL,1,level=INFO,process=rphost,OSThread=15876,t:clientID=25,callWait=0,first=1,Usr=DefUser,SessionID=30(29),p:processName=rlab,Func=Background job,Module=РЛаб,Method=Нагрузка,Memory=-1417016,MemoryPeak=301783072,InBytes=0,OutBytes=609,CpuTime=14328125
Как читать:
MemoryPeak=301783072: пик памяти вызова в байтах, около 288 МБ;Memory=-1417016: изменение памяти процесса за вызов. Отрицательные значения возможны, поэтому это разность;Module=РЛаб,Method=Нагрузка: общий модуль и процедура фонового задания. Они и есть ответ на вопрос «что вызвали»;Usr,SessionID,p:processName: пользователь, сеанс и база.
Число после дефиса в начале строки (25066973) - длительность вызова в микросекундах, то есть 25 секунд. Запись появляется, когда вызов завершился. Пока тяжёлый вызов идёт, его видно только в rac.
Чего в моих записях нет:
- Свойства
Context(строка кода BSL) вCALLфонового задания. Документация перечисляетContextсреди свойствCALL, но на моём стенде оно не появилось. Строку модуля из журнала я не получил, только модуль и метод; - Событие
MEM. Я включил его вlogcfg.xmlбез условий, но за все прогоны в журнал не попало ни одной записиMEM. Как заставить его сработать, не выяснил; - Оценку «менее 50 МБ в сутки». На стенде нет живой нагрузки, чтобы её проверить.
Каталог журнала платформа создаёт для каждого процесса, который запустил rac, powershell или 1С. Фильтр отсекает содержимое (файлы в этих каталогах по 3 байта), но каталоги остаются.
Откуда берётся память: замеры по приёмам BSL
Задания выполнялись фоновыми заданиями на свежем процессе. Пик берётся из MemoryPeak записи CALL.
| Приём | Данные | Пик памяти вызова |
|---|---|---|
Запрос, Выгрузить() в таблицу значений |
1 млн строк, 3 колонки | 452 МБ |
Тот же запрос, обход через Выбрать() и Следующий() |
1 млн строк | 216 МБ |
| Общий модуль с повторным использованием «на время сеанса», массив из 1 млн строк | один сеанс | 115 МБ |
| То же, два сеанса на одном процессе | каждый сеанс | 115 МБ, память процесса выросла с 125 до 308 МБ |
ПрочитатьJSON в соответствие целиком |
файл 46 МБ, 500 тыс. объектов | 715 МБ, в 15,6 раза больше файла |
Частая ошибка: ПрочитатьJSON вызвана на имени свойства массива |
тот же файл | 844 МБ, прочитан 1 элемент (весь массив) |
| Потоковое чтение по элементам | тот же файл | ниже порога журнала (1 МБ), память процесса осталась 126 МБ |
Обход через Выбрать() вдвое экономнее Выгрузить(), но память тоже занимает: 216 МБ на миллион строк. Ограничивать выборку по периоду и полям имеет смысл в любом случае.
Кэш «на время сеанса» хранится в сеансе. Каждый сеанс, вызвавший функцию, получает свою копию: два сеанса дали две копии по 115 МБ. С сотней сеансов копий будет сотня, но такой нагрузки на стенде не было.
С потоковым чтением JSON легко ошибиться, и ошибка стоит памяти. ПрочитатьJSON читает следующее значение и сама двигает читатель. Если вызвать её, когда читатель стоит на имени свойства items, она прочитает весь массив целиком. Если вызвать на начале объекта, платформа выдаст «Недопустимое состояние потока чтения JSON». Рабочий вариант, проверенный на 500 тыс. элементов: встать на начало массива и читать элементы, пока функция не вернёт Неопределено:
Признак конца массива сработает и на элементе null, если он есть в вашем файле. Проверяйте формат обмена.
Модули для всех замеров этой таблицы лежат в архиве (stand/RLab.bsl, stand/RLabКэш.bsl). Синтаксис проверен /CheckModules на 8.3.27.2130.
Приёмы, которые я не проверял: временное хранилище с привязкой и без привязки к форме, циклические ссылки в контексте управляемой формы, ФабрикаXDTO.ПрочитатьXML.
Linux: арены glibc, malloc_trim и systemd
Платформу под Linux я не запускал. Что можно проверить без неё - поведение аллокатора glibc, которым пользуются процессы на Linux. Две программы на C собраны в Debian 12 (glibc 2.36, 4 ядра). Исходники лежат в архиве, каталог linux.
Фрагментация. Программа выделяет 500 тыс. блоков по 1000 байт, освобождает 99% из них и оставляет каждый сотый:
выделено 500000 x 1000 байт    RSS=485 МБ
освобождено 99% блоков         RSS=485 МБ
после malloc_trim(0)           RSS=29 МБ
free() вернул блоки аллокатору, но не ОС: 485 МБ остались за процессом. malloc_trim(0) отдал свободные страницы, и RSS упал до 29 МБ. Значит, освобождённая память остаётся за процессом, пока кто-нибудь не вызовет malloc_trim. Вызывает ли его rphost, я не выяснял.
Арены. Программа запускает N потоков, каждый выделяет 100 КБ:
| Потоков | Переменная | VIRT | RSS |
|---|---|---|---|
| 4 | - | 290 МБ | 1 МБ |
| 64 | - | 2498 МБ | 8 МБ |
| 64 | MALLOC_ARENA_MAX=2 |
581 МБ | 8 МБ |
По man mallopt, на 64-разрядной системе glibc создаёт до 8 арен на ядро, то есть на моих 4 ядрах до 32, и резервирует под каждую адресное пространство. Замер согласуется: 64 потока дали 2498 МБ VIRT. RSS не растёт, поэтому большой VIRT сам по себе не признак утечки.
Systemd. В примерах для среза (.slice) встречается MemoryOOMScoreAdjust=-500. Такого ключа нет: systemd-analyze verify на systemd 252 пишет Unknown key 'MemoryOOMScoreAdjust' in section [Slice], ignoring. Ключ OOMScoreAdjust= существует для служб (секция [Service]), и systemd-analyze verify принял его вместе с MemoryHigh= и MemoryMax=.
Режим vm.overcommit_memory=2. По документации ядра, лимит выделения в этом режиме равен swap + RAM × overcommit_ratio / 100, а при превышении процесс получает ошибку выделения памяти вместо вызова OOM Killer. То есть malloc в rphost начнёт возвращать ошибки. Как платформа на них реагирует, я не проверял, поэтому включать режим на рабочем сервере из-за этой статьи не советую.
Что кластер делает сам
Два параметра из справки rac, которые обещают ограничить память процессов, на стенде себя вели по-разному:
| Команда | Что вернула | Что в кластере после |
|---|---|---|
cluster update --max-memory-size=350000 --max-memory-time-limit=20 |
код 0 | оба значения остались 0 |
server update --safe-call-memory-limit=200000000 |
код 0 | значение записано |
Первая команда ничего не записала, при этом rac не сообщил об ошибке. Читайте параметры обратно после каждой записи. Вторую я применил и запустил вызов с MemoryPeak 453 МБ. Я наблюдал 100 секунд: вызов не оборвался, процесс не перезапустился. Что именно делает этот параметр на превышение, я не выяснил.
Если не работает
| Симптом | Причина | Что сделать |
|---|---|---|
rac печатает кракозябры или Python падает на decode |
rac.exe пишет в cp866 (Windows) |
декодировать в cp866, утилита из архива пробует UTF-8, затем cp866 |
awk не находит процесс на Windows |
строки вывода заканчиваются CR LF | пропустить вывод через tr -d '\r' |
rac вернул код 4294967295, «Сервер баз данных не обнаружен... could not translate host name "127.0.0.1:5442"» |
порт СУБД в строке сервера БД | --db-server="127.0.0.1 port=5442" |
could not open extension control file ".../mchar.control" |
обычный PostgreSQL без расширения mchar |
сборка Postgres Pro для 1С или PostgreSQL, собранный по инструкции 1С |
DESIGNER с Srvr=localhost:1640;Ref=база: «Адрес не является адресом кластера серверов 1С:Предприятия» |
1640 - порт ragent, клиент подключается к порту кластера |
взять порт кластера из rac cluster list (поле port), у меня 1641 |
В scan у раздутого процесса нет сеансов |
память держит сам процесс, сеансов на нём уже нет | вывести процесс через turn-off |
turn-off вернул 0, а процесс не исчез |
на процессе остались сеансы | soft_drain_rphost.sh PID --wait 300 покажет число соединений |
Записи MEM нет в журнале |
событие в моих прогонах не срабатывало | использовать CALL и MemoryPeak |
Что не проверено
- Платформа под Linux: пути, кодировка вывода
rac, работаrphostс glibc. - Сеансы с формами, толстый и тонкий клиент,
interrupt-current-server-callна пользовательском сеансе. - Служба ragent под учётной записью службы,
logcfg.xmlв системном каталогеconf. - Событие
MEM, свойствоContextвCALLфонового задания. - Влияние
safe-call-memory-limitна вызов, поведение лимитов кластера при превышении. - Платформы, отличные от 8.3.27.2130.
- Нагрузка в сотни сеансов и объёмы от гигабайта: стенд занимал до 850 МБ.
Чек-лист дежурного
rphost_memory_doctor.py scan --threshold-mb 4096: процесс и сеансы по убыванию памяти.interrupt --session N --yes: прервать вызов виновника. Если память процесса не упала, это нормально (Рис. 1).scanещё раз: убедиться, что сеанс пропал и что осталось на процессе.drain --pid PID --yesилиsoft_drain_rphost.sh PID --yes --wait 300: вывести процесс, дать остальным доработать.- Включить
logcfg(logcfg --min-mb 100), чтобы следующий тяжёлый вызов остался в журнале с модулем и методом. - Передать разработчикам
Module,MethodиMemoryPeakиз записиCALL.
Все команды, кроме scan, без --yes только печатают то, что собираются сделать.
Вопрос читателям
Что показал scan на вашем сервере? Особенно интересны: платформа под Linux (возвращает ли rphost память после завершения сеанса), сервер с несколькими рабочими процессами и сеансы с открытыми формами при turn-off. Напишите версию платформы и ОС, если вывод разошёлся с моим.
Другие материалы автора по теме
Вступайте в нашу телеграмм-группу Инфостарт