Партицированная дисциплина в 1С: явная граница Index Seek при join больших регистров сведений на MS SQL
Партицированная дисциплина программиста в 1С нужна там, где регистры сведений с версионным хранением и разделителями БСП упираются в MS SQL: даже при корректном join к временной таблице идентификаторов оптимизатор выбирает Merge Join и Index Seek только по разделителю и прокачивает почти весь индекс. Ниже разбор кейса на SQL Server 2019: как читать план, зачем явная нижняя граница по следующему ключу индекса и почему это аналог partitioning column без физических партиций.
Когда партиций нет, а дисциплина «как у партиций» обязательна
В типовых конфигурациях 1С:Предприятие 8.3 партицирование таблиц на стороне СУБД упирается в общие реквизиты и разделители. Платформа ставит разделитель первым полем в индексы, и для большинства типовых решений это оправдано. Часть объектов метаданных разнесена по нескольким таблицам без одного осмысленного partition column: регистры бухгалтерии, документы с табличными частями. Классификацию таких случаев подробно разбирают в материале «Методика похудения для 1С - 100%»; для нашей темы достаточно помнить, что «просто включить партиции» на всю базу не получится.
Долго казалось, что поможет железо и штатное партицирование SQL Server. Узкое место сместилось в текст запросов: без явного сужения по ключу индекса seek по разделителю формально корректен и по факту слишком широк. Отсюда партицированная дисциплина программиста: для каждого тяжёлого обращения к большой таблице 1С задавать границу, с которой оптимизатор отсекает хвост индекса, как partition elimination при работе с партициями.
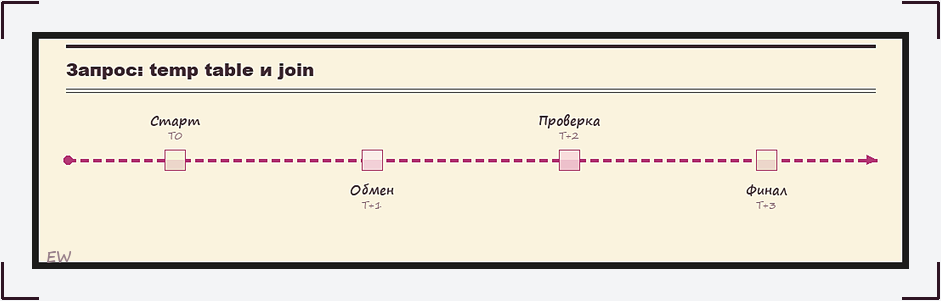
Цепочка ПОМЕСТИТЬ и join регистра транзакций к сделкам
На рисунке выше зафиксирована цепочка, с которой начинали замеры: отбор идентификаторов во временную таблицу и join к регистру сделок. Речь не об инциденте у пользователя, а о порядке шагов в одном пакете запросов платформы.
Версионные регистры сведений и join через временную таблицу
Операции лежат в двух регистрах сведений: агрегированные денежные трансферы со ссылкой на сделку и агрегированные сделки. Документы для потоковой загрузки не подошли: нужна максимальная скорость импорта пакетами по тысяче записей без обновлений по измерениям. Версионное хранение завязано на поле Период как дату и время загрузки версии; пишутся только новые наборы записей. Пакетная запись без обновлений по измерениям подробнее описана в материале «Язык мой враг мой». Минус переносится на выборку: позже где-то придётся брать последние версии по измерениям, но это отдельная тема и не цель текущего разбора.
Контекст: Версионные регистры сведений и join через временную таблицу
Масштабы на MS SQL Server 2019 (15.0.2000.5): порядка 210 миллионов строк в регистре сделок и около 474 миллионов в регистре транзакций. Задача сопровождения: отобрать трансферы по критериям (в том числе Период не раньше параметра), собрать DISTINCT идентификаторов связанной операции во временную таблицу, проиндексировать её и соединить с регистром сделок по полю идентификатора в исходной системе.
Прямой join «последних срезов» трансферов и сделок сознательно не рассматривали: у объектов разные наборы версий, а выборка актуальных версий в одном запросе с join на сотни миллионов строк оказалась бы ещё тяжелее. Временная таблица стала компромиссом между скоростью загрузки и сложностью последующей аналитики.
Базовый запрос и что показывает план на MS SQL
Первый шаг на языке запросов 1С: собрать уникальные идентификаторы операций из транзакций за интервал и положить их во временную таблицу с индексом по ключу соединения.

Контекст: Базовый запрос и что показывает план на MS SQL
ВЫБРАТЬ РАЗЛИЧНЫЕ
    Транзакции.СвязаннаяОпИдИсхСистемы КАК ИдСделкиИзТранзакции
ПОМЕСТИТЬ ВремИдИзТранзакций
ИЗ
    РегистрСведений.СУУ_АгрегированныеДенежныеТранзакции КАК Транзакции
ГДЕ
    Транзакции.Период >= &ДатаНачала

ИНДЕКСИРОВАТЬ ПО
    ИдСделкиИзТранзакции;

ВЫБРАТЬ
    Сделки.Период,
    Сделки.ИсходнаяСистема,
    Сделки.ИдИсхСистемы,
    Сделки.ОсновнойСчет,
    Сделки.НогаСделки
ПОМЕСТИТЬ РезультатСделокПоИд
ИЗ
    РегистрСведений.СУУ_АгрегированнаяСделкаКП КАК Сделки
        ВНУТРЕННЕЕ СОЕДИНЕНИЕ ВремИдИзТранзакций КАК ИдИзТранзакций
        ПО Сделки.ИдИсхСистемы = ИдИзТранзакций.ИдСделкиИзТранзакции
На стороне SQL платформа разворачивает это во временные таблицы tempdb (#tt1, #tt2) и INSERT…SELECT с фильтром по разделителю области данных. Фактический текст последнего шага join выглядит так:
INSERT INTO #tt2 WITH (TABLOCK)
    (_Q_001_F_000, _Q_001_F_001RRef, _Q_001_F_002, _Q_001_F_003RRef, _Q_001_F_004RRef)
SELECT
    СделкиРег._Period,
    СделкиРег._Fld18861RRef,
    СделкиРег._Fld18865,
    СделкиРег._Fld18863RRef,
    СделкиРег._Fld19363RRef
FROM dbo._InfoRg18860 AS СделкиРег WITH (NOLOCK)
    INNER JOIN #tt1 AS ВремИд WITH (NOLOCK)
        ON СделкиРег._Fld18865 = ВремИд._Q_000_F_000
WHERE СделкиРег._Fld628 = @P1;
Чтобы сравнивать планы, а не кэш прошлых прогонов, перед серией замеров сбрасывали wait stats, кэш планов и чистые буферы (DBCC SQLPERF для sys.dm_os_wait_stats, FREEPROCCACHE, DROPCLEANBUFFERS). Это лабораторная методика: на продуктиве так делать нельзя, но для сопоставления Nested Loop и Merge Join на одном тексте запроса она даёт повторяемую картину.
Фактический план с MS SQL снимаю так: в SSMS включаю «Include Actual Execution Plan» и выполняю тот же SQL, что сгенерировала платформа; либо собираю Extended Events с событием sqlserver.query_post_execution_showplan; либо трассировку с showplan. Обычно сверяю estimated и actual rows на join и на Index Seek, а не одну цифру времени из клиента 1С.
Batch 1С и ответ SQL Server с планом выполнения
Сеанс 1С и SQL Server обмениваются параметризованным batch: сервер возвращает план и статистику операторов. Если смотреть только факт «запрос выполнился», граница seek в плане остаётся незаметной.
Nested Loop, Merge Join и ловушка «правильного» плана
Пока во #tt1 лежало порядка 100–200 тысяч идентификаторов, SQL Server брал Nested Loop: соединение помещалось в память, Merge Join не включался. На копии базы с урезанным периодом такой план легко ввести в заблуждение: он не переносится на месячную выборку с миллионами ключей.
Контекст: Nested Loop, Merge Join и ловушка «правильного» плана
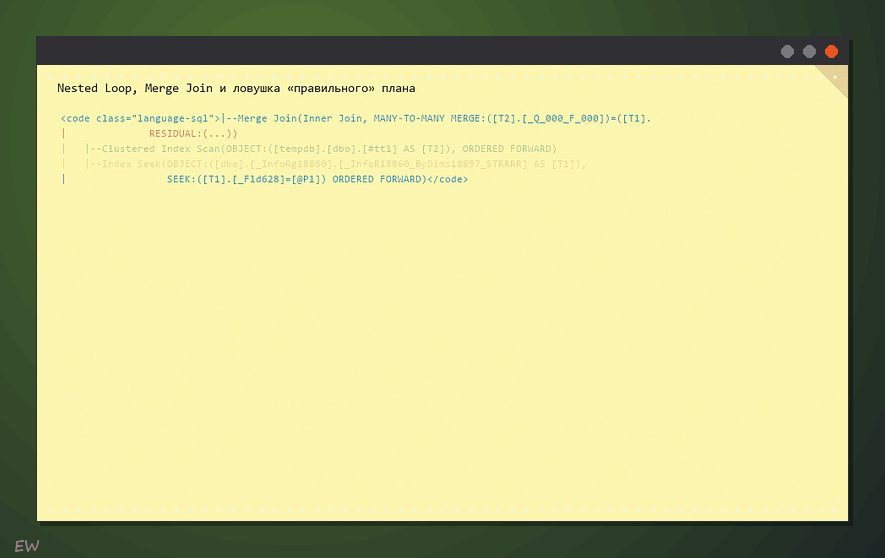
Когда период по транзакциям расширили до типичного месяца, во #tt1 оказалось около 20 миллионов строк. План сменился: Clustered Index Scan по #tt1 ORDERED FORWARD и Index Seek по индексу сделок _InfoR18860_ByDims18897_STRRRR с полем идентификатора _Fld18865, Merge Join Inner, MANY-TO-MANY. Сортировки по ключам join совпадают, картина выглядит здоровой.
На этом этапе соблазно решить, что раз Merge Join, осталось подкрутить MAXDOP или память. Фактический план показал иное. Seek по сделкам шёл только по разделителю _Fld628 = @P1 (общий реквизит области данных), без предиката на следующие ключи индекса. В поток Merge Join ушло порядка 210 649 142 строк, то есть фактически весь индекс по области, хотя #tt1 содержала около 20 миллионов ключей.
|--Merge Join(Inner Join, MANY-TO-MANY MERGE:([T2].[_Q_000_F_000])=([T1].[_Fld18865]),
|              RESIDUAL:(...))
|   |--Clustered Index Scan(OBJECT:([tempdb].[dbo].[#tt1] AS [T2]), ORDERED FORWARD)
|   |--Index Seek(OBJECT:([dbo].[_InfoRg18860].[_InfoR18860_ByDims18897_STRRRR] AS [T1]),
|                 SEEK:([T1].[_Fld628]=[@P1]) ORDERED FORWARD)
Оптимизатор MS SQL не выводит автоматически min/max идентификатора из #tt1 как верхнюю и нижнюю границу seek по _Fld18865, если в тексте запроса нет явного условия. Разделитель в WHERE обязателен для мультитенантности, но как единственный предикат seek он закрывает лишь первый столбец индекса. Время растёт с размером таблицы сделок при фиксированном объёме #tt1.
Отдельно смотрели оценку cardinality по #tt1. После ПОМЕСТИТЬ большого набора статистика на временной таблице на стороне SQL часто неточна; в actual plan сверяем estimated и actual rows на scan #tt1. При прямом T-SQL иногда помогает UPDATE STATISTICS на #tt1. Неверная оценка чаще меняет выбор между Nested Loop и Merge Join, но симптом сохранялся и при «ожидаемом» Merge Join: широкий ordered seek по сделкам.
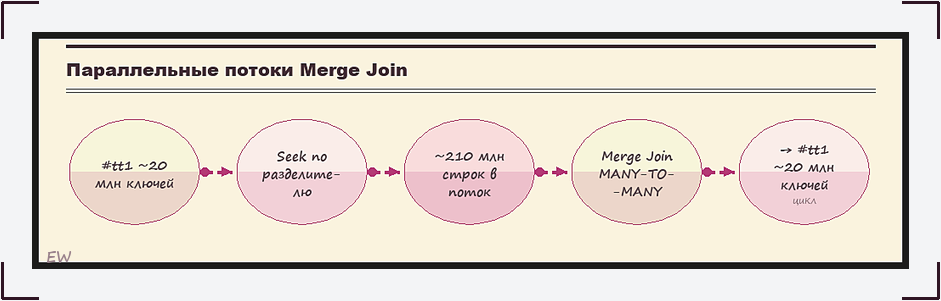
Scan #tt1 и широкий Index Seek по _Fld628
На иллюстрации параллельно идут два потока: компактный scan временной таблицы и широкий seek по регистру сделок. Пока второй поток не сужен следующим ключом индекса, стоимость join привязана к полному объёму области, а не к двадцати миллионам идентификаторов.
Явная граница seek: Период и порядок ключей индекса
Имя индекса регистра сведений _InfoR18860_ByDims18897_STRRRR читается по правилам платформы: префикс _InfoRg, блок ByDims с перечислением измерений, суффиксы типов полей. Суффиксы намекают на типы столбцов в ключе; точный порядок проще сверить с sys.index_columns на копии базы, чем угадывать по одному _Fld*. Поле для «границы seek» выбирают по этому порядку и по предикатам в запросе. Фильтр по реквизиту, который в jоин-индексе стоит дальше по ключу, чем вы думали, seek не сузит так же, как предикат по Период сразу после разделителя.
Контекст: Явная граница seek: Период и порядок ключей индекса
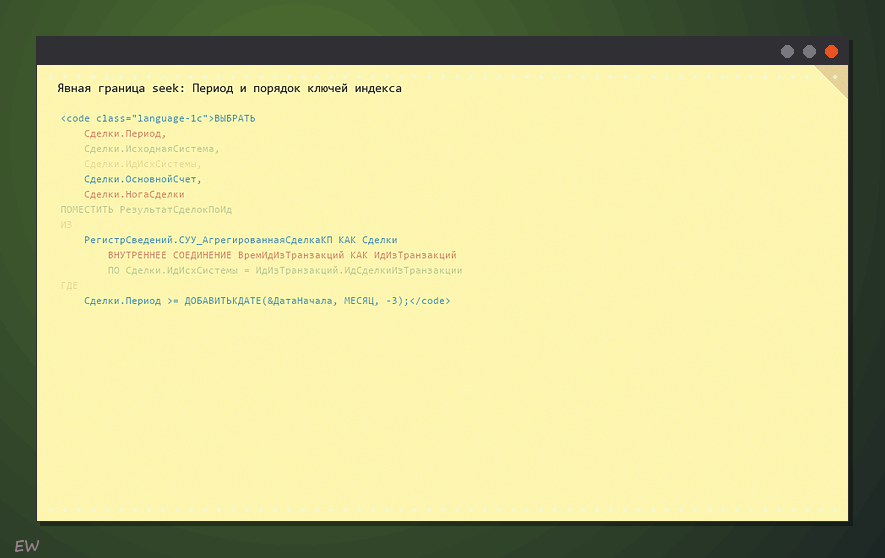
В рассматриваемом индексе после разделителя участвует идентификатор _Fld18865; следующий ключ, которым можно осмысленно сузить версионный регистр, это _Period (в метаданных 1С поле Период версии). К запросу ко второму регистру добавили условие по периоду загрузки, согласованное с отбором транзакций, со сдвигом на три месяца назад от &ДатаНачала:
ВЫБРАТЬ
    Сделки.Период,
    Сделки.ИсходнаяСистема,
    Сделки.ИдИсхСистемы,
    Сделки.ОсновнойСчет,
    Сделки.НогаСделки
ПОМЕСТИТЬ РезультатСделокПоИд
ИЗ
    РегистрСведений.СУУ_АгрегированнаяСделкаКП КАК Сделки
        ВНУТРЕННЕЕ СОЕДИНЕНИЕ ВремИдИзТранзакций КАК ИдИзТранзакций
        ПО Сделки.ИдИсхСистемы = ИдИзТранзакций.ИдСделкиИзТранзакции
ГДЕ
    Сделки.Период >= ДОБАВИТЬКДАТЕ(&ДатаНачала, МЕСЯЦ, -3);
В плане на T-SQL появился дополнительный предикат seek по _Period. Оценочная стоимость фрагмента в тесте автора снизилась с 11424 до 7801 (без обещания тех же секунд на проде). Для сопровождения важнее другое: в seek появилась нижняя граница по следующему ключу после разделителя, а не только @P1.
Если по смыслу данных граница по Период недоступна, можно сужать по бизнес-дате операции (в исходном кейсе поле «Дата»), но только когда она входит в тот же индекс или есть другой подходящий индекс. Иначе filter или scan вынесутся из мерге-потока и план снова станет неожиданным.
Краткая альтернатива из того же опыта: ограничение по минимальному значению идентификатора из #tt1 (подзапрос или второй проход). Для строкового типа идентификатора сравнение min/max и collations проверяют отдельно; lexicographic min не всегда совпадает с бизнес-минимумом.
Параметр @P1 на разделитель напоминает про parameter sniffing: план с широким seek при одной области данных может отличаться от плана при другой. Query Store в MS SQL 2019 помогает поймать регрессию плана при изменении &ДатаНачала и объёма #tt1, но явные границы в тексте запроса всё равно прописывают вручную.
Партицированная дисциплина: чек-лист для больших запросов
Правило, которое мы зафиксировали в регламенте отчётов и регламентных выгрузок: для каждого тяжёлого обращения к регистру сведений с разделителем в индексе явно задавать нижнюю и при необходимости верхнюю границу по следующему ключу seek, по аналогии с partitioning column. Одного попадания в индекс по _Fld628 мало.
- Сопоставить имя индекса _InfoRg*_ByDims* с полями в WHERE и ON.
- После отбора во #tt1 проверить в actual plan actual rows на Merge Join и Index Seek по регистру.
- Не доверять плану на 100 тысячах строк, если на проде ожидаются миллионы идентификаторов.
- При смене &ДатаНачала сверить план в Query Store, не полагаясь на один успешный прогон.
- Если добавили фильтр по Период или Дате, убедиться, что поле стоит в нужном месте ключа индекса.
Смежные темы за рамками статьи: выбор последних версий в версионном регистре, тонкая настройка партиций SQL под 1С, хинты как единственный способ лечения. Их не смешивают с базовой дисциплиной границы seek.
Три вывода из кейса
- Index Seek по разделителю на таблице в сотни миллионов строк может отдавать в Merge Join весь индекс области; join здесь ни при чём, не хватает явной границы по следующему ключу.
- Версионное хранение в регистрах сведений и join через временную таблицу меняют постановку задачи: оптимизация join к «сырой» таблице версий не сводится к индексу только по идентификатору.
- Партицированная дисциплина программиста в 1С - осознанный предикат по полю индекса после разделителя (Период, идентификатор или согласованная бизнес-дата), как partition elimination без физических партиций.
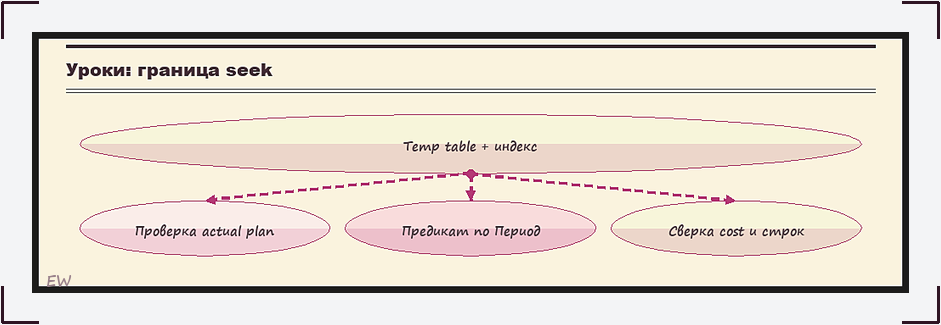
От широкого seek к границе по Период
Итоговая диаграмма собирает цепочку: temp table с индексом, join по идентификатору, проверка плана, добавление границы seek, повторная сверка стоимости и строк.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

