Данные из базы 1С удалили, а файл на диске не уменьшился: две ночи сжатия
База данных - Администрирование СУБД
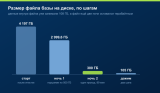
Самое приятное число в проекте обрезки базы мы получили за пару минут. После очистки служебного кэша внутри файла данных осталось 108 ГБ занятого места. До очистки было занято 4 108 ГБ, а сам файл на диске весил 4 197.
Но сам диск этого не заметил: файл как занимал 4 197 ГБ, так и продолжал занимать. Свободного места на сервере практически не осталось. Чтобы вернуть его системе, потребовалось две ночи. В первую ночь всё шло по плану — удалось сжать файл с 4,2 ТБ на 1,2 ТБ. А вот вторая ночь пошла уже не по плану, но в итоге мы справились.
Кейс тот же, что в статье 3,85 ТБ мёртвого кэша: розничная сеть fashion-сегмента, три страны, около двухсот касс, MS SQL Server. Там разбиралось, почему данные мёртвые и почему их можно убирать. Здесь продолжение, о котором та статья молчит: что происходит с файлом после того, как данные ушли.
Свободно внутри файла и свободно на диске - разные числа
Удаление данных освобождает страницы внутри файла, и только. SQL Server однажды выделил под базу 4 197 ГБ и отдавать их обратно сам не станет. Для него это нормальное поведение: база выросла один раз, вырастет снова, зачем дёргать диск.
На тестовой копии базы мы увидели это в чистом виде. Размер у копии чуть отличался от боевой, 4 099 ГБ. Замеры после двух раундов очистки:
| Что меряем | До очистки | После первого раунда | После второго раунда |
|---|---|---|---|
| Занято данными внутри файла | 4 099 ГБ | 386 ГБ | 160 ГБ |
| Свободно внутри файла | меньше 1 ГБ | 3 713 ГБ | 3 940 ГБ |
| Размер файла на диске | 4 099 ГБ | 4 099 ГБ | 4 099 ГБ |
Освободили 96 % объёма, последняя строка не сдвинулась ни на гигабайт.
Поэтому на фразу "база похудела" первый вопрос всегда один: что именно похудело, данные или файл. Мы сами, готовя материалы по этому проекту, однажды приняли занятое место за размер файла и подняли ложную тревогу.
Бэкапа это, к слову, почти не касается. Сжатый полный бэкап берёт только занятые страницы, и он похудел вместе с данными: после первой ночи весил 21 ГБ при файле почти в три терабайта. Сжатие файла нужно диску, бэкапу оно ничего не добавляет.
Почему быстрый вариант не сработал
У команды сжатия есть режим TRUNCATEONLY. Страниц он не двигает, фрагментации не добавляет, просто отрезает пустой хвост файла. На тестовой копии он шёл сразу после очистки.
Результат: файл остался ровно тем же.
Режим отрезает только свободное место в конце файла, после последней занятой страницы. У нас свободное место оказалось разбросано по всему файлу, и ближе к концу стояли живые страницы, которые держали хвост.
На втором раунде очистки картина повторилась нагляднее. Первый раз TRUNCATEONLY ответил мгновенно, второй шёл шесть минут и снова не вернул ни гигабайта: свободные участки были рассыпаны по середине файла, сервер их перебирал, а отрезать в конце было нечего.
Если база росла годами, а освобождённое место лежит вперемешку с живыми данными, мгновенного сжатия не будет. Понадобится полное, с перемещением страниц, и оно стоит времени.
План: порциями, несколько ночей
Полное сжатие переносит занятые страницы из конца файла в свободные места ближе к началу и потом отрезает освободившийся хвост. Отсюда его репутация: долго, однопоточно, упирается в диск, после него индексы фрагментированы.
В нашем регламенте до прода стояла ровно эта картина. Сжатие 3,84 ТБ - самая долгая часть всей работы, часы или несколько ночей. Идти порциями, каждую ночь отрезать по куску. Прервать можно в любой момент, перенесённое не теряется.
С такой логикой трудно спорить: порция укладывается в окно, прерывание ничего не ломает. Эта гипотеза прожила одну ночь.
Ночь первая: порции застревают на хвосте
Первую ночь мы шли по плану, порциями по 500 ГБ. Файл уменьшился с 4 197 до 2 999,6 ГБ, диску вернулось 1,2 ТБ. До цели оставалось почти три терабайта.
Порция застревала на хвосте. Основной её объём переносился, а на последних гигабайтах сеанс повисал в ожидании SLEEP_TASK: в переводе с серверного это значит "жду", и работа при этом не идёт.
Сделанное мы фиксировали так: база переводилась в OFFLINE и обратно в ONLINE, после чего запускался TRUNCATEONLY. Перевод снимал зависшую операцию вместе со всеми сеансами. Перенесённые к этому моменту страницы уже стояли на новых местах, поэтому хвост за ними был свободен и теперь отрезался. Весь объём шага оставался за нами. Почему именно так снимается зависание, в отчёте не разобрано, это наша версия по результату.
Вторая находка той же ночи касалась расписания. База по автоматическим заданиям переключала модель восстановления: в 22:30 ставилось SIMPLE, в 00:02 возвращалось FULL. Сжатие пишет в журнал транзакций каждое перемещение страницы. В SIMPLE журнал очищается сам на контрольных точках. В FULL он копит всё до ближайшего бэкапа журнала, и терабайтное перемещение упирается в его потолок: ошибка 9002, журнал заполнен, операция стоит.
Правило после этой ночи: на всё время сжатия база стоит в SIMPLE, а задания, которые её переключают, на ночь работ надо знать заранее и отключить. После работ модель возвращается на место, иначе вы молча теряете восстановление на точку во времени.
Ночь вторая: один большой проход оказался быстрее
На вторую ночь мы сделали то, от чего план прямо отговаривал: запустили одно сжатие сразу с 2 999,6 до 300 ГБ. Без порций, одной командой.
Оно прошло за 89 минут.
Внутри этих полутора часов было две разные фазы. Первые примерно 45 минут ушли на работу, упиравшуюся в процессор. По отчёту это была фоновая доработка освобождения страниц, оставшаяся от очистки. SQL Server освобождает очень большие объёмы не сразу, сначала помечает их и разбирает потом, в фоне. Наша трактовка: "две минуты", за которые освободилось почти 4 ТБ, были минутами на пометку, а сама разборка шла ещё и во вторую ночь.
Вторая фаза пошла быстро. Оставшиеся примерно 44 минуты файл уменьшался в среднем на 50-60 ГБ в минуту: в отчёте стоит около 53, наш пересчёт 2 700 ГБ на 44 минуты, если считать, что весь объём ушёл во второй фазе, даёт 61. Обе исходные цифры приблизительные, поэтому читайте их как порядок, точного хронометража у нас нет.
Почему проигрывали порции, наша версия такая: каждая из них заново натыкалась на недоразобранные страницы, отсюда и хвосты с SLEEP_TASK. Отдельного замера под это нет, но фазы большого прохода с ней сходятся.
Дальше двумя шагами дожали файл с 300 до 105 ГБ. Данных к этому моменту было около 104 ГБ, так что файл встал почти впритык к ним.
От старта проекта: 4 197 ГБ превратились в 105, минус 97,5 %.
Что ещё останавливало сжатие
Кроме хвостов, операцию останавливали ещё три вещи, и все три к самому сжатию отношения не имели.
Ошибка 3140: параллельный бэкап. Плановый полный бэкап базы пришёлся на время сжатия, и операция упала: эти две вещи одновременно не идут. Дальше просто дождались конца бэкапа. В расписании на ночь работ стоит проверить все задания, которые трогают эту базу, а не только переключение модели восстановления.
Залипший флаг сжатия. После прерванных попыток база продолжала считать, что сжатие идёт, и новую операцию не принимала. Снялось тем же переводом в OFFLINE и обратно.
Чужой отчёт на соседней базе. На том же экземпляре SQL Server жила вторая база сети. Там зависший отчёт занял 24 потока, проработал 4,3 часа и душил весь сервер, сжатие нашей базы почти встало. После того как его сеанс сняли, сжатие пошло дальше. Перед ночью работ проверяйте не только свою базу, но и соседей по экземпляру: тяжёлое у соседа отнимает ресурсы у вас.
После сжатия: индексы и статистика
Сжатие переставляет страницы без оглядки на порядок, поэтому индексы после него фрагментированы почти гарантированно. Перестраивать их до сжатия бессмысленно, следующая операция всё перемешает снова. Порядок один: сначала сжатие, потом перестроение.
Перестроение 200 индексов заняло 44 минуты и прошло без единой ошибки. Вместе с ним обновили статистику, чтобы отчёты получили свежие планы. Занятое место внутри файла при этом ещё сократилось, с 104 до 90,7 ГБ: перестроенные индексы плотнее.
Последним шагом вернули модель восстановления FULL и сразу сняли полный бэкап, от которого теперь отсчитывается цепочка. Он весил 18,34 ГБ. До проекта ночной бэкап этой базы занимал 556 ГБ и шёл два часа, и похудел он благодаря очистке данных, сжатие файла тут было ни при чём.
Сколько места оставить
Сжимать файл в упор к данным не обязательно. База растёт, и автоприрост файла посреди рабочего дня может дать паузу пользователям. В итоговом отчёте это записано опцией: если нужен запас, файл можно разово выставить на 130-150 ГБ, хвост уже чистый, это минуты работы.
Отсюда и наш ответ на спор о том, вредно ли сжатие. Регулярное сжатие по расписанию вредно: файл сжимается, потом снова растёт, индексы каждый раз перемешиваются, и сервер тратит ночи на работу, которая ничего не меняет. После разовой очистки картина другая. Из базы ушло 97 % объёма, обратно он не вернётся, и сжатие тут самый короткий путь вернуть диск. Есть и штатный вариант с выгрузкой и загрузкой базы через DT, но замера на терабайтах по нему у нас нет, и сравнивать мы не берёмся.
С чего начинать, если база выросла
Всё описанное выше начинается после того, как стало понятно, что именно занимает место и что из этого можно убирать. Это главная часть работы: две ночи сжатия ничего не стоят, если удалили не то.
Первым шагом нужна карта: какие объекты базы сколько весят и где объём не совпадает с ожиданием. Для этого у нас есть обработка Карта объёмов базы 1С. Она обходит объекты метаданных платформенными средствами, отдельным списком показывает служебные таблицы, за которыми не стоит ни один объект, и считает долю каждого. На этой самой базе такая карта и показала, что 92 % объёма занимает мёртвый кэш разграничения доступа. Дальше решается, что из этого живое, что мёртвое и каким путём его убирать, и только потом очередь доходит до файла.
Вопрос к тем, кто сжимал базы от терабайта и больше: вы шли порциями или одним проходом? Нам интересно, повторяется ли картина с долгой первой фазой на других версиях SQL Server, или это особенность нашего случая, где освободилось почти всё.
Другие наши инструменты:
- Чек-ап СУБД под 1С - больше сорока проверок сервера баз данных с вердиктом: память, tempdb, журнал транзакций, статистика, параллелизм.
- Журнал транзакций переполнен: кто держит и что делать - находит из 1С транзакцию, которая не даёт журналу очиститься, и печатает скрипт для администратора.
- Чек-ап чистоты базы 1С: сколько займёт уборка и что сломается - оценивает объём будущей очистки и риски до того, как вы договорились об окне.
- Чек-ап сервера 1С: настройки кластера и рабочих процессов - проверяет настройки кластера 1С и рабочих процессов на типовые ошибки.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.


