Инструкция по выживанию при столкновении с интеграцией в дикой природе
Интеграция - Перенос данных 1C
Зачем нужен системный подход к интеграции
С 1С я в жизни практически не встречался. Но так получилось, что я довольно много работал в заказной разработке, в банках, в ритейле и во всяком разном кровавом энтерпрайзе, где много систем, коробок, которые нужно как-то связать, подружить, проинтегрировать.
В большом энтерпрайзе задачи интеграции встречаются постоянно. Хотя само слово «интеграция» мне не очень нравится. Скорее, это вообще история про интеграционную архитектуру, про что-то большое. По сути, мы строим какие-то распределенные системы.
И очень часто – я это чувствовал сам, слышал от коллег, наблюдал – масштабные задачи, где нам нужно подружить несколько систем, компонентов, сервисов или чего-то еще, решаются так, что каждый смотрит на свой кусочек, но какого-то цельного подхода нет.
Как нам реализовать новую фичу, продукт, проект – вставьте свое название в этот процесс – так, чтобы действительно ничего не продолбать, чтобы все работало, чтобы мы учли все нужные доработки, а ненужные не делали?
Один из вариантов такого, назовем это пафосного, фреймворка – последовательный, отчасти даже алгоритмичный подход к этой работе.
Он полезен для тех, кто периодически занимается задачами интеграции, но не всегда до конца понимает: что именно я сейчас делаю? Может быть, можно сделать по-другому? Как убедиться в том, что я ничего не забываю и все делаю правильно?
Разберем, как можно выжить, если вы столкнулись с какой-то большой интеграционной задачей.
Концептуальное проектирование
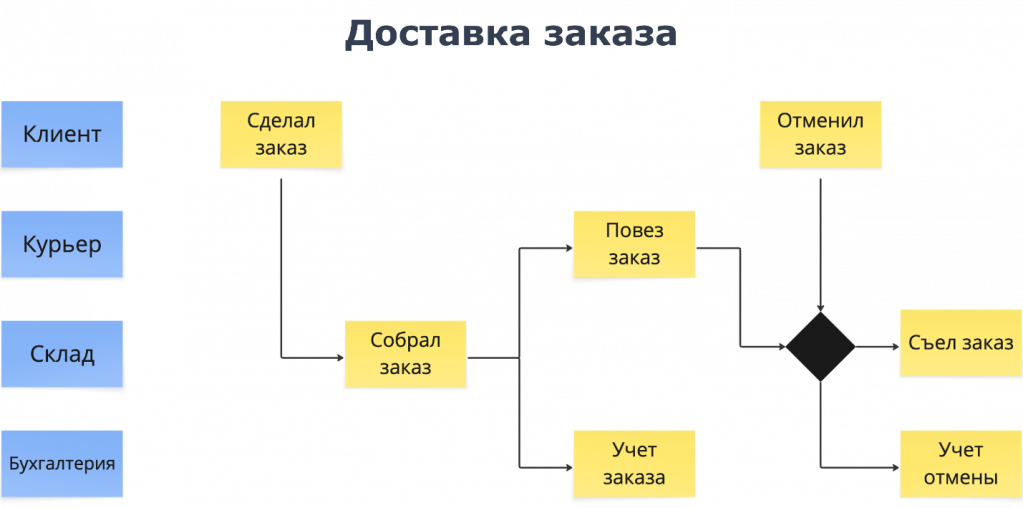
Например, прилетел новый проект: мы запускаем какой-то продукт или что-то в нем меняем. Допустим, появляется идея: «Давайте запустим доставку продуктов или товаров на дом».
У нас есть какой-то бизнес-процесс. Возможно, мы вместе определили его, посидели с заказчиками, а может быть, нам кто-то его уже принес – неважно. Главное, что обычно в этом фигурирует какой-то процесс, наверное, какие-нибудь требования, в нем участвуют люди, роли, отделы.
Первая мысль может быть такой: я вообще-то что-то поинтегрировать пришел, а вы мне процесс принесли. Что с этим делать?
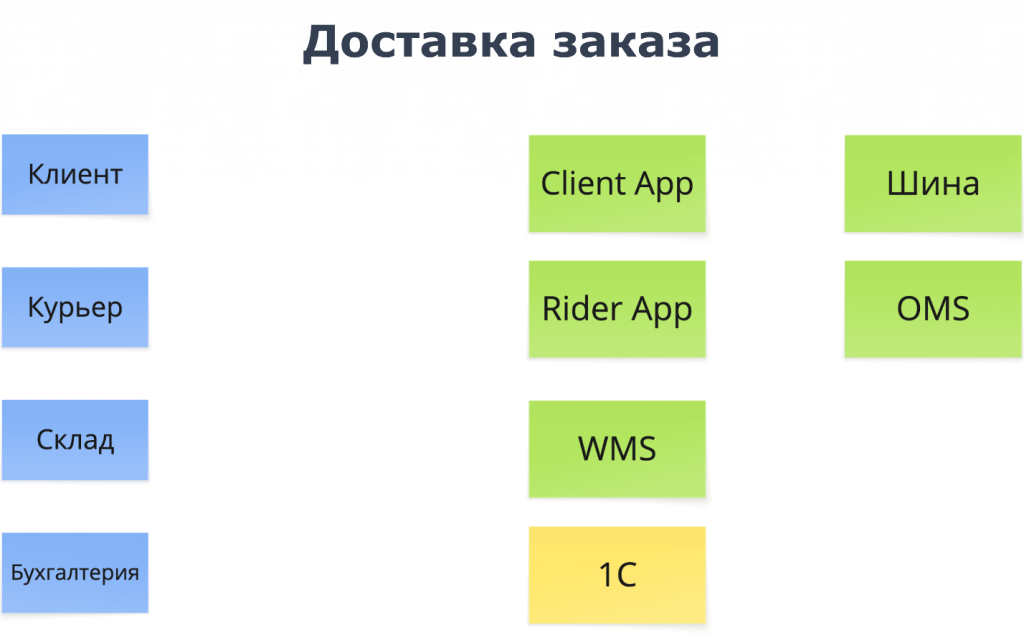
Если я работаю не первый день, то, возможно, уже подозреваю, что в компании есть какие-то системы, в которых внезапно работают люди.
Когда мы говорим о процессах, мы, во-первых, явно видим людей, пользователей и роли, которые в них участвуют. Какие-то еще роли уточним по ходу. И нам нужно понять, какие системы здесь задействованы.
Первое – это системы, которыми пользуются люди. Второе – возможно, какие-то скрытые, неявные системы вроде шины: технические системы, о которых пользователь и бизнес вообще могут ничего не знать и не слышать, но мы о них знаем.
Наша задача – взять этот процесс, намапить его на системы и понять, что где нужно.
Контекстная диаграмма
На первом этапе можно воспользоваться контекстной диаграммой.
Это схема, с помощью которой мы можем понять, какие у нас есть люди и системы, как и зачем они друг друга используют и чем это может нам помочь.
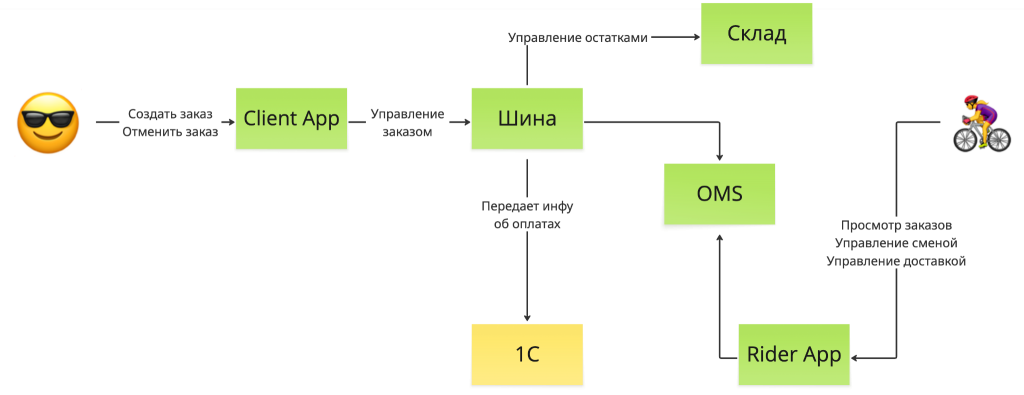
Что мы стремимся на ней отразить?
Первое – пользователей и роли, которые участвуют в процессе, то есть людей.
Второе – системы, которые тоже будут как-то участвовать в процессе.
И самое интересное, третье – мы стремимся найти то, что я называю отношениями использования: кто кого и зачем использует.
Стрелочки, которые мы видим на такой схеме, – это не технические запросы, не потоки данных и не что-то еще. Это именно связи, которые показывают отношения использования.
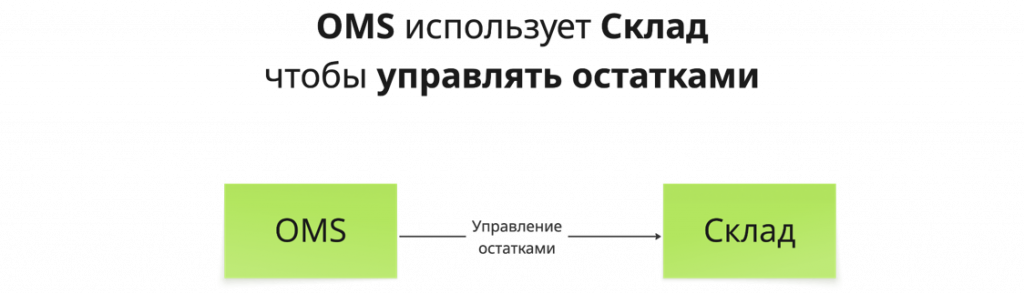
Например, у нас связаны две системы: система управления заказами, OMS, и склад. Между ними есть стрелочка. Читать ее стоит примерно так: OMS использует склад для того, чтобы управлять остатками, получать остатки или делать что-то еще.
Нам важно определить именно то, для чего одна система использует другую.
В рамках контекстной диаграммы мы простраиваем такие отношения для всего процесса, который у нас был на входе.
Очень важно в этот момент не скатиться – а это очень любят делать – в отображение технических взаимодействий. Например: OMS обращается, чтобы получить остатки, в ответ получает остаток.
Нет. Сейчас нас это, во-первых, не интересует. Во-вторых, таким образом мы теряем строгое соответствие отношениям использования. Уже здесь начинаем смешивать логические функции и непосредственно бизнес-данные, бизнес-объекты, которыми обмениваемся. Речь пока вообще не про методы.
Зачем нужны такие строгие правила?
Во-первых, контекстная диаграмма сама по себе полезный инструмент. Ее можно посмотреть и покрутить с архитектором, иногда – с более-менее технически подкованным заказчиком. Это некоторый способ проверки полноты: все ли мы отразили в наших системах из тех процессов, которые ранее собрали и выявили.
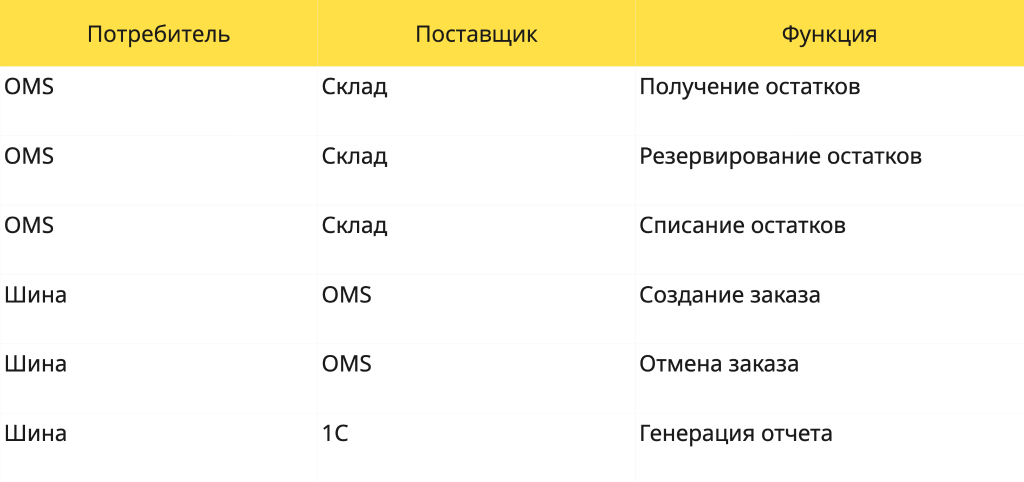
Но самое интересное начинается, если после этого построить в голове или реально на бумаге таблицу, в которой каждую стрелочку, каждое отношение использования мы представим в виде трех элементов.
Есть потребитель – тот, кто использует. В нашем случае это OMS.
Есть поставщик – тот, кого используют. В нашем случае это склад.
И есть непосредственно функция – бизнес-функция, логическая функция, как вам удобнее.
После этого мы можем пройтись по каждой системе и посмотреть: а функции, которые нам требуются, вообще везде есть? Там ли мы ожидаем их увидеть? Например, действительно ли склад управляет остатками или под это есть какой-то выделенный сервис или система?
Где-то, возможно, мы встретим функции, которые еще не реализованы. Боже мой, нам нужны доработки!
Это уже первая проверка, которая очень хорошо подходит под идею итеративного проектирования вместе с архитекторами.
Мы посмотрели, кого и как используем, какие функции нам нужны, где уже могут понадобиться доработки. Возможно, сразу архитектор или кто-то еще предложит новые системы, сервисы, компоненты – все вот это.
Это был первый шаг – контекстная диаграмма.
Диаграмма потоков данных – DFD
Мы посмотрели на функции. Теперь логично подумать про данные и объекты: чем вообще обмениваются наши системы?
Для этого есть так называемая диаграмма потоков данных – Data Flow Diagram, или DFD.
Исторически контекстная диаграмма является некоторой нулевой версией DFD, но в это углубляться не будем. И у контекстной диаграммы, и у DFD есть строгие нотации, разные версии, но я буду пользоваться стрелочками и квадратиками – они приятнее глазу.
Что нам дает DFD? Мы можем понять, где и в каких системах нужны какие данные, кто их хранит, кто получает и как системы ими обмениваются.
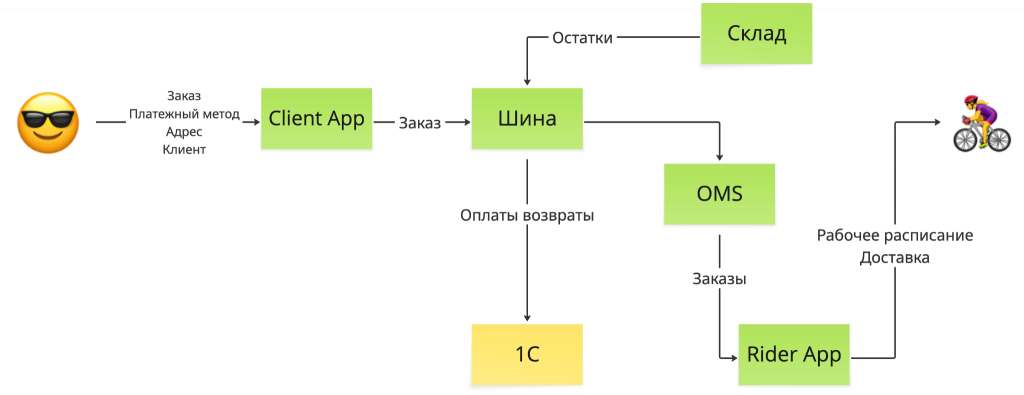
По сути, мы берем ту же самую схему, но теперь каждая стрелочка отображает не отношение использования, а направление движения каких-то бизнес-объектов, бизнес-данных.
Очень важно: запрос сам по себе не является бизнес-объектом. Запрос – техническая сущность.
Мы все еще не спускаемся на технический уровень. Мы стараемся выяснить, что такое бизнес-объект. Это может быть заказ, клиент, остатки какого-то товара или что-нибудь еще. И смотрим, как эти объекты двигаются.
В некоторых случаях направление стрелочки вообще может поменяться относительно направления функций на предыдущей диаграмме. А может не поменяться – зависит от ситуации.
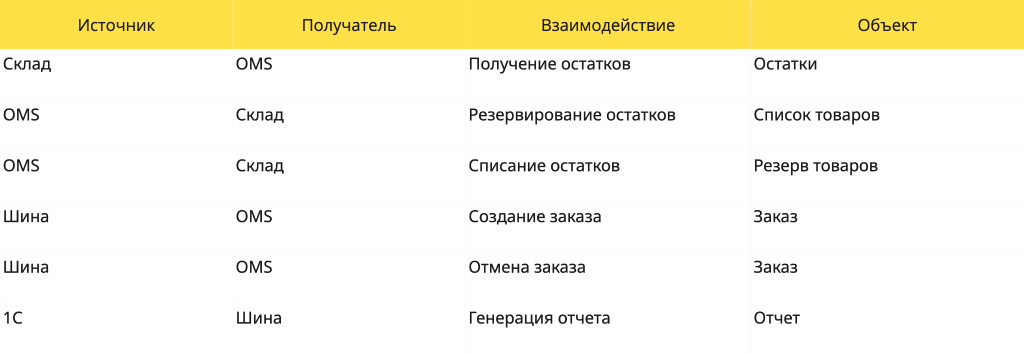
После этого мы снова можем достаточно формально составить таблицу, где отобразим источник данных, получателя данных, взаимодействие, в рамках которого передается бизнес-объект, и непосредственно сам объект.
Если говорить про совсем уж лютый энтерпрайс, когда задача охватывает десятки систем, может быть полезно ввести какой-нибудь реестр или библиотеку бизнес-объектов и описывать их там.
На некоторых очень больших проектах мы так заморачивались. Правда, это было очень больно, и на это уходила едва ли не большая часть времени. Тем не менее такой подход существует.
Итак, есть контекстная диаграмма, после нее при необходимости можем построить таблицу функций. Есть DFD и реестр, по которому мы уже выявляем непосредственно объекты.
Зачем нам вообще эта таблица и потоки данных?
Ровно так же, как в случае с функциями, мы можем проверить: если ожидаем, что из какой-то системы будут исходить определенные данные, есть ли эта информация там вообще? Это раз.
Второе: если ее нет, снова идем и смотрим, какие нужны доработки.
Третье: здесь же можно проверять актуальность, время и частоту обновления объектов, а также определять, что является мастер-системой. Это тоже важная история, хотя уже больше архитектурная.
Это два основных этапа концептуального проектирования.
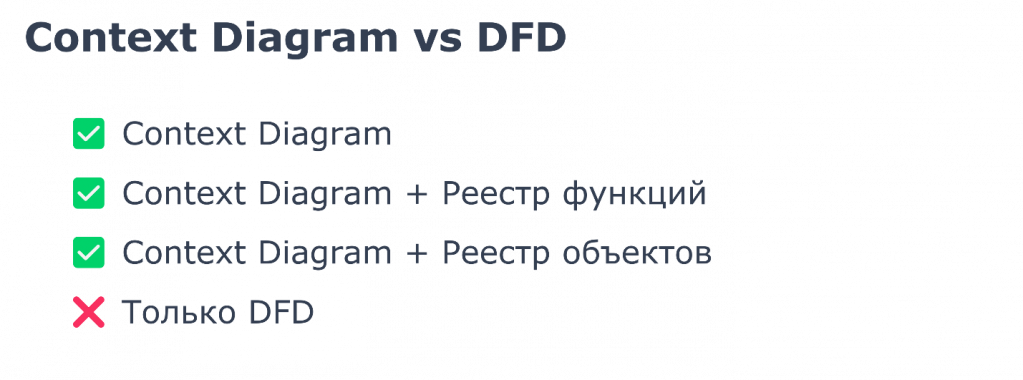
Сначала строим контекстную диаграмму. Если схема достаточно сложная, при необходимости дополняем ее таблицей с функциями. Для больших и сложных схем добавляем DFD, которую тоже можем дополнить реестром.
Единственная просьба: не надо начинать сразу с DFD или делать только DFD. Если сил, времени и упорства хватает только на одну диаграмму, лучше остановиться на контекстной. Так вы увидите функции. Из функций данные, как показывает практика, потом вытащить проще, чем сначала нарисовать, как у нас двигаются объекты, а затем пытаться вычленить из этого функции.
Это первый этап – концептуальное проектирование. По сути, кусочки solution architecture, которые можно обсуждать с архитекторами.
Сценарии взаимодействий
Хорошо, на концептуальном уровне мы что-то обсудили с архитекторами. Но можно спросить: а я-то вообще API-шками занимаюсь, зачем мне все это?
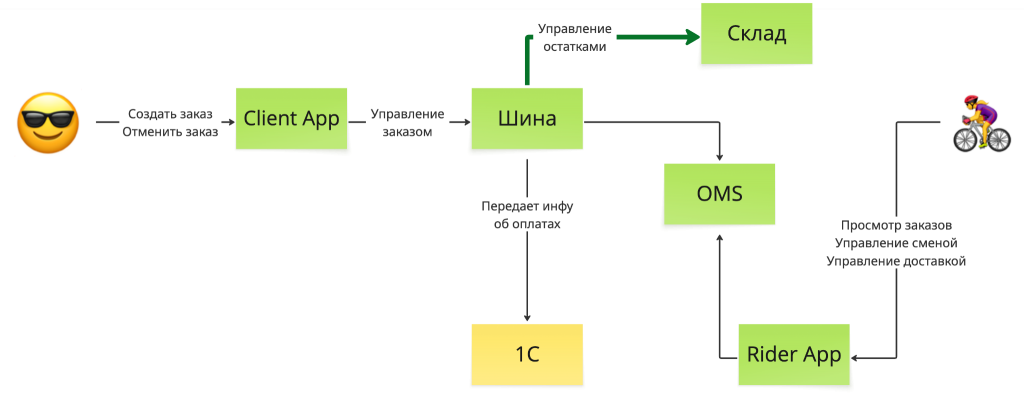
Затем, что каждая стрелочка на контекстной диаграмме, которую мы показывали как логическое использование – например, проведение оплаты, получение остатков, управление остатками и так далее, – на самом деле может распадаться на достаточно сложный сценарий взаимодействия между двумя системами.
И здесь нам пригодится диаграмма последовательности – sequence diagram.
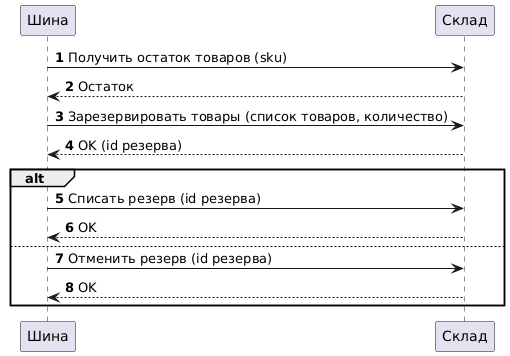
По-хорошему, каждую такую стрелочку с контекстной диаграммы, если есть какие-то сомнения, неуверенность или взаимодействие нужно подробно разложить, мы превращаем в сценарий взаимодействия, в диаграмму последовательности.
При этом все еще не обязательно спускаться на технический уровень. Если вы давно на проекте и уже со всем этим работаете, возможно, технический уровень тоже поможет. Но пока можно оперировать вызовами вроде: «Дай мне остатки», «Зарезервируй товары» и так далее.
Не надо стремиться сразу уходить в технику. Пока неважно, на каких технологиях все это работает.
Мы максимально строго стремимся отразить само взаимодействие: одна система что-то спросила у другой, та ответила и так далее.
Сначала такие диаграммы можно разворачивать попарно. Если стрелка на контекстной диаграмме была между двумя системами, сначала построить sequence для этих двух систем.
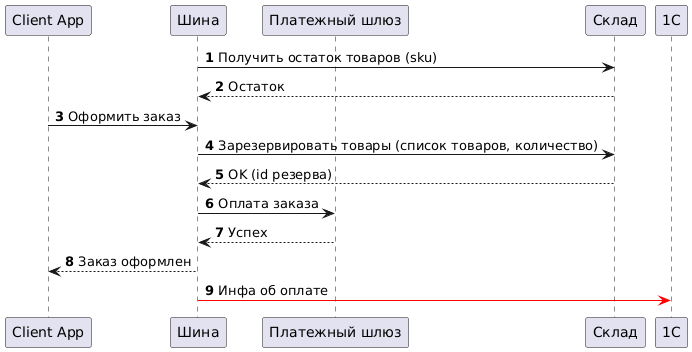
Для более сложных сценариев бывает полезно расширять эти диаграммы, когда уже несколько стрелок с контекстной диаграммы оказываются на одной диаграмме последовательности.
Чем это полезно? Можно отследить целиком путь вызовов. При необходимости можно даже в скобках подписать, какие объекты используются, – как раз те, которые мы выявили на этапе DFD.
Первое, что это нам дает, – возможность еще раз провалидировать себя и проверить, ничего ли мы не забыли, прежде чем сразу бросаться проектировать.
Второе – мы получаем сценарий, с которым уже можно идти к конкретным системам.
Например, вы используете платежный шлюз. Идете в платежный шлюз и проверяете: «Такие методы, такие функции у вас есть или нет?» Можно спросить, можно посмотреть самостоятельно в описании.
Это уже более приземленное проектирование сценария взаимодействия.
Здесь же можно определить, какие взаимодействия нужны синхронные, а какие асинхронные. Но это уже отдельная тема.
Итак, на этом промежуточном этапе мы детализируем взаимодействие.
Проектирование API
Представим, что с архитекторами на концептуальном уровне мы поговорили, все нарисовали, получили красивые sequence-диаграммы и знаем, как системы взаимодействуют.
Чаще всего интеграция в итоге сводится к тому, что нам нужно как-то доработать API, спроектировать свое или использовать чужое.
Если используем чужое, нам может хватить схемы, которую мы отразили в сценарии последовательности. Просто смотрим, все ли нужные методы существуют.
Представим теперь, что каких-то методов в системе не хватает и нам нужно спроектировать что-то свое.
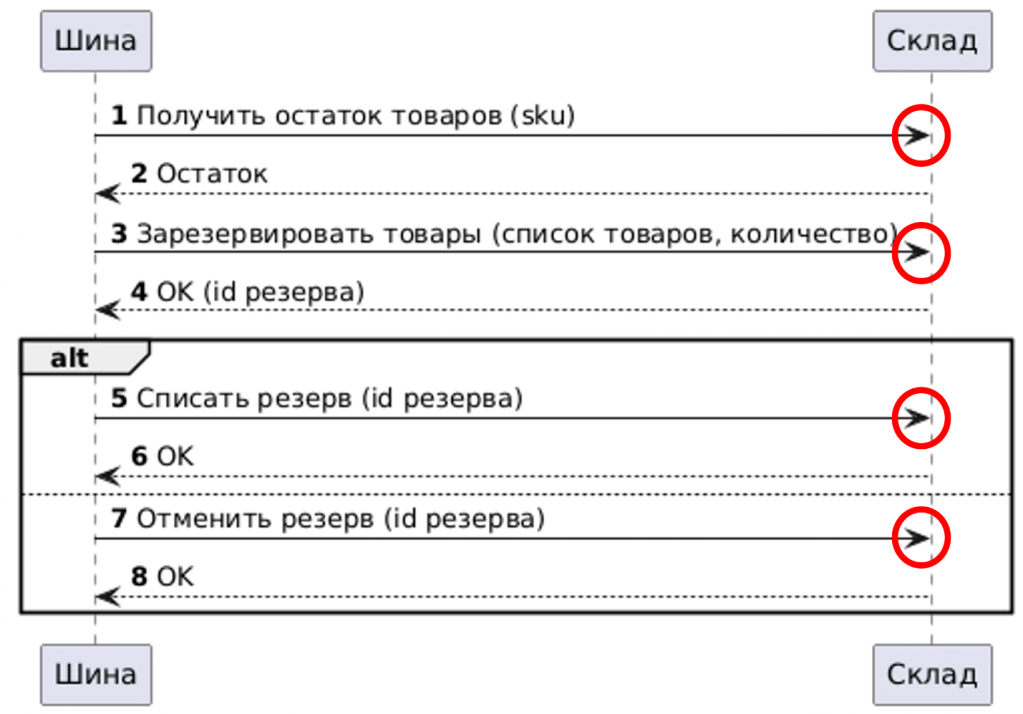
Берем sequence-диаграмму и совершенно в лоб, пока особо не думая, каждую входящую стрелочку воспринимаем как метод. Просто скрупулезно выписываем их.
Для каждого метода указываем логическое название – что этот метод делает. Указываем запрос и ответ.
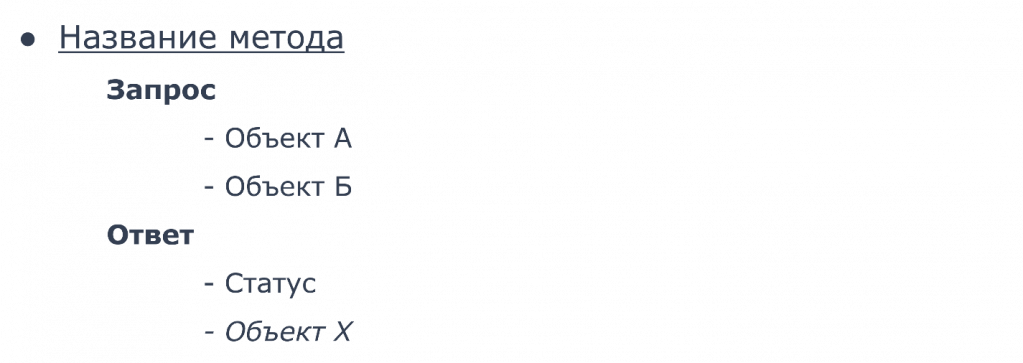
Для каждого запроса и ответа, по-хорошему, нужно определить, что именно мы там передаем.
И вот здесь, если предыдущие шаги не пропускались, бизнес-объекты и параметры запросов и ответов должны соответствовать объектам из нашей диаграммы потоков данных.
Если внезапно на этом этапе откуда-то взялись новые бизнес-объекты, возникает вопрос: а что мы продолбали раньше? Нет ли у нас каких-то веток интеграции, где мы не учли целую систему? Не забыли ли мы о чем-то? Эти объекты не должны браться из воздуха.
Более того, все методы, которые мы увидели на этапе сценариев взаимодействия, на sequence-диаграммах, должны соответствовать функциям с контекстной диаграммы. Здесь может быть соответствие один ко многим. Например, одной функции с контекстной диаграммы может соответствовать несколько методов. Но если метод возникает из ниоткуда, опять появляется вопрос: не продолбали ли мы какие-то функции на контекстной диаграмме? Не нужно ли вернуться еще раз? Иногда понимаем, что нужно, и возвращаемся.
На этом этапе сначала берем и выписываем все методы, затем смотрим, какие уже существуют.
Если метод существует, все объекты на входе и выходе совпадают – все здорово, доработка не нужна, оставляем задачу на уровне сценария.
Не хватает какого-то объекта в запросе, ответе или параметра – добавляем, вносим в спецификацию.
Обнаружили, что нужен новый метод, – значит, его нужно добавить в API.
Когда мы таким образом составим список методов из стрелочек, может неожиданно выясниться, например, что методы «получить список заказов» и «получить список активных заказов», которые на диаграмме последовательности выглядели разными, по сути являются одним методом. Тогда их можно схлопнуть.
Таким образом, мы получаем некоторый драфт API на бизнес-уровне.
После этого можно сделать еще одну полезную вещь – проверить API на полноту.
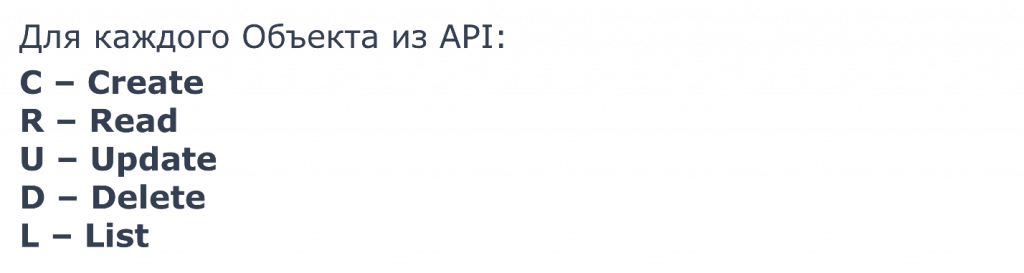
Берем каждый объект, с которым работаем на уровне API с помощью каких-то методов, и проверяем CRUD: Create, Read, Update, Delete – стандартный набор операций, которые можно совершать с объектом.
Если у вас есть объект, это совершенно не означает, что в рамках каждого взаимодействия вам обязательно нужны все эти операции. Но проверить, нужен ли нам соответствующий метод для этого объекта, бывает полезно.
К этому можно дополнительно добавить другие действия. Например, клонирование. Задачу в Jira иногда клонируют. Документ тоже можно склонировать.
Какого-нибудь клиента или что-нибудь еще иногда можно заархивировать: не удалить, а спрятать в архив.
То есть каждый объект, каждый ресурс полезно проверить: нужны ли нам такие методы? Если нужны – внести их и добавить в API.
Что еще можно сделать для валидации?
Если есть возможность, очень полезно взять тестовый стенд, открытую публичную API, тестовые ключи – что угодно – и прогнать все эти методы и взаимодействия. Потому что документация врет, люди врут, вы сами могли не увидеть или не учесть какие-нибудь corner cases и тому подобные вещи. Поэтому прогонять все это очень полезно.
Если в рамках вашего API выяснилось, что нужны новые методы, можно сгенерировать моки и, с одной стороны, включить их в цепочку своих прогонов, а с другой – передать тем счастливым людям, которые будут интегрироваться с вами и использовать ваши новые методы.
Все шаги, которые я описывал, можно частично выполнять или дополнительно проверять с помощью ИИ: закидывать материалы в обычные чаты, просить накидать вопросов, проверять отдельные моменты. В принципе, они неплохо помогают. Если вы сами понимаете, что делаете.
Трассировка требований
Я уже отчасти упоминал трассировку требований.
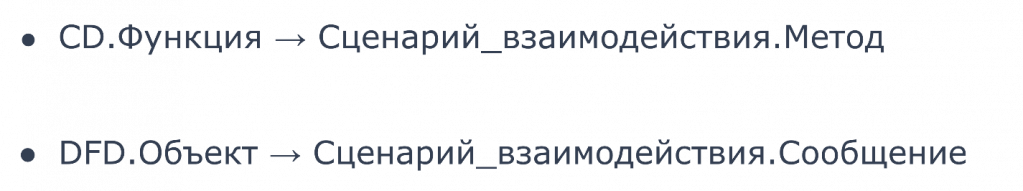
Как все эти шаги и артефакты связаны между собой?
Когда мы говорили про контекстную диаграмму, зачем мы отражали на ней отношения использования и функции?
По-хорошему, каждая функция, которую мы там отразили, должна быть реализована, использоваться и отражаться в одном или нескольких сценариях взаимодействия – тех самых sequence-диаграммах.
Если этого не произошло, велика вероятность, что вы что-то упустили.
Если в каком-то sequence возникла функция, которой не было на контекстной диаграмме, возникает обратный вопрос: почему так? Не упустили ли мы что-то еще?
Аналогичная история с DFD и потоками данных.
Когда мы выявляли бизнес-объекты, они должны дальше прослеживаться на уровне sequence-диаграмм и API.
Если внезапно там возникают совершенно новые объекты – это что-то нездоровое.
Значит, возможно, мы что-то не учли, не использовали какие-то системы, нужно что-то добавить, что-то убрать и так далее.
Естественно, один объект при этом может появляться в нескольких сценариях взаимодействия – в ответе, запросе, где угодно.
Главное, чтобы связь между уровнями оставалась явной.
Общий алгоритм
Если собрать все в некоторый общий алгоритм и представить, что перед нами задача, где нужно запилить новый процесс на несколько систем, последовательность будет примерно такой.
Шаг первый – проанализировать, что вообще нужно сделать.
На входе может быть бизнес-процесс, use case, требования – что угодно. Все это нужно как-то намапить на системы, пользователей и взаимодействия между ними.
Шаг второй – построить контекстную диаграмму, чтобы понять, кто кого и зачем использует.
Шаг третий – построить диаграмму потоков данных, чтобы понять, какие объекты и данные здесь перемещаются, кто их передает и кому они нужны.
Следующий этап – связать все это через sequence-диаграммы: развернуть в них функции из контекстной диаграммы в сценарии взаимодействия.
После этого при необходимости проектируем новые API или дорабатываем существующие, проверяем все на полноту и на трассировку: нигде ли мы ничего не потеряли, везде ли есть явные связи.
После этого можем радоваться жизни. Надеюсь, проект не изменится – и полетим. Мы великолепны.
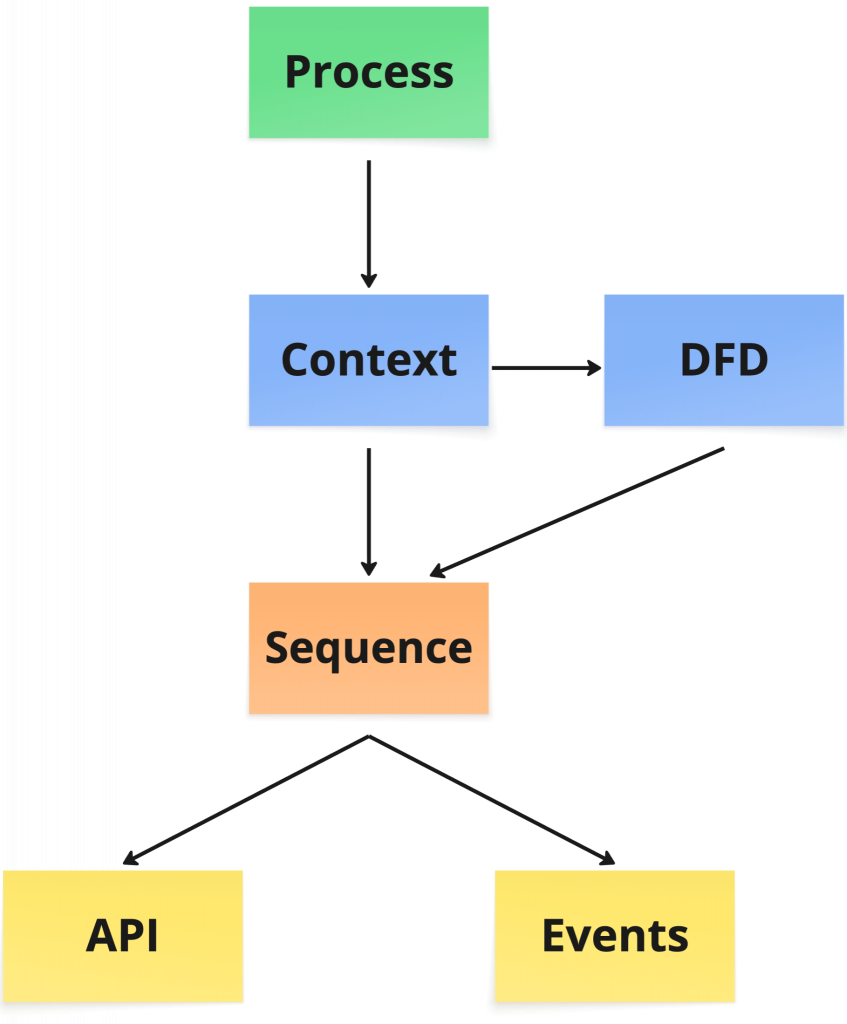
Если представить весь путь визуально, вначале у нас есть процесс в каком-то виде. Это может быть CJM, макеты в Figma – что угодно.
Из него строим контекстную диаграмму. Если есть силы, время и достаточно высокая сложность, добавляем потоки данных.
Затем спускаемся на уровень ниже – к сценариям взаимодействия, строим sequence-диаграммы.
Из них проектируем API.
Я здесь не затрагивал историю про взаимодействия через брокеры и событийность – это немного другая тема. Но при работе с брокерами весь этот подход тоже можно адаптировать.
Полный путь нужен не всегда. Иногда, если вы, например, проектируете API между мобильным приложением и бэкендом, возможно, проходить все этапы не требуется.
Хотя если есть какие-нибудь гигантские сценарии и макеты в Figma, по которым потом нужно понять, как все будет работать, особенно если на бэкенде достаточно развесистый API, такой подход тоже может быть актуален.
Для каких-то задач нужен полный путь. Для каких-то вы поймете, что это слишком много, и можно, например, начать сразу со сценариев взаимодействия. Здесь нужно адаптироваться к конкретной задаче.
*************
Статья написана по итогам доклада (видео), прочитанного на конференции INFOSTART TEAM EVENT.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

