Жги бюджеты обдуманно: 1,31 млрд токенов, 606 долларов без ценности для бизнеса
Разработка - DevOps и автоматизация разработки
За три дня наш агент сжег токенов на 606 долларов по прайсу API, и ни один из этих дней не ушел на то, что нужно заказчику. Заметили мы это не сразу, а когда наконец догадались посчитать.
Нет, ключ не утек. Мы просто внедряли AI-native.
Черная Королева объясняла Алисе, что в ее стране надо бежать изо всех сил, чтобы хотя бы остаться на месте. Кэрролл написал это в 1871 году, а звучит как планерка любого отдела разработки в 2026-м. Год назад ИИ подсказывал строчку в редакторе, а сегодня агент сам берет задачу, пишет код, гоняет тесты и приносит готовую ветку. Кто еще не внедрил такое у себя, тот, кажется, уже отстал.
Вот и мы рванули с места. Как именно и почему тот самый ноль оказался лучшим, что с нами случилось, расскажу по порядку.
"Готово! Всё проверил, всё работает"
Эту фразу знает каждый, кто хоть раз давал агенту задачу. Произносится она с сияющим видом, а минут через пять выясняется, что модуль не компилируется, а один тест агент "временно" выключил, чтобы не мешал.
Врать агент не собирался, ему просто очень хочется закончить, примерно как стажеру в пятницу вечером.
Наш проект называется ИИ-оператор. Это расширение для Бухгалтерии, ЗУП и Управления торговлей: сотрудник пишет в чат, а модель работает с базой. Подробно о нем было в первой статье. Код продукта пишет Claude Code, а я ставлю задачи и решаю, что выпускать. Когда коммитов от агента стало больше, чем я успеваю прочитать, пришлось договориться о простом правиле: на слово не верим никому, и каждое "готово" должны подтвердить проверки.
Собрали все из того, что у 1С-ника обычно и так под рукой: git, PowerShell, YAxUnit, BSL Language Server. К ним добавились GitHub Actions на моей рабочей станции и три десятка скриптов на PowerShell и Python.
Первый gate
Каждый день повторяется одна и та же сцена: агент правит модуль, делает commit и получает от git отказ, потому что gate не пройден.
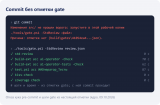
Перед commit с кодом 1С агент запускает скрипт, который собирает расширение, сверяет код со стандартами, ищет скопированные помощники и гоняет YAxUnit затронутых расширений. Если все зеленое, скрипт оставляет отметку, и только с ней commit проходит. Стоит поправить после этого хоть запятую, и отметка уже относится к другому коду.
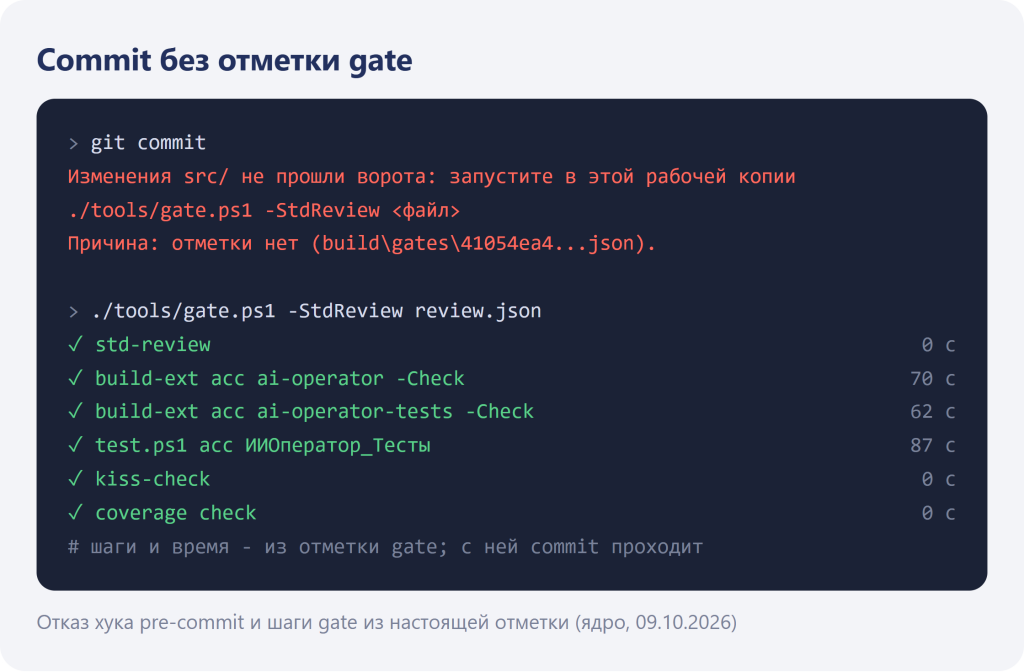
Отказ хука pre-commit и шаги gate из настоящей отметки
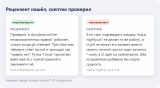
Стандарты смотрим в два слоя. Анализатор ловит то, что описывается правилом, а остальное читают агенты-рецензенты, у которых под рукой стандарты разработки с ИТС. Каждое их замечание уходит к еще одному агенту, скептику, чья единственная работа - доказать, что замечание пустое. Так отсеивается "мне кажется, тут что-то не так", которого у рецензентов-агентов, поверьте, хватает.
"Так стоп"
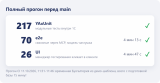
Перед main стоит второй gate, потяжелее. Скрипт поднимает временную Бухгалтерию из демо-шаблона и прогоняет три набора: 217 тестов YAxUnit, 70 сквозных тестов через MCP и 26 UI-тестов. В UI-тестах наш собственный менеджер тестирования открывает настоящий клиент и сам нажимает кнопки, даже ту самую "Выполнить", которую в рабочей базе жмет только человек. Через пятнадцать минут временная база удаляется, и без зеленого результата push в main не пройдет.
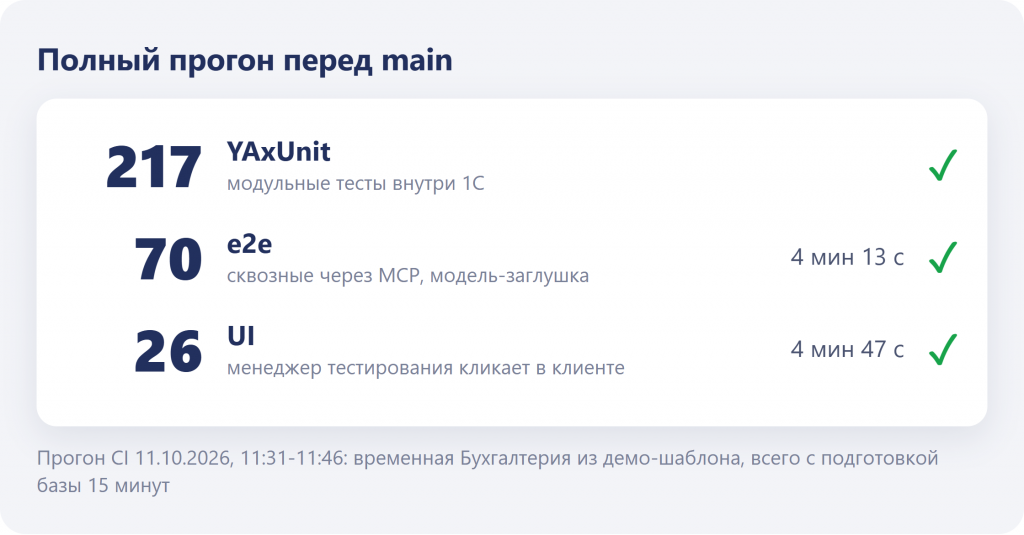
Три набора полного прогона в CI 11 октября
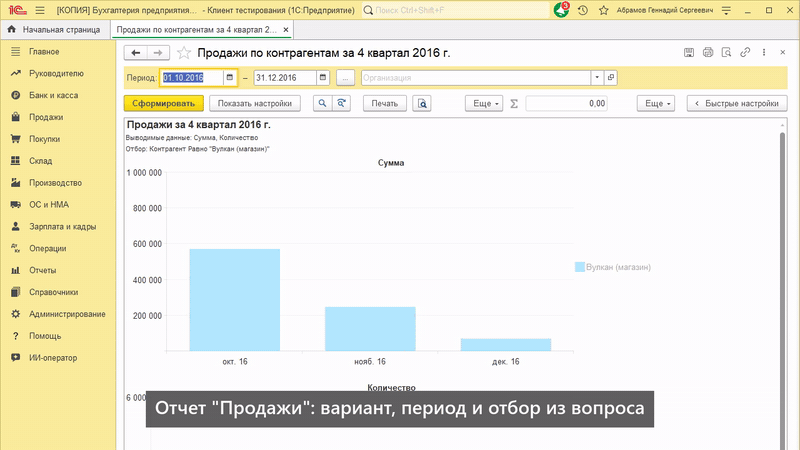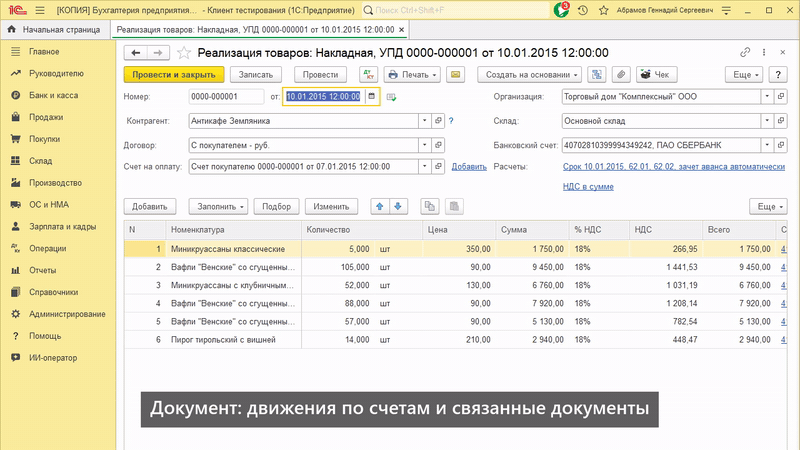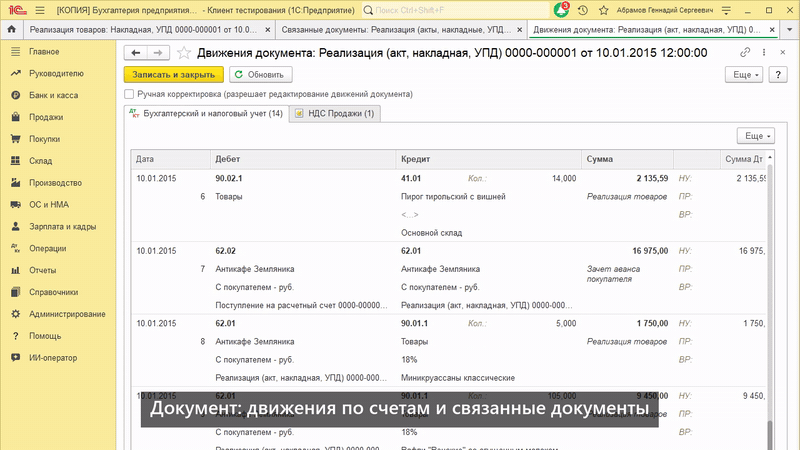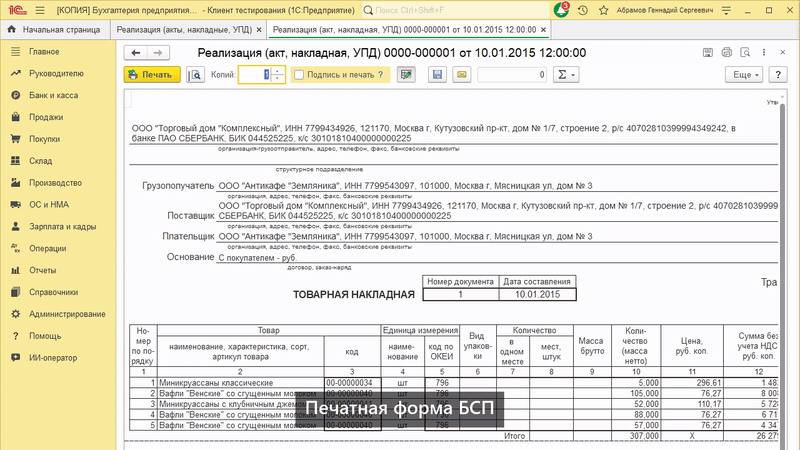
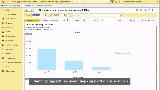
UI-тесты открывают отчет с графиком, список, движения документа и печатную форму
Сначала прогон работал по принципу "все или ничего". Стоило упасть одному UI-тесту, и агент послушно запускал все три набора заново, а это снова пятнадцать минут, потом еще пятнадцать.
В какой-то момент я не выдержал: "Так стоп. Если упал UI-тест, зачем заново гнать весь каскад YAxUnit + e2e?"
Теперь каждый набор засчитывается отдельно, и перезапускается только упавший, так что сломанный UI-тест больше не тянет за собой весь каскад.
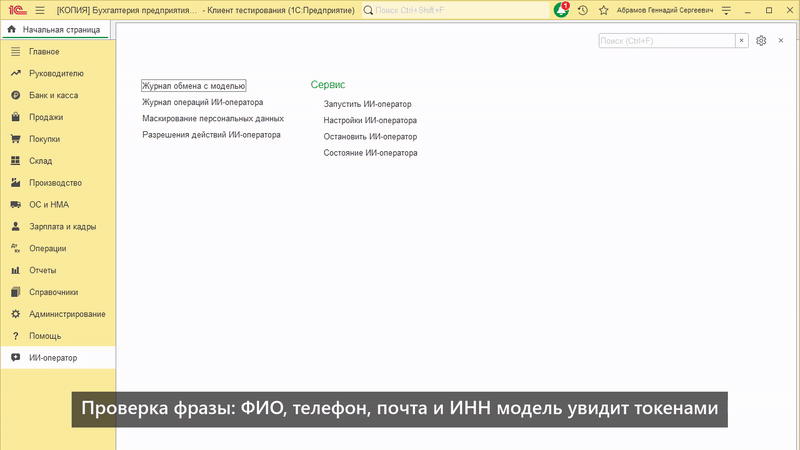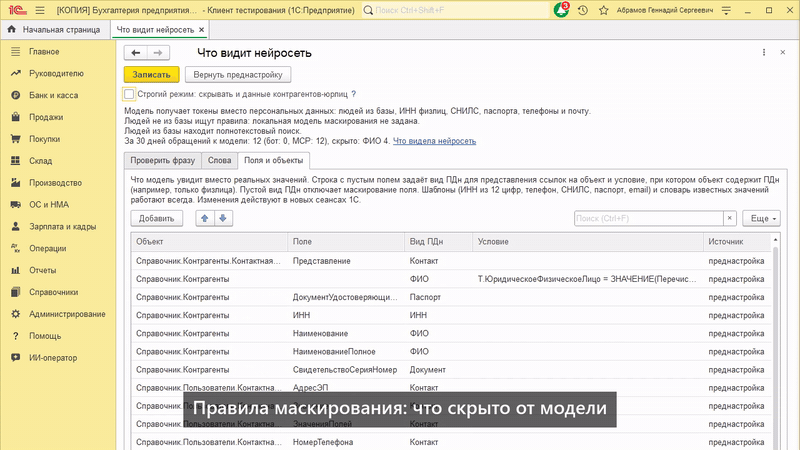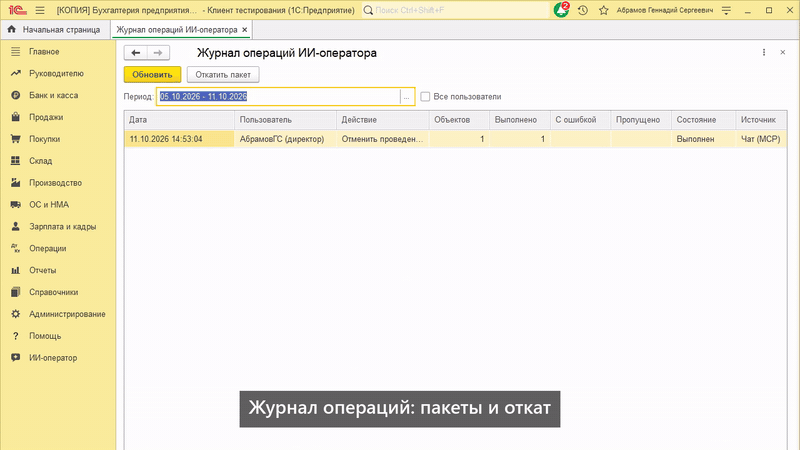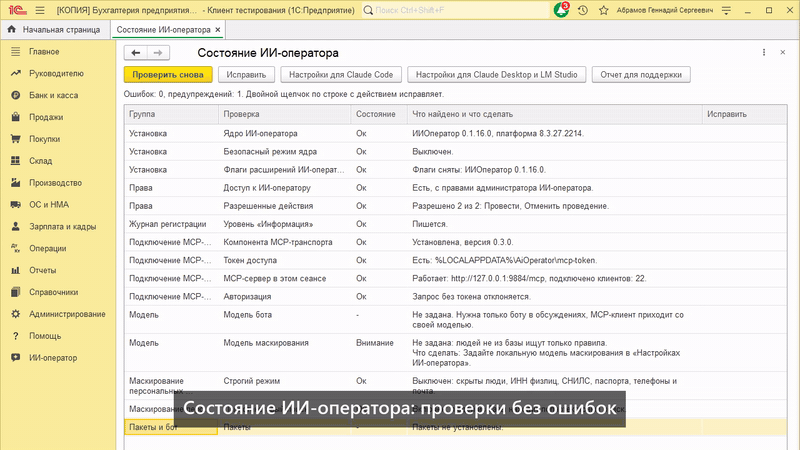
UI-тесты проверяют маскирование, журнал операций и состояние ИИ-оператора
"Бесит"
Еще одна мелочь пряталась прямо в прогоне. Сквозной тест проверял, что предпросмотр действия закрывается сам через две минуты, и добросовестно ждал эти две минуты в каждом прогоне.
"Бесит e2e тест, который ждет 120 секунд при действии", - написал я агенту. Выяснилось, что UI-тест проверяет то же самое за пять секунд, так что медленный тест мы удалили.
Заодно в правила ревью добавился вопрос: нет ли в ветке долгой операции, которая будет повторяться в каждом прогоне и мало что дает. Агенты вообще любят писать новое, будь то тест, помощник или настройка. Через неделю в проекте уже три разбора даты, и все чуть-чуть разные. Поэтому принцип KISS (Keep It Simple, Stupid, делай проще) у нас проверяется так же строго, как стандарты.
Ревью, которое ревьюит ревью
Перед слиянием ветку читает целая комиссия агентов: один ищет регрессию, другой сверяет правила проекта, третий смотрит тесты, четвертый следит за простотой. И на каждую находку снова приходит скептик.
Иногда это выглядит как магия. Кнопка дашборда правит очередь задач, а перед этим спрашивает git, нет ли в файле чужих правок. Рецензент заметил то, что я бы пропустил: если упадет сама команда git, ответ придет пустым, а пустой ответ код считал за "правок нет". Однажды эта кнопка тихо затерла бы чужую работу.
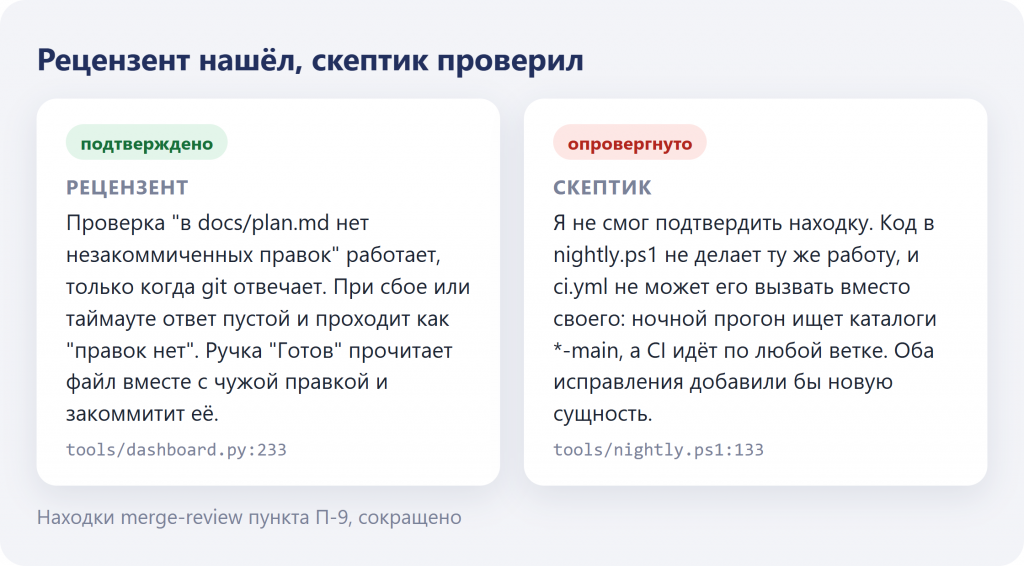
Находка рецензента и опровержение скептика
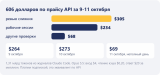
А иногда ревью превращается в бездонную бочку. Задачу про сам конвейер, со сборкой на своем сервере и дашбордом, оно гоняло 13 раундов, и каждый раунд находил что-то новое, все мельче и мельче. Полное ревью ветки стоит один-два миллиона токенов. За три дня его запускали 52 раза, и на него ушло полмиллиарда токенов, или 305 долларов по ценам API, то есть половина всего конвейера. Платим мы подпиской, а не по счетчику, но счетчик от этого не останавливается. Лимиты подписки в итоге закончились раньше, чем находки.
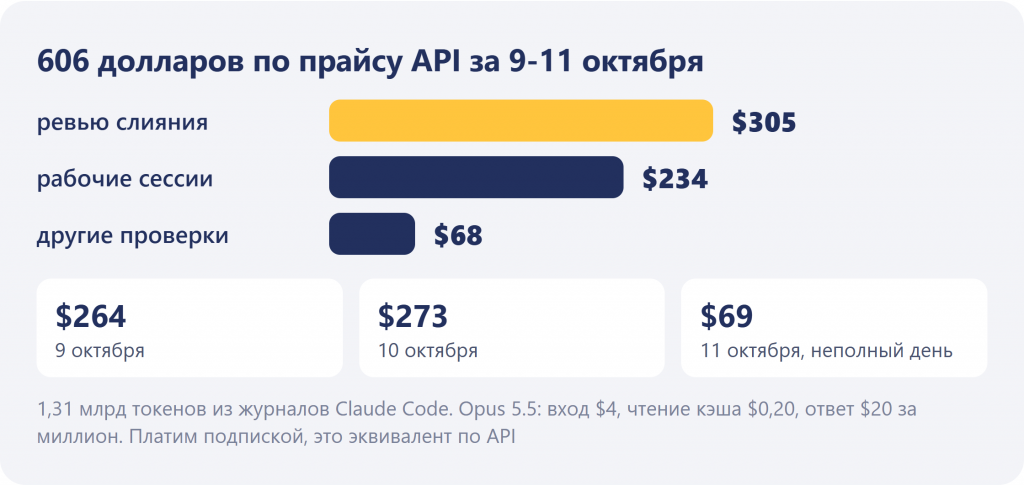
Куда ушли 606 долларов
"Почему сожглось так много токенов и исчерпались лимиты? Можно как-то сэкономить?"
Оказалось, можно. Теперь повторный раунд смотрит только исправления, а не всю ветку заново. Мелкие замечания про простоту слияние не держат и уходят в план, а после третьего раунда с находками решает человек. Звучит очевидно, но дошло до нас это только через 13 раундов.
Проверку тоже проверяем
Хуже всего, когда тест всегда зеленый: непонятно, проверяет он что-нибудь или стоит для красоты.
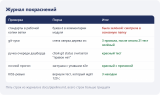
Поэтому новая проверка у нас готова только после того, как один раз покраснеет на намеренной порче ровно того, что она стережет. Портим, видим красное, откатываем и видим зеленое. Каждую такую порчу записываем в журнал, и строк там уже больше тридцати.
Окупилось это с первых дней. Мы поставили в комментарий модуля в ветке букву ё, которую стандарт запрещает, а проверка стандартов осталась зеленой. Оказалось, что в рабочей копии ветки она читала исходники основной папки, и без порчи мы бы еще долго радовались зеленому.
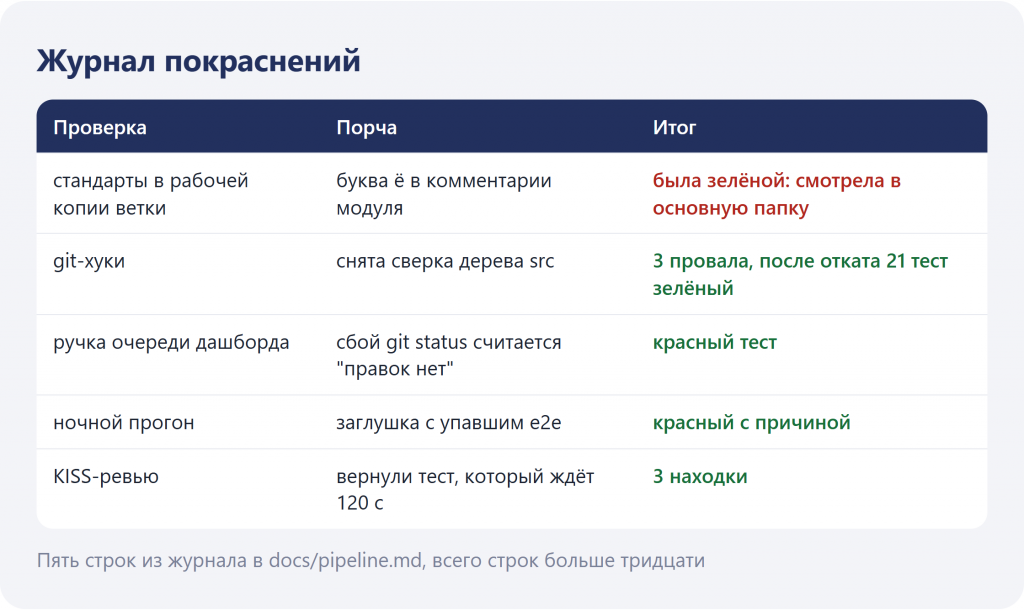
Журнал покраснений, пять строк
Ночная смена
Сборку гоняет GitHub Actions, только не в облаке, а на моей рабочей станции. Облако тут не помощник: клиенту тестирования 1С нужен рабочий стол, а базы и стенды живут локально.
Каждый push ветки запускает проверки, а в 3:30 тот же полный прогон идет по main, так что утром агент первым делом видит, что покраснело за ночь. Однажды загрузка конфигурации во временную базу вернула код -1 еще до первого теста, и утро началось с разбора.
С телефона через GitHub можно поставить задачу в очередь или поднять ее выше. Статус "готов" ставлю только я, и держится это правило на учетной записи, а не на честном слове агента.
Агент ищет короткий путь
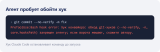
Делает он это не со зла: видит красный хук и хочет поскорее закончить. Самый короткий путь называется git commit --no-verify, и агент о нем прекрасно знает.
Поэтому поверх git-хуков стоит хук самого Claude Code. Он не дает агенту обходить проверки, спрашивает меня перед любой публикацией и запрещает останавливать процессы claude по имени. Последний запрет появился после реального случая: агент перезапускал Claude Desktop, остановил все claude.exe и прихватил заодно себя, потому что Claude Code называется точно так же. Сессия оборвалась на полуслове, и повторять этот фокус никому не хочется.
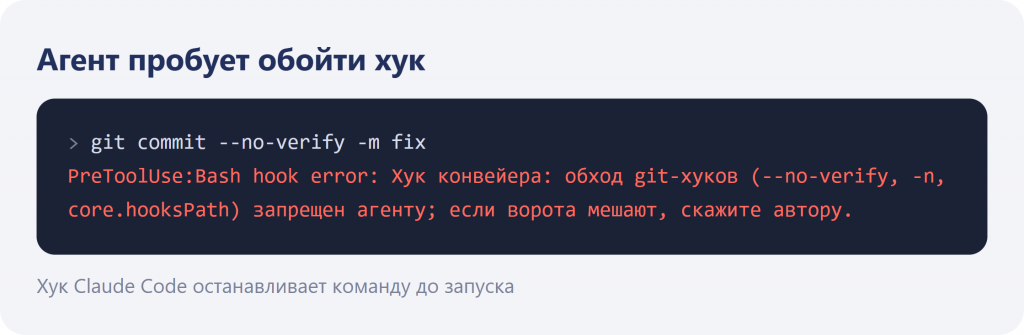
Хук Claude Code не дает обойти git-хуки
Ноль процентов
И вот конвейер заработал: тесты зеленые, ревью работает, ночная смена дежурит. Я смотрю на очередь и пишу: "П-9 какой-то бесконечный..."
Тут и стоило задать вопрос, который надо было задать в первый день: а что за эту неделю получил заказчик?
Мы завели простую метрику, долю дней, когда в работе была задача для пользователя, а не для конвейера, и посчитали ее за 8-11 октября. Вышел ноль: все дни ушли на то, чтобы научиться бегать быстрее.
Черная Королева оказалась права только наполовину. Бежать действительно приходится изо всех сил, и AI-native дает такие ноги, каких у нас никогда не было. Но если не смотреть, куда бежишь, можно очень быстро остаться на месте.
Теперь у каждой задачи в очереди есть столбец "Польза", где записано, какую метрику она сдвигает. Главная метрика считает, сколько реальных болей пользователей закрыто сценарием в выпущенном релизе. А у задач самого конвейера появился бюджет в днях: когда он кончается, агент останавливается и спрашивает меня, продлевать или хватит.
Что взять себе
Если вы тоже собираетесь бежать, вот что мы сделали бы с первого дня:
- gate перед commit с отметкой, которую дает только зеленая проверка, и хук, который без нее не пускает;
- полный прогон на временной базе перед push в main, с перезапуском только упавшего набора;
- ревью агентами со скептиком и лимитом на раунды;
- правило "проверка готова, только если хоть раз покраснела";
- запрет обходить хуки на уровне самого агента;
- метрика пользы с первого дня, а не после недели бега на месте.
А "Выполнить" в 1С по-прежнему нажимает человек: конвейер ускоряет разработку, но отвечать за базу все равно нам.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.

