Как учится нейросеть: обучил модель прямо на сервере 1С за три часа
В августе я посчитал, сколько займёт обучение маленькой языковой модели на встроенном языке 1С, получил 51 сутки и отказался от затеи. 11 октября в 22:00 я запустил это обучение на сервере 1С, а в 00:58 оно закончилось, и модель отвечала на вопросы. Без видеокарты и внешних компонент, на Массив и циклах Для, 2,96 часа счёта.
Скорость 1С тут почти ни при чём: работы стало в 349 раз меньше, потому что я по-другому нарезал обучающие примеры, подобрал скорость обучения и сократил число шагов. И ещё одно вышло неожиданным: 1С посчитала обучение так же, как PyTorch в двойной точности, а PyTorch в обычном режиме из-за округления ушёл на свою траекторию и на одном вопросе ответил верно там, где точный расчёт ошибся.
Рецепт я подбирал в Python, оттуда же взял стартовые случайные веса и порядок примеров, чтобы сверять 1С шаг в шаг. Сами 800 шагов посчитала 1С.
Модель та же, что в статье Внутри LLM нет ни одного Если: 21 920 чисел, два слоя, алфавит из 36 символов, сорок пар вопрос-ответ про объекты 1С. Там я писал, что обратный проход на встроенном языке делать не стану. Сделал, и по нему удобно объяснять, как учится нейросеть: потеря, градиент и шаг здесь - процедуры модуля объекта, их можно открыть и пройти отладчиком.
Откуда взялись 51 сутки и куда они делись
Расчёт августа лежит в обработке Обучение на глазах, функция КакОбучить(). Модель там чуть другая, 21 984 числа под свой корпус, формула та же. Один шаг обучения - пачка из 32 кусков текста по 96 символов, около 162 миллионов умножений. Двенадцать тысяч шагов, 438 539 умножений в секунду на встроенном языке. Получалось 51 сутки.
Расчёт был ещё и занижен. Формула не учитывала внимание: модель на каждом символе сравнивает его со всеми предыдущими, и на пачке 32 x 96 это ещё 35 % умножений сверху. С вниманием выходит 69 суток.
Сначала я уменьшал задачу в лоб, перебрал 27 вариантов в Python и мерил одним числом: на сколько из 40 вопросов модель отвечает слово в слово. Часы в таблице посчитаны по августовской скорости, 438 тысяч умножений в секунду.
| кусок текста | пачка | шагов | верно из 40 | часов в 1С |
|---|---|---|---|---|
| 48 символов | 2-8 | 1 000-4 000 | 0 везде | 3,8-60 |
| 64 символа | 8 | 4 000 | 8 | 84 |
| 96 символов | 2 | 1 000 | 0 | 8,7 |
| 96 символов | 8 | 4 000 | 29 | 139 |
В десятичасовую ночь влезали пять вариантов из 27 (в таблице крайние), и ни один не выучил ничего. Куски по 48 и 64 символа к тому же короче самих пар: при 48 не влезает ни одна, при 64 только 10 из 40.
Причина нашлась в том, как нарезался текст. Сорок пар склеивались в одну длинную строку, и кусок по 96 символов вырезался из неё с любого места. Вопрос почти всегда попадал в кусок со сдвигом, на позиции 30-90. А отвечает модель всегда с нулевой позиции: функция Ответить начинает с вопроса. Модель тратила шаги на то, чтобы продолжать текст с середины, а с начала ей отвечать почти не приходилось.
Я переделал нарезку: один пример - одна пара целиком, с первой позиции, в среднем около 72 символов. Новая нарезка сама по себе уже учит корпус, 39 из 40, но за 1 600 шагов. Уложиться в 800 помогла скорость обучения 0,01 вместо 0,003 (что это, ниже); старую нарезку на 0,01 я не прогонял, так что вклад двух правок не разделён. Итог в Python: 39 из 40 на пяти разных стартах при 800 шагах по две пары. Сороковая пара длиннее 96 символов, которые модель видит за раз, так что 39 - потолок.
Множители: 2 пары в шаге вместо 32 дают 16 раз, 800 шагов вместо 12 000 ещё 15, короткий пример с дешёвым вниманием ещё 1,46. Вместе 7,5 миллиарда умножений против 2,6 триллиона по исправленному августовскому расчёту, в 349 раз меньше, или 4,8 часа по августовской скорости. На обучении 1С считала быстрее, чем на ответе модели, где снимался августовский замер: 681 тысяча умножений в секунду на первых шагах (отсюда прогноз 3,1 часа) и 706 тысяч в среднем за ночь.
Обучение - это цикл. Вот он целиком
Шаг обучения в обработке выглядит так:
// Один шаг обучения: пачка пар по расписанию, градиенты, AdamW.

Функция ШагОбучения(Корпус)
	Номера = Обучение.Расписание[Обучение.Шаг];
	Пачка = Новый Массив;
	Для Каждого Номер Из Номера Цикл
		Пачка.Добавить(Корпус[Номер]);
	КонецЦикла;
	Итог = ГрадиентыПачки(Пачка);
	ШагAdamW(Итог.Г);
	Возврат Итог.Потеря;
КонецФункции
Вес - одно число. Вся модель это 21 920 чисел в 20 таблицах, таблица в коде - Массив строк, где каждая строка тоже Массив чисел, лежат они в Обучение.Т. Обучение меняет только значения в клетках.
Пачка - сколько примеров берётся в один шаг, у меня две пары, номера разложены заранее в Обучение.Расписание. Эпоха - все сорок пар по одному разу: 800 шагов по две пары это 1 600 примеров, ровно 40 эпох.
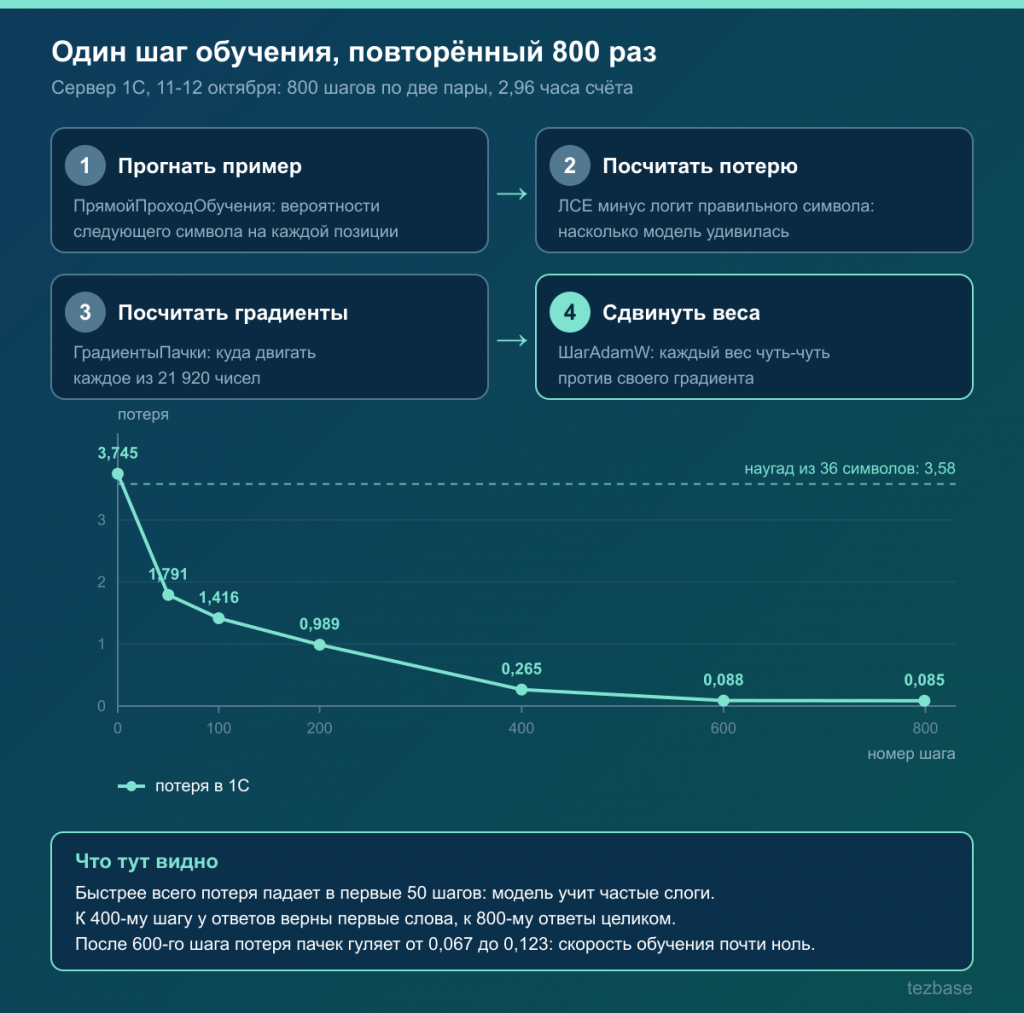
Внутри ГрадиентыПачки три действия: прогнать пример через модель, посчитать ошибку, посчитать, куда двигать каждый вес. ШагAdamW двигает.
Потеря: насколько модель удивилась
Модель читает пару символ за символом и на каждой позиции раздаёт вероятности всем 36 символам алфавита: какой, по её мнению, будет следующим. Правильный следующий символ мы знаем, он в обучающей паре. Ошибка считается одной строкой:
Потеря = Потеря + Ф.ЛСЕ[Поз] - Ф.Логиты[Поз][Посл[Поз + 1]];
Логиты - сырые оценки модели по каждому символу, ЛСЕ - логарифм суммы их экспонент. Их разность равна минус логарифму вероятности, которую модель дала правильному символу. Дала 100 % - ошибка ноль. Дала 1 % - ошибка 4,6. Потом всё делится на число символов в пачке, получается средняя.
Это число и называют потерей. На нулевом шаге у моей модели 3,745. Для сравнения: если тыкать в алфавит из 36 символов наугад, выйдет натуральный логарифм 36, то есть 3,58. Стартовая модель гадает чуть хуже, чем наугад: случайные веса уверенно ставят на неправильные символы. На последнем, 800-м шаге потеря пачки 0,085: правильному символу модель обычно отдаёт около 92 %.
Градиент: куда двигать каждое из 21 920 чисел
Градиент веса - на сколько вырастет потеря, если этот вес чуть-чуть увеличить. Знак говорит, в какую сторону крутить, величина говорит, насколько вес вообще влияет. Градиент нужен для каждого числа модели, поэтому ГрадиентыПачки возвращает Г той же формы, что и сами веса.
Начинается всё с выхода модели. Градиент потери по оценкам символов считается так:
// градиент потери по логитам: вероятность минус единица на правильном символе

Вероятности = Ф.Вероятности[Поз];
ДЛог = Новый Массив(Вероятности.Количество());
Для Ном = 0 По Вероятности.ВГраница() Цикл
	ДЛог[Ном] = Окр(Вероятности[Ном] / Всего, Знаков);
КонецЦикла;
ДЛог[Цель] = Окр((Вероятности[Цель] - 1) / Всего, Знаков);
Каждый неправильный символ тянет вниз на свою вероятность: модель поставила на него 0,3 - получит поправку 0,3 (делённую на число символов пачки Всего, как и потеря). Правильный тянет вверх на недостающее до единицы. Чем увереннее модель ошиблась, тем сильнее толчок.
Дальше этот градиент идёт назад через все слои, от выхода к входу, отсюда название: обратный проход. Почти вся модель состоит из умножений таблицы на вектор, и для них правило одно:
// Обратный ход через y = W x. Пришёл градиент Д по выходу y:

//   градиент веса W[i][j] копится как Д[i] * x[j],

//   градиент входа x[j] копится как сумма W[i][j] * Д[i].

// Оба накопления в одном проходе по строке. Нулевой Д[i] (после ReLU их половина)

// строку не трогает вовсе.

Процедура НазадЛинейный(Тензор, Град, Д, Вход, ДВход)
	Колонок = Вход.Количество();
	Для Ном = 0 По Тензор.ВГраница() Цикл
		Дн = Д[Ном];
		Если Дн = 0 Тогда
			Продолжить;
		КонецЕсли;
		Ряд = Тензор[Ном];
		ГРяд = Град[Ном];
		Для Кол = 0 По Колонок - 1 Цикл ДВход[Кол] = ДВход[Кол] + Дн * Ряд[Кол]; ГРяд[Кол] = ГРяд[Кол] + Дн * Вход[Кол]; КонецЦикла;
	КонецЦикла;
КонецПроцедуры
Градиент веса - произведение пришедшего градиента на вход: вес, который умножался на большое число, получает больше поправки. Градиент входа уходит дальше, в предыдущий слой, и там всё повторяется.
В первой статье я писал, что внутри модели нет ни одного Если, разбирающего язык. В обучении появились новые, одно выше, и языка оно тоже не касается: после слоя ReLU, который обнуляет отрицательные числа, часть градиентов нулевая, и такую строку проще пропустить. Вместе с нормализацией и вниманием область Обучение вышла на шестьсот с небольшим строк с комментариями.
Шаг: AdamW и скорость обучения
Градиенты посчитаны, пора двигать веса. Самый простой способ - вычесть из каждого веса его градиент, умноженный на маленькое число. Градиенты у разных весов отличаются в тысячи раз, и при таком способе одни веса летят, а другие стоят. Для таких моделей обычно берут AdamW, у меня тоже он:
Градиент = ГР[Кол];
МР[Кол] = Окр(Б1 * МР[Кол] + (1 - Б1) * Градиент, ЗнМомента);
ВР[Кол] = Окр(Б2 * ВР[Кол] + (1 - Б2) * Градиент * Градиент, ЗнМомента);
Ряд[Кол] = Окр(Ряд[Кол] * Затухание - РазмерШага * МР[Кол] / (Sqrt(ВР[Кол]) / Поправка2 + Эпсилон), ЗнВеса);
МР - скользящее среднее градиента этого веса, ВР - среднее его квадрата; Б1 и Б2 задают, как долго помнить прошлое, Поправка2 выравнивает средние на первых шагах, Эпсилон не даёт делить на ноль. Сдвиг равен первому среднему, делённому на корень из второго, то есть каждый вес делится на собственный масштаб: у постоянного градиента, крупного или мелкого, сдвиг одного порядка, а у скачущего туда-сюда среднее гасится, и вес почти стоит. Затухание каждый шаг чуть поджимает все веса к нулю.
РазмерШага растёт из скорости обучения. Это главная ручка всего процесса, по-английски learning rate:
Функция СкоростьНаШаге(ШагНомер)
	Пи = 3.14159265358979323846264338328;
	Возврат Обучение.СкоростьОбучения * (1 + Cos(Пи * ШагНомер / Обучение.ВсегоШагов)) / 2;
КонецФункции
Стартует с 0,01 и по косинусу сходит к нулю к последнему шагу: в начале модель шагает широко, к концу дошлифовывает. С 0,003, как в августе, 800 шагов дают ноль верных ответов, а 1 600 шагов дают 39: мелким шагам не хватает их числа.
Как это крутилось на сервере
Один вызов сервера на три часа я держать не стал. Снаружи работает маленький скрипт на Node.js, который через HTTP-сервис базы вызывает экспортную ОбучитьПорцию: до восьми шагов и не дольше 150 секунд за раз, на деле выходило около 105 секунд. Всё состояние между вызовами лежит в файле: веса, оба средних AdamW, номер шага, расписание. Пишет его ЗначениеВФайл прямо из структуры, 2,5 МБ за 22 мс. Оборвался вызов - следующий запуск продолжит с последнего сохранённого шага.
Шаг занимал от 10 до 19 секунд, в среднем 13,3. Из них на AdamW по всем 21 920 весам уходит около четверти секунды, остальное - градиенты. Прогноз был 3,1 часа, вышло 2,96. Мерить надо на свободной машине: пока рядом крутился перебор в Python, тот же шаг 1С занял 25,8 секунды вместо 10,7. На рисунке ночной прогон целиком.
Две вещи на встроенном языке надо знать заранее.
Числа 1С растут в длину. Число в 1С десятичное и точное, и произведение двух чисел по 20 знаков после запятой даёт 40 знаков. В цикле сумма у меня накопила 72 знака, а среднее квадратов в AdamW добавляло по три знака на каждом шаге навсегда. Длинные числа считаются примерно в 1,6 раза медленнее коротких. Поэтому в коде везде Окр: векторы между операциями режутся до 20 знаков, средние AdamW до 28.
Число("1.5e-3") экспоненту не понимает, а ЧтениеJSON понимает. Стартовые веса из PyTorch записаны с экспонентой, поэтому они приходят в 1С файлом JSON, а не строками.
Что модель знала по дороге
Я повторил прогон в 1С с сохранением весов на шагах 50-400 (повтор совпал с ночным байт в байт) и задал снимкам одни и те же вопросы. Похожая таблица была в статье Нейросеть назвала метод, которого нет, но там веса учил Python.
| шаг | ответ на "зачем нужна транзакция" |
|---|---|
| 0 | еачтжхмнвеьюялз?лъчснялф?ллъчзф?чзбялльняеацзшуч |
| 50 | реният па данит да зания храниканият ит по: ранит зия ок от довия |
| 100 | рения денистано до зния ранисия доли. |
| 200 | истазат ия защой денния ны ния тразы. |
| 400 | транзакция защищает данные от чадазапистие у азанития да ханития д |
| 800 | транзакция защищает данные от частичной записи. |
Порядок похож на ту статью: сначала частые слоги, потом куски слов, верный ответ последним. Новое здесь то, что точка в конце и длина фразы появляются уже к 100-му шагу, раньше слов. Вопрос про котлеты на 800-м шаге получает бессмыслицу тем же ровным тоном: "двит прачит ператаету длет п поль чу?".
Как я проверял, что не ошибся в производных
Обратный проход - самое хрупкое место. Перепутал знак или индекс, и модель всё равно учится, только хуже, и ошибку не видно три часа. Поэтому до ночного прогона я сделал две проверки.
Первая: одни и те же стартовые веса, одна и та же пачка, посчитать потерю и все градиенты в 1С и в PyTorch с двойной точностью. Потеря совпала в 16 знаках: 3,745062506464834. Худшая из 20 таблиц градиентов разошлась на 6,4e-11 (относительная ошибка по элементу) при пороге 1e-6.
Вторая обходится без чужой библиотеки, и её можно применить к любому своему расчёту. Берём вес, сдвигаем его на 0,00001 вверх и считаем потерю, потом вниз и снова считаем. Разность потерь, делённая на двойной сдвиг, и есть градиент, посчитанный в лоб. Я сравнил так 40 весов, по два на таблицу: у 38 из них градиент больше 0,0001, и относительное расхождение не хуже 1,9e-7; худшее, 1,3e-6, у веса с крошечным градиентом 1,2e-5, где сказывается погрешность самой формулы. Функция ПроверитьКонечнымиРазностями лежит в модуле, область ПроверкаОбучения.
Кто посчитал точнее
После ночи модель 1С ответила верно на 38 вопросов из 40, модель PyTorch в том же режиме на 39. Ответы совпали дословно на 39 вопросах, разошлись на одном:
где хранятся права?
1С:      итава хранятся дня ся пользоватегистаель.
PyTorch: права хранятся в роли пользователя.
Первая мысль была про округление в 1С. Я обучил ту же модель в PyTorch дважды: в обычной одинарной точности (float32, около 7 значащих цифр) и в двойной (float64, около 16).
| что с чем сравнивал | наибольшая разница потерь за 800 шагов | итоговые веса: наибольшая разница к самому крупному весу таблицы |
|---|---|---|
| 1С и PyTorch float64 | 7,8e-13 | 1,4e-12 |
| 1С и PyTorch float32 | 0,176 | 61 % |
| PyTorch float32 и float64 | 0,176 | 61 % |
1С прошла все 800 шагов вместе с двойной точностью, и модель float64 отвечает про права той же кашей. Веса float32 к концу другие, а ответы на 39 вопросах те же: одну задачу решают разные наборы чисел. А float32 начал расходиться с первого шага: к 37-му разница потерь 0,00001, к 236-му уже 0,1.
Крошечное отклонение на старте раскачивается: шаг зависит от весов, веса от прошлых шагов. Float32 ушёл на свою траекторию и на вопросе про права попал удачно. Это один старт: на пяти стартах float32 давал 39 из 40, а float64 и 1С на других я не прогонял, так что везение это или закономерность, не скажу. Тот же float32 с другим числом потоков процессора даёт третью траекторию, потому что меняется порядок сложения: на шаге 200 потеря 1,0128 при шести потоках и 1,0165 при двух. У 1С повтор совпал с ночным прогоном на всех проверенных 400 шагах.
Потеря на всём корпусе, сорок пар разом, у моделей почти равна, 0,0784 у 1С и 0,0798 у float32, и лишний верный ответ всё-таки у float32. Точность 1С здесь ограничена 20 знаками, которые я храню, и 15 значащими цифрами Exp и Sqrt.
Как сломать обучение
Самый быстрый способ - скорость обучения. При 0,03 модель ещё выходит на 39 из 40, а при 0,1 потеря застревает около 2,5-2,9, модель выучивает только частые буквы и на вопрос про справочник отвечает "ие иениениенаие иение иение ние ие ие". Верных ответов ноль. В 1С я прогнал 20 таких шагов: потеря скачет 3,745, 3,270, 3,578, 3,338, 3,627 вместо ровного спуска рабочего режима 3,745, 3,509, 3,314, 3,262, 3,109. Шаг слишком широкий, и модель каждый раз перепрыгивает яму, в которую должна скатиться.
Второе я ждал увидеть и не увидел. Перед каждым слоем модель нормализует вектор: делит на корень из среднего квадрата его чисел, чтобы они не разъезжались. Я был уверен, что без этого обучение развалится, и убрал нормализацию. На скорости 0,01 модель выучила корпус так же, 39 из 40, и потеря вышла даже чуть меньше. На медленной 0,003 без нормализации 9 из 40, а с ней на той же скорости было ноль. На двух слоях её отсутствие не помешало ни в одном режиме, что я пробовал.
Насколько большую модель потянет встроенный язык
Я замерил два шага обучения для моделей шире: длина вектора 64 и 128 вместо 32. Сколько шагов нужно до 39 из 40, проверил в Python (для 64 и 128 на одном старте), часы пересчитал от ночного прогона.
| длина вектора | чисел в модели | шаг дороже в | шагов до 39 из 40 | часов в 1С | ночей по 10 часов |
|---|---|---|---|---|---|
| 32 | 21 920 | 1 | 800 | 2,96 (факт) | 0,3 |
| 64 | 76 608 | 3,0 | 400 | 4,5 | 0,45 |
| 128 | 284 288 | 9,7 | 400 | 14,4 | 1,4 |
Широкой модели хватило вдвое меньше шагов, но шаг дорожает в три с небольшим раза на каждое удвоение ширины. 128 уже не влезает в ночь, а 256 по той же закономерности вышла бы около 46 часов, но это оценка: такой шаг я не мерил.
Модель на наших статьях
Сорок пар про объекты 1С я писал руками. Второй корпус я собрал из 38 наших статей: заголовок раздела как вопрос, первое предложение под ним как ответ, без кода и таблиц. Вышло 253 пары и алфавит из 49 символов. Подбирал в Python при тех же 800 шагах; часы - прогноз для 1С по числу умножений, пары здесь длиннее ручных, отсюда 4 часа против 2,96.
| пар | эпох | верно дословно | прогноз часов в 1С |
|---|---|---|---|
| 40 из статей | 40 | 39 из 40 | 4,0 |
| 80 | 20 | 0 | 4,1 |
| 253 | 6,3 | 0 | 4,1 |
Модель из Python на сорока парах отвечает нашими фразами. На заголовок "отчет, в который я почти поверил" пишет "свертка шла в самописной конфигурации крупной сети.". На заголовок, которого в корпусе не было, "почему обработка работает медленно", выдаёт "привычттри встри р зднораль.".
На сорока парах модель запоминает дословно и ничего не обобщает. На 80 и 253 парах она просто недоучилась, 20 и 6 эпох вместо 40. Если давать каждой фразе те же 40 эпох, это около шести минут счёта 1С на фразу. Эти числа сняты в PyTorch; тот же прогон на сорока парах из статей в 1С стоит в очереди на ночь, по расчёту это около четырёх часов.
Код обучения лежит в модуле объекта новой версии обработки Локальная LLM на встроенном языке 1С, область Обучение. Выученные веса 1С ужимает в тот же формат, что и веса из Python, и их читает прежний Ответить: на нём получены 38 из 40. Формат сверен на стартовых весах: ужатые в 1С и в Python, они совпали во всех 24 740 байтах.
Обучение внутри базы хорошо тем, что данные никуда не уезжают, ни в Python, ни на чужой сервер, а платить за это приходится ночью счёта вместо минут снаружи. Для какой задачи в своей базе вы бы пошли на такой размен, будь модель полезной, а не игрушечной: классификация обращений, разнесение статей затрат, что-то ещё? Или проще выгрузить данные и обучить снаружи?
Обработка из статьи: Локальная LLM на встроенном языке 1С. Бесплатно, один файл, веса внутри, код обучения и ответа открыт.
Серия про языковую модель на встроенном языке 1С:
- Внутри LLM нет ни одного Если. Языковая модель целиком на встроенном языке 1С - токены, веса, внимание и галлюцинация на 21 920 параметрах.
- Нейросеть назвала метод, которого нет - двенадцать снимков одной модели по ходу обучения. Обработка к ней: Обучение на глазах.
Другие наши инструменты:
- Выгрузка метаданных для LLM - структура вашей конфигурации в виде, который нейросеть читает без пересказа, чтобы она не выдумывала реквизиты.
- Чек-ап СУБД под 1С - проверка настроек сервера баз данных, на которых 1С теряет скорость.
- Карта объёмов базы 1С - какие таблицы и объекты занимают место в базе.
- Аудит паролей СУБД - где пароль к серверу баз данных лежит открыто.
Вступайте в нашу телеграмм-группу Инфостарт
Вы можете заказать платную адаптацию этой статьи под ваши задачи на «Бирже заказов».
- 0% комиссии — оплата напрямую исполнителю;
- Исполнители любого масштаба — от отдельных специалистов до команд под проект;
- Прямой обмен контактами между заказчиком и исполнителем;
- Безопасная сделка — при необходимости;
- Рейтинги, кейсы и прозрачная система откликов.